首页 文章 精选 留言 我的

精选列表

搜索[单体架构],共10008篇文章
优秀的个人博客,低调大师

深入Redux架构

关于redux 之前写了一篇通过一个demo了解Redux,但对于redux的核心方法没有进行深入剖析,在此重新总结学习,完整的代码看这里。(参考了React 技术栈系列教程) 什么情况需要用redux? 用户的使用方式复杂 不同身份的用户有不同的使用方式(比如普通用户和管理员) 多个用户之间可以协作 与服务器大量交互,或者使用了WebSocket View要从多个来源获取数据 简单说,如果你的UI层非常简单,没有很多互动,Redux 就是不必要的,用了反而增加复杂性。多交互、多数据源场景就比较适合使用Redux。 设计思想: Web 应用是一个状态机,视图与状态是一一对应的。 所有的状态,保存在一个对象里面。 Redux工作流程: 首先,用户发出 Action。 store.dispatch(action); 然后,Store 自动调用 Reducer,并且传入两个参数:当前 State 和收到的 Action。 Reducer 会返回新的 State 。 letnextState=todoApp(previousState,action); State 一旦有变化,Store 就会调用监听函数。 //设置监听函数store.subscribe(listener); listener可以通过store.getState()得到当前状态。如果使用的是 React,这时可以触发重新渲染 View。 functionlisterner(){ letnewState=store.getState(); component.setState(newState); } 如果现在没理解以上流程,不要急,看完以下API就差不多能懂得Redux的核心机制了。 回到顶部(go to top) API Store Store 就是保存数据的地方,你可以把它看成一个容器。整个应用只能有一个 Store。 Redux 提供createStore这个函数,用来生成 Store。 下面代码中,createStore函数接受另一个函数作为参数,返回新生成的 Store 对象。 import{createStore}from'redux'; conststore=createStore(fn); State Store对象包含所有数据。如果想得到某个时点的数据,就要对 Store 生成快照。这种时点的数据集合,就叫做 State。 当前时刻的 State,可以通过store.getState()拿到。 import{createStore}from'redux'; conststore=createStore(fn); conststate=store.getState(); Redux 规定, 一个 State 对应一个 View。只要 State 相同,View 就相同。你知道 State,就知道 View 是什么样,反之亦然。 Action State 的变化,会导致 View 的变化。但是,用户接触不到 State,只能接触到 View。所以,State 的变化必须是 View 导致的。Action 就是 View 发出的通知,表示 State 应该要发生变化了。 Action 是一个对象。其中的type属性是必须的,表示 Action 的名称。其他属性可以自由设置,社区有一个规范可以参考。 constaction={ type:'ADD_TODO', payload:'LearnRedux'}; 上面代码中,Action 的名称是ADD_TODO,它携带的信息是字符串Learn Redux。 可以这样理解,Action 描述当前发生的事情。改变 State 的唯一办法,就是使用 Action。它会运送数据到 Store。 Action Creator View 要发送多少种消息,就会有多少种 Action。如果都手写,会很麻烦。可以定义一个函数来生成 Action,这个函数就叫 Action Creator。 constADD_TODO='添加TODO';functionaddTodo(text){return{ type:ADD_TODO, text } } constaction=addTodo('LearnRedux'); store.dispatch() store.dispatch()是 View 发出 Action 的唯一方法。 import{createStore}from'redux'; conststore=createStore(fn); store.dispatch({ type:'ADD_TODO', payload:'LearnRedux'}); 上面代码中,store.dispatch接受一个 Action 对象作为参数,将它发送出去。 结合 Action Creator,这段代码可以改写如下。 store.dispatch(addTodo('LearnRedux')); Reducer Store 收到 Action 以后,必须给出一个新的 State,这样 View 才会发生变化。这种 State 的计算过程就叫做 Reducer。 Reducer 是一个函数,它接受 Action 和当前 State 作为参数,返回一个新的 State。下面是一个实际的例子 constdefaultState=0; constreducer=(state=defaultState,action)=>{switch(action.type){case'ADD':returnstate+action.payload;default: returnstate; } }; conststate=reducer(1,{ type:'ADD', payload:2}); 上面代码中,reducer函数收到名为ADD的 Action 以后,就返回一个新的 State,作为加法的计算结果。其他运算的逻辑(比如减法),也可以根据 Action 的不同来实现。 实际应用中,Reducer 函数不用像上面这样手动调用,store.dispatch方法会触发 Reducer 的自动执行。为此,Store 需要知道 Reducer 函数,做法就是在生成 Store 的时候,将 Reducer 传入createStore方法。 import{createStore}from'redux'; conststore=createStore(reducer); 上面代码中,createStore接受 Reducer 作为参数,生成一个新的 Store。以后每当store.dispatch发送过来一个新的 Action,就会自动调用 Reducer,得到新的 State。 store.subscribe() Store 允许使用store.subscribe方法设置监听函数,一旦 State 发生变化,就自动执行这个函数。 import{createStore}from'redux'; conststore=createStore(reducer); store.subscribe(listener); 显然,只要把 View 的更新函数(对于 React 项目,就是组件的render方法或setState方法)放入listen,就会实现 View 的自动渲染。 store.subscribe方法返回一个函数,调用这个函数就可以解除监听。 letunsubscribe=store.subscribe(()=> console.log(store.getState()) ); unsubscribe(); 回到顶部(go to top) 中间件与异步操作 一个关键问题没有解决:异步操作怎么办?Action 发出以后,Reducer 立即算出 State,这叫做同步;Action 发出以后,过一段时间再执行 Reducer,这就是异步。 怎么才能 Reducer 在异步操作结束后自动执行呢?这就要用到新的工具:中间件(middleware)。 为了理解中间件,让我们站在框架作者的角度思考问题:如果要添加功能,你会在哪个环节添加? (1)Reducer:纯函数,只承担计算 State 的功能,不合适承担其他功能,也承担不了,因为理论上,纯函数不能进行读写操作。 (2)View:与 State 一一对应,可以看作 State 的视觉层,也不合适承担其他功能。 (3)Action:存放数据的对象,即消息的载体,只能被别人操作,自己不能进行任何操作。 想来想去,只有发送 Action 的这个步骤,即store.dispatch()方法,可以添加功能。 中间件的用法 本文不涉及如何编写中间件,因为常用的中间件都有现成的,只要引用别人写好的模块即可。比如,上一节的日志中间件,就有现成的redux-logger模块。这里只介绍怎么使用中间件。 import{applyMiddleware,createStore}from'redux'; importcreateLoggerfrom'redux-logger'; constlogger=createLogger(); conststore=createStore( reducer, applyMiddleware(logger) ); 上面代码中,redux-logger提供一个生成器createLogger,可以生成日志中间件logger。然后,将它放在applyMiddleware方法之中,传入createStore方法,就完成了store.dispatch()的功能增强。 这里有两点需要注意: (1)createStore方法可以接受整个应用的初始状态作为参数,那样的话,applyMiddleware就是第三个参数了。 conststore=createStore( reducer, initial_state, applyMiddleware(logger) ); (2)中间件的次序有讲究。 conststore=createStore( reducer, applyMiddleware(thunk,promise,logger) ); 上面代码中,applyMiddleware方法的三个参数,就是三个中间件。有的中间件有次序要求,使用前要查一下文档。比如,logger就一定要放在最后,否则输出结果会不正确。 回到顶部(go to top) 异步操作的基本思路 理解了中间件以后,就可以处理异步操作了。 同步操作只要发出一种 Action 即可,异步操作的差别是它要发出三种 Action。 操作发起时的 Action 操作成功时的 Action 操作失败时的 Action 以向服务器取出数据为例,三种 Action 可以有两种不同的写法。 //写法一:名称相同,参数不同{type:'FETCH_POSTS'} {type:'FETCH_POSTS',status:'error',error:'Oops'} {type:'FETCH_POSTS',status:'success',response:{...}}//写法二:名称不同{type:'FETCH_POSTS_REQUEST'} {type:'FETCH_POSTS_FAILURE',error:'Oops'} {type:'FETCH_POSTS_SUCCESS',response:{...}} 除了 Action 种类不同,异步操作的 State 也要进行改造,反映不同的操作状态。下面是 State 的一个例子。 letstate={//... isFetching:true, didInvalidate:true, lastUpdated:'xxxxxxx'}; 上面代码中,State 的属性isFetching表示是否在抓取数据。didInvalidate表示数据是否过时,lastUpdated表示上一次更新时间。 现在,整个异步操作的思路就很清楚了。 操作开始时,送出一个 Action,触发 State 更新为"正在操作"状态,View 重新渲染 操作结束后,再送出一个 Action,触发 State 更新为"操作结束"状态,View 再一次重新渲染 redux-thunk中间件 异步操作至少要送出两个 Action:用户触发第一个 Action,这个跟同步操作一样,没有问题;如何才能在操作结束时,系统自动送出第二个 Action 呢? 奥妙就在 Action Creator 之中。 classAsyncAppextendsComponent{ componentDidMount(){ const{dispatch,selectedPost}=this.props dispatch(fetchPosts(selectedPost)) }//... 上面代码是一个异步组件的例子。加载成功后(componentDidMount方法),它送出了(dispatch方法)一个 Action,向服务器要求数据fetchPosts(selectedSubreddit)。这里的fetchPosts就是 Action Creator。 下面就是fetchPosts的代码,关键之处就在里面。 constfetchPosts=postTitle=>(dispatch,getState)=>{ dispatch(requestPosts(postTitle));returnfetch(`/some/API/${postTitle}.json`) .then(response=>response.json()) .then(json=>dispatch(receivePosts(postTitle,json))); }; };//使用方法一store.dispatch(fetchPosts('reactjs'));//使用方法二store.dispatch(fetchPosts('reactjs')).then(()=> console.log(store.getState()) ); 上面代码中,fetchPosts是一个Action Creator(动作生成器),返回一个函数。这个函数执行后,先发出一个Action(requestPosts(postTitle)),然后进行异步操作。拿到结果后,先将结果转成 JSON 格式,然后再发出一个 Action(receivePosts(postTitle, json))。 上面代码中,有几个地方需要注意。 (1)fetchPosts返回了一个函数,而普通的 Action Creator 默认返回一个对象。 (2)返回的函数的参数是dispatch和getState这两个 Redux 方法,普通的 Action Creator 的参数是 Action 的内容。 (3)在返回的函数之中,先发出一个 Action(requestPosts(postTitle)),表示操作开始。 (4)异步操作结束之后,再发出一个 Action(receivePosts(postTitle, json)),表示操作结束。 这样的处理,就解决了自动发送第二个 Action 的问题。但是,又带来了一个新的问题,Action 是由store.dispatch方法发送的。而store.dispatch方法正常情况下,参数只能是对象,不能是函数。 这时,就要使用中间件redux-thunk。 import{createStore,applyMiddleware}from'redux'; importthunkfrom'redux-thunk'; importreducerfrom'./reducers';//Note:thisAPIrequiresredux@>=3.1.0conststore=createStore( reducer, applyMiddleware(thunk) ); 上面代码使用redux-thunk中间件,改造store.dispatch,使得后者可以接受函数作为参数。 因此,异步操作的第一种解决方案就是,写出一个返回函数的 Action Creator,然后使用redux-thunk中间件改造store.dispatch。 回到顶部(go to top) React-Redux的用法 为了方便使用,Redux 的作者封装了一个 React 专用的库React-Redux,本文主要介绍它。 这个库是可以选用的。实际项目中,你应该权衡一下,是直接使用 Redux,还是使用 React-Redux。后者虽然提供了便利,但是需要掌握额外的 API,并且要遵守它的组件拆分规范。 React-Redux 将所有组件分成两大类:UI 组件(presentational component)和容器组件(container component)。 UI组件 UI 组件有以下几个特征。 只负责 UI 的呈现,不带有任何业务逻辑 没有状态(即不使用this.state这个变量) 所有数据都由参数(this.props)提供 不使用任何 Redux 的 API 下面就是一个 UI 组件的例子。 constTitle= value=><h1>{value}</h1>; 因为不含有状态,UI 组件又称为"纯组件",即它纯函数一样,纯粹由参数决定它的值。 容器组件 容器组件的特征恰恰相反。 负责管理数据和业务逻辑,不负责 UI 的呈现 带有内部状态 使用 Redux 的 API 总之,只要记住一句话就可以了:UI 组件负责 UI 的呈现,容器组件负责管理数据和逻辑。 你可能会问,如果一个组件既有 UI 又有业务逻辑,那怎么办?回答是,将它拆分成下面的结构:外面是一个容器组件,里面包了一个UI 组件。前者负责与外部的通信,将数据传给后者,由后者渲染出视图。 React-Redux 规定,所有的 UI 组件都由用户提供,容器组件则是由 React-Redux 自动生成。也就是说,用户负责视觉层,状态管理则是全部交给它。 connect() React-Redux 提供connect方法,用于从 UI 组件生成容器组件。connect的意思,就是将这两种组件连起来。 connect方法的完整 API 如下。 import{connect}from'react-redux'constVisibleTodoList=connect( mapStateToProps, mapDispatchToProps )(TodoList) 上面代码中,TodoList是 UI 组件,VisibleTodoList就是由 React-Redux 通过connect方法自动生成的容器组件。connect方法接受两个参数:mapStateToProps和mapDispatchToProps。它们定义了 UI 组件的业务逻辑。前者负责输入逻辑,即将state映射到 UI 组件的参数(props),后者负责输出逻辑,即将用户对 UI 组件的操作映射成 Action。 mapStateToProps mapStateToProps是一个函数。它的作用就是像它的名字那样,建立一个从(外部的)state对象到(UI 组件的)props对象的映射关系。 作为函数,mapStateToProps执行后应该返回一个对象,里面的每一个键值对就是一个映射。请看下面的例子。 constmapStateToProps=(state)=>{return{ todos:getVisibleTodos(state.todos,state.visibilityFilter) } } 上面代码中,mapStateToProps是一个函数,它接受state作为参数,返回一个对象。这个对象有一个todos属性,代表 UI 组件的同名参数,后面的getVisibleTodos也是一个函数,可以从state算出todos的值。 下面就是getVisibleTodos的一个例子,用来算出todos。 constgetVisibleTodos=(todos,filter)=>{switch(filter){case'SHOW_ALL':returntodoscase'SHOW_COMPLETED':returntodos.filter(t=>t.completed)case'SHOW_ACTIVE':returntodos.filter(t=>!t.completed)default:thrownewError('Unknownfilter:'+filter) } } mapStateToProps会订阅 Store,每当state更新的时候,就会自动执行,重新计算 UI 组件的参数,从而触发 UI 组件的重新渲染。 mapStateToProps的第一个参数总是state对象,还可以使用第二个参数,代表容器组件的props对象。 //容器组件的代码//<FilterLinkfilter="SHOW_ALL">//All//</FilterLink>constmapStateToProps=(state,ownProps)=>{return{ active:ownProps.filter===state.visibilityFilter } } 使用ownProps作为参数后,如果容器组件的参数发生变化,也会引发 UI 组件重新渲染。 connect方法可以省略mapStateToProps参数,那样的话,UI 组件就不会订阅Store,就是说 Store 的更新不会引起 UI 组件的更新。 mapDispatchToProps() mapDispatchToProps是connect函数的第二个参数,用来建立 UI 组件的参数到store.dispatch方法的映射。也就是说,它定义了哪些用户的操作应该当作 Action,传给 Store。它可以是一个函数,也可以是一个对象。 如果mapDispatchToProps是一个函数,会得到dispatch和ownProps(容器组件的props对象)两个参数。 constmapDispatchToProps=( dispatch, ownProps )=>{return{ onClick:()=>{ dispatch({ type:'SET_VISIBILITY_FILTER', filter:ownProps.filter }); } }; } 从上面代码可以看到,mapDispatchToProps作为函数,应该返回一个对象,该对象的每个键值对都是一个映射,定义了 UI 组件的参数怎样发出 Action。 如果mapDispatchToProps是一个对象,它的每个键名也是对应 UI 组件的同名参数,键值应该是一个函数,会被当作 Action creator ,返回的 Action 会由 Redux 自动发出。举例来说,上面的mapDispatchToProps写成对象就是下面这样。 constmapDispatchToProps={ onClick:(filter)=>{ type:'SET_VISIBILITY_FILTER', filter:filter }; } <Provider>组件 connect方法生成容器组件以后,需要让容器组件拿到state对象,才能生成 UI 组件的参数。React-Redux 提供Provider组件,可以让容器组件拿到state。 import{Provider}from'react-redux'import{createStore}from'redux'importtodoAppfrom'./reducers'importAppfrom'./components/App'letstore=createStore(todoApp); render(<Providerstore={store}> <App/> </Provider>, document.getElementById('root') ) 上面代码中,Provider在根组件外面包了一层,这样一来,App的所有子组件就默认都可以拿到state了。 React-Router路由库 使用React-Router的项目,与其他项目没有不同之处,也是使用Provider在Router外面包一层,毕竟Provider的唯一功能就是传入store对象。 constRoot=({store})=>(<Providerstore={store}> <Router> <Routepath="/"component={App}/> </Router> </Provider> ); 本文转自 bxst 51CTO博客,原文链接:http://blog.51cto.com/13013670/1943931

优秀的个人博客,低调大师

商城架构二

index.php: <?php /* 以后所有由用户直接访问到的这些页面 都得先加载init.php */ require('./include/init.php'); $conf = conf::getIns(); var_dump($conf); ?> include/config.inc.php: <?php /* file.config.inc.php 配置文件 */ $_CFG = array(); $_CFG['host'] = '127.0.0.1'; $_CFG['user'] = 'root'; $_CFG['pwd'] = '111111'; ?> include/conf.class.php: <?php /* file conf.class.php 配置文件读取类 */ class conf{ protected static $ins = null; protected $data = array(); final protected function __construct(){ //一次性把配置文件信息读过来赋给$data属性; //这样以后就不再管配置文件了; //再要配置的值时,直接从$data属性找; include(ROOT . 'config.inc.php'); $this->data = $_CFG; } final protected function __clone(){ } public static function getIns(){ if(self::$ins instanceof self){ return self::$ins; }else{ self::$ins = new self(); return self::$ins; } } //用魔术方法,读取data内的信息 public function __get($key){ if(array_key_exists($key,$this->data)){ return $this->data[$key]; }else{ return null; } } //用魔术方法,在运行期间,动态增加,动态增加或改变配置选项 public function __set($key,$value){ $this->data[$key] = $value; } } $conf = conf::getIns(); /* 已经能把配置文件的信息,读取的自身的data属性中存储起来 print_r($conf); */ //var_dump($conf->user);//测试魔术方法__get() 读取选项 /* $conf->template_dir = 'D:/www/smary';//测试__set() 动态的追加选项 echo $conf->template_dir; */ ?> include/init.php: <?php /* file init.php 作用:框架初始化 */ //初始化当前的绝对路径 //换成正斜线是因为win/linux都支持正斜线,而linux不支持反斜线 define('ROOT',str_replace('\\','/',dirname(__FILE__)) . '/'); define('DEBUG',true); require(ROOT . 'db.class.php'); require(ROOT . 'conf.class.php'); //过滤参数,用递归的方式过滤$_GET,$_POST,$_COOKIE,暂时不会 //设置报错级别 if(defined('DEBUG')){ error_reporting(E_ALL); }else{ error_reporting(0); } ?> 本文转自 IT阿飞 51CTO博客,原文链接:http://blog.51cto.com/itafei/1711171

优秀的个人博客,低调大师

MySQL主从架构

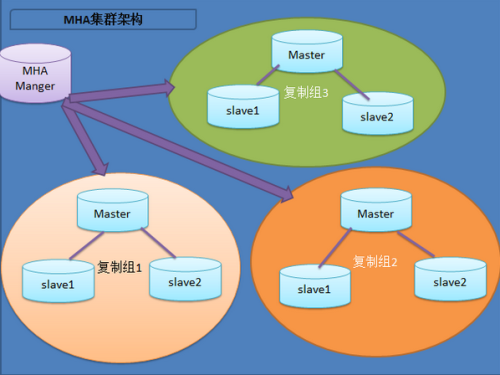
MySQL主从又叫做Replication、AB复制。简单讲就是A和B两台机器做主从后,在A上写数据,另外一台B也会跟着写数据,两者数据实时同步的。它基于binlog,主设备上须开启binlog才能进行主从。 主从过程大致有3个步骤: 1)主设备将更改操作记录到binlog里; 2)从将主设备的binlog事件(sql语句)同步到从本机上并记录在relaylog里; 3)从根据relaylog里面的sql语句按顺序执行。 主设备上有一个log dump线程,用来和从的I/O线程传递binlog。从设备上有两个线程,其中I/O线程用来同步主的binlog并生成relaylog,另外一个SQL线程用来把relaylog里面的sql语句落地。 准备工作 1、准备两台装有mysql的服务器,并启动mysql服务。 2、分配角色,确定设备主从。 配置主设备 1、编辑配置文件 1 2 3 4 [root@plinuxos~] #vim/etc/my.cnf [mysqld] server- id =88 log_bin=bin01 2、重启mysql 1 2 3 [root@plinuxos~] #/etc/init.d/mysqldrestart ShuttingdownMySQL....SUCCESS! StartingMySQL.SUCCESS! 3、检查log_bin 1 2 [root@plinuxos~] #ls/data/mysql/bin01.* /data/mysql/bin01 .000001 /data/mysql/bin01 .index 4、创建数据库 1 2 [root@plinuxosmysql] #cd/data/mysql [root@plinuxosmysql] #/usr/local/mysql/bin/mysql-uroot-e'createdatabasedb01' 5、增加测试数据 1 2 [root@plinuxosmysql] #/usr/local/mysql/bin/mysqldump-urootzrlog>/tmp/zrlog.sql [root@plinuxosmysql] #/usr/local/mysql/bin/mysql-urootdb01</tmp/zrlog.sql 6、备份所有数据库 1 2 [root@plinuxosmysql] #/usr/local/mysql/bin/mysqldump-urootdb01>/tmp/db01.sql [root@plinuxosmysql] #/usr/local/mysql/bin/mysqldump-urootzrlog>/tmp/zrlog.sql 7、创建用户 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 [root@plinuxosmysql] #/usr/local/mysql/bin/mysql-uroot WelcometotheMySQLmonitor.Commandsendwith;or\g. YourMySQLconnection id is414 Serverversion:5.6.35-logMySQLCommunityServer(GPL) Copyright(c)2000,2016,Oracleand /or itsaffiliates.Allrightsreserved. OracleisaregisteredtrademarkofOracleCorporationand /or its affiliates.Othernamesmaybetrademarksoftheirrespective owners. Type 'help;' or '\h' for help.Type '\c' to clear thecurrentinputstatement. mysql>grantreplicationslaveon*.*to 'repl' @ '122.112.197.192' identifiedby '123456' ; QueryOK,0rowsaffected(0.01sec) 8、锁表并查看状态 1 2 3 4 5 6 7 8 9 10 mysql>flushtableswith read lock; ##锁表,防止写入 QueryOK,0rowsaffected(0.01sec) mysql>showmasterstatus; ##下方两个参数需要在从设备上配置 +--------------+----------+--------------+------------------+-------------------+ |File|Position|Binlog_Do_DB|Binlog_Ignore_DB|Executed_Gtid_Set| +--------------+----------+--------------+------------------+-------------------+ |bin01.000001|10472|||| +--------------+----------+--------------+------------------+-------------------+ 1row in set (0.00sec) 配置从设备 1、编辑配置文件 1 2 3 [root@ecs-89c1mysql] #vi/etc/my.cnf [mysqld] server- id =192 2、重启mysql 1 2 3 [root@ecs-89c1mysql] #/etc/init.d/mysqldrestart ShuttingdownMySQL..SUCCESS! StartingMySQL.SUCCESS! 3、复制主设备数据库备份文件 1 2 3 4 5 6 7 8 [root@ecs-89c1mysql] #scp122.112.253.88:/tmp/*.sql/tmp/ Theauthenticityofhost '122.112.253.88(122.112.253.88)' can'tbeestablished. ECDSAkeyfingerprintis2e:6e:90:32:87:05:9e:63:63:d6:2d:44:a5:5f:be:51. Areyousureyouwantto continue connecting( yes /no )? yes Warning:Permanentlyadded '122.112.253.88' (ECDSA)tothelistofknownhosts. root@122.112.253.88'spassword: db01.sql100%98779.7KB /s 00:00 zrlog.sql100%98789.7KB /s 00:00 4、创建对应数据库 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 [root@ecs-89c1mysql] #/usr/local/mysql/bin/mysql-uroot WelcometotheMySQLmonitor.Commandsendwith;or\g. YourMySQLconnection id is1 Serverversion:5.6.35MySQLCommunityServer(GPL) Copyright(c)2000,2016,Oracleand /or itsaffiliates.Allrightsreserved. OracleisaregisteredtrademarkofOracleCorporationand /or its affiliates.Othernamesmaybetrademarksoftheirrespective owners. Type 'help;' or '\h' for help.Type '\c' to clear thecurrentinputstatement. mysql>createdatabasedb01; QueryOK,1rowaffected(0.00sec) mysql>createdatabasezrlog; QueryOK,1rowaffected(0.00sec) [root@ecs-89c1mysql] #/usr/local/mysql/bin/mysql-urootdb01</tmp/db01.sql [root@ecs-89c1mysql] #/usr/local/mysql/bin/mysql-urootzrlog</tmp/zrlog.sql 5、配置主备同步 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 [root@ecs-89c1mysql] #/usr/local/mysql/bin/mysql-uroot WelcometotheMySQLmonitor.Commandsendwith;or\g. YourMySQLconnection id is4 Serverversion:5.6.35MySQLCommunityServer(GPL) Copyright(c)2000,2016,Oracleand /or itsaffiliates.Allrightsreserved. OracleisaregisteredtrademarkofOracleCorporationand /or its affiliates.Othernamesmaybetrademarksoftheirrespective owners. Type 'help;' or '\h' for help.Type '\c' to clear thecurrentinputstatement. mysql>stopslave; QueryOK,0rowsaffected,1warning(0.00sec) mysql>changemastertomaster_host= '122.112.253.88' ,master_user= 'repl' ,master_password= '123456' ,master_log_file= 'bin01.000001' ,master_log_pos=10472; QueryOK,0rowsaffected,2warnings(0.03sec) mysql>startslave; QueryOK,0rowsaffected(0.01sec) 6、查看主从状态 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 mysql>showslavestatus\G; ##如果出现错误,可能是云主机策略没放过3306端口 ***************************1.row*************************** Slave_IO_State:Waiting for mastertosendevent Master_Host:122.112.253.88 Master_User:repl Master_Port:3306 Connect_Retry:60 Master_Log_File:bin01.000001 Read_Master_Log_Pos:10708 Relay_Log_File:ecs-89c1-relay-bin.000003 Relay_Log_Pos:515 Relay_Master_Log_File:bin01.000001 Slave_IO_Running:Yes Slave_SQL_Running:Yes Replicate_Do_DB: Replicate_Ignore_DB: Replicate_Do_Table: Replicate_Ignore_Table: Replicate_Wild_Do_Table: Replicate_Wild_Ignore_Table: Last_Errno:0 Last_Error: Skip_Counter:0 Exec_Master_Log_Pos:10708 Relay_Log_Space:691 Until_Condition:None Until_Log_File: Until_Log_Pos:0 Master_SSL_Allowed:No Master_SSL_CA_File: Master_SSL_CA_Path: Master_SSL_Cert: Master_SSL_Cipher: Master_SSL_Key: Seconds_Behind_Master:0 Master_SSL_Verify_Server_Cert:No Last_IO_Errno:0 Last_IO_Error: Last_SQL_Errno:0 Last_SQL_Error: Replicate_Ignore_Server_Ids: Master_Server_Id:88 Master_UUID:79b66469-8cc8-11e7-ae36-fa163eb51d35 Master_Info_File: /data/mysql/master .info SQL_Delay:0 SQL_Remaining_Delay:NULL Slave_SQL_Running_State:Slavehas read allrelaylog;waiting for theslaveI /O threadtoupdateit Master_Retry_Count:86400 Master_Bind: Last_IO_Error_Timestamp: Last_SQL_Error_Timestamp: Master_SSL_Crl: Master_SSL_Crlpath: Retrieved_Gtid_Set: Executed_Gtid_Set: Auto_Position:0 1row in set (0.00sec) ERROR: Noqueryspecified 7、主设备解锁 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 [root@plinuxosmysql] #/usr/local/mysql/bin/mysql-uroot WelcometotheMySQLmonitor.Commandsendwith;or\g. YourMySQLconnection id is875 Serverversion:5.6.35-logMySQLCommunityServer(GPL) Copyright(c)2000,2016,Oracleand /or itsaffiliates.Allrightsreserved. OracleisaregisteredtrademarkofOracleCorporationand /or its affiliates.Othernamesmaybetrademarksoftheirrespective owners. Type 'help;' or '\h' for help.Type '\c' to clear thecurrentinputstatement. mysql>unlocktables; QueryOK,0rowsaffected(0.00sec) 测试主从同步 1、在主设备上删除db01数据库的表; 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 mysql>showtables; +----------------+ |Tables_in_db01| +----------------+ |comment| |link| |log| |lognav| |plugin| |tag| | type | |user| +----------------+ 8rows in set (0.00sec) mysql>droptabletag; QueryOK,0rowsaffected(0.01sec) 2、在从设备查看对应的表也已经不存在了。 1 2 3 4 5 6 7 8 9 10 11 12 13 mysql>showtables; +----------------+ |Tables_in_db01| +----------------+ |comment| |link| |log| |lognav| |plugin| | type | |user| +----------------+ 7rows in set (0.00sec) 扩展学习 ▎配置参数 1.主服务器上: binlog-do-db= //仅同步指定的库(其他库不同步) binlog-ignore-db= //忽略指定库(其他库都同步) 2.从服务器上: replicate_do_db= //(不常用) replicate_ignore_db= //(不常用) replicate_do_table= //(不常用) replicate_ignore_table= //(不常用) replicate_wild_do_table= //如aming.%, (支持通配符%) replicate_wild_ignore_table= 本文转自Grodd51CTO博客,原文链接:http://blog.51cto.com/juispan/1961233,如需转载请自行联系原作者

优秀的个人博客,低调大师

metaq架构原理

原创文章,转载请注明出处:http://jameswxx.iteye.com/blog/2034111 本来只是想看下metaq的文档,结果发现好乱,现在metaq其实有两个大分支了,一个是庄晓丹维护的已开源的,另外一个是淘宝内部的,本质结构原理没太大区别,只不过开源的已经去掉了对淘系相关的依赖。然后淘系的metaq已经到3.*版本了,但是文档比较乱,深入到细节时,发现好乱,一个点有好几种说法,火大,干脆自己看metaq的源码,有点意思,做个笔记记录下,怕我以后忘记了。有少量的章节和图片从内网拿来的,大部分是自己写的,记录下几个主要的点。 一:metaq是什么 metaq是一个分布式消息中间件,消息中间件是典型的生产者-消费者模型,核心作用是解耦,生产者和消费者彼此没有直接依赖,同步化解成了异步。metaq并没有遵循jms规范,jms规范体现在系统层面和api层面。 消费模型 例如jms定义了两种消息传递方式: 1 基于队列的点对点消费模型 2 基于发布/订阅的消费模型 Metaq只有发布订阅的消费方式。 消息类型 JMS定义的消息类型有TextMessage、MapMessage、BytesMessage、StreamMessage、ObjectMessage。Metaq只有一种类型:Message。 消息持久性 JMS定义两种持久性类型: PERSISTENT 指示JMS provider持久保存消息,以保证消息不会因为JMS provider的失败而丢失。 NON_PERSISTENT不要求JMS provider持久保存消息。 Metaq的消息都是持久性的 API JMS定义了消息中间件的生产端api和消费端api,这些api都是约定的接口,都都被metaq无视了。 二:一些概念 消息生产者 负责产生消息并发送消息到meta服务器 消息消费者 负责消息的消费,meta采用pull模型,由消费者主动从meta服务器拉取数据并解析成消息并消费 Topic 消息的主题,由用户定义并在服务端配置。producer发送消息到某个topic下,consumer从某个topic下消费消息 分区 同一个topic下面还分为多个分区,如meta-test这个topic我们可以分为10个分区,分别有两台服务器提供,那么可能每台服务器提供5个分 区,假设服务器分别为0和1,则所有分区为0-0、0-1、0-2、0-3、0-4、1-0、1-1、1-2、1-3、1-4 Message 消息,负载用户数据并在生产者、服务端和消费者之间传输 Broker 就是meta的服务端或者说服务器,在消息中间件中也通常称为broker。 消费者分组(Group) 消费者可以是多个消费者共同消费一个topic下的消息,每个消费者消费部分消息。这些消费者就组成一个分组,拥有同一个分组名称,通常也称为消费者集群 Offset 消息在broker上的每个分区都是组织成一个文件列表,消费者拉取数据需要知道数据在文件中的偏移量,这个偏移量就是所谓offset。Offset是绝对偏移量,服务器会将offset转化为具体文件的相对偏移量 三:总体结构图 四:消息存储 消息中间件中消息堆积是很常见,这要求broker具有消息存储的能力,消息存储结构决定了消息的读写性能,对整体性能有很大影响,metaq是分布式的,多个borker可以为一个topic提供服务,一个topic下的消息分散存储在多个broker,它们是多对多关系。 如下图 消息定义 id 消息的唯一id,系统自动产生,用户无法设置,在发送成功后由服务器返回,发送失败则为0。 topic 消息的主题,订阅者订阅该主题即可接收发送到该主题下的消息,必须 data 消息的有效载荷,也就是消息内容,meta永远不会修改消息内容,你发送出去是什么样子,接收到就是什么样子。 attribute 消息属性,一个字符串,可选。发送者可设置消息属性来让消费者过滤。 物理文件 metaq将消息存储在本地文件中,每个文件最大大小为1G,如果写入新的消息时,超过当前文件大小,则会自动新建一个文件。文件名称为起始字节大小,例如,假设文件最大尺寸为1k,有三个文件,则文件名如 下(长度为20位,不足补0): 00000000000000000000 00000000000000001024 00000000000000002048 即使一个broker为多个topic服务,这些topic的消息都存储同一个文件组中,消息顺序写入,永远都是当前文件在写,其他文件只读。 索引文件 弄清消息的物理存储后,也许我们会有一个疑问:如何读取指定topic的当前消息?的确,仅仅只存储消息是无法做到这个的,所以metaq还有索引文件,类似数据库的索引,但是有很大区别。broker将消息存储到文件后,会将该消息在文件的物理位置,消息大小,消息类型封装成一个固定大小的数据结构,暂且称这个数据结构为索引单元吧,大小固定为16k,消息在物理文件的位置称为offset。 索引单元结构 offset size messateType 8字节 4字节 4字节 多个索引单元组成了一个索引文件,索引文件默认固定大小为20M,和消息文件一样,文件名是 起始字节位置,写满后,产生一个新的文件。 逻辑分区 一个逻辑分区实际上是一组索引文件。一个topic在一个broker上可以有多个逻辑分区,默认为1,但可自由配置。为什么会有多个分区的情况?逻辑分区的作用不仅仅是通过索引提供快速定位消息的功能,它还跟整个metaq的集群有很大的关系。 逻辑结构图 五:集群与负载均衡 Topic分布 一个topic可以分布在多台broker上,具体体现就是多个broker配置了这个topic,并且最少有一个分区。假如有一个topic名为”t1”,两个broker:b1,b2;每个borker都为t1配置了两个分区。那么t1一共有4个分区:b1-1,b1-2,b2-1,b2-2。生产者和消费者对topic发布消息或消费消息时,目的地都是以分区为单位。当一个topic消息量逐渐变大时,可以将topic分布在更多的borker上。某个broker上的分区数越多,意味着该borker承担更繁重的任务,分区数可以认为是权重的表现形式。 生产者 生产者在通过zk获取分区列表之后,会按照brokerId和分区号的顺序排列组织成一个有序的分区列表,发送的时候按照从头到尾循环往复的方式选择一个分区来发送消息。这是默认的分区策略,考虑到我们的broker服务器软硬件配置基本一致,默认的轮询策略已然足够。如果你想实现自己的负载均衡策略,可以实现上文提到过的PartitionSelector接口,并在创建producer的时候传入即可。在broker因为重启或者故障等因素无法服务的时候,producer通过zookeeper会感知到这个变化,将失效的分区从列表中移除做到fail over。因为从故障到感知变化有一个延迟,可能在那一瞬间会有部分的消息发送失败。 消费者 消费者的负载均衡会相对复杂一些。我们这里讨论的是单个分组内的消费者集群的负载均衡,不同分组的负载均衡互不干扰,没有讨论的必要。 消费者的负载均衡跟topic的分区数目紧密相关,要考察几个场景。 首先是,单个分组内的消费者数目如果比总的分区数目多的话,则多出来的消费者不参与消费 其次,如果分组内的消费者数目比分区数目小,则有部分消费者要额外承担消息的消费任务,具体见示例图如下 六:文件读写 消息存储在文件中,如何保证性能?Metaq使用了文件内存映射特性,对应的是MappedByteBuffer对象。 MappedByteBuffer 只是一种特殊的 ByteBuffer ,即是ByteBuffer的子类。 MappedByteBuffer 将文件直接映射到内存(这里的内存指的是虚拟内存,并不是物理内存)。通常,可以映射整个文件,如果文件比较大的话可以分段进行映射, 只要指定文件的那个部分就可以。而且,与ByteBuffer十分类似,没有构造函数(你不可new MappedByteBuffer()来构造一个MappedByteBuffer),我们可以通过 java.nio.channels.FileChannel 的 map() 方法来获取 MappedByteBuffer 。其实说的通俗一点就是Map把文件的内容被映像到计算机虚拟内存的一块区域,这样就可以直接操作内存当中的数据而无需操作的时候每次都通过I/O去物理 硬盘读取文件,所以效率上有很大的提升。 映射方式 MappedByteBuffermap(intmode,longposition,longsize); 可以把文件的从position开始的size大小的区域映射为内存映像文件,mode指出了可访问该内存映像文件的方式: READ_ONLY,(只读) 试图修改将导致抛出异常 READ_WRITE(读/写) 对得到的缓冲区的更改最终将传播到文件;该更改对映射到同一文件的其他程序不一定是可见的。 PRIVATE(专用) 对得到的缓冲区的更改不会传播到文件,并且该更改对映射到同一文件的其他程序也不是可见的;相反,会创建缓冲区已修改部分的专用副本。 三个关键方法 fore() 缓冲区是READ_WRITE模式下,此方法对缓冲区内容的修改强行写入文件 load() 将缓冲区的内容载入内存,并返回该缓冲区的引用 isLoaded() 如果缓冲区的内容在物理内存中,则返回真,否则返回假 调用信道的map()方法后,即可将文件的某一部分或全部映射到内存中,映射内存缓冲区是个直接缓冲区,继承自ByteBuffer,但相对于ByteBuffer,它有更多的优点:a.读取快b.写入快c.随时随地写入 释放内存句柄 通过FileChannel.map方法可以得到一个MappedByteBuffer,但FileChannel没有提供unmap方法,FileChannel关闭后,不会释放映射的MappedByteBuffer。导致的问题是一个map过的文件关闭后,却无法将其删除。根据JAVADOC的说明,是在垃圾收集的时候.而众所周知垃圾收集是程序根本无法控制的,有个土方: Java代码 AccessController.doPrivileged(newPrivilegedAction(){ publicObjectrun(){ try{ MethodgetCleanerMethod=buffer.getClass().getMethod("cleaner",newClass[0]); getCleanerMethod.setAccessible(true); sun.misc.Cleanercleaner=(sun.misc.Cleaner) getCleanerMethod.invoke(byteBuffer,newObject[0]); cleaner.clean(); }catch(Exceptione){ e.printStackTrace(); } returnnull; } }); 如果希望更加高效地处理映射到内存中的文件,把文件的内容加载到物理内存中是一个好办法。通过MappedByteBuffer类的load方法可以把该缓冲区所对应的文件内容加载到物理内存中,以提高文件操作时的性能。由于物理内存的容量受限,不太可能直接把一个大文件的全部内容一次性地加载到物理内存中。可以每次只映射文件的部分内容,把这部分内容完全加载到物理内存中进行处理。完成处理之后,再映射其他部分的内容。由于I/O操作一般比较耗时,出于性能考虑,很多操作在操作系统内部都是使用缓存的。在程序中对MappedByteBuffer做的修改不一定会立即同步到文件 系统中。如果在没有同步之前发生了程序错误,可能导致所做的修改丢失。因此,在执行完某些重要文件内容的更新操作之后,应该调用MappedByteBuffer类 的force方法来强制要求把这些更新同步到底层文件中。可以强制同步的更新有两类,一类是文件的数据本身的更新,另一类是文件的元数据的更新。在使用 force方法时,可以通过参数来声明是否在同步数据的更新时也同步元数据的更新。 七:消息消费 metaq的消费模型不是生产端推送,而是消费端不停拉取。但是注意,不停拉取不是指消费端定时拉取,而是拉取完一批消息,消费完毕,再去拉取下一批。这里有实时性和吞吐量之间的矛盾,如果每次批量拉取的消息数量过少,会增加实时性,但是减少吞吐量;反之,如果每次批量拉取的消息数量过大,则实时性会打折扣,但吞吐量上升。由于metaq的消息存储结构,消费端拉取消息时,至少需要以下几个参数: 消息主题 逻辑队列序号 索引起始位置 消息最大长度 当前请求序列号 消费者分组名称 Metaq刚好也定义了这样的一个请求对象,刚好6个属性,分别对应前面所说的参数。 Java代码 publicclassGetCommand{ privatefinallongoffset; privatefinalintmaxSize; privatefinalintpartition; privatefinalStringgroup; privateIntegeropaque; privateStringtopic; …… } 根据topic和partition找到逻辑队列:A 根据offset从A定位指定的索引文件:B 从B中读取所有的索引数据:C 遍历C,根据索引单元的消息物理地址和消息长度,找到物理消息D,将D放入集合,并计算消息的累加长度,若大于请求里消息最大长度maxSize,则终止遍历,返回结果。 消息结果里有当前批次消息的索引读取结束位置(offset),消费端会将当前offset存储在本地,下次拉取消息时,要将结束位置作为参数放入消息拉取请求里。由于metaq是分布式结构,消费端和生产端的对应关系可能会经常变动,offset不能仅仅只是保存到本地,必须保存在一个共享的存储里,比如zookeeper,数据库,或共享的文件系统。默认情况下,metaq将offset及时保存在本地,并定时写入zookeeper。在某些情况下,会发生消息重复消费,比如某个consumer挂掉了,新的consumer将会接替它继续消费,但是offset是异步存储的,可能新的consumer起来后,从zookeeper上拿到的还是旧的offset,导致当前批次重复,产生重复消费。 八:可靠性保证 生产者可靠性保证 消息生产者发送消息后返回SendResult,如果isSuccess返回为true,则表示消息已经确认发送到服务器并被服务器接收存储。整个发送过程是一个同步的过程。保证消息送达服务器并返回结果。 服务器可靠性保证 消息生产者发送的消息,meta服务器收到后在做必要的校验和检查之后的第一件事就是写入磁盘,写入成功之后返回应答给生产者。因此,可以确认每条发送结果为成功的消息服务器都是写入磁盘的。 写入磁盘,不意味着数据落到磁盘设备上,毕竟我们还隔着一层os,os对写有缓冲。Meta有以下刷盘策略: 异步刷盘 每1000条(可配置),即强制调用一次force来写入磁盘设备。 每隔10秒(可配置),强制调用一次force来写入磁盘设备。 同步刷盘 此外,如果存储配置上的groupCommitEnable选项为true,则会在写入消息后,立即强制刷盘。 消费者可靠性保证 消费者是一条接着一条地消费消息,只有在成功消费一条消息后才会接着消费下一条。如果在消费某条消息失败(如异常),则会尝试重试消费这条消 息(默认最大5次),超过最大次数后仍然无法消费,则将消息存储在消费者的本地磁盘,由后台线程继续做重试。而主线程继续往后走,消费后续的消息。因此, 只有在MessageListener确认成功消费一条消息后,meta的消费者才会继续消费另一条消息。由此来保证消息的可靠消费。消费者的另一个可靠性的关键点是offset的存储,也就是拉取数据的偏移量。默认存储在zoopkeeper上,zookeeper通过集群来保证数据的安全性。Offset会定期保存,并且在每次重新负载均衡前都会强制保存一次,因此可能会存在极端情况下的消息的重复消费。 九:zookeeper存储结构 /meta/brokers/ids 描述broker的注册信息 假如有3个broker,id分别为m1,s1,s2,s1和s2是m1的slave(实际上这些id都是数字,不能有字母)。则结构为 /meta/brokers/ids/m1/master /meta/brokers/ids/m1/slaves1 /meta/brokers/ids/m1/slaves2 m1是master brokerid,如果根据m1找master brokerid,只需判断m1/master是否存在。如果寻找m1的slave,只需找到m1下的3个节点,比对节点名称是否以"slave"字符串开头,若是,则截取slave id加入到slave节点集合。 /meta/brokers/topics 这个结构稍微有些复杂,还是举例说明吧。假如有以下broker信息:master m1,slave s1;master m2,slave s2;有一个topic名为”hello”,两组broker都配置了”hello”这个topic。则目录如下: /meta/brokers/topics/hello/m1-m /meta/brokers/topics/hello/m2-m /meta/brokers/topics/hello/s1-s /meta/brokers/topics/hello/s2-s -m表示master,-s表示slave,为什么要有这个结构呢?因为producer给某个topic推送消息时,需要知道哪些broker配置了该topic。 根据topic获取master或者slave,很简单,找到/meta/brokers/topics/hello的子目录名称,然后判断是否以-m或者-s结尾,分别归类为master和slave。不过拿到master或者slave的brokeid后,还需要按照brokeid检查broker是否存在。详情可以看MetaZookeeper的getMasterBrokersByTopic方法。 关于topic在broker上的分区信息,接着上面继续思考,仅仅知道哪些borker配置了某个topic还不够, 因为topic在一个broker上还有分区信息。假如hello这个topic在m1上有2个分区,可以认为 /meta/brokers/topics/hello是一个目录,/meta/brokers/topics/hello/m1-m是一个文件,那么hello这个 topic在m1上的分区信息就是文件里的数据了。 /meta/brokers/topics/hello/m1-m的数据是一个整数,某个topic在某个broker上的分区号是递增的,因此如果/meta/brokers/topics/hello/m1-m的数据为2,则表明hello在m1上的分区有2个。详情请看MetaZookeeper的getPartitionsForTopicsFromMaster方法。基于/meta/brokers/topics的结构,还可以查找某个broker发布了哪些topic。假如存在以下目录 /meta/brokers/topics/hello1/m1-m /meta/brokers/topics/hello1/m2-m /meta/brokers/topics/hello1/s1-s /meta/brokers/topics/hello1/s2-s /meta/brokers/topics/hello2/m1-m /meta/brokers/topics/hello2/m2-m /meta/brokers/topics/hello2/s1-s /meta/brokers/topics/hello2/s2-s 查找过程如下 找到/meta/brokers/topics的所有子目录,得到hello1和hello2,其实就是整个集群里有哪些topic。 遍历每个topic的子目录,例如hello1的子目录为m1-m,m2-m,s1-s,s2-s 遍历这些子目录,找到角色为master的brokerid是否和当前查找的brokerid一致,如果是,则将当前topic加入到指定brokerid发布的topic集合里。例如对于m1这个brokerid,输出是hello1,hello2。详情见getTopicsByBrokerIdFromMaster方法。 /meta/consumers/group/ids 存储某个分组的消费者注册信息,还有他们分别订阅了哪些topic。group是个变量,以消费者的实际分组为 准。假设有一个消费者分组名为“hellogroup”,该分组有两个消费者,id分别为"c1"和"c2",c1订阅了 topic "t1"和"t2",c3订阅了"t3"和"t4"。则存在以下两个节点: /meta/consumers/hellogroup/ids/hellogroup_c1 节点数据为“hello1,hello2” /meta/consumers/hellogroup/ids/hellogroup_c2 节点数据为"hello2,hello3" 消费者id的计算规则 consumerId=所属分组名称+“_”+consumerUUID 如果构建一个消费端时,配置里指定了consumerUUID,则以该consumerUUID为准,否则按照规则计算。见 ConsumerZookeeper的getConsumerUUID方法: Java代码 protectedStringgetConsumerUUID(finalConsumerConfigconsumerConfig)throwsException{ StringconsumerUUID=null; if(consumerConfig.getConsumerId()!=null){ consumerUUID=consumerConfig.getConsumerId(); }else{ consumerUUID= RemotingUtils.getLocalAddress()+"-"+System.currentTimeMillis()+"-" +this.counter.incrementAndGet(); } returnconsumerUUID; } /meta/consumers/group/standby group是一个变量,以实际消费者分组名称为准,这个比较简单,存储的是一个数字,假设为n,那么意思就是该分组的所有消费者都从第n个slave获取信息,禁止写入。默认情况下,该值为空,除非master挂掉,或者人工修改。有个问题待定:一个topic分布在多个broker上,每个broker的slave数量可能不一样,例如某个broker的slave数量1,但是n却为2。以此推测,这个配置可能是基于一个约定,就是每个broker的slave数量都是相同的。 /meta/consumers/group/offsets/topic 存储一个分组对某个topic不同分区的消费位置,group和topic是变量,以实际值为准,假如一个topic名称 为t1,部署在两台broker:b1,b2;每个broker有两个分区。则一共有4个分区:b1-1,b1-2,b2-1,b2-2。一个 消费者分组“hellogroup”消费了这个topic,b1-1,b1-2,b2-1,b2-2的消费位置分别是1,2,3,4;则有以下节点: /meta/consumers/hellogroup/offsets/t1/b1-1 数据为1 /meta/consumers/hellogroup/offsets/t1/b1-2 数据为2 /meta/consumers/hellogroup/offsets/t1/b2-1 数据为3 /meta/consumers/hellogroup/offsets/t1/b2-2 数据为4 /meta/consumers/group/owners/topic存储一个分组内,某个topic不同分区被哪个消费者消费了,group和topic是变量,以实际值为准。假如一个topic名称为t1,部署在1台broker:b1;b1有两个分区。则分区id为:b1-1,b1-2。一个分组“hellogroup 消费了这个topic,消费者id分别为c1,c2;c1消费了b1-1,c2消费了b1-2,则有以下节点: /meta/consumers/hellogroup/owners/t1/b1-1 数据为c1 /meta/consumers/hellogroup/owners/t1/b1-2 数据为c2 十:通信框架 使用淘宝内部一个基于nio的通信框架gecko,类似tbremoting。实现方式和api使用都是类似的。不同的是tbremoting默认基于mina实现,而gecko全都是自己实现的。与tbremoting一样,gecko也是基于Handler机制,向上提供request/processor方式进行业务处理。有关mina的资料介绍非常多,有兴趣可自己学习下,这里不做深入介绍。Gecko的hander定义和mina很像。 Java代码 publicinterfaceHandler{ voidonSessionCreated(Sessionsession); voidonSessionStarted(Sessionsession); voidonSessionClosed(Sessionsession); voidonMessageReceived(Sessionsession,Objectmsg); voidonMessageSent(Sessionsession,Objectmsg); voidonExceptionCaught(Sessionsession,Throwablethrowable); voidonSessionExpired(Sessionsession); voidonSessionIdle(Sessionsession); voidonSessionConnected(Sessionsession,Object...args); } 关注void onMessageReceived(Session session, Object msg);当服务端或客户端收到消息后,就会触发这个方法。Session为当前网络连接,msg为收到的信息,网络中传输二进制数据,类似mina,在过滤器链中,二进制数据与java对象之间会互相编码解码,不需要应用层关心。gecko包装了handler,对外只提供request/processor处理方式,意思是对于不同类型请求用相应的处理器处理。事实上onMessageReceived方法收到的msg只有两种对象:RequestCommand和ResponseCommand。分别代表了请求和响应。 Java代码 voidonMessageReceived(Sessionsession,Objectmsg){ …… if(messageinstanceofRequestCommand){ this.processRequest(session,message,defaultConnection); }elseif(messageinstanceofResponseCommand){ this.processResponse(message,defaultConnection); } …… } 看看MetaMorphosisBroker的registerProcessors()就知道了。摘录片段如下: Java代码 this.remotingServer.registerProcessor(GetCommand.class,newGetProcessor(this.brokerProcessor, this.executorsManager.getGetExecutor())); this.remotingServer.registerProcessor(PutCommand.class,newPutProcessor(this.brokerProcessor, this.executorsManager.getUnOrderedPutExecutor())); this.remotingServer.registerProcessor(OffsetCommand.class,newOffsetProcessor(this.brokerProcessor, this.executorsManager.getGetExecutor())); 以下是对应关系(不是全部的),实际上,不同的request都有对应的通讯协议 GetCommand.class/GetProcessor; PutCommand.class/PutProcessor; OffsetCommand.class/OffsetProcessor 十一:通信协议 Meta的协议是基于文本行的协议,类似memcached的文本协议。通用的协议格式如下 command params opaque\r\n body 其中command为协议命令,params为参数列表,而opaque为协议的序列号,用于请求和应答的映射。客户端发送协议的时候需要自增此序列号, 而服务端将拷贝来自客户端的序列号并作为应答的序列号返回,客户端可根据应答的序列号将应答和请求对应起来。body为协议体,可选,在协议头里需要有字 段指名body长度 Put命令 参数 topic partition value-length flag [transactionKey] 说明 发送消息协议,topic为发送的消息主题,partition为发送的目的分区,value-length为发送的消息体长度,flag为消息标识位,transactionKey为事务标识符,可选。 示例 put meta-test 0 5 0 1\r\nhello get命令参数 topic group partition offset maxSize 说明 消费者拉取消息协议,topic为拉取的消息主题,group为消费者分组名称,partition为拉取的目的分区,offset为拉取的起始偏移量,maxSize为本次拉取的最大数据量大小 示例 get meta-test example 0 1024 512 1\r\n data命令 参数 total-length 说明 get请求返回的应答,total-length返回的数据长度 示例 data 5 1\r\nhello result命令 参数 code length 说明 通用应答协议,如返回请求结果。code为应答状态码,采用与HTTP应答状态码一样的语义。length为协议体长度 示例 result 200 0 1\r\n offset命令 参数 topic group partition offset 说明 查询离某个offset的最近有效的offset,topic为查询的消息主题,group为消费者分组名称,partition为查询的分区,offset为查询的offset 示例 offset meta-test example 0 1024 1\r\n stats命令 参数 item(可选) 说明 查询服务器的统计情况,item为查询的项目名称,如realtime(实时统计),具体的某个topic等,可以为空 示例 stats 1\r\n 十二:异步复制 Meta的HA(High Availability)提供了在某些Broker出现故障时继续工作而不影响消息服务的可用性;跟HA关系紧密的就是Failover,当故障 Server恢复时能重新加入Cluster处理请求,这个过程对消息服务的使用者是透明的。Meta基于Master/Slave实现HA,Slave 以作为Master的订阅者(consumer)来跟踪消息记录,当消息发送到Master时候,Slave会定时的获取此消息记录,并存储在自己的 Store实现上;当Master出现故障无法继续使用了,消息还会在Slave上Backup的记录。这种方式不影响原有的消息的记录,一旦 master记录成功,就返回成功,不用等待在slave上是否记录;正因如此,slave和master还有稍微一点的时间差异,在Master出故障 那一瞬间,或许有最新产生的消息,就无法同步到slave;另外Slave可以作为Consumer的服务提供者,意思就是如果要写入必须通过 Master,消费时候可以从Slave上直接获取。 Failover机制采用client端方式,Master和Slave都需要注册到ZK上,一旦Master无法使用,客户端可使用与之对应的Slave;当Master的故障恢复时候,这时候有两种方式处理: 原来的master变成Slave,Slave变成Master;恢复故障的broker作为slave去之前的Slave同步消息。优点简单,但是需要slave和Master有一样的配置和处理能力,这样就能取代Master的位置。(目前Meta采用此方式) 需要自动把请求重新转移回恢复的Master。实现复杂,需要再次把最新的消息从Slave复制会Master,在复制期间还要考虑处理最新的消息服务(Producer可以暂存消息在本地,等复制成功后再和Broker交互)。 十三:分布式事务 metaq提供分了布式事务的功能,说起分布式事务,就不能不提及XA。X/Open 组织定义了分布式事务处理模型。 X/Open DTP 模型包括 应用程序( AP ) 事务管理器( TM ) 资源管理器( RM ) 通信资源管理器( CRM ) 一般,常见的资源管理器( RM )是数据库,常见的通信资源管理器( CRM )是消息中间件。 X/Open DTP 模型 二阶段提交示意图 XA与JTA的关系 XA是一个规范,JTA也是一个规范,其实这两个规范是一样的,只不过XA跟语言无关,而JTA是java版的规范,进一步细化了XA规范,定义了明确清晰的接口。 JTA的主要接口 UserTransaction 面向应用程序的接口,控制事务的开始、挂起、提交、回滚等 begin() 开始一个分布式事务,(在后台 TransactionManager 会创建一个 Transaction 事务对象并把此对象通过 ThreadLocale关联到当前线程上 ) commit() 提交事务(在后台 TransactionManager 会从当前线程下取出事务对象并把此对象所代表的事务提交) rollback() 回滚事务(在后台 TransactionManager 会从当前线程下取出事务对象并把此对象所代表的事务回滚) ugetStatus() 返回关联到当前线程的分布式事务的状态 usetRollbackOnly() 标识关联到当前线程的分布式事务将被回滚 Transaction 代表一个物理意义上的事务,UserTransaction 接口中的 commit()、rollback(),getStatus() 等方法都将最终委托给 Transaction 类的对应方法执行。 commit() 提交事务 rollback() 回滚事务 setRollbackOnly() 标识关联到当前线程的分布式事务将被回滚 getStatus() 返回关联到当前线程的分布式事务的状态 enListResource(XAResource xaRes, int flag) 将事务资源加入到当前的事务中 udelistResourc(XAResource xaRes, int flag) 将事务资源从当前事务中删除 uregisterSynchronization(Synchronization sync) 回调接口,在事务完成时得到通知从而触发一些处理工作。当事务成功提交后,回调程序将被激活。 TransactionManager 不承担实际事务处理功能,是用户接口和实现接口的桥梁。调用 UserTransaction.begin() 方法时 TransactionManager 会创建一个 Transaction 对象,并把此对象关联到当前线程上;同样 UserTransaction.commit() 会调用 TransactionManager.commit(),方法将从当前线程下取出事务对象 Transaction 并提交, 即调用 Transaction.commit()。 begin() 开始事务 commit() 提交事务 rollback() 回滚事务 getStatus() 返回当前事务状态 setRollbackOnly() getTransaction() 返回关联到当前线程的事务 setTransactionTimeout(int seconds) 设置事务超时时间 resume(Transaction tobj) 继续当前线程关联的事务 suspend() 挂起当前线程关联的事务 XAResource 这是一个非常重要的接口,是对底层事务资源的抽象,定义了分布式事务处理过程中事务管理器和资源管理器之间的协议。 commit() 提交事务 isSameRM(XAResource xares) 检查当前的 XAResource 与参数是否同一事务资源 prepare() 通知资源管理器准备事务的提交工作 rollback() 通知资源管理器回滚事务 消息提交和回滚 我们熟悉了前面的一些概念,分布式事务模型中有几个角色。metaq和数据库一样其实是一个RM,不过它没有遵守JMS的分布式事务标准,它对外呈现的就是一个XAResource。可以粗略的讲,只有数据可能会发生修改,才需要事务来保证数据的完整性,如果只是读取数据,则不需要事务,因为事务需要成本(数据库读取数据也会有事务的,这个原因有很多方面,比如事务的隔离和MVCC )。所以,metaq的事务主要发生在生产者,一个典型的场景示例如下: 应用程序向数据库写入一条记录 然后向metaq写入一条消息 然后再向数据库写入一条日志 如果日志写入失败,则前面步骤全部回滚 如果日志写入成功,则前面步骤全部提交 如果metaq调用处于分布式事务,则调用方式如下 Java代码 XAMessageSessionFactoryxaSF=newXAMetaMessageSessionFactory(newMetaClientConfig()); XAMessageProducerxaProducer=xaSF.createXAProducer(); XAResourcemetaXares=producer.getXAResource(); /** *加入JTA事务该接口最终会调用XAResource.start方法,即metaXares.start(Xid,int)方法, *把该资源加入当前事务当中,发送一个带XID的事务命定,通知Metaq启动一个全局事务 *分支,用XID标示该全局事务。 */ tx.enlistResource(metaXares); //事务中的业务操作向metaserver发送一条消息 Stringmessage="helloworld!"; Stringtopic="meta-test"; producer.sendMessage(newMessage(topic,messate.getBytes()); 看看两阶段提交和XAResouce,XAMessageProducer的getXAResource()方法可得到一个TransactionContext对象,实现了XAResource接口。通过UserTransaction. enListResource(XAResource xaRes, intflag)方法将当前XAResource加入到分布式事务里时,XAResource的start方法将被调用。Start方法向metaq的broker发送一个事务开始的命令,表示后续的操作都在分布式服务里,这些操作要暂存是事务文件里,不能直接写到消息队列里。ransactionContext有prepare()和commit()方法,这两个方法对应着分布式事务提交的两个阶段。prepare阶段,metaq只是将生产者发送的消息暂存在本地的事务日志里,其实就是一个文件,commit阶段才会从事务暂存文件里提取消息,写入到消息队列。

优秀的个人博客,低调大师

vue项目架构

一、工程说明: 1.代码git仓库地址:git@gitlab.*****.git。 2.目录结构: 1>.index.html 为build打包发布网页入口; 2>.lieda文件夹代码项目工程目录; 3>.static为build打包发布网页入口访问资源; 注意:不是发布勿动index.html和static文件,勿在该层级目录下引入任何资源 3.开发打开leida项目工程进行开发。 4.git中test分支为测试环境;master为线上环境分支; 二、工程注意事项: 1.拉下分支更新资源文件:cnpm install 2.接入第三方库(在package.json—>dependencies中添加可省去此步骤): 1>.Mint-ui H5开发快速集成组建; 2>.base64-js-codec加密; 3>.fastclick双击事件(地址:http://www.cnblogs.com/yexiaochai/p/3442220.html); 4>.font-awesome一套绝佳的图标字体库和css框架; 5>.js-cookie缓存; 6>. Lodash封装了诸多对字符串、数组、对象等常见数据类型的处理函数; 7>.normalize.css让所有的浏览器上对于未定义的样式浏览效果达到一致; 8>.promise异步操作,有三种状态:Pending(进行中)、Resolved(已完成,又称 Fulfilled)和 Rejected(已失败); 9>.store.js轻松实现本地缓存(地址:http://www.cnblogs.com/lhb25/p/store-js-for-localstorage.html); 10>.vue-router路由跳转; 11>.animate.css动画; 12>.vue; 三、工程目录结构: 1.src问开发中文件目录, 下: apis文件夹(所有的网络请求文件) —>根据不同需求功能建立不同的文件夹例如:advert文件夹; —>utils文件夹网络底层请求封装; assets文件夹:放图片资源, —>下根据不同的页面新建不同的文件夹再放入资源图片; components文件夹:公用封装组建, —>根据功能划分新建功能文件夹然后新建组建; filters文件夹:处理业务显示js文件,例如(处理职位类型,公司规模,时间显示的js文件): export let genderRequired = function(id){ if(id==0){ return "不限" }else if(id==1){ return "男士优先" }else if(id==2){ return "女士优先" }else{ return ""; } } routers:路由配置文件; views:页面代码文件 —>根据不同的业务建立文件夹! styles:不同的css样式封装; 四、打包发布流程; 1.测试域名为:lie*****.com 对应的分支为test; 2.线上域名为:暂时没配置 对应的分支为master; 3.npm run build 等待生成dist文件(dist文件为打包之后的文件资源包); 4.替换一级目录下的index.html文件和static文件夹; 5.上传打包后代码到git上test分支; 6.进入ci.*****.com网页发布 —>前端发布(测试环境)—>***.h5项目—>立即构建

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册