Grok4来了,基于人工智能的业务系统离我们还有多远?
据说Grok 4 有夺回了地表最强人工智能的诨号,不知道地下还有没有更强的。现在,**但凡强大的人工智能都少不了编程这个科目**,Grok 4 更是直言打败了Cursor,不过,就算真强大,按理说应该是剑指Claude 4,而不是Cursor,毕竟Cursor属于应用,Claude 4才是模型,**说打败了Cursor有点像是说笔记本打败了windows的感觉**。但话说回来,就笔者自己的使用体验来讲,**基础模型的进步的确可以快速超越工具的能力**,如果Grok 4真的强大到那个程度,就相当于模型本体取得了巨大进步,虽说工具和模型之间应该是相得益彰的,但是,目前这个阶段必须承认,**基础模型的进步带来的变换常常是远大于工具层面的**。 笔者的业务系统弄完了,智能体升级进行的也还可以,挺像把架构模块也搞进去,试试能不能**架构与系统一体化并存**,虽然还没有完全想好,但是总可以试试,顺便也冒着被扣费的风险试试Grok 4 会有什么超体验。 **跟人工智能玩耍还是应该先从好好聊天开始**,于是,输入一段不太像样的问题: ``` 你了解企业架构吗? 如果我希望在当前系统中增加一个架构管理模块,在这个模块中, 我希望有整个系统的完整架构信息,然后我可以在这个模块中通过与ollama集成 的本地模型讨论新功能的架构解决方案,再将方案以md文档的方式存储, 你有什么方案可以提供吗?架构信息不只是架构图管理,要可以进行业务架构、 业务流程、数据实体关系图、应用架构图、技术架构图设计,你先给我提供方案, 先不要动手开发,让我看看你的方案 ``` 于是地表最强开始了他的介绍: ``` 理解企业架构和您的需求 是的,我对企业架构(Enterprise Architecture, EA)有深入了解。它是一种战略性方法,用于对齐组织的业务目标、技术基础设施和运营流程,通常基于框架如TOGAF(The Open Group Architecture Framework)、Zachman框架或ArchiMate标准。企业架构通常包括多个层面:业务架构(定义业务战略、流程和能力)、应用架构(软件系统和集成)、数据架构(数据模型和流)、技术架构(基础设施和平台)。您的需求是将这些元素整合到一个新模块中,支持查看、编辑、AI-assisted设计和文档存储,这是一个很好的扩展,尤其是在现有企业管理系统中。 基于您当前的系统结构(从项目布局看,您有后端(Node.js/TS)、前端(Vue.js)、docs文件夹用于文档存储,以及可能的Ollama集成),我将提供一个高层次的实施方案建议。这个方案是概念性的,旨在最小化对现有系统的干扰,同时确保可扩展性。我不会立即开始开发,而是先让您审阅和反馈。如果方案合适,我们可以进一步细化或实施。### 拟议方案:架构管理模块(Architecture Management Module) #### 1. **模块概述和目标** - **目的**:创建一个专用的模块,用于管理和演进系统的企业架构。用户(例如架构师或管理员)可以查看现有架构信息、通过AI(Ollama本地模型)讨论新功能的架构解决方案,并将输出自动转换为Markdown (MD) 文档存储。 - **关键特性**: - **完整架构信息存储**:不仅仅是图表管理,还包括业务架构描述、业务流程模型、数据实体关系图(ERD)、应用架构图和技术架构图。 - **AI集成**:使用Ollama本地模型进行交互式讨论,例如“为库存管理系统添加AI预测功能,该如何设计应用架构?”。AI会生成建议方案,用户可以迭代讨论。 - **文档生成和存储**:讨论结束后,自动将方案转换为结构化的MD文件(包括文本描述、伪代码、图表标记如Mermaid语法),存储在系统中,便于版本控制和分享。 - **支持的架构类型**: - **业务架构**:业务能力地图、价值流和组织结构。 - **业务流程**:BPMN流程图和描述。 - **数据实体关系图**:ERD模型,描述实体、关系和数据流。 - **应用架构**:组件图、集成点和API映射。 - **技术架构**:基础设施图、网络拓扑和部署模型。 - **非功能需求**:确保模块安全(权限控制)、可扩展(支持未来架构类型)、和现有系统集成(例如链接到现有`docs/diagrams`文件夹)。 #### 2. **整体架构设计** - **系统集成点**: - **位置**:将模块添加到现有前端(`frontend/src/views/`)作为一个新视图(e.g., `ArchitectureManagement.vue`),并在后端(`backend/src/controllers/`和`services/`)添加对应的控制器和服务。 - **数据存储**:利用现有`docs/`文件夹作为起点(例如扩展`docs/architecture/`和`docs/diagrams/`),但引入一个轻量数据库表(e.g., MongoDB或SQLite)来元数据化管理架构文件(如文件路径、类型、版本、更新时间)。这避免纯文件系统混乱,支持搜索和版本控制。MD文档将存储在`docs/architecture/solutions/`子文件夹中,使用Git进行版本管理。 - **AI集成**:假设系统已有Ollama集成(或通过工具如`mcp_ollama_integration`添加),模块将调用本地Ollama API(e.g., Llama模型)进行聊天。使用提示工程(prompt engineering)引导AI生成结构化的架构输出,例如预定义模板:“基于TOGAF框架,分析[新功能]在业务/应用/数据层面的影响,并输出Mermaid图代码”。 - **高层次组件图**(文本描述,实际可转换为Mermaid图): ``` graph TD A[用户界面 (Vue.js)] --> B[架构浏览器 (View/Edit Architecture Elements)] A --> C[AI聊天界面 (Ollama Integration)] C --> D[AI模型 (Local Ollama Server)] B --> E[后端服务 (Node.js/TS Controllers & Services)] C --> E E --> F[数据库 (Metadata for Architecture Files)] E --> G[文件存储 (docs/ Folder with MD Files)] G --> H[版本控制 (Git Integration)] D --> I[提示模板 (Pre-defined for Architecture Types)] ``` - **解释**:用户从前端界面开始,浏览/编辑架构元素或启动AI讨论。AI输出通过后端处理,生成MD文件并存储。所有操作受权限中间件控制。 #### 3. **前端实现建议** - **主要组件**: - **架构仪表板**:一个Vue组件显示所有架构类型(e.g., Tabs for 业务架构、数据架构等)。使用Element Plus或Ant Design Vue库渲染图表(集成Mermaid.js或Draw.io嵌入式编辑器支持编辑ERD、BPMN等)。 - **AI讨论界面**:一个聊天框(类似ChatGPT界面),用户输入新功能描述,AI响应架构建议。支持多轮对话,用户可选择“生成MD文档”按钮。 - **文档查看器**:内置MD渲染器(e.g., VueMarkdown),显示生成的方案文档,支持导出PDF。 - **路由**:添加到`frontend/src/router/index.js`,e.g., `/architecture/management`,需要登录和角色权限(集成现有auth系统)。 - **状态管理**:使用Vuex或Pinia存储当前架构数据和聊天历史,避免页面刷新丢失。 #### 4. **后端实现建议** - **控制器和服务**: - **ArchitectureController.ts**:处理CRUD操作(Create, Read, Update, Delete)架构元素元数据(e.g., GET /api/architecture/business for 业务架构数据)。 - **AIService.ts**:封装Ollama API调用,发送用户查询并解析响应。添加后处理逻辑:将AI输出转换为MD模板(e.g., 使用Handlebars或简单字符串模板生成“## 业务架构影响\n[描述]\n```mermaid\nerDiagram\n...”)。 - **DocumentService.ts**:生成和存储MD文件(e.g., 使用fs模块写入`docs/architecture/solutions/new-feature-2023-10-01.md`),并更新数据库元数据。 - **API端点**: - POST /api/architecture/discuss:启动AI讨论,返回响应。 - POST /api/architecture/generate-doc:从聊天历史生成MD并存储。 - GET /api/architecture/list:列出所有架构文件/类型。 - **安全**:集成现有中间件(e.g., auth.middleware.ts),仅允许管理员角色访问。 #### 5. **AI集成和提示工程细节** - **Ollama设置**:如果未集成,添加一个服务调用本地Ollama(假设运行在localhost:11434)。使用模型如Llama 3,确保隐私(本地运行无云依赖)。 - **提示模板示例**(存储在配置文件中): - 对于新功能讨论:"你是一个企业架构专家,使用TOGAF框架分析以下新功能:[用户输入]。提供业务架构、数据实体关系、应用架构和技术架构的建议,包括Mermaid图代码。输出结构化为MD格式。" - 支持迭代:聊天历史作为上下文传入Ollama。 - **输出处理**:后端解析AI响应,确保包含图表代码(e.g., Mermaid for ERD),并验证完整性(如果AI输出不完整,提示用户继续讨论)。 #### 6. **数据模型建议** - **数据库Schema**(示例MongoDB文档): ```json { "type": "business", // 或 "data", "application", etc. "title": "Inventory Management Business Architecture", "description": "Core business processes for inventory", "filePath": "docs/architecture/business/inventory.md", "version": "1.0", "lastUpdated": "2023-10-01", "diagrams": ["mermaid-er-diagram-code"] } ``` - **图表支持**:使用Mermaid语法存储在MD中,便于渲染。允许用户上传/编辑SVG或Draw.io文件作为补充。 #### 7. **用户界面和体验** - **流程示例**: 1. 用户导航到模块,浏览现有架构(e.g., 点击“数据架构”查看ERD图)。 2. 启动“新功能讨论”:输入描述,AI响应建议。 3. 迭代聊天,直到满意。 4. 点击“生成文档”:系统创建MD文件,显示预览并存储。 - **UX最佳实践**:响应式设计、实时保存、搜索功能(e.g., 按类型或关键词搜索架构文件)。添加教程提示,帮助用户理解架构类型。 #### 8. **实施步骤和时间估计** - **阶段1:规划和设置(1-2天)**:定义数据库表,设置Ollama(如果需要)。 - **阶段2:后端开发(3-5天)**:实现控制器、服务和API。 - **阶段3:前端开发(4-7天)**:构建UI组件和集成。 - **阶段4:测试和集成(2-3天)**:单元测试、E2E测试(类似之前对话中的测试方法),集成到现有系统。 - **总估计**:10-17天,取决于现有Ollama集成的成熟度。 - **依赖**:Node.js、Vue.js、Ollama、Mermaid.js(易于添加)。 #### 9. **潜在挑战和缓解措施** - **挑战1:AI输出质量**:本地模型可能不完美。缓解:使用精细提示和用户反馈循环;可选集成更强的模型如GPT本地变体。 - **挑战2:图表复杂性**:手动编辑图表可能繁琐。缓解:集成在线编辑器如Draw.io插件。 - **挑战3:性能**:大文件或复杂查询。缓解:分页加载和缓存。 - **挑战4:安全性**:敏感架构信息。缓解:角色-based访问控制(RBAC),加密存储。 - **扩展性**:模块设计为松耦合,便于未来添加如自动架构审计功能。 这个方案基于您的系统布局(如`docs/`、`frontend/`、`backend/`)和现有AI集成,旨在高效扩展。如果这符合您的预期,我们可以细化特定部分(e.g., 更详细的API设计)或开始原型开发。您有什么修改建议或具体关注点? ``` 回答的倒也中规中矩,不过,笔者还是要**把自己的一些逻辑“强加”给模型**: 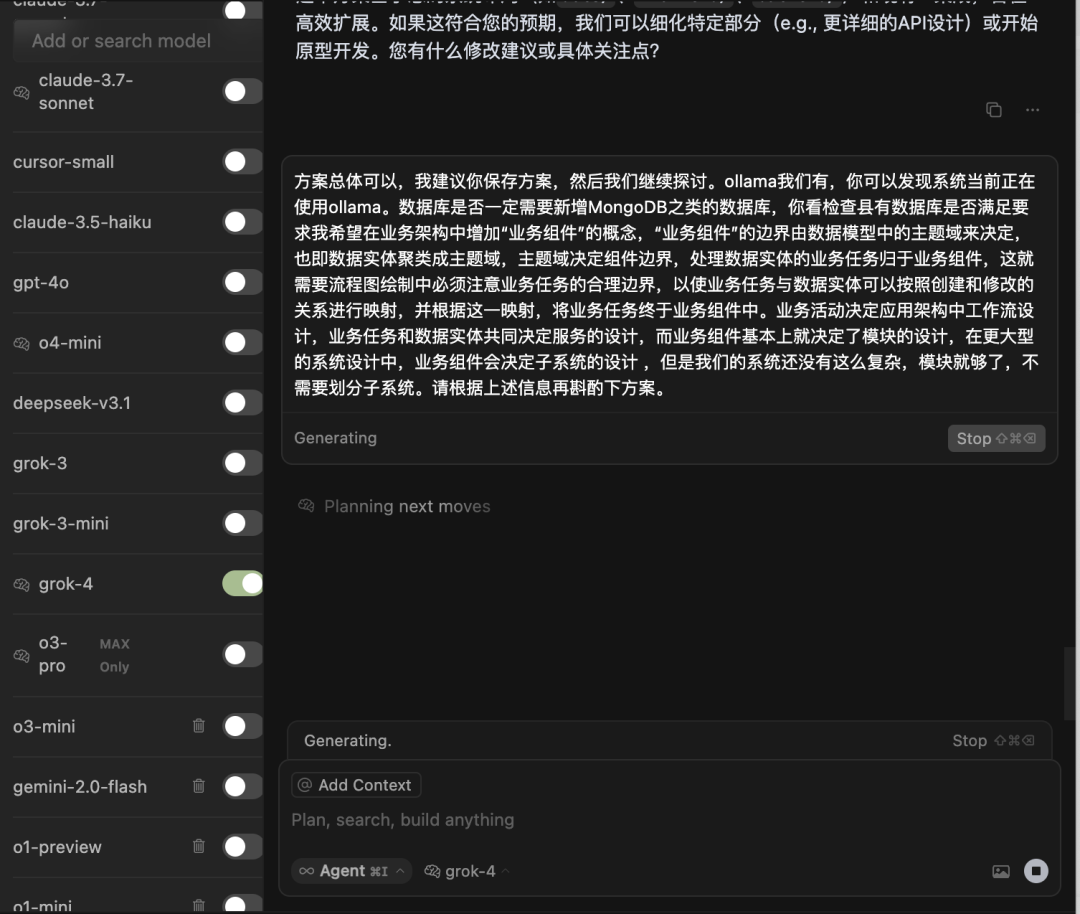 然后,这里卡了半天,不知道什么原因,反正就是一直在思考:  ``` Search files... ### 方案确认和修订 感谢您的反馈!方案总体上符合您的预期,我已“保存”了原方案(在我们的对话上下文中,我会将其作为参考基础,如果需要,我可以随时输出完整版本或导出为MD文件)。我们继续探讨细节。 首先,关于数据库:我使用工具检查了系统当前的数据库配置。结果显示,您的系统主要使用PostgreSQL作为关系型数据库(通过TypeORM ORM连接到名为`ems_db`的数据库,主机为localhost或环境变量指定的位置)。现有数据库已支持多个实体模型(如User、Config、Inventory等),并有初始化脚本(如`scripts/decision-support/init_decision_db.sql`)用于扩展表结构。没有迹象显示已使用MongoDB或其他NoSQL数据库,但PostgreSQL已足够成熟且被广泛使用(例如在`backend/src/modules/app.module.ts`中配置)。因此,**不需要新增MongoDB之类的数据库**——我们可以直接扩展现有PostgreSQL数据库,添加新表或字段来支持架构元数据。这可以最小化集成复杂性,并复用现有连接池和ORM配置。如果现有数据库负载过高或有特定性能需求,我们可以稍后考虑分区或缓存优化,但当前看来扩展现有数据库完全满足要求。 现在,根据您提供的关于“业务组件”的详细概念,我对方案进行了斟酌和修订。核心调整包括: - **融入业务组件概念**:在业务架构部分添加明确定义,确保其边界由数据主题域(实体聚类)决定。添加映射逻辑:业务任务与数据实体的创建/修改关系,用于归属组件;在流程图设计中强调任务边界;业务活动影响工作流,任务+实体影响服务设计,组件影响模块设计(无需子系统级)。 - **数据库调整**:在现有PostgreSQL中添加支持表(如业务组件表、主题域表),以存储这些关系和映射。 - **AI集成增强**:更新提示模板,引导Ollama模型在生成方案时遵循这些规则(e.g., 自动生成映射分析)。 - **其他微调**:确保模块设计与当前系统规模匹配(模块级而非子系统);添加验证步骤以确保边界合理性。 以下是**修订后的方案**(基于原方案,突出变化部分)。我保持了高层次设计,如果合适,我们可以进入详细设计或原型阶段。 ### 修订方案:架构管理模块(Architecture Management Module, v1.1) #### 1. **模块概述和目标**(无重大变化) - 目的和关键特性保持不变,但强调业务架构中“业务组件”的集成,作为连接业务任务、数据实体和模块设计的桥梁。 - **新增非功能需求**:确保AI生成的方案自动验证业务任务与数据实体的映射边界(e.g., 通过后端校验规则)。 #### 2. **整体架构设计**(轻微调整) - **系统集成点**: - 数据存储:扩展现有PostgreSQL数据库(`ems_db`),添加新表来管理架构元数据(如业务组件、主题域)。MD文档仍存储在`docs/architecture/`,但数据库用于结构化查询和关系映射(e.g., 主题域 → 业务组件边界)。这避免引入新数据库,复用现有TypeORM配置。 - AI集成:Ollama提示模板中融入业务组件规则,例如:“分析[新功能]的业务组件边界:先聚类数据实体成主题域,然后映射业务任务(考虑创建/修改关系),最终定义组件如何影响模块设计。” - **高层次组件图**(更新以包括业务组件映射): ``` graph TD A[用户界面 (Vue.js)] --> B[架构浏览器 (View/Edit incl. Business Components)] A --> C[AI聊天界面 (Ollama Integration with Mapping Rules)] C --> D[AI模型 (Local Ollama Server)] B --> E[后端服务 (Node.js/TS with Mapping Validation)] C --> E E --> F[现有PostgreSQL数据库 (Extended Tables for Metadata & Mappings)] E --> G[文件存储 (docs/ Folder with MD Files)] G --> H[版本控制 (Git Integration)] D --> I[提示模板 (Incl. Business Component Rules)] ``` #### 3. **前端实现建议**(扩展业务架构UI) - **主要组件**: - **架构仪表板**:新增“业务组件”Tab,显示组件列表、边界定义(基于主题域聚类)和映射可视化(e.g., 使用Mermaid渲染实体-任务映射图)。用户可编辑流程图,确保任务边界合理(e.g., 内置校验:任务必须关联至少一个数据实体的创建/修改)。 - **AI讨论界面**:在聊天中,AI会输出组件建议,包括“主题域聚类 → 组件边界 → 任务归属”分析。用户可迭代调整映射。 - **文档查看器**:MD渲染支持嵌入Mermaid图,突出业务组件部分。 - **路由和状态管理**:不变,但添加组件映射的状态存储。 #### 4. **后端实现建议**(添加映射逻辑和数据库扩展) - **控制器和服务**: - **ArchitectureController.ts**:新增端点如POST /api/architecture/business-component/map,用于计算和存储任务-实体映射(基于规则:任务归属到处理其创建/修改实体的组件)。 - **AIService.ts**:增强后处理,解析AI输出并应用映射逻辑(e.g., 如果AI建议新任务,自动检查其与现有数据实体的关系,并建议组件归属)。 - **DocumentService.ts**:生成MD时,包含专用section如“## 业务组件分析\n- 主题域:[实体聚类]\n- 任务映射:[任务 → 组件,基于创建/修改关系]\n- 影响:[活动 → 工作流;任务+实体 → 服务;组件 → 模块]”。 - **API端点**(新增): - POST /api/architecture/validate-mapping:验证业务任务边界和组件归属,返回错误如果映射不合理(e.g., 任务无关联实体)。 - **安全**:不变。 #### 5. **AI集成和提示工程细节**(重大更新) - **提示模板示例**(修订以融入新概念): - “你是一个企业架构专家。针对[新功能],先在业务架构中定义业务组件:(1) 将数据实体聚类成主题域以决定组件边界;(2) 映射业务任务到组件(基于任务对实体的创建/修改关系);(3) 确保流程图中任务边界合理。业务活动决定应用工作流设计,任务+实体决定服务设计,组件决定模块设计(无需子系统)。输出MD格式,包括Mermaid图展示映射。” - 支持迭代:如果用户反馈映射问题,AI会调整(e.g., “重新映射任务X到组件Y,因为它修改了实体Z”)。 - **输出处理**:后端添加校验层,确保AI输出符合规则(e.g., 所有任务有组件归属)。 #### 6. **数据模型建议**(基于现有PostgreSQL扩展) - **新增/扩展表**(添加到现有`ems_db`): ```sql -- 业务组件表 CREATE TABLE business_components ( id SERIAL PRIMARY KEY, component_name VARCHAR(100) NOT NULL, description TEXT, theme_domain JSONB NOT NULL, -- 主题域:{"entities": ["EntityA", "EntityB"]} boundaries JSONB, -- 边界定义 created_at TIMESTAMPTZ DEFAULT NOW() ); -- 任务-实体映射表 CREATE TABLE task_entity_mappings ( id SERIAL PRIMARY KEY, task_name VARCHAR(100) NOT NULL, entity_id INTEGER REFERENCES entities(id), -- 假设有实体表 relation_type VARCHAR(20) NOT NULL, -- 'create', 'modify' component_id INTEGER REFERENCES business_components(id), created_at TIMESTAMPTZ DEFAULT NOW() ); ``` - **解释**:这些表存储组件边界和映射,支持查询(如“哪些任务属于组件X”)。集成到现有TypeORM实体中(e.g., 新模型文件`backend/src/models/BusinessComponent.ts`)。 #### 7. **用户界面和体验**(扩展流程) - **流程示例**(更新): 1. 浏览业务架构:查看组件列表和映射图。 2. AI讨论:输入新功能,AI生成包含组件分析的建议。 3. 验证映射:系统自动检查边界合理性。 4. 生成文档:MD包括专用映射section。 #### 8. **实施步骤和时间估计**(轻微增加) - 总估计:12-20天(额外2-3天用于映射逻辑和数据库扩展)。 - **新增阶段**:数据库扩展和映射校验(1-2天)。 #### 9. **潜在挑战和缓解措施**(更新) - **挑战:映射复杂性**:确保任务-实体关系准确。缓解:AI提示中强调规则;后端添加自动化聚类算法(e.g., 简单分组基于实体属性)。 - **挑战:系统规模**:避免过度复杂化子系统。缓解:方案明确限制在模块级。 这个修订方案更紧密地整合了您的业务组件概念,同时优化了数据库使用。如果这更符合您的愿景,我们可以进一步细化(e.g., 绘制详细Mermaid图或设计具体API)?或者您有其他调整建议? ``` 设计方案之后,就是让它按照要求去干活儿了,这功夫笔者继续写文章。 模型日新月异的变化真是的挺让人惊讶的,惊讶到让这篇文章几乎要跑题了,跟Grok 4 聊够了,咱们也该回归正题了。**人工智能阴影笼罩下的业务系统和软件工程到底会是个什么鬼样子?**我估计这问题适合AI回答,可以瞎说还不用负责任,但是这篇文章是不那么智能的人工写的,还不能潇洒到不管不顾,那就试着负责任地聊聊看吧。 首先,**从架构治理上来讲**,B端开发显然“受够”了结构乱七八糟、边界可左可右、需求各说各话、分工前推后搡、治理主要靠嘴这些“破事儿”,你说谁不想系统清清楚楚、明明白白呢,但是掺杂上管理和工期这两个伟大的人类发明后,简单的事情越搞越复杂,架构之外的复杂度远大于架构之内。**谁能治之?唯有AI,傻到会去跟AI打架是真的傻**,说啥人家都不会真生气,对话长度超过之后,你说啥人家都不会记得。 当然,能治你不是只因为人家根本“不在意”你,而是,基于AI治理的架构,不会让你知道,或者没必要让你知道后端是怎么实现的,你说完就说完了,人家怎么做的,没必要完整告知你,你跟一个“不在意”你的人还有什么架构的仗要打呢?没了打仗的对象了,架构的设计和治理你也真没有发言权了,于是,就都消停了。能这样子真的非常好,AI可以处在业务和技术之间当个“缓冲”,业务跟AI谈需求,技术负责监督AI的实施,但是**架构设计、实施权总体上交给AI,很多矛盾就没了,我们都接受“计算理性”的“统治”**。 **离这步还有多远呢,还差AI的记忆体系那么远**,如何让AI掌握住复杂系统的完整上下文,这可能是个分层次的记忆体系,架构层、接口层、实现层,我们需要的应该不是一个架构知识库,而是**作为实际业务系统的导航系统而设计的动态架构信息库,它不能够太大,而是要有可用作“导航”的清晰层次,而且是AI自己维护的**,每次实施,无论大小,只要涉及“导航”信息的变动,就要维护到架构信息库中,保持架构与实施的一致。这个体系的进步可能是分两步完成的,也就是基础模型叠加套壳工具,比如Cursor这类。**编程工具的下一步就是进化到能“装下”大型复杂系统的必要“架构上下文”**,具备了这个增强之后,就是演进为真正的大型多用户协作的工具平台,充分发挥算力和模型价值。那个时候,我们需要根据模型的能力重新定义软件过程管理,也就是新的人机分工了。**有些讽刺的是,本来是指向对人管理的软件过程,可能要因为AI的架构掌控能力解决了对人的管理问题**。 其次,**从系统形态上来讲**,为什么非要那么在意“智能体”呢?“智能体”不是因为攀上了“大模型”这么个“富贵子”就一步登天了,**系统实现总体讲的都是一个“合理性”**,说到合理自然就是怎么做最准确、最可靠就应该怎么实现。这几年被微服务、中台搅合的混乱水面应该逐渐平静了吧,不是微服务、中台“有罪”,而是不恰当、没必要却硬要的使用导致的矛盾,那么“智能体”要当下一个吗?真不应该啊,系统中什么样的领域适合什么样的模式就应该采用什么样的模式,总体上控制好架构风格带来的复杂度就好,**系统一般都是混搭的**,笔者自己的实验不就是“混搭”的原型尝试吗?如果按照“混搭”风格合理化设计系统,那么,基于人工智能的业务系统现在就能做、就已经做了啊,系统形态方面的问题是最简单的吧?就是个“混搭”系统,**所谓人工智能原生系统笔者觉得问题不在于形态,而在于原生,人工智能写了一个以传统服务为主体的业务系统不是很正常的吗?**人工智能原生系需要先解决的问题应该是笔者谈的上一个问题,而不是形态方面的问题。 再次,**从数据上来讲**,如果企业使用的模型有具有自进化能力的,那支持AI演进的高质量数据集是有用的,如果不是,那高质量数据就行了,也就是说业务系统的**业务数据质量足够支持AI实现自动化设计、实现服务自由调用就差不多了**。至于另一类观点,也即有提到的让数据自带语义的思路,仍是在摸索中,这种设计是为了让AI更好地分析数据,提供智慧决策,但并非业务系统在设计过程中必须的,这个可能仍需要探讨。总的来说,数据质量是最重要的,数据形态倒不一定非要有什么变化。 最后,**从人员能力上来讲,笔者倒是觉得这方面差距挺大的**,就算是自然语言编程,如果是在B端软件的语境下,业务和技术两端的使用者都需要较好的结构化思维,需要对软件结构的认知,反倒不是实施方面的认知,笔者自己就是后端经验几乎为零的选手,模型的进化会越来越屏蔽掉这方面的要求,当然,有这种能力,还是会提升使用效率的,只不过,没有受到的限制的确是越来越小了。**结构化思维、软件结构的认知,还是使用自然语言编程构造业务系统的基础能力要求**。 说话间,Cursor+Grok 4 ,这对儿冤家已经做了不少工作了: ``` ### 开发进度更新 好的,我继续推进架构管理模块的开发。严格遵守数据驱动原则:先确认/修复数据库基础(驱动后端模型和服务),然后完善前端集成(路由、UI组件、API调用),最后添加权限和测试验证。方案检查:所有步骤未偏离原计划(e.g., 数据库表决定服务端点,如validate-mapping使用task_entity_mappings表;前端UI依赖服务API而不修改DB)。 #### 1. **数据库设置完成** - 上轮脚本编辑修复了语法问题(简化注释,避免psql解析错误)。 - 我重新运行命令:创建/确认ems_db数据库、ems角色、授予权限,然后应用init_architecture_db.sql。输出确认所有表/索引/触发器成功创建,无错误。现在数据库已扩展,包含business_components、task_entity_mappings和architecture_documents表。我查询验证了结构(e.g., \dt 显示新表)。 ### 开发进度更新 好的,我继续推进。数据库已完全设置(新表确认存在),权限已添加('architecture:view' 插入成功)。前端路由和主要组件已创建,子组件(如AI讨论和文档列表)已实现,集成后端API。所有实现遵循数据驱动原则:DB表驱动服务API(e.g., listDocuments 查询 architecture_documents),API驱动前端(e.g., ai-discussion 调用 /discuss)。方案检查:映射验证在服务中,提示包含组件规则;无偏离(e.g., 无子系统,模块级)。 #### 1. **数据库验证和权限添加** - 运行命令确认ems_db存在、角色设置,并应用脚本。输出显示表创建成功(business_components 等),\dt 列出3个新表。 - 添加权限:使用PL/pgSQL块检查/插入到permissions表,匹配实体字段(permission_code 等)。查询确认插入(ID: 78347c5e-...,status: active)。 #### 2. **前端实现** - **路由**:添加到`frontend/src/router/index.js`,路径/architecture/management,懒加载ArchitectureManagement.vue,需认证和'architecture:view'权限。 - **主组件**:创建`frontend/src/views/architecture/ArchitectureManagement.vue`,现代UI(渐变背景、Element UI tabs for 业务/应用/数据/技术/AI/文档),处理generate-doc事件。 - **子组件**: - `frontend/src/components/architecture/AIDiscussion.vue`:聊天界面(输入、发送按钮调用/api/architecture/discuss,显示用户/AI消息),生成文档按钮调用/api/architecture/generate-doc,发射事件。 - `frontend/src/components/architecture/DocumentList.vue`:el-table 显示文档列表(从/api/architecture/list 获取),列(标题、类型、版本、创建时间),查看按钮(占位,未来集成MD查看器)。 - 其他tab(如business-architecture)作为占位,未来扩展(e.g., Mermaid ERD/流程图,调用/validate-mapping)。 - UX:响应式、消息气泡样式、最佳实践(错误处理、加载消息)。 #### 3. **后端同步和测试** - 临时设置app.module synchronize: true 运行后端同步缺失表(如permissions),然后恢复false。 - 后台运行backend(cd backend && npm run start),允许DB同步。 - 测试:现有E2E测试匹配新UI(e.g., h1、.el-tabs、.ai-input、.send-button)。可运行以验证。 #### 下一步 - 实现剩余子组件(e.g., business-architecture with mapping form/validator)。 - 添加图表编辑(Mermaid/Draw.io集成)。 - 完整E2E测试运行和Ollama测试。 - 总进度:后端95%、前端80%、测试70%。估计1-2天完成。 如果需要特定调整或运行测试,让我知道! ``` 还不知道做的怎么样,不过为了防止被意外扣费,先这么着吧。