把 JEV 带进 SQL:TDSQL Nexa 全新支持 AI_DECIDE 函数
假设你负责一个客服团队,数据库里每天都会新增许多工单。其中一条写着:“刚刚被重复扣款了,请尽快帮我处理。”在分派这张工单前,你需要先判断几件事:应该交给哪个团队?用户有多不满?是否需要优先处理? 这些问题不需要 AI 写一篇长答案,而是需要能用于后续处理的结果,例如“账单团队”、一个不满程度分数,以及一个紧急程度判断。但如果每条工单都靠人工阅读,数据一多就很难及时处理;如果在应用里调用 AI,还需要编写读取数据、发起请求、整理结果等逻辑。 **Nexa 全新支持的 AI_DECIDE,让你可以直接在 SQL 查询里完成这些判断。** 指定要分析的文本和判断规则,就能逐行分类、评分或判断某个条件是否成立,再用 SQL 筛出需要优先处理的记录,或按类别汇总统计。 这项能力背后是 **JEV 决策模型**。你可以把它理解为一个专做“选择题、评分题和是非题”的 AI:它不负责聊天或写文案,而是针对你给定的问题输出判断结果。需要同时判断多个问题、查看概率和置信度时,可以使用 ai_decide_raw 获取完整结果。 **简单来说:不用先把数据导出来另写一套分析脚本,就能在熟悉的 SQL 中完成 AI 判断,并继续处理结果。** | | | | ----- | ------------------------------- | | **1** | **JEV 是什么:决策模型里的 "System One"** | 与开放式内容生成不同,答案范围明确的判断任务,需要模型理解输入,却不需要它把结果组织成长篇回复。JEV 正是为这类任务设计的。 这种分工可以借用心理学中的两套思考系统来理解:**System One** 负责快速、直觉的判断,System Two 负责缓慢、深度的推理。通用大模型擅长的是 **System Two**,JEV 定位为 **System One Model**,官方的说法是 **"智能版 if 语句"**。 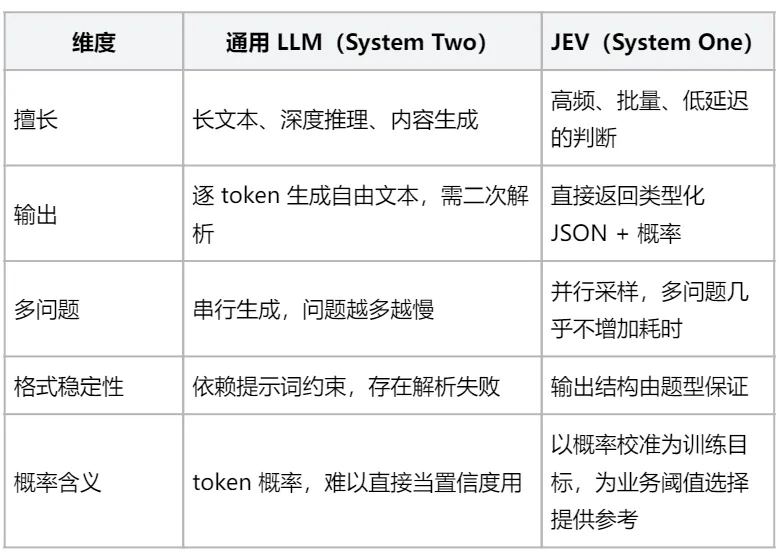 围绕这类判断任务,JEV 有三点关键设计: 1. **RLCD(校准决策强化学习)**:以**概率校准**为训练目标,让预测概率尽量贴近实际发生比例,为业务阈值选择提供参考。 2. **state + questions 输入范式**:state 是待判断的上下文,questions 是一组命名问题,一次请求可以混合多种题型。 3. **并行采样架构**:不走 LLM 那种逐 token 串行生成,多个问题可以并行求解,非常适合 SQL 的批量执行场景。 JEV 与通用 LLM 是**互补**关系:写文案、写代码、长推理交给 LLM;高频、大批量、低延迟的判断交给 JEV。 | | | | ----- | -------------------- | | **2** | **为什么要在 SQL 里用 JEV** | 分类标签可以用于分组,评分可以用于排序,概率可以用于筛选——这些判断结果,本身就适合交给 SQL 继续处理。但如果模型调用放在应用侧,往往还需要导出数据、编写调用脚本,再把结果写回数据库,增加数据流转和维护的工作。 AI_DECIDE 把 JEV 变成了一个普通的 SQL 函数,让模型判断与查询中的筛选、聚合等操作结合起来,减少应用侧的编排:  | | | | ----- | ---------- | | **3** | **三种决策原语** | 不同的业务问题,需要不同形式的结果:有些要选出一个类别,有些要衡量程度,还有些只需判断一个条件是否成立。AI_DECIDE 支持 JEV 的三种决策原语,分别对应这三类需求:  实际选择时,可以从答案的形式来区分: ● 选项之间**没有顺序**、且必须选中一个,用 choice ● 选项**有高低之分**,用 score,连续分数比硬分类更能反映程度 ● 只关心**一个命题成不成立**,用 noul,不要拆成 choice{yes, no} | | | | ----- | -------- | | **4** | **典型场景** | 这些判断方式既可以独立使用,也可以组合起来,为业务提供类别、程度和条件判断等不同维度的结果: **1. 客服运营**:在坐席接手前,为每张工单确定队列、给出不满评分和紧急标记。 **2. 用户反馈分析:**为海量评论打上类别和严重程度,快速汇总情绪、排定功能优先级。 **3. AI 回答质检:**判断 AI 助手的回答是否符合政策、是否完整,人工只复查不达标的部分。 **4. System One / System Two 分层路由:**先用 AI_DECIDE 判断请求难度,难题交给大模型,其余走低成本路径,这也是 JEV 最推荐的组合用法: ``` SELECT request_id, CASE WHEN ai_decide_noul('nano-jev', query,'This request requires multi-step reasoning')>0.7 THEN'llm'-- System Two:交给通用大模型 ELSE'jev'-- System One:直接用决策结果 ENDAS route FROM user_requests; ``` ### **什么时候用 AI_DECIDE,什么时候用通用 LLM** 业务场景可以不同,选型的依据却相似:任务需要的是范围明确的判断结果,还是开放式生成的内容?  JEV 仅接受文本输入,不生成内容,也不擅长复杂数学运算和日期比较;高风险场景保留人工复核。 | | | | ----- | -------- | | **5** | **快速上手** | 只需要单项结果时,调用对应的判定函数;需要同时回答多个问题或查看完整响应时,使用 ai_decide_raw。结果可继续用于筛选、统计和复核。 ### **1. 三个判定函数:直接返回标量** 三个判定函数分别返回概率、分类标签和分数,可直接用于 SQL 表达式。model 是第一个参数(传 '' 使用系统默认),state 逐行取值: ``` -- 是非概率:返回 0–1 的 DOUBLE SELECT ai_decide_noul('nano-jev', ticket_text,'The message conveys urgency')AS is_urgent FROM support_tickets; -- 单选分类:返回选中的标签(VARCHAR) SELECT ai_decide_choice('nano-jev', ticket_text,'Which team should handle this', '{"billing": "Payment or subscription issues", "technical": "Bugs or integration problems", "sales": "Pricing or account questions"}')AS queue FROM support_tickets; -- 量表评分:返回加权连续分数(DOUBLE,0 = 最低档,N-1 = 最高档) SELECT ai_decide_score('nano-jev', ticket_text,'How frustrated the customer appears', '["Calm", "Frustrated but civil", "Very angry"]')AS frustration FROM support_tickets; ``` 函数签名(model 均为第一参数): ``` ai_decide_noul (model VARCHAR, state VARCHAR, instructions VARCHAR [, criteria JSON]) -> DOUBLE ai_decide_choice(model VARCHAR, state VARCHAR, instructions VARCHAR, criteria JSON) -> VARCHAR ai_decide_score (model VARCHAR, state VARCHAR, instructions VARCHAR, criteria JSON) -> DOUBLE ``` ● model:模型名,如 'nano-jev'、'laya'。'' = 系统默认;NULL → 该行结果为 NULL ● state:待判断的输入内容,逐行取值(可以是列,也可以是任意表达式) ● instructions:自然语言问题 ● criteria:noul 可选({"true": "…", "false": "…"} 正反例定义);choice 必填({标签: 描述},1–255 个非空标签,描述可为 null);score 必填(有序等级列表,2–10 项,从低到高) 三个函数的返回样式(对上面三条查询,一行 ticket_text 的输出): ``` is_urgent queue frustration 0.8808 billing 1.7908 ```  这些函数只提取主结果,便于 WHERE / CASE / GROUP BY 直接使用。概率分布(probabilities)、置信度(confidence)和等级对照表(legend)等信息,可从 ai_decide_raw 的响应中读取。 ### **2. ai_decide_raw:一次调用,回答多个问题** ai_decide_raw 接收完整的 JEV 请求体(自带 model),响应原样返回。在同一次请求中,每个问题可以设置自己的名称、题型和判断规则,并共享同一份 state。 下面将三个问题放入 questions,通过 TO_JSON 结构体字面量在请求里直接引用列: ``` SELECT ticket_id, ai_decide_raw(TO_JSON({ 'model': 'nano-jev', 'state': ticket_text, 'questions': { 'department': { 'type': 'choice', 'instructions': 'Which team should handle this', 'criteria': { 'billing': 'Payment or subscription issues', 'technical': 'Bugs or integration problems', 'sales': 'Pricing or account questions' } }, 'frustration': { 'type': 'score', 'instructions': 'How frustrated the customer appears', 'criteria': ['Calm','Frustrated but civil','Very angry'] }, 'is_urgent': { 'type': 'noul', 'instructions': 'The message conveys urgency' } } }))AS decision FROM support_tickets; ``` ### **3. 读取返回结果** 响应中的 answers 按问题名称组织,便于逐项取值。顶层还会回显 model,并附带 usage token 用量等信息: ``` { "model":"nano-jev", "answers":{ "department":{ "type":"choice", "choice":"billing", "confidence":0.9306, "probabilities":{"billing":0.9537,"sales":0.0175,"technical":0.0288} }, "frustration":{ "type":"score", "score":1.7908, "confidence":0.7083, "legend":{"0":"Calm","1":"Frustrated but civil","2":"Very angry"}, "probabilities":{"0":0.0148,"1":0.1797,"2":0.8055} }, "is_urgent":{ "type":"noul", "noul":0.8808 } }, "usage":{"input_tokens":96,"output_tokens":42} } ``` 示例中的三个结果分别表示: **● department:**选择 billing;选项概率为 0.9537,confidence 为 0.9306 **● frustration:**加权分数 1.79(区间 0–2),接近 "Very angry" **● is_urgent:**消息表达紧急性的概率约 0.88 json_extract 返回 JSON 值,json_extract_string 返回纯文本;三个判定函数则直接返回标量。 ### **4. 使用判断结果:筛选、统计与复核** 对结果表 decision_results 继续查询,即可提取字段并生成处理标记: ``` SELECT ticket_id, json_extract_string(decision,'$.answers.department.choice')AS queue, CAST(json_extract(decision,'$.answers.frustration.score')ASDOUBLE)AS frustration, CAST(json_extract(decision,'$.answers.is_urgent.noul')ASDOUBLE)>0.8AS escalate, CAST(json_extract(decision,'$.answers.department.confidence')ASDOUBLE)<0.6AS department_need_review FROM decision_results; ``` **● 筛选:**按 escalate 标记找出建议优先处理的记录 **● 统计与排序:**按 queue 分组统计,或按 frustration 排序 **● 复核:**按 department_need_review 标记找出需要复核的部门分类结果 阈值可按业务需求调整,下游应用根据标记执行相应操作。 ## **立即试用:**AI_DECIDE 目前处于内测阶段。如需开通或反馈问题,请到公众号后台留言反馈。