一张 GPU 长时间被某个团队占用,可能是在运行在线模型,也可能只是测试环境没有释放。从资源台账上看,两者都是“已分配”;从业务角度看,它们需要完全不同的管理方式。
企业建设 GPU 资源池,应先记录任务,再决定如何分配硬件。训练、推理和开发测试的运行节奏不同,把任务区分开,才有依据决定哪些保留整卡、哪些验证共享、哪些可以到期回收。
从任务台账开始,而不是先设置切分比例
一份可执行的任务记录,至少应写明模型或程序、责任人、使用期限、运行环境及中断影响。缺少这些信息,运维团队很难判断某项资源是否能调整。
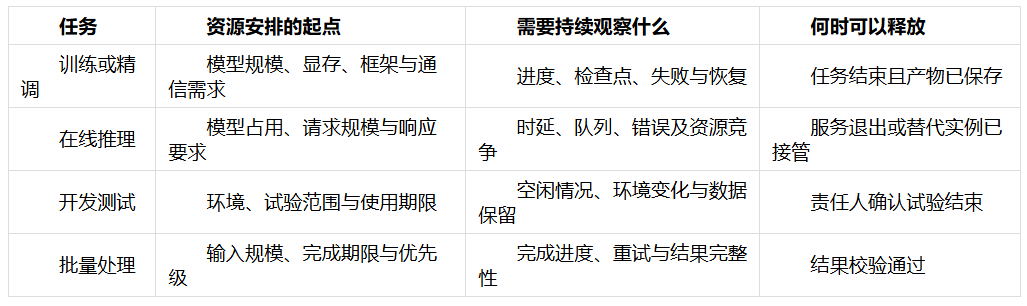
表中的释放条件可以先通过管理流程执行,不必等到所有步骤都实现自动化。先知道资源为什么保留、由谁确认释放,再把重复工作交给平台。
再决定任务运行在哪里、如何取得 GPU
虚拟机和容器描述运行环境;整卡分配、vGPU、dGPU 或容器显存切分描述特定环境下的资源使用方式。它们不应混为一个可以随意替换的功能列表。
以一个持续提供推理服务的模型为例,可以先在受支持配置上建立运行基线,确认其资源需求。只有当模型和运行方式支持、并行测试结果满足要求时,再考虑共享。对需要多卡协同的任务,还要把通信与网络条件纳入配置。
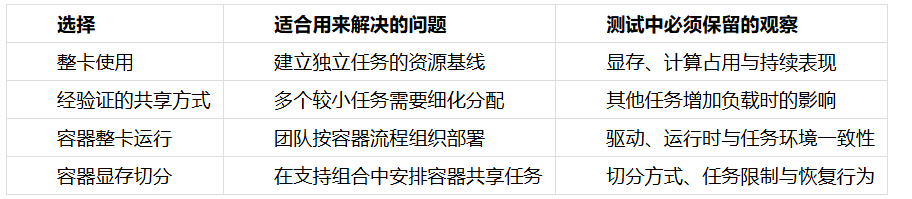
共享值得评估,但收益要通过任务表现证明。显存能够划分,不等于计算性能完全隔离,也不能直接换算成模型调用成本下降。
把一组模型任务放进 ZStack AIOS 试点
ZStack AIOS 公开手册区分物理 GPU、vGPU、dGPU 等模式。对资源池项目而言,这提供了按任务选择资源方式的基础;采购与试点需要继续核对具体模型支持。
本轮查阅的手册写明:AI 模型平台暂不支持使用 vGPU 部署推理服务和模型精调;dGPU 的模型任务支持也存在部署形式限制,包括多实例推理服务部署。容器显存切分则应按容器环境的说明确认,不能照搬虚拟机模式的结论。
据此,AIOS 试点可以采用“一个稳定服务加一个研发任务”的组合。稳定服务保持既定配置,研发任务验证申请、运行和释放过程。这样既检查模型能否运行,也检查平台如何服务不同使用者。
如果企业的本地 GPU 正分散在各团队手中,这种任务导向的试点比单纯展示资源总量更有价值:它能帮助确定哪些工作可交由平台管理,哪些仍要由模型和应用团队负责。
用三轮实验决定是否扩大共享
先测基线。 固定模型、精度、输入长度、框架和请求方式,记录单任务的响应、错误与资源占用。保留配置,后续比较才有共同起点。
再加入竞争。 增加另一个任务,观察原任务的响应分布与失败情况。不能只测共享环境中只有一个任务时的表现。
最后测试退出与恢复。 停止或异常中断一个任务,检查其他任务、资源状态和重新申请过程。在线推理还要检查业务入口是否按设计处理失败。
这三轮实验的结论可能不同:某类研发任务适合共享,某个在线服务仍需要独立资源。资源池应允许这些结果并存。
从试点配置走向日常运行
正式运行前,可以先设稳定服务、研发试验和批处理三个逻辑资源区。它们是运营分类,不必对应三套独立硬件,也不表示平台自动具备全部策略。
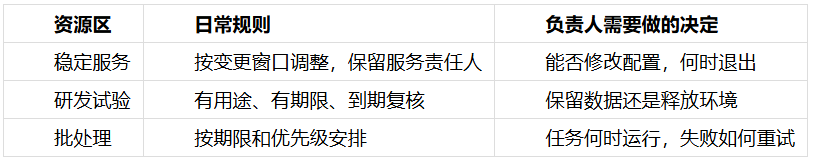
企业 GPU 资源池的成效,可以先从一件具体事情判断:任务结束后,资源是否能够按规则回到下一项任务。围绕这个目标评估 ZStack AIOS,再逐步增加模型和使用团队,资源池建设才有清晰的扩展顺序。
产品使用范围依据截至 2026 年 11 月查阅的公开手册;本文资源分区和实验安排为建设建议。