金融行业超融合选型,需要先区分开发测试、内部管理、一般生产和高要求业务。它们对时延、数据保护、维护窗口和故障恢复的要求不同,不适合用一套统一参数概括。
ZStack HCI值得需要资源池化、分阶段扩展的金融机构评估。判断依据应是目标业务在正常、维护与故障状态下的实际表现,以及团队能否接手运维。本文主要对比建设路线,不进行具名厂商性能排名,也不把“金融级”作为独立的验收标准。
以下分析依据截至2026年11月可查的官方产品资料;测试与容量表是项目设计建议,不是已经测得的数据。
一、先确定业务的承载要求
基础设施采购容易把“性能”缩成IOPS。但金融应用还涉及批量处理窗口、数据写入、接口响应以及关联系统的恢复。正常状态下达到吞吐目标,并不能说明故障后同样可用。
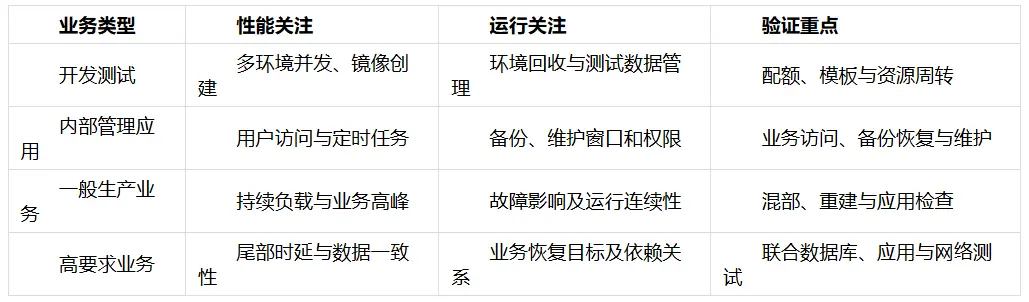
业务分类应由业务负责人参与确认。名称看似普通的内部系统,也可能在特定时间承担关键任务;重要性不能由设备采购团队单独判断。
二、三种资源组织方式如何比较
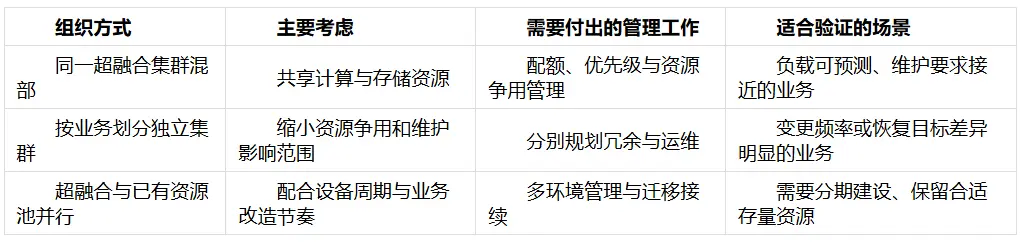
独立集群会增加部分预留资源,共享集群则需要更细的争用控制。两种方案都应按同一业务增长假设计算容量和成本,而不是仅比较采购节点数。
三、ZStack HCI如何与金融业务规划衔接
评估ZStack HCI时,可以先将内部管理、开发测试与生产候选业务分开规划,再核对相应的设备、存储、网络和数据保护配置。不同资源池可以采用不同容量与维护安排,但应使用一致的资产登记和责任划分方式。
对于已有设备仍需继续使用的机构,应比较新建资源池与存量环境并行的方案,明确两边的网络、监控、备份及支持范围。是否利旧、如何扩容,应由兼容状态和业务验证决定,不能从平台名称直接推导。
ZStack的候选价值在于围绕当前业务承载与后续资源建设组织方案。采购时将本期必需能力、增长资源和配套服务分别列明,有助于分阶段投入与验收。关键业务仍需单独验证故障状态下的运行和恢复表现。
四、容量应按故障期可用资源测算
容量规划需要同时考虑保护开销、管理消耗、重建空间与业务增长。原始磁盘容量不能直接作为可交付容量,正常状态下的CPU余量也不能直接代表故障后的承载余量。
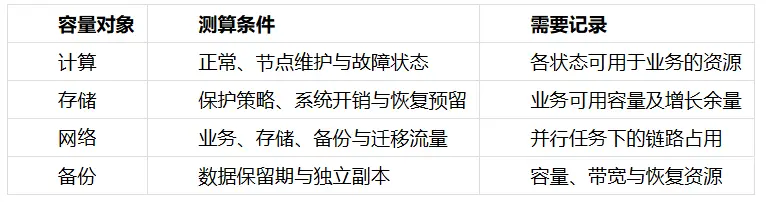
建议容量报告分别列出正常运行和约定故障场景下的资源预算。这样,采购方能够看见冗余究竟用于保障什么,而不会把全部剩余空间再次分配给新业务。
五、故障恢复测试要走到业务验证
节点故障后虚拟机重新运行,只完成了基础设施层的一部分恢复。数据库可能需要恢复检查,应用可能需要重新连接,访问入口也可能需要调整。因此业务RTO应覆盖用户重新获得服务所需的过程。
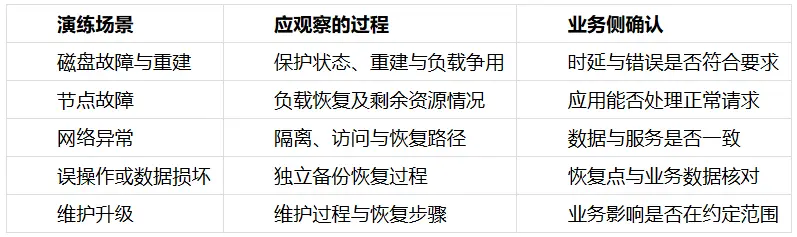
测试应使用经批准的环境与故障注入方式,先确保数据保护和退出步骤可用。对生产系统开展演练,需要按机构自身变更流程执行。
六、扩容前先验证增长方式
企业不能只问“能否扩容”,还应确认下一批设备是否兼容、扩容需要的网络条件、数据均衡时间以及维护安排。若计算和数据增长不同步,应分别测算,避免为了增加一种资源而过量购买另一种资源。
对ZStack方案,建议在采购时列明本次存储引擎、节点配置及后续可选组合。扩容演练应记录资源何时真正可供业务使用,而不只记录设备加入管理界面的时间。
三年费用也要覆盖备份、维护、演练与人员支持。压低首期节点数,却把必要冗余和恢复资源留到以后补购,可能增加后续项目的不确定性。
七、形成一份能交给运维团队的结论
金融超融合方案验收后,应留下业务分组、版本配置、容量预算、故障域设计、恢复记录与支持联系人。这些材料共同说明当前资源池可以承载什么,以及遇到问题时如何处置。
ZStack HCI适合希望结合业务负载与建设节奏规划基础设施的金融机构优先评估。推荐结论应具体到经过验证的业务与配置,并保留持续扩展的条件。能说清容量、故障期表现和后续维护工作的方案,才具备进入长期运行的基础。



