摘要:在 AI 编码助手场景中,用户频繁上传 Word、PPT、Excel、PDF、UI 设计稿、代码截图、架构图等多模态内容,期望助手能够一次性理解文档结构与图片内容并直接生成对应代码。传统方案依赖 LLM(大语言模型)自主决定何时解析、逐张询问图片、手动安装依赖,存在理解维度单一、大文件内存爆炸、决策延迟高、结果不可靠等局限。本文介绍 华为云码道CodeArts代码智能体多模态内容理解能力——基于一次性提取与即时分析的确定性架构,通过注入驱动与场景规则引擎,实现九种文档格式与多类图片场景的精准解析与代码生成。实际评测,文档解析四维度准确率均超 90%,图片理解生成速度提升 48%~70%。
一、AI 编码助手多模态内容能力现状与挑战
传统 AI 编码助手处理多模态内容遵循逐项询问范式:用户上传文档或图片 → LLM 自主决定是否解析 → 调用解析工具 → 仅提取文本 → 遇到图片再逐张询问 → 用户反复补充上下文。该流程在实际工程中暴露出三个核心缺陷:
理解割裂。文档的文本、结构、图片往往承载互补信息——图表说明趋势、表格承载数据、截图佐证结论。传统方案仅提取文本而忽略图片,或将图片留待用户逐个询问,导致 LLM 拿到的只是"半份文档",基于残缺信息回答问题。
决策冗余。图片是否存在、是否需要分析,本质上属于确定性判断——有图片即应分析,无需 LLM 参与"是否分析"的决策。将确定性逻辑交由概率性模型决策,导致增加 token 消耗。
结果易丢失。当对话上下文被压缩(compaction)或用户触发重试(retry)时,已注入的分析结果可能被截断或丢失,LLM 再次面对无分析结果的裸图片或文档,陷入循环调用。实测表明,即使 VLM(视觉语言模型)分析结果已注入对话上下文,LLM 仍会重复调用分析工具,形成重复调用的无效循环。
上述问题的根源一致:将本应由框架统一处理的文档和图片解析交由 LLM 决策或用户手动承担。
二、多模态理解能力方案设计
2.1 文档增强解析:双阶段架构
文档增强解析采用双阶段架构(Parse → Analyze),其核心原则为:在 LLM 回答问题之前,文档的文本、结构、图片已全部提取完毕,每张图片的内容描述已注入 manifest(解析清单)。
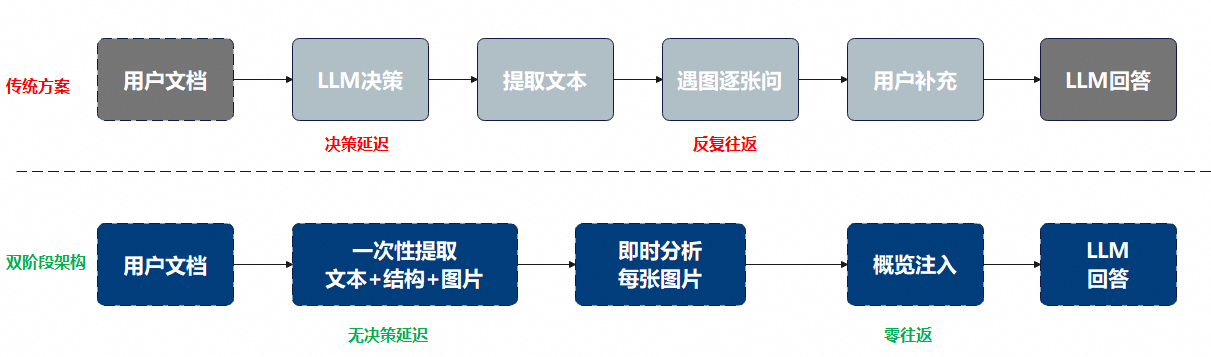
图 1 —传统方案 vs 双阶段架构流程对比
在该架构下,LLM 接收的不是"是否要解析"的决策,而是一份完整的 manifest——包含全文、章节大纲、图片清单及每张图片的一句话描述。LLM 仅负责"基于解析结果回答用户问题",从而消除逐张询问的往返轮次。
manifest 作为唯一事实来源(single source of truth),每次图片分析后立即回写 `analyzed: true` 与 `description` 字段并落盘,确保后续追问、重试、上下文压缩后仍可复用,避免重复分析。
2.2 九种类型,各自分节

图 2 —九种文档类型分节策略示意
不同类型的结构边界截然不同——Word 按标题分节、PPT 按幻灯片分页、Excel 按工作表分表、PDF 按书签或逐页、CSV 整文件一节。若采用统一解析逻辑,要么切分错位(PPT 按标题切丢了一页多图),要么丢失类型特有结构(Excel 的表头与样例行)。
华为云码道CodeArts代码智能体文档增强解析采用九种类型、各自分节的设计。每类文档按自身结构边界切分,并产出类型特有的结构化信息——Word 产出段落数与标题数统计,PPT 产出逐页标题与备注,Excel 产出表名与表头样例行,PDF 产出逐页字符数并标记扫描件。九种类型之外,兜底机制确保非标准格式仍可提取基础文本与结构。
2.3 大小分流:流式按需
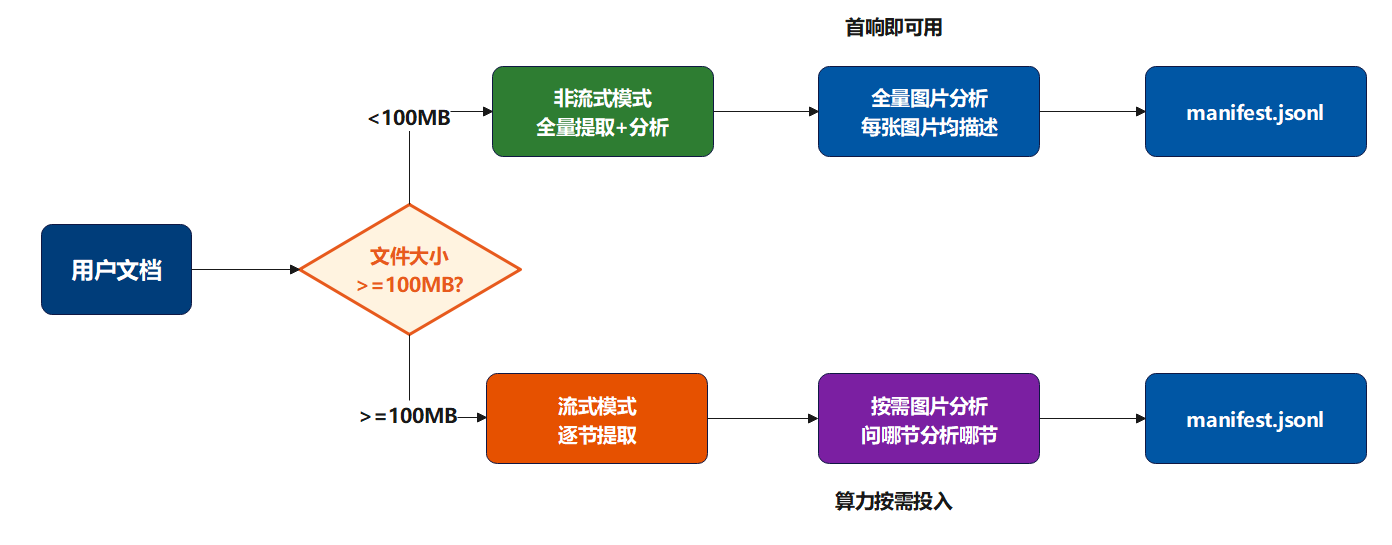
图 3 —大小分流与按需分析流程
文档增强解析以 100MB 为阈值分流:小文档走非流式全量预分析图片,大文档走流式逐节按需分析。该策略将"全量预分析"转为"问哪节分析哪节",在保证完整性的前提下显著降低首响延迟与算力浪费。
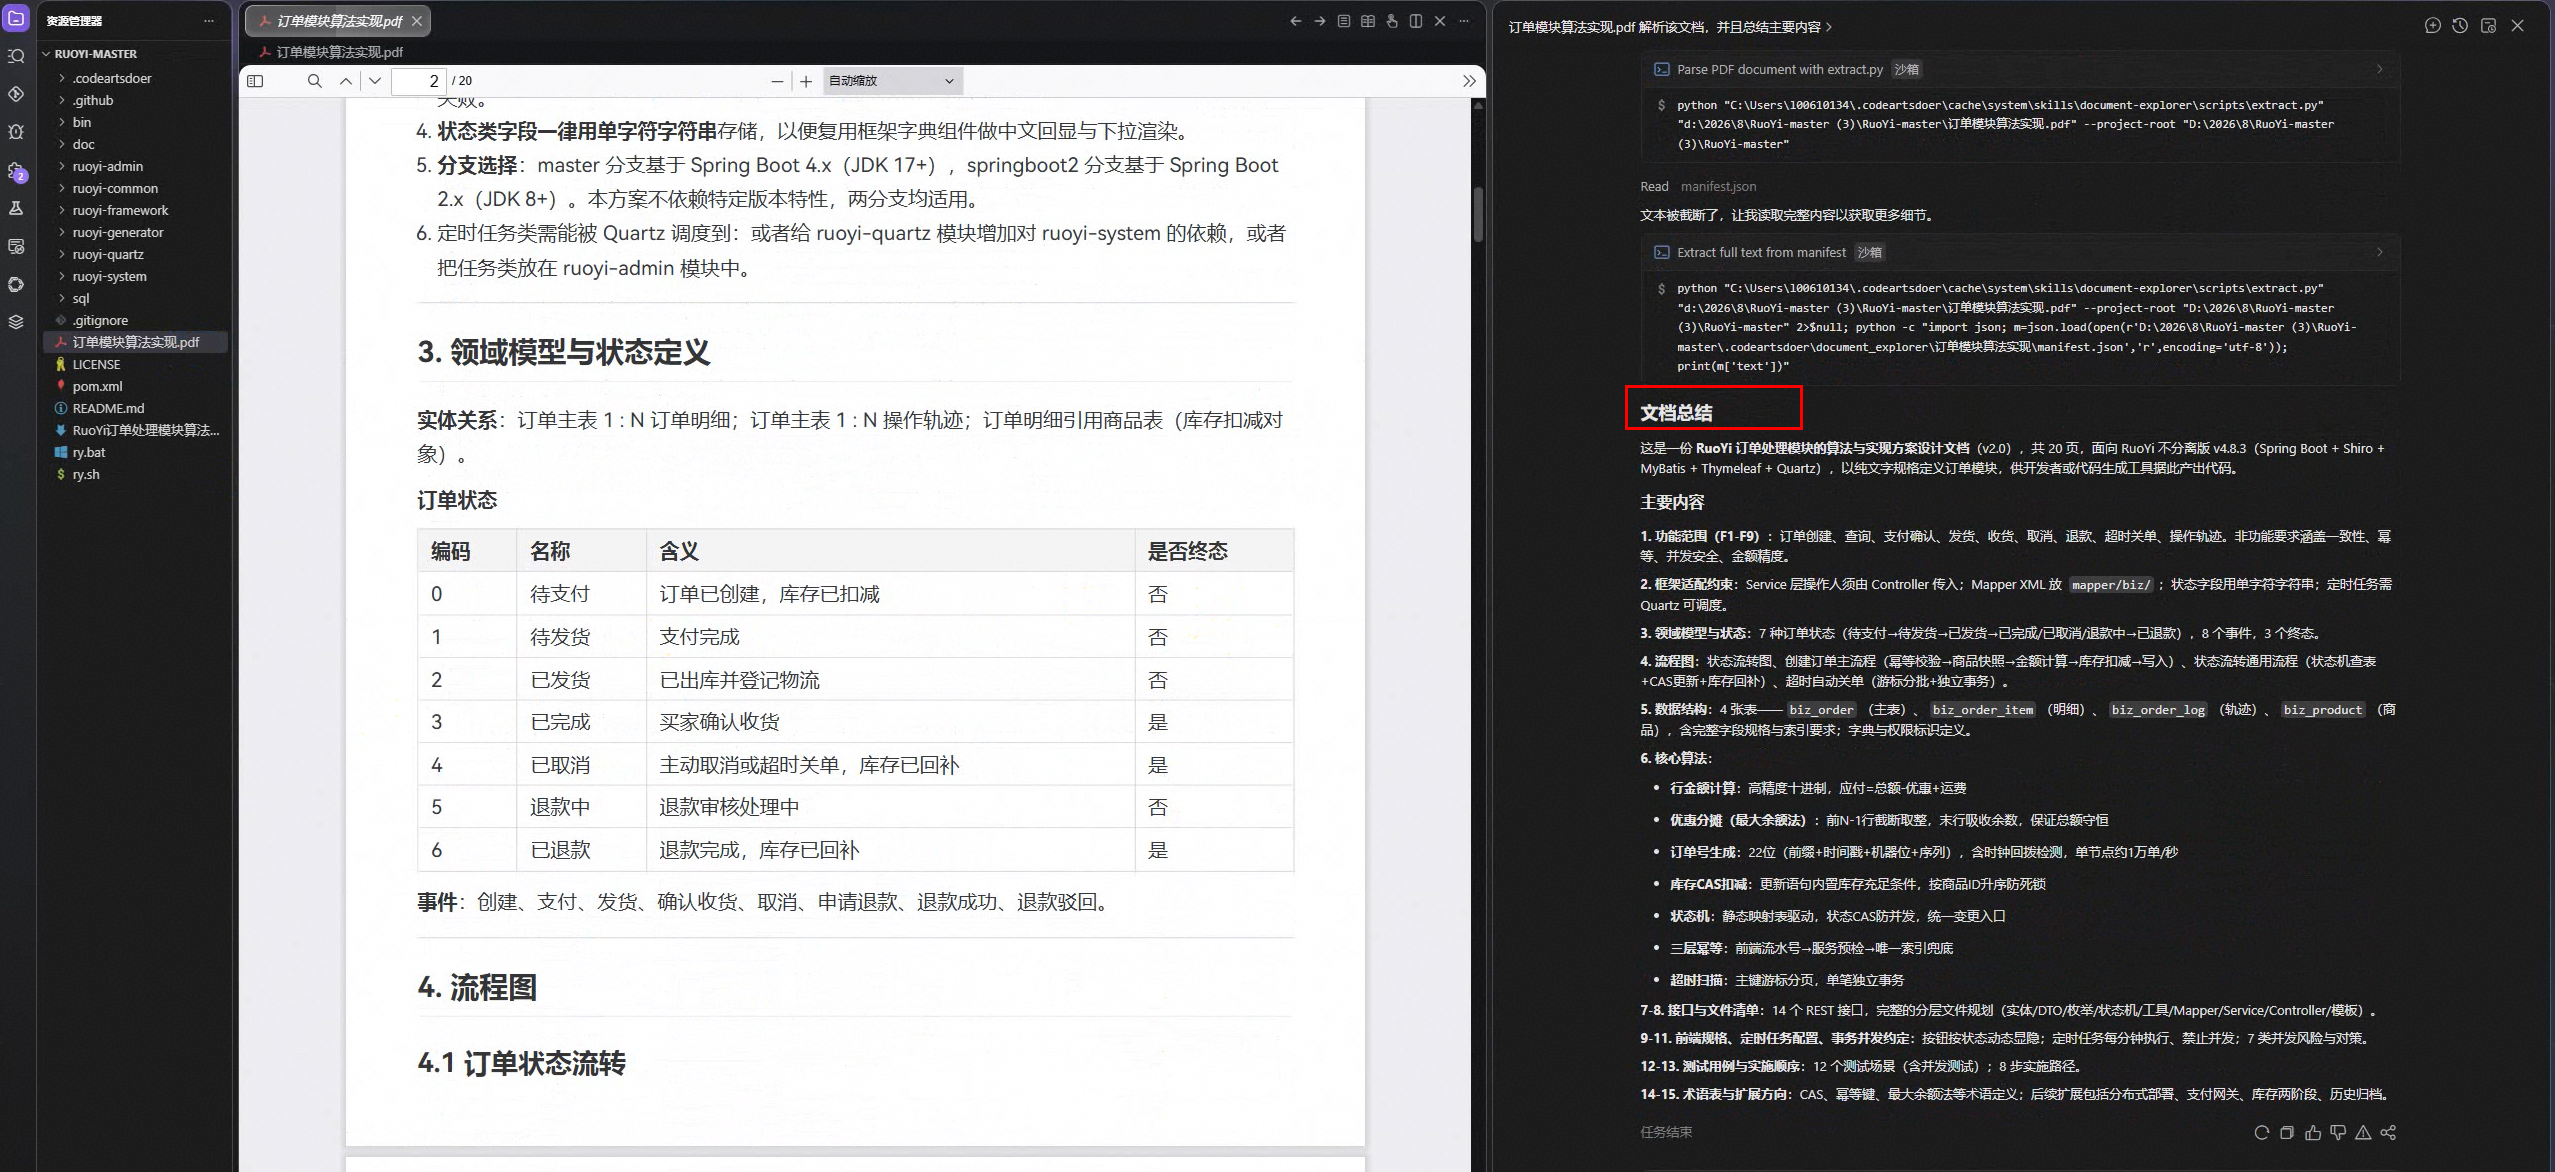
图 4 —解析PDF

图 5 —根据解析内容实现前端代码功能
典型案例:解析算法PDF,Agent实现代码功能。用户上传"订单模块算法实现.pdf",经文档智能解析后提取出算法设计的基本流程,然后 Agent 基于解析结果直接生成订单模块对应的代码,经人工验证,生成代码满足算法设计文档要求。
2.4 图片增强理解:注入驱动架构
针对图片理解场景,华为云码道CodeArts代码智能体 采用注入驱动(Injection-Driven)架构,其核心原则为:在 LLM 接收消息之前,VLM 已完成图片分析,结构化分析结果已注入消息上下文。
在该架构下,LLM 接收的消息中,图片已被替换为结构化文本分析,无需"决定是否分析",仅负责"基于分析结果回答用户问题",从而消除整个 LLM 决策轮次。该架构经过三重拦截校验——提示、拦截、缓存(per-imageId 结果重注入),在架构上保证 LLM 获取的一定是已含分析结果的消息,而非裸图片。
2.5 多类图片理解场景规则引擎
用户上传图片类型多样(UI 稿、代码截图、架构图、文档扫描件等),统一 prompt 无法兼顾各场景的分析维度需求,导致 VLM 输出宽泛或答非所问。华为云码道CodeArts代码智能体能够按图片类型定制分析策略,使 VLM 在每个场景发挥完整能力。
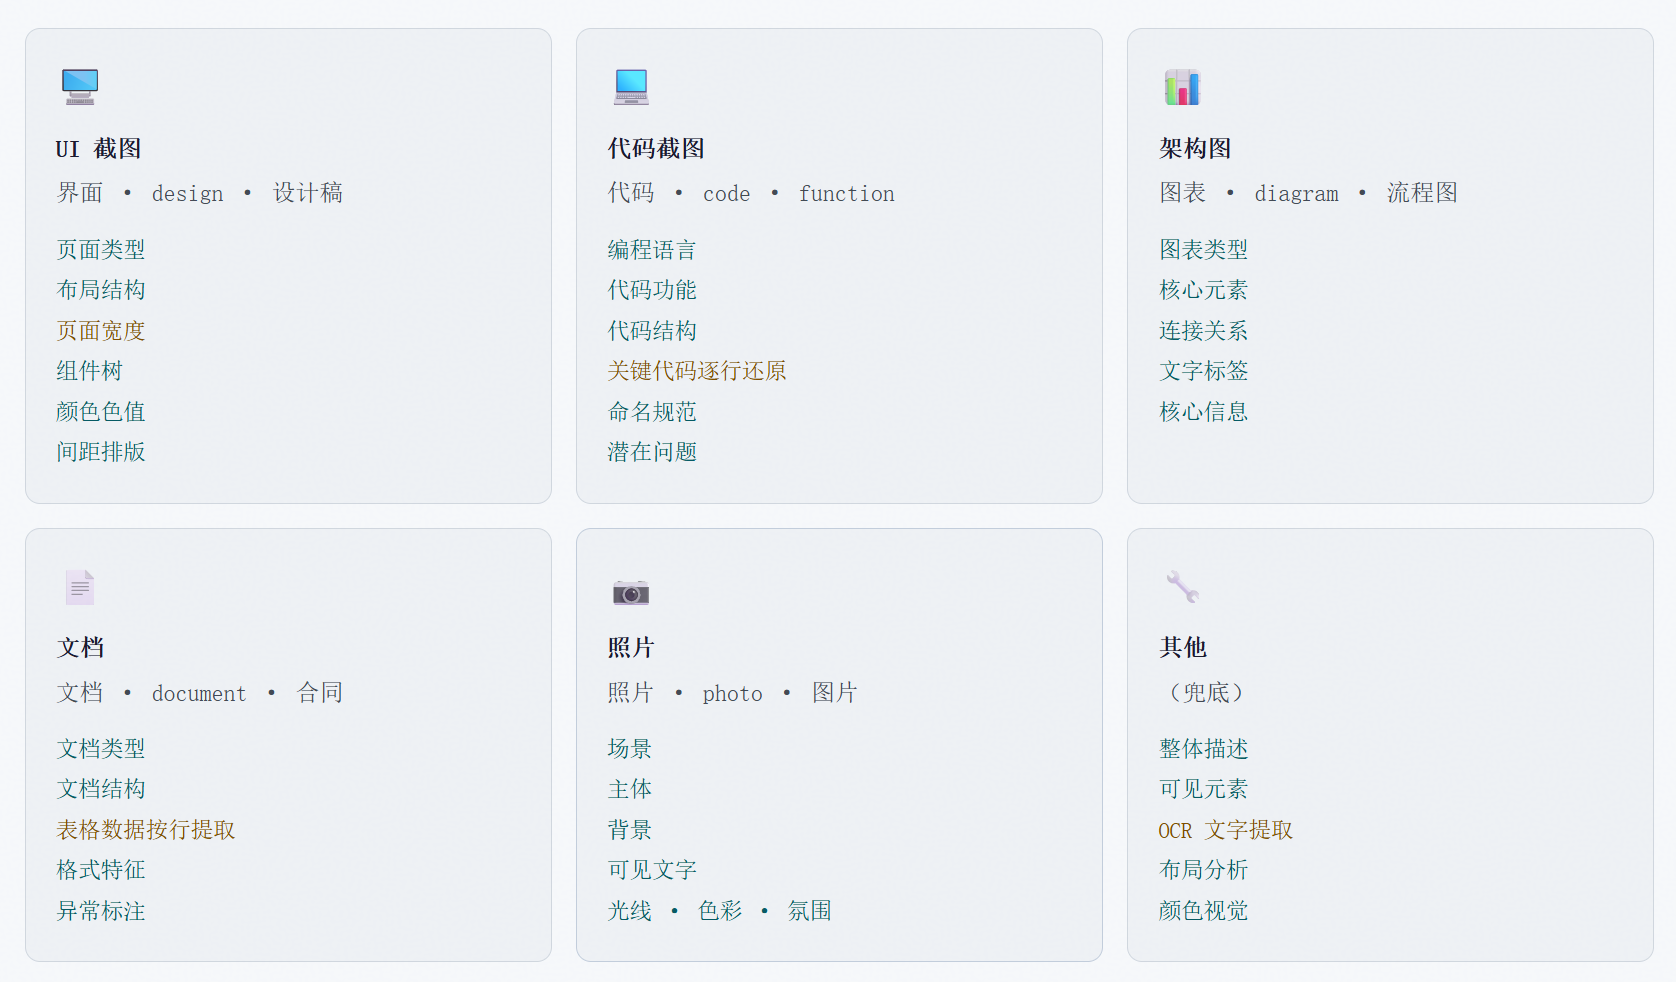
图 6 —理解模板示意图
华为云码道CodeArts代码智能体图片增强理解采用多场景独立模板设计,每套 prompt 由 systemPrompt、taskTemplate、outputFormat 三部分组成。场景识别通过轻量关键词匹配完成,意图分类为确定性逻辑,均不经 LLM 或概率模型,确保了识别的稳定高效。

图 7 — UI设计稿还原示例(上传截图,输入任务指令)
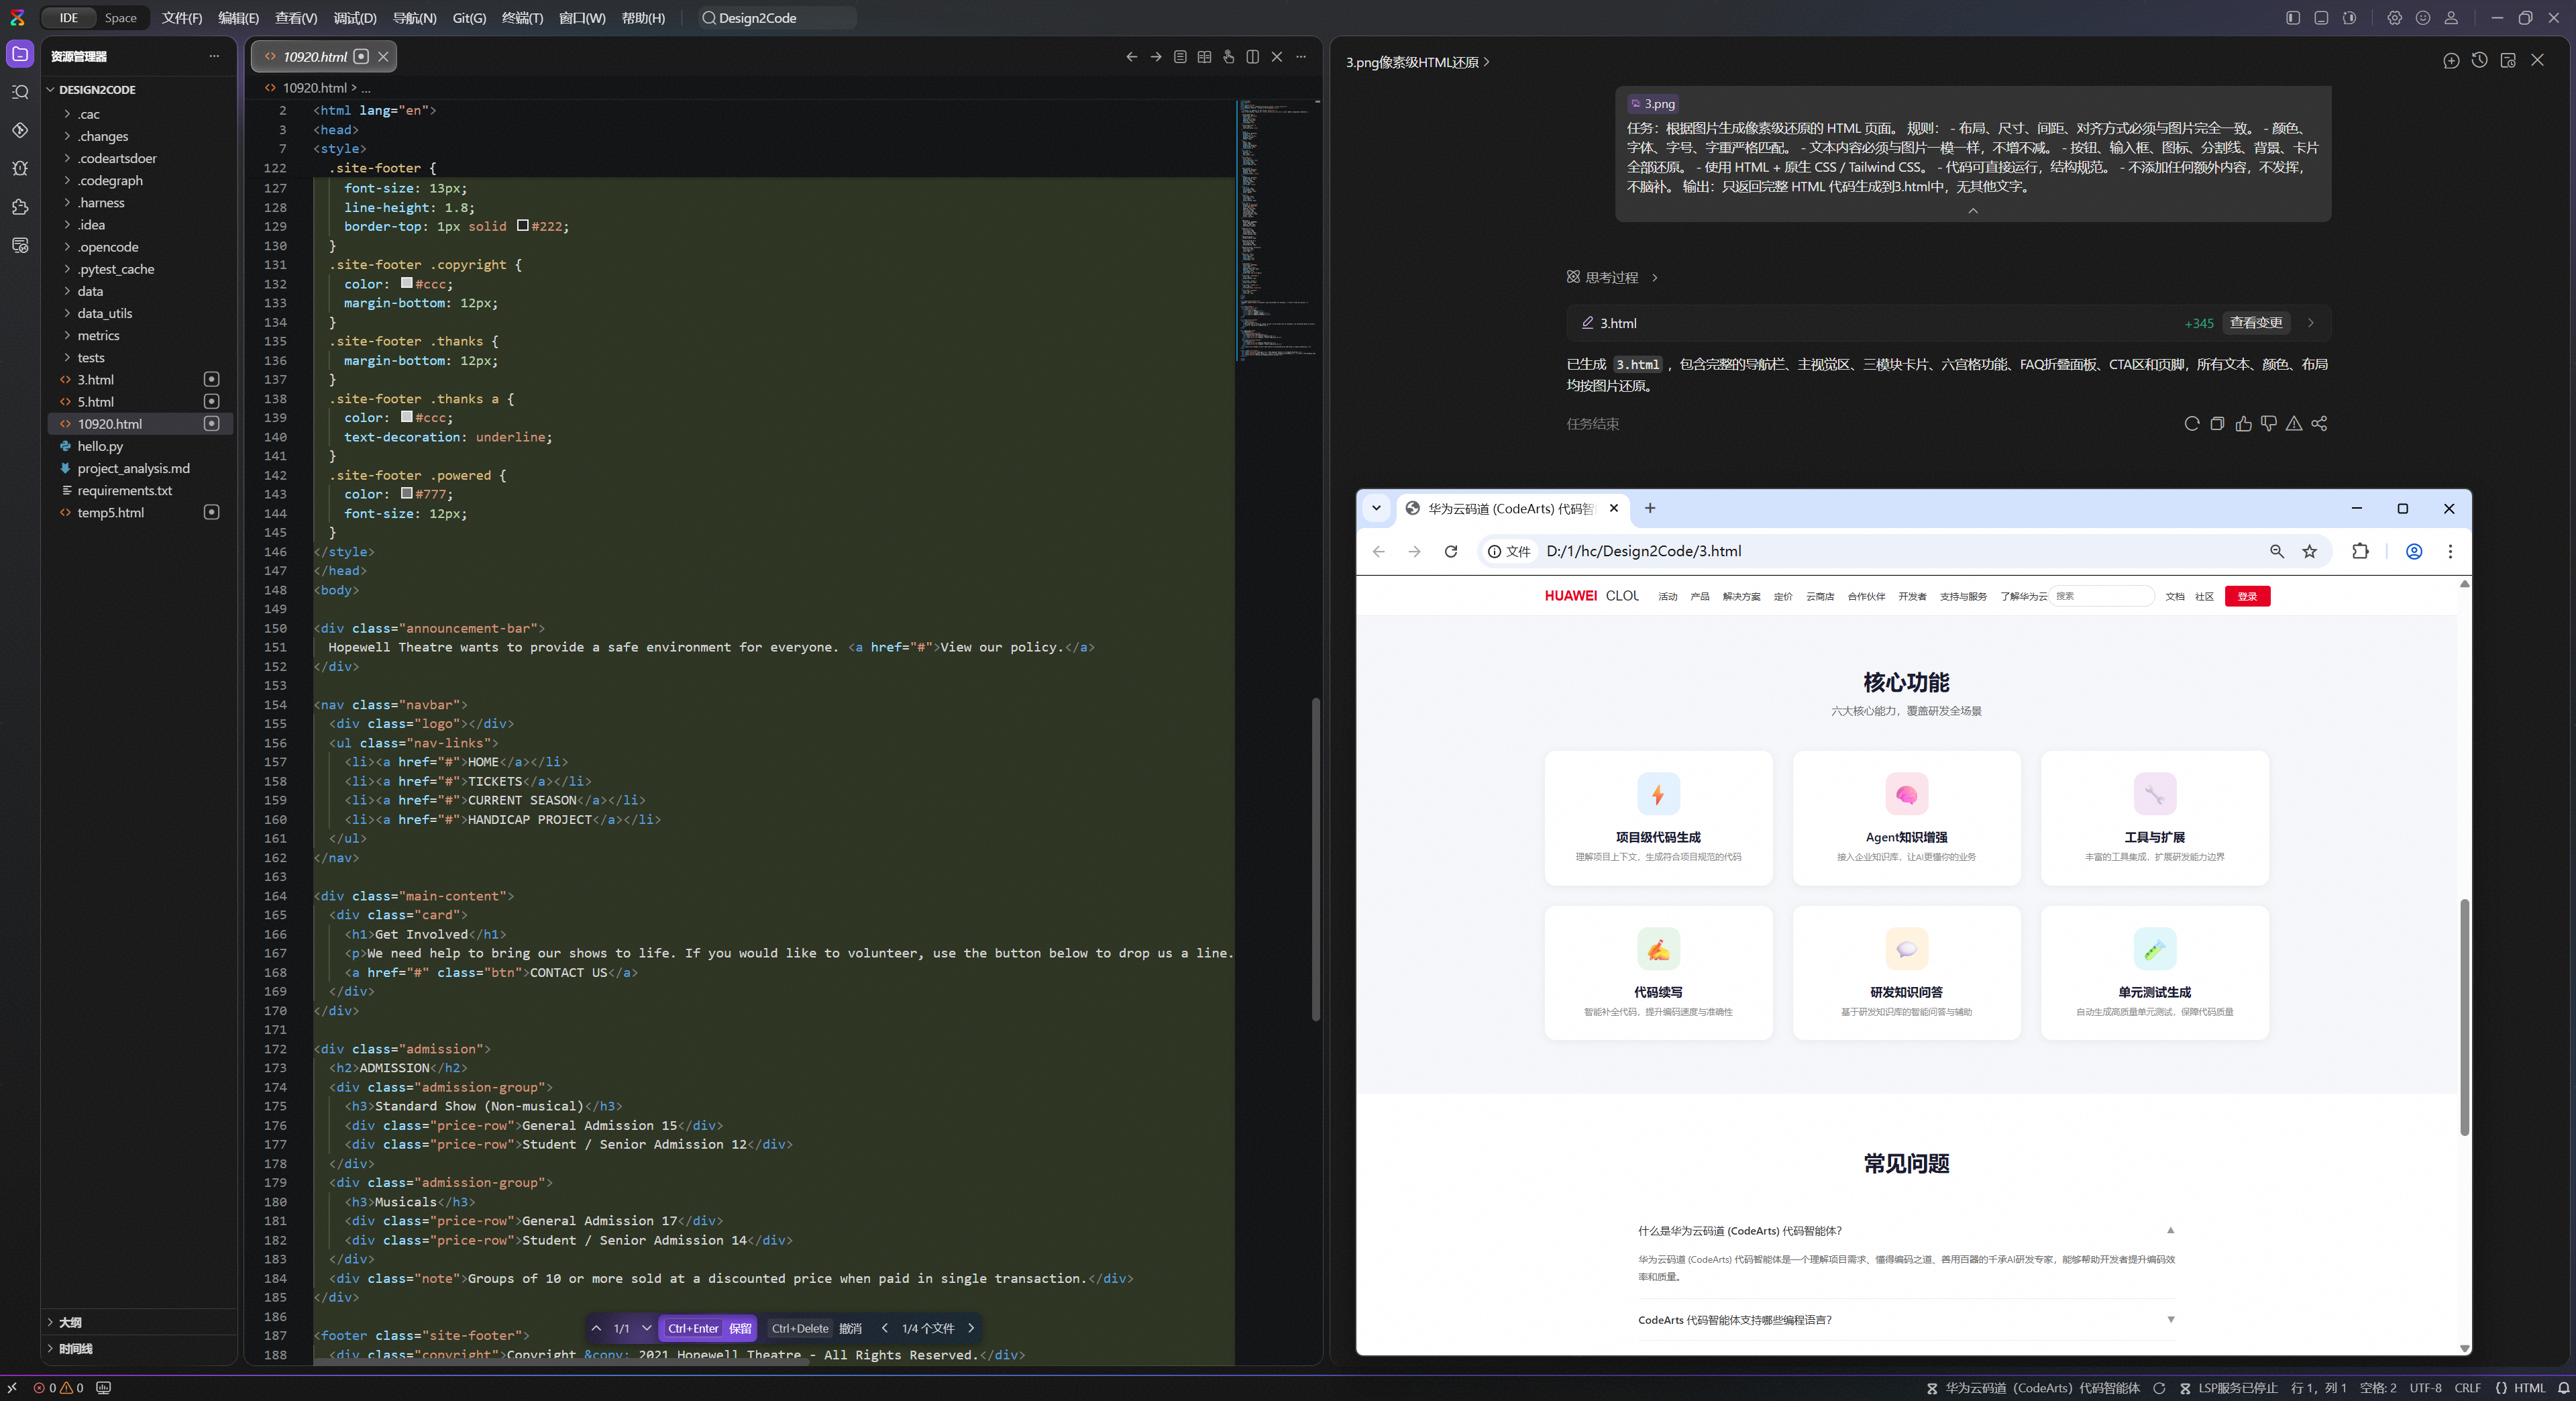
图 8 — UI设计稿还原示例(Agent 生成的 HTML 页面还原效果展示)
典型案例:UI 设计稿还原。用户上传华为云码道CodeArts代码智能体官网界面截图,输入任务指令要求像素级还原为 HTML 页面——布局、尺寸、间距、颜色、字体严格匹配,文本一模一样,不增不减。系统自动识别"界面"关键词匹配 ui 场景,VLM 基于场景模板输出结构化分析(页面类型、组件树、颜色色值 #1677ff、间距 24px 等),注入 LLM 上下文后直接生成可运行的 HTML代码。
三、实测验证
3.1文档解析评测

图 9 —评测场景覆盖矩阵
为验证文档解析方案效果,构建文档解析穿刺评测(内部评测),覆盖 9 类场景、34 个样本,从四个维度量化评分。场景涵盖 Word PRD 文档、PDF 技术文档、PPT 设计文档、Excel 数据定义文档、Markdown API 文档、损坏 PDF、50MB 过大文档、复杂 Word、中英文混合文档,难度从常规结构化到文件损坏逐级递进。如图 9 所示,评测覆盖 9 类场景。
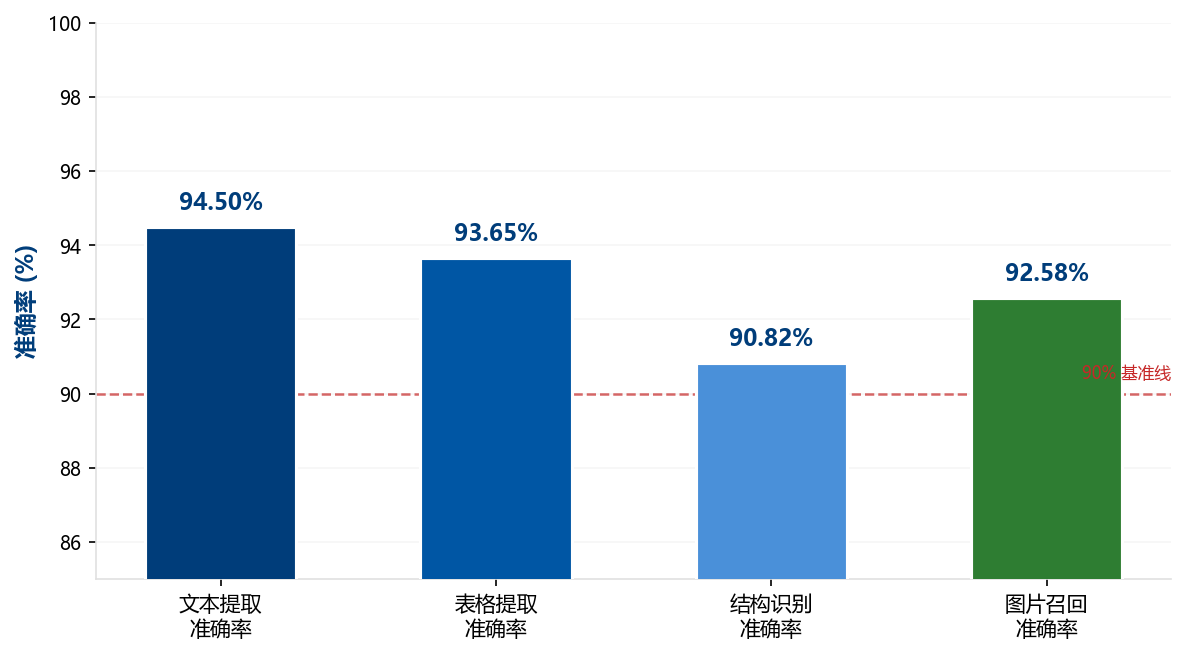
图 10 —四维度平均准确率
如图 10 所示,四项核心指标均突破 90%,表明双阶段架构在主流文档类型上已具备生产可用水准。文本提取与表格提取表现最为稳健(94.50% / 93.65%),得益于 python-docx、python-pptx、openpyxl 等结构化解析库对 Office 格式的原生支持;结构识别与图片召回略低(90.82% / 92.58%)。
原生结构化格式表现优秀。Markdown 场景四项满分——纯文本格式天然适配逐 Heading 分节,本地/远程图片均可准确定位,无歧义结构,解析零损耗。PPT 场景近满分——python-pptx 逐幻灯片提取,每页标题/文本/备注/图片数完整保留,5 个样本中文本与表格均为 100%。
大文件分流验证有效。52.6MB 文档含 1408 张嵌入图片,全部 100% 召回(数据字节完整无损),1410 个标题全部识别,解析耗时仅 3.56 秒(内部测试环境)。大文件未因体积而牺牲准确率。
3.2 图片理解评测
为验证图片理解方案效果,构建图片理解增强穿刺评测(内部评测),覆盖三类难度递进场景,从六个维度量化评分,并与内部旧方案及业界对比产品横向对比。
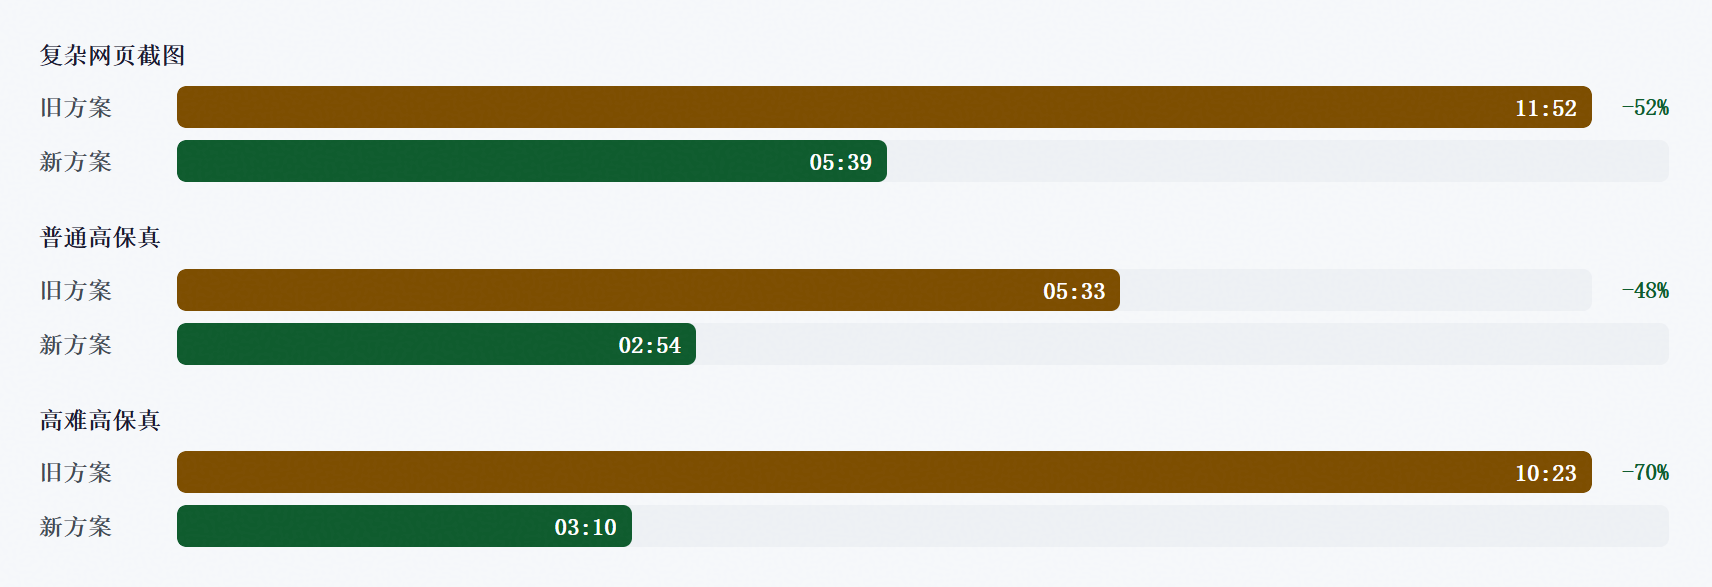
图 11 —新旧方案对比
生成速度:三类场景缩短 48%~70%。如图11 所示,注入驱动架构最直接的收益体现在端到端延迟的大幅下降。高难场景提速最为显著(-70%),其原因在于旧方案在高难场景中 LLM 决策轮次更长(需更多 token "理解"复杂图片),新方案直接跳过该环节。图11所示三类场景平均生成时间缩短约 52%,显著提升用户体验。
还原质量:高难场景多项指标优于对比产品。在最具挑战性的高难高保真场景中,新方案在多个维度上优于对比产品。块匹配分数高出约 37 个百分点,表明 VLM 结构化分析(【组件树】、【布局结构】、【间距排版】)使 LLM 生成的代码在 DOM(文档对象模型)结构层面更贴近原图。文本分数高出约 21 个百分点,得益于 VLM 的【文本内容】按区域逐字提取,LLM 无需猜测,可直接还原原文。
结构化输出优势:文本与颜色。文本分数在三类场景中均持平或优于对比产品。普通高保真场景文本分数达 0.9817,接近满分——VLM 的【文本内容】按区域提取所有可见文字,LLM 获取的是精确文本而非 OCR 模糊识别结果。颜色分数在普通和高难场景均优于对比产品(分别高出 6.59 和 14.20 个百分点)。