当AI步入产业深水区,算力已成为驱动新质生产力发展的核心引擎。从单机到万卡级超大规模集群,企业AI基础设施建设正经历规模跃升。万卡集群标志着AI算力正式迈入规模化落地新阶段,行业竞争焦点正从单纯的“算力规模比拼”转向“稳定运行能力”的较量;随着大模型训练与产业智能化需求激增,高可用、低中断的集群稳定性已成为释放AI价值、推动千行百业智能升级的核心基石,亦是构筑未来AI基础设施话语权的关键所在。
然而,万卡集群“牵一发而动全身”的特性,让集群级容错从可选项变为必选项。成千上万张算力卡协同运行时的极致稳定,已成为制约大模型迭代效率的核心瓶颈。在这个AI时代,运维的核心命题已从被动的“出了问题怎么办”,转向主动的“提前发现风险”、“极速恢复故障”以及“通过持续运营实现集群越用越稳”。未来,AI基础设施的竞争已不再仅仅是算力规模的比拼,更是筑牢稳定底座、保障业务连续性的综合能力博弈。
万卡集群背后的三大运维挑战
当集群规模突破万卡门槛,运维复杂度呈指数级上升,系统可靠性面临前所未有的考验。传统AI基础设施“提供算力”的模式,正加速向“提供持续稳定的算力服务”演进,主要面临以下三大挑战:
挑战一:规模效应下的稳定性难题——在由海量NPU、高速互联网络及复杂调度软件构成的算力资源池中,任何单一节点故障、网络传输丢包等失效,都可能引发连锁反应,导致训练中断、结果失真甚至全局宕机。此时,稳定性不再是“锦上添花”的加分项,而是决定业务生死的“底线”。
挑战二:故障隐蔽性与定位困境——链路交织、信号相互耦合,微小异常极易被海量指标掩盖,故障表象零散失真,溯源时难以区分是单卡局部问题还是跨节点连锁扰动,定位排查极易陷入多因素纠缠的僵局。传统的 “事后救火” 模式在此场景下严重滞后,必须转向 “事前预警 + 精准定因”。
挑战三:资源调度拥堵与恢复效率瓶颈——万卡集群中算力资源海量且强绑定分布式训练任务,由于算力资源宝贵,通常处于常态饱和运行状态。当故障触发时,受监控发现延迟、资源抢占排队以及重建链手动执行耗时过长等多重因素影响,会导致故障恢复MTTR被显著拉长。面对不确定的硬件故障或软件崩溃,如何快速重调度资源和恢复故障,已成为关键命题。故障恢复延迟一分钟,不仅是真金白银的挥霍,更意味着数小时的训练成果可能付诸东流。
因此,万卡时代的核心命题,在于构建一套集高可用设计、主动运维与快速恢复于一体的稳定运行体系。这不仅是底层硬件极致稳定的体现,更关键在于软件栈对分布式状态一致性的精准管理。唯有打通从芯片到应用的全栈稳定链路,才能确保AI基础设施持续、高效地供给算力。
这正是华为云在万卡AI集群稳定运行保障实践中持续探索的方向——通过技术创新夯实稳定基座,赋能千行万业智能化升级。
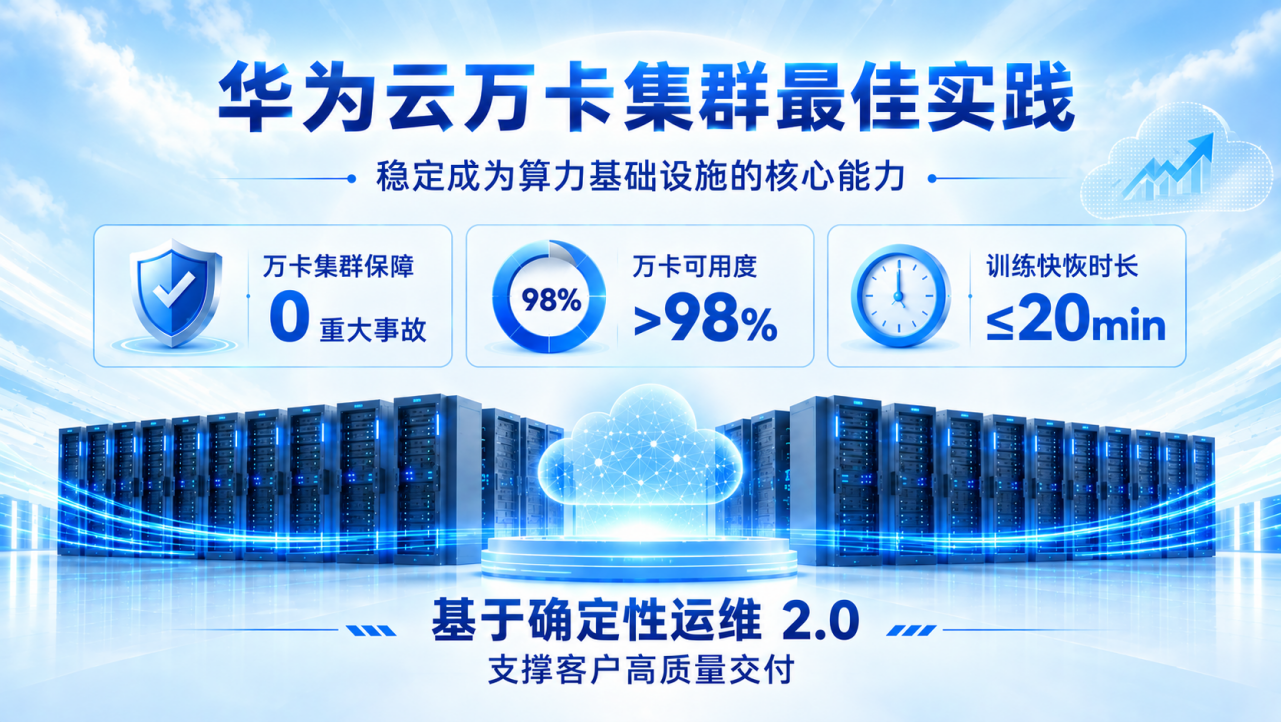
图:华为云万卡集群能力
架构先行:华为云基于确定性运维体系,构建面向万卡集群的稳定底座
万卡集群的稳定性,首先是一道架构题。对于超大规模AI集群而言,稳定性不是后期“运维出来”的,而是在架构设计阶段就已奠定基调。
以华为云服务某M大型客户为例,为保障客户集群业务稳定,华为云基于自身成熟的实践经验,联合客户以“全局冗余、分层隔离、数据持久、自动化运维”四大核心理念,设计集群高可用架构方案,构建起面向万卡集群的稳定底座,确保大规模AI训练任务在极端场景下依然稳定运行。
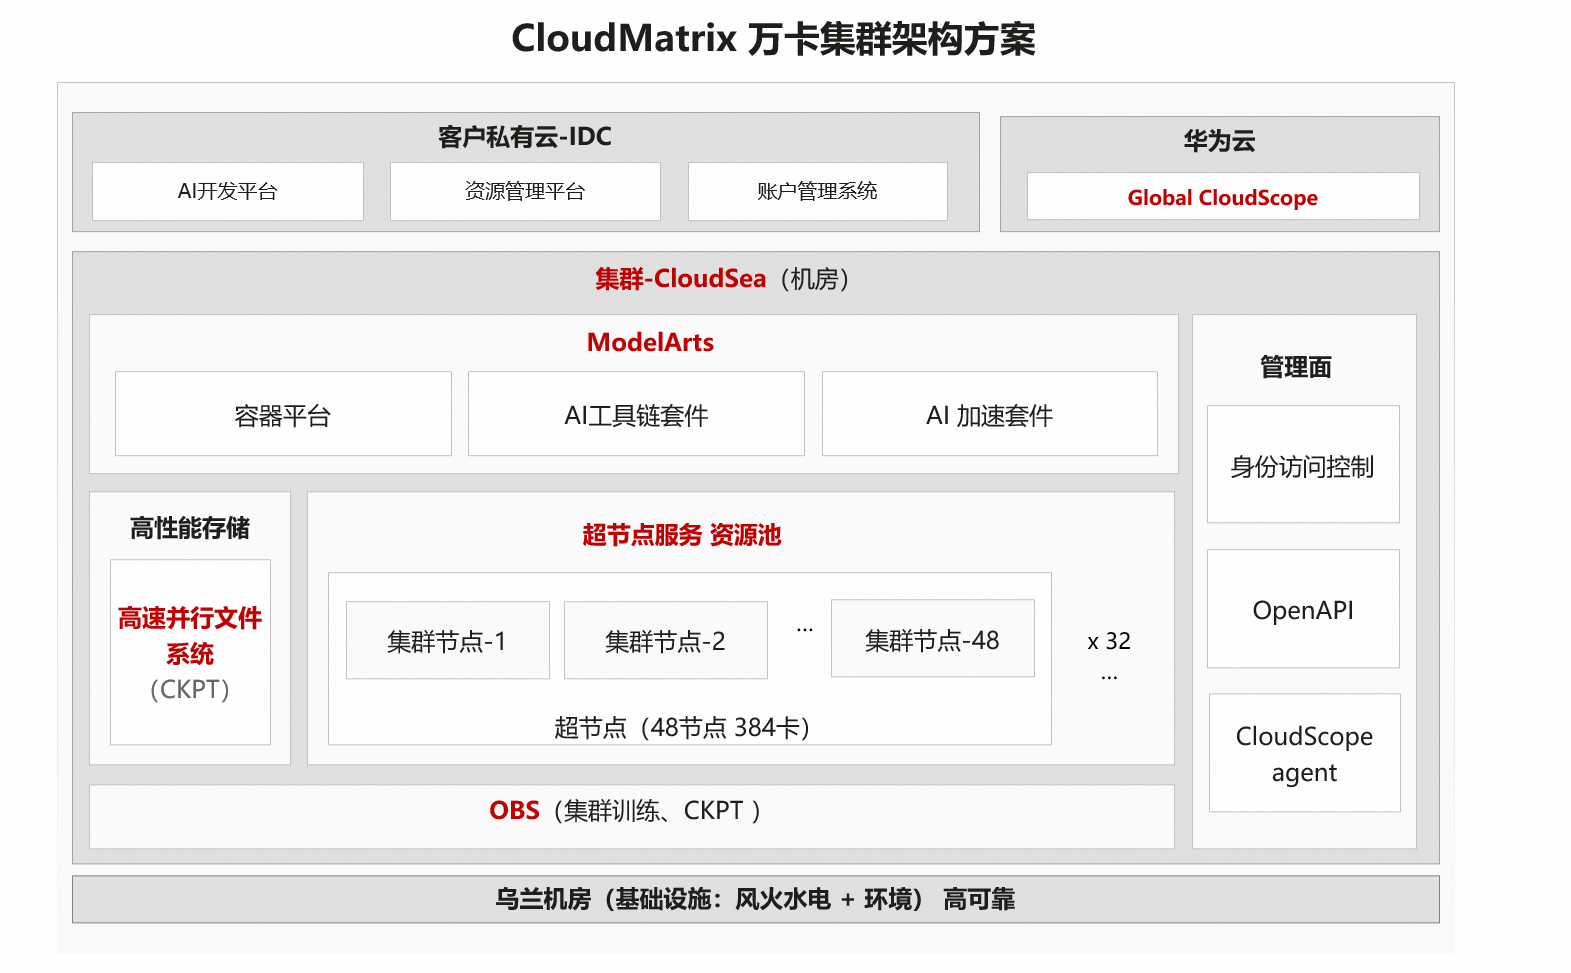
图:某客户CloudMatrix 万卡集群架构方案
多区域异构部署,打破单点故障瓶颈。集群横跨上海与乌兰察布两大地理区域,实现物理层面的灾备隔离。通过“数据复制”机制,关键元数据与控制面服务(如AI开发平台、资源管理平台、账户管理系统)在两地同步冗余,即使某一区域发生网络中断或硬件故障,业务可无缝切换至另一区域,保障服务连续性。
控制面与数据面解耦,提升系统弹性。架构采用“管理面”与“存储面”分离设计。管理面承载OpenAPI、身份访问控制模块、CloudScope agent等核心管控组件,独立于计算资源池,避免算力波动影响调度决策;存储面l依托OBS对象存储实现跨可用区数据冗余,结合高速并行文件系统的高吞吐特性保障数据读取稳定性,确保模型Checkpoint(检查点)不丢失、监控数据不中断,从结构上奠定高可用基础。
超节点级资源池化 + 动态负载均衡 。集群将48个节点打包为一个逻辑超节点(共32组),每组含384张加速卡。这种“超节点+容器平台”的组合,既提升了资源利用率,又通过内部负载均衡(ELB)和虚拟IP(VPC/EIP)实现流量分发与故障转移。当某个节点异常时,系统自动将其剔除并重新分配任务,无需人工干预。
全链路可观测 + 自动化运维闭环 。从底层基础设施(风火水电+环境)到上层应用(ModelArts、AI工具链套件),每一层都内置“CloudScope agent”进行实时健康检查与性能采集。系统能自动触发告警、自愈或扩容动作,形成“感知—诊断—响应”的完整闭环,大幅降低MTTR(平均修复时间)。
此外,基于客户自身需求,华为云的云原生服务能够无缝对接客户自建服务。客户的基础设施可通过标准化接口(OpenAPI)与华为云原生服务(IMS、ECS、CES、CFW、HSS等)无缝对接。这种“混合云架构”既保留了客户对敏感数据的控制权,又能让公有云的弹性伸缩与安全合规能力发挥效能,真正实现“稳中有进”。
主动运维:华为云重保体系,实现万卡集群作业重大事故0起
在万卡集群的运维实践中,比故障发生后的紧急响应更关键的,是端到端的主动运维。对于拥有海量资源的超大规模集群而言,日常运维的核心并非处理突发重大故障,而是通过持续的健康检查与风险管控,将潜在问题拦截在爆发之前。
基于这一理念,华为云为S客户构建了一套以“主动运维”为核心的重保体系。该体系彻底摒弃了传统的“事后补救”模式,将重心前移,围绕事前预防、事中快速响应、事后复盘总结改进和协同支撑四大维度,建立了从基础资源到平台环境的持续主动运维体系,最终实现S客户万卡训练任务点火过程中在重保期间重大故障为0的目标。
极致的“事前预防”:标准化与深度压测的双重护航。首先,风险识别与处理,对硬件(NPU/网卡/存储)、网络拓扑、软件栈兼容性等进行全面扫描,识别架构、性能容量和云服的潜在风险;其次,全面的资源监控和告警优化,搭建全链路监控看板,覆盖算力、内存、带宽、温度、功耗等关键指标,同时阈值告警对相关指标进行告警优化;再次,应急预案制定,针对万卡集群故障场景(如节点宕机、网络中断、驱动异常)制定标准化处置流程,并组织混沌演练,模拟Anet切流、超平面故障、算子重执行及专线故障等真实极端场景,完整验证从故障发现、精准定位、影响评估到恢复处置的全流程;在测试环节,引入“浴盆曲线”理论指导深度压测,在集群上线前及故障修复后,对链路运维风险进行全量压力测试。通过极致的“事前预防”,将万卡训练任务日常监控中难以察觉的隐患被提前挖掘,将不可预测的突发情况转化为可验证、可优化的稳定性能力。
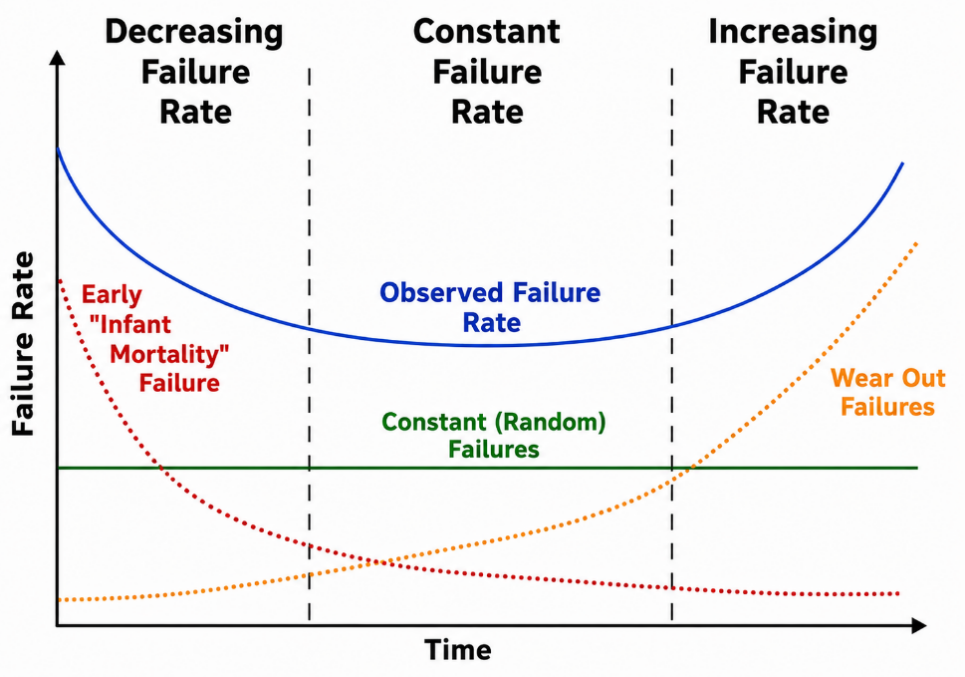
图:浴缸曲线风险函数
敏捷的“事中响应”与全域“监控巡检”。在故障感知层面,华为云运维可观测体系覆盖150+关键指标,涵盖NPU利用率、温度、ECC错误及RoCE链路状态等核心数据。通过配置7类NPU事件告警,并对关键业务指标执行1-2小时的高频巡检,系统实现了对集群状态的无死角感知,为故障的及时捕捉和后续根因分析提供详实的数据支撑;在故障响应层面,华为云建立了三级、二级War Room分级决策机制,针对训练拉起失败、性能骤降、节点卡死等6类典型场景,明确责任链条,确保在10分钟内拉起应急小组,并在2小时内完成业务恢复。同时,针对现网高频痛点,制定标准化SOP,显著缩短故障平均修复时间(MTTR)。
严谨的“事后闭环”,数据驱动与知识沉淀。华为云坚持“以数据驱动改进,以复盘驱动优化”的原则,构建从故障处置到知识沉淀的完整闭环体系。通过建立每日快恢数据统计、硬件及软件故障管理机制,累计修复多个硬件故障并攻关软件疑难问题。针对演练中发现的恢复慢、性能下降等问题,纳入改进清单并持续验证。同时,明确多领域责任矩阵,建立精度和性能疑难问题的专项对接流程,确保复杂问题有人管、有结果,显著降低故障复发率
端到端的协同支撑,全栈保障业务连续性。无论是版本不一致的预防,还是客户代码问题的排查,通过落实首问责任制与线上化闭环管理,华为云帮助客户建立了从基础资源到平台环境的持续健康检查机制,确保问题快速定位及业务高效恢复,所有测试问题均跟踪至彻底闭环,为万卡集群的训练作业平稳运行、性能达标及业务连续性奠定了坚实基础。
华为云通过成熟的运维保障体系,有效保障了客户万卡集群训练作业的平稳运行与业务连续性。华为云守护的不仅是零故障的数据,更是那份对业务连续性最深沉的承诺与安心。
快速恢复:超大规模AI集群训练全链路优化,实现训练快恢复能力跃升
为破解客户在大型AI集群训练中“模型备份耗时长、恢复耗时久和有效训练时长占比低”等痛点,华为云通过端到端全链路优化,实现训练任务快速恢复能力的跨越式提升——从188分钟压缩至20分钟,效率提升近9倍。本次优化围绕四大关键步骤展开,系统性地重构了 CKPT(Checkpoint 检查点)备份、环境初始化、模型加载建链与算子编译全流程,全面赋能高并发、大规模模型训练场景。
重构CKPT链路,底层引擎深度优化,实现存取流程端到端加速。针对CKPT存取流程进行结构性重构。读取侧部署智能解析引擎与镜像热加载技术,智能解析文件结构,通过去冗余分片与编译缓存泛化,跳过无效元数据扫描,直接定位权重块,大幅压缩初始化耗时。写入侧采用两阶段写与异步可靠持久化策略,结合缓存预热机制,显著降低磁盘IO等待,大幅缩短备份耗时。此外,通过模型加载与编译并行及集合通信监控方案,打通故障发现到算子编译的全链路瓶颈,实现从“小时级”恢复向“分钟级”甚至“秒级”响应的跨越。
模型高效并行存取,消除通信开销并重构数据恢复流程。在环境初始化阶段,打破原集中式模型搬运模式,使各节点独立加载所需片段,彻底消除保存与加载阶段的集中式通信开销并降低网络带宽压力;同时,基于数据集索引重构恢复流程,跳过冗余扫描实现快速数据加载,并结合镜像热加载、巡检预检、进程有序退出及训练进程管理框架优化,在快恢阶段自动跳过非必要流程并最小化初始化固定耗时,从而显著提升环境初始化效率与系统稳定性。
链路升级,多组件协同提升数据访问效率。针对CKPT存储恢复耗时长、训练占比低的痛点,实施全链路优化,打通训练调度插件、底层加速引擎及客户端技术壁垒。训练调度插件支持多卡同步加载的自动分片与负载均衡;客户端实现本地缓存高效命中与远程请求智能调度,并升级元数据管理与会话保持能力。配合存储桶带宽扩容与读写能力升级,突破存储瓶颈。三者协同支撑万卡集群稳定运行,结合数据恢复与算子编译优化,显著提升训练效率。
算子编译缓存与底层通信优化,突破训练效率瓶颈。通过存储桶带宽扩容保障海量CKPT高速流转,并引入算子编译缓存机制复用历史结果以缩短初始化耗时。同时,深度优化通信底层,采用分层与并行建联、长连接及控制信息拼包降低开销;支持复用连接创建及基于节点标识创建或切分通信域;在主机侧实现并发调用、多线程管理及收发线程池管理,支持集合通信单算子模式及内存复用。这些基础设施层优化协同发力,全面突破存储与通信瓶颈,实现训练效率的显著跃升。

图:训练故障恢复流程
从一次次保障,到一套持续运行的确定性运维稳定性体系
万卡集群的稳定运行,绝非单一技术点的突破,而是架构、硬件、平台、网络与运维体系协同作用的系统工程。AI算力越强,越需要与之匹配的稳定性能力。从架构设计到硬件可靠性,从故障演练到主动巡检,华为云正通过技术与专业服务能力的深度融合,持续构建面向超大规模AI集群的稳定运行能力。企业所求,不仅是更大的算力规模,更是能够长期稳定运行的智能基础设施。算力决定AI能走多远,稳定性决定AI能跑多久。
当万卡集群成为智能时代的关键基础设施,真正值得关注的,不仅是万卡背后的强大计算力,更是那些在幕后持续守护算力稳定运行的技术服务体系与保障团队。
华为云希望做的,正是让日益庞大的AI算力转化为更加可靠、稳定且持续的生产力。通过持续探索确定性运维能力,结合技术创新与专业服务,致力于帮助企业构建更加可靠、高效、智能的AI算力底座。
让每一份算力都能够释放更大的价值,支撑千行百业走向智能化未来。