一、面壁智能 MiniCPM5-2B「镜像+模型」上线,初具端侧通用 Agent 能力
近日,面壁智能联合 OpenBMB 开源社区正式开源新一代「小钢炮」MiniCPM5-2B。MiniCPM5-2B 的参数规模为 2B,是一款高密度端侧语言基座模型,支持工具调用、深度搜索、代码生成等任务,初步实现了端侧通用 Agent 雏形。
广大企业与开发者可在国家超算互联网 AI 社区使用基于众智 FlagOS 统一软件栈和国产异构加速卡适配的 MiniCPM5-2B 模型镜像,快速部署面向业务场景的 AI 应用服务。
同时,依托国家超算互联网海量国产算力资源池,以及平台安全可信的 Notebook 开发环境,开发者亦可在 AI 社区快速下载 MiniCPM5-2B 模型权重文件,开展二次开发、本地部署与技术研究。
MiniCPM5-2B 镜像地址:https://www.scnet.cn/ui/aihub/models/FlagOS/MiniCPM5-2B-BF16-hygon-FlagOS
MiniCPM5-2B 模型地址:
https://www.scnet.cn/ui/aihub/models?keyword=MiniCPM5-2B
根据国际知名权威榜单 Artificial Analysis Intelligence Index(以下简称「AA榜单」)的最新评测,MiniCPM5-2B 综合能力得分 23 分,在全球 4B 参数规模以下的开源基座模型中综合表现第一。
其中,在评测智能体能力的 Agentic Index 指标上,MiniCPM5-2B 更是断层式领先:总分高达 20 分,同级模型(如 LFM2.5-2.6B、Granite 4.2 3B、Mistral 3 3B)仅 2 分。
二、腾讯视觉文档检索模型 EVIE 上线,精确的视觉文档检索器
近日,腾讯发布 EVIE-8B 和 EVIE-4.5B 视觉文档检索模型,面向复杂版式文档提供视觉检索能力,它将页面中的不同区域表示为多个向量,再与查询匹配,有助于保留表格结构、图表和小字号文字等细节,适合接入企业文档检索与知识库。
官方以 Apache 2.0 许可开放模型权重、训练流程、压缩算法和评测套件。开发者可在超算互联网 AI 社区下载模型文件进行快速开发。
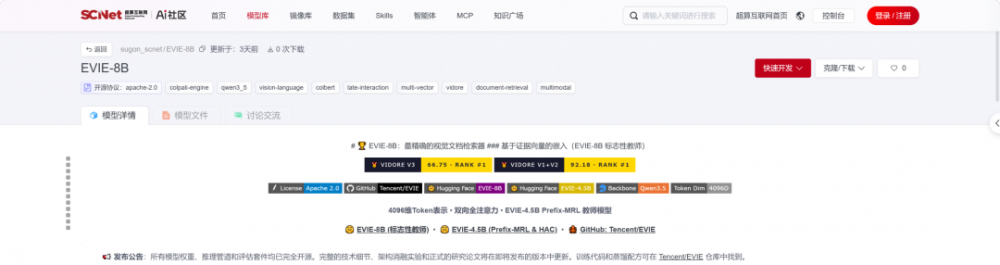
EVIE 突出亮点:
最高检索准确率:在 ViDoRe V3 上达到 66.75 nDCG@10,提供行业领先的视觉文档检索准确率。
高容量 4096D 表示:全token多向量嵌入,保留细粒度的布局、排版、图表和表格结构。
教师基础:为轻量级的 EVIE-4.5B Prefix-MRL 模型提供容量感知的关系和边缘蒸馏目标。
多基准 138 任务覆盖:在 4 个标准指标家族(nDCG、召回率、MAP、MRR @1/5/10)的 138 个任务(ViDoRe V1、V2、V3 和 JinaVDR)上进行了彻底验证。
一键直达 EVIE:https://www.scnet.cn/ui/aihub/models/sugon_scnet/EVIE-8B
三、 基元律动 NeoHorse-1 上线,Agent 驱动的模型训练
近日,基元律动(TokenRhythm)联合无问芯穹,与清华大学、北京大学、香港中文大学、阿里巴巴等合作伙伴发布 NeoHorse-1,包含 4B 和 9B 两个版本。该系列面向 Agent 场景训练,覆盖工具调用、任务规划、深度搜索和代码生成。
超算互联网 AI 社区即刻上线 NeoHorse-1,企业及开发者可下载模型文件进行二次部署、开发。
NeoHorse-1 4B 在 Agent 任务上的表现已超过多个参数量显著更大的通用模型;9B 版本在更复杂的推理与长程规划任务上表现更优。两个规模的后训练增益,都最突出地体现在 Agentic 任务上。
一键直达 NeoHorse-1:https://www.scnet.cn/ui/aihub/models/sugon_scnet/NeoHorse-1-9B
三、蚂蚁 Ling-3.0-flash-VL 上线,让视觉能力服务真实任务
近日,超算互联网 AI 社区上线蚂蚁百灵系列首个原生多模态大模型 Ling-3.0-flash-VL。模型基于 Ling-3.0-flash 的 MoE 架构拓展而来,总参数量为 124B,单次推理激活 5.5B 参数,原生支持图像、文本与视频输入,上下文窗口达到 256K Token。
在 Ling-3.0-flash-VL 的训练中,通过原生多模态联合训练,视觉信息的引入对模型的文本能力带来了正向提升。在 Artificial Analysis Intelligence Index v4.1.1 评估中,Ling-3.0-flash-VL 较纯文本版本(Ling-3.0-Flash)提升了 4 分; 在多模态综合评测中,模型也取得了不错的表现。这说明视觉不止是一种新的输入模态——来自图像和视频的信息,也在帮助模型建立对概念、空间、关系乃至现实世界更完整的理解。
理解视觉信息只是起点。真实任务往往要求模型根据视觉信息持续行动,并对行动结果负责。为此,Ling-3.0-flash-VL 引入了视觉反馈机制, 将任务从一次性生成,推进为"观察 → 行动 → 验证 → 修正"的持续闭环,使最终结果更接近真实可用、可验证的交付。
一键直达 Ling-3.0-flash-VL:https://www.scnet.cn/ui/aihub/models/sugon_scnet/Ling-3.0-flash-VL
四、蚂蚁扩散模型 LLaDA2.2-mini 上线,128K 上下文
近日,超算互联网 AI 社区上线蚂蚁 LLaDA2.2-mini,该模型是 LLaDA2 系列中智能体扩散语言模型的轻量级变体。它基于 LLaDA2.0-mini 架构构建,继承了 LLaDA2.2 系列的核心创新——Levenshtein 编辑(引入了 DELETE 和 INSERT 控制标记),从而支持长上下文工具调用、多轮交互和强大的错误纠正能力,同时保持更小的参数量和更低的推理成本。
LLaDA2.2-mini 核心特性如下:
高效的 128K 扩散架构:LLaDA2.2-mini 将上下文窗口扩展至 128K,并引入块路由(Block Routing) 机制,在扩散块级别限制 MoE 专家的激活,从而高效支持长上下文智能体任务。
Levenshtein 编辑:引入 DELETE 和 INSERT 控制标记,使扩散解码能够编辑序列结构、删除冗余内容,并在并行生成过程中创建插入点。
智能体强化学习:提出基于 Levenshtein 编辑 ELBO 的块级策略优化(L-EBPO),利用智能体环境奖励,在多轮工具使用场景中训练 Levenshtein 编辑与错误修正能力。
轻量高效:模型总参数量为 16B,推理时仅激活 1.4B 参数,在显著降低计算成本的同时保持强大能力。
一键直达 LLaDA2.2-mini:https://www.scnet.cn/ui/aihub/models/sugon_scnet/LLaDA2.2-mini



