首页 文章 精选 留言 我的

精选列表

搜索[爬虫框架],共10008篇文章
优秀的个人博客,低调大师

如何使用爬虫分析Python岗位招聘情况

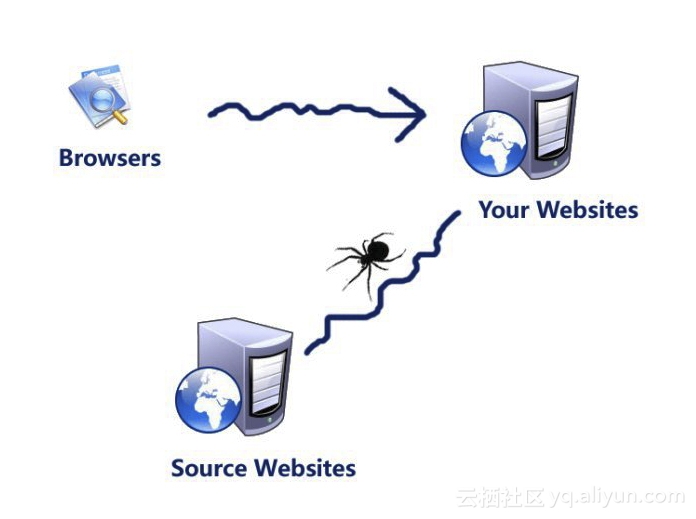
Life is short, you need Python。Python 是一门很优雅的语言,用着挺舒服的。所以就在想,现在的 Python 开发的岗位招聘,公司们需要什么样的人才?要有什么样的技能?以及对应的市场如何? 所以,我又有了一个大胆的想法。爬取了前程无忧上 Python 关键字的招聘岗位,地区锁定在中国四个一线城市,北上深广。选取 top650 条招聘岗位带 Python 关键字的招聘信息进行数据分析。 岗位分布 650 条招聘信息中,各城市岗位数量分布如下图。 上海 228 是最多的,北京 202 排在第二,两者都超过了 200,深圳和广州就和上海北京差得有点多了,分别只有 115 和 91,另外还有 14 个是异地招聘的。当然数据只是针对这前 650 条数据而言!不过总体上也差不多,后面的招聘信息都只是在岗位要求里提到

优秀的个人博客,低调大师

scrapy-splash 爬虫渲染异步加载,ajax

首先给出splash官网地址:http://splash.readthedocs.io/en/stable/api.html#render-html 1.安装和准备 (1)先安装scrapy-splash库: pip install scrapy-splash (2)然后将我们的docker起起来 docker run -p 8050:8050 scrapinghub/splash 如果关于docker安装还有更多的问题,请查考: splash安装文档 2.配置 (1)将splash server的地址放在你的settings.py文件里面,如果是你在本地起的,那地址应该是http://127.0.0.1:8050,我的地址如下 SPLASH_URL = 'http://192.168.99.100:8050' (2)在你的下载器中间件:download_middleware 里面启用如下的中间文件,注意启用的顺序 DOWNLOADER_MIDDLEWARES = { 'scrapy_splash.SplashCookiesMiddleware': 723, 'scrapy_splash.SplashMiddleware': 725, 'scrapy.downloadermiddlewares.httpcompression.HttpCompressionMiddleware': 810, } 另外注意: scrapy_splash.SplashMiddleware(725)的顺序是在默认的HttpProxyMiddleware(750)之前,要不然顺序的紊乱会造成功能的紊乱的 HttpCompressionMiddleware的优先级和顺序也应该适当的更改一下,这样才能更能处理请求 查看:https://github.com/scrapy/scrapy/issues/1895.里面提到的一些问题 (3)在settings.py启用SplashDeduplicateArgsMiddleware中间件 SPIDER_MIDDLEWARES = { 'scrapy_splash.SplashDeduplicateArgsMiddleware': 100, } (4)我们来设置一个去重的类 DUPEFILTER_CLASS = 'scrapy_splash.SplashAwareDupeFilter' (5)如果你使用scrapy http 缓存系统,那你就有必要启用这个scrapy-splash的缓存系统 HTTPCACHE_STORAGE = 'scrapy_splash.SplashAwareFSCacheStorage' 如果你有在你自己的settings.py里面启用DEFAULT_REQUEST_HEADERS ,请务必注释掉,目前看来是一个bug ,我已经给scrapy splash 官方提了这个bug https://github.com/scrapy-plugins/scrapy-splash/issues/67 该bug 是由于default_request_headers 里面的host 与我要爬的sougou不匹配,这当然会出错,不得不说scrapy的官方维护人反应真的很迅速。大家添加的headers的时候注意这些细节内容。 代码 # -*- coding: utf-8 -*- from scrapy import Request from scrapy.spiders import Spider from scrapy_splash import SplashRequest from scrapy_splash import SplashMiddleware from scrapy.http import Request, HtmlResponse from scrapy.selector import Selector class SplashSpider(Spider): name = 'scrapy_splash' # main address since it has the fun list of the products start_urls = [ 'https://item.jd.com/2600240.html' ] # allowed_domains = [ # 'sogou.com' # ] # def __init__(self, *args, **kwargs): # super(WeiXinSpider, self).__init__(*args, **kwargs) # request需要封装成SplashRequest def start_requests(self): # text/html; charset=utf-8 for url in self.start_urls: yield SplashRequest(url , self.parse , args={'wait': '0.5'} # ,endpoint='render.json' ) pass def parse(self, response): print "############"+response._url fo = open("html.txt", "wb") fo.write(response.body); # 写入文件 fo.close(); #本文只抓取一个京东链接,此链接为京东商品页面,价格参数是ajax生成的。会把页面渲染后的html存在html.txt #如果想一直抓取可以使用CrawlSpider,或者把下面的注释去掉 '''site = Selector(response) links = site.xpath('//a/@href') for link in links: linkstr=link.extract() print "*****"+linkstr yield SplashRequest(linkstr, callback=self.parse)'''

优秀的个人博客,低调大师

欢迎使用CSDN-markdown编辑器Python爬虫初接触,学会爬虫不抓美女图片干啥!

学习编程语言是很枯燥的,尤其是对一个编程零基础的人来说,更为枯燥!所以我们要从枯燥的学习中找点乐趣和动力!比如,抓点小姐姐的图片 我们的目标选择唯一图库,url自己去找【人工呲牙笑】 这个网站没有反爬,特别好爬,打开主页后,找到美女图片分类 上面分类没有这个分类,自己想办法进入哦。。。 然后往下拉,就会发现N多的图集,我们先去找找翻页,记得先打开F12开发者工具,然后选择翻页,查看源代码中位置! 可以看到这里就是控制页面翻页的源代码了,我们直接拿到a标签的href属性,这个是最后一页的地址,将属性中的“789”切出来,就拿到了最大页码,然后循环拿到所有页面的url,如下图 这样就拿到所有页面的url了,然后我们取图集的url,同样的方式,找到源码中url的位置 img_urls = etree.HTML(requests.get(url_i).text).xpath('//div[@class="ABox"]/a/@href') #url_i 是页面的url,也就是上个代码截图中那个列表,循环遍历出来的 一行代码就取到了所有a标签下的图集地址,一页有24个图集!这里我们用一个函数来获取所有图集内图片地址并返回图集名字和图片地址 这样,主要内容就写完了,然后就是构建整个代码,写入本地,我还将之前做的进度条也加进去了,整体代码和效果发出来看看! import os import time import requests from lxml import etree def get_img_url(url): ''' :param url: 图集url :return: 图集名字和图片地址所构成的字典 ''' img = {}#空字典,用于放图片url和对应的编号 html = requests.get(url)#获取页面源码 html.encoding = 'gb2312' data = etree.HTML(html.text)#解析 title = data.xpath('//div[@class="wrapper clearfix imgtitle"]/h1/text()')[0]#图集名 page = data.xpath('//div[@class="wrapper clearfix imgtitle"]/h1/span/span[2]/text()')[0]#图集图片数 img['1'] = data.xpath('//a[@class="down-btn"]/@href')[0]#第一张的图片地址 for i in range(2,int(page)+1): #其余的图片地址 img_url = etree.HTML(requests.get(url.replace('.html','_%s.html'%str(i))).text).xpath('//a[@class="down-btn"]/@href')[0] img['%s'%str(i)] = img_url#写入字典 return title,img def downloader(url,path,name,header={}): start = time.time()#开始时间 if os.path.exists(path): # 判断路径及文件夹是否存在,不存在即创建 pass else: os.mkdir(path) size = 0 if header is None: response = requests.get(url, stream=True)#stream属性必须带上 else: response = requests.get(url, stream=True,headers=header)#stream属性必须带上 chunk_size = 1024#每次下载的数据大小 content_size = int(response.headers['content-length'])#总大小 if response.status_code == 200: print('[文件大小]:%0.2f MB' % (content_size / chunk_size / 1024))#换算单位并print with open(path+'\\%s'%name, "ab") as file: for data in response.iter_content(chunk_size=chunk_size): file.write(data) file.flush()#清空缓存 size += len(data)#已下载文件大小 #\r指定行第一个字符开始,搭配end属性完成覆盖进度条 print('\r'+'[下载进度]:%s%.2f%%' % ('>'*int(size*50/ content_size),float(size / content_size * 100)),end='') end = time.time()#结束时间 print('\n'+"%s下载完成!用时%.2f秒"%(name,(end-start))) if __name__ == '__main__': url_list=[]#放入所有页面url url = 'http://www.mmonly.cc/mmtp/' url_list.append(url)#先放入第一页 html = requests.get(url) html.encoding = 'gb2312' page = etree.HTML(html.text).xpath('//a[text()="末页"]/@href')[0].split('_')[-1].split('.')[0] for i in range(2,int(page)+1): url_list.append(url+'list_9_{}.html'.format(str(i)))#其余页面url,注意第一页和其他页不一样 for url_i in url_list: img_urls = etree.HTML(requests.get(url_i).text).xpath('//div[@class="ABox"]/a/@href') for img_url in img_urls: title,imgs = get_img_url(img_url) for img in imgs.keys(): path = 'E:\\python\\mn\\%s' % title downloader(url= imgs[img],path=path,name='%s.jpg'%(title+img)) 其实这里我想说的是,整个网站很标题党。。。完全不符合标题的。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册