首页 文章 精选 留言 我的

精选列表

搜索[Arch Linux],共10000篇文章
优秀的个人博客,低调大师

Linux CentOS6编译安装Python2.7

CentOS6.x系统中一直沿用的都是Python2.6.x(目前最新版本是python-2.6.6),有时不能满足某些应用生产环境和开发环境的需要,直接从yum官方仓库和epel中安装Python2.7(目前最新版本是python-2.7.12)似乎也是没有什么可能,除非使用更三方的软件源。CentOS6.x系统中有很多系统组件是使用Python2.6的,比如刚才提到的yum,但yum不一定是唯一依赖Python2.6的程序,尽管一般的生产环境中不会使用到特别混杂的运行环境,但在使用的过程中需要留意某些工具&程序是否能在Python2.7下正常运行。 安装Python2.7.x实际上非常简单,唯一需要了解的是,编译安装Python2.7.x时必须将使用--enable-shared (enable building shared python library)选项用来安装python动态链接库(share object, /usr/lib64/libpython2.7.so.1.0),这一文件会被很多python模块(甚至python本身)所用到,当没有使用这一选项时可以加上这个选项重新编译Python,步骤见下文。 下载地址:https://www.python.org/downloads/ wget-chttps://www.python.org/ftp/python/2.7.12/Python-2.7.12.tgz wget-chttps://www.python.org/ftp/python/2.7.12/Python-2.7.12.tgz.asc wgethttps://www.python.org/static/files/pubkeys.txt gpg--importpubkeys.txt gpg--recv-keys6A45C816365802887D9DC8D218ADD4FFA4135B38A74B06BFEA5BBD71ED9D77D5E6DF025CAA65421D6F5E1540F73C700D487034E5 gpg--verifyPython-2.7.12.tgz.asc#Goodsignature tarzxfPython-2.7.12.tgz cdPython-2.7.12/ yuminstall-ygccgcc-c++openssl-devel ./configure--enable-shared make&&makeinstall echo'/usr/local/lib'>/etc/ld.so.conf.d/libpython2.7.conf ldconfig python--version sed-i'1s/python/python2.6/g'/usr/bin/yum wgethttps://bootstrap.pypa.io/ez_setup.py pythonez_setup.py#setuptools easy_install--version wgethttps://bootstrap.pypa.io/get-pip.py pythonget-pip.py#pip pip--version tag: CentOS Python2.7,centos安装python2.7,编译安装python2.7--end--

优秀的个人博客,低调大师

Linux基础之sed流编辑器详解

之前介绍了三大文本编辑器的grep,这里介绍比grep功能更强的sed流编辑器 sed是什么? sed是Stream EDitor的缩写,man中对sed的简介为 sed - stream editor for filtering and transforming text 它的主要功能是对文本的过滤与替换。 sed的工作原理 sed的工作过程:sed是一个流编辑器,所谓流编辑器是指sed每次只从文件或stdin中读入一行,将读入的行保存至模式空间然后根据指定的要求对其进行处理,并将处理后的结果输出至屏幕,接着读入下一行,整个文本的过程如流水线般被逐行处理后输出。 sed对内容的处理方式:sed不是在原文件中或原输入上直接进行处理的,它将读入的行放入缓存区,对缓存区里的内容进行处理,处理完毕后默认不会写入或覆盖源文件,而是直接输出到屏幕上。 它有两个内存缓冲区分别叫做:模式空间(pattern space)、保持空间也有称作暂存缓存区(holding space)。 一般情况下sed首先把第一行装入模式空间,进行处理后输出屏幕,然后第二行装入模式空间替换掉模式空间里原来的内容,再进行处理,依次循环,直至结束。 下面是我对sed工作流程的理解图。 1、sed每次将stdin中的内容中的一行读入模式空间 2、之后根据模式空间中的匹配条件进行匹配,符合条件进入下一阶段即普通编辑,不满足则默认至标准输出,结束 3、普通编辑之后分三个阶段,1)普通编辑之后选择性显示至STDOUT,结束;2)进入holding space进行高级编辑,编辑结束后选择性显示至模式空间,之后再次根据编辑命令重复2-3过程;3)若是出现多编辑命令则需要再返回模式空间根据编辑条件再次进行2-3步骤。 限于个人理解程度上述的理解免不了跟真实的工作流程有些出入,大家要抱着质疑的态度去看,我写的不一定都是对的,不过错的应该不至于很多。 sed语法 sed OPTIONS... <SCRIPT>[INPUTFILE...] [SCRIPT]:可以理解为地址定界加编辑命令。 常用选项: -n:不输出模式空间中的内容至屏幕;通俗点可以理解为它可以自动过滤掉模式空间中未匹配到的行,-n 要与命令编辑中的p合用(命令编辑见下文),用于显示模式空间中被匹配到的内容。 suppress automatic printing of pattern space -n的具体应用见后面的sed编辑高级命令演示 -e:多点编辑 add the script to the commands to be executed -f:每行一个编辑命令 add the contents of script-file to the commands to be executed -r:使用扩展表达式 use extended regular expressions in the script. -i:直接编辑原文件 edit files in place (makes backup if SUFFIX supplied) SCRIPT: 之前对这块很迷糊,因为info中sed显示语法有[]表示可加可不加,于是就在sed后直接加想要编辑的文本 于是就出现如下情况 [root@localhosttest]#sedsed1 sed:-e表达式#1,字符4:未终止的“s”命令 报错信息没找到终止的限制条件,所以上面的sed语法格式并不准确。 通过实验,sed可以不加[OPTION]但是[SCRIPT]则必须添加 SCRIPT分两部分:地址定界(用于限定编辑文本的范围)、编辑命令(用于对匹配到的内容进行什么样的操作或编辑),前者可少后者必不可少,如果没有编辑的命令会发生如下错误 [root@localhosttest]#sed'1'cat1 sed:-e表达式#1,字符1:遗漏命令 [root@localhosttest]#catcat1 hi,everyone nowIwillshowhowtousecat [root@localhosttest]#sed'p'cat1 hi,everyone hi,everyone nowIwillshowhowtousecat nowIwillshowhowtousecat 地址定界: 1、空地址:对全文处理。 2、单地址: #:指定行; /pattern/:被此模式所匹配到的每一行; 3、地址范围: #,#:从#开始到#结束的所有行 #,+#:从#开始向下至+#的行之间的所有行 #,/pat1/ 从#开始至匹配到第一次出现/pat1/模式的行之间的所有行 /pat1/,/pat2/:第一次匹配到/pat1/的行到第一次匹配到/pat2/的行之间的所有行 4、步进:~ 1~2:所有奇数行 2~2:所有偶数行 编辑命令:若少了编辑命令会报错,编辑命令在SCRIPT中至少出现一次。 d:删除模式空间中匹配到的内容 Delete pattern space a \text 在行后面插入文本“text”,支持使用\n实现多行插入 Append text, which has each embedded newline preceded by a back slash. i \text 在行前面插入文本“text”,支持使用\n实现多行插入 Insert text, which has each embedded newline preceded by a back slash. c\text 把匹配到的行替换为此处指定的文本“text” Replace the selected lines with text, which has each embedded new line preceded by a backslash. w filename 保存模式空间匹配的行至指定的文件中 Write the current pattern space to filename. r filename 读取指定文件内容至当前文件被模式匹配到的行文件后合并 Append text read from filename. = : 为模式匹配到的行打印行号 Print the current line number. !: 条件取反(它比较特殊,它必须跟其他编辑命令一起使用) s/regexp/replacement/ : 查找替换,其分隔符可自行指定,常用有s@@@,s### 它有一个特殊的用法s//x&/:表示将被查找的内容在其前面添加x内容 s//&x/:表示将被查找的内容在其后面添加x内容 &代表被查找的内容 [root@localhosttest]#catcat1 hi,everyone nowIwillshowhowtousecat [root@localhosttest]#sed's/e/&#/'cat1 hi,e#veryone nowIwillshowhowtouse#cat [root@localhosttest]#sed's/e/#&/'cat1 hi,#everyone nowIwillshowhowtous#ecat p :显示替换成功的行 g :全局替换 w filename : 将替换成功的结果保存至指定文件中 查找替换在sed中应用很广,下面很多例子都是以sed的替换功能实现的 p :显示当前模式空间中的内容 Print the current pattern space. 注:同时使用多个编辑命令,命令之间要用;隔开(!除外) 例子如下: [root@localhosttest]#sed'p;='cat1 hi,everyone 1 hi,everyone nowIwillshowhowtousecat 2 nowIwillshowhowtousecat 实例演示: 1、删除/etc/grub2.conf文件中所有以空白开头的行行首的空白字符 sed's#^[[:space:]]\+##'/etc/grub2.cfg 这里##是将前面匹配到的内容删除的意思,上面文本内容太多,就不截取了。 2、删除/etc/fstab文件中所有以#开头,后面至少跟一个空白字符的行的行首的#号及#后面的所有空白字符 sed's@^#[[:space:]]\+@@'/etc/fstab [root@localhosttest]#cat/etc/fstab # #/etc/fstab #CreatedbyanacondaonTueJul1923:52:412016 # #Accessiblefilesystems,byreference,aremaintainedunder'/dev/disk' #Seemanpagesfstab(5),findfs(8),mount(8)and/orblkid(8)formoreinfo # /dev/mapper/centos-root/xfsdefaults00 UUID=6efb8a23-bae1-427c-ab10-3caca95250b1/bootxfsdefaults00 /dev/mapper/centos-swapswapswapdefaults00 [root@localhosttest]#sed's@^#[[:space:]]\+@@'/etc/fstab # /etc/fstab CreatedbyanacondaonTueJul1923:52:412016 # Accessiblefilesystems,byreference,aremaintainedunder'/dev/disk' Seemanpagesfstab(5),findfs(8),mount(8)and/orblkid(8)formoreinfo # /dev/mapper/centos-root/xfsdefaults00 UUID=6efb8a23-bae1-427c-ab10-3caca95250b1/bootxfsdefaults00 /dev/mapper/centos-swapswapswapdefaults00 3、在/etc/fstab每一行行首增加#号 cat/etc/fstab # #/etc/fstab #CreatedbyanacondaonTueJul1923:52:412016 # #Accessiblefilesystems,byreference,aremaintainedunder'/dev/disk' #Seemanpagesfstab(5),findfs(8),mount(8)and/orblkid(8)formoreinfo # /dev/mapper/centos-root/xfsdefaults00 UUID=6efb8a23-bae1-427c-ab10-3caca95250b1/bootxfsdefaults00 /dev/mapper/centos-swapswapswapdefaults00 sed's@^@#&@'/etc/fstab # ## ##/etc/fstab ##CreatedbyanacondaonTueJul1923:52:412016 ## ##Accessiblefilesystems,byreference,aremaintainedunder'/dev/disk' ##Seemanpagesfstab(5),findfs(8),mount(8)and/orblkid(8)formoreinfo ## #/dev/mapper/centos-root/xfsdefaults00 #UUID=6efb8a23-bae1-427c-ab10-3caca95250b1/bootxfsdefaults00 #/dev/mapper/centos-swapswapswapdefaults00 4、处理/etc/fstab路径,使用sed命令取出其目录名和基名 目录名: [root@localhosttest]#echo'/etc/fstab'|sed-r's#(.*/)([^/]+/?)#\1#' /etc/ 基名: [root@localhosttest]#echo'/etc/fstab'|sed-r's#(.*/)([^/]+/?)#\2#' fstab sed高级编辑命令: h:把模式空间中的内容覆盖至保持空间中; H:把模式空间中的内容追加至保持空间中; g:把保持空间中的内容覆盖至模式空间中; G:把保持空间中的内容追加至模式空间中; x:把模式空间中的内容与保持空间中的内容互换; n:覆盖读取匹配到的行的下一行至模式空间中; N:追加读取匹配到的行的下一行至模式空间中; d:删除模式空间中的行; D:删除多行模式空间中的所有行; 我知道看了上面这些高级命令一定很晕,下面通过5个例子来理一下使用sed高级编辑命令的思路 高级编辑命令实例演示: 1、 sed -n 'n;p' FILE: ''内意思:将读取到的行的下一行内容显示至模式空间 -n 'p':将模式空间中被匹配到的内容显示至屏幕 二者结合起来就是只显示偶数行。 [root@localhosttest]#cat-ncat1 1hi,everyone 2nowIwillshowhowtousecat [root@localhosttest]#sed-n'n;p'cat1 nowIwillshowhowtousecat 2、 sed '1!G;h;$!d' FILE: 这个命令按'x;x;x'中的;号分割分为三部分: 1、1!G:除读取的第一行都进行G编辑 2、h:将模式空间中的内容覆盖至保持空间中 3、$!d:删除非最后一行的内容 命令解释完了,我想大家对此应该还是一头雾水,那么就具体说明这个命令的意思: 1)读取文本信息的1行内容至模式空间,由于是第一行所以模式空间中的1行不进行G操作,之后触发h,将模式空间中的1行放入保持空间中,再之后触发$!d,由于1行不是最后一行,所以将模式空间中的1行删除; 2)读取2行内容至模式空间,由于不是1行所以触发G操作,将保持空间中1行追加到2行后面,此时模式空间中的顺序内容为2行,1行,之后h命令将模式空间中内容覆盖至保持空间中,此时保持空间内容为2行,1行,因为2行不是最后一行,所以$!d删除模式空间中内容; 3)上述过程不断重复,直到最后一行时不进行d操作,此时模式空间中的第一行就是原文件的最后一行。 因此这个命令就是原文件内容反过来的排列。 [root@localhosttest]#catcat1 hi,everyone nowIwillshowhowtousecat [root@localhosttest]#sed'1!G;h;$!d'cat1 nowIwillshowhowtousecat hi,everyone 3、 sed '$!d' FILE: 经过了上面两个命令的磨练,这个就显得简单了。 '$!d':不是最后一行则删除 意思是说模式空间中只保留文本的最后一行 [root@localhosttest]#sed'$!d'cat1 nowIwillshowhowtousecat 4、 sed '/^$/d;G' FILE '/^$/d':查找模式空间中的每行是否包含空白行,若包含则将其删除 G:将保持空间中的内容追加至模式空间中的每行后面 删除原有的所有空白行,而后为所有的非空白行后添加一个空白行; 二者结合在一起即:保证指定文件每一行后方有且只有一个空白行 [root@localhosttest]#sed'/^$/d;G'cat1 hi,everyone nowIwillshowhowtousecat 5、 sed 'n;d' FILE:显示奇数行; 这个就很简单了,大家按照sed的工作原理及编辑命令n与d很容易就能明白其所表达的意思 [root@localhosttest]#catcat1 hi,everyone nowIwillshowhowtousecat [root@localhosttest]#sed'n;d'cat1 hi,everyone 学习sed的一些感受 学习sed如果对于sed的编辑命令或高级命令很困惑,那么不妨试试照着我上面的sed工作流程图,一步一步的自己画图分析每一步所代表的意思。这既能加强自己对sed这个工具的了解也可有助于理清我们的使用思路。这是我在学习过程中觉得很有用的一种方法。 sed这个工具它的精髓在于它的替换,替换的精髓在于精确匹配,而精确匹配又离不开正则表达式的,所以如果觉得自己对于替换很不擅长的话那么可以好好练习一下正则表达式。 sed是一个实用性很强的文本编辑工具,由于能力所限,也只能对sed进行下简要的介绍,大家若对其有进一步的兴趣可以查找更专业的书籍。

优秀的个人博客,低调大师

《Linux内核设计的艺术:图解Linux操作系统架构设计与实现原理》——2.5 异常处理类中断服务程序挂接

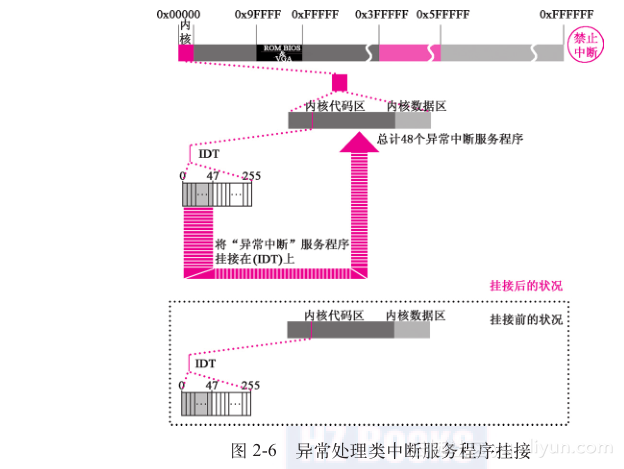
2.5 异常处理类中断服务程序挂接 不论是用户进程还是系统内核都要经常使用中断或遇到很多异常情况需要处理,如CPU在参与运算过程中,可能会遇到除零错误、溢出错误、边界检查错误、缺页错误……免不了需要“异常处理”。中断技术也是广泛使用的,系统调用就是利用中断技术实现的。这些中断、异常都需要具体的服务程序来执行。trap_init()函数将中断、异常处理的服务程序与IDT进行挂接,逐步重建中断服务体系,支持内核、进程在主机中的运算。挂接的具体过程及异常处理类中断服务程序在IDT中所占用的位置如图2-6所示。 执行代码如下: //代码路径:init/main.c: void main(void) { … trap_init(); … } //代码路径:kernel/traps.c: void trap_init(vo

优秀的个人博客,低调大师

Linux 串口设备号漂移的 udev 规则工程实践

## 一、设备号为什么会漂移 ### 1.1 内核枚举顺序不是稳定契约 USB 转串口设备插入时,内核按枚举完成的先后顺序分配次设备号。`/dev/ttyUSB0` 这个编号来自驱动 `usb_serial` 的 `minor` 分配,先枚举完成的拿小编号。枚举顺序受 USB 总线拓扑、hub 端口、主机控制器调度影响,同一台机器上重启两次都可能不同。多口设备的四个通道在一次枚举中连续分配,但不同设备之间没有顺序保证。 程序用 `open("/dev/ttyUSB0")` 绑定设备,就是在赌枚举顺序。这个赌局在单设备场景下几乎总赢,一旦现场有两台以上同类设备就必输。典型的失败现场是产线工装,扫码枪和 PLC 同时接在同一个 hub 上,某次上电后扫码枪拿到 ttyUSB1,程序把心跳帧发给扫码枪,PLC 收不到指令,产线停 40 分钟。 `/dev/serial/by-id/` 和 `/dev/serial/by-path/` 是内核与 udev 提供的稳定入口,但它们是符号链接,指向的仍是 ttyUSBx。程序直接 open 这两个路径可以绕开编号问题,代价是路径长度可达 120 字节以上,部分老代码的固定长度缓冲区会截断。更彻底的做法是自建 symlink,名字由业务定义。 ### 1.2 udev 在设备节点出现之后才介入 内核先创建 `/dev/ttyUSB0` 设备节点,再通过 netlink 广播 `uevent`,udev 收到后匹配规则、创建符号链接、设置权限。这个顺序决定了两件事。第一,符号链接的出现晚于设备节点,程序如果在 `uevent` 处理完成前就 open,会拿到 ENOENT。第二,udev 规则不改变内核分配的编号,只是增加别名。 ![udev 从内核 uevent 到设备节点与符号链接的处理时序](https://developer.qcloudimg.com/http-save/yehe-9147031/ce69ec0008e2821df02e5f80846151ab.png) 冷启动时 udev 处理全部设备的 `uevent`,单条规则的处理时间在 1 到 5 毫秒量级,上百条规则叠加后整体延迟可达数百毫秒。热插拔单设备通常在 50 毫秒内完成。程序如果在 systemd 服务里 `After=dev-ttyUSB0.device`,systemd 等待的是设备节点的 `systemd-udev-settle` 完成,不是自定义符号链接就绪。这个差异是后面 DeviceAllow 一节里最常见的事故源。 ### 1.3 反例 用 lsusb 输出写规则 有人用 `lsusb` 看到 `ID 0403:6001 Future Technology Devices International, Ltd FT232 Serial`,就把 `ATTRS{idVendor}=="0403"` 写进规则。FT232 是全市场最通用的芯片,同型号设备有几十个,规则会同时匹配所有 FT232 设备,符号链接被最后一个匹配的设备覆盖。这是 90% 规则失效的第一类原因,匹配条件过宽。 ## 二、udev 匹配的三层优先级 ### 2.1 内核属性层 最稳定 `KERNEL`、`SUBSYSTEM`、`DRIVER` 由内核直接给出,不依赖设备描述符内容。`KERNEL=="ttyUSB[0-9]*"`、`SUBSYSTEM=="tty"`、`DRIVER=="ftdi_sio"` 属于这一层。这一层的信息量最少,只能区分设备类别,无法区分同型号的不同个体。规则里这一层通常作为前置过滤,缩小匹配范围。 ### 2.2 设备属性层 区分个体的关键 `ATTRS{}` 从 USB 设备描述符读取,`idVendor`、`idProduct`、`serial`、`manufacturer`、`product` 都在这一层。`ATTRS{serial}` 是区分同型号设备的核心字段,但很多廉价转串口芯片的 serial 是空串或固定值。 FTDI 原厂芯片出厂 serial 唯一,CH340 大量批次 serial 为空,CP2102 部分型号 serial 全为 `0001`。规则里写 `ATTRS{serial}=="0001"` 会匹配所有 CP2102,等于没写。判断方法是用 `udevadm info -a -n /dev/ttyUSB0` 查看 `ATTRS{serial}` 的实际值,空串在规则里无法作为有效条件。 ### 2.3 环境变量层 由 udev 内置规则填充 `ENV{ID_VENDOR_ID}`、`ENV{ID_MODEL_ID}`、`ENV{ID_SERIAL}` 由 `/usr/lib/udev/rules.d/60-serial.rules` 和 `70-usb-*` 系列规则计算得出。它们不是内核给的,是 udev 在匹配过程中逐步赋值的。这带来一个执行顺序陷阱,规则文件名数字前缀小于填充这些变量的规则时,`ENV{ID_SERIAL}` 还是空值,匹配必然失败。 | 变量 | 来源 | 稳定性 | 典型值 | |------|------|--------|--------| | `ID_VENDOR_ID` | udev 从 idVendor 转换 | 高 同型号相同 | `0403` | | `ID_MODEL_ID` | udev 从 idProduct 转换 | 高 同型号相同 | `6001` | | `ID_SERIAL` | vendor+model+serial 拼接 | 中 取决于 serial 是否唯一 | `FTDI_FT232R_USB_UART_A50285BI` | | `ID_SERIAL_SHORT` | 仅 serial 字段 | 中 | `A50285BI` | | `ID_PATH` | 物理端口路径 | 高 但换端口即变 | `pci-0000:00:14.0-usb-0:2:1.0` | `ID_VENDOR_ID` 和 `ID_MODEL_ID` 组合只能定位型号,`ID_SERIAL` 才能定位个体。三者都受 udev 内置规则执行顺序影响,自定义规则文件名必须以大于 70 的数字开头,否则变量尚未赋值。这是第二类规则失效原因,占现场问题的三成左右。 ### 2.4 反例 在 50- 开头的规则里用 ID_SERIAL ``` # 错误示范 文件名 50-mydevice.rules SUBSYSTEM=="tty", ENV{ID_SERIAL}=="FTDI_FT232R_USB_UART_A50285BI", SYMLINK+="plc" ``` `60-serial.rules` 才计算 `ID_SERIAL`,50 号规则执行时该变量为空,条件永不成立。规则不报错,只是静默不生效。排查时 `udevadm test` 能看到变量在后续规则里才出现,但很多人不知道要看这个输出。 ## 三、规则文件的写法 ### 3.1 匹配条件的组合方式 匹配条件之间是逻辑与。`ATTRS{}` 会向上遍历设备树的所有父节点,`ATTR{}` 只看当前设备节点。对 tty 设备,`idVendor` 在 USB 接口的父节点上,必须用 `ATTRS{}`。用 `ATTR{}` 匹配 `idVendor` 永远失败,这是第三类常见错误。 ``` # /etc/udev/rules.d/99-serial-fixed.rules # 数字前缀 99 保证在 60-serial.rules 之后执行 此时 ID_SERIAL 已赋值 # 匹配条件用 ATTRS 因为 idVendor 在父节点 不是当前 tty 节点 SUBSYSTEM=="tty", KERNEL=="ttyUSB[0-9]*", \ ATTRS{idVendor}=="0403", ATTRS{idProduct}=="6001", \ ATTRS{serial}=="A50285BI", \ SYMLINK+="ttyPLC", MODE="0660", GROUP="dialout" # 第二台同型号设备 serial 不同 各自独立符号链接 SUBSYSTEM=="tty", KERNEL=="ttyUSB[0-9]*", \ ATTRS{idVendor}=="0403", ATTRS{idProduct}=="6001", \ ATTRS{serial}=="A50286CD", \ SYMLINK+="ttyScanner", MODE="0660", GROUP="dialout" ``` `SYMLINK+="ttyPLC"` 的加号表示追加,同一设备可以有多条符号链接。不加加号是覆盖,多条规则匹配同一设备时只有最后一条生效。符号链接默认建在 `/dev/` 下,写绝对路径会报错。 ### 3.2 SYMLINK 与 GROUP/MODE 的配合 `MODE="0660"` 和 `GROUP="dialout"` 作用于设备节点本身,不是符号链接。符号链接的权限由目标节点决定。设备节点默认属主 root、属组 dialout 的发行版(Debian、Ubuntu)不需要额外设置,属组改成 root 的发行版(部分 RHEL 配置)必须显式指定 GROUP,否则普通用户 open 返回 EACCES。 `MODE` 的数值是八进制,写 `0660` 不能写 `660`,后者会被解析成十进制 660 即八进制 1224,权限位错乱。这个错误在复制粘贴场景里很常见。 服务以非 root 运行时,除了文件权限还要看 SELinux 或 AppArmor。SELinux 下 tty 设备的标签是 `tty_device_t`,自定义符号链接不改变标签,`ls -Z /dev/ttyPLC` 能看到实际标签。策略没放行时 open 返回 EACCES,`ausearch -m avc` 能看到拒绝记录。 ### 3.3 规则文件命名与执行顺序 `/etc/udev/rules.d/` 下的文件按文件名字典序执行,数字前缀决定顺序。同名前缀不同后缀(`.rules` 与 `.rules.d`)不冲突,但同一目录下同名文件后者覆盖前者。发行版自带规则在 `/usr/lib/udev/rules.d/`,`/etc/` 下同名文件优先,这是覆盖系统规则的唯一正确方式,直接改 `/usr/lib/` 下的文件会在系统升级时被覆盖。 自定义规则建议用 90 到 99 的前缀。小于 60 会和变量填充规则竞争,大于 99 没有实际意义,udev 不限制上限但排序结果不变。 ### 3.4 反例 用 RUN 启动程序 ``` # 错误示范 在规则里拉起业务进程 SUBSYSTEM=="tty", ATTRS{serial}=="A50285BI", RUN+="/usr/local/bin/myapp" ``` `RUN` 在 udev 工作进程里同步执行,有 180 秒超时限制,超时后 udev 杀掉整个进程组。业务进程常驻会占住 udev worker,后续所有设备的 `uevent` 处理被阻塞,表现为「插别的设备没反应」。正确做法是 `RUN` 里只做轻量动作(发信号、touch 文件),常驻进程交给 systemd 管理。 ## 四、reload 与 trigger 的时机 ### 4.1 两者职责不同 `udevadm control --reload-rules` 只重新加载规则文件到内存,不重新处理已有设备。新插入的设备用新规则,已存在的设备仍是旧状态。`udevadm trigger` 重新广播 `uevent`,让 udev 对已有设备重新跑一遍规则。改完规则文件后两条都要执行,顺序是先 reload 再 trigger。 ``` # 修改规则后的标准动作 两条缺一不可 sudo udevadm control --reload-rules # --action=add 只重放添加事件 避免 change 事件触发无关规则 # --subsystem-match=tty 限定范围 全量 trigger 在设备多的机器上耗时数秒 sudo udevadm trigger --action=add --subsystem-match=tty # 验证 符号链接应在 1 秒内出现 ls -l /dev/ttyPLC # 查看规则匹配过程 输出里能看到每条规则的命中情况 sudo udevadm test /sys/class/tty/ttyUSB0 ``` `udevadm test` 的输出里 `Reading rules file` 逐条列出,能直接看到哪条规则的条件不满足。这是排查规则失效最快的手段,比反复插拔设备快一个数量级。 ### 4.2 冷启动与热插拔的差异 `trigger` 重放的是 `add` 事件,和冷启动时内核发出的事件类型一致。但冷启动时 udev 处理的是 initramfs 切换根文件系统后的批量事件,规则文件可能还没挂载完成。把规则放在独立分区、`/etc` 由 initramfs 延迟挂载的嵌入式系统上,早期事件会因规则文件不存在而跳过,设备节点的符号链接缺失直到下次热插拔。 嵌入式设备上更稳的做法是把关键规则编译进 initramfs,或者用 systemd 的 `systemd-udev-settle.service` 等待 settle 完成后再启动依赖服务。settle 的默认超时 120 秒,设备多的机器上会拖慢启动,代价是启动时间增加。 ### 4.3 反例 只 reload 不 trigger 现场改完规则,`systemctl restart myservice` 后服务仍报找不到 `/dev/ttyPLC`。原因是符号链接没重建,服务启动时 open 失败。这类问题在远程运维场景里反复出现,因为 reload 命令看起来「已经生效」了。判断方法是用 `stat /dev/ttyPLC` 看 inode 时间戳,早于规则文件修改时间就说明没 trigger。 ## 五、systemd 服务里的 DeviceAllow ### 5.1 设备白名单的匹配粒度 `DeviceAllow=` 的单位是设备节点路径,支持 `char-*` 通配。`DeviceAllow=/dev/ttyUSB0 rw` 只放行这一个节点,符号链接 `/dev/ttyPLC` 指向的节点不在白名单时 open 返回 EPERM。这是 DeviceAllow 最隐蔽的坑,因为文件权限看起来完全正确。 ``` # /etc/systemd/system/myapp.service [Unit] Description=Serial gateway # 等待设备单元就绪 但注意这只等内核节点 不等自定义符号链接 After=dev-ttyUSB0.device BindsTo=dev-ttyUSB0.device [Service] ExecStart=/usr/local/bin/myapp # 白名单按真实节点写 符号链接不参与匹配 DeviceAllow=/dev/ttyUSB0 rw DeviceAllow=char-ttyUSB rw # 关闭默认的全量设备访问 白名单才生效 PrivateDevices=no DevicePolicy=closed Restart=on-failure RestartSec=2 [Install] WantedBy=multi-user.target ``` `DevicePolicy=closed` 是白名单生效的前提。默认策略是 `auto`,此时 `DeviceAllow` 只做补充不做限制,写了等于没写。这个默认值让很多人误以为白名单已经生效。 ### 5.2 BindsTo 与符号链接的时序 `After=dev-ttyUSB0.device` 保证服务在设备节点出现后启动,但符号链接由 udev 规则创建,可能晚于设备单元就绪。服务启动时 open `/dev/ttyPLC` 拿到 ENOENT,`Restart=on-failure` 会重试,`RestartSec=2` 下最多重试 5 次(默认 `StartLimitBurst=5`),全部失败后服务进入 failed 状态,需要 `systemctl reset-failed` 才能再启动。 更稳的做法是服务启动时先 open 真实节点路径(从环境变量或配置文件读),符号链接只作为运维便利。或者用 `ExecStartPre` 加一个小循环等待符号链接出现,超时 10 秒退出。 ``` #!/bin/sh # /usr/local/bin/wait-symlink.sh 等待符号链接就绪 最多 10 秒 # 每 100 毫秒检查一次 嵌入式设备上 udev 处理通常在 200 毫秒内完成 i=0 while [ $i -lt 100 ]; do [ -e /dev/ttyPLC ] && exit 0 sleep 0.1 i=$((i + 1)) done echo "timeout waiting /dev/ttyPLC" >&2 exit 1 ``` ### 5.3 反例 DeviceAllow 写成符号链接 ``` # 错误示范 符号链接不在设备白名单匹配范围 DeviceAllow=/dev/ttyPLC rw ``` systemd 解析 `DeviceAllow` 时对路径做 `stat`,符号链接解析到真实节点后按理应能匹配,但 systemd 在服务启动时解析一次并缓存,符号链接尚未创建时解析失败,白名单为空,服务内所有设备访问被拒。现场表现是 `EPERM` 且 `dmesg` 无记录,排查方向容易跑偏到 SELinux。 | 排查项 | 命令 | 期望输出 | |--------|------|----------| | 规则是否加载 | `udevadm control --reload-rules` 后 `udevadm test /sys/class/tty/ttyUSB0` | 输出含自定义规则文件名 | | 变量是否已赋值 | `udevadm info -q property -n /dev/ttyUSB0` | 含 `ID_SERIAL=...` | | 符号链接是否创建 | `ls -l /dev/ttyPLC` | 指向 ttyUSBx | | 服务设备策略 | `systemctl show myapp -p DevicePolicy -p DeviceAllow` | `closed` 且含真实节点 | | 权限拒绝来源 | `ausearch -m avc -ts recent` | 无 avc 记录则查 DeviceAllow | ## 六、工程化落地建议 ### 6.1 规则模板与设备清单 现场设备超过 5 台时,手写规则容易漏。用脚本从 `udevadm info` 批量生成规则模板,serial 为空的设备标记出来人工处理。生成脚本在产线工装上一次跑完,规则文件随固件一起烧录,避免现场手改。 ``` #!/bin/sh # 扫描当前所有 ttyUSB 设备 输出规则模板到标准输出 # serial 为空或全零的设备单独标注 需要人工确认区分方式 for dev in /sys/class/tty/ttyUSB*; do node=$(basename "$dev") info=$(udevadm info -q property -n "/dev/$node" 2>/dev/null) vid=$(echo "$info" | sed -n 's/^ID_VENDOR_ID=//p') pid=$(echo "$info" | sed -n 's/^ID_MODEL_ID=//p') ser=$(echo "$info" | sed -n 's/^ID_SERIAL_SHORT=//p') [ -z "$vid" ] && continue if [ -z "$ser" ] || [ "$ser" = "0001" ]; then echo "# WARN $node serial 不唯一 需按端口路径区分" >&2 continue fi echo "SUBSYSTEM==\"tty\", KERNEL==\"ttyUSB[0-9]*\", ATTRS{idVendor}==\"$vid\", ATTRS{idProduct}==\"$pid\", ATTRS{serial}==\"$ser\", SYMLINK+=\"tty_${ser}\", MODE=\"0660\", GROUP=\"dialout\"" done ``` 脚本的输出直接追加到 `/etc/udev/rules.d/99-serial-fixed.rules`,每台设备一行。规则文件行数超过 200 行时 udev 加载时间增加约 3 毫秒,对启动时间影响可忽略,代价是规则文件需要随设备变更维护。 ### 6.2 监控与回归 符号链接缺失是静默故障,加一个每分钟检查的 systemd timer,发现缺失时记录并告警。检查本身不 open 设备,只 `stat` 符号链接,CPU 占用可忽略。 ``` # /etc/systemd/system/serial-check.timer [Unit] Description=Check serial symlinks every minute [Timer] OnBootSec=30s OnUnitActiveSec=60s [Install] WantedBy=timers.target ``` 回归测试在产线老化环节跑,反复插拔 50 次,每次校验符号链接指向的 ttyUSB 编号与预期一致。50 次插拔能覆盖绝大多数枚举顺序变化,耗时约 8 分钟。这个测试能提前发现 serial 重复、规则条件过宽的问题,避免现场停线。 ### 6.3 边界 设备本身不提供唯一标识 CH340、部分 PL2303 的 serial 字段为空或固定值,规则层无法区分。此时只能退回 `ID_PATH` 按物理端口区分,代价是设备必须固定插在同一个 USB 口,换口即失效。工程上把端口号写进设备标签贴在机箱上,运维按标签插线。这是硬件限制下的妥协方案,规则文件里用 `ENV{ID_PATH}=="pci-0000:00:14.0-usb-0:2:1.0"` 匹配,路径在换主机或换 hub 后失效,需要在部署文档里明确标注这个约束。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册