首页 文章 精选 留言 我的

精选列表

搜索[趋势探讨],共10000篇文章
优秀的个人博客,低调大师

大模型生成内容的相关性及模型性能的评估方式探讨

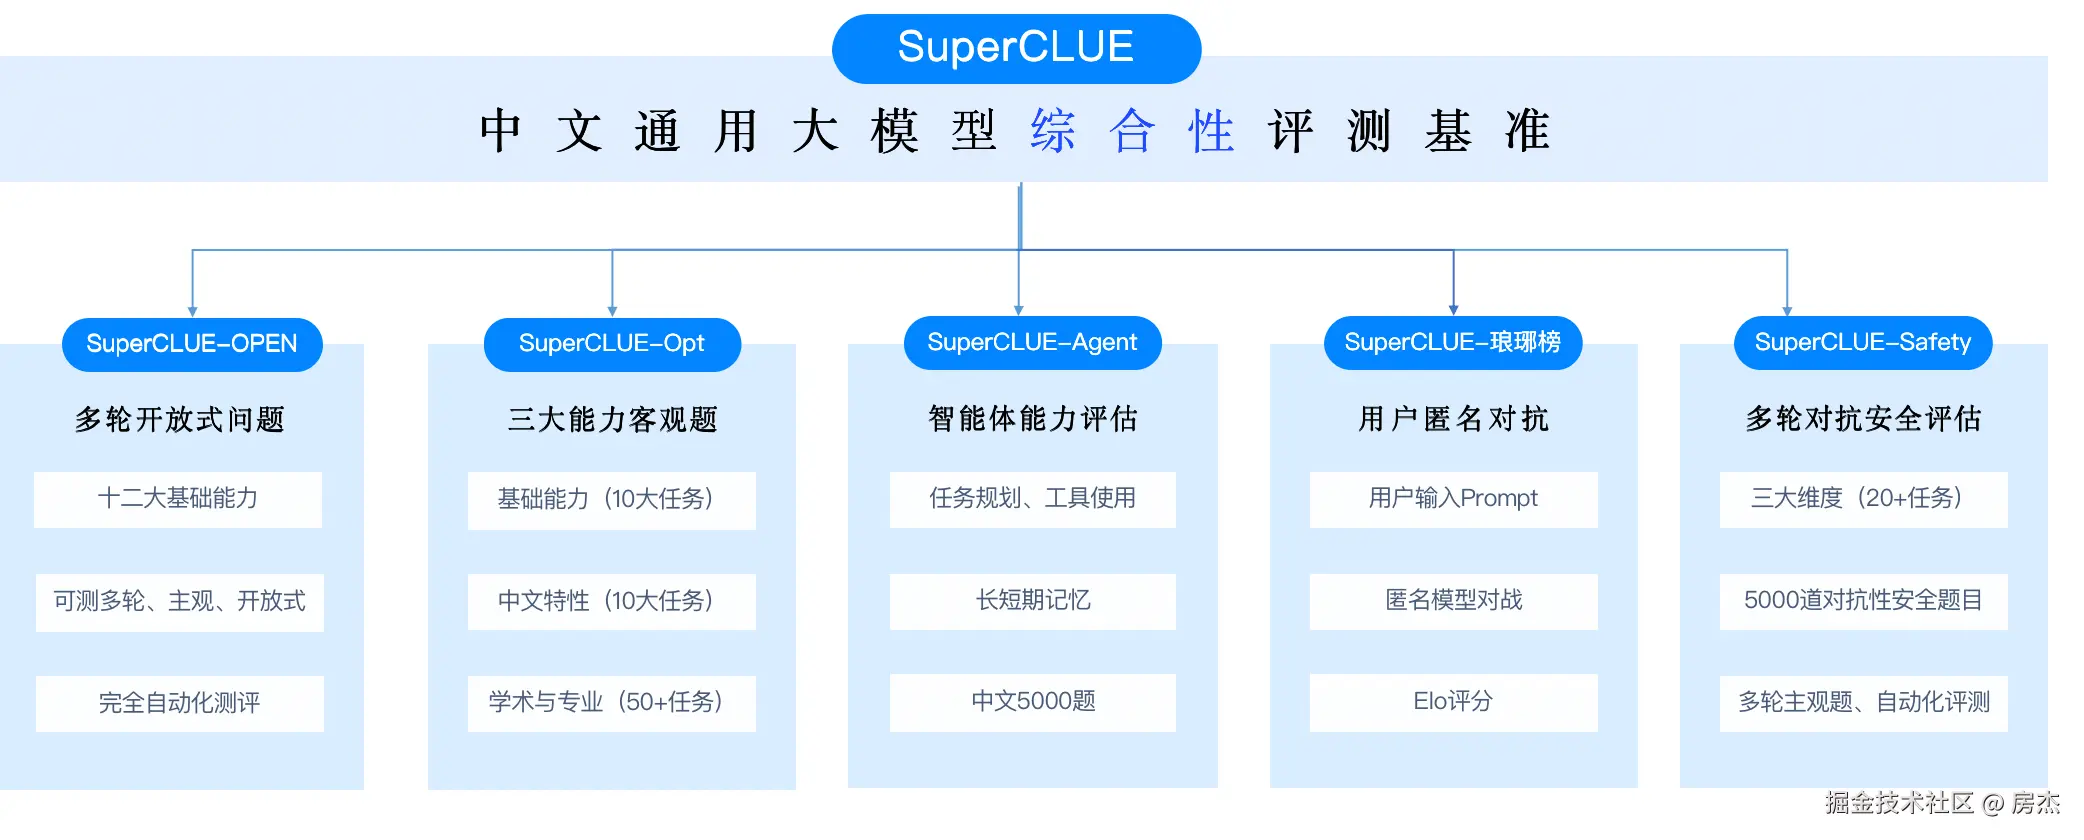
为什么要评估测试(Evaluation Testing) 随着大模型技术的推进,评测其性能和能力的需求也日益增长,这不仅仅是技术层面的需求,更关系到商业决策和公众认知。 为什么需要大模型评估测试?主要原因如下; 模型好坏的统一判断标准:如果不构建一个客观公正和定量的模型评测体系,则无法判断众多大模型之间的能力高低,用户无法了解模型的真实能力和实际效果。 模型迭代优化的依据:对于开发者而言,如果不能定量评估模型的能力,则无法跟踪模型能力的变化,无法知道模型的优势和劣势,从而无法有针对的指定模型提升策略,影响模型的迭代升级。 监管安全的要求考虑:对于法律、医疗等关乎社会安全的领域,需要对大模型进行系统的评测,以确认大模型适合在该领域进行使用,而不会造成安全事故。 领域基础模型的选择依据:在不同的领域下,大模型的能力表现各有优劣,需要引入评测体系对大模型在各个领域下的能力进行统一测试,选择出最适合该特定领域的大模型作为基座,从而更好的产业落地。 大模型的评估标准是什么 大模型的评估需要一套标准,所有按照一套标准进行评估,比较才会有公平性,就以 SuperCLUE 为例。 SuperCLUE是一个综合性大模型评测基准,评测主要聚焦于大模型的四个能力象限,包括语言理解与生成、专业技能与知识、Agent智能体和安全性,进而细化为12项基础能力。 评估基准 多维度的评测方案 根据评测我们可以从大范围内选择适合我们的模型,在此基础上我们可能对模型进行微调等,在微调后我们就需要对微调的模型,使用一些测试数据,对模型进行评估测试。 Spring AI 框架如何支持评估测试 Spring AI 主要测试 AI 应用程序需要评估生成的内容,以确保 AI 模型没有产生幻觉反应。 第一种方式:使用AI自身评估 用于评估响应的 Spring AI 接口定义为Evaluator: @FunctionalInterface public interface Evaluator { EvaluationResponse evaluate(EvaluationRequest evaluationRequest) } 评估的输入EvaluationRequest定义为 public class EvaluationRequest { private final String userText; private final List<Content> dataList; private final String responseContent; public EvaluationRequest(String userText, List<Content> dataList, String responseContent) { this.userText = userText; this.dataList = dataList; this.responseContent = responseContent; } ... } userText: 用户的输入文本 dataList: 附加到原始输入的上下文数据 reponseContent: AI 模型的响应内容 第二种方式:RelevancyEvaluator 它使用 AI 模型进行评估。未来版本中将提供更多实现。 RelevancyEvaluator使用输入 (userText) 和 AI 模型的输出 (chatResponse) 来提出问题: Your task is to evaluate if the response for the query is in line with the context information provided.\n You have two options to answer. Either YES/ NO.\n Answer - YES, if the response for the query is in line with context information otherwise NO.\n Query: \n {query}\n Response: \n {response}\n Context: \n {context}\n Answer: " 例如:该测试对加载到 Vector Store 中的 PDF 文档执行 RAG 查询,然后评估响应是否与用户文本相关。 @Test void testEvaluation() { dataController.delete(); dataController.load(); // 用户的提问 String userText = "What is the purpose of Carina?"; // 大模型影响 String responseContent = ChatClient.builder(chatModel) .build().prompt() .advisors(new QuestionAnswerAdvisor(vectorStore, SearchRequest.defaults())) .user(userText) .call() .content(); // 定义一个相关性评估器 var relevancyEvaluator = new RelevancyEvaluator(ChatClient.builder(chatModel)); // 将 用户提问 + 模型的响应,一并发给大模型进行评估 EvaluationRequest evaluationRequest = new EvaluationRequest(userText, (List<Content>) response.getMetadata().get(QuestionAnswerAdvisor.RETRIEVED_DOCUMENTS), responseContent); // 返回评估结果 EvaluationResponse evaluationResponse = relevancyEvaluator.evaluate(evaluationRequest); // 断言是否大模型是否满足性能需求 assertTrue(evaluationResponse.isPass(), "Response is not relevant to the question"); } 总结 大模型的评估也是相当重要的,是用好大模型的关键步骤。就像测试一样保障程序尽量少出bug。这个也是一个值得研究的专题,后续也会持续研究,并实践。本文也仅是做一个引入并记录一下。 参考文章 A Survey on Evaluation of Large Language Models Awesome-LLMs-Evaluation-Papers SuperCLUE

优秀的个人博客,低调大师

每日一博 | 面向未来的开源 OLAP 技术架构探讨以及选型实践

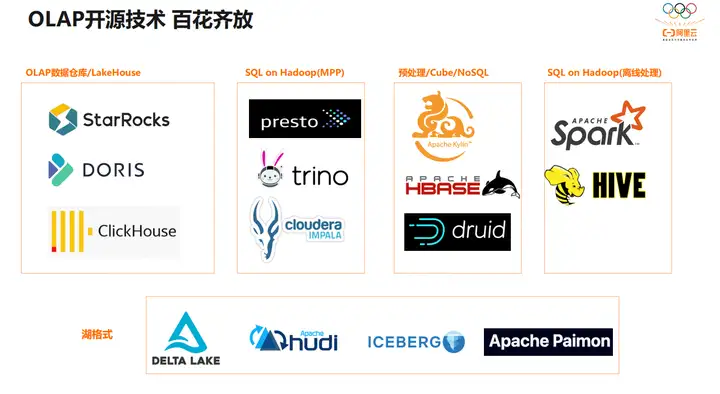
摘要:本文将介绍开源大数据 OLAP 的演化过程和最佳实践。文章将围绕下面六点展开: 1.开源 OLAP 综述 2.OLAP 场景思考 3.开源数据湖/流式数仓解决方案 4.StarRocks 介绍 5.客户案例 6.未来规划 一、开源 OLAP 综述 基于历史发展和开源社区的火热,现在的OLAP技术可以用百花齐放四个字来形容。 如图中最左边这一部分,是现在比较流行或者已经是业界标准的 OLAP 数据仓库/LakeHouse,包括 StarRocks、Doris、ClickHouse。第二部分是 SQL on Hadoop,该技术于10年前开始,以 HDFS 平台或者 OSS 为存储底座,包括 Presto 以及分支出来的 Trino、Impala。第三部分是预处理/Cube/NoSQL,已经使用得越来越少,麒麟、Druid 社区以及背后的商业化公司活跃度不高,Hbase 目前主要用在 Serving 的场景,社区相对比较老,稳定性尚可,解决了一部分业务场景,应用规模不小,但热度在逐渐下降。第四列是离线部分,目前的事实标准是 Spark,比较老的技术栈则是 Hive。 最底下这一部分是数据湖格式,之所以放在最下面,是有原因的。Delta Lake 在2019 年推出了增量数据湖格式,后期包括 Hudi,Iceberg,被大家称作数据湖三剑客。它们主要解决数据增量更新的问题。在大多情况下,作为 Presto、StarRocks 的外表,以读的方式作为 OLAP 来使用。Apache Paimon 是 Flink 社区推出的,原来叫 Flink Table Store,目前也贡献到了 Apache 社区,以 Flink 为基础,把整个存储留在湖里。 二、OLAP 场景思考 典型业务场景 OLAP 的业务场景主要有四大类: 第一类是面向用户的报表,比如一个比较典型的场景,给第三方广告主出报表,它可能是一个 ToB 的公司,利用 OLAP 引擎去做 Serving 服务; 第二类是面向经营人员、数据分析人员、老板的一些经营的报表,也是传统 BI 的 OLAP 行为; 第三类是用户画像,在游戏等行业里用得非常多,主要是把所有的用户标签统一到一张比较宽的表里,可以用各个维度去筛选出需要的客户; 第四类是流式的、实时的场景,包括直播、风控、实时预测。 接下来将介绍这几种业务场景对 OLAP 技术的需求及解决方案。 面向客户的报表 面向客户的报表,业务特点是按照客户的ID去检索数据,需要低延迟、高并发,而且需要明细数据,不仅仅是聚合模型。基于明细可以实现更灵活的自助分析,或者称作实时OLAP。但是实时 OLAP 性能也会受限制,比如三张表、十张表的 Join 查询的 latency 可能会非常的高,所以我们需要去做物化视图。总结起来,业务场景的需求是明细加上物化视图。 在技术上的需求,第一点是数据过滤,比如前缀索引、Bloom filter,以及一些更高级的filter,通过一些统计值有效过滤,减少读取的数据,使得点查或者范围查询更加快速。 第二点是向量化引擎,Presto、Hive、Spark 在某一个时间点上都有 OLAP 的尝试。当然现在 Presto、Trino 社区还是非常活跃的,尤其是在国外,它们是通过 Java 技术栈实现的,但是 Java 技术栈从语言层面而言没有 C++ 快,同时因为JVM向量化现在还不是特别成熟,也不能利用JVM的向量化模式。当然 Trino 社区在不断地去做这件事,不过到现在还没有一个完整的产品。另外 Presto,也在做 Native 的 Engine,去解决 OLAP 加上向量化的问题。但是有一些数据库,包括 ClickHouse、StarRocks、Doris,在几年前就已经布局了向量化引擎,因为其整个执行引擎本来就是用C++写的,所以会更快。 第三点是数据在机器的合理分布,数据分布对查询影响也是比较大的,包括数据是否有序、是否是 shard。 最后一点是对物化视图的支持是否足够好。 面向经营的报表 面向经营的报表,一般是企业内部提供给老板和数据分析人员查看的报表,比较典型的是实时风控场景。业务特点首先是需求变化特别快,要有明细表的存在,不只聚合成一种预设的模式,一般要把明细表直接导入到数据仓库中。第二是要求响应低延迟,对查询性能要求很高。 低延时对技术的需求包括向量化极速查询、多表关联查询能力、物化视图等等。 ClickHouse 针对宽表的场景,把整个数据通过 shard 分布,每一台机器进行分布式计算,最后将结果汇总起来形成查询的结果。ClickHouse 宽表比较快,但是宽表维护起来比较麻烦。所以我们思索是否有一种引擎可以对明细模型做高效的分布式 Join,在具有多机多核的同时也有核的向量化。 用户画像 用户画像场景是以一个ID为主键,构成一张列特别多的宽表。在 StarRocks 出现之前,更多用的是 Flink 或者 Spark 在外围加工出一张可能上千列的宽表,再直接 load 到数据库中,比较常见的是 ClickHouse 中。现在由于 StarRocks 逐渐崛起,很多需求都落到了 StarRocks 上。因为多表关联的能力也是需要的,如果用户画像只用宽表来做,还是有一些限制。在跟客户交流的过程中了解到,ClickHouse 这条链路会存在烟囱式开发的问题,维护起来有难度,所以 ClickHouse 的高效是牺牲了一定的运维能力。另外ClickHouse 对人员的要求也比较高,因为业务线的人员更多的是关注业务,这时要求业务线的人员去对 ClickHouse 进行维护就会存在困难。 订单分析 订单分析场景,在没有增量数据湖格式出现之前,用 Hive 或 Spark 一般是T+1的形式,如果要进一步提高时效,可能会用更短的时间去建分区,比如一个小时一个分区,但如果对这类分区表做全量刷新则会非常不友好,无论是对数据湖还是调度,压力都非常大。现在希望实时或者准实时地去分析数据,增量数据湖,包括 Delta Lake、Hudi、Iceberg 就是为了解决这一问题。 在线教育、企业订单、打车软件等场景,常常需要数据回刷,这对数据湖来说是一个非常大的挑战。在有了更新模型之后,很多企业开始把整个链路加到 Hudi,或者 Delta Lake上面。比如上一次的数据是一个小时之前的数据,下一个小时去更新这一批数据,但是如果做 OLAP 查询,速度会比较慢。因为直接查湖上的数据,受网络 IO 影响比较大。另外数据湖后台的 Compaction 要求比较高,尤其流量特别大的时候,很难同时保证数据查询的新鲜度和查询性能的要求。 StarRocks 引出了一部分主键模型,能够直接把 MySQL 或者原始数据直接打到主键模型里,通过主键的方式去更新,同一个主键,实现部分列的更新,是一种最佳实践。 技术需求思考 通过上述场景分析,对技术需求可以总结为如下几大类: 多表关联 首先是对 SQL 的支持,比如是否支持 IC SQL,还是会违背 IC SQL的语法,有很多自己的 SQL 语法。引申就是有没有一些 MySQL 协议或者是 PG 协议,直接可以去对接更好的BI工具,能够较少地去改动。 其次是对 Join 的支持。对比 StarRocks 和 CK,可以看出来,StarRocks 对于分布式 Join 的支持是特别好的,因为它有 FE 去做整个的 CBO,比如有5张表去做 Join a,Join b,Join c,Join d、 Join e 以怎样的顺序去做 Join,这时就需要通过 CBO 算法来挑出一个最好的方式。 另外是分布式 Join 的支持。StarRocks 还有一些其它的特性,通过数据的分布,实现一些 Join 的高级特性,比如 broadcast Join、shuffle Join,对比起来 CK 这几点就比较弱,因为 CK 最开始的时候是类似于以单机的形式拓展的分布式,它不是 MPP 架构,而是 Scatter-Gather 的架构。Scatter-Gather 架构需要去手动地把整个数据分成不同的Shard,每一台机器计算自己的 Shard,再把整个数据回吐到一个中心节点,这样就相当于是两层架构,对于 Join 的支持是很有限的。 多维查询 需要关注性能和索引的支持是否完备,以及一些高级的特性比如物化视图。物化视图在 StarRocks 里是一种比较重要的特性,包括同步物化视图、异步物化视图、单表物化视图、多表物化视图等。 实时导入和查询 是否有 Exactly Once 的语法保证。StarRocks 是能够保证的。CK 也是支持事务的,但分布式事务存在一些缺陷。是否有 Update 功能,包括 Partial Update。Schema Change 的感知。列数的限制,宽表限制了1000列还是1万列是有本质区别的。 开发效率、架构和运维 对于企业,开发效率、架构、运维难度可能更加重要,很多情况下企业人员并不是那么充足,运维的简便就很重要,比如能否以最小代价弹性缩容,能否根据扩缩容来自动均衡,是否能够达到高可用等等,都是非常实际的问题。开发效率方面,比如函数的支持是否完备,UDF 支持是否完备。现在越来越多的客户也都是湖仓的架构,本身有一些湖数据,这些数据是否可以不导进来,可以直接查询,也是一个特别常见的刚需。 三、开源数据湖/流式数仓解决方案 整体架构 上图是EMR的整体架构。以 ECS 或 Kubernetes 作为底座,主推方向是存算分离。左边是 JindoFS 加上 OSS,我们叫做 HCFS, Hadoop Compatible FS。Spark、Presto 这些计算引擎,不需要更改任何接口,直接能够对接以 OSS 为底座的 HCFS。其中有一些引擎是比较活跃的,也有一些基本上已经退出了历史舞台。 上面是一些数据分析或者数据应用平台的组件,下面将介绍的是企业架构。 Lambda 架构 第一个是 Lambda 架构,是最传统的一套架构,也是大厂现在用得最多的。离线和实时分别走不同的链路。图中这一块分层 ODS、DWD、DWS,放在 OLAP 的数据仓库里,这一层直接体现了报表的查询响应速度,可以用类似 Presto、Trino 这类引擎去查询,这是比较传统的架构,这里最终加工出来的最后一层的报表,直接放在 OLAP 里。 实时数据湖解决方案 第二个是相对比较新的一种架构,它提供了按主键 merger into 的能力,解决增量更新的场景。 这套架构计算会比较频繁,原来只是T+1,现在则需要实时或者近实时,比如半小时,几分钟去做更新,逐渐向流批一体靠拢。因为Iceberg、Hudi两个数据湖格式对批引擎和流引擎是完全适用的,这点在选型时大家也会着重考虑。对于查询数据湖,有越来越多的客户,从 Trino 或者 Presto 迁移到 StarRocks 上,因为目前 StarRocks 对于 Data Lake Analytics(DLA),也就是读外表的数据,支持是非常好的。 大家如果关注 StarRocks 社区版3.0会了解到,除了 UDF,StarRocks 能够提供和 Presto一模一样的语法,叫做 Presto Gateway,可以在不改 Presto 的 SQL 的情况下,就能够查询湖数据。这个能力将会包含在EMR 2.5的版本上。 最开始我们是最后一层 ADS 导入到 OLAP 中,现在有很多客户是希望 ODS、DWD、DWS 里面挑选一些比较关键的表,提供比较高的性能,也导入到 OLAP 中,然后通过 OLAP 完成高效的查询。 实时分析解决方案 上图是传统的 Kappa 架构,对于一些垂直业务线部门,不是数据中台部门,需要做这样一套数仓来解决其业务问题。通常是用 Flink CDC 把 MySQL 的数据同步到 Kafka 里,数据一般存储7天或者3天。虽然商业版的 Kafka 可以提供 KSQL,但在 Kafka 里查询数据,性能一直都是不太好的。 所以通常把整个 Kafka 数据通过 routine load 直接导到数据仓库里面,或者直接导到StarRocks 里面,这样就能保证 ODS、DWD、DWS 这三层数据全部可以增量查到,也能够去做整个的 OLAP,ODS 和 DWD 这两层的表也可以去做一些 Join。 StarRocks 的物化视图会在2. 5版本或者之后的几个小版本才能够比较稳定地跑起来,现在提供的是类似于全量物化视图,或是分区物化视图,而不是那种完全的 Incremental 物化视图。另外2. 5版本有外表物化视图,也可以把一些比较重的表,或者是我们通常叫做大湖小仓,把所有的数据放到湖里,需要的数据导到仓里。导入到仓里的时候也提供了一种比较暖心的方式,会去做外表的优化视图进行数据的导入。比如按时间,每10分钟导一次,把外表物化视图直接导进 StarRocks 里边,而不是用灌数据的方式。直接通过物化视图的方式,内部也会起更多的物化视图,也会在物化视图里边去建物化视图,这样把每一层的数据全部都物化起来,这也是 StarRocks 社区版中主推的。 四、StarRocks 介绍 接下来介绍 StarRocks 的价值和一些关键技术。 StarRocks 价值&架构 StarRocks 主打极速统一的概念,3. 0也会主打云原生这一概念。统一方面,StarRocks可以进行多维分析、实时分析,包括高并发查询、AD hoc 查询,包括前面介绍的所有场景,希望能够都统一起来,逐步在演化过程中,也慢慢地都开始做到了。在极速方面,StarRocks 对特别多的细节优化得也相当到位。通过 StarRocks 可以解决目前的大部分问题。 StarRocks 架构简单。FE 如果是高可用,则是有三个节点,它是通过 BDB 的库去做journal log 同步,类似于 raft 协议。BE 包括执行引擎和 IO 的引擎。比如查数据湖时,数据不在本地,所以整个 BE 节点,没必要去启动存储引擎,只需要计算引擎就可以。 StarRocks 核心技术特性 上图中列出了向量化的优化效果(2.1版本)。对于几个算子,比如 filter、group、shuffle Join、broadcast Join 等算子的性能提升是比较明显的。只要查询是非常重计算,轻 IO 的,最后整个查询的性能提升会非常明显。 StarRocks CBO 优化器采用 Cascades 框架。其中 Join 的推算是用动态规划算法实现的。 分布式 Join 的能力包括 Shuffle Join、Bucket Join、Colocation Join 等。Colocation Join 是指不需要网络传输,事先把两张表的数据,需要被 Join 的 key 置于同一台机器上,可以不走网络,不走 shuffle 的过程,这样能够显著加速 Join 的过程。但这种方式使用起来还是有一些门槛的,实际中不仅需要非常懂业务,还需要懂 Colocation Join 命中的规则,才能将其真正用起来。但是一般情况下 Shuffle Join,Bucket Join,Broadcast Join 也都够用了。 实时分析方面,StarRocks 有一个比较重要的特性——主键模型,也是不断地在优化中。1. 9的版本开始出现主键模型,一直优化到2. 5版本,经历了一年多,所以稳定性、内存的使用、以及 Partial Update 这些方面都表现优异。 整体性能方面,如果是查询数据湖外表,采用 TPCH 的标准跟 Trino 对比是3- 5倍的差距,数据来源 StarRocks 官网,或者是阿里云EMR官网。如果是在自己的业务,自己的 SQL 上,可能会有差异,但是有好有坏,如果查询是IO瓶颈的,那无论计算还是索引优化得多么好,也不一定有多大的提升,瓶颈卡在IO上,StarRocks 的向量化计算,包括一些高级的索引都没用上。但IO用的不是特别多,主要都是在函数计算,或其它方面,算子运行时间长,那么提升可能会非常多。 SSB 100G对比的是单表场景,数据来源 ClickBench 网站。在 CK 的优势领域,单表查询上,StarRocks 目前表现也是比较突出。如果感兴趣可以访问 ClickBench 官网。 StarRocks 目前也有资源隔离能力,如果要自建 StarRocks,资源隔离能力用得是比较多的。如果是在阿里云的场景上,或者后续要推出存算分离的场景,资源隔离能力,可以去官网上参考,但是在我们的客户里边用的并不是特别多。 最后是副本自动平衡的能力。如果去扩一台机器或者缩一台机器,不需要去手动做副本平衡,或者一台机器坏了,或者一个副本坏了,都是由 FE 的 task 去做平衡。 五、客户案例 某社交领域客户 第一个案例是某社交领域客户,他们最开始用的是CK。在StarRocks 2. 1时,他们开始用 StarRocks 去做整个的关联查询,用CK去做宽表的查询。但后来他们不愿意去维护两个技术栈,所以就去掉了CK,目前基本上用 StarRocks 支撑了所有的业务,包括用户画像、点查,以及传统的 OLAP 多表关联查询。 某电商领域客户 第二个案例是一个电商领域的客户,它们有着非常强烈的统一 OLAP 的需求。之前他们的 OLAP 由于历史原因用得特别乱,运维人员又比较少,维护困难。最后统一到了 StarRocks 里。首先,他们看中了阿里云的专家支持能力;同时,也看中了社区的发展,在社区中提出的问题总能得到较快的回答;另外,StarRocks 基本满足了他们所有的需求。 某在线教育客户 在线教育这个案例中,之前是通过 Hive 做小时级的更新,也无法实现 Upsert 场景,后面迁移到了 Hudi 数据湖上,中间链路除了 Flink 也使用了 Spark。属于大湖小仓,他们把一些关键的、性能要求高的数据都导到 StarRocks 里,对性能要求不那么高的就通过外表的方式直接查询 Hudi。经过数月的生产实践,目前已非常稳定。 六、未来规划 StarRocks3.x:极速统一&云原生 最后来介绍一下 StarRocks 3.x 版本的规划。 包括几条线,第一,继续坚持极速统一这一特性;第二,积极配合去做云原生,存算分离。 大家可能会有一个比较大的困惑,如果用 StarRocks 做仓,那么我们提供的都是云盘,毕竟从成本上来看是要比 OSS 贵不少。所以是否能够类似于 Snowflake,把整个数据全部放到 OSS 里边,只是把云盘作为缓存层去做。 在 LakeHouse 这一部分,2. 3的版本外表查询已经比较完备了,但是对于 Iceberg、 Hudi 的支持,还有很多工作要做。因为StarRocks社区是全球化的,在海外客户对于 Iceberg 用的还是比较多的。 在 ETL 方面和 Snowflake 对标,从3. 0 StarRocks 已经不是纯内存去做ETL了,会有 spill 框架。如果做一个比较大的 ETL 可以 Spill,有限的内存就可以把数据算好。比如做 Hashmap,Hashmap就可以去不断地往磁盘里面去写,有Spill的框架去支撑整个算子。 做ETL的时候并不像 Spark 那样 stage by stage,把每一个 stage 数据都存下来,保证容错性。思路是做得足够快,比Spark快上几倍,即使中间有问题,直接可以通过重算 Job来解决。 但是 ETL 也有资源隔离的问题。资源硬隔离,指的不是用现在已有资源组的方式,而是用跟 Snowflake 一样的架构,不同的节点去算不同的数据,相当于 OLAP 用一系列节点, ETL 用一系列节点,数据都存在 OSS 里边,这样能够保证两个 Workload 同时发生,但互不影响,这也是很多客户需要的。 目前 StarRocks 也在做多模的物化视图,包括增量的物化视图,流式的物化视图。 还有一些比较小的点,包括统一导入、半结构化数据。 以上就是本次分享的内容,谢谢大家。 点击立即免费试用云产品 开启云上实践之旅! 原文链接 本文为阿里云原创内容,未经允许不得转载。

优秀的个人博客,低调大师

Linux 内核对 Rust 的支持有新进展,双方进行深入探讨

从去年九月,Linux 内核维护者 Greg 表示愿意接受用 Rust 开发 Linux 驱动,到今年七月,Linus Torvalds 回应称可以默认启用 Rust 支持,Linux 开发者并非只是说说而已。 在八月底举办的2020 Linux Plumbers 大会上,关于 Linux 内核上游对 Rust 的开放程度成为了最热门的讨论话题。Rust 语言团队的联合负责人Thomas 和 Gaynor,以及 Linux 内核开发者Josh Triplett 等人参与了这场讨论,并向大家展示了截至目前的一些研究成果、想法,还有遇到的问题。 他们强调,并不打算将已有的内核改写成 Rust,而只专注于可以用 Rust 编写的新代码。具体来讲,与会者集中讨论了 Linux 内核对Rust 的支持可能涉及到的三个方面:内核中现有的 API、架构支持,和 ABI 与内核的兼容性问题。 绑定到现有的 C API 目前来看,Rust 能够生成可以链接到内核的代码还不够。它还需要一种方法来访问 Linux 内核中使用的大量 API,这些 API 目前都在 C 头文件中定义。 Linux 内核开发者指出,Rust 与 C 具有良好的互操作性;此外,bindgen 工具能够解析 C 头文件以生成适当的 Rust 声明,因此 Rust 不需要从 C 复制重复的定义,这也提供了一种跨语言类型检查的措施。 从表面上看,这些特性使 Rust 具备了与现有 C API 集成的良好条件,但实际上实施起来还存在一些挑战。例如,Linux 大量使用了预处理器宏和内联函数,bindgen 和 Rust 的外函数接口不容易支持它们。 有关 API 绑定的第二个问题是:需要手动封装多少 C API 才能呈现惯用的 Rust 接口? Thomas 和 Gaynor 展示了一个linux-kernel-module-rust项目,可在其中看到内核模式的 Rust 代码示例。在这个项目中,指向用户空间的指针被封装到 UserSlicePtr 类型中。这样的封装生成的代码对现有 Rust 开发者而言更加熟悉,并使 Rust 的类型系统和借用检查器提供最大程度的安全性。但是,必须针对每个 API 进行设计和开发,用 C 和 Rust 编写的模块也会创建不同的 API。这无疑加重了工作的繁琐度。 John Baublitz 也给出了一个演示模块,它更直接地绑定了内核的用户访问功能,绑定多由 bindgen 自动生成。然而,Rust 开发者对这些代码可能会不太习惯,并且这种方式可能需要放弃 Rust 的许多安全保证。 最后,会议达成了共识:对于某些最常见和关键的 API,编写 Rust 封装器是有意义的,但是手动封装每个内核 API 不可行。Thomas 还提到谷歌正致力于自动生成 C++ 代码的惯用绑定,并考虑内核是否可以做类似的事情。 架构支持 对架构的支持是讨论的另一个重点。与会者表示,在 Rust 中实现 Linux 驱动是可以接受的,但无论如何不能把它放在更晦涩难懂的架构上。 在这方面,现阶段唯一成熟的 Rust 实现是 rustc 编译器,该编译器通过 LLVM 发出代码。Linux 内核支持多种架构,其中一些没有可用的 LLVM 后端,另一些存在 LLVM 后端,却尚不受rustc 支持。 Triplett 认为,先将Rust 添加到 Linux 内核中,反过来会有助于增加对更多架构的 Rust 支持。就像 Rust 软件被引入Debian 后,吸引了更多不同架构的爱好者协助改进 Rust 支持一样,他寄希望于为 Linux 内核添加 Rust 支持也获得类似的效果。 ABI 与内核的兼容性 Gaynor 问到了有关 ABI 兼容性的建议。当前 Rust 是通过 LLVM 编译的,而 Linux 内核通常使用 GCC 构建,因此将 Rust 代码链接到内核可能意味着混合 GCC 和 LLVM 发出的代码。 参与讨论者担心 LLVM 与 GCC 可能会有 ABI 兼容的问题,于是提出一个设想,即 Linux 内核社区是否可以将 Rust 支持仅限于使用 Clang 构建的内核,以确保兼容性。 Linux 内核维护者 Greg 指出,当前的内核规则是,仅当内核中的所有目标文件使用相同的编译器并使用相同的标志构建时,才能保证兼容性。不过,他仍然对将 LLVM 构建的 Rust 对象链接到 GCC 构建的内核表示满意,因为只要配置适当,并通过测试即可。他认为不需要任何预先的限制,直到真正有实际问题产生。 另一位内核开发者Triplett 也强调,GCC 和 Rust 之间的调用是常规且普遍的,不必担心兼容性。因此目前看来,二者的兼容性问题目前不会成为将 Rust 引入 Linux 内核的阻碍。 这场会议上的讨论大致到此,暂时没有后续消息。随着越来越多的人对此抱有期待和热情,正如 LWN.net所说,或许待一个具体的 Rust 内核驱动用例出现时,所有的争议和决策都将变得更加清晰。

优秀的个人博客,低调大师

从NDK在非Root手机上的调试原理探讨Android的安全机制

最近都在忙着研究Android的安全攻防技术,好长一段时间没有写博客了,准备回归老本行中--Readthefunckingandroidsourcecode。这两天在看NDK文档的时候,看到一句话“Nativedebugging...doesnotrequirerootorprivilegedaccess,aslongasyourapplicationisdebuggable”。咦,NDK调试不就是通过ptrace来实现调试的么?在非Root的手机上是怎么进行ptrace的呢?借这两个问题正好可以介绍一下Android的安全机制。 老罗的新浪微博:http://weibo.com/shengyangluo,欢迎关注! Android是一个基于Linux内核的移动操作系统。Linux是一个支持多用户的系统,系统中的文件的访问权限是通过用户ID(UID)和用户组ID(GID)来控制的。换句话说,就是Linux的安全机制是基于UID和GID来实现的。Android在Linux内核提供的基于UID和GID的安全机制的基础上,又实现了一套称为Permission的安全机制,如图1所示: 图1Linux的UID/GID安全机制与Android的Permission安全机制 那么,这两个安全机制是如何对应起来的呢? 我们首先看一下Linux基于UID和GID的安全机制,它包含三个基本角色:用户、进程和文件,如图2所示: 图2Linux基于UID/GID的安全机制的三个角色 Linux中的每一个用户都分配有一个UID,然后所有的用户又按组来进划分,每一个用户组都分配有一个GID。注意,一个用户可以属于多个用户组,也就是说,一个UID可以对应多个GID。在一个用户所对应的用户组中,其中有一个称为主用户组,其它的称为补充用户组。 Linux中的每一个文件都具有三种权限:Read、Write和Execute。这三种权限又按照用户属性划分为三组:Owner、Group和Other。如图3所示: 图3Linux的文件权限划分 从图3就可以看出文件acct:1.所有者为root,可读可写可执行;2.所有者所属的主用户组为root,在这个组中的其它用户可读可执行;3.其余的用户可读可执行。 Linux中的每一个进程都关联有一个用户,也就是对应有一个UID,如图4所示: 图4Linux的进程 由于每一个用户都对应有一个主用户组,以及若干个补充用户组,因此,每一个进程除了有一个对应的UID之外,还对应有一个主GID,以及若干个SupplementaryGIDs。这些UID和GID就决定了一个进程所能访问的文件或者所能调用的系统API。例如,在图4中,PID为340的进程一般来说,就只能访问所有者为u0_a19的文件。 一个进程的UID是怎么来的呢?在默认情况下,就等于创建它的进程的UID,也就是它的父进程的UID。Linux的第一个进程是init进程,它是由内核在启动完成后创建的,它的UID是root。然后系统中的所有其它进程都是直接由init进程或者间接由init进程的子进程来创建。所以默认情况下,系统的所有进程的UID都应该是root。但是实际情况并非如此,因为父进程在创建子进程之后,也就是在fork之后,可以调用setuid来改变它的UID。例如,在PC中,init进程启动之后,会先让用户登录。用户登录成功后,就对应有一个shell进程。该shell进程的UID就会被setuid修改为所登录的用户。之后系统中创建的其余进程的UID为所登录的用户。 进程的UID除了来自于父进程之外,还有另外一种途径。上面我们说到,Linux的文件有三种权限,分别是Read、Wirte和Execute。其实还有另外一个种权限,叫做SUID。例如,我们对Android手机进行root的过程中,会在里面放置一个su文件。这个su文件就具有SUID权限,如图5所示: 图5su的SUID和SGID 一个可执行文件一旦被设置了SUID位,那么当它被一个进程通过exec加载之后,该进程的UID就会变成该可执行文件的所有者的UID。也就是说,当上述的su被执行的时候,它所运行在的进程的UID是root,于是它就具有最高级别的权限,想干什么就干什么。 与SUI类似,文件还有另外一个称为SGID的权限,不过它描述的是用户组。也就是说,一个可执行文件一旦被设置了GUID位,么当它被一个进程通过exec加载之后,该进程的主UID就会变成该可执行文件的所有者的主UID。 现在,小伙伴们应该可以理解Android手机的root原理了吧:一个普通的进程通过执行su,从而获得一个具有root权限的进程。有了这个具有root权限的进程之后,就可以想干什么就干什么了。su所做的事情其实很简单,它再fork另外一个子进程来做真正的事情,也就是我们在执行su的时候,后面所跟的那些参数。由于su所运行在的进程的UID是root,因此由它fork出来的子进程的UID也是root。于是,子进程也可以想干什么就干什么了。 不过呢,用来root手机的su还会配合另外一个称为superuser的app来使用。su在fork子进程来做真正的事情之前,会将superuser启动起来,询问用户是否允许fork一个UID是root的子进程。这样就可以对root权限进行控制,避免被恶意应用偷偷地使用。 这里是su的源代码,小伙伴们可以根据上面所讲的知识读一读:https://code.google.com/p/superuser/source/browse/trunk/su/su.c?r=2。 在传统的UNIX以及类UNIX系统中,进程的权限只划分两种:特权和非特权。UID等于0的进程就是特权进程,它们可以通过一切的权限检查。UID不等于0的进程就非特权进程,它们在访问一些敏感资源或者调用一个敏感API时,需要进行权限检查。这种纯粹通过UID来做权限检查的安全机制来粗放了。于是,Linux从2.2开始,从进程的权限进行了细分,称为Capabilities。一个进程所具有Capabilities可以通过capset和prctl等系统API来设置。也就是说,当一个进程调用一个敏感的系统API时,Linux内核除了考虑它的UID之外,还会考虑它是否具有对应的Capability。 这里就是Linux所设计的Capabilities列表,有兴趣的小伙伴可以再读一读:http://man7.org/linux/man-pages/man7/capabilities.7.html。 以上就是Linux基于UID/GID的安全机制的核心内容。接下来我们再看Android基于Permission的安全机制,它也有三个角色:apk、signature和permission,如图6所示: 图6Android的Permission安全机制 Android的APK经过PackageManagerService安装之后,就相当于Linux里面的User,它们都会被分配到一个UID和一个主GID,而APK所申请的Permission就相当于是Linux里面的SupplementaryGID。 我们知道,Android的APK都是运行在独立的应用程序进程里面的,并且这些应用程序进程都是Zygote进程fork出来的。Zygote进程又是由init进程fork出来的,并且它被init进程fork出来后,没有被setuid降权,也就是它的uid仍然是root。按照我们前面所说的,应用程序进程被Zygote进程fork出来的时候,它的UID也应当是root。但是,它们的UID会被setuid修改为所加载的APK被分配的UID。 参照Android应用程序进程启动过程的源代码分析一文的分析,ActivityManagerService在请求Zygote创建应用程序进程的时候,会将这个应用程序所加载的APK所分配得到的UID和GID(包括主GID和SupplementaryGID)都收集起来,并且将它们作为参数传递给Zygote进程。Zygote进程通过执行函数来fork应用程序进程: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 /* *Utilityroutinetoforkzygoteandspecializethechildprocess. */ static pid_tforkAndSpecializeCommon( const u4*args,boolisSystemServer) { pid_tpid; uid_tuid=(uid_t)args[ 0 ]; gid_tgid=(gid_t)args[ 1 ]; ArrayObject*gids=(ArrayObject*)args[ 2 ]; ...... pid=fork(); if (pid== 0 ){ ...... err=setgroupsIntarray(gids); ...... err=setgid(gid); ...... err=setuid(uid); ...... } ..... return pid; } 参数args[0]、args[1]和args[]保存的就是APK分配到的UID、主GID和SupplementaryGID,它们分别通过setuid、setgid和setgroupsIntarray设置给当前fork出来的应用程序进程,于是应用程序进程就不再具有root权限了。 那么,Signature又充当什么作用呢?两个作用:1.控制哪些APK可以共享同一个UID;2.控制哪些APK可以申请哪些Permission。 我们知道,如果要让两个APK共享同一个UID,那么就需要在AndroidManifest中配置android:sharedUserId属性。PackageManagerService在安装APK的时候,如果发现两个APK具有相同的android:sharedUserId属性,那么它们就会被分配到相同的UID。当然这有一个前提,就是这两个APK必须具有相同的Signature。这很重要,否则的话,如果我知道别人的APK设置了android:sharedUserId属性,那么我也在自己的APK中设置相同的android:sharedUserId属性,就可以去访问别人APK的数据了。 除了可以通过android:sharedUserId属性申请让两个APK共享同一个UID之外,我们还可以将android:sharedUserId属性的值设置为“android.uid.system”,从而让一个APK的UID设置为1000。UID是1000的用户是system,系统的关键服务都是运行在的进程的UID就是它。它的权限虽然不等同于root,不过也足够大了。我们可以通过MasterKey漏洞来看一下有多大。 MasterKey漏洞发布时,曾轰动了整个Android界,它的具体情况老罗就不分析了,网上很多,这里是一篇官方的文章:http://bluebox.com/corporate-blog/bluebox-uncovers-android-master-key/。现在就简单说说它是怎么利用的: 1.找到一个具有系统签名的APP,并且这个APP通过android:sharedUserId属性申请了android.uid.system这个UID。 2.通过MasterKey向这个APP注入恶意代码。 3.注入到这个APP的恶意代码在运行时就获得了system用户身份。 4.修改/data/local.prop文件,将属性ro.kernel.qemu的值设置为1。 5.重启手机,由于ro.kernel.qemu的值等于1,这时候手机里面的adb进程不会被setuid剥夺掉root权限。 6.通过具有root权限的adb进程就可以向系统注入我们熟悉的su和superuser.apk,于是整个root过程完成。 注意,第1步之所以要找一个具有系统签名的APP,是因为通过android:sharedUserId属性申请android.uid.system这个UID需要有系统签名,也就是说不是谁可以申请system这个UID的。另外,/data/local.prop文件的Owner是system,因此,只有获得了system这个UID的进程,才可以对它进行修改。 再说说Signature与Permission的关系。有些Permission,例如INSTALL_PACKAGE,不是谁都可以申请的,必须要具有系统签名才可以,这样就可以控制SuppementaryGID的分配,从而控制应用程序进程的权限。具有哪些Permission是具有系统签名才可以申请的,可以参考官方文档:http://developer.android.com/reference/android/Manifest.html,就是哪些标记为“Notforusebythird-partyapplications”的Permission。 了解了Android的Permission机制之后,我们就可以知道: 1.Android的APK就相当于是Linux的UID。 2.Android的Permission就相当于是Linux的GID。 3.Android的Signature就是用来控制APK的UID和GID分配的。 这就是Android基于Permission的安全机制与Linux基于UID/GID的安全机制的关系,概括来说,我们常说的应用程序沙箱就是这样的: 图7Android的ApplicationSandbox 接下来我们就终于可以步入正题分析NDK在非root手机上调试APP的原理了。首先们需要知道的是,NDK是通过gdbclient和gdbserver来调试APP的。具体来说,就是通过gdbserver通过ptrace附加上目标APP进程去,然后gdbclient再通过socket或者pipe来链接gdbserver,并且向它发出命令来对APP进程进行调试。这个具体的过程可以参考这篇文章,讲得很详细的了:http://ian-ni-lewis.blogspot.com/2011/05/ndk-debugging-without-root-access.html。老罗希望小伙伴们认真看完这篇文章再来看接下来的内容,因为接下来我们只讲这篇文章的关键点。 第一个关键点是每一个需要调试的APK在打包的时候,都会带上一个gdbserver。因为手机上面不带有gdbserver这个工具。这个gdbserver就负责用来ptrace到要调度的APP进程去。 第二个关键点是ptrace的调用。一般来说,只有root权限的进程只可以调用。例如,如果我们想通过ptrace向目标进程注入一个SO,那么就需要在root过的手机上通过向su申请root权限。但是,这不是绝对的。如果一个进程与目标进程的UID是相同的,那么该进程就具有调用ptrace的权限。我们可以看看ptrace_attach函数的实现: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 staticintptrace_attach(structtask_struct*task, long request, unsigned long addr, unsigned long flags) { ...... task_lock(task); retval=__ptrace_may_access(task,PTRACE_MODE_ATTACH); task_unlock(task); if (retval) goto unlock_creds; ...... unlock_creds: mutex_unlock(&task->signal->cred_guard_mutex); out: ...... return retval; } gdbserver在调试一个APP之前,首先要通过ptrace_attach来附加到该APP进程去。ptrace_attach在执行实际操作之后,会调用__ptrace_may_access来检查调用进程的权限: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 int __ptrace_may_access(structtask_struct*task,unsigned int mode) { conststructcred*cred=current_cred(),*tcred; ...... if (task==current) return 0 ; rcu_read_lock(); tcred=__task_cred(task); if (cred->user->user_ns==tcred->user->user_ns&& (cred->uid==tcred->euid&& cred->uid==tcred->suid&& cred->uid==tcred->uid&& cred->gid==tcred->egid&& cred->gid==tcred->sgid&& cred->gid==tcred->gid)) goto ok; if (ptrace_has_cap(tcred->user->user_ns,mode)) goto ok; rcu_read_unlock(); return -EPERM; ok: ...... return security_ptrace_access_check(task,mode); } 这里我们就可以看到,如果调用进程与目标进程具有相同的UID和GID,那么权限检查就通过。否则的话,就要求调用者进程具有执行ptrace的capability,这是通过另外一个函数ptrace_has_cap来检查的。如果是调用进程的UID是root,那么ptrace_has_cap一定会检查通过。当然,通过了上述两个权限检查之后,还要接受内核安全模块的检查,这个就不是通过UID或者Capability这一套机制来控制的了,我们可以忽略这个话题。 第三个关键点是如何让gdbserver进程的UID与要调试的APP进程的UID一样。因为在没有root过的手机上,要想获得root权限是不可能的了,因此只能选择以目标进程相同的UID运行这个方法。这就要用到另外一个工具了:run-as。 runs-as其实是一个与su类似的工具,它在设备上是自带的,位于/system/bin目录下,它的SUID位也是被设置了,并且它的所有者也是root,我们可以通过ls-l/system/bin/run-as来看到: 1 2 root@android:/#ls-l/system/bin/run-as -rwsr-s---rootshell95282013-12-0505:32run-as 但是与su不同,run-as不是让一个进程以root身份运行,而是让一个进程以指定的UID来运行,这也是通过setuid来实现的。run-as能够这样做是因为它运行的时候,所获得的UID是root。 第四个关键点是被调试的APK在其AndroidManifext.xml里必须将android:debuggable属性设置为true。这是为什么呢?原来,当一个进程具有ptrace到目标进程的权限时,还不能够对目标进程进行调试,还要求目标进程将自己设置为可dumpable的。我们再回过头来进一步看看__ptrace_may_access的实现: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 int __ptrace_may_access(structtask_struct*task,unsigned int mode) { conststructcred*cred=current_cred(),*tcred; ...... int dumpable= 0 ; ...... ok: rcu_read_unlock(); smp_rmb(); if (task->mm) dumpable=get_dumpable(task->mm); if (!dumpable&&!ptrace_has_cap(task_user_ns(task),mode)) return -EPERM; return security_ptrace_access_check(task,mode); } 我们再来看看当一个APK在其AndroidManifext.xml里必须将android:debuggable属性设置为true时会发生什么事情。ActivityManagerService在请求Zygote进程为其fork一个应用程序进程时,会将它的DEBUG_ENABLE_DEBUGGER标志位设置为1,并且以参数的形式传递给Zygote进程。Zygote进程在调用我们在上面分析的函数forkAndSpecializeCommon来fork应用程序进程时,就会相应的处理,如下所示: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 static pid_tforkAndSpecializeCommon( const u4*args,boolisSystemServer) { pid_tpid; ...... u4debugFlags=args[ 3 ]; ...... pid=fork(); if (pid== 0 ){ ...... /*configureadditionaldebugoptions*/ enableDebugFeatures(debugFlags); ...... } ...... return pid; } 参数args[3]包含的就是调试标志位,函数enableDebugFeatures的实现如下所示: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 void enableDebugFeatures(u4debugFlags) { ...... if ((debugFlags&DEBUG_ENABLE_DEBUGGER)!= 0 ){ /*Toletanon-privilegedgdbserverattachtothis *process,wemustsetitsdumpablebitflag.However *wearenotinterestedingeneratingacoredumpin *caseofacrash,soalsosetthecoredumpsizeto0 *todisablethat */ if (prctl(PR_SET_DUMPABLE, 1 , 0 , 0 , 0 )< 0 ){ ALOGE(\"couldnotsetdumpablebitflag for pid%d:%s\", getpid(),strerror(errno)); } else { structrlimitrl; rl.rlim_cur= 0 ; rl.rlim_max=RLIM_INFINITY; if (setrlimit(RLIMIT_CORE,&rl)< 0 ){ ALOGE(\"couldnotdisablecorefilegeneration for pid%d:%s\", getpid(),strerror(errno)); } } } ...... } 这样当一个APK在其AndroidManifext.xml里必须将android:debuggable属性设置为true时,它所运行在的进程就会通过prctl将PR_SET_DUMPABLE设置为1,这样gdbserver才能对它进行调试。 这下我们就明白NDK在非root手机上调试APP的原理了:gdbserver通过run-as获得与目标进程相同的UID,然后就可以ptrace到目标进程去调试了。 这一下就引出了run-as这个工具,貌似很强大的样子,那我们是不是也可以利用它来做坏事呢?例如,我们可以在adbshell中运行run-as(run-as属于shell组,因此可以执行),并且指定run-as以某一个APK的UID运行,那么不就是可以读取该APK的数据了吗?从而突破了Android的应用程序沙箱。但是这是不可能做到的。 我们可以看一下run-as的源代码: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 int main( int argc, char **argv) { constchar*pkgname; int myuid,uid,gid; PackageInfoinfo; ...... /*checkuseridofcaller-mustbe\'shell\'or\'root\'*/ myuid=getuid(); if(myuid!=AID_SHELL&&myuid!=AID_ROOT){ panic(\"only\'shell\'or\'root\'userscanrunthisprogram\\n\"); } /*retrievepackageinformationfromsystem*/ pkgname=argv[1]; if(get_package_info(pkgname,&info)<0){ panic(\"Package\'%s\'isunknown\\n\",pkgname); return1; } /*rejectsystempackages*/ if(info.uid<AID_APP){ panic(\"Package\'%s\'isnotanapplication\\n\",pkgname); return1; } /*rejectanynon-debuggablepackage*/ if(!info.isDebuggable){ panic(\"Package\'%s\'isnotdebuggable\\n\",pkgname); return1; } /*Ensurethatwechangeallreal/effectivevedIDsatthe *sametimetoavoidnastysurprises. */ uid=gid=info.uid; if(setresgid(gid,gid,gid)||setresuid(uid,uid,uid)){ panic(\"Permissiondenied\\n\"); return1; } ...... /*Defaultexecshell.*/ execlp(\"/system/bin/sh\",\"sh\",NULL); panic(\"execfailed\\n\"); return 1 ; } 这里我们就可以看到run-as在启动的时候做了很多安全检查,包括: 1.检查自身是不是以shell或者root用户运行。 2.检查指定的UID的值是否是在分配给APK范围内的值,也就是只可以指定APK的UID,而不可以指定像system这样的UID。 3.指定的UID所对应的APK的android:debuggable属性必须要设置为true。 综合了以上三个条件之后,我们才可以成功地执行run-as。 这里还有一点需要提一下的就是,我们在运行run-as的时候,指定的参数其实是一个packagename。run-as通过这个packagename到/data/system/packages.xml去获得对应的APK的安装信息,包括它所分配的UID,以及它的android:debuggable属性。文件/data/system/packages.xml的所有者是system,run-as在读取这个文件的时候的身份是root,因此有权限对它进行读取。 这下我们也明白了,你想通过run-as来做坏事是不行的。同时,这也提醒我们,在发布APK的时候,一定不要将android:debuggable属性的值设置为true。否则的话,就提供了机会让别人去读取你的数据,或者对你进行ptrace了。 本文转自 Luoshengyang 51CTO博客,原文链接:http://blog.51cto.com/shyluo/1338267,如需转载请自行联系原作者
优秀的个人博客,低调大师

2025 AI Agents 发展趋势

📌 自主检索增强生成 (Agentic RAG) 基于推理的,用于实时数据检索和生成的AI智能体工作流。 Agentic RAG的应用不局限于单一场景,同样也被应用于医疗保健领域。 举例:Perplexity, Harvey AI 和 Glean AI 📌 语音智能体 (Voice Agents) 能够通过自然口语与用户互动的智能代理,利用广泛的文本转语音(TTS)和语音转文本(STTS)的嵌入和检索技术。 举例:ElevenLabs, Cognigy, Vapi 和 Deepgram 📌 AI智能体协议 (AI Agent Protocols) 简化多智能体之间的通信,支持不同框架下构建的智能体之间的交流。 举例:Accenture,A2A, ACP, SLIM等 📌 计算机使用智能体 (CUA - Computer Using Agents) 能像人类一样与计算机交互的AI智能体,可利用浏览器、命令行界面(CLI)甚至鼠标光标等工具。 举例:OpenAI的Operator, Claude的Computer Use, H-Company的Runner H以及Manus AI 📌 编程智能体 (Coding Agents) 借助巧妙的工具使用和基于大语言模型(LLM)的代码生成,使构建和调试应用程序的速度提高10倍的多智能体。 举例:Windsurf, Cursor 和 GitHub Copilot 📌 深度研究智能体 (DeepResearch Agents) 协作式多智能体系统,可从大量来源构建内容详尽的研究报告。 举例: Gemini DeepResearch, OpenAI DeepResearch 和 You(.)com DeepResearch 转自karminski-牙医 微博

优秀的个人博客,低调大师

全球DevOps行业最新薪酬趋势

数据中心自动化初创企业Puppet公司日前发布了一项调查结果,揭示了新冠疫情发生之后的运营环境对DevOps人员的薪酬有什么直接影响,越来越多的企业提高薪酬以投资具有竞争力的顶尖人才。 Puppet公司对全球2600多名技术专业人士进行了调查,发现高收入人群的薪酬水平显著增长。调查表明,女性在不同地区、不同岗位和不同行业中的收入地位正在稳步提高。此外还表明,其他国家的DevOps人才在薪酬方面正在赶超美国。 Puppet公司首席技术官Abby Kearns说:“我们看到越来越多的女性进入高收入阶层,尤其是在这个男性占主导地位的DevOps领域,这令人兴奋。薪酬差距的逐渐缩小预示着薪酬公平的长期转变。作为DevOps人士,我受到这一进步的鼓舞,并期待在DevOps行业中看到更多的薪酬平等和性别平等。” 辞职潮和新冠疫情驱动的数字化转型工作直接影响了DevOps行业的发展。这些变革性的转变迫使DevOps公司提供更具竞争力的薪酬,并投资于顶尖人才,以确保可持续的成功。报告发现,与过去三年中比,越来越多的DevOps人员的收入水平正在提高。此外,DevOps发展水平较高的企业正在向其更高级别的员工提供更高的薪酬,越来越多的管理人员和从业人员的收入超过15万美元。 Puppet公司研究总监Ronan Keenan说:“在今年的调查中,我们首次要求受访者不仅要明确其职位,还要明确其所在团队,因为DevOps领域的合作正在增加。有趣的是,与其他团队相比,DevOps团队大部分成员的年薪在15万美元到25万美元之间。这也与平台工程师连续两年成为受访者认为薪酬最高的职位保持一致。” 主要发现 男性和女性从业者之间的薪酬差距正在缩小,因为女性正在稳定地、潜在地长期转向更高的收入。与上一年相比,薪酬达到15万美元以上收入水平的女性人数增加了一倍多(2021年为17%,2020年为8%)。 尽管新冠疫情导致了一些中断,但欧洲就业市场仍然相当稳定,这推动了与美国的市场竞争。事实上,像法国这样的国家正在经历显著的薪酬增长。在法国,45%的DevOps技术工作者(领导者和从业人员)在2021年收入超过7.5万美元,2019年这一比例为38%。 DevOps发展水平高的企业继续为其员工提供更高的薪酬,从2020年到2021年,DevOps从业人员薪酬翻了一番,领导者的薪酬几乎翻了三倍。那些在快速发展的企业中薪酬超过15万美元的人的比例增加了一倍多,从2020年的8%增长到2021年的20%。 从事金融服务的受访者收入最高,其次是从事医疗保健和科技行业的受访者。所有行业都出现了大幅增长,金融服务从2020年的16%增长到2021年的29%,几乎翻了一番。 版权声明:本文为企业网D1Net编译,转载需在文章开头注明出处为:企业网D1Net,如果不注明出处,企业网D1Net将保留追究其法律责任的权利。

优秀的个人博客,低调大师

Java 定时任务技术趋势

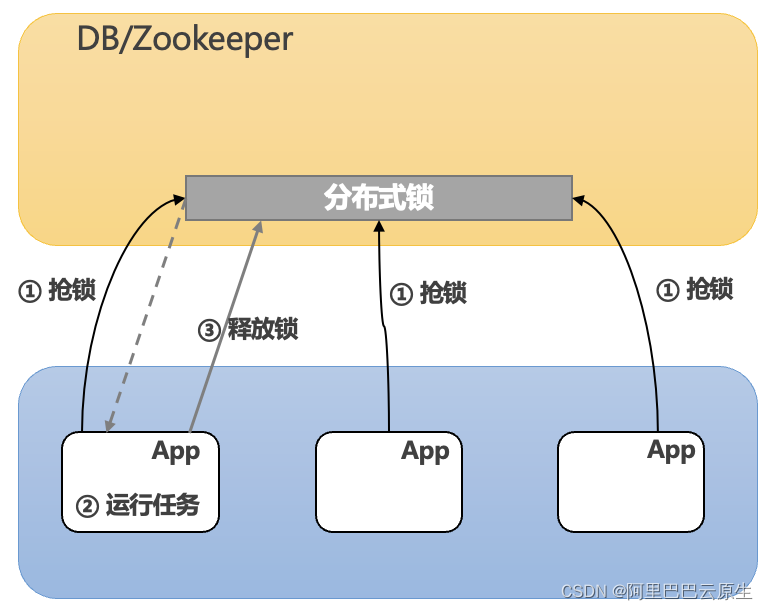
作者:黄晓萌(学仁) 定时任务是每个业务常见的需求,比如每分钟扫描超时支付的订单,每小时清理一次数据库历史数据,每天统计前一天的数据并生成报表等等。 Java 中自带的解决方案 使用 Timer 创建 java.util.TimerTask 任务,在 run 方法中实现业务逻辑。通过 java.util.Timer 进行调度,支持按照固定频率执行。所有的 TimerTask 是在同一个线程中串行执行,相互影响。也就是说,对于同一个 Timer 里的多个 TimerTask 任务,如果一个 TimerTask 任务在执行中,其它 TimerTask 即使到达执行的时间,也只能排队等待。如果有异常产生,线程将退出,整个定时任务就失败。 import java.util.Timer; import java.util.TimerTask; public class TestTimerTask { public static void main(String[] args) { TimerTask timerTask = new TimerTask() { @Override public void run() { System.out.println("hell world"); } }; Timer timer = new Timer(); timer.schedule(timerTask, 10, 3000); } } 使用 ScheduledExecutorService 基于线程池设计的定时任务解决方案,每个调度任务都会分配到线程池中的一个线程去执行,解决 Timer 定时器无法并发执行的问题,支持 fixedRate 和 fixedDelay。 import java.util.Timer; import java.util.TimerTask; public class TestTimerTask { public static void main(String[] args) { TimerTask timerTask = new TimerTask() { @Override public void run() { System.out.println("hell world"); } }; Timer timer = new Timer(); timer.schedule(timerTask, 10, 3000); } } Spring 中自带的解决方案 Springboot 中提供了一套轻量级的定时任务工具 Spring Task,通过注解可以很方便的配置,支持 cron 表达式、fixedRate、fixedDelay。 import java.util.concurrent.Executors; import java.util.concurrent.ScheduledExecutorService; import java.util.concurrent.TimeUnit; public class TestTimerTask { public static void main(String[] args) { ScheduledExecutorService ses = Executors.newScheduledThreadPool(5); //按照固定频率执行,每隔5秒跑一次 ses.scheduleAtFixedRate(new Runnable() { @Override public void run() { System.out.println("hello fixedRate"); } }, 0, 5, TimeUnit.SECONDS); //按照固定延时执行,上次执行完后隔3秒再跑 ses.scheduleWithFixedDelay(new Runnable() { @Override public void run() { System.out.println("hello fixedDelay"); } }, 0, 3, TimeUnit.SECONDS); } } Spring Task 相对于上面提到的两种解决方案,最大的优势就是支持 cron 表达式,可以处理按照标准时间固定周期执行的业务,比如每天几点几分执行。 业务幂等解决方案 现在的应用基本都是分布式部署,所有机器的代码都是一样的,前面介绍的 Java 和 Spring 自带的解决方案,都是进程级别的,每台机器在同一时间点都会执行定时任务。这样会导致需要业务幂等的定时任务业务有问题,比如每月定时给用户推送消息,就会推送多次。 于是,很多应用很自然的就想到了使用分布式锁的解决方案。即每次定时任务执行之前,先去抢锁,抢到锁的执行任务,抢不到锁的不执行。怎么抢锁,又是五花八门,比如使用 DB、zookeeper、redis。 使用 DB 或者 Zookeeper 抢锁 使用 DB 或者 Zookeeper 抢锁的架构差不多,原理如下: 定时时间到了,在回调方法里,先去抢锁。 抢到锁,则继续执行方法,没抢到锁直接返回。 执行完方法后,释放锁。 示例代码如下: import org.springframework.scheduling.annotation.EnableScheduling; import org.springframework.scheduling.annotation.Scheduled; import org.springframework.stereotype.Component; @Component @EnableScheduling public class MyTask { /** * 每分钟的第30秒跑一次 */ @Scheduled(cron = "30 * * * * ?") public void task1() throws InterruptedException { System.out.println("hello cron"); } /** * 每隔5秒跑一次 */ @Scheduled(fixedRate = 5000) public void task2() throws InterruptedException { System.out.println("hello fixedRate"); } /** * 上次跑完隔3秒再跑 */ @Scheduled(fixedDelay = 3000) public void task3() throws InterruptedException { System.out.println("hello fixedDelay"); } } 当前的这个设计,仔细一点的同学可以发现,其实还是有可能导致任务重复执行的。比如任务执行的非常快,A 这台机器抢到锁,执行完任务后很快就释放锁了。B 这台机器后抢锁,还是会抢到锁,再执行一遍任务。 使用 redis 抢锁 使用 redis 抢锁,其实架构上和 DB/zookeeper 差不多,不过 redis 抢锁支持过期时间,不用主动去释放锁,并且可以充分利用这个过期时间,解决任务执行过快释放锁导致任务重复执行的问题,架构如下: 示例代码如下: @Component @EnableScheduling public class MyTask { /** * 每分钟的第30秒跑一次 */ @Scheduled(cron = "30 * * * * ?") public void task1() throws InterruptedException { String lockName = "task1"; if (tryLock(lockName, 30)) { System.out.println("hello cron"); releaseLock(lockName); } else { return; } } private boolean tryLock(String lockName, long expiredTime) { //TODO return true; } private void releaseLock(String lockName) { //TODO } } 看到这里,可能又会有同学有问题,加一个过期时间是不是还是不够严谨,还是有可能任务重复执行? ——的确是的,如果有一台机器突然长时间的 fullgc,或者之前的任务还没处理完(Spring Task 和 ScheduledExecutorService 本质还是通过线程池处理任务),还是有可能隔了 30 秒再去调度任务的。 使用 Quartz Quartz[1] 是一套轻量级的任务调度框架,只需要定义了 Job(任务),Trigger(触发器)和 Scheduler(调度器),即可实现一个定时调度能力。支持基于数据库的集群模式,可以做到任务幂等执行。 Quartz 支持任务幂等执行,其实理论上还是抢 DB 锁,我们看下 quartz 的表结构: 其中,QRTZ_LOCKS 就是 Quartz 集群实现同步机制的行锁表,其表结构如下: --QRTZ_LOCKS表结构 CREATE TABLE `QRTZ_LOCKS` ( `LOCK_NAME` varchar(40) NOT NULL, PRIMARY KEY (`LOCK_NAME`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8; --QRTZ_LOCKS记录 +-----------------+ | LOCK_NAME | +-----------------+ | CALENDAR_ACCESS | | JOB_ACCESS | | MISFIRE_ACCESS | | STATE_ACCESS | | TRIGGER_ACCESS | +-----------------+ 可以看出 QRTZ_LOCKS 中有 5 条记录,代表 5 把锁,分别用于实现多个 Quartz Node 对 Job、Trigger、Calendar 访问的同步控制。 开源任务调度中间件 上面提到的解决方案,在架构上都有一个问题,那就是每次调度都需要抢锁,特别是使用 DB 和 Zookeeper 抢锁,性能会比较差,一旦任务量增加到一定的量,就会有比较明显的调度延时。还有一个痛点,就是业务想要修改调度配置,或者增加一个任务,得修改代码重新发布应用。 于是开源社区涌现了一堆任务调度中间件,通过任务调度系统进行任务的创建、修改和调度,这其中国内最火的就是 XXL-JOB 和 ElasticJob。 ElasticJob ElasticJob[2] 是一款基于 Quartz 开发,依赖 Zookeeper 作为注册中心、轻量级、无中心化的分布式任务调度框架,目前已经通过 Apache 开源。 ElasticJob 相对于 Quartz 来说,从功能上最大的区别就是支持分片,可以将一个任务分片参数分发给不同的机器执行。架构上最大的区别就是使用 Zookeeper 作为注册中心,不同的任务分配给不同的节点调度,不需要抢锁触发,性能上比 Quartz 上强大很多,架构图如下: 开发上也比较简单,和 springboot 结合比较好,可以在配置文件定义任务如下: elasticjob: regCenter: serverLists: localhost:2181 namespace: elasticjob-lite-springboot jobs: simpleJob: elasticJobClass: org.apache.shardingsphere.elasticjob.lite.example.job.SpringBootSimpleJob cron: 0/5 * * * * ? timeZone: GMT+08:00 shardingTotalCount: 3 shardingItemParameters: 0=Beijing,1=Shanghai,2=Guangzhou scriptJob: elasticJobType: SCRIPT cron: 0/10 * * * * ? shardingTotalCount: 3 props: script.command.line: "echo SCRIPT Job: " manualScriptJob: elasticJobType: SCRIPT jobBootstrapBeanName: manualScriptJobBean shardingTotalCount: 9 props: script.command.line: "echo Manual SCRIPT Job: " 实现任务接口如下: @Component public class SpringBootShardingJob implements SimpleJob { @Override public void execute(ShardingContext context) { System.out.println("分片总数="+context.getShardingTotalCount() + ", 分片号="+context.getShardingItem() + ", 分片参数="+context.getShardingParameter()); } 运行结果如下: 分片总数=3, 分片号=0, 分片参数=Beijing 分片总数=3, 分片号=1, 分片参数=Shanghai 分片总数=3, 分片号=2, 分片参数=Guangzhou 同时,ElasticJob 还提供了一个简单的 UI,可以查看任务的列表,同时支持修改、触发、停止、生效、失效操作。 遗憾的是,ElasticJob 暂不支持动态创建任务。 XXL-JOB XXL-JOB[3] 是一个开箱即用的轻量级分布式任务调度系统,其核心设计目标是开发迅速、学习简单、轻量级、易扩展,在开源社区广泛流行。 XXL-JOB 是 Master-Slave 架构,Master 负责任务的调度,Slave 负责任务的执行,架构图如下: XXL-JOB 接入也很方便,不同于 ElasticJob 定义任务实现类,是通过@XxlJob 注解定义 JobHandler。 @Component public class SampleXxlJob { private static Logger logger = LoggerFactory.getLogger(SampleXxlJob.class); /** * 1、简单任务示例(Bean模式) */ @XxlJob("demoJobHandler") public ReturnT<String> demoJobHandler(String param) throws Exception { XxlJobLogger.log("XXL-JOB, Hello World."); for (int i = 0; i < 5; i++) { XxlJobLogger.log("beat at:" + i); TimeUnit.SECONDS.sleep(2); } return ReturnT.SUCCESS; } /** * 2、分片广播任务 */ @XxlJob("shardingJobHandler") public ReturnT<String> shardingJobHandler(String param) throws Exception { // 分片参数 ShardingUtil.ShardingVO shardingVO = ShardingUtil.getShardingVo(); XxlJobLogger.log("分片参数:当前分片序号 = {}, 总分片数 = {}", shardingVO.getIndex(), shardingVO.getTotal()); // 业务逻辑 for (int i = 0; i < shardingVO.getTotal(); i++) { if (i == shardingVO.getIndex()) { XxlJobLogger.log("第 {} 片, 命中分片开始处理", i); } else { XxlJobLogger.log("第 {} 片, 忽略", i); } } return ReturnT.SUCCESS; } } XXL-JOB 相较于 ElasticJob,最大的特点就是功能比较丰富,可运维能力比较强,不但支持控制台动态创建任务,还有调度日志、运行报表等功能。 XXL-JOB 的历史记录、运行报表和调度日志,都是基于数据库实现的: 由此可以看出,XXL-JOB 所有功能都依赖数据库,且调度中心不支持分布式架构,在任务量和调度量比较大的情况下,会有性能瓶颈。不过如果对任务量级、高可用、监控报警、可视化等没有过高要求的话,XXL-JOB 基本可以满足定时任务的需求。 企业级解决方案 开源软件只能提供基础的调度能力,在监管控上的能力一般都比较弱。比如日志服务,业界往往使用 ELK 解决方案;短信报警,需要有短信平台;监控大盘,现在主流的解决方案是 Prometheus;等等。企业想要有这些能力,不但需要额外的开发成本,还需要昂贵的资源成本。 另外使用开源软件也伴随着稳定性的风险,就是出了问题没人能处理,想要反馈到社区等社区处理,这个链路太长了,早就产生故障了。 阿里云任务调度 SchedulerX[4] 是阿里巴巴自研的基于 Akka 架构的一站式任务调度平台,兼容开源 XXL-JOB、ElasticJob、Quartz(规划中),支持 Cron 定时、一次性任务、任务编排、分布式跑批,具有高可用、可视化、可运维、低延时等能力,自带企业级监控大盘、日志服务、短信报警等服务。 优势 安全防护 • 多层次安全防护:支持 HTTPS 和 VPC 访问,同时还有阿里云的多层安全防护,防止恶意攻击。 • 多租户隔离机制:支持多地域、命名空间和应用级别的隔离。 • 权限管控:支持控制台读写的权限管理,客户端接入的鉴权。 企业级高可用 SchedulerX2.0 采用高可用架构,任务多备份机制,经历阿里集团多年双十一、容灾演练,可以做到任意一个机房挂了,任务调度都不会收到影响。 商业级报警运维 • 报警:支持邮件、钉钉、短信、电话,(其他报警方式在规划中)。支持任务失败、超时、无可用机器报警。报警内容可以直接看出任务失败的原因,以钉钉机器人为例。 • 运维操作:原地重跑、重刷数据、标记成功、查看堆栈、停止任务、指定机器等。 丰富的可视化 schedulerx 拥有丰富的可视化能力,比如: • 用户大盘 • 查看任务历史执行记录 • 查看任务运行日志 • 查看任务运行堆栈 • 查看任务操作记录 兼容开源 Schedulerx 兼容开源 XXL-JOB、ElasticJob、Quartz(规划中),业务不需要改一行代码,即可以将任务托管在 SchedulerX 调度平台,享有企业级可视化和报警的能力。 Spring 原生 SchedulerX 支持通过控制台和 API 动态创建任务,也支持 Spring 声明式任务定义,一份任务配置可以拿到任何环境一键启动,配置如下: spring: schedulerx2: endpoint: acm.aliyun.com #请填写不同regin的endpoint namespace: 433d8b23-06e9-xxxx-xxxx-90d4d1b9a4af #region内全局唯一,建议使用UUID生成 namespaceName: 学仁测试 appName: myTest groupId: myTest.group #同一个命名空间下需要唯一 appKey: myTest123@alibaba #应用的key,不要太简单,注意保管好 regionId: public #填写对应的regionId aliyunAccessKey: xxxxxxx #阿里云账号的ak aliyunSecretKey: xxxxxxx #阿里云账号的sk alarmChannel: sms,ding #报警通道:短信和钉钉 jobs: simpleJob: jobModel: standalone className: com.aliyun.schedulerx.example.processor.SimpleJob cron: 0/30 * * * * ? # cron表达式 jobParameter: hello overwrite: true shardingJob: jobModel: sharding className: ccom.aliyun.schedulerx.example.processor.ShardingJob oneTime: 2022-06-02 12:00:00 # 一次性任务表达式 jobParameter: 0=Beijing,1=Shanghai,2=Guangzhou overwrite: true broadcastJob: # 不填写cron和oneTime,表示api任务 jobModel: broadcast className: com.aliyun.schedulerx.example.processor.BroadcastJob jobParameter: hello overwrite: true mapReduceJob: jobModel: mapreduce className: com.aliyun.schedulerx.example.processor.MapReduceJob cron: 0 * * * * ? jobParameter: 100 overwrite: true alarmUsers: #报警联系人 user1: userName: 张三 userPhone: 12345678900 user2: userName: 李四 ding: https://oapi.dingtalk.com/robot/send?access_token=xxxxx 分布式跑批 SchedulerX 提供了丰富的分布式模型,可以处理各种各样的分布式业务场景。包括单机、广播、分片、MapReduce[5] 等,架构如下: SchedulerX 的 MapReduce 模型,简单几行代码,就可以将海量任务分布式到多台机器跑批,相对于大数据跑批来说,具有速度快、数据安全、成本低、简单易学等特点。 任务编排 SchedulerX 通过工作流进行任务编排,并且提供了一个可视化的界面,操作简单,拖拖拽拽即可配置一个工作流。详细的任务状态图能一目了然看到下游任务为什么没跑,方便定位问题。 可抢占的任务优先级队列 常见场景是夜间离线报表业务,比如很多报表任务是晚上 1、2 点开始跑,要控制应用最大并发的任务数量(否则业务扛不住),达到并发上限的任务会在队列中等待。同时要求早上 9 点前必须把 KPI 报表跑出来,可以设置 KPI 任务高优先级,会抢占低优先级任务优先调度。 SchedulerX 支持可抢占的任务优先级队列,可以在控制台动态配置: Q&A Kubernetes 应用可以接入 SchedulerX 吗? ——可以的,无论是物理机、容器、还是 Kubernetes pod,都可以接入 SchedulerX。 我的应用不在阿里云上,可否使用 SchedulerX? ——可以的,任何云平台或者本地机器,只要能访问公网,都可以接入 SchedulerX。 发布云原生技术最新资讯、汇集云原生技术最全内容,定期举办云原生活动、直播,阿里产品及用户最佳实践发布。与你并肩探索云原生技术点滴,分享你需要的云原生内容。 关注【阿里巴巴云原生】公众号,获取更多云原生实时资讯!

优秀的个人博客,低调大师

工业物联网趋势已经形成

当前制造业面临着劳动力上涨,老龄化、经济放缓等多重挑战,同时全球制造竞争也在变得越来越激烈。随着信息技术(IT)和操作技术(OT)的融合发展,许多公司开始寻找新的方法来实现连接。通过物联网收集供应商和客户资料,实现更详细的生产信息,使整个制造运营效率达到最大化,物联网将数字世界和现实世界无缝连接,机器系统和人不再有隔阂,能够进行信息交换并自动调整生产计划。工业物联网制造业为了让产品更快上市、满足越来越高的复杂度、以及提升生产设备的连网性,因此正扩大投资各种新的科技,来应付未来5年的挑战。 尽管制造业者都表示会增加投资,但将近半数(49%)表示技术的复杂度是一大障碍,而预算有限(43%)和难以与旧系统集成(39%)也是常见的问题。研究显示,有将近3分之2的制造业者准备在2022年以前利用智能科技,转型成完全连网的工厂。 目前仅有43%的制造业者正在使用智能科技。研究指出,有62%受访者使用纸和笔来追踪重要的生产环节,让公司面临巨大的出错风险。这个数字预计会在2022年下降到5分之1,预计业者将陆续导入条形码、RFID与行动装置。 工业物联网(IIoT)是这一切转型的核心,制造业者透过IIoT来实现工业4.0,结合条形码、RFID、穿戴式装置、自动化系统与其它创新科技,来追踪实体的生产流程,让公司能更快速做出决策。生产流程的实时监测,预计到2022年会增加到21%。 例如,在生产流程中安装更多的条形码扫描点,就是一个作法。这执行起来很容易,也逐渐变成标准作业程序,并让企业掌握更高的能见度。在组装在线,可以直接采取必要行动,并检验相关零件,而不是一直等到质量检验关卡才做。 制造业现在必须管理庞大的产品复杂度,来满足客户的个人化需求。因此,质量管理变成最大的疑虑与挑战—有58%的受访者都这么认为。 而随著制造业持续自动化,穿戴式装置也将扮演更重要的角色。有5分之2的制造业者表示,会在2022年以前增加穿戴式科技的投资;但这对制造业而言,依然是一个很新的概念。在某些情境下,穿戴式装置可以让工作者看到所需信息,而且手部仍可继续进行操作。 穿戴式装置除了提升生产力,还可以提升工厂安全。配备录像眼镜的员工,可以记录生产在线发生的状况。穿戴式装置甚至可以监测员工的健康,并提醒管理者可能发生的问题。 许多国际公司、供应商或工作人员通过虚拟现实系统走得更近,从而提高思想的流动,掌握更多的知识和技术经验。物联网技术促进了制造业的发展,廉价的数据存储和传输将增加企业的分权管理和灵活性。工业物联网作为一种新模式,使得工厂生产变得更透明、更高效,同时其定制化功能使得企业拥有较高的灵活性,新模式将进一步提升企业国际化竞争力,推动产业全球化进程。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册