首页 文章 精选 留言 我的

精选列表

搜索[离线容错],共8805篇文章
优秀的个人博客,低调大师

Android SDK 安装中组件的离线安装方法 (share)

这次安装在Android开发环境搭建及配置phoneGap中,搜到了一下资料,留个备份。 源地址:http://anlab-qiao.blog.sohu.com/190769011.html 一、迅雷下载地址 资源 https://dl-ssl.google.com/android/repository/xxx.zip , xxx用以下包替换。 API 3 android-1.5_r04-windows.zip android-1.5_r04-macosx.zip android-1.5_r04-linux.zipAPI 4 android-1.6_r03-windows.zip android-1.6_r03-linux.zip android-1.6_r03-macosx.zip API 5 android-2.0_r01-linux.zip android-2.0_r01-macosx.zip android-2.0_r01-windows.zip API 6 android-2.0.1_r01-linux.zip android-2.0.1_r01-macosx.zip android-2.0.1_r01-windows.zip API 7 android-2.1_r03-linux.zip(三种平台共用) API 8 android-2.2_r03-linux.zip(三种平台共用) API 9 android-2.3.1_r02-linux.zip(三种平台共用)API 10android-2.3.3_r02-linux.zip(三种平台共用) API 11 android-3.0_r02-linux.zip(三种平台共用)API 12 android-3.1_r03-linux.zip(三种平台共用) API 13 android-3.2_r01-linux.zip(三种平台共用) API 14 android-14_r01.zip(三种平台共用) sysimg_armv7a-14_r01.zip 2.2 Android SDK Platform-tools revision 7platform-tools_r07-windows.zip platform-tools_r07-linux.zip platform-tools_r07-macosx.ziprevision 8platform-tools_r08-windows.zip platform-tools_r08-linux.zip platform-tools_r08-macosx.zip 2.3 Android SDK Tools revision 12tools_r12-windows.zip tools_r12-linux.zip tools_r12-macosx.ziprevision 13tools_r13-windows.zip tools_r13-linux.zip tools_r13-macosx.ziprevision 14tools_r14-windows.zip tools_r14-linux.zip tools_r14-macosx.zip 2.4 Android SDK Docs for Android API X, revision Y docs-3.2_r01-linux.zip docs-14_r01.zip Android SDK Samples for Android API X, revision Ysamples-2.1_r01-linux.zip samples-2.2_r01-linux.zip samples-2.3_r01-linux.zip samples-2.3.3_r01-linux.zip samples-3.0_r01-linux.zip samples-3.1_r01-linux.zip samples-3.2_r01-linux.zip samples-14_r01.zip 二、将下载的压缩包放入temp文件夹下 例如:D:\ProgramFiles\android-sdk-windows\temp 三、点击SDK Manaer.exe,让其自动解压缩。 四、配置环境变量 PATH =D:\ProgramFiles\android-sdk-windows\tools SDK安装完成 本文转自挨踢前端博客园博客,原文链接http://www.cnblogs.com/duanhuajian/archive/2012/10/21/2732883.html如需转载请自行联系原作者 @挨踢前端

优秀的个人博客,低调大师

破解“工具调用幻觉”:AI Agent函数校验、沙箱隔离与容错编排实战

2026年7月,AI Agent工具调用失败率成为生产环境最大痛点。Gartner数据显示,38%的Agent故障源于参数幻觉或接口误用,导致业务中断与数据污染。行业正从“盲目信任模型输出”转向“防御性工具工程”,通过Schema强校验、运行时沙箱与智能重试机制,将不可靠的概率输出转化为确定性系统交互。这标志着Agent开发进入“鲁棒集成”时代,工具调用的可靠性已取代推理能力,成为衡量Agent能否落地的核心指标。

优秀的个人博客,低调大师

跨越“单机瓶颈”:AI Agent多智能体编排、状态管理与容错实战

2026年7月,AI Agent正从单体应用迈向多智能体协作时代,但“协作混乱”成为规模化新障碍。Gartner指出,缺乏标准化编排框架的多Agent项目交付失败率超65%。行业共识已从“堆叠更强模型”转向构建确定性协作架构,通过状态机编排、共享记忆与优雅降级,将概率性智能体纳入工程化协同体系,这已成为复杂业务场景落地的核心基础设施。

优秀的个人博客,低调大师

一台不容错过的Java单元测试代码“永动机”

作者:京东零售 陈志良 作为一名京东的软件匠人,我们开发的软件支撑着数亿的用户,责任是重大的,因此我们深深地敬畏每一行代码,那如何将我们的失误降到最低呢?那就是单元测试,它会让我们树立对代码的自信心。为此我们期望能打造一台生产Java单元测试代码的“永动机”,源源不断地为开发者生产代码,辅助大家高效地做好单元测试,节省精力能投入到更多的业务创新中去。 一、开发者对代码的自信心来自哪里? 京东随着业务高速发展,我们缔造的、承载着数亿用户的、功能强大的系统,在经过十多年的打磨,也变得日益复杂。作为JD软件开发者,我们是自豪的,但我们承担的责任也是重大的。我们每一次的创新,就像打造一座下图这样的过山车。我们在为客户带来如此顶级体验的同时,更重要的是保障每一次的旅行都可以安全地着陆。所以我们深深敬畏每一行代码,努力将我们的失误降到最低,为业务保驾护航。  然而,业务的迭代速度之快,交付压力之大,作为“过山车”的缔造者,你是否有以下的经历? 1)每一次上线也像坐了一次过山车呢? 2)你亲手打造的“过山车”,自己是否亲身体验过呢? 3)你是否曾对测试同学说,“你们先上去坐坐看,遇到了问题再下来找我”? 如果你的答案是:每一次上线也像坐了一次过山车,我们自己打造的“过山车”自己不敢坐,我们的代码要靠测试同学兜底,那么就说明我们对自己的代码是缺乏信心的,我们的工作还有待提升的空间;反之则说明,作为一个开发者你已经相当优秀了。 那么如何让我们开发者建立对自己代码的信心呢,一般来说有两种方式: 1)对“过山车”的每个零件都进行充分的测试,保证每一部分在各种场景下都可以正常工作,对所有的异常也能够处理得当,这即是单元测试。 2)对“过山车”启动前做好充分“检查”,这即是代码评审,我们邀请其他大佬帮我们把关,及时发现问题。 这两部分工作在开发阶段都是必要的工作,二者缺一不可。 代码评审是借助了外力,单元测试则是内功,靠自己,靠开发者自测来增强对代码的信心。 本文主要和大家一起探讨单元测试,如何把这单元测试的内功练好。 二、做好单测,慢即是快 对于单元测试的看法,业界同仁理解多有不同,尤其是在业务变化快速的互联网行业,通常的问题主要有,必须要做吗?做到多少合适?现在没做不也挺好的吗?甚至一些大佬们也是存在不同的看法。我们如下先看一组数字: “在 STICKYMINDS 网站上的一篇名为 《 The Shift-Left Approach to Software Testing 》 的文章中提到,假如在编码阶段发现的缺陷只需要 1 分钟就能解决,那么单元测试阶段需要 4 分钟,功能测试阶段需要 10 分钟,系统测试阶段需要 40 分钟,而到了发布之后可能就需要 640 分钟来修复。”——来自知乎网站节选 对于这些数字的准确性我们暂且持保留意见。大家可以想想我们实际中遇到的线上问题大概需要消耗多少工时,除了要快速找到bug,修复bug上线,还要修复因为bug引发的数据问题,最后还要复盘,看后续如何能避免线上问题,这样下来保守估计应该不止几人日吧。所以这篇文章作者所做的调研数据可信度还是很高的, 缺陷发现越到交付流程的后端,其修复成本就越高。 有人说写单测太耗费时间了,会延长交付时间,其实不然: 1)研测同学大量的往返交互比编写单测的时间要长的多,集成测试的时间被拖长。 2)没经过单测的代码bug会多,开发同学忙于修复各种bug,对代码debug跟踪调试找问题,也要消耗很多精力。 3)后期的线上问题也会需要大量的精力去弥补。 如果有了单元测试的代码,且能实现一个较高的行覆盖率,则可以将问题尽可能消灭在开发阶段。同时有了单测代码的积累,每次代码改动后可以提前发现这次改动引发的其他关联问题,上线也更加放心。单测虽然使提测变慢了一些,软件质量更加有保障,从而节省了后续同学的精力,从整体看其实效率更高。 所以做好单测,慢即是快。 我们集团技术委员会大佬们从去年开始也在倡议大家做单元测试, 做为一名开发者我们需要对自己的代码质量负责, 也更能体现我们大厂开发者的工匠精神。 三、如何编写单元测试 1、单元测试的主流框架及核心思想 以下我们先通过一个案例介绍下主流框架的思想。下图为一个简单的函数执行逻辑,在函数体内直接调用了函数1、函数2、函数3,间接调用了函数2.1,其中1和2分别是普通函数,2.1和3涉及到外部系统调用,例如JSF、Redis、MySQL等操作,最后返回结果。 代码大致如下: public class MyObject { @Autowired private RedisHelper redisHelper; public MyResult myFunction(InputParam inputParam){ MyResult myResult = new MyResult(); //普通代码块 if(inputParam.isFlag()) { //如果标记flag为true,则执行函数1 String f1 = invokeFunction1(); //调用函数3,函数3封装了redis中间件操作 String f3 = redisHelper.get(f1); myResult.setResult(f3); } else { //调用函数2,在函数2内部又调用远程服务接口2.1 String f2 = invokeFunction2(); myResult.setResult(f2); } return myResult; } 在当下微服务时代,系统间的交互变得更加日益复杂,以上图例只是简化的例子,实际系统中的上下游外部依赖多达十几个,甚至几十个。 在这种情况下,如果过度依赖外部服务就很难保障每次用例执行成功,会影响到单元测试的执行效果。 所以,当前主流的单元测试框架大都采用了mock技术,来屏蔽对外部服务的依赖,例如:mockito、powermock、Spock等。 图例中2.1和3即是对外部系统的调用,单元测试代码中需要将其API进行mock,在用例运行时运用mock技术模拟外部API接口的返回值,具体写法此处不作举例。 要注意的是,使用Mock技术的框架需要注意两个前提: 1)接口契约是相对稳定的(例如redis的api暂时不会发生变化),否则就需要调整测试用例代码以适应最新的接口契约,如果不调整则此单元测试用例代码是无效的。 2)接口调用是幂等的,同样的入参需要返回相同的结果,否则用例中的断言会失败或者需要对断言进行特殊的处理,例如比较时忽略某些变化的内容(如id、时间等)。 2、第1种单元测试用例的编写方案 接下来写一段基于mockito框架的测试代码,下图中的做法是,开发者编写了一个用例,对外部函数2.1和3进行了mock,然后在测试用例中调用待测函数,再对返回值进行断言。  示意代码如下: //创建函数2.1的mock对象 @MockBean private JSFService myJSFService; //创建函数3的mock对象 @MockBean private RedisHelper redisHelper; @Autowired MyObject myObject; @Test public void testMyFunction(InputParameter parameter) { //根据入参mock返回数据 when(myJSFService.invoke(parameter.getX())).thenReturn(X); when(redisHelper.get(parameter.getY())).thenReturn(Y); //期望结果 MyResult expect = new Result(XXX); //实际调用被测试函数,返回结果 MyResult actual = vmyObject.myFunction(parameter); //断言 Assert.assertEquals(actual.toString(), expect.toString()); 运行该用例后,除了待测函数,连带函数1、2一起都被测试到了,在实际中调用链路会更加复杂,那么这种写法如何呢?我们做个简要的分析: 1)优点:用例的编码量较少,实现速度快,一个用例覆盖了3个函数,整个业务执行路径也都被测试到了,另外单测覆盖率的指标不受影响,只要执行过的代码都会被统计到。 2)缺点:如果用例失败,那么去定位问题会较慢,实际项目中链路会更加复杂,因此排查问题的时间会大幅度增加,假设问题发生在函数1或2中,那么就需要通过debug跟踪逐步排查。 那么这样的做法究竟如何?到这里如果测试的同学看到肯定会有疑问,这样做的用例跟集成测试阶段的自动化用例有啥区别?是的,从效果上看是一样的,只不过将运行转移到了开发阶段。对于排查和定位问题仍然比较困难,所以从真正的效果出发,不建议只是这样做,请往下看。 3、第2种单元测试用例的编写方案 第2种方案是对每一个方法都写用例代码,每个方法是独立的功能单元,隔离该被测方法的全部依赖,将外部依赖的调用都做好mock。大致的做法类似下图: 待测函数的测试用例中会涉及到3个mock,分别是函数1、2、3;函数1、函数2也都有自己的测试用例,这样做出来的单元测试效果会更好。在Java中方法是一个最小存在的可测试单元,所以对每个方法进行独立的充分测试,那么组装后就可以充分保障代码的整体质量,同时也能快速的定位问题,实现快速交付。 目前,业界开发者大多采用第一种偏集成测试的写法,因其工作量相对较小,在交付压力较大的时候,甚至会放弃单元测试,这种情况在互联网行业尤为普遍。在单元测试不足的情况下,则需要靠增强测试人员的人力来缓解质量问题,但当前业务增长压力渐渐显现,各大公司都聚焦于内部提效,人力成本控制更加严格。打铁还需自身硬,当下我们每一位开发者都需要加强自身的内功修炼。 综合以上两种方案,小结如下: 1)为每个方法写单元测试的测试用例,本方法外部调用均为mock。 2)编写一小部分集成测试用例,对整体功能进行部分验证,集成测试主要工作还是交给测试同学。 四、单元测试应遵循的一些原则 目前行业比较流行的有FIRST原则,整理如下 1)Fast,快速 单元测试用例是执行一个特定任务的一小段代码。与集成测试不同的是,单元测试很小很轻,尽量做到没有网络通信,不执行数据库操作,不启动web容器等耗时操作,使它们能快速执行。开发者在实现应用程序功能时,或者调试bug时,需要频繁去运行单元测试验证结果是否正确。如果单元测试足够快速,就可以省去不必要浪费的时间,提高工作效率。 2)Independent/Isolated,独立/隔离 单元测试的用例需要是相互独立的。一个单元测试不要依赖其它单元测试所产生的结果,因为在大多数情况下,单元测试是以随机的顺序运行的。另外,用例代码也不应该依赖和修改外部数据或服务等共享资源,做到测试前后共享资源数据一致,可以用mock或stub的方式对依赖项进行模拟,屏蔽这些依赖项的不确定性,确保单元测试结果的准确性。 3)Repeatable,可重复 单元测试需要保持运行稳定,在不同的计算机、不同的时间点多次运行,都应该产生相同的结果,如果间歇性的失败,会导致我们不断的去查看这个测试,不可靠的测试也就失去了意义。 4)Self-Validating,自我验证 单元测试需要采用Assert相关断言函数等进行自我验证,即当单元测试执行完毕之后就可得知测试结果,全程无需人工介入,不应该在测试完成后做任何额外的人工检查。注意在单元测试中不要添加任何打印日志的语句,避免通过打印出日志才能判断单元测试是否通过。 5)Thorough/Timely,彻底/及时 在测试一个功能时,我们除了考虑主要逻辑路径以外,还要关注边界或异常场景。因此在多数时候,我们除了要创建一个具有有效入参的单元测试,还需要准备其他使用了无效入参的单元测试。例如被测方法入参有一个范围,从MIN到MAX,那么应该创建额外的单元测试来测试输入为MIN和MAX时是否能正确处理。另外就是及时性,等代码稳定运行再来补齐单元测试可能是低效的,最有效的方式是在写好功能函数接口后(实现函数功能前)进行单元测试。 五、单元测试的现状及痛点 1、我们通过对行业现状进行调研后,有以下发现: 1)从行业特点看:传统行业软件(ERP、CRM等)单测覆盖率至少达到80%以上,互联网行业软件较低,一般低于50%,大部分没有。 2)从软件特点看:用户量较大的软件(工具类、中间件等)基础软件覆盖率相对较高,至少80%以上,需求变化快的业务类软件相对较低。 3)从开发习惯看:国外开发的软件较高,更加重视软件的质量,大多数开源软件覆盖率至少都在60%以上。国内开发者多数未养成习惯。 2、单元测试这么重要的事情,为什么在企业中实际中却很难做好呢,主要有以下几个痛点: 1)开发者需要投入更多的工作量:一个应用系统的单元测试代码行数与应用功能代码行数比至少为1:1,复杂应用则更高。通常来说每提升1%的单测行覆盖率,则需要编写业务代码1%的测试代码,所以开发者需要付出更多工作量。随着单元测试覆盖率的提升,每提升1%,都需要编写大量的用例,因为后续的用例至少有80%,甚至是90%以上的代码运行路径是重叠的,最坏的情况是增加了一个用例,只多了一行的覆盖。 2)存量代码数量庞大:我们目前关注的指标还只是核心系统的覆盖率,全量代码覆盖率提升更加困难,经年积累的应用中保持代码活跃的数量依然很庞大,要做现有代码的单元测试编码需要消耗大量人力。 3)单元测试代码容易失效:单元测试的代码需要持续维护,新业务需求引发的代码变更会导致原有的单测代码失效,在业务高速迭代的情况下,没有额外精力投入,要么忽略,要么删除,在这种情况下,很难持续维持一个较高的覆盖率指标。 归根结底,单元测试最大的困难就是成本问题,做好单元测试,我们的开发者需要持续投入大量的精力,而在业务需求高速迭代的情况下,我们该如何破局?答案就是:自动化技术 六、单元测试自动化调研 其实,单测自动化技术的发展至少已有15年以上的历史,目前主流的技术是静态代码分析技术,它是指无需运行被测代码,仅通过分析或检查源程序的语法、结构、过程、接口等来检查程序的正确性,找出代码隐藏的错误和缺陷。主要的代表产品有:EvoSuite、Squaretest等。 上图是EvoSuite工具根据现有被测代码自动生成的测试代码,目前这类产品生成的单测代码的行覆盖率一般可以达到30%左右,代码越复杂效果越差,它们可以作为简单业务场景的单测代码生成方案。 主要的优点有:纯客户端工具,安装即可使用,不需复杂配置。支持多种开发平台:支持idea、eclipse、命令行等多种工具。 主要的不足:生成代码质量不高、单测覆盖率较低:受限于代码分析技术和现实技术框架的复杂多样,生成的代码质量不高,单测覆盖率较低,只能适用于简单业务场景,且生成的代码需要人工判断有效性。例如订单sendpay这样的标记包含了丰富的业务语义,则很难通过静态分析生成有效的用例代码。 七、我们的一些想法与技术突破 1、将录制的数据转化为单元测试用例 基于静态代码分析局限性,我们需要寻找一个新的方向,那么如何能够获得更加丰富的业务数据呢,而不是通过一些策略生产数据,前年咱们零售交易研发创新了月光宝盒,完全可以将数据录制下来,于是我们就想到是否可以利用宝盒录制到的数据,反向生成测试用例呢,以此来实现快速生产单元测试的用例代码。大致的方案思路如下:  2、标杆验证的效果给了我们信心 乍一听这个想法有点疯狂,我们针对这个想法做了效果验证,虽然还没有达到奇效,但整体思路得到了检验,事实证明,这个方案虽然很难,但是是可行的,以下为Y侧做的标杆案例的尝试。通过4个标杆的试运行情况分析,接入一周内,生成代码2.3万行,单测行覆盖率提升幅度均在30%以上。  3、然而,该方案还并不完美,我们还有些建议 如果你仔细看过前面提到的单元测试原则,针对该方案一定会有疑问,没错,它违反了及时性原则,我们应该在写代码时或者提测前完成啊,测试阶段再录制生成已经晚了。的确,该方案不是完美的,为此我们给出的建议是: 1)针对存量代码,由于目前我们的存量代码数量较大,该方案将会产生较大的效果,开发者只要将录制工具集成到被测应用即可,接入成功后,如果测试同学能帮忙跑一次全量回归测试最佳,则可以快速生成大量的用例代码,如果测试同学时间不充足,则借助测试同学的日常测试逐渐积累数据,经过一两周后也能获得大量用例代码。 2)对于新开发代码,在开发者完成编码后的自测阶段,由开发者自己本地运行程序进行自测、录制,也能帮助我们生成一大批用例,然后可以基于生成的用例,再通过复制、手工调整进行快速扩充用例,从而保证单元测测的及时性。 3)特殊业务场景处理,对于边界或异常用例很难录制到,则可以通过手工复制用例,再修改用例数据,来扩充用例,这种方式比纯手工编写还是快很多,尤其是mock对象非常复杂的时候,用该方案可以在1分钟内即可基于已有用例扩展一个新用例。 4、生成的单元测试用例是什么样子 下面举一个生成单元测试用例代码的实际例子,该例子基于Mockito框架,每一个用例方法对应一个JSON文件,JSON文件中存储着用例运行时需要的出入参、全部外部调用的数据,用例代码和数据全部由工具自动生成,生成的大部分代码都是在帮助开发者将录制的数据组装Mock对象,这部分工作量在实际开发中是最大的,因此可以大幅度减小开发者自己纯手工编码工作。当需要手工扩充用例时,只需要将用例方法和数据文件复制一份,再对用例数据做出调整即可制作出新的用例。 数据文件样例: /artt/StockStatusReOccupySplitServiceImpl1#HpCm.json 5、我们所遇到的技术挑战 我们遇到了很多技术难点,由于基于宝盒录制的数据在还原代码时信息还不足,需要增加更多的录制信息与特殊应用场景处理,主要难点有: 1)结构化数据的录制与还原,复杂泛型的还原、复杂对象的序列化和反序列化 2)基于动态代理技术实现代码的特殊处理,如mybatis、JSF 3)用例的采样控制,重复用例的识别与剔除, 4)用例结果断言的多样性,需要丰富的比对策略 期间涉及到了大量的底层技术研究,截至目前我们仍然有很多技术点需要攻克。例如,我们正在做的应用接入提升,将Spring AOP的方式用agent+ASM方式进行替换,实现代码增强在不重启服务的情况下动态挂载、卸载,也进一步降低接入成本,减少对应用的入侵。 八、单测自动化平台的架构  整体分为三部分: 1)录制端,采用月光宝盒为基座,基于Spring AOP和ASM字节码增强agent技术,开发者在应用内部进行集成,同时在应用启动中增加agent代理脚本设置。 2)平台端,采集到的数据将被发往平台端,平台端主要负责应用注册、录制用例的统一管理等,并为生成端提供用例抽取服务。 3)生成端,以idea插件、命令行脚本的形式,为用户的应用生成代码,并且按照每个用例覆盖业务代码的行号进行去重。最终生成的代码提交到代码库,bamboo集成获取代码进行单测运行与指标的采集。 九、单测平台的共建与接入 单元测试自动化技术是当今软件领域的一个难题,行业的开发者也都在积极寻求突破 我们愿意做一只啄木鸟 帮助开发者找到代码里的虫子 通过自动化技术建立单测的信心 但啄木鸟还做不到全面自动化 大家不要因为它的存在而变得懈怠 每位开发者仍然要发扬: 工匠精神,以人为本,工具为辅 在提测前轻松做好单元测试

优秀的个人博客,低调大师

(二十七) 跟我学习SpringCloud-使用Hystrix实现容错处理

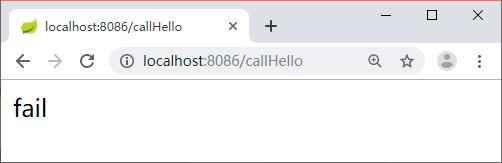
创建一个新的Maven项目 hystrix-feign-demo,增加 Hystrix 的依赖,代码如下所示。 <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-netflix-hystrix</artifactId> </dependency> 在启动类上添加 @EnableHystrix 或者 @EnableCircuitBreaker。注意,@EnableHystrix 中包含了 @EnableCircuitBreaker。 然后编写一个调用接口的方法,在上面增加一个 @HystrixCommand 注解,用于指定依赖服务调用延迟或失败时调用的方法,代码如下所示。 @GetMapping("/callHello") @HystrixCommand(fallbackMethod = "defaultCallHello") public String callHello() { String result = restTemplate.getForObject("http://localhost:8088/house/hello", String.class); return result; } 当调用失败触发熔断时会用 defaultCallHello 方法来回退具体的内容,定义 default-CallHello 方法的代码如下所示。 public String defaultCallHello() { return "fail"; } 只要不启动 8088 端口所在的服务,调用 /callHello 接口,就可以看到返回的内容是“fail”,如图 1 所示。 将启动类上的 @EnableHystrix 去掉,重启服务,再次调用 /callHello 接口可以看到返回的是 500 错误信息,这个时候就没有用到回退功能了。 { code: 500, message: "I/O error on GET request for "http://localhost:8088/house/hello": Connection refused; nested exception is java.net.ConnectException: Connection refused ", data: null } 配置详解 HystrixCommand 中除了 fallbackMethod 还有很多的配置,下面我们来看看这些配置,如下表所示: HystrixCommand 配置详解 名称 说明 hystrix.command.default.execution.isolation .strategy 该配置用来指定隔离策略,具体策略有下面 2 种。 THREAD:线程隔离,在单独的线程上执行,并发请求受线程池大小的控制。 SEMAPHORE:信号量隔离,在调用线程上执行,并发请求受信号量计数器的限制。 hystrix.command.default.execution.isolation .thread.timeoutInMilliseconds 该配置用于 HystrixCommand 执行的超时时间设置,当 HystrixCommand 执行的时间超过了该配置所设置的数值后就会进入服务降级处理,单位是毫秒,默认值为 1000。 hystrix.command.default.execution .timeout.enabled 该配置用于确定是否启用 execution.isolation.thread.timeoutInMilliseconds 设置的超时时间,默认值为 true。设置为 false 后 execution.isolation.thread.timeoutInMilliseconds 配置也将失效。 hystrix.command.default.execution.isolation .thread.interruptOnTimeout 该配置用于确定 HystrixCommand 执行超时后是否需要中断它,默认值为 true。 hystrix.command.default.execution.isolation .thread.interruptOnCancel 该配置用于确定 HystrixCommand 执行被取消时是否需要中断它,默认值为 false。 hystrix.command.default.execution.isolation .semaphore.maxConcurrentRequests 该配置用于确定 Hystrix 使用信号量策略时最大的并发请求数。 hystrix.command.default.fallback.isolation .semaphore.maxConcurrentRequests 该配置用于如果并发数达到该设置值,请求会被拒绝和抛出异常并且 fallback 不会被调用,默认值为 10。 hystrix.command.default.fallback.enabled 该配置用于确定当执行失败或者请求被拒绝时,是否会尝试调用 hystrixCommand.getFallback(),默认值为 true。 hystrix.command.default.circuitBreaker.enabled 该配置用来跟踪 circuit 的健康性,如果未达标则让 request 短路,默认值为 true。 hystrix.command.default.circuitBreaker .requestVolumeThreshold 该配置用于设置一个 rolling window 内最小的请求数。如果设为 20,那么当一个 rolling window 的时间内(比如说 1 个 rolling window 是 10 秒)收到 19 个请求,即使 19 个请求都失败,也不会触发 circuit break,默认值为 20。 hystrix.command.default.circuitBreaker .sleepWindowInMilliseconds 该配置用于设置一个触发短路的时间值,当该值设为 5000 时,则当触发 circuit break 后的 5000 毫秒内都会拒绝 request,也就是 5000 毫秒后才会关闭 circuit。默认值为 5000。 hystrix.command.default.circuitBreaker .errorThresholdPercentage 该配置用于设置错误率阈值,当错误率超过此值时,所有请求都会触发 fallback,默认值为 50。 hystrix.command.default.circuitBreaker.forceOpen 如果配置为 true,将强制打开熔断器,在这个状态下将拒绝所有请求,默认值为 false。 hystrix.command.default.circuitBreaker.forceClosed 如果配置为 true,则将强制关闭熔断器,在这个状态下,不管错误率有多高,都允许请求,默认值为 false。 hystrix.command.default.metrics .rollingStats.timeInMilliseconds 设置统计的时间窗口值,单位为毫秒。circuit break 的打开会根据 1 个 rolling window 的统计来计算。若 rolling window 被设为 10 000 毫秒,则 rolling window 会被分成多个 buckets,每个 bucket 包含 success、failure、timeout、rejection 的次数的统计信息。默认值为 10 000 毫秒。 hystrix.command.default.metrics .rollingStats.numBuckets 设置一个 rolling window 被划分的数量,若 numBuckets=10、rolling window=10 000,那么一个 bucket 的时间即 1 秒。必须符合 rolling window%numberBuckets==0。默认值为 10。 hystrix.command.default.metrics .rollingPercentile.enabled 是否开启指标的计算和跟踪,默认值为 true。 hystrix.command.default.metrics .rollingPercentile.timeInMilliseconds 设置 rolling percentile window 的时间,默认值为 60 000 毫秒 hystrix.command.default.metrics .rollingPercentile.numBuckets 设置 rolling percentile window 的 numberBuckets,默认值为 6。 hystrix.command.default.metrics .rollingPercentile.bucketSize 如果 bucket size=100、window=10 秒,若这 10 秒里有 500 次执行,只有最后 100 次执行会被统计到 bucket 里去。增加该值会增加内存开销及排序的开销。默认值为 100。 hystrix.command.default.metrics .healthSnapshot.intervalInMilliseconds 用来计算影响断路器状态的健康快照的间隔等待时间,默认值为 500 毫秒。 hystrix.command.default.requestCache.enabled 是否开启请求缓存功能,默认值为 true。 hystrix.command.default.requestLog.enabled 记录日志到 HystrixRequestLog,默认值为 true。 hystrix.collapser.default.maxRequestsInBatch 单次批处理的最大请求数,达到该数量触发批处理,默认为 Integer.MAX_VALUE。 hystrix.collapser.default.timerDelayInMilliseconds 触发批处理的延迟,延迟也可以为创建批处理的时间与该值的和,默认值为 10 毫秒。 hystrix.collapser.default.requestCache.enabled 是否启用对 HystrixCollapser.execute() 和 HystrixCollapser.queue() 的请求缓存,默认值为 true。 hystrix.threadpool.default.coreSize 并发执行的最大线程数,默认值为 10。 hystrix.threadpool.default.maxQueueSize BlockingQueue 的最大队列数。当设为 -1 时,会使用 SynchronousQueue;值为正数时,会使用 LinkedBlcokingQueue。该设置只会在初始化时有效,之后不能修改 threadpool 的 queue size。默认值为 -1。 hystrix.threadpool.default.queueSizeRejectionThreshold 即使没有达到 maxQueueSize,但若达到 queueSizeRejectionThreshold 该值后,请求也会被拒绝。因为 maxQueueSize 不能被动态修改,而 queueSizeRejectionThreshold 参数将允许我们动态设置该值。if maxQueueSize==-1,该字段将不起作用。 hystrix.threadpool.default.keepAliveTimeMinutes 设置存活时间,单位为分钟。如果 coreSize 小于 maximumSize,那么该属性控制一个线程从实用完成到被释放的时间。默认值为 1 分钟。 hystrix.threadpool.default .allowMaximumSizeToDivergeFromCoreSize 该属性允许 maximumSize 的配置生效。那么该值可以等于或高于 coreSize。设置 coreSize 小于 maximumSize 会创建一个线程池,该线程池可以支持 maximumSize 并发,但在相对不活动期间将向系统返回线程。默认值为 false。 hystrix.threadpool.default.metrics .rollingStats.timeInMilliseconds 设置滚动时间窗的时间,单位为毫秒,默认值是 10 000。 hystrix.threadpool.default.metrics .rollingStats.numBuckets 设置滚动时间窗划分桶的数量,默认值为 10。 官方的配置信息文档请参考:https://github.com/Netflix/Hystrix/wiki/Configuration。 上面列出来的都是 Hystrix 的配置信息,那么在Spring Cloud中该如何使用呢?只需要在接口的方法上面使用 HystrixCommand 注解(如下代码所示),指定对应的属性即可。 @HystrixCommand(fallbackMethod = "defaultCallHello",commandProperties = { @HystrixProperty(name="execution.isolation.strategy", value = "THREAD") } ) @GetMapping("/callHello") public String callHello() { String result = restTemplate.getForObject("http://localhost:8088/house/hello", String.class); return result; } 给大家推荐分布式架构源码

优秀的个人博客,低调大师

Kubernetes 正式登陆 Docker Desktop 稳定版,尝鲜演示不容错过!

本文首发自“Docker公司”公众号(ID:docker-cn)编译丨小东每周一、三、五 与您不见不散! 早在今年1月份,我们就为 MacOS 和 Windows 系统的上的Docker Desktop 的 Edge 渠道提供了 Kubernetes。今天,我们很高兴地宣布,Kubernetes 编排已经正式在 Docker Desktop 的稳定渠道发布! Docker Desktop 是在桌面计算机上运行 Kubernetes 集群最快速、最简单的方法,同时还能让您自由选择 Docker Swarm。Docker 开发者 Elton Stoneman 最近发布了一个简短的视频,演示了在 Windows 和 Mac 系统上的 Docker Desktop。在视频中,Elton 演示了: 在 Docker Desktop 中交替使用 Kubernetes 和 Swarm 编排; 将 Docker Desktop 和容器集成到您的环境和工作流中; 使用 Docker Desktop 部署 .NET、NodeJS 和 Java应用程序,包括使用 Compose 文件部署到Kubernetes; 如果想了解更多相关信息,请观看以下演示视频: Docker 官方微信公众号入口:http://t.cn/ReCkfgm Docker Desktop 很容易在 macOS 和 Windows 10 Pro 系统上安装,可以点击下列链接获取。 如果您已经在使用 Docker Desktop 的 Stable 版本(默认情况下),那么您很快就会看到自动更新的通知了。 Docker Community Edition for Mac:https://store.docker.com/editions/community/docker-ce-desktop-mac Docker Community Edition for Windows:https://store.docker.com/editions/community/docker-ce-desktop-windows 用 Kubernetes 在您的桌面上能做什么? Docker Desktop 是时下配置 Docker 开发/测试环境最流行的方式,每天都有数百万开发人员使用它来构建、测试和调试容器化应用程序。使用 Docker Desktop 构建的美妙之处在于,无论您是 macOS 还是 Windows 系统用户,您都可以在您自己的桌面上部署与 Docker 企业版的生产系统相同设置的 Docker 容器镜像。Docker Desktop 已获得 Kubernetes 的一致性认证,因此您可以放心的使用。 Docker Desktop 用于在本地构建、测试和发布应用程序,然后 Docker 企业版提供了大规模保护和管理生产应用程序的能力。Docker Desktop 消除了“该应用程序在我的机器上运行”的问题,因为您在开发、测试和生产环境中运行了相同的 Docker 容器化应用程序,您可以选择 Docker Swarm 或 Kubernetes 进行编排。 期待您的反馈! 请将您的反馈意见、改进建议、错误、投诉等发送给我们,以便我们让 Docker Desktop 变得更好。 您可以直接在文尾处留言!

优秀的个人博客,低调大师

springCloud(12):使用Hystrix实现微服务的容错处理-Hystrix的监控

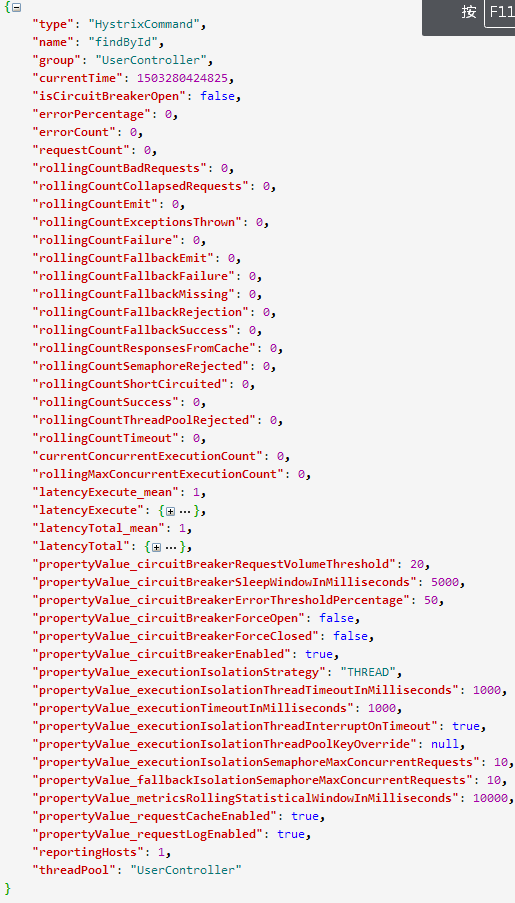
一、简介 Hystrix提供了几乎实时的监控。HystrixCommand和HystrixObserv-ableCommand在执行时,会生成执行结果和运行指标,比如每秒执行的请求数、成功数等,这些监控数据对分析应用系统的状态很有用。 使用Hystrix的模块hystrix-metrics-event-stream,就可将这些监控的指标信息以text/event-stream的格式暴露给外部系统。spring-cloud-starter-hystrix已包含该模块,在此基础上,只须为项目添加spring-boot-starter-actuator,就可使用/hystrix.stream端点获得Hystrix的监控信息了。 我们以前的项目spring-hystrix-consumer中就已经包含了spring-cloud-starter-hystrix、spring-boot-starter-actuator,启动访问:http://localhost:8087/user/1后,再访问:http://localhost:8087/manage/hystrix.stream,会重复出现如下内容: 这是因为系统会不断地刷新以获取实时的监控数据.Hystrix的监控指标非常全面,例如HystrixCommand的名称、group名称、断路器状态、错误率、错误数等。 二、使用Hystrix Dashboard可视化监控数据 前面通过访问/hystrix.stream端点获得的数据很难一眼看出系统当前的运行状态,可是使用Hystrix Dashboard可以让监控数据图形化、可视化。 操作: 1、创建一个maven工程,加入Hystrix Dashboard依赖 1 2 3 4 <dependency> <groupId>org.springframework.cloud< / groupId> <artifactId>spring - cloud - starter - hystrix - dashboard< / artifactId> < / dependency> 2、编写启动类,添加@EnableHystrixDashboard注解 3、配置yml文件端口8086 测试: 1、访问http://localhost:8087/hystrix.stream,可看到Hystrix Dashbord的主页,如下: 2、随意设置一个title,并点击Monitor Stream,这里Title是:测试,URl是:http://localhost:8087/manage/hystrix.stream 注意:此处没有将Hystrix Dashboard注册到Eureka Server上,在生产环境中,为了更方便的管理Hystrix Dashboard,可将其注册到Eureka Server上。 三、使用Turbine聚合监控数据 前面使用的/hystrix.stream端点监控单个微服务。然而在使用微服务架构的应用系统一般会包含多个微服务,每个微服务通常都会部署多个实例。如果每次只能查看单个实例的监控数据,就必须在Hystrix Dashboard上切换想要监控的地址,这显然很不方便。 3.1、Turbine简介 Turbine是一个聚合Hystrix监控数据的工具,它可将所有相关/hystrix.stream端点的数据聚合到一个组合的/turbine.stream中,从而让集群的监控更加方便。 3.2、使用Turbine监控多个微服务 a、创建一个maven项目,添加turbine依赖: 1 2 3 4 5 <!--turbine--> < dependency > < groupId >org.springframework.cloud</ groupId > < artifactId >spring-cloud-starter-turbine</ artifactId > </ dependency > b、在启动类上添加@EnableTurbine注解 c、编写application.yml配置文件 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 spring: profiles: active: -dev application: name:hystrix-turbine eureka: client: service-url: defaultZone:http://liuy2:5010/eureka/ #设置与EurekaServer交互的地址,查询服务和注册服务都需要依赖这个地址,多个用逗号分隔 instance: prefer-ip-address:true turbine: app-config:hystrix-consumer-movie,ribbon-consumer-movie #参数指定了需要收集监控信息的服务名 cluster-name-expression: "'default'" #参数指定了集群名称为 --- spring: profiles: active:dev server: port:5014 说明:使用上面配置,Turbine会在Eureka Server中找到hystrix-consumer-movie和ribbon-consumer-movie这两个微服务,并聚合这两个微服务的监控数据。 d、测试 第一步:依次启动Eureka Server(4010)、provide-user(4011)、hystrix-consumer-movie(5012)、ribbon-consumer-movie(5011)、hystrix-turbine(5014)、hystrix-dashboard(5013) 第二步:访问http://localhost:5012/user/1,让hystrix-consumer-movie微服务产生监控数据 第三步:访问http://localhost:5011/user/1,让ribbon-consumer-movie微服务产生监控数据 第四步:打开Hystrix Dashboard首页http://localhost:5013/hystrix.stream,在URL栏填写http://localhost:5014/turbine.stream,随意填写title,点击Monitor Stream后出现如下图: 问题:在一些场景下,如微服务与Turbine网络不通,监控数据怎么处理? -- 使用消息中间件收集数据 3.3、使用rabbitmq收集监控数据 改造微服务:hystrix-consumer-movie a、添加以下依赖 1 2 3 4 5 6 7 8 < dependency > < groupId >org.springframework.cloud</ groupId > < artifactId >spring-cloud-netflix-hystrix-stream</ artifactId > </ dependency > < dependency > < groupId >org.springframework.cloud</ groupId > < artifactId >spring-cloud-starter-stream-rabbit</ artifactId > </ dependency > b、在application.yml中添加 1 2 3 4 5 6 spring: rabbitmq: host:192.168.175.13 port:5672 username:liuy password:123456 改造:hystrix-turbine a、添加以下依赖 1 2 3 4 5 6 7 8 9 < dependency > < groupId >org.springframework.cloud</ groupId > < artifactId >spring-cloud-starter-turbine-stream</ artifactId > </ dependency > <!--rabbit--> < dependency > < groupId >org.springframework.cloud</ groupId > < artifactId >spring-cloud-starter-stream-rabbit</ artifactId > </ dependency > 注意:此处删除spring-cloud-starter-turbine依赖 b、修改启动类,将@EnableTurbine改成@EnableTurbineStream c、修改application.yml 1 2 3 4 5 6 spring: rabbitmq: host:192.168.175.13 port:5672 username:liuy password:123456 同时删除:turbine 测试: 第一步:依次启动Eureka Server(4010)、provide-user(4011)、hystrix-dashboard(5013)、hystrix-consumer-movie-rabbitmq(5020)、hystrix-turbine-rabbitmq(5021) 第二步:访问http://localhost:5020/user/1,可正常获取结果 第三步:打开Hystrix Dashboard首页http://localhost:5013/hystrix.stream,在URL栏填写http://localhost:5021/,随意填写title,点击Monitor Stream后出现如下图: 本文转自我爱大金子博客51CTO博客,原文链接http://blog.51cto.com/1754966750/1949857如需转载请自行联系原作者 我爱大金子

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册