首页 文章 精选 留言 我的

精选列表

搜索[智能问数],共10011篇文章
优秀的个人博客,低调大师

面试被问MySQL 主从复制,怎么破?

一、前言 随着应用业务数据不断的增大,应用的响应速度不断下降,在检测过程中我们不难发现大多数的请求都是查询操作。 此时,我们可以将数据库扩展成主从复制模式,将读操作和写操作分离开来,多台数据库分摊请求,从而减少单库的访问压力,进而应用得到优化。整理了一份328页MySQLPDF文档 本次测试使用两个虚拟机:ip:192.168.2.21(主) ip:192.168.2.22(从) 二、主从复制原理 同步操作通过 3 个线程实现,其基本步骤如下: 主服务器将数据的更新记录到二进制日志中(记录被称作二进制日志事件)-- 主库线程; 从库将主库的二进制日志复制到本地的中继日志(relay log)-- 从库 I/O 线程; 从库读取中继日志中的事件,将其重放到数据中 -- 从库 SQL 线程。 三、配置主库 # 3.1 创建用户 为了安全起见,准备创建一个新用户用于从库连接主库。 # 创建用户 create user 'repl'@'%' identified by 'repl'; # 授权,只授予复制和客户端访问权限 grant replication slave,replication client on *.* to 'repl'@'%' identified by 'repl'; # 3.2 修改配置文件 1)vim /etc/my.cnf 在[mysqld]下添加: log-bin = mysql-bin log-bin-index = mysql-bin.index binlog_format = mixed server-id = 21 sync-binlog = 1 character-set-server = utf8 2)保存文件并重启主库: service mysqld restart 配置说明: log-bin:设置二进制日志文件的基本名; log-bin-index:设置二进制日志索引文件名; binlog_format:控制二进制日志格式,进而控制了复制类型,三个可选值 -STATEMENT:语句复制 -ROW:行复制 -MIXED:混和复制,默认选项 server-id:服务器设置唯一ID,默认为1,推荐取IP最后部分; sync-binlog:默认为0,为保证不会丢失数据,需设置为1,用于强制每次提交事务时,同步二进制日志到磁盘上。 # 3.3 备份主数据库数据 若主从数据库都是刚刚装好且数据都是一致的,直接执行 show master status 查看日志坐标。 若主库可以停机,则直接拷贝所有数据库文件。 若主库是在线生产库,可采用 mysqldump 备份数据,因为它对所有存储引擎均可使用。 1)为了获取一个一致性的快照,需对所有表设置读锁: flush tables with read lock; 2)获取二进制日志的坐标: show master status; 返回结果: +------------------+----------+--------------+------------------+-------------------+ | File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set | +------------------+----------+--------------+------------------+-------------------+ | mysql-bin.000001 | 120 | | | | +------------------+----------+--------------+------------------+-------------------+ 1 row in set (0.00 sec) 3)备份数据: # 针对事务性引擎 mysqldump -uroot -ptiger --all-database -e --single-transaction --flush-logs --max_allowed_packet=1048576 --net_buffer_length=16384 > /data/all_db.sql # 针对 MyISAM 引擎,或多引擎混合的数据库 mysqldump -uroot --all-database -e -l --flush-logs --max_allowed_packet=1048576 --net_buffer_length=16384 > /data/all_db.sql 1 row in set (0.00 sec) 4)恢复主库的写操作: unlock tables; 四、配置从库 # 4.1 修改配置文件 1)vim /etc/my.cnf 在[mysqld]下添加: log-bin = mysql-bin binlog_format = mixed log-slave-updates = 0 server-id = 22 relay-log = mysql-relay-bin relay-log-index = mysql-relay-bin.index read-only = 1 slave_net_timeout = 10 2)保存文件并重启从库: service mysqld restart 配置说明: log-slave-updates:控制 slave 上的更新是否写入二进制日志,默认为0;若 slave 只作为从服务器,则不必启用;若 slave 作为其他服务器的 master,则需启用,启用时需和 log-bin、binlog-format 一起使用,这样 slave 从主库读取日志并重做,然后记录到自己的二进制日志中; relay-log:设置中继日志文件基本名; relay-log-index:设置中继日志索引文件名; read-only:设置 slave 为只读,但具有super权限的用户仍然可写; slave_net_timeout:设置网络超时时间,即多长时间测试一下主从是否连接,默认为3600秒,即1小时,这个值在生产环境过大,我们将其修改为10秒,即若主从中断10秒,则触发重新连接动作。 # 4.2 导入备份数据 如果 3.3 步骤中没进行备份,忽略此步骤。 mysql -uroot -p < /data/all_db.sql # 4.3 统一二进制日志的坐标 根据 3.3 步骤获取的坐标,统一到从库中: change master to master_host='192.168.2.21', master_user='repl', master_password='repl', master_port=3306, master_log_file='mysql-bin.000001', master_log_pos=120; 注意:此处使用的是新创建的账户。 # 4.4 启动主从复制 1)启动从库 slave 线程: start slave; 2)查看从服务器复制功能状态: show slave status\G; 返回结果: *************************** 1. row *************************** Slave_IO_State: Waiting for master to send event Master_Host: 192.168.2.21 Master_User: repl Master_Port: 3306 Connect_Retry: 60 Master_Log_File: mysql-bin.000001 Read_Master_Log_Pos: 120 Relay_Log_File: mysql-relay-bin.000002 Relay_Log_Pos: 283 Relay_Master_Log_File: mysql-bin.000001 Slave_IO_Running: Yes Slave_SQL_Running: Yes Replicate_Do_DB: Replicate_Ignore_DB: Replicate_Do_Table: Replicate_Ignore_Table: Replicate_Wild_Do_Table: Replicate_Wild_Ignore_Table: Last_Errno: 0 Last_Error: Skip_Counter: 0 Exec_Master_Log_Pos: 120 此处只张贴部分返回结果。 结果说明: Slave_IO_Running:此进程负责 slave 从 master 上读取 binlog 日志,并写入 slave 上的中继日志。 Slave_SQL_Running:此进程负责读取并执行中继日志中的 binlog 日志。 这两个进程的状态需全部为 YES,只要有一个为 NO,则复制就会停止。 当 Relay_Master_Log_File = Master_Log_File 且 Read_Master_Log_Pos = Exec_Master_Log_Pos 时,则表明 slave 和 master 处于完全同步的状态。 五、验证 使用一个简单的例子: 在主库创建名为 mysql_test 的数据库,如果同步成功,那么在从库中也能查询出名为 mysql_test 数据库。 六、参考资料 MySQL 官网整理了一份328页MySQLPDF文档 dev.mysql.com/doc/refman/…

优秀的个人博客,低调大师

聊到JVM(还怕面试官问JVM吗?)

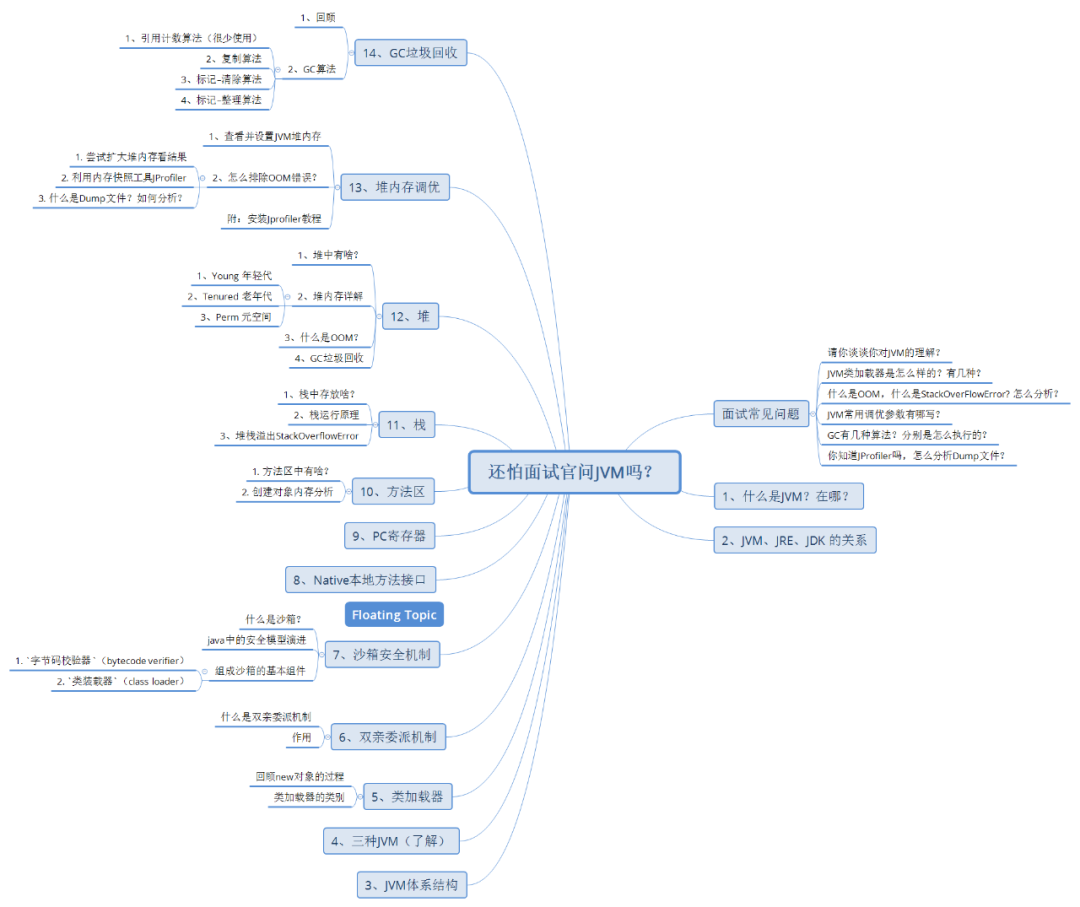
点击上方"程序员历小冰",选择“置顶或者星标” 你的关注意义重大! 前言 无论什么级别的Java从业者, JVM都是进阶时必须迈过的坎。不管是工作还是面试中,JVM都是必考题。 如果不懂JVM的话,薪酬会非常吃亏(近70%的面试者挂在JVM上了)。 请你谈谈你对JVM的理解? JVM类加载器是怎么样的?有几种? 什么是OOM,什么是StackOverFlowError? 怎么分析? JVM常用调优参数有哪写? GC有几种算法?分别是怎么执行的? 你知道JProfiler吗,怎么分析Dump文件? 第一次看到这些真真实实的面试题的时候,我~ 这都什么玩意??????? 经过一段时间的研究!!接下来,我将以大白话从头到尾给大家讲讲 Java虚拟机 !! 不对的地方还请大家指正~ 1、什么是JVM?在哪? JVM是Java Virtual Machine(Java虚拟机)的缩写,JVM是一种用于计算设备的规范,它是一个虚构出来的计算机,是通过在实际的计算机上仿真模拟各种计算机功能来实现的。 百度的解释云里雾里,对于我们Java程序员,说白了就是: JVM本质上是一个程序,它能识别.class字节码文件(里面存放的是我们对.java编译后产生的二进制代码),并且能够解析它的指令,最终调用操作系统上的函数,完成我们想要的操作! 关于Java语言的跨平台性,就是因为JVM,我们可以将其想象为一个抽象层,只要这个抽象层JVM正确执行了.class文件,就能运行在各种操作系统之上了!这就是一次编译,多次运行 对于JVM的位置: JVM是运行在操作系统之上的,它与硬件没有直接的交互 2、JVM、JRE、JDK 的关系 JDK(Java Development Kit):Java开发工具包 JRE(Java Runtime Environment):Java运行环境 JDK = JRE + javac/java/jar 等指令工具 JRE = JVM + Java基本类库 3、JVM体系结构 Java虚拟机主要分为五大模块: ‍类装载器子系统 运行时数据区 执行引擎 本地方法接口 垃圾收集模块 ‍ 方法区是一种特殊的堆 栈里面不会有垃圾,用完就弹出了,否则阻塞了main方法 垃圾几乎都在堆里,所以JVM性能调优%99都针对于堆 4、三种JVM(了解) Sun公司 HotSpot (我们都用的这个) BEA公司 JRockit IBM公司 J9 VM 5、类加载器 作用:加载 .Class 字节码文件 1、回顾new对象的过程 publicclassStudent{//私有属性privateStringname;//构造方法publicStudent(Stringname){this.name=name;}} 类是模板、模板是抽象的;对象是具体的,是对抽象的实例化 //运行时,JVM将Test的信息放入方法区publicclassTest{//main方法本身放入方法区publicstaticvoidmain(String[]args){//s1、s2、s3为不同对象Students1=newStudent("zsr");//引用放在栈里,具体的实例放在堆里Students2=newStudent("gcc");Students3=newStudent("BareTH");System.out.println(s1.hashCode());System.out.println(s2.hashCode());System.out.println(s3.hashCode());//class1、class2、class3为同一个对象Class<?extendsStudent>class1=s1.getClass();Class<?extendsStudent>class2=s2.getClass();Class<?extendsStudent>class3=s3.getClass();System.out.println(class1.hashCode());System.out.println(class2.hashCode());System.out.println(class3.hashCode());}} 根据结果,我们发现: ‍s1、s2、s3的hashcode是不同的,因为是三个不同的对象,对象是具体的 class1、class2、class3的hashcode是相同的,因为这是类模板,模板是抽象的 我们画图分析以下 new一个对象的流程: 首先Class Loader读取字节码.class文件,加载初始化生成Student模板类 通过Student模板类new出三个对象 ‍那么Class Loader具体是怎么执行我们的.class字节码文件呢,这就引出了我们类加载器~ 2、类加载器的类别 我们编写这样一个程序 根据返回结果,我们来讲解以下三种加载器: 级别从高到底 1.启动类(根)加载器:BootstrapClassLoader ‍c++编写,加载java核心库java.*,构造拓展类加载器和应用程序加载器。 根加载器加载拓展类加载器,并且将拓展类加载器的父加载器设置为根加载器, 然后再加载应用程序加载器,应将应用程序加载器的父加载器设置为拓展类加载器 由于引导类加载器涉及到虚拟机本地实现细节,我们无法直接获取到启动类加载器的引用;这就是上面那个程序我们第三个结果为null的原因。 加载文件存在位置 2. 拓展类加载器:PlatformClassLoader java编写,加载扩展库,开发者可以直接使用标准扩展类加载器。 java9之前为ExtClassloader,Java9以后改名为PlatformClassLoader 加载文件存在位置 ‍ 3.应用程序加载器:AppClassLoader 1 . java 编写,加载程序所在的目录 2. 是Java默认的类加载器 4.用户自定义类加载器:CustomClassLoader 1 . java 编写,用户自定义的类加载器,可加载指定路径的 class 文件 6、双亲委派机制 1、什么是双亲委派机制 ‍类加载器收到类加载的请求 将这个请求向上委托给父类加载器去完成,一直向上委托,直到根加载器BootstrapClassLoader 根加载器检查是否能够加载当前类,能加载就结束,使用当前的加载器;否则就抛出异常,通知子加载器进行加载;自加载器重复该步骤。 2、作用 举个例子:我们重写以下java.lang包下的String类 发现报错了,这就是 双亲委派机制 起的作用,当类加载器委托到 根加载器 的时候, String类 已经被 根加载器 加载过一遍了,所以不会再加载,从一定程度上防止了危险代码的植入!! 作用总结: 1. 防止重复加载同一个 .class 。通过不断委托父加载器直到根加载器,如果父加载器加载过了,就不用再加载一遍。保证数据安全。 2. 保证系统核心.class,如上述的String类不能被篡改。通过委托方式,不会去篡改核心.class,即使篡改也不会去加载,即使加载也不会是同一个.class对象了。不同的加载器加载同一个.class也不是同一个class对象。这样保证了class执行安全。 7、沙箱安全机制 这里引用了这篇博文引用链接,了解即 可 什么是沙箱? Java安全模型的核心就是Java沙箱(sandbox) 1. 沙箱是一个限制程序运行的环境。沙箱机制就是将 Java 代码限定在虚拟机(JVM)特定的运行范围中,并且严格限制代码对本地系统资源访问,通过这样的措施来保证对代码的有效隔离,防止对本地系统造成破坏。 沙箱主要限制系统资源访问,系统资源包括CPU、内存、文件系统、网络。不同级别的沙箱对这些资源访问的限制也可以不一样。 所有的Java程序运行都可以指定沙箱,可以定制安全策略。 java中的安全模型演进 在Java中将执行程序分成 本地代码 和 远程代码 两种 本地代码可信任,可以访问一切本地资源。 远程代码不可信信在早期的Java实现中,安全依赖于沙箱 (Sandbox) 机制。 如下图所示 如此严格的安全机制也给程序的功能扩展带来障碍,比如当用户希望远程代码访问本地系统的文件时候,就无法实现。 因此在后续的 Java1.1 版本中,针对安全机制做了改进,增加了 安全策略 ,允许用户指定代码对本地资源的访问权限。 如下图所示 在 Java1.2 版本中,再次改进了安全机制,增加了 代码签名 。 不论本地代码或是远程代码,都会按照用户的安全策略设定,由类加载器加载到虚拟机中权限不同的运行空间,来实现差异化的代码执行权限控制。 如下图所示 ‍ 当前最新的安全机制实现,则引入了 域 (Domain) 的概念。 虚拟机会把所有代码加载到不同的系统域和应用域 系统域部分专门负责与关键资源进行交互 应用域部分则通过系统域的部分代理来对各种需要的资源进行访问。 虚拟机中不同的受保护域 (Protected Domain),对应不一样的权限 (Permission)。存在于不同域中的类文件就具有了当前域的全部权限,如下图所示 组成沙箱的基本组件 1.字节码校验器(bytecode verifier) 确保Java类文件遵循Java语言规范。这样可以帮助Java程序实现内存保护。但并不是所有的类文件都会经过字节码校验,比如核心类(如上述java.lang.String)。 2.类装载器(class loader) 其中类装载器在3个方面对Java沙箱起作用 它防止恶意代码去干涉善意的代码; 它守护了被信任的类库边界; 它将代码归入保护域,确定了代码可以进行哪些操作。 虚拟机为不同的类加载器载入的类提供不同的命名空间,命名空间由一系列唯一的名称组成,每一个被装载的类将有一个名字,这个命名空间是由Java虚拟机为每一个类装载器维护的,它们互相之间甚至不可见。 类装载器采用的机制是双亲委派模式。 从最内层JVM自带类加载器开始加载,外层恶意同名类得不到加载从而无法使用; 由于严格通过包来区分了访问域,外层恶意的类通过内置代码也无法获得权限访问到内层类,破坏代码就自然无法生效。 存取控制器(access controller):存取控制器可以控制核心API对操作系统的存取权限,而这个控制的策略设定,可以由用户指定。 安全管理器(security manager):是核心API和操作系统之间的主要接口。实现权限控制,比存取控制器优先级高。 安全软件包(security package):java.security下的类和扩展包下的类,允许用户为自己的应用增加新的安全特性,包括: 安全提供者 消息摘要 数字签名 加密 鉴别 8、Native本地方法接口 JNI:Java Native Interface 本地接口的作用是融合不同的编程语言为Java所用,它的初衷是融合C/C++程序 native :凡是带native关键字的,说明java的作用范围达不到了,会去调用底层c语言的库!进入本地方法栈,调用 本地方法接口JNI ,拓展Java的使用,融合不同的语言为Java所用 Java诞生的时候C、C++横行,为了立足,必须要能调用C、C++的程序 于是在内存区域中专门开辟了一块标记区域:Native Method Stack,登记Native方法 最终在执行引擎执行的的时候通过JNI(本地方法接口)加载本地方法库的方法 目前该方法使用的越来越少了,除非是与硬件有关的应用,比如通过Java程序驱动打印机或者Java系统管理生产设备,在企业级应用中已经比较少见。因为现在的异构领域间通信很发达,比如可以使用 Socket通信,也可以使用 Web service等等,了解即可! 9、PC寄存器 程序计数器 :Program Counter Register 每个线程都有一个程序计数器,是线程私有的,就是一个指针,指向方法区中的方法字节码(用来存储指向像一条指令的地址,也即将要执行的指令代码),在执行引擎读取下一条指令,是一个非常小的内存空间,几乎可以忽略不计 10、方法区 方法区 :Method Area 方法区是被所有线程共享,所有字段和方法字节码,以及一些特殊方法,如构造函数,接口代码也在此定义,简单说,所有定义的方法的信息都保存在该区域,此区域属于共享区间; 方法区与Java堆一样,是各个线程共享的内存区域,用于存储已被虚拟机加载的类信息、常量、静态变量、即时编译器编译后的代码等数据。虽然Java 虚拟机规范把方法区描述为堆的一个逻辑部分,但是它却有一个别名叫做Non-Heap(非堆),目的应该是与Java 堆区分开来。 1. 方法区中有啥? 静态变量(static) 常量(final) 类信息(构造方法、接口定义) 运行时的常量池 2. 创建对象内存分析 创建一个对象时,方法区中会生成对应类的抽象模板;还有对应的常量池、静态变量、类信息、常量 我们通过类模板去new对象的时候 堆中存放实例对象 栈中存放对象的引用,每个对象对应一个地址指向堆中相同地址的实例对象 例如这个例子中,生成了对应的Person模板类,name常量“zsr”放在常量池中,三个对象的引用放在栈中,该引用指向放在堆中的三个实例对象。 这就是堆、栈、方法区的交互关系 11、栈 又称 栈内存 ,主管程序的运行,生命周期和线程同步,线程结束,栈内存就释放了, 不存在垃圾回收 栈:先进后出 队列:先进先出(FIFO) 1、栈中存放啥? 8大基本类型 对象引用 实例的方法 2、栈运行原理 栈表示Java方法执行的内存模型 每调用一个方法就会为每个方法生成一个栈帧(Stack Frame),每个方法被调用和完成的过程,都对应一个栈帧从虚拟机栈上入栈和出栈的过程。 程序正在执行的方法一定在栈的顶部 3、堆栈溢出StackOverflowError 举个例子: publicclassTest{publicstaticvoidmain(String[]args){newTest().a();}publicvoida(){b();}publicvoidb(){a();}} 最开始,main()方法压入栈中,然后执行a(),a()压入栈中;再调用b(),b()压入栈中;以此往复,a与b方法不断被压入栈中,最终导致栈溢出 12、堆 Heap,一个JVM只有一个堆内存(栈是线程级的),堆内存的大小是可以调节的 1、堆中有啥? 实例化的对象 2、堆内存详解 1、Young 年轻代 对象诞生、成长甚至死亡的区 Eden Space(伊甸园区):所有的对象都是在此new出来的 Survivor Space(幸存区) 幸存0区(From Space)(动态的,From和To会互相交换) 幸存1区(To Space) Eden区占大容量,Survivor两个区占小容量,默认比例是8:1:1。 2、Tenured 老年代 3、Perm 元空间 存储的是Java运行时的一些环境或类信息,这个区域不存在垃圾回收!关闭虚拟机就会释放这个区域内存! 这个区域常驻内存,用来存放JDK自身携带的Class对象、Interface元数据。 名称演变 jdk1.6之前:永久代 jdk1.7:永久代慢慢退化,去永久代 jdk1.8之后:永久代改名为元空间 注意:元空间在逻辑上存在,在物理上不存在 新生代 + 老年代的内存空间 = JVM分配的总内存 如图所示: 3、什么是OOM? 内存溢出java.lang.OutOfMemoryError 产生原因: 分配的太少 用的太多 用完没释放 4、GC垃圾回收 GC垃圾回收,主要在年轻代和老年代 首先,对象出生再 伊甸园区 假设伊甸园区只能存一定数量的对象,则每当存满时就会触发一次轻GC(Minor GC) 轻GC清理后,有的对象可能还存在引用,就活下来了,活下来的对象就进入幸存区;有的对象没用了,就被GC清理掉了;每次轻GC都会使得伊甸园区为空 如果幸存区和伊甸园都满了,则会进入老年代,如果老年代满了,就会触发一次重GC(FullGC),年轻代+老年代的对象都会清理一次,活下的对象就进入老年代 如果新生代和老年代都满了,则OOM Minor GC:伊甸园区满时触发;从年轻代回收内存 Full GC:老年代满时触发;清理整个堆空间,包含年轻代和老年代 Major GC:清理老年代 什么情况永久区会崩? 一个启动类加载了大量的第三方Jar包,Tomcat部署了过多应用,或者大量动态生成的反射类 这些东西不断的被加载,直到内存满,就会出现 OOM 13、堆内存调优 1、查看并设置JVM堆内存 查看我们jvm的 堆内存 publicclassTest{publicstaticvoidmain(String[]args){//返回jvm试图使用的最大内存longmax=Runtime.getRuntime().maxMemory();//返回jvm的初始化内存longtotal=Runtime.getRuntime().totalMemory();//默认情况下:分配的总内存为电脑内存的1/4,初始化内存为电脑内存的1/64System.out.println("max="+max/(double)1024/1024/1024+"G");System.out.println("total="+total/(double)1024/1024/1024+"G");}} 默认情况下: JVM最大分配内存为电脑内存的1/4 JVM初始化内存为电脑内存的1/64 我们可以手动调堆内存大小 在 VM options 中可以指定 jvm试图使用的最大内存 和 jvm初始化内存 大小 -Xms1024m -Xmx1024m -Xlog:gc* -Xmx用来设置jvm试图使用的最大内存,默认为1/4 -Xms用来设置jvm初始化内存,默认为1/64 -Xlog:gc*用来打印GC垃圾回收信息 2、怎么排除OOM错误? 1. 尝试扩大堆内存看结果 利用上述方法指定jvm试图使用的最大内存和jvm初始化内存大小 2. 利用内存快照工具JProfiler 内存快照工具: MAT(Eclipse) JProfiler 作用: 分析Dump内存文件,快速定位内存泄漏 获得堆中的文件 获得大的对象 … 3. 什么是Dump文件?如何分析? Dump文件是进程的内存镜像,可以把程序的执行状态通过调试器保存到dump文件中 importjava.util.ArrayList;publicclassTest{byte[]array=newbyte[1024*1024];//1Mpublicstaticvoidmain(String[]args){ArrayList<Test>list=newArrayList<>();intcount=0;try{while(true){list.add(newTest());count++;}}catch(Exceptione){System.out.println("count="+count);e.printStackTrace();}}} 运行该程序,报错OOM 接下来我们设置以下堆内存,并附加生成对应的dump文件的指令 -Xms1m-Xmx8m-XX:+HeapDumpOnOutOfMemoryError -XX:+HeapDumpOnOutOfMemoryError 表示当JVM发生OOM时,自动生成DUMP文件。 再次点击运行,下载了对应的Dump文件 我们右键该类,点击 Show in Explorer 一直点击上级目录,直到找到.hprof文件,与src同级目录下 我们双击打开,可以看到每块所占的大小,便于分析问题 点击Thread Dump,里面是所有的线程,点击对应的线程可以看到相应的错误,反馈到具体的行,便于排错 每次打开Dump文件查看完后,建议删除,可以在idea中看到,打开文件后生成了很多内容,占内存,建议删除 附:安装Jprofiler教程 1.idea中安装插件 2.下载客户端 https://www.ej-technologies.com/download/jprofiler/files 3.安装客户端 选择自定义安装,注意:路径不能有中文和空格 这里name和Company任意,License Key大家可以寻找对应版本的注册机获得 后续默认,安装成功即可!!! 4. 安装完成后,重启IDEA,可以看到我们的内存快照工具 打开IDEA的设置,找到Tools里面的JProfiler,没有设置位置则设置位置 此时则全部安装完成! 14、GC垃圾回收 1、回顾 Garbage Collection:垃圾回收 在12.4中,我们已经对GC的流程进行了大概的讲解,这里做一些总结: JVM在进行GC时,并不是对年轻代、老年代统一回收;大部分时候,回收都是在年轻代 GC分为两种: 轻GC(清理年轻代) 重GC(清理年轻代+老年代) 2、GC算法 1、引用计数算法(很少使用) 每个对象在创建的时候,就给这个对象绑定一个计数器。 每当有一个引用指向该对象时,计数器加一;每当有一个指向它的引用被删除时,计数器减一。 这样,当没有引用指向该对象时,该对象死亡,计数器为0,这时就应该对这个对象进行垃圾回收操作。 2、复制算法 复制算法主要发生在 年轻代 ( 幸存0区 和 幸存1区 ) 当Eden区满的时候,会触发轻GC,每触发一次,活的对象就被转移到幸存区,死的就被GC清理掉了,所以每触发轻GC时,Eden区就会清空; 对象被转移到了幸存区,幸存区又分为From Space和To Space,这两块区域是动态交换的,谁是空的谁就是To Space,然后From Space就会把全部对象转移到To Space去; 那如果两块区域都不为空呢?这就用到了复制算法,其中一个区域会将存活的对象转移到令一个区域去,然后将自己区域的内存空间清空,这样该区域为空,又成为了To Space; 所以每次触发轻GC后,Eden区清空,同时To区也清空了,所有的对象都在From区 这也就是幸存0区和幸存1区总有一块为空的原因 好处:没有内存的碎片(内存集中在一块) 坏处: 浪费了内存空间(浪费了幸存区一半空间) 对象存活率较高的场景下(比如老年代那样的环境),需要复制的东西太多,效率会下降。 最佳使用环境:对象存活度较低的时候,也就是 年轻代 3、标记–清除算法 为每个对象存储一个标记位,记录对象的生存状态 标记阶段:这个阶段内,为每个对象更新标记位,检查对象是否死亡; 清除阶段:该阶段对死亡的对象进行清除,执行 GC 操作。 缺点:两次扫描严重浪费时间,会产生内存碎片 优点:不需要额外的空间 4、标记–整理算法 标记-整理法 是 标记-清除法 的一个改进版。 又叫做 标记-清楚-压缩法 标记阶段,该算法也将所有对象标记为存活和死亡两种状态; 不同的是,在第二个阶段,该算法并没有直接对死亡的对象进行清理,而是将所有存活的对象整理一下,放到另一处空间,然后把剩下的所有对象全部清除。 可以进一步优化,在内存碎片不太多的情况下,就继续标记清除,到达一定量的时候再压缩. 总结 内存(时间复杂度)效率:复制算法 > 标记清除算法 > 标记压缩算法 内存整齐度:复制算法 = 标记压缩法 > 标记清除法 内存利用率:标记压缩法 = 标记清除法 > 复制算法 思考:有没有最优的算法? 没有最优的算法,只有最合适的算法 GC 也称为 分代收集算法 对于 年轻代: 对象存活率低 用复制算法 对于 老年代: 区域大,对象存活率高 用标记清除+标记压缩混合实现 结束! 作者:Baret H 原文链接:http://i8n.cn/iWLG4r -关注我 本文分享自微信公众号 - 程序员历小冰(gh_a1d0b50d8f0a)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Java面试必问通信框架NIO,原理详解

NIO流与块通道与缓冲区缓冲区状态变量文件 NIO 实例选择器套接字 NIO 实例内存映射文件NIO与IO对比PathFilesNIO新的输入/输出 (NIO) 库是在 JDK 1.4 中引入的,弥补了原来的 I/O 的不足,提供了高速的、面向块的 I/O。 NIO核心组件: 通道(Channels)缓冲区(Buffers)选择器(Selectors)流与块I/O 与 NIO 最重要的区别是数据打包和传输的方式,I/O 以流的方式处理数据,而 NIO 以块的方式处理数据。 面向流的 I/O 一次处理一个字节数据:一个输入流产生一个字节数据,一个输出流消费一个字节数据。 为流式数据创建过滤器非常容易,链接几个过滤器,以便每个过滤器只负责复杂处理机制的一部分。不利的一面是,面向流的 I/O 通常相当慢。 面向块的 I/O 一次处理一个数据块,按块处理数据比按流处理数据要快得多。 但是面向块的 I/O 缺少一些面向流的 I/O 所具有的优雅性和简单性。 I/O 包和 NIO 已经很好地集成了,java.io. 已经以 NIO 为基础重新实现了,所以现在它可以利用 NIO 的一些特性。 例如,java.io. 包中的一些类包含以块的形式读写数据的方法,这使得即使在面向流的系统中,处理速度也会更快。 通道与缓冲区 通道通道 Channel 是对原 I/O 包中的流的模拟,可以通过它读取和写入数据。 通道与流的不同之处在于,流只能在一个方向上移动(一个流必须是 InputStream 或者 OutputStream 的子类), 而通道是双向的,可以用于读、写或者同时用于读写。 通道包括以下类型: FileChannel:从文件中读写数据;DatagramChannel:通过 UDP 读写网络中数据;SocketChannel:通过 TCP 读写网络中数据;ServerSocketChannel:可以监听新进来的 TCP 连接,对每一个新进来的连接都会创建一个 SocketChannel。 缓冲区发送给一个通道的所有数据都必须首先放到缓冲区中,同样地,从通道中读取的任何数据都要先读到缓冲区中。也就是说,不会直接对通道进行读写数据,而是要先经过缓冲区。 缓冲区实质上是一个数组,但它不仅仅是一个数组。缓冲区提供了对数据的结构化访问,而且还可以跟踪系统的读/写进程。 缓冲区包括以下类型: ByteBufferCharBufferShortBufferIntBufferLongBufferFloatBufferDoubleBuffer缓冲区状态变量capacity:最大容量;position:当前已经读写的字节数;limit:还可以读写的字节数。状态变量的改变过程举例: ① 新建一个大小为 8 个字节的缓冲区,此时 position 为 0,而 limit = capacity = 8。capacity 变量不会改变,下面的讨论会忽略它。 ② 从输入通道中读取 5 个字节数据写入缓冲区中,此时 position 为 5,limit 保持不变。 ③ 在将缓冲区的数据写到输出通道之前,需要先调用 flip() 方法,这个方法将 limit 设置为当前 position,并将 position 设置为 0。 ④ 从缓冲区中取 4 个字节到输出缓冲中,此时 position 设为 4。 ⑤ 最后需要调用 clear() 方法来清空缓冲区,此时 position 和 limit 都被设置为最初位置。 文件 NIO 实例FileChannel的使用开启FileChannel从FileChannel读取数据/写入数据3.关闭FileChannel public class FileChannelDemo { public static void main(String[] args) throws IOException { //1.创建一个RandomAccessFile(随机访问文件)对象通过RandomAccessFile对象的getChannel()方法。 RandomAccessFile raf=new RandomAccessFile("demo6.txt","rw"); FileChannel fc=raf.getChannel(); //使用FileChannel的read()方法读取数据: ByteBuffer byteBuffer=ByteBuffer.allocate(1024); int bys=fc.read(byteBuffer); //使用FileChannel的write()方法写入数据: ByteBuffer byteBuffer2=ByteBuffer.allocate(1024); byteBuffer2.put("hello".getBytes()); fc.write(byteBuffer2); //3.关闭FileChannel fc.close(); } }以下展示了使用 NIO 快速复制文件的实例:public class CopyFile { public static void main(String[] args) throws IOException { String srcFile="国旗歌.mp4"; String destFile="demo3.mp4"; long start = System.currentTimeMillis(); //copyFile(srcFile,destFile); //共耗时:75309毫秒 //copyFile2(srcFile,destFile); //共耗时:153毫秒 //copyFile3(srcFile,destFile);//共耗时:282毫秒 //copyFile4(srcFile,destFile);//共耗时:44毫秒 copyFile5(srcFile,destFile);//共耗时:共耗时:113毫秒 long end = System.currentTimeMillis(); System.out.println("共耗时:" + (end - start) + "毫秒"); } /** * 基本字节流一次读写一个字节 */ public static void copyFile(String srcFile,String destFile) throws IOException { FileInputStream fis=new FileInputStream(srcFile); FileOutputStream fos=new FileOutputStream(destFile); int by=0; while((by=fis.read())!=-1){ fos.write(by); } fis.close(); fos.close(); } /** * 基本字节流一次读写一个字节数组 */ public static void copyFile2(String srcFile,String destFile) throws IOException{ FileInputStream fis=new FileInputStream(srcFile); FileOutputStream fos=new FileOutputStream(destFile); int len=0; byte[] bys=new byte[1024]; while((len=fis.read(bys))!=-1){ fos.write(bys,0,len); } fis.close(); fos.close(); } /** * 高效字节流一次读写一个字节 */ public static void copyFile3(String srcFile,String destFile) throws IOException{ BufferedInputStream bis=new BufferedInputStream(new FileInputStream(srcFile)); BufferedOutputStream bos=new BufferedOutputStream(new FileOutputStream(destFile)); int by=0; while((by=bis.read())!=-1){ bos.write(by); } bis.close(); bos.close(); } /** * 高效字节流一次读写一个字节数组 */ public static void copyFile4(String srcFile,String destFile) throws IOException{ BufferedInputStream bis=new BufferedInputStream(new FileInputStream(srcFile)); BufferedOutputStream bos=new BufferedOutputStream(new FileOutputStream(destFile)); int len=0; byte[] bys=new byte[1024]; while((len=bis.read(bys))!=-1){ bos.write(bys,0,len); } bis.close(); bos.close(); } /** * 使用FileChannel复制文件 */ public static void copyFile5(String srcFile,String destFile) throws IOException{ FileInputStream fis=new FileInputStream(srcFile); //获取输入字节流的文件通道 FileChannel fcin=fis.getChannel(); FileOutputStream fos=new FileOutputStream(destFile); //获取输出字节流的文件通道 FileChannel fcout=fos.getChannel(); //为缓冲区分配 1024 个字节 ByteBuffer buffer = ByteBuffer.allocateDirect(1024); while(true){ //从输入通道中读取数据到缓冲区中 int r = fcin.read(buffer); // read() 返回 -1 表示 EOF if(r==-1){ break; } //切换读写 buffer.flip(); //把缓冲区的内容写入输出文件中 fcout.write(buffer); //清空缓冲区 buffer.clear(); } } }SocketChannel和ServerSocketChannel的使用SocketChannel用于创建基于TCP协议的客户端对象,因为SocketChannel中不存在accept()方法, 所以,它不能成为一个服务端程序。 通过connect()方法,SocketChannel对象可以连接到其他TCP服务器程序。 ServerSocketChannel允许我们监听TCP协议请求,通过ServerSocketChannel的accept()方法创建一个SocketChannel对象用户从客户端读/写数据。 服务端:通过ServerSocketChannel 绑定ip地址和端口号通过ServerSocketChannel的accept()方法创建一个SocketChannel对象用户从客户端读/写数据创建读数据/写数据缓冲区对象来读取客户端数据或向客户端发送数据关闭SocketChannel和ServerSocketChannelpublic class Server { public static void main(String[] args) throws IOException { //通过ServerSocketChannel 的open()方法创建一个ServerSocketChannel对象 ServerSocketChannel ssc=ServerSocketChannel.open(); //1. 通过ServerSocketChannel 绑定ip地址和端口号 ssc.socket().bind(new InetSocketAddress(InetAddress.getByName("LAPTOP-D9966H06"),8888)); //2. 通过ServerSocketChannel的accept()方法创建一个SocketChannel对象用户从客户端读/写数据 SocketChannel sc=ssc.accept(); //3. 创建读数据/写数据缓冲区对象来读取客户端数据或向客户端发送数据 //读取客户端发送的数据 ByteBuffer buffer=ByteBuffer.allocate(1024); //从通道中读取数据到缓冲区 sc.read(buffer); StringBuffer sb=new StringBuffer(); buffer.flip(); while(buffer.hasRemaining()){ sb.append((char)buffer.get()); } System.out.println(sb.toString()); ByteBuffer buffer2=ByteBuffer.allocate(1024); //向客户端发送数据 buffer2.put("data has been received.".getBytes()); buffer2.flip(); sc.write(buffer2); //4. 关闭SocketChannel和ServerSocketChannel sc.close(); ssc.close(); } }客户端:1.通过SocketChannel连接到远程服务器 2.创建读数据/写数据缓冲区对象来读取服务端数据或向服务端发送数据 3.关闭SocketChannel public class Client { public static void main(String[] args) throws IOException { //1.通过SocketChannel连接到远程服务器 SocketChannel sc=SocketChannel.open(); sc.connect(new InetSocketAddress(InetAddress.getByName("LAPTOP-D9966H06"),8888)); //2.创建读数据/写数据缓冲区对象来读取服务端数据或向服务端发送数据 //向通道中写入数据 ByteBuffer buffer=ByteBuffer.allocate(1024); buffer.put("hello".getBytes()); buffer.flip(); sc.write(buffer); //读取从客户端中获取的数据 ByteBuffer buffer2=ByteBuffer.allocate(1024); sc.read(buffer2); StringBuffer sb=new StringBuffer(); buffer2.flip(); while(buffer2.hasRemaining()){ sb.append((char)buffer2.get()); } System.out.println(sb.toString()); //3.关闭SocketChannel sc.close(); } }DatagramChannel的使用DataGramChannel,类似于java 网络编程的DatagramSocket类; 使用UDP进行网络传输, UDP是无连接,面向数据报文段的协议。 服务端:public class Server { public static void main(String[] args) throws IOException { DatagramChannel dc= DatagramChannel.open(); dc.bind(new InetSocketAddress(InetAddress.getByName("LAPTOP-D9966H06"),8888)); //创建读数据/写数据缓冲区对象来读取客户端数据或向客户端发送数据 //读取客户端发送的数据 ByteBuffer buffer=ByteBuffer.allocate(1024); //从通道中读取数据到缓冲区 dc.receive(buffer); StringBuffer sb=new StringBuffer(); buffer.flip(); while(buffer.hasRemaining()){ sb.append((char)buffer.get()); } System.out.println(sb.toString()); ByteBuffer buffer2=ByteBuffer.allocate(1024); //向客户端发送数据 buffer2.put("data has been received.".getBytes()); buffer2.flip(); dc.send(buffer2,new InetSocketAddress(InetAddress.getByName("LAPTOP-D9966H06"),9999)); dc.close(); } }客户端:public class Client { public static void main(String[] args) throws IOException { DatagramChannel dc= DatagramChannel.open(); dc.bind(new InetSocketAddress(InetAddress.getByName("LAPTOP-D9966H06"),9999)); //创建读数据/写数据缓冲区对象来读取服务端数据或向服务端发送数据 //向通道中写入数据 ByteBuffer buffer=ByteBuffer.allocate(1024); buffer.put("hello".getBytes()); buffer.flip(); dc.send(buffer,new InetSocketAddress(InetAddress.getByName("LAPTOP-D9966H06"),8888)); //读取从客户端中获取的数据 ByteBuffer buffer2=ByteBuffer.allocate(1024); dc.receive(buffer2); StringBuffer sb=new StringBuffer(); buffer2.flip(); while(buffer2.hasRemaining()){ sb.append((char)buffer2.get()); } System.out.println(sb.toString()); dc.close(); } }通道之间的数据传输在Java NIO中如果一个channel是FileChannel类型的,那么他可以直接把数据传输到另一个channel。 transferFrom() :transferFrom方法把数据从通道源传输到FileChanneltransferTo() :transferTo方法把FileChannel数据传输到另一个FileChhannelpublic static void copyFile6(String srcFile,String destFile) throws IOException { FileInputStream fis = new FileInputStream(srcFile); //获取输入字节流的文件通道 FileChannel fcin = fis.getChannel(); FileOutputStream fos = new FileOutputStream(destFile); //获取输出字节流的文件通道 FileChannel fcout = fos.getChannel(); //fcin通道中读出count bytes ,并写入fcout通道中 //fcin.transferTo(0,fcin.size(),fcout); //或者 fcout.transferFrom(fcin,0,fcin.size()); }选择器NIO 常常被叫做非阻塞 IO,主要是因为 NIO 在网络通信中的非阻塞特性被广泛使用。 NIO 实现了 IO 多路复用中的 Reactor 模型,一个线程 Thread 使用一个选择器 Selector 通过轮询的方式 去监听多个通道 Channel 上的事件,从而让一个线程就可以处理多个事件。 通过配置监听的通道 Channel 为非阻塞,那么当 Channel 上的 IO 事件还未到达时, 就不会进入阻塞状态一直等待,而是继续轮询其它 Channel,找到 IO 事件已经到达的 Channel 执行。 因为创建和切换线程的开销很大,因此使用一个线程来处理多个事件而不是一个线程处理一个事件, 对于 IO 密集型的应用具有很好地性能。 应该注意的是,只有套接字 Channel 才能配置为非阻塞,而 FileChannel 不能, 为 FileChannel 配置非阻塞也没有意义。 使用Selector的优点: 使用更少的线程来就可以来处理通道了, 相比使用多个线程, 避免了线程上下文切换带来的开销。 创建选择器Selector selector = Selector.open(); 将通道注册到选择器上ServerSocketChannel ssChannel = ServerSocketChannel.open(); ssChannel.configureBlocking(false);//通道必须配置为非阻塞模式ssChannel.register(selector, SelectionKey.OP_ACCEPT);通道必须配置为非阻塞模式,否则使用选择器就没有任何意义了,因为如果通道在某个事件上被阻塞,那么服务器就不能响应其它事件,必须等待这个事件处理完毕才能去处理其它事件,显然这和选择器的作用背道而驰。 在将通道注册到选择器上时,还需要指定要注册的具体事件,主要有以下几类: SelectionKey.OP_CONNECTSelectionKey.OP_ACCEPTSelectionKey.OP_READSelectionKey.OP_WRITE它们在 SelectionKey 的定义如下: public static final int OP_READ = 1 << 0;public static final int OP_WRITE = 1 << 2;public static final int OP_CONNECT = 1 << 3;public static final int OP_ACCEPT = 1 << 4;可以看出每个事件可以被当成一个位域,从而组成事件集整数。例如: int interestSet = SelectionKey.OP_READ | SelectionKey.OP_WRITE; 监听事件 num = selector.select(); 使用 select() 来监听到达的事件,它会一直阻塞直到有至少一个事件到达。 获取到达的事件Set keys = selector.selectedKeys(); Iterator keyIterator = keys.iterator();while (keyIterator.hasNext()) { SelectionKey key = keyIterator.next(); if (key.isAcceptable()) { // ... } else if (key.isReadable()) { // ... } keyIterator.remove(); } 事件循环因为一次 select() 调用不能处理完所有的事件,并且服务器端有可能需要一直监听事件,因此服务器端处理事件的代码一般会放在一个死循环内。 while (true) { int num = selector.select(); Set<SelectionKey> keys = selector.selectedKeys(); Iterator<SelectionKey> keyIterator = keys.iterator(); while (keyIterator.hasNext()) { SelectionKey key = keyIterator.next(); if (key.isAcceptable()) { // ... } else if (key.isReadable()) { // ... } keyIterator.remove(); } }套接字 NIO 实例public class NIOServer { public static void main(String[] args) throws IOException { //1. 创建选择器 Selector selector = Selector.open(); //2.将通道注册到选择器上 ServerSocketChannel ssChannel = ServerSocketChannel.open(); ssChannel.configureBlocking(false); //通道必须配置为非阻塞模式,否则使用选择器就没有任何意义了 ssChannel.register(selector, SelectionKey.OP_ACCEPT); ServerSocket ss=ssChannel.socket(); ss.bind(new InetSocketAddress("127.0.0.1",8888)); while (true){ //3. 监听事件 selector.select(); //4. 获取到达的事件 Set<SelectionKey> keys = selector.selectedKeys(); Iterator<SelectionKey> keyIterator = keys.iterator(); while (keyIterator.hasNext()) { SelectionKey key = keyIterator.next(); if (key.isAcceptable()) { ServerSocketChannel ssChannel1 = (ServerSocketChannel) key.channel(); // 服务器会为每个新连接创建一个 SocketChannel SocketChannel sChannel = ssChannel1.accept(); sChannel.configureBlocking(false); // 这个新连接主要用于从客户端读取数据 sChannel.register(selector, SelectionKey.OP_READ); } else if (key.isReadable()) { SocketChannel sChannel = (SocketChannel) key.channel(); System.out.println(readDataFromSocketChannel(sChannel)); sChannel.close(); } keyIterator.remove(); } } } private static String readDataFromSocketChannel(SocketChannel sChannel) throws IOException { ByteBuffer buffer = ByteBuffer.allocate(1024); StringBuilder data = new StringBuilder(); while (true) { buffer.clear(); int r = sChannel.read(buffer); if (r == -1) { break; } buffer.flip(); int limit = buffer.limit(); char[] dst = new char[limit]; for (int i = 0; i < limit; i++) { dst[i] = (char) buffer.get(i); } data.append(dst); buffer.clear(); } return data.toString(); } }public class NIOClient { public static void main(String[] args) throws IOException { Socket socket = new Socket("127.0.0.1", 8888); OutputStream out = socket.getOutputStream(); String s = "hello world"; out.write(s.getBytes()); out.close(); } }内存映射文件内存映射文件 I/O 是一种读和写文件数据的方法,它可以比常规的基于流或者基于通道的 I/O 快得多。 向内存映射文件写入可能是危险的,只是改变数组的单个元素这样的简单操作,就可能会直接修改磁盘上的文件。修改数据与将数据保存到磁盘是没有分开的。 下面代码行将文件的前 1024 个字节映射到内存中,map() 方法返回一个 MappedByteBuffer,它是 ByteBuffer 的子类。因此,可以像使用其他任何 ByteBuffer 一样使用新映射的缓冲区,操作系统会在需要时负责执行映射。 MappedByteBuffer mbb = fc.map(FileChannel.MapMode.READ_WRITE, 0, 1024);NIO与IO对比NIO 与普通 I/O 的区别主要有以下三点: NIO 是非阻塞的;NIO 面向块,I/O 面向流。NIO有选择器,而I/O没有。PathJava7中文件IO发生了很大的变化,专门引入了很多新的类来取代原来的 基于java.io.File的文件IO操作方式。 创建一个Path使用Paths工具类的get()方法创建Path对象 public class PathDemo { public static void main(String[] args) { //方式一 Path path=Paths.get("demo5.txt"); System.out.println(path); //方式二 Path path2 = FileSystems.getDefault().getPath("demo5.txt"); System.out.println(path2); } }File和Path之间的转换,File和URI之间的转换public class PathDemo2 { public static void main(String[] args) { Path path=Paths.get("demo5.txt"); File file=path.toFile(); URI uri=path.toUri(); System.out.println(path); System.out.println(file); System.out.println(uri); } }demo5.txtdemo5.txtfile:///F:/Java_Review/05Java/JavaIO/demo5.txt获取Path的相关信息public class PathDemo3 { public static void main(String[] args) { Path path= Paths.get("demo3\\test3.txt"); System.out.println("文件名:"+ path.getFileName()); System.out.println("名称元素的数量:"+path.getNameCount()); System.out.println("父路径:"+ path.getParent()); System.out.println("根路径:"+ path.getRoot()); System.out.println("是否是绝对路径:"+path.isAbsolute()); //startWith() 参数既可以是字符串,也可以是Path System.out.println("是否是以路径demo3开头:"+path.startsWith(Paths.get("demo3"))); System.out.println("该路径的字符串形式:"+path.toString()); } }文件名:test3.txt名称元素的数量:2父路径:demo3根路径:null是否是绝对路径:false是否是以路径demo3开头:true该路径的字符串形式:demo3test3.txt移除Path中的冗余项 .表示的是当前目录 ..表示父目录或者说是上一级目录 normalize() : 返回一个路径,该路径是取出冗余项的路径。 toRealPath() : 可以看成,先进行toAbsolutePath()操作,然后进行normalize()操作 public class PathDemo4 { public static void main(String[] args) throws IOException { Path path= Paths.get("./demo3"); System.out.println("original :"+ path.toAbsolutePath()); System.out.println("after normalize:"+ path.toAbsolutePath().normalize()); System.out.println("after toRealPath:"+ path.toRealPath()); } }original :F:Java_Review05JavaJavaIO.demo3after normalize:F:Java_Review05JavaJavaIOdemo3after toRealPath:F:Java_Review05JavaJavaIOdemo3public class PathDemo5 { public static void main(String[] args) throws IOException { Path path= Paths.get("../JavaIO"); System.out.println("original :"+ path.toAbsolutePath()); System.out.println("after normalize:"+ path.toAbsolutePath().normalize()); System.out.println("after toRealPath:"+ path.toRealPath()); } }original :F:Java_Review05JavaJavaIO..JavaIOafter normalize:F:Java_Review05JavaJavaIOafter toRealPath:F:Java_Review05JavaJavaIOFilesjava.nio.file.Files类是和java.nio.file.Path相结合使用的 检查给定的Path在文件系统中是否存在Files.exists():检测文件路径是否存在 public class FilesDemo { public static void main(String[] args) { Path path = Paths.get("demo5.txt"); //LinkOptions.NOFOLLOW_LINKS:表示检测时不包含符号链接文件。 boolean isExist= Files.exists(path,new LinkOption[]{LinkOption.NOFOLLOW_LINKS}); System.out.println(isExist); } }创建文件/文件夹Files.createFile():创建文件 Files.createDirectory(): 创建文件夹 Files.createDirectories(): 创建文件夹 public class FilesDemo2 { public static void main(String[] args) throws IOException { Path path= Paths.get("demo7.txt"); if(!Files.exists(path)){ Files.createFile(path); } Path path2=Paths.get("demo4"); if(!Files.exists(path2)){ Files.createDirectory(path2); } Path path3=Paths.get("demo5\\test"); if(!Files.exists(path3)){ Files.createDirectories(path3); } } }删除文件或目录Files.delete():删除一个文件或目录 public class FilesDemo3 { public static void main(String[] args) throws IOException { Path path= Paths.get("demo7.txt"); Files.delete(path); } }把一个文件从一个地址复制到另一个位置Files.copy():把一个文件从一个地址复制到另一个位置 public class FilesDemo4 { public static void main(String[] args) throws IOException { Path srcPath= Paths.get("demo6.txt"); Path destPath=Paths.get("demo7.txt"); //Files.copy(srcPath,destPath); //强制覆盖已经存在的目标文件 Files.copy(srcPath,destPath, StandardCopyOption.REPLACE_EXISTING); } }获取文件属性public class FilesDemo5 { public static void main(String[] args) throws IOException { Path path= Paths.get("demo7.txt"); System.out.println(Files.getLastModifiedTime(path)); System.out.println(Files.size(path)); System.out.println(Files.isSymbolicLink(path)); System.out.println(Files.isDirectory(path)); System.out.println(Files.readAttributes(path,"*")); } }遍历一个文件夹public class FilesDemo6 { public static void main(String[] args) throws IOException { Path path= Paths.get("demo3\\demo2"); DirectoryStream<Path> paths=Files.newDirectoryStream(path); for(Path p:paths){ System.out.println(p.getFileName()); } } }遍历整个文件目录FileVisitor需要调用方自行实现,然后作为参数传入walkFileTree(); FileVisitor的每个方法会在遍历过程中被调用多次。 public class FilesDemo7 { public static void main(String[] args) throws IOException { Path path= Paths.get("demo3\\demo2"); List<Path> paths=new ArrayList<>(); Files.walkFileTree(path,new FileVisitor(paths)); System.out.println("paths:"+paths); } private static class FileVisitor extends SimpleFileVisitor<Path> { private List<Path> paths; public FileVisitor(List<Path> paths){ this.paths=paths; } @Override public FileVisitResult visitFile(Path file, BasicFileAttributes attrs) throws IOException { if(file.toString().endsWith(".txt")){ paths.add(file.getFileName()); } return super.visitFile(file, attrs); } } }输出结果: paths:[a.txt, test2.txt, test.txt, test3.txt]

优秀的个人博客,低调大师

BATJ都爱问的多线程面试题

下面最近发的一些并发编程的文章汇总,通过阅读这些文章大家再看大厂面试中的并发编程问题就没有那么头疼了。今天给大家总结一下,面试中出镜率很高的几个多线程面试题,希望对大家学习和面试都能有所帮助。备注:文中的代码自己实现一遍的话效果会更佳哦! 并发编程面试必备:synchronized 关键字使用、底层原理、JDK1.6 之后的底层优化以及 和ReenTrantLock 的对比 并发编程面试必备:JUC 中的 Atomic 原子类总结 并发编程面试必备:AQS 原理以及 AQS 同步组件总结 该文已加入开源文档:JavaGuide(一份涵盖大部分Java程序员所需要掌握的核心知识)。地址:https://github.com/Snailclimb/JavaGuide. 【强烈推荐!非广告!】阿里云双11褥羊毛活动:https://m.aliyun.com/act/team1111/#/share?params=N.FF7yxCciiM.hf47liqn 差不多一折,不过仅限阿里云新人购买,不是新人的朋友自己找方法买哦! 一 面试中关于 synchronized 关键字的 5 连击 1.1 说一说自己对于 synchronized 关键字的了解 synchronized关键字解决的是多个线程之间访问资源的同步性,synchronized关键字可以保证被它修饰的方法或者代码块在任意时刻只能有一个线程执行。 另外,在 Java 早期版本中,synchronized属于重量级锁,效率低下,因为监视器锁(monitor)是依赖于底层的操作系统的 Mutex Lock 来实现的,Java 的线程是映射到操作系统的原生线程之上的。如果要挂起或者唤醒一个线程,都需要操作系统帮忙完成,而操作系统实现线程之间的切换时需要从用户态转换到内核态,这个状态之间的转换需要相对比较长的时间,时间成本相对较高,这也是为什么早期的 synchronized 效率低的原因。庆幸的是在 Java 6 之后 Java 官方对从 JVM 层面对synchronized 较大优化,所以现在的 synchronized 锁效率也优化得很不错了。JDK1.6对锁的实现引入了大量的优化,如自旋锁、适应性自旋锁、锁消除、锁粗化、偏向锁、轻量级锁等技术来减少锁操作的开销。 1.2 说说自己是怎么使用 synchronized 关键字,在项目中用到了吗 synchronized关键字最主要的三种使用方式: 修饰实例方法,作用于当前对象实例加锁,进入同步代码前要获得当前对象实例的锁 修饰静态方法,作用于当前类对象加锁,进入同步代码前要获得当前类对象的锁 。也就是给当前类加锁,会作用于类的所有对象实例,因为静态成员不属于任何一个实例对象,是类成员( static 表明这是该类的一个静态资源,不管new了多少个对象,只有一份,所以对该类的所有对象都加了锁)。所以如果一个线程A调用一个实例对象的非静态 synchronized 方法,而线程B需要调用这个实例对象所属类的静态 synchronized 方法,是允许的,不会发生互斥现象,因为访问静态 synchronized 方法占用的锁是当前类的锁,而访问非静态 synchronized 方法占用的锁是当前实例对象锁。 修饰代码块,指定加锁对象,对给定对象加锁,进入同步代码库前要获得给定对象的锁。 和 synchronized 方法一样,synchronized(this)代码块也是锁定当前对象的。synchronized 关键字加到 static 静态方法和 synchronized(class)代码块上都是是给 Class 类上锁。这里再提一下:synchronized关键字加到非 static 静态方法上是给对象实例上锁。另外需要注意的是:尽量不要使用 synchronized(String a) 因为JVM中,字符串常量池具有缓冲功能! 下面我已一个常见的面试题为例讲解一下 synchronized 关键字的具体使用。 面试中面试官经常会说:“单例模式了解吗?来给我手写一下!给我解释一下双重检验锁方式实现单利模式的原理呗!” 双重校验锁实现对象单例(线程安全) public class Singleton { private volatile static Singleton uniqueInstance; private Singleton() { } public static Singleton getUniqueInstance() { //先判断对象是否已经实例过,没有实例化过才进入加锁代码 if (uniqueInstance == null) { //类对象加锁 synchronized (Singleton.class) { if (uniqueInstance == null) { uniqueInstance = new Singleton(); } } } return uniqueInstance; } } 另外,需要注意 uniqueInstance 采用 volatile 关键字修饰也是很有必要。 uniqueInstance 采用 volatile 关键字修饰也是很有必要的, uniqueInstance = new Singleton(); 这段代码其实是分为三步执行: 为 uniqueInstance 分配内存空间 初始化 uniqueInstance 将 uniqueInstance 指向分配的内存地址 但是由于 JVM 具有指令重排的特性,执行顺序有可能变成 1->3->2。指令重排在单线程环境下不会出先问题,但是在多线程环境下会导致一个线程获得还没有初始化的实例。例如,线程 T1 执行了 1 和 3,此时 T2 调用 getUniqueInstance() 后发现 uniqueInstance 不为空,因此返回 uniqueInstance,但此时 uniqueInstance 还未被初始化。 使用 volatile 可以禁止 JVM 的指令重排,保证在多线程环境下也能正常运行。 1.3 讲一下 synchronized 关键字的底层原理 synchronized 关键字底层原理属于 JVM 层面。 ① synchronized 同步语句块的情况 public class SynchronizedDemo { public void method() { synchronized (this) { System.out.println("synchronized 代码块"); } } } 通过 JDK 自带的 javap 命令查看 SynchronizedDemo 类的相关字节码信息:首先切换到类的对应目录执行 javac SynchronizedDemo.java 命令生成编译后的 .class 文件,然后执行javap -c -s -v -l SynchronizedDemo.class。 从上面我们可以看出: synchronized 同步语句块的实现使用的是 monitorenter 和 monitorexit 指令,其中 monitorenter 指令指向同步代码块的开始位置,monitorexit 指令则指明同步代码块的结束位置。 当执行 monitorenter 指令时,线程试图获取锁也就是获取 monitor(monitor对象存在于每个Java对象的对象头中,synchronized 锁便是通过这种方式获取锁的,也是为什么Java中任意对象可以作为锁的原因) 的持有权.当计数器为0则可以成功获取,获取后将锁计数器设为1也就是加1。相应的在执行 monitorexit 指令后,将锁计数器设为0,表明锁被释放。如果获取对象锁失败,那当前线程就要阻塞等待,直到锁被另外一个线程释放为止。 ② synchronized 修饰方法的的情况 public class SynchronizedDemo2 { public synchronized void method() { System.out.println("synchronized 方法"); } } synchronized 修饰的方法并没有 monitorenter 指令和 monitorexit 指令,取得代之的确实是 ACC_SYNCHRONIZED 标识,该标识指明了该方法是一个同步方法,JVM 通过该 ACC_SYNCHRONIZED 访问标志来辨别一个方法是否声明为同步方法,从而执行相应的同步调用。 1.4 说说 JDK1.6 之后的synchronized 关键字底层做了哪些优化,可以详细介绍一下这些优化吗 JDK1.6 对锁的实现引入了大量的优化,如偏向锁、轻量级锁、自旋锁、适应性自旋锁、锁消除、锁粗化等技术来减少锁操作的开销。 锁主要存在四中状态,依次是:无锁状态、偏向锁状态、轻量级锁状态、重量级锁状态,他们会随着竞争的激烈而逐渐升级。注意锁可以升级不可降级,这种策略是为了提高获得锁和释放锁的效率。 关于这几种优化的详细信息可以查看:synchronized 关键字使用、底层原理、JDK1.6 之后的底层优化以及 和ReenTrantLock 的对比 1.5 谈谈 synchronized和ReenTrantLock 的区别 ① 两者都是可重入锁 两者都是可重入锁。“可重入锁”概念是:自己可以再次获取自己的内部锁。比如一个线程获得了某个对象的锁,此时这个对象锁还没有释放,当其再次想要获取这个对象的锁的时候还是可以获取的,如果不可锁重入的话,就会造成死锁。同一个线程每次获取锁,锁的计数器都自增1,所以要等到锁的计数器下降为0时才能释放锁。 ② synchronized 依赖于 JVM 而 ReenTrantLock 依赖于 API synchronized 是依赖于 JVM 实现的,前面我们也讲到了 虚拟机团队在 JDK1.6 为 synchronized 关键字进行了很多优化,但是这些优化都是在虚拟机层面实现的,并没有直接暴露给我们。ReenTrantLock 是 JDK 层面实现的(也就是 API 层面,需要 lock() 和 unlock 方法配合 try/finally 语句块来完成),所以我们可以通过查看它的源代码,来看它是如何实现的。 ③ ReenTrantLock 比 synchronized 增加了一些高级功能 相比synchronized,ReenTrantLock增加了一些高级功能。主要来说主要有三点:①等待可中断;②可实现公平锁;③可实现选择性通知(锁可以绑定多个条件) ReenTrantLock提供了一种能够中断等待锁的线程的机制,通过lock.lockInterruptibly()来实现这个机制。也就是说正在等待的线程可以选择放弃等待,改为处理其他事情。 ReenTrantLock可以指定是公平锁还是非公平锁。而synchronized只能是非公平锁。所谓的公平锁就是先等待的线程先获得锁。 ReenTrantLock默认情况是非公平的,可以通过 ReenTrantLock类的ReentrantLock(boolean fair)构造方法来制定是否是公平的。 synchronized关键字与wait()和notify/notifyAll()方法相结合可以实现等待/通知机制,ReentrantLock类当然也可以实现,但是需要借助于Condition接口与newCondition() 方法。Condition是JDK1.5之后才有的,它具有很好的灵活性,比如可以实现多路通知功能也就是在一个Lock对象中可以创建多个Condition实例(即对象监视器),线程对象可以注册在指定的Condition中,从而可以有选择性的进行线程通知,在调度线程上更加灵活。 在使用notify/notifyAll()方法进行通知时,被通知的线程是由 JVM 选择的,用ReentrantLock类结合Condition实例可以实现“选择性通知” ,这个功能非常重要,而且是Condition接口默认提供的。而synchronized关键字就相当于整个Lock对象中只有一个Condition实例,所有的线程都注册在它一个身上。如果执行notifyAll()方法的话就会通知所有处于等待状态的线程这样会造成很大的效率问题,而Condition实例的signalAll()方法 只会唤醒注册在该Condition实例中的所有等待线程。 如果你想使用上述功能,那么选择ReenTrantLock是一个不错的选择。 ④ 性能已不是选择标准 二 面试中关于线程池的 4 连击 2.1 讲一下Java内存模型 在 JDK1.2 之前,Java的内存模型实现总是从主存(即共享内存)读取变量,是不需要进行特别的注意的。而在当前的 Java 内存模型下,线程可以把变量保存本地内存(比如机器的寄存器)中,而不是直接在主存中进行读写。这就可能造成一个线程在主存中修改了一个变量的值,而另外一个线程还继续使用它在寄存器中的变量值的拷贝,造成数据的不一致。 要解决这个问题,就需要把变量声明为 volatile,这就指示 JVM,这个变量是不稳定的,每次使用它都到主存中进行读取。 说白了, volatile 关键字的主要作用就是保证变量的可见性然后还有一个作用是防止指令重排序。 2.2 说说 synchronized 关键字和 volatile 关键字的区别 synchronized关键字和volatile关键字比较 volatile关键字是线程同步的轻量级实现,所以volatile性能肯定比synchronized关键字要好。但是volatile关键字只能用于变量而synchronized关键字可以修饰方法以及代码块。synchronized关键字在JavaSE1.6之后进行了主要包括为了减少获得锁和释放锁带来的性能消耗而引入的偏向锁和轻量级锁以及其它各种优化之后执行效率有了显著提升,实际开发中使用 synchronized 关键字的场景还是更多一些。 多线程访问volatile关键字不会发生阻塞,而synchronized关键字可能会发生阻塞 volatile关键字能保证数据的可见性,但不能保证数据的原子性。synchronized关键字两者都能保证。 volatile关键字主要用于解决变量在多个线程之间的可见性,而 synchronized关键字解决的是多个线程之间访问资源的同步性。 三 面试中关于 线程池的 2 连击 3.1 为什么要用线程池? 线程池提供了一种限制和管理资源(包括执行一个任务)。 每个线程池还维护一些基本统计信息,例如已完成任务的数量。 这里借用《Java并发编程的艺术》提到的来说一下使用线程池的好处: 降低资源消耗。 通过重复利用已创建的线程降低线程创建和销毁造成的消耗。 提高响应速度。 当任务到达时,任务可以不需要的等到线程创建就能立即执行。 提高线程的可管理性。 线程是稀缺资源,如果无限制的创建,不仅会消耗系统资源,还会降低系统的稳定性,使用线程池可以进行统一的分配,调优和监控。 3.2 实现Runnable接口和Callable接口的区别 如果想让线程池执行任务的话需要实现的Runnable接口或Callable接口。 Runnable接口或Callable接口实现类都可以被ThreadPoolExecutor或ScheduledThreadPoolExecutor执行。两者的区别在于 Runnable 接口不会返回结果但是 Callable 接口可以返回结果。 备注: 工具类Executors可以实现Runnable对象和Callable对象之间的相互转换。(Executors.callable(Runnable task)或Executors.callable(Runnable task,Object resule))。 3.3 执行execute()方法和submit()方法的区别是什么呢? 1)execute() 方法用于提交不需要返回值的任务,所以无法判断任务是否被线程池执行成功与否; 2)submit()方法用于提交需要返回值的任务。线程池会返回一个future类型的对象,通过这个future对象可以判断任务是否执行成功,并且可以通过future的get()方法来获取返回值,get()方法会阻塞当前线程直到任务完成,而使用 get(long timeout,TimeUnit unit)方法则会阻塞当前线程一段时间后立即返回,这时候有可能任务没有执行完。 3.4 如何创建线程池 《阿里巴巴Java开发手册》中强制线程池不允许使用 Executors 去创建,而是通过 ThreadPoolExecutor 的方式,这样的处理方式让写的同学更加明确线程池的运行规则,规避资源耗尽的风险** Executors 返回线程池对象的弊端如下: FixedThreadPool 和 SingleThreadExecutor : 允许请求的队列长度为 Integer.MAX_VALUE,可能堆积大量的请求,从而导致OOM。 CachedThreadPool 和 ScheduledThreadPool : 允许创建的线程数量为 Integer.MAX_VALUE ,可能会创建大量线程,从而导致OOM。 方式一:通过构造方法实现方式二:通过Executor 框架的工具类Executors来实现我们可以创建三种类型的ThreadPoolExecutor: FixedThreadPool : 该方法返回一个固定线程数量的线程池。该线程池中的线程数量始终不变。当有一个新的任务提交时,线程池中若有空闲线程,则立即执行。若没有,则新的任务会被暂存在一个任务队列中,待有线程空闲时,便处理在任务队列中的任务。 SingleThreadExecutor: 方法返回一个只有一个线程的线程池。若多余一个任务被提交到该线程池,任务会被保存在一个任务队列中,待线程空闲,按先入先出的顺序执行队列中的任务。 CachedThreadPool: 该方法返回一个可根据实际情况调整线程数量的线程池。线程池的线程数量不确定,但若有空闲线程可以复用,则会优先使用可复用的线程。若所有线程均在工作,又有新的任务提交,则会创建新的线程处理任务。所有线程在当前任务执行完毕后,将返回线程池进行复用。 对应Executors工具类中的方法如图所示: 四 面试中关于 Atomic 原子类的 4 连击 4.1 介绍一下Atomic 原子类 Atomic 翻译成中文是原子的意思。在化学上,我们知道原子是构成一般物质的最小单位,在化学反应中是不可分割的。在我们这里 Atomic 是指一个操作是不可中断的。即使是在多个线程一起执行的时候,一个操作一旦开始,就不会被其他线程干扰。 所以,所谓原子类说简单点就是具有原子/原子操作特征的类。 并发包 java.util.concurrent 的原子类都存放在java.util.concurrent.atomic下,如下图所示。 4.2 JUC 包中的原子类是哪4类? 基本类型 使用原子的方式更新基本类型 AtomicInteger:整形原子类 AtomicLong:长整型原子类 AtomicBoolean :布尔型原子类 数组类型 使用原子的方式更新数组里的某个元素 AtomicIntegerArray:整形数组原子类 AtomicLongArray:长整形数组原子类 AtomicReferenceArray :引用类型数组原子类 引用类型 AtomicReference:引用类型原子类 AtomicStampedRerence:原子更新引用类型里的字段原子类 AtomicMarkableReference :原子更新带有标记位的引用类型 对象的属性修改类型 AtomicIntegerFieldUpdater:原子更新整形字段的更新器 AtomicLongFieldUpdater:原子更新长整形字段的更新器 AtomicStampedReference :原子更新带有版本号的引用类型。该类将整数值与引用关联起来,可用于解决原子的更新数据和数据的版本号,可以解决使用 CAS 进行原子更新时可能出现的 ABA 问题。 4.3 讲讲 AtomicInteger 的使用 AtomicInteger 类常用方法 public final int get() //获取当前的值 public final int getAndSet(int newValue)//获取当前的值,并设置新的值 public final int getAndIncrement()//获取当前的值,并自增 public final int getAndDecrement() //获取当前的值,并自减 public final int getAndAdd(int delta) //获取当前的值,并加上预期的值 boolean compareAndSet(int expect, int update) //如果输入的数值等于预期值,则以原子方式将该值设置为输入值(update) public final void lazySet(int newValue)//最终设置为newValue,使用 lazySet 设置之后可能导致其他线程在之后的一小段时间内还是可以读到旧的值。 AtomicInteger 类的使用示例 使用 AtomicInteger 之后,不用对 increment() 方法加锁也可以保证线程安全。 class AtomicIntegerTest { private AtomicInteger count = new AtomicInteger(); //使用AtomicInteger之后,不需要对该方法加锁,也可以实现线程安全。 public void increment() { count.incrementAndGet(); } public int getCount() { return count.get(); } } 4.4 能不能给我简单介绍一下 AtomicInteger 类的原理 AtomicInteger 线程安全原理简单分析 AtomicInteger 类的部分源码: // setup to use Unsafe.compareAndSwapInt for updates(更新操作时提供“比较并替换”的作用) private static final Unsafe unsafe = Unsafe.getUnsafe(); private static final long valueOffset; static { try { valueOffset = unsafe.objectFieldOffset (AtomicInteger.class.getDeclaredField("value")); } catch (Exception ex) { throw new Error(ex); } } private volatile int value; AtomicInteger 类主要利用 CAS (compare and swap) + volatile 和 native 方法来保证原子操作,从而避免 synchronized 的高开销,执行效率大为提升。 CAS的原理是拿期望的值和原本的一个值作比较,如果相同则更新成新的值。UnSafe 类的 objectFieldOffset() 方法是一个本地方法,这个方法是用来拿到“原来的值”的内存地址,返回值是 valueOffset。另外 value 是一个volatile变量,在内存中可见,因此 JVM 可以保证任何时刻任何线程总能拿到该变量的最新值。 关于 Atomic 原子类这部分更多内容可以查看我的这篇文章:并发编程面试必备:JUC 中的 Atomic 原子类总结 五 AQS 5.1 AQS 介绍 AQS的全称为(AbstractQueuedSynchronizer),这个类在java.util.concurrent.locks包下面。 AQS是一个用来构建锁和同步器的框架,使用AQS能简单且高效地构造出应用广泛的大量的同步器,比如我们提到的ReentrantLock,Semaphore,其他的诸如ReentrantReadWriteLock,SynchronousQueue,FutureTask等等皆是基于AQS的。当然,我们自己也能利用AQS非常轻松容易地构造出符合我们自己需求的同步器。 5.2 AQS 原理分析 AQS 原理这部分参考了部分博客,在5.2节末尾放了链接。 在面试中被问到并发知识的时候,大多都会被问到“请你说一下自己对于AQS原理的理解”。下面给大家一个示例供大家参加,面试不是背题,大家一定要假如自己的思想,即使加入不了自己的思想也要保证自己能够通俗的讲出来而不是背出来。 下面大部分内容其实在AQS类注释上已经给出了,不过是英语看着比较吃力一点,感兴趣的话可以看看源码。 5.2.1 AQS 原理概览 AQS核心思想是,如果被请求的共享资源空闲,则将当前请求资源的线程设置为有效的工作线程,并且将共享资源设置为锁定状态。如果被请求的共享资源被占用,那么就需要一套线程阻塞等待以及被唤醒时锁分配的机制,这个机制AQS是用CLH队列锁实现的,即将暂时获取不到锁的线程加入到队列中。 CLH(Craig,Landin,and Hagersten)队列是一个虚拟的双向队列(虚拟的双向队列即不存在队列实例,仅存在结点之间的关联关系)。AQS是将每条请求共享资源的线程封装成一个CLH锁队列的一个结点(Node)来实现锁的分配。 看个AQS(AbstractQueuedSynchronizer)原理图: AQS使用一个int成员变量来表示同步状态,通过内置的FIFO队列来完成获取资源线程的排队工作。AQS使用CAS对该同步状态进行原子操作实现对其值的修改。 private volatile int state;//共享变量,使用volatile修饰保证线程可见性 状态信息通过procted类型的getState,setState,compareAndSetState进行操作 //返回同步状态的当前值 protected final int getState() { return state; } // 设置同步状态的值 protected final void setState(int newState) { state = newState; } //原子地(CAS操作)将同步状态值设置为给定值update如果当前同步状态的值等于expect(期望值) protected final boolean compareAndSetState(int expect, int update) { return unsafe.compareAndSwapInt(this, stateOffset, expect, update); } 5.2.2 AQS 对资源的共享方式 AQS定义两种资源共享方式 Exclusive(独占):只有一个线程能执行,如ReentrantLock。又可分为公平锁和非公平锁: 公平锁:按照线程在队列中的排队顺序,先到者先拿到锁 非公平锁:当线程要获取锁时,无视队列顺序直接去抢锁,谁抢到就是谁的 Share(共享):多个线程可同时执行,如Semaphore/CountDownLatch。Semaphore、CountDownLatCh、 CyclicBarrier、ReadWriteLock 我们都会在后面讲到。 ReentrantReadWriteLock 可以看成是组合式,因为ReentrantReadWriteLock也就是读写锁允许多个线程同时对某一资源进行读。 不同的自定义同步器争用共享资源的方式也不同。自定义同步器在实现时只需要实现共享资源 state 的获取与释放方式即可,至于具体线程等待队列的维护(如获取资源失败入队/唤醒出队等),AQS已经在顶层实现好了。 5.2.3 AQS底层使用了模板方法模式 同步器的设计是基于模板方法模式的,如果需要自定义同步器一般的方式是这样(模板方法模式很经典的一个应用): 使用者继承AbstractQueuedSynchronizer并重写指定的方法。(这些重写方法很简单,无非是对于共享资源state的获取和释放) 将AQS组合在自定义同步组件的实现中,并调用其模板方法,而这些模板方法会调用使用者重写的方法。 这和我们以往通过实现接口的方式有很大区别,这是模板方法模式很经典的一个运用。 AQS使用了模板方法模式,自定义同步器时需要重写下面几个AQS提供的模板方法: isHeldExclusively()//该线程是否正在独占资源。只有用到condition才需要去实现它。 tryAcquire(int)//独占方式。尝试获取资源,成功则返回true,失败则返回false。 tryRelease(int)//独占方式。尝试释放资源,成功则返回true,失败则返回false。 tryAcquireShared(int)//共享方式。尝试获取资源。负数表示失败;0表示成功,但没有剩余可用资源;正数表示成功,且有剩余资源。 tryReleaseShared(int)//共享方式。尝试释放资源,成功则返回true,失败则返回false。 默认情况下,每个方法都抛出 UnsupportedOperationException。 这些方法的实现必须是内部线程安全的,并且通常应该简短而不是阻塞。AQS类中的其他方法都是final ,所以无法被其他类使用,只有这几个方法可以被其他类使用。 以ReentrantLock为例,state初始化为0,表示未锁定状态。A线程lock()时,会调用tryAcquire()独占该锁并将state+1。此后,其他线程再tryAcquire()时就会失败,直到A线程unlock()到state=0(即释放锁)为止,其它线程才有机会获取该锁。当然,释放锁之前,A线程自己是可以重复获取此锁的(state会累加),这就是可重入的概念。但要注意,获取多少次就要释放多么次,这样才能保证state是能回到零态的。 再以CountDownLatch以例,任务分为N个子线程去执行,state也初始化为N(注意N要与线程个数一致)。这N个子线程是并行执行的,每个子线程执行完后countDown()一次,state会CAS(Compare and Swap)减1。等到所有子线程都执行完后(即state=0),会unpark()主调用线程,然后主调用线程就会从await()函数返回,继续后余动作。 一般来说,自定义同步器要么是独占方法,要么是共享方式,他们也只需实现tryAcquire-tryRelease、tryAcquireShared-tryReleaseShared中的一种即可。但AQS也支持自定义同步器同时实现独占和共享两种方式,如ReentrantReadWriteLock。 推荐两篇 AQS 原理和相关源码分析的文章: http://www.cnblogs.com/waterystone/p/4920797.html https://www.cnblogs.com/chengxiao/archive/2017/07/24/7141160.html 5.3 AQS 组件总结 Semaphore(信号量)-允许多个线程同时访问: synchronized 和 ReentrantLock 都是一次只允许一个线程访问某个资源,Semaphore(信号量)可以指定多个线程同时访问某个资源。 CountDownLatch (倒计时器): CountDownLatch是一个同步工具类,用来协调多个线程之间的同步。这个工具通常用来控制线程等待,它可以让某一个线程等待直到倒计时结束,再开始执行。 CyclicBarrier(循环栅栏): CyclicBarrier 和 CountDownLatch 非常类似,它也可以实现线程间的技术等待,但是它的功能比 CountDownLatch 更加复杂和强大。主要应用场景和 CountDownLatch 类似。CyclicBarrier 的字面意思是可循环使用(Cyclic)的屏障(Barrier)。它要做的事情是,让一组线程到达一个屏障(也可以叫同步点)时被阻塞,直到最后一个线程到达屏障时,屏障才会开门,所有被屏障拦截的线程才会继续干活。CyclicBarrier默认的构造方法是 CyclicBarrier(int parties),其参数表示屏障拦截的线程数量,每个线程调用await方法告诉 CyclicBarrier 我已经到达了屏障,然后当前线程被阻塞。 关于AQS这部分的更多内容可以查看我的这篇文章:并发编程面试必备:AQS 原理以及 AQS 同步组件总结 Reference 《深入理解 Java 虚拟机》 《实战 Java 高并发程序设计》 《Java并发编程的艺术》 http://www.cnblogs.com/waterystone/p/4920797.html https://www.cnblogs.com/chengxiao/archive/2017/07/24/7141160.html 【强烈推荐!非广告!】阿里云双11褥羊毛活动(10.29-11.12):https://m.aliyun.com/act/team1111/#/share?params=N.FF7yxCciiM.hf47liqn 。一句话解析该次活动:新用户低至一折购买(1核2g服务器仅8.3/月,比学生机还便宜,真的强烈推荐屯3年)。老用户可以加入我的战队,然后分享自己的链接,可以获得红包和25%的返现,我们的战队目前300位新人,所以可以排进前100,后面可以瓜分百万现金(按拉新人数瓜分现金,拉的越多分的越多!不要自己重新开战队,后面不能参与瓜分现金)。 你若盛开,清风自来。 欢迎关注我的微信公众号:“Java面试通关手册”,一个有温度的微信公众号。公众号后台回复关键字“1”,可以免费获取一份我精心准备的小礼物哦!

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册