首页 文章 精选 留言 我的

精选列表

搜索[文档识别],共10000篇文章
优秀的个人博客,低调大师

Android 3.0 r1 API中文文档(107) —— AsyncPlayer

正文 一、结构 public classAsyncPlayer extendsObject java.lang.Object android.media.AsyncPlayer 二、概述 播放一个连续 ( 多个 ) 的音频 URLs ,但那些任务较重的工作在另外的线程中完成,所以任何预处理或加载的延迟都不阻碍线程调用。 三、构造函数 publicAsyncPlayer(String tag) 构造一个AsyncPlayer对象。 参数 tag用于调试的字符串 四、公共方法 public voidplay(Context context, Uri uri, boolean looping, int stream) 开始播放声音。可在某个点上开始播放。这里不保证可能有延迟。在另一个音频文件播放时调用这个方法将导致当前音频停止播放并开始播放新的音频。 参数 context 应用程序上下文 uri 播放的URI (参见setDataSource(Context, Uri)) looping是否无限循环播放声音。(参见setLooping(boolean)) stream音频流(AudioStream)类型(参见setAudioStreamType(int))(译者注:例如AudioManager.STREAM_MUSIC) public voidstop() 停止之前播放的声音。不能在某点上暂停然后接着播放。多次调用没有不良影响。 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582378,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android 3.0 r1 API中文文档(113) ——SlidingDrawer

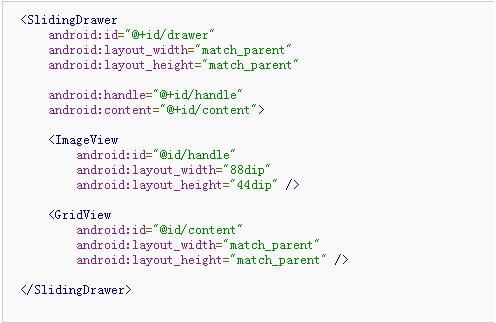
正文 一、结构 public classSlidingDrawer extendsViewGroup java.lang.Object android.view.View android.view.ViewGroup android.widget.SlidingDrawer 二、概述 SlidingDrawer (滑动式抽屉)隐藏屏外的内容,并允许用户拖拽一个 handle 以显示隐藏的内容。 SlidingDrawer 可以在垂直或者水平使用。它由两个子视图组成:一个是用户拖拽的 handle (柄),另一个是随着拖动变化的 content (内容)。 SlidingDrawer 应当作为内部布局的覆盖来使用,也就是说 SlidingDrawer 内部应该使用 FrameLayout 或 RelativeLayout 布局。 SlidingDrawer 的大小决定了其内容显示时所占空间的大小,所以它的尺寸一般定义为 match_parent 。在 XML 布局中 SlidingDrawer 必须指定 handle 和 content 的 id : 三、内部类 interface SlidingDrawer.OnDrawerCloseListener 当drawer(抽屉)关闭时调用 interface SlidingDrawer.OnDrawerOpenListener 当drawer(抽屉)打开时调用 interface SlidingDrawer.OnDrawerScrollListener 当drawer(抽屉)滑动(滚动)时调用 四、XML属性 属性名称 描述 android:allowSingleTap 指示是否可通过单击handle打开或关闭(如果是false,刚用户必须通过拖动,滑动或者使用轨迹球,来打开/关闭抽屉。)默认的是true。 android:animateOnClick 指示当用户点击handle的时候,抽屉是否以动画的形式打开或关闭。默认的是true。 android:bottomOffset Handle距离SlidingDrawer底部的额外距离 android:content 标识SlidingDrawer的内容 android:handle 标识SlidingDrawer的handle(译者注:如按钮) android:orientation SlidingDrawer的方向。必须是下面的一个值: 常量 值 描述 horizontal 0 水平方向对齐 vertical 1 竖直方向对齐 android:topOffset Handle距离SlidingDrawer顶部的额外距离 五、常量 public static final intORIENTATION_HORIZONTAL (译者注:水平方向对齐) 常量值:0 (0x00000000) public static final intORIENTATION_VERTICAL (译者注:垂直方向对齐) 常量值:1 (0x00000001) 六、构造函数 publicSlidingDrawer(Context context, AttributeSet attrs) 用xml中设置的属性来创建一个新的SlidingDrawe 参数 context上下文 attrs XML中定义的属性 public SlidingDrawer (Context context, AttributeSet attrs, int defStyle) 用xml中设置的属性来创建一个新的SlidingDrawe 参数 context上下文 attrs XML中定义的属性 defStyle要应用到这个组件上的样式 七、公共方法 public voidanimateClose() 动画效果关闭抽屉。 参见 close() open() animateOpen() animateToggle() toggle() public voidanimateOpen() 动画效果打开抽屉。 参见 close() open() animateOpen() animateToggle() toggle() public voidanimateToggle() 在打开和关闭抽屉之间动画切换 参见 close() open() animateOpen() animateToggle() toggle() public voidclose() 立即关闭抽屉 参见 open() toggle() animateClose() public ViewgetContent() 返回抽屉的内容(content) 返回值 返回在抽屉内容的视图,它在XML中是用“content”id标识的 public ViewgetHandle() 返回抽屉的handle 返回值 返回在抽屉handle的视图,它在XML中是用“handle”id标识的 public booleanisMoving() 抽屉是否在滚动或滑动。 返回值 如果在滚动或滑动,返回true,否则返回false public booleanisOpened() 当前抽屉是否被完全打开 返回值 如果是打开的,返回true,否则返回false。 public voidlock() 锁定SlidingDrawer,忽略触摸事件 参见 unlock() public booleanonInterceptTouchEvent(MotionEvent event) 实现这个方法可以拦截所有的触屏事件,它在事件被传到子类之前拦截,并获得当前手势的所有权。 使用这个方法时要注意,因为它与View.onTouchEvent(MotionEvent)有一个相当复杂的交互,使用它需要用正确的方法来实现。事件会按照下列顺序接受: 1.down事件会被首先传到本方法中。 2.这个down事件会被当前viewgroup的onTouchEvent()方法或者其各个子视图处理,也就是说你应该实现onTouchEvent()方法并返回true,你会继续看到剩下事件的传递(而不是找一个parent view处理它)。同样的,从onTouchEvent()中返回true,你不会在onInterceptTouchEvent()中接受到任何接下来的事件,并且所有的事件都会被onTouchEvent()处理。 3.如果当前方法返回false,所有接下来的事件(截止到最后包含注册的事件)首先都会被继续传到这里,然后一起传递给目标的onTouchEvent()方法。截至及包括最后注册。 4.如果在这里返回true,将不会收到以下任何事件:目标view将收到同样的事件但是是伴随ACTION_CANCEL事件,并且所有的更进一步的事件将会传递到你自己的onTouchEvent()方法中而不会再在这里出现。 (译者著:这里实在是太麻烦了,很不好懂,我自己看着都头晕,在网上找到一篇很不错的总结,才知道是怎么回事,这里总结一下,记住这个原则你就会很清楚了: 1、onInterceptTouchEvent()是用于处理事件(类似于预处理,当然也可以不处理)并改变事件的传递方向,也就是决定是否允许Touch事件继续向下(子控件)传递,一但返回True(代表事件在当前的viewGroup中会被处理),则向下传递之路被截断(所有子控件将没有机会参与Touch事件),同时把事件传递给当前的控件的onTouchEvent()处理;如果返回false,则把事件交给子控件的onInterceptTouchEvent()处理 2、onTouchEvent()用于处理事件,返回值决定当前控件是否消费(consume)了这个事件,也就是说在当前控件在处理完Touch事件后,是否还允许Touch事件继续向上(父控件)传递,一但返回True,则父控件不用操心自己来处理Touch事件。 相关文章这里1、这里2) 参数 event分层次的动作事件 返回值 如果将运动事件从子视图中截获并且通过onTouchEvent()发送到当前ViewGroup,返回true。当前目标将会收到ACTION_CANCEL事件,并且不再会有其他消息传递到此。 public booleanonTouchEvent(MotionEvent event) 实现触摸屏幕事件的方法 参数 event当前事件 返回值 如果事件被处理就返回true,否则返回false public voidopen() 立即打开抽屉 参见 toggle() close() animateOpen() public voidsetOnDrawerCloseListener(SlidingDrawer.OnDrawerCloseListener onDrawerCloseListener) 给抽屉的关闭事件绑定监听器 参数 onDrawerCloseListener抽屉关闭时的监听器 public voidsetOnDrawerOpenListener(SlidingDrawer.OnDrawerOpenListener onDrawerOpenListener) 给抽屉的打开事件绑定监听器 参数 onDrawerOpenListener抽屉打开时的鉴别器 public voidsetOnDrawerScrollListener(SlidingDrawer.OnDrawerScrollListener onDrawerScrollListener) 给抽屉的滚动(收缩)事件绑定监听器,轻滑(fling)也被当作一个滚动(收缩)事件,同时它可以触发抽屉关闭或者打开事件。 参数 onDrawerScrollListener当滚动(收缩)开始或者停止时通知的监听器 public voidtoggle() 在抽屉打开或关闭状态之间切换。事件会立即产生。 参见 close() open() animateOpen() animateToggle() toggle() public voidunlock() 解锁SlidingDrawer使触摸事件能被处理 参见 lock() 八、补充 文章精选 Android高手进阶教程(二)之----Android Launcher抽屉类SlidingDrawer的使用 SlidingDrawer抽屉类{Android学习指南} MotionEvent事件在onInterceptTouchEvent()、onTouchEvent()中的传递顺序 http://hi.baidu.com/j_fo/blog/item/7321c91324203437dc54017d.html http://www.cnblogs.com/rocky_yi/archive/2011/01/21/1941522.html# 示例代码 < SlidingDrawer android:id ="@+id/drawer" android:layout_width ="match_parent" android:layout_height ="match_parent" android:handle ="@+id/handle" android:content ="@+id/content" > < ImageView android:id ="@id/handle" android:layout_width ="88dip" android:layout_height ="44dip" /> < GridView android:id ="@id/content" android:layout_width ="match_parent" android:layout_height ="match_parent" /> </ SlidingDrawer > SlidingDrawer.OnDrawerCloseListener 译者署名:xiaoQLu 译者链接:http://www.cnblogs.com/xiaoQLu 版本:Android 3.0 r1 结构 继承关系 public static interfaceSlidingDrawer.OnDrawerCloseListener android.widget.SlidingDrawer.OnDrawerCloseListener 类概述 当抽屉被关闭时调用的回调。 公共方法 public abstract voidonDrawerClosed() 当抽屉被完全关闭时调用 补充 文章精选 Android控件之SlidingDrawer(滑动式抽屉)详解与实例 SlidingDrawer.OnDrawerOpenListener 译者署名:xiaoQLu 译者链接:http://www.cnblogs.com/xiaoQLu 版本:Android 3.0 r1 结构 继承关系 public static interfaceSlidingDrawer.OnDrawerOpenListener android.widget.SlidingDrawer.OnDrawerOpenListener 类概述 当抽屉被打开时调用 公共方法 public abstract voidonDrawerOpened() 当抽屉被完全打开时调用 SlidingDrawer.OnDrawerScrollListener 译者署名:xiaoQLu 译者链接:http://www.cnblogs.com/xiaoQLu 版本:Android 3.0 r1 结构 继承关系 public static interfaceSlidingDrawer.OnDrawerScrollListener android.widget.SlidingDrawer.OnDrawerScrollListener 类概述 当抽屉被滚动时调用 公共方法 public abstract voidonScrollEnded() 当用户停止拖曳/滑动抽屉的handle时调用 public abstract voidonScrollStarted() 当用户开始拖曳/滑动抽屉的handle时调用 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582369,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android 3.0 r1 API中文文档(106) —— SimpleCursorAdapter

正文 一、结构 public classSimpleCusrorAdapter extendsResourceCusorAdpater java.lang.Object android.widget.BaseAdapter android.widget.CursorAdapter android.widget.ResourceCusorAdapter android.widget.SimpleCusorAdapter 二、概述 这是一个用起来很方便的适配器类,它主要将Cursor与TexiView或ImageView进行映射。比如,你想设定要展示三列,那么当做好绑定之后,视图就会展示你设定好的那些列;当然了,视图的外观是定义在XML文件里面的,你只需用这个类与视图做好绑定就可以了。与视图绑定有两个阶段。第一阶段:如果SimpleCursorAdapter.ViewBinder可用,将会调用setViewValue(android.view.View, android.database.Cursor, int)方法。该方法返回true就说明绑定成功,否则返回false,这就到了第二阶段,SimpleCursorAdapter内部开始自行绑定,过程是这样的,若绑定到TextView上,调用setViewText();若绑定到ImageView上,调用setViewImage();如果视图不是TextView或ImageView则抛出IllegalStateException异常。当使用带有过滤器的适配器时,例如,在APIDemo中有个AutoCompleteTextView的例子,我们能使用SimpleCursorAdapter.CursorToStringConverter和接口FilterQueryProvider来控制过滤过程。更多信息请参考convertToString(android.database.Cursor)和runQueryOnBackgroundThread(CharSequence)。 三、内部类 public interfaceSimpleCusorAdapter.ViewBinder 这个内部接口可以在外部通过SimpleCursorAdapter.ViewBinder的方式进行Cursor与View的绑定。 public interfaceSimpleCusorAdapter.CursorToStringConverter 这个内部接口可以在外部通过 SimpleCursorAdapter.CursorToStringConverter 的方式 定义怎样将 Cursor 转换成字符串。 四、构造函数 publicSimpleCursorAdapter(Context context, int layout, Cursor c, String[] from, int[] to) 构造函数启动自动重新查询(auto-requery)。 这个构造器已被标记为弃用(@Deprecated)。 该方法不推荐使用,Cursor查询操作是执行在应用程序的UI线程当中,那么会导致无响应的情况。另一种方式是使用LoaderManager和CursorLoader来进行。 (译者注:3.0已不推荐使用该构造方法) 参数 context应用程序上下文,具体来说就是ListView所在的上下文当中。 layout布局文件的资源定位标识符,也就是说标识了ListView中的item。那么这个布局文件至少包含了参数“to”中的传进来值。 c 数据库游标,如果游标不可用则为null。 from列名字列表,表示着你要绑定到UI上的列。如果游标不可用则为null。 to展示参数“from”中的列,也就是说ListView中的视图显示的是参数“from”的列值,这些视图应该都是TextView。如果游标不可用则为null。 publicSimpleCursorAdapter(Context context, int layout, Cursor c, String[] from, int[]to,int flags) 该适配器类标准的构造函数。(译者注:3.0新添的构造方法) 参数 context应用程序上下文,具体来说就是ListView所在的上下文当中。 layout布局文件的资源定位标识符,也就是说标识了ListView中的item。那么这个布局文件至少包含了参数“to”中的传进来值。 c数据库游标,如果游标不可用则为null。 from列名字列表,表示着你要绑定到UI上的列。如果游标不可用则为null。 to展示参数“from”中的列,也就是说ListView中的视图显示的是参数“from”的列值,这些视图应该都是TextView。如果游标不可用则为null。 flags 这个标志用来决定该适配器的行为。 ( 译者注: Android3.0 推荐我们传递 CursorAdapter.FLAG_REGISTER_CONTENT_OBSERVER 。设置标志用来添加一个监听器,监听着参数 cursor 的数据是否有更变。 ) 四、公共方法 public voidbindView(View view, Context context, Cursor cursor) 绑定所有构造函数中的参数from(字段名)一一绑定到参数to(视图资源ID)。与视图绑定有两个阶段。第一阶段:如果SimpleCursorAdapter.ViewBinder可用,将会调用setViewValue(android.view.View, android.database.Cursor, int)方法。该方法返回true就说明绑定成功,否则返回false,这就到了第二阶段,SimpleCursorAdapter内部开始自行绑定,过程是这样的,若绑定到TextView上,调用setViewText();若绑定到ImageView上,调用setViewImage();如果视图不是TextView或ImageView则抛出IllegalStateException异常。 参数 view已存在的视图(View)对象,也就是早先new出来的。 context应用程序上下文。 cursor 数据库游标。该游标已经移动到指定位置上。 异常 IllegalStateException如果绑定的视图中不是TextView或是ImageView则会抛出这个异常。 参见 bindView(android.view.View, android.content.Context, android.database.Cursor) getViewBinder() setViewBinder(android.widget.SimpleCursorAdapter.ViewBinder) setViewImage(ImageView, String) setViewText(TextView, String) public voidchangeCursorAndColumns(Cursor c, String[] from, int[] to) 同时更改Cursor与View的映射关系。 参数 c数据库游标,如果游标不可用则为null。 from列名字列表,表示着你要绑定到UI上的列。如果游标不可用则为null。 to展示参数“from”中的列,也就是说ListView中的视图显示的是参数“from”的列值,这些视图应该都是TextView。如果游标不可用则为null。 public CharSequenceconvertToString(Cursor cursor) 通过CursorToStringConverter接口实现并返回一个CharSequence类型的值,以表示指定的Cursor。如果没有设置CursorToStringConverter,那么就会用另外的方式进行转换。如果列数为-1,或者cursor为null返回空串,否则返回cursor.toString()。 参数 cursor 转换为CharSequence的数据库游标。 返回值 返回一个不为null的CharSequence类型来表示参数cursor。 public SimpleCursorAdapter.CursorToStringConvertergetCursorToStringConverter() 返回自定义的SimpleCursorAdapter.CursorToStringConverter的实现。 返回值 如果没有设置SimpleCursorAdapter.CursorToStringConverter,则为null。 参考 setCursorToStringConverter(android.widget.SimpleCursorAdapter.CursorToStringConverter) getStringConversionColumn() setStringConversionColumn(int) convertToString(android.database.Cursor) public intgetStringConversionColumn() 返回转换成String类型的列位置。 返回值 返回列位置,如果没有则返回-1。 参考 convertToString(android.database.Cursor) setStringConversionColumn(int) setCursorToStringConverter(android.widget.SimpleCursorAdapter.CursorToStringConverter) getCursorToStringConverter() public SimpleCursorAdapter.ViewBindergetViewBinder() 返回SimpleCursorAdapter.ViewBinder引用,这个ViewBinder用来将数据绑定到视图上的。 返回值 如果ViewBinder不存在,则返回null。 参考 bindView(android.view.View, android.content.Context, android.database.Cursor) setViewBinder(android.widget.SimpleCursorAdapter.ViewBinder) public voidsetCursorToStringConverter(SimpleCursorAdapter.CursorToStringConverter cursorToStringConverter) 设置String转换器。 参数 cursorToStringConverterString转换器,设置为null就意味着移除。 参考 setCursorToStringConverter(android.widget.SimpleCursorAdapter.CursorToStringConverter) getStringConversionColumn() setStringConversionColumn(int) convertToString(android.database.Cursor) public voidsetStringConversionColumn(int stringConversionColumn) 设置Cursor中的列要转换成String类型的位置。不过仅当未设置CursorToStringConverter时,这个列才会进行默认转换。 参数 stringConversionColumn列位置,如果参数为-1,则使用默认转换机制。 参考 convertToString(android.database.Cursor) getStringConversionColumn() setCursorToStringConverter(android.widget.SimpleCursorAdapter.CursorToStringConverter) getCursorToStringConverter() public voidsetViewBinder(SimpleCursorAdapter.ViewBinder viewBinder) 设置视图绑定器。 参数 viewBinder视图绑定器,可用为null删除现有的绑定器。 参考 bindView(android.view.View, android.content.Context, android.database.Cursor) getViewBinder() public voidsetViewImage(ImageView v, String value) 仅当ViewBinder不存在或是当ViewBinder不为ImageView绑定时(也就是setViewValue()返回false),则这个方法会被bindView()调用,以便为ImageView设置图片。默认情况下,参数value作为图片资源ID来看待,否则,会视为图片的Uri。另外还可以通过过滤器来获得更灵活的设置。 参数 v图片控件引用 value图片资源ID,是从Cursor获取到的。 public voidsetViewText(TextView v, String text) 仅当ViewBinder不存在或是当ViewBinder不为TextView绑定时(也就是setViewValue()返回false),则这个方法会被bindView()调用,以便为TextView设置文本。可用重写适配器从数据库中检索过滤字符串。 参数 v文本控件引用 value为文本控件设置的文本信息(译者注:是从Cursor获取到的)。 public CursorswapCursor(Cursor c) 交换两个Cursor的列以及它们的数据,并最终返回的还是旧的Cursor。不同于changeCursor(Cursor)的是,旧的Cursor非但不会关闭,而且还会返回出去。(译者注: 3.0新添的方法) 参数 c新的Cursor对象。 返回值 返回旧的 Cursor 引用,如果参数 cursor 不可用,则返回 null 。如果参数 cursor 与原来的 Cursor 引用相同,那么也返回 null 。 五、补充 文章精选 ArrayAdapter和SimpleCursorAdapter例子 Android API : SimpleCursorAdapter() 示例代码 Demo_SimpleCursorAdapter(深夜未眠).rar SimpleCursorAdapter.CursorToStringConverter 译者署名:深夜未眠 译者链接:http://chris1012f.javaeye.com/ 版本:Android 3.0 r1 正文 一、结构 public static interfaceSimpleCusrorAdapter.CursorToStringConverter java.lang.Object android.widget.SimpleCursorAdapter.CursorToStringConverter 二、概述 这个内部接口可以在外部通过SimpleCursorAdapter.CursorToStringConverter的方式定义怎样将Cursor转换成字符串。 参见 convertToString(android.database.Cursor) 三、公共方法 public abstract CharSequenceconvertToString(Cursor cursor) 返回CharSequence类型的值,用来表示参数cursor。 参数 cusor需要转换成CharSequence类型的数据库游标。 返回值 返回代表参数cursor的非空字符串。 SimpleCursorAdapter.ViewBinder 译者署名:深夜未眠 译者链接:http://chris1012f.javaeye.com/ 版本:Android 3.0 r1 正文 一、结构 public static interfaceSimpleCusrorAdapter.ViewBinder java.lang.Object android.widget.SimpleCursorAdapter.ViewBinder 二、概述 这个内部接口可以在外部通过SimpleCursorAdapter.ViewBinder的方式进行Cursor与View的绑定。Android推荐我们采用这种方式进行绑定操作,而不是沿用SimpleCursorAdapter内部的方式。 参见 bindView(android.view.View, android.content.Context, android.database.Cursor) setViewImage(ImageView, String) setViewText(TextView, String) 三、公共方法 public abstract booleansetViewValue(View view, Cursor cursor, int columnIndex) 将指定的列数据绑定到指定的视图上。当ViewBinder处理时,这个方法必须返回true。如果这个方法返回false,SimpleCursorAdapter将用自己的方式进行绑定操作。 参数 view被绑定的视图。 cursor数据库游标,绑定数据从它这里获取 columnIndex列位置,能够在数据库游标中寻找到。 返回值 返回true意味着数据与视图已经绑定上,否则为未绑定上。 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582379,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android 3.0 r1 API中文文档(108) —— ExpandableListAdapter

正文 一、结构 public interfaceExpandableListAdapter android.widget.ExpandableListAdapter 间接子类 BaseExpandableListAdapter,CursorTreeAdapter,ResourceCursorTreeAdapter, SimpleCursorTreeAdapter, SimpleExpandableListAdapter 二、概述 这个适配器在 ExpandableListView 和底层数据之间起到了一个衔接的作用。该接口的实现类提供了访问子元素(以组的形式将它们分类)的数据;同样,也提供了为子元素和组创建相应的视图。 三、公共方法 public abstract booleanareAllItemsEnabled() ExpandableListAdapter里面的所有条目都可用吗?如果是yes,就意味着所有条目可以选择和点击了。 返回值 返回True表示所有条目均可用。 参见 areAllItemsEnabled() public abstract CursorgetChild(int groupPosition, int childPosition) 获取指定组中的指定子元素数据。 参数 groupPosition组位置(该组内部含有子元素) childPosition子元素位置(相对于其它子元素) 返回值 返回指定子元素数据。 public abstract longgetChildId(int groupPosition, int childPosition) 获取指定组中的指定子元素ID,这个ID在组里一定是唯一的。联合ID(参见getCombinedChildId(long, long))在所有条目(所有组和所有元素)中也是唯一的。 参数 groupPosition组位置(该组内部含有子元素) childPosition子元素位置(相对于其它子元素) 返回值 子元素关联ID。 public abstract ViewgetChildView(int groupPosition, int childPosition, boolean isLastChild, View convertView, ViewGroup parent) 获取一个视图对象,显示指定组中的指定子元素数据。 参数 groupPosition组位置(该组内部含有子元素) childPosition子元素位置(决定返回哪个视图) isLastChild子元素是否处于组中的最后一个 convertView重用已有的视图(View)对象。注意:在使用前你应该检查一下这个视图对象是否非空并且这个对象的类型是否合适。由此引伸出,如果该对象不能被转换并显示正确的数据,这个方法就会调用getChildView(int, int, boolean, View, ViewGroup)来创建一个视图(View)对象。 parent 返回的视图(View)对象始终依附于的视图组。 返回值 指定位置上的子元素返回的视图对象 public abstract intgetChildrenCount(int groupPosition) 获取指定组中的子元素个数 参数 groupPosition组位置(决定返回哪个组的子元素个数) 返回值 指定组的子元素个数 public abstract longgetCombinedChildId(long groupId, long childId) 从列表所有项(组或子项)中获得一个唯一的子ID号。可折叠列表要求每个元素(组或子项)在所有的子元素和组中有一个唯一的ID。本方法负责根据所给的子ID号和组ID号返回唯一的ID。此外,若hasStableIds()是true,那么必须要返回稳定的ID。 参数 groupId包含该子元素的组ID childId子元素的ID 返回值 列表所有项(组或子项)中唯一的(和可能稳定)的子元素ID号。(译者注:ID理论上是稳定的,不会发生冲突的情况。也就是说,这个列表会有组、子元素,它们的ID都是唯一的。) public abstract CursorgetGroup(int groupPosition) 获取指定组中的数据 参数 groupPosition组位置 返回值 返回组中的数据,也就是该组中的子元素数据。 public abstract intgetGroupCount() 获取组的个数 返回值 组的个数 public abstract longgetGroupId(int groupPosition) 获取指定组的ID,这个组ID必须是唯一的。联合ID(参见getCombinedGroupId(long))在所有条目(所有组和所有元素)中也是唯一的。 参数 groupPosition组位置 返回值 返回组相关ID public abstract ViewgetGroupView(int groupPosition, boolean isExpanded, View convertView, ViewGroup parent) 获取显示指定组的视图对象。这个方法仅返回关于组的视图对象,要想获取子元素的视图对象,就需要调用getChildView(int, int, boolean, View, ViewGroup)。 参数 groupPosition组位置(决定返回哪个视图) isExpanded 该组是展开状态还是伸缩状态 convertView重用已有的视图对象。注意:在使用前你应该检查一下这个视图对象是否非空并且这个对象的类型是否合适。由此引伸出,如果该对象不能被转换并显示正确的数据,这个方法就会调用getGroupView(int, boolean, View, ViewGroup)来创建一个视图(View)对象。 parent返回的视图对象始终依附于的视图组。 返回值 返回指定组的视图对象 public abstract booleanhasStableIds() 组和子元素是否持有稳定的ID,也就是底层数据的改变不会影响到它们。 返回值 返回一个Boolean类型的值,如果为TRUE,意味着相同的ID永远引用相同的对象。 public abstract booleanisChildSelectable(int groupPosition, int childPosition) 是否选中指定位置上的子元素。 参数 groupPosition组位置(该组内部含有这个子元素) childPosition子元素位置 返回值 是否选中子元素 public abstract booleanisEmpty() 返回值 如果当前适配器不包含任何数据则返回True。经常用来决定一个空视图是否应该被显示。一个典型的实现将返回表达式getCount() == 0的结果,但是由于getCount()包含了头部和尾部,适配器可能需要不同的行为。 参见 isEmpty() public abstract voidonGroupCollapsed(int groupPosition) 当组收缩状态的时候此方法被调用。 参数 groupPosition收缩状态的组索引 public abstract voidonGroupExpanded(int groupPosition) 当组展开状态的时候此方法被调用。 参数 groupPosition展开状态的组位置 public abstract voidregisterDataSetObserver(DataSetObserver observer) 注册一个观察者(observer),当此适配器数据修改时即调用此观察者。 参数 observer当数据修改时通知调用的对象。 public abstract voidunregisterDataSetObserver(DataSetObserver observer) 取消先前通过registerDataSetObserver(DataSetObserver)方式注册进该适配器中的观察者对象。 参数 observer 取消这个观察者的注册 四、补充 文章精选 android可展开(收缩)的列表ListView(ExpandableListView) android CursorAdapter的监听事件 ExpandableListView.OnChildClickListener 译者署名:情敌贝多芬 译者链接:http://liubey.javaeye.com/ 版本:Android 3.0 r1 结构 继承关系 public static interfaceExpandableListView.OnChildClickListener java.lang.Object android.widget.ExpandableListView.OnChildClickListener 子类及间接子类 间接子类 ExpandableListActivity 类概述 这是一个定义了当可折叠列表(expandable list)里的子元素(child)发生点击事件时调用的回调方法的接口。 公共方法 public abstract booleanonChildClick(ExpandableListView parent, View v, int groupPosition, int childPosition, long id) 用当可折叠列表里的子元素(child)被点击的时候被调用的回调方法。 参数 parent 发生点击动作的ExpandableListView v 在expandable list/ListView中被点击的视图(View) groupPosition 包含被点击子元素的组(group)在ExpandableListView中的位置(索引) childPosition被点击子元素(child)在组(group)中的位置 id 被点击子元素(child)的行ID(索引) 返回值 当点击事件被处理时返回 true ExpandableListView.OnGroupClickListener 译者署名:情敌贝多芬 译者链接:http://liubey.javaeye.com/ 版本:Android 3.0 r1 结构 继承关系 public static interfaceExpandableListView.OnGroupClickListener java.lang.Object android.widget.ExpandableListView.OnGroupClickListener 类概述 这是一个定义了当可折叠列表(expandable list)里的组(group)发生点击事件时调用的回调方法的接口。 公共方法 public abstract booleanonGroupClick(ExpandableListView parent, View v, int groupPosition, long id) 用当可折叠列表里的组(group)被点击的时候被调用的回调方法。 参数 parent发生点击事件的ExpandableListConnector v 在expandable list/ListView中被点击的视图(View) groupPosition被点击的组(group)在ExpandableListConnector中的位置(索引) id 被点击的组(group)的行ID(索引) 返回值 当点击事件被处理的时候返回true ExpandableListView.OnGroupCollapseListener 译者署名:深夜未眠 译者链接:http://chris1012f.javaeye.com/ 版本:Android 3.0 r1 结构 继承关系 public interfaceExpandableListView.OnGroupCollapseListener java.lang.Object android.widget.ExpandableListView.OnGroupCollapseListener 子类及间接子类 间接子类 ExpandableListActivity 类概述 当收缩某个组时,就会发出通知。 公共方法 public abstract void onGroupCollapse (int groupPosition) 每当收缩当前可伸缩列表中的某个组时,就调用该方法。 参数 groupPosition组位置,也就是收缩的那个组的位置。 ExpandableListView.OnGroupExpandListener 译者署名:深夜未眠 译者链接:http://chris1012f.javaeye.com/ 版本:Android 3.0 r1 结构 继承关系 public interfaceExpandableListView.OnGroupExpandListener java.lang.Object android.widget.ExpandableListView.OnGroupExpandListener 子类及间接子类 间接子类 ExpandableListActivity 类概述 当展开某个组时,就会发出通知。 公共方法 public abstract void onGroupExpand (int groupPosition) 每当展开当前可伸缩列表中的某个组时,就调用该方法。 参数 groupPosition 组位置,也就是展开的那个组的位置。 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582376,如需转载请自行联系原作者

优秀的个人博客,低调大师

android 官方文档中的一些错误收集

1,Intents and Intent Filters 中<data> 的 说明 原文: For example, in the following URI, content://com.example.project:200/folder/subfolder/etc the scheme is "content", the host is "com.example.project", the port is "200", and the path is "folder/subfolder/etc". The host and port together constitute the URIauthority; if a host is not specified, the port is ignored. 这里的错误的地方在于path=”folder/subfolder/etc” 而实际上path=”/folder/subfolder/etc” 在首位应该还有一个分隔符,少了这个分隔符,将无法匹配<data> 由android 2.2 测试实际方法得出: ps:有同样的错误的文章 Content Providers 中 Content URI Summary C 项的解释 本文转自 liam2199 博客,原文链接:http://blog.51cto.com/youxilua/773123如需转载请自行联系原作者

优秀的个人博客,低调大师

Android 3.0 r1 API中文文档(105) —— ViewParent

正文 一、结构 public interfaceViewParent android.view.ViewParent 间接子类 AbsListView, AbsSpinner, AbsoluteLayout, AdapterView<T extends Adapter>, AppWidgetHostView, DatePicker, DialerFilter, ExpandableListView, FrameLayout, Gallery, GestureOverlayView, GridView, HorizontalScrollView, ImageSwitcher, LinearLayout, ListView, MediaController, RadioGroup, RelativeLayout, ScrollView, SlidingDrawer, Spinner, TabHost, TabWidget, TableLayout, TableRow, TextSwitcher, TimePicker, TwoLineListItem, ViewAnimator, ViewFlipper, ViewGroup, ViewSwitcher, WebView, ZoomControls 二、类概述 定义了一些作为View父类,它所具有的功能(译者注:也可以理解为方法)。当一个View与父类交互时,就可以用到这些API了。(译者注:Android中子控件维系一个ViewParent对象,该对象象征着整个控件树的管理者,子控件产生影响整个控件树的事件时,会通知到ViewParent,ViewParent会将其转换成一个自顶向下的事件,分发下去。参照这里) 三、公共方法 public abstract voidbringChildToFront(View child) 把该视图置于其他所有子视图之上。(译者注:如在FrameLayout中切换被叠放的视图) 参数 child 需要改变顺序的子视图 public abstract voidchildDrawableStateChanged(View child) 当子视图的drawable状态发生变化的时候,调用该方法。 参数 child drawable状态发生变化的子视图 public abstract voidclearChildFocus(View child) 当子视图失去焦点的时候调用该方法。 参数 child 失去焦点的子视图 public abstract voidcreateContextMenu(ContextMenu menu) 如果该指定的ContextMenu需要增加菜单,则会由它的父类去填充(同时会向上递归)。 参数 menu 需要填充的菜单 public abstract ViewfocusSearch(View v, int direction) 在指定的方向找到最近的View来切换焦点。 参数 v 当前视图 direction FOCUS_UP, FOCUS_DOWN, FOCUS_LEFT,与FOCUS_RIGHT中取值 public abstract voidfocusableViewAvailable(View v) 通知父类一个新的并且能够取得焦点的子视图可以使用了。用于处理从没有可取得焦点的视图到出现第一个可以取得焦点的视图的转变。 参数 v 新出现的可以取得焦点的视图 public abstract booleangetChildVisibleRect(View child, Rect r, Point offset) public abstractViewParentgetParent() 如果存在父视图,则返回该视图;否则返回NULL。 返回 如果不存在父视图,则返回null public abstract voidinvalidateChild(View child, Rect r) 重绘当前child指定的范围。 参数 child 当前视图 r child中无效的范围区域 public abstract ViewParentinvalidateChildInParent(int[]location, Rect r) 重绘当前child的全部或者一部分指定范围。location长度为的整形数组,两个数分别为child左边和上边的坐标。如果父视图中指定的区域r是无效的,则返回该ViewParent的父视图。如果父视图中指定区域是有效的或者父视图不存在,则返回null。如果方法返回对象不为空,则需要把location数组中的数值更新为返回的ViewParent的左边和上边的坐标值。 参数 location 长度为2的整形数组,数据为需要失效的child左边和上边的坐标值 r child中无效的范围区域 返回 ViewParent,如果不存在父视图,则返回null public abstract booleanisLayoutRequested() 返回该视图父类是否有layout控件被请求。 返回 true需要,false不需要 public abstract voidrecomputeViewAttributes(View child) 通知父类和子类所有的View属性需要重新生成。 参数 child 改变属性的View public abstract voidrequestChildFocus(View child, View focused) 当需要转换子类焦点时调用。 参数 child该ViewParent需要取得焦点的视图。该视图包含当前聚焦视图。但事实上也不一定会获得焦点 focused child的一个有焦点的子视图 public abstract booleanrequestChildRectangleOnScreen(View child, Rect rectangle, booleanimmediate) 当该child视图需要显示在屏幕特定位置时调用。ViewGroup如果需要重写该方法,可以遵循以下几点: *必须是该group的直接子类 *要是child中的坐标 ViewGroup要重写该方法,要坚持几下几点: *规定的区域已经是可见的,那么该方法将什么都不会改变 *区域可见时,该视图才会有滚动条 参数 child以起请求的直接子视图 rectangle需要显示到屏幕上的区域范围 immediate true禁止有滚动 false则有 返回值 处理请求操作后是否有滚动 public abstract voidrequestDisallowInterceptTouchEvent(boolean disallowIntercept) 让父类不用onInterceptTouchEvent(MotionEvent)来拦截触屏事件。 该父类需要把该方法传递给它的父类。同时也要服从触屏的请求(也就是说,只有在按上Up或者clear后才能清除该标识)。 参数 disallowIntercept true表示child触屏事件 public abstract voidrequestLayout() 当父视图的一个child的Layout控件失效时调用。该方法将会重新请求一个Layout控件。 public abstract voidrequestTransparentRegion(View child) 当一个child希望视图层去收集透明区域并报告给窗口排序服务时调用。例如SurfaceView可以用这个接口来提高接口性能。如果在当前层次没有视图,没有必要用该方法优化,否则有可能会轻微影响该层的性能。 参数 child要求透明区域进行处理的视图 public abstract booleanshowContextMenuForChild(View originalView) 显示该视图或者其祖先类的上下文菜单。 大多数情况下,子类不需要重写该方法。但是,当该子类被直接加到窗口管理器上时(例如:addView(View, android.view.ViewGroup.LayoutParams)),就会重写该方法,并显示上下文菜单。 参数 originalView需要显示上下文菜单的视图 返回 显示上下文菜单时返回true public abstract ActionModestartActionModeForChild(View originalView, ActionMode.Callback callback)Since: API Level 11 为指定视图启动一个操作模式。 大多数情况下,一个子类并不需要重新此类。但是,如果子类是直接添加到窗口管理器(例如,addView(View, android.view.ViewGroup.LayoutParams)),那么应重写此方法并启动操作模式。(译者注:关于ActionMode参见这里) 参数 originalView 操作模式首页调用的源视图 callback处理操作模式生命周期的回调函数 返回值 如果新的操作模式已经启动,返回该操作模式,否则返回 null 。 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582380,如需转载请自行联系原作者


优秀的个人博客,低调大师

Apache Storm 官方文档 —— 定义 Storm 的非 JVM 语言 DSL

实现非 JVM 语言 DSL(Domain Specific Language,领域专用语言)应该从storm-core/src/storm.thrift文件开始。由于 Storm 拓扑是 Thrift 结构,而且 Nimbus 是一个 Thrift 后台进程,你可以以任意语言创建并提交拓扑。 当你创建 Thrift 结构的 spouts 与 bolts 时,spout 或者 bolt 的代码是以 ComponentObject 结构体的形式定义的: union ComponentObject { 1: binary serialized_java; 2: ShellComponent shell; 3: JavaObject java_object; } 对于非 JVM 语言 DSL(这里以 Python DSL 为例),你需要使用其中的 “2” 与 “3”。ShellComponent 负责指定运行该组件(例如你的 python 代码)的脚本,而 JavaObject 则负责指定该组件的本地(native)Java spouts 与 bolts(而且 Storm 也会使用反射来创建 spout 或者 bolt)。 “storm shell” 命令可以用于提交拓扑。下面是一个示例: storm shell resources/ python topology.py arg1 arg2 Storm shell 随后会将resources/打包到一个 jar 文件中,将该文件上传到 Nimbus,然后像这样调用你的 topology.py 脚本: python topology.py arg1 arg2 {nimbus-host} {nimbus-port} {uploaded-jar-location} 接着你就可以使用 Thrift API 连接到 Nimbus 来提交拓扑,并将上传的 jar 文件地址作为参数传入 submitTopology 方法中。作为参考,下面给出了 submitTopology 的定义: void submitTopology(1: string name, 2: string uploadedJarLocation, 3: string jsonConf, 4: StormTopology topology) throws (1: AlreadyAliveException e, 2: InvalidTopologyException ite); 最后,对于非 JVM DSL 还有一件非常重要的事就是要确保可以在一个文件中方便地定义出完整的拓扑(bolts,spouts,以及拓扑的其他部分定义)。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark SQL, DataFrames 以及 Datasets 编程指南(二)

编程方式定义Schema Scala Java Python 如果不能事先通过case class定义schema(例如,记录的字段结构是保存在一个字符串,或者其他文本数据集中,需要先解析,又或者字段对不同用户有所不同),那么你可能需要按以下三个步骤,以编程方式的创建一个DataFrame: 从已有的RDD创建一个包含Row对象的RDD 用StructType创建一个schema,和步骤1中创建的RDD的结构相匹配 把得到的schema应用于包含Row对象的RDD,调用这个方法来实现这一步:SQLContext.createDataFrame For example: 例如: // sc 是已有的SparkContext对象 val sqlContext = new org.apache.spark.sql.SQLContext(sc) // 创建一个RDD val people = sc.textFile("examples/src/main/resources/people.txt") // 数据的schema被编码与一个字符串中 val schemaString = "name age" // Import Row. import org.apache.spark.sql.Row; // Import Spark SQL 各个数据类型 import org.apache.spark.sql.types.{StructType,StructField,StringType}; // 基于前面的字符串生成schema val schema = StructType( schemaString.split(" ").map(fieldName => StructField(fieldName, StringType, true))) // 将RDD[people]的各个记录转换为Rows,即:得到一个包含Row对象的RDD val rowRDD = people.map(_.split(",")).map(p => Row(p(0), p(1).trim)) // 将schema应用到包含Row对象的RDD上,得到一个DataFrame val peopleDataFrame = sqlContext.createDataFrame(rowRDD, schema) // 将DataFrame注册为table peopleDataFrame.registerTempTable("people") // 执行SQL语句 val results = sqlContext.sql("SELECT name FROM people") // SQL查询的结果是DataFrame,且能够支持所有常见的RDD算子 // 并且其字段可以以索引访问,也可以用字段名访问 results.map(t => "Name: " + t(0)).collect().foreach(println) 数据源 Spark SQL支持基于DataFrame操作一系列不同的数据源。DataFrame既可以当成一个普通RDD来操作,也可以将其注册成一个临时表来查询。把DataFrame注册为table之后,你就可以基于这个table执行SQL语句了。本节将描述加载和保存数据的一些通用方法,包含了不同的Spark数据源,然后深入介绍一下内建数据源可用选项。 通用加载/保存函数 在最简单的情况下,所有操作都会以默认类型数据源来加载数据(默认是Parquet,除非修改了spark.sql.sources.default 配置)。 Scala Java Python R val df = sqlContext.read.load("examples/src/main/resources/users.parquet") df.select("name", "favorite_color").write.save("namesAndFavColors.parquet") 手动指定选项 你也可以手动指定数据源,并设置一些额外的选项参数。数据源可由其全名指定(如,org.apache.spark.sql.parquet),而对于内建支持的数据源,可以使用简写名(json, parquet, jdbc)。任意类型数据源创建的DataFrame都可以用下面这种语法转成其他类型数据格式。 Scala Java Python R val df = sqlContext.read.format("json").load("examples/src/main/resources/people.json") df.select("name", "age").write.format("parquet").save("namesAndAges.parquet") 直接对文件使用SQL Spark SQL还支持直接对文件使用SQL查询,不需要用read方法把文件加载进来。 Scala Java Python R val df = sqlContext.sql("SELECT * FROM parquet.`examples/src/main/resources/users.parquet`") 保存模式 Save操作有一个可选参数SaveMode,用这个参数可以指定如何处理数据已经存在的情况。很重要的一点是,这些保存模式都没有加锁,所以其操作也不是原子性的。另外,如果使用Overwrite模式,实际操作是,先删除数据,再写新数据。 仅Scala/Java 所有支持的语言 含义 SaveMode.ErrorIfExists(default) "error"(default) (默认模式)从DataFrame向数据源保存数据时,如果数据已经存在,则抛异常。 SaveMode.Append "append" 如果数据或表已经存在,则将DataFrame的数据追加到已有数据的尾部。 SaveMode.Overwrite "overwrite" 如果数据或表已经存在,则用DataFrame数据覆盖之。 SaveMode.Ignore "ignore" 如果数据已经存在,那就放弃保存DataFrame数据。这和SQL里CREATE TABLE IF NOT EXISTS有点类似。 保存到持久化表 在使用HiveContext的时候,DataFrame可以用saveAsTable方法,将数据保存成持久化的表。与registerTempTable不同,saveAsTable会将DataFrame的实际数据内容保存下来,并且在HiveMetastore中创建一个游标指针。持久化的表会一直保留,即使Spark程序重启也没有影响,只要你连接到同一个metastore就可以读取其数据。读取持久化表时,只需要用用表名作为参数,调用SQLContext.table方法即可得到对应DataFrame。 默认情况下,saveAsTable会创建一个”managed table“,也就是说这个表数据的位置是由metastore控制的。同样,如果删除表,其数据也会同步删除。 Parquet文件 Parquet是一种流行的列式存储格式。Spark SQL提供对Parquet文件的读写支持,而且Parquet文件能够自动保存原始数据的schema。写Parquet文件的时候,所有的字段都会自动转成nullable,以便向后兼容。 编程方式加载数据 仍然使用上面例子中的数据: Scala Java Python R Sql // 我们继续沿用之前例子中的sqlContext对象 // 为了支持RDD隐式转成DataFrame import sqlContext.implicits._ val people: RDD[Person] = ... // 和上面例子中相同,一个包含case class对象的RDD // 该RDD将隐式转成DataFrame,然后保存为parquet文件 people.write.parquet("people.parquet") // 读取上面保存的Parquet文件(多个文件 - Parquet保存完其实是很多个文件)。Parquet文件是自描述的,文件中保存了schema信息 // 加载Parquet文件,并返回DataFrame结果 val parquetFile = sqlContext.read.parquet("people.parquet") // Parquet文件(多个)可以注册为临时表,然后在SQL语句中直接查询 parquetFile.registerTempTable("parquetFile") val teenagers = sqlContext.sql("SELECT name FROM parquetFile WHERE age >= 13 AND age <= 19") teenagers.map(t => "Name: " + t(0)).collect().foreach(println) 分区发现 像Hive这样的系统,一个很常用的优化手段就是表分区。在一个支持分区的表中,数据是保存在不同的目录中的,并且将分区键以编码方式保存在各个分区目录路径中。Parquet数据源现在也支持自动发现和推导分区信息。例如,我们可以把之前用的人口数据存到一个分区表中,其目录结构如下所示,其中有2个额外的字段,gender和country,作为分区键: path └── to └── table ├── gender=male │ ├── ... │ │ │ ├── country=US │ │ └── data.parquet │ ├── country=CN │ │ └── data.parquet │ └── ... └── gender=female ├── ... │ ├── country=US │ └── data.parquet ├── country=CN │ └── data.parquet └── ... 在这个例子中,如果需要读取Parquet文件数据,我们只需要把 path/to/table 作为参数传给 SQLContext.read.parquet 或者 SQLContext.read.load。Spark SQL能够自动的从路径中提取出分区信息,随后返回的DataFrame的schema如下: root |-- name: string (nullable = true) |-- age: long (nullable = true) |-- gender: string (nullable = true) |-- country: string (nullable = true) 注意,分区键的数据类型将是自动推导出来的。目前,只支持数值类型和字符串类型数据作为分区键。 有的用户可能不想要自动推导出来的分区键数据类型。这种情况下,你可以通过 spark.sql.sources.partitionColumnTypeInference.enabled (默认是true)来禁用分区键类型推导。禁用之后,分区键总是被当成字符串类型。 从Spark-1.6.0开始,分区发现默认只在指定目录的子目录中进行。以上面的例子来说,如果用户把 path/to/table/gender=male 作为参数传给 SQLContext.read.parquet 或者 SQLContext.read.load,那么gender就不会被作为分区键。如果用户想要指定分区发现的基础目录,可以通过basePath选项指定。例如,如果把 path/to/table/gender=male作为数据目录,并且将basePath设为 path/to/table,那么gender仍然会最为分区键。 Schema合并 像ProtoBuffer、Avro和Thrift一样,Parquet也支持schema演变。用户从一个简单的schema开始,逐渐增加所需的新字段。这样的话,用户最终会得到多个schema不同但互相兼容的Parquet文件。目前,Parquet数据源已经支持自动检测这种情况,并合并所有文件的schema。 因为schema合并相对代价比较大,并且在多数情况下不是必要的,所以从Spark-1.5.0之后,默认是被禁用的。你可以这样启用这一功能: 读取Parquet文件时,将选项mergeSchema设为true(见下面的示例代码) 或者,将全局选项spark.sql.parquet.mergeSchema设为true Scala Python R // 继续沿用之前的sqlContext对象 // 为了支持RDD隐式转换为DataFrame import sqlContext.implicits._ // 创建一个简单的DataFrame,存到一个分区目录中 val df1 = sc.makeRDD(1 to 5).map(i => (i, i * 2)).toDF("single", "double") df1.write.parquet("data/test_table/key=1") // 创建另一个DataFrame放到新的分区目录中, // 并增加一个新字段,丢弃一个老字段 val df2 = sc.makeRDD(6 to 10).map(i => (i, i * 3)).toDF("single", "triple") df2.write.parquet("data/test_table/key=2") // 读取分区表 val df3 = sqlContext.read.option("mergeSchema", "true").parquet("data/test_table") df3.printSchema() // 最终的schema将由3个字段组成(single,double,triple) // 并且分区键出现在目录路径中 // root // |-- single: int (nullable = true) // |-- double: int (nullable = true) // |-- triple: int (nullable = true) // |-- key : int (nullable = true) Hive metastore Parquet table转换 在读写Hive metastore Parquet 表时,Spark SQL用的是内部的Parquet支持库,而不是Hive SerDe,因为这样性能更好。这一行为是由spark.sql.hive.convertMetastoreParquet 配置项来控制的,而且默认是启用的。 Hive/Parquet schema调和 Hive和Parquet在表结构处理上主要有2个不同点: Hive大小写敏感,而Parquet不是 Hive所有字段都是nullable的,而Parquet需要显示设置 由于以上原因,我们必须在Hive metastore Parquet table转Spark SQL Parquet table的时候,对Hive metastore schema做调整,调整规则如下: 两种schema中字段名和字段类型必须一致(不考虑nullable)。调和后的字段类型必须在Parquet格式中有相对应的数据类型,所以nullable是也是需要考虑的。 调和后Spark SQL Parquet table schema将包含以下字段: 只出现在Parquet schema中的字段将被丢弃 只出现在Hive metastore schema中的字段将被添加进来,并显式地设为nullable。 刷新元数据 Spark SQL会缓存Parquet元数据以提高性能。如果Hive metastore Parquet table转换被启用的话,那么转换过来的schema也会被缓存。这时候,如果这些表由Hive或其他外部工具更新了,你必须手动刷新元数据。 Scala Java Python Sql // 注意,这里sqlContext是一个HiveContext sqlContext.refreshTable("my_table") 配置 Parquet配置可以通过 SQLContext.setConf 或者 SQL语句中 SET key=value来指定。 属性名 默认值 含义 spark.sql.parquet.binaryAsString false 有些老系统,如:特定版本的Impala,Hive,或者老版本的Spark SQL,不区分二进制数据和字符串类型数据。这个标志的意思是,让Spark SQL把二进制数据当字符串处理,以兼容老系统。 spark.sql.parquet.int96AsTimestamp true 有些老系统,如:特定版本的Impala,Hive,把时间戳存成INT96。这个配置的作用是,让Spark SQL把这些INT96解释为timestamp,以兼容老系统。 spark.sql.parquet.cacheMetadata true 缓存Parquet schema元数据。可以提升查询静态数据的速度。 spark.sql.parquet.compression.codec gzip 设置Parquet文件的压缩编码格式。可接受的值有:uncompressed, snappy, gzip(默认), lzo spark.sql.parquet.filterPushdown true 启用过滤器下推优化,可以讲过滤条件尽量推导最下层,已取得性能提升 spark.sql.hive.convertMetastoreParquet true 如果禁用,Spark SQL将使用Hive SerDe,而不是内建的对Parquet tables的支持 spark.sql.parquet.output.committer.class org.apache.parquet.hadoop. ParquetOutputCommitter Parquet使用的数据输出类。这个类必须是 org.apache.hadoop.mapreduce.OutputCommitter的子类。一般来说,它也应该是 org.apache.parquet.hadoop.ParquetOutputCommitter的子类。注意:1. 如果启用spark.speculation, 这个选项将被自动忽略 2. 这个选项必须用hadoop configuration设置,而不是Spark SQLConf 3. 这个选项会覆盖 spark.sql.sources.outputCommitterClass Spark SQL有一个内建的org.apache.spark.sql.parquet.DirectParquetOutputCommitter, 这个类的在输出到S3的时候比默认的ParquetOutputCommitter类效率高。 spark.sql.parquet.mergeSchema false 如果设为true,那么Parquet数据源将会merge 所有数据文件的schema,否则,schema是从summary file获取的(如果summary file没有设置,则随机选一个) 转载自 并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark SQL, DataFrames 以及 Datasets 编程指南(三)

JSON数据集 Scala Java Python R Sql Spark SQL在加载JSON数据的时候,可以自动推导其schema并返回DataFrame。用SQLContext.read.json读取一个包含String的RDD或者JSON文件,即可实现这一转换。 注意,通常所说的json文件只是包含一些json数据的文件,而不是我们所需要的JSON格式文件。JSON格式文件必须每一行是一个独立、完整的的JSON对象。因此,一个常规的多行json文件经常会加载失败。 // sc是已有的SparkContext对象 val sqlContext = new org.apache.spark.sql.SQLContext(sc) // 数据集是由路径指定的 // 路径既可以是单个文件,也可以还是存储文本文件的目录 val path = "examples/src/main/resources/people.json" val people = sqlContext.read.json(path) // 推导出来的schema,可由printSchema打印出来 people.printSchema() // root // |-- age: integer (nullable = true) // |-- name: string (nullable = true) // 将DataFrame注册为table people.registerTempTable("people") // 跑SQL语句吧! val teenagers = sqlContext.sql("SELECT name FROM people WHERE age >= 13 AND age <= 19") // 另一种方法是,用一个包含JSON字符串的RDD来创建DataFrame val anotherPeopleRDD = sc.parallelize( """{"name":"Yin","address":{"city":"Columbus","state":"Ohio"}}""" :: Nil) val anotherPeople = sqlContext.read.json(anotherPeopleRDD) Hive表 Spark SQL支持从Apache Hive读写数据。然而,Hive依赖项太多,所以没有把Hive包含在默认的Spark发布包里。要支持Hive,需要在编译spark的时候增加-Phive和-Phive-thriftserver标志。这样编译打包的时候将会把Hive也包含进来。注意,hive的jar包也必须出现在所有的worker节点上,访问Hive数据时候会用到(如:使用hive的序列化和反序列化SerDes时)。 Hive配置在conf/目录下hive-site.xml,core-site.xml(安全配置),hdfs-site.xml(HDFS配置)文件中。请注意,如果在YARN cluster(yarn-cluster mode)模式下执行一个查询的话,lib_mananged/jar/下面的datanucleus 的jar包,和conf/下的hive-site.xml必须在驱动器(driver)和所有执行器(executor)都可用。一种简便的方法是,通过spark-submit命令的–jars和–file选项来提交这些文件。 Scala Java Python R 如果使用Hive,则必须构建一个HiveContext,HiveContext是派生于SQLContext的,添加了在Hive Metastore里查询表的支持,以及对HiveQL的支持。用户没有现有的Hive部署,也可以创建一个HiveContext。如果没有在hive-site.xml里配置,那么HiveContext将会自动在当前目录下创建一个metastore_db目录,再根据HiveConf设置创建一个warehouse目录(默认/user/hive/warehourse)。所以请注意,你必须把/user/hive/warehouse的写权限赋予启动spark应用程序的用户。 // sc是一个已有的SparkContext对象 val sqlContext = new org.apache.spark.sql.hive.HiveContext(sc) sqlContext.sql("CREATE TABLE IF NOT EXISTS src (key INT, value STRING)") sqlContext.sql("LOAD DATA LOCAL INPATH 'examples/src/main/resources/kv1.txt' INTO TABLE src") // 这里用的是HiveQL sqlContext.sql("FROM src SELECT key, value").collect().foreach(println) 和不同版本的Hive Metastore交互 Spark SQL对Hive最重要的支持之一就是和Hive metastore进行交互,这使得Spark SQL可以访问Hive表的元数据。从Spark-1.4.0开始,Spark SQL有专门单独的二进制build版本,可以用来访问不同版本的Hive metastore,其配置表如下。注意,不管所访问的hive是什么版本,Spark SQL内部都是以Hive 1.2.1编译的,而且内部使用的Hive类也是基于这个版本(serdes,UDFs,UDAFs等) 以下选项可用来配置Hive版本以便访问其元数据: 属性名 默认值 含义 spark.sql.hive.metastore.version 1.2.1 Hive metastore版本,可选的值为0.12.0 到 1.2.1 spark.sql.hive.metastore.jars builtin 初始化HiveMetastoreClient的jar包。这个属性可以是以下三者之一: builtin 目前内建为使用Hive-1.2.1,编译的时候启用-Phive,则会和spark一起打包。如果没有-Phive,那么spark.sql.hive.metastore.version要么是1.2.1,要就是未定义 maven 使用maven仓库下载的jar包版本。这个选项建议不要再生产环境中使用 JVM格式的classpath。这个classpath必须包含所有Hive及其依赖的jar包,且包含正确版本的hadoop。这些jar包必须部署在driver节点上,如果你使用yarn-cluster模式,那么必须确保这些jar包也随你的应用程序一起打包 spark.sql.hive.metastore.sharedPrefixes com.mysql.jdbc, org.postgresql, com.microsoft.sqlserver, oracle.jdbc 一个逗号分隔的类名前缀列表,这些类使用classloader加载,且可以在Spark SQL和特定版本的Hive间共享。例如,用来访问hive metastore 的JDBC的driver就需要这种共享。其他需要共享的类,是与某些已经共享的类有交互的类。例如,自定义的log4j appender spark.sql.hive.metastore.barrierPrefixes (empty) 一个逗号分隔的类名前缀列表,这些类在每个Spark SQL所访问的Hive版本中都会被显式的reload。例如,某些在共享前缀列表(spark.sql.hive.metastore.sharedPrefixes)中声明为共享的Hive UD函数 用JDBC连接其他数据库 Spark SQL也可以用JDBC访问其他数据库。这一功能应该优先于使用JdbcRDD。因为它返回一个DataFrame,而DataFrame在Spark SQL中操作更简单,且更容易和来自其他数据源的数据进行交互关联。JDBC数据源在java和python中用起来也很简单,不需要用户提供额外的ClassTag。(注意,这与Spark SQL JDBC server不同,Spark SQLJDBC server允许其他应用执行Spark SQL查询) 首先,你需要在spark classpath中包含对应数据库的JDBC driver,下面这行包括了用于访问postgres的数据库driver SPARK_CLASSPATH=postgresql-9.3-1102-jdbc41.jar bin/spark-shell 远程数据库的表可以通过Data Sources API,用DataFrame或者SparkSQL 临时表来装载。以下是选项列表: 属性名 含义 url 需要连接的JDBC URL dbtable 需要读取的JDBC表。注意,任何可以填在SQL的where子句中的东西,都可以填在这里。(既可以填完整的表名,也可填括号括起来的子查询语句) driver JDBC driver的类名。这个类必须在master和worker节点上都可用,这样各个节点才能将driver注册到JDBC的子系统中。 partitionColumn, lowerBound, upperBound, numPartitions 这几个选项,如果指定其中一个,则必须全部指定。他们描述了多个worker如何并行的读入数据,并将表分区。partitionColumn必须是所查询的表中的一个数值字段。注意,lowerBound和upperBound只是用于决定分区跨度的,而不是过滤表中的行。因此,表中所有的行都会被分区然后返回。 fetchSize JDBC fetch size,决定每次获取多少行数据。在JDBC驱动上设成较小的值有利于性能优化(如,Oracle上设为10) Scala Java Python R Sql val jdbcDF = sqlContext.read.format("jdbc").options( Map("url" -> "jdbc:postgresql:dbserver", "dbtable" -> "schema.tablename")).load() 疑难解答 JDBC driver class必须在所有client session或者executor上,对java的原生classloader可见。这是因为Java的DriverManager在打开一个连接之前,会做安全检查,并忽略所有对原声classloader不可见的driver。最简单的一种方法,就是在所有worker节点上修改compute_classpath.sh,并包含你所需的driver jar包。 一些数据库,如H2,会把所有的名字转大写。对于这些数据库,在Spark SQL中必须也使用大写。 性能调整 对于有一定计算量的Spark作业来说,可能的性能改进的方式,不是把数据缓存在内存里,就是调整一些开销较大的选项参数。 内存缓存 Spark SQL可以通过调用SQLContext.cacheTable(“tableName”)或者DataFrame.cache()把tables以列存储格式缓存到内存中。随后,Spark SQL将会扫描必要的列,并自动调整压缩比例,以减少内存占用和GC压力。你也可以用SQLContext.uncacheTable(“tableName”)来删除内存中的table。 你还可以使用SQLContext.setConf 或在SQL语句中运行SET key=value命令,来配置内存中的缓存。 属性名 默认值 含义 spark.sql.inMemoryColumnarStorage.compressed true 如果设置为true,Spark SQL将会根据数据统计信息,自动为每一列选择单独的压缩编码方式。 spark.sql.inMemoryColumnarStorage.batchSize 10000 控制列式缓存批量的大小。增大批量大小可以提高内存利用率和压缩率,但同时也会带来OOM(Out Of Memory)的风险。 其他配置选项 以下选项同样也可以用来给查询任务调性能。不过这些选项在未来可能被放弃,因为spark将支持越来越多的自动优化。 属性名 默认值 含义 spark.sql.autoBroadcastJoinThreshold 10485760 (10 MB) 配置join操作时,能够作为广播变量的最大table的大小。设置为-1,表示禁用广播。注意,目前的元数据统计仅支持Hive metastore中的表,并且需要运行这个命令:ANALYSE TABLE <tableName> COMPUTE STATISTICS noscan spark.sql.tungsten.enabled true 设为true,则启用优化的Tungsten物理执行后端。Tungsten会显式的管理内存,并动态生成表达式求值的字节码 spark.sql.shuffle.partitions 200 配置数据混洗(shuffle)时(join或者聚合操作),使用的分区数。 分布式SQL引擎 Spark SQL可以作为JDBC/ODBC或者命令行工具的分布式查询引擎。在这种模式下,终端用户或应用程序,无需写任何代码,就可以直接在Spark SQL中运行SQL查询。 运行Thrift JDBC/ODBC server 这里实现的Thrift JDBC/ODBC server和Hive-1.2.1中的HiveServer2是相同的。你可以使用beeline脚本来测试Spark或者Hive-1.2.1的JDBC server。 在Spark目录下运行下面这个命令,启动一个JDBC/ODBC server ./sbin/start-thriftserver.sh 这个脚本能接受所有 bin/spark-submit 命令支持的选项参数,外加一个 –hiveconf 选项,来指定Hive属性。运行./sbin/start-thriftserver.sh –help可以查看完整的选项列表。默认情况下,启动的server将会在localhost:10000端口上监听。要改变监听主机名或端口,可以用以下环境变量: export HIVE_SERVER2_THRIFT_PORT=<listening-port> export HIVE_SERVER2_THRIFT_BIND_HOST=<listening-host> ./sbin/start-thriftserver.sh \ --master <master-uri> \ ... 或者Hive系统属性 来指定 ./sbin/start-thriftserver.sh \ --hiveconf hive.server2.thrift.port=<listening-port> \ --hiveconf hive.server2.thrift.bind.host=<listening-host> \ --master <master-uri> ... 接下来,你就可以开始在beeline中测试这个Thrift JDBC/ODBC server: ./bin/beeline 下面的指令,可以连接到一个JDBC/ODBC server beeline> !connect jdbc:hive2://localhost:10000 可能需要输入用户名和密码。在非安全模式下,只要输入你本机的用户名和一个空密码即可。对于安全模式,请参考beeline documentation. Hive的配置是在conf/目录下的hive-site.xml,core-site.xml,hdfs-site.xml中指定的。 你也可以在beeline的脚本中指定。 Thrift JDBC server也支持通过HTTP传输Thrift RPC消息。以下配置(在conf/hive-site.xml中)将启用HTTP模式: hive.server2.transport.mode - Set this to value: http hive.server2.thrift.http.port - HTTP port number fo listen on; default is 10001 hive.server2.http.endpoint - HTTP endpoint; default is cliservice 同样,在beeline中也可以用HTTP模式连接JDBC/ODBC server: beeline> !connect jdbc:hive2://<host>:<port>/<database>?hive.server2.transport.mode=http;hive.server2.thrift.http.path=<http_endpoint> 转载自 并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark SQL, DataFrames 以及 Datasets 编程指南(一)

Spark SQL, DataFrames 以及 Datasets 编程指南 概要 Spark SQL是Spark中处理结构化数据的模块。与基础的Spark RDD API不同,Spark SQL的接口提供了更多关于数据的结构信息和计算任务的运行时信息。在Spark内部,Spark SQL会能够用于做优化的信息比RDD API更多一些。Spark SQL如今有了三种不同的API:SQL语句、DataFrame API和最新的Dataset API。不过真正运行计算的时候,无论你使用哪种API或语言,Spark SQL使用的执行引擎都是同一个。这种底层的统一,使开发者可以在不同的API之间来回切换,你可以选择一种最自然的方式,来表达你的需求。 本文中所有的示例都使用Spark发布版本中自带的示例数据,并且可以在spark-shell、pyspark shell以及sparkR shell中运行。 SQL Spark SQL的一种用法是直接执行SQL查询语句,你可使用最基本的SQL语法,也可以选择HiveQL语法。Spark SQL可以从已有的Hive中读取数据。更详细的请参考Hive Tables这一节。如果用其他编程语言运行SQL,Spark SQL将以DataFrame返回结果。你还可以通过命令行command-line或者JDBC/ODBC使用Spark SQL。 DataFrames DataFrame是一种分布式数据集合,每一条数据都由几个命名字段组成。概念上来说,她和关系型数据库的表 或者 R和Python中的data frame等价,只不过在底层,DataFrame采用了更多优化。DataFrame可以从很多数据源(sources)加载数据并构造得到,如:结构化数据文件,Hive中的表,外部数据库,或者已有的RDD。 DataFrame API支持Scala,Java,Python, andR。 Datasets Dataset是Spark-1.6新增的一种API,目前还是实验性的。Dataset想要把RDD的优势(强类型,可以使用lambda表达式函数)和Spark SQL的优化执行引擎的优势结合到一起。Dataset可以由JVM对象构建(constructed)得到,而后Dataset上可以使用各种transformation算子(map,flatMap,filter 等)。 Dataset API 对Scala和Java的支持接口是一致的,但目前还不支持Python,不过Python自身就有语言动态特性优势(例如,你可以使用字段名来访问数据,row.columnName)。对Python的完整支持在未来的版本会增加进来。 入门 入口:SQLContext Scala Java Python R Spark SQL所有的功能入口都是SQLContext类,及其子类。不过要创建一个SQLContext对象,首先需要有一个SparkContext对象。 val sc: SparkContext // 假设已经有一个 SparkContext 对象 val sqlContext = new org.apache.spark.sql.SQLContext(sc) // 用于包含RDD到DataFrame隐式转换操作 import sqlContext.implicits._ 除了SQLContext之外,你也可以创建HiveContext,HiveContext是SQLContext 的超集。 除了SQLContext的功能之外,HiveContext还提供了完整的HiveQL语法,UDF使用,以及对Hive表中数据的访问。要使用HiveContext,你并不需要安装Hive,而且SQLContext能用的数据源,HiveContext也一样能用。HiveContext是单独打包的,从而避免了在默认的Spark发布版本中包含所有的Hive依赖。如果这些依赖对你来说不是问题(不会造成依赖冲突等),建议你在Spark-1.3之前使用HiveContext。而后续的Spark版本,将会逐渐把SQLContext升级到和HiveContext功能差不多的状态。 spark.sql.dialect选项可以指定不同的SQL变种(或者叫SQL方言)。这个参数可以在SparkContext.setConf里指定,也可以通过 SQL语句的SET key=value命令指定。对于SQLContext,该配置目前唯一的可选值就是”sql”,这个变种使用一个Spark SQL自带的简易SQL解析器。而对于HiveContext,spark.sql.dialect默认值为”hiveql”,当然你也可以将其值设回”sql”。仅就目前而言,HiveSQL解析器支持更加完整的SQL语法,所以大部分情况下,推荐使用HiveContext。 创建DataFrame Spark应用可以用SparkContext创建DataFrame,所需的数据来源可以是已有的RDD(existingRDD),或者Hive表,或者其他数据源(data sources.) 以下是一个从JSON文件创建DataFrame的小栗子: Scala Java Python R val sc: SparkContext // 已有的 SparkContext. val sqlContext = new org.apache.spark.sql.SQLContext(sc) val df = sqlContext.read.json("examples/src/main/resources/people.json") // 将DataFrame内容打印到stdout df.show() DataFrame操作 DataFrame提供了结构化数据的领域专用语言支持,包括Scala,Java,PythonandR. 这里我们给出一个结构化数据处理的基本示例: Scala Java Python R val sc: SparkContext // 已有的 SparkContext. val sqlContext = new org.apache.spark.sql.SQLContext(sc) // 创建一个 DataFrame val df = sqlContext.read.json("examples/src/main/resources/people.json") // 展示 DataFrame 的内容 df.show() // age name // null Michael // 30 Andy // 19 Justin // 打印数据树形结构 df.printSchema() // root // |-- age: long (nullable = true) // |-- name: string (nullable = true) // select "name" 字段 df.select("name").show() // name // Michael // Andy // Justin // 展示所有人,但所有人的 age 都加1 df.select(df("name"), df("age") + 1).show() // name (age + 1) // Michael null // Andy 31 // Justin 20 // 筛选出年龄大于21的人 df.filter(df("age") > 21).show() // age name // 30 Andy // 计算各个年龄的人数 df.groupBy("age").count().show() // age count // null 1 // 19 1 // 30 1 DataFrame的完整API列表请参考这里:API Documentation 除了简单的字段引用和表达式支持之外,DataFrame还提供了丰富的工具函数库,包括字符串组装,日期处理,常见的数学函数等。完整列表见这里:DataFrame Function Reference. 编程方式执行SQL查询 SQLContext.sql可以执行一个SQL查询,并返回DataFrame结果。 Scala Java Python R val sqlContext = ... // 已有一个 SQLContext 对象 val df = sqlContext.sql("SELECT * FROM table") 创建Dataset Dataset API和RDD类似,不过Dataset不使用Java序列化或者Kryo,而是使用专用的编码器(Encoder)来序列化对象和跨网络传输通信。如果这个编码器和标准序列化都能把对象转字节,那么编码器就可以根据代码动态生成,并使用一种特殊数据格式,这种格式下的对象不需要反序列化回来,就能允许Spark进行操作,如过滤、排序、哈希等。 Scala Java // 对普通类型数据的Encoder是由 importing sqlContext.implicits._ 自动提供的 val ds = Seq(1, 2, 3).toDS() ds.map(_ + 1).collect() // 返回: Array(2, 3, 4) // 以下这行不仅定义了case class,同时也自动为其创建了Encoder case class Person(name: String, age: Long) val ds = Seq(Person("Andy", 32)).toDS() // DataFrame 只需提供一个和数据schema对应的class即可转换为 Dataset。Spark会根据字段名进行映射。 val path = "examples/src/main/resources/people.json" val people = sqlContext.read.json(path).as[Person] 和RDD互操作 Spark SQL有两种方法将RDD转为DataFrame。 1. 使用反射机制,推导包含指定类型对象RDD的schema。这种基于反射机制的方法使代码更简洁,而且如果你事先知道数据schema,推荐使用这种方式; 2. 编程方式构建一个schema,然后应用到指定RDD上。这种方式更啰嗦,但如果你事先不知道数据有哪些字段,或者数据schema是运行时读取进来的,那么你很可能需要用这种方式。 利用反射推导schema Scala Java Python Spark SQL的Scala接口支持自动将包含case class对象的RDD转为DataFrame。对应的case class定义了表的schema。case class的参数名通过反射,映射为表的字段名。case class还可以嵌套一些复杂类型,如Seq和Array。RDD隐式转换成DataFrame后,可以进一步注册成表。随后,你就可以对表中数据使用SQL语句查询了。 // sc 是已有的 SparkContext 对象 val sqlContext = new org.apache.spark.sql.SQLContext(sc) // 为了支持RDD到DataFrame的隐式转换 import sqlContext.implicits._ // 定义一个case class. // 注意:Scala 2.10的case class最多支持22个字段,要绕过这一限制, // 你可以使用自定义class,并实现Product接口。当然,你也可以改用编程方式定义schema case class Person(name: String, age: Int) // 创建一个包含Person对象的RDD,并将其注册成table val people = sc.textFile("examples/src/main/resources/people.txt").map(_.split(",")).map(p => Person(p(0), p(1).trim.toInt)).toDF() people.registerTempTable("people") // sqlContext.sql方法可以直接执行SQL语句 val teenagers = sqlContext.sql("SELECT name, age FROM people WHERE age >= 13 AND age <= 19") // SQL查询的返回结果是一个DataFrame,且能够支持所有常见的RDD算子 // 查询结果中每行的字段可以按字段索引访问: teenagers.map(t => "Name: " + t(0)).collect().foreach(println) // 或者按字段名访问: teenagers.map(t => "Name: " + t.getAs[String]("name")).collect().foreach(println) // row.getValuesMap[T] 会一次性返回多列,并以Map[String, T]为返回结果类型 teenagers.map(_.getValuesMap[Any](List("name", "age"))).collect().foreach(println) // 返回结果: Map("name" -> "Justin", "age" -> 19) 转载自 并发编程网 - ifeve.com

优秀的个人博客,低调大师

一款超级好用的文档编辑器-ATOM

最近,社区的 聚能聊 栏目出了一个讨论的题目,名字是聊一聊你的编辑器。我就想在这里和大家讨论一款我最喜欢的编辑器,他的名字叫做ATOM。 Atom由github开发,支持node.js编写的插件。我喜欢他的原因是因为ATOM是一款超级好用的开源软件。怎么好用呢,我给大家列出以下几点。 1.ATOM支持超级多的插件,无论你是前端开发,还是书写嵌入式代码,甚至是写小说。总有一款插件适合你。2.ATOM的界面非常漂亮,在ATOM上写代码是一件非常有逼格的事情 3.如果将ATOM放到技术热度曲线上,ATOM无疑是编辑器中排名前列的。 习惯试用linux系统,我这就把linux下ATOM的安装方法给大家说一下: 官网下载DEB包,DPKG解包。安装成功。 我的邮箱是iotbixiaojie@163.com。是一个物联网开发者,喜欢前端,人工智能和嵌入式开发。如果你有需要回答的问题可以E-mail给我,我们一起解决这个问题。

优秀的个人博客,低调大师

[Hadoop]Sqoop 1.4.2中文文档(一)之数据导入

一、Sqoop Help $ sqoop help usage: sqoop COMMAND [ARGS] Available commands: codegen Generate code to interact with database records create-hive-table Import a table definition into Hive eval Evaluate a SQL statement and display the results export Export an HDFS directory to a database table help List available commands import Import a table from a database to HDFS import-all-tables Import tables from a database to HDFS list-databases List available databases on a server list-tables List available tables in a database version Display version information See 'sqoop help COMMAND' for information on a specific command. 你可以使用sqoop help (tool-name)也可以使用sqoop (tool-name)--help来使用帮助。例如: sqoop help import. sqoop import --help.二、Sqoop的别名例如:sqoop import --help 等同于 sqoop-import --help,即sqoop-import是sqoop import的别名。三、sqoop-import$ sqoop help import usage: sqoop import [GENERIC-ARGS] [TOOL-ARGS] Common arguments: --connect <jdbc-uri> Specify JDBC connect string --connect-manager <jdbc-uri> Specify connection manager class to use --driver <class-name> Manually specify JDBC driver class to use --hadoop-home <dir> Override $HADOOP_HOME --help Print usage instructions -P Read password from console --password <password> Set authentication password --username <username> Set authentication username --verbose Print more information while working [...] Generic Hadoop command-line arguments: (must preceed any tool-specific arguments) Generic options supported are -conf <configuration file> specify an application configuration file -D <property=value> use value for given property -fs <local|namenode:port> specify a namenode -jt <local|jobtracker:port> specify a job tracker -files <comma separated list of files> specify comma separated files to be copied to the map reduce cluster -libjars <comma separated list of jars> specify comma separated jar files to include in the classpath. -archives <comma separated list of archives> specify comma separated archives to be unarchived on the compute machines. The general command line syntax is bin/hadoop command [genericOptions] [commandOptions] 其中Generic option的设置要在Common arguments之前,-conf,-fs,-jt-,-D都是对hadoop服务进行设置的,例如 -D mapred.job.name=<job_name>能够制定job的名字,如果不指定的话Job的名字将以用到的Jar包作为Job的名字。 例如: User: hdfs Job Name: cn_opda_a_phonoalbumshoushou_json_120901.jar Job File: hdfs://vm-nba01.in.dx:9000/home/hdfs/tmp/mapred/staging/hdfs/.staging/job_201210171559_0391/job.xml Submit Host: vm-nba01.in.dx Submit Host Address: 10.18.102.101 Job-ACLs: All users are allowed Job Setup: Successful Status: Succeeded Started at: Tue Oct 23 15:18:41 CST 2012 Finished at: Tue Oct 23 15:23:20 CST 2012 Finished in: 4mins, 39sec Job Cleanup: Successful 而files、libjars 、archives 选项则不具有代表性质,因为这些选项在Hadoop内部命令中已经被支持了,可以查看hadoop job的帮助。 [work@vm-nba01 ~]$ hadoop job Usage: JobClient <command> <args> [-submit <job-file>] [-status <job-id>] [-counter <job-id> <group-name> <counter-name>] [-kill <job-id>] [-set-priority <job-id> <priority>]. Valid values for priorities are: VERY_HIGH HIGH NORMAL LOW VERY_LOW [-events <job-id> <from-event-#> <#-of-events>] [-history <jobOutputDir>] [-list [all]] [-list-active-trackers] [-list-blacklisted-trackers] [-list-attempt-ids <job-id> <task-type> <task-state>] [-kill-task <task-id>] [-fail-task <task-id>] Generic options supported are -conf <configuration file> specify an application configuration file -D <property=value> use value for given property -fs <local|namenode:port> specify a namenode -jt <local|jobtracker:port> specify a job tracker -files <comma separated list of files> specify comma separated files to be copied to the map reduce cluster -libjars <comma separated list of jars> specify comma separated jar files to include in the classpath. -archives <comma separated list of archives> specify comma separated archives to be unarchived on the compute machines. 四、sqoop脚本 举例: $ sqoop import --connect jdbc:mysql://localhost/db --username foo --table TEST 下面把这些选项参数做成脚本进行传递:(import.txt) $ sqoop --options-file /users/homer/work/import.txt --table TEST 那么import.txt中的参数要按照行来进行分隔,内容如下: # # Options file for Sqoop import # # Specifies the tool being invoked import # Connect parameter and value --connect jdbc:mysql://localhost/db # Username parameter and value --username foo # # Remaining options should be specified in the command line. # 举个sqoop连接数据库,将数据库内的数据导入到HDFS中的例子: sqoop import --connect jdbc:mysql://database.example.com/employees \ --username aaron --password 12345 这样连接例子需要把mysql driver的jar包放到你的环境Path中,否则请这样使用: $ sqoop import --driver com.microsoft.jdbc.sqlserver.SQLServerDriver \ --connect <connect-string> ... sqoop-import控制参数: usage: sqoop import [GENERIC-ARGS] [TOOL-ARGS] Common arguments: --connect <jdbc-uri> Specify JDBC connect string --connection-manager <class-name> Specify connection manager class name --connection-param-file <properties-file> Specify connection parameters file --driver <class-name> Manually specify JDBC driver class to use --hadoop-home <dir> Override $HADOOP_HOME --help Print usage instructions -P Read password from console --password <password> Set authentication password --username <username> Set authentication username --verbose Print more information while working Import control arguments: --append Imports data in append mode --as-avrodatafile Imports data to Avro data files --as-sequencefile Imports data to SequenceFiles --as-textfile Imports data as plain text (default) --boundary-query <statement> Set boundary query for retrieving max and min value of the primary key --columns <col,col,col...> Columns to import from table --compression-codec <codec> Compression codec to use for import --direct Use direct import fast path --direct-split-size <n> Split the input stream every 'n' bytes when importing in direct mode -e,--query <statement> Import results of SQL 'statement' --fetch-size <n> Set number 'n' of rows to fetch from the database when more rows are needed --inline-lob-limit <n> Set the maximum size for an inline LOB -m,--num-mappers <n> Use 'n' map tasks to import in parallel --split-by <column-name> Column of the table used to split work units --table <table-name> Table to read --target-dir <dir> HDFS plain table destination --warehouse-dir <dir> HDFS parent for table destination --where <where clause> WHERE clause to use during import -z,--compress Enable compression Incremental import arguments: --check-column <column> Source column to check for incremental change --incremental <import-type> Define an incremental import of type 'append' or 'lastmodified' --last-value <value> Last imported value in the incremental check column Output line formatting arguments: --enclosed-by <char> Sets a required field enclosing character --escaped-by <char> Sets the escape character --fields-terminated-by <char> Sets the field separator character --lines-terminated-by <char> Sets the end-of-line character --mysql-delimiters Uses MySQL's default delimiter set: fields: , lines: \n escaped-by: \ optionally-enclosed-by: ' --optionally-enclosed-by <char> Sets a field enclosing character Input parsing arguments: --input-enclosed-by <char> Sets a required field encloser --input-escaped-by <char> Sets the input escape character --input-fields-terminated-by <char> Sets the input field separator --input-lines-terminated-by <char> Sets the input end-of-line char --input-optionally-enclosed-by <char> Sets a field enclosing character Hive arguments: --create-hive-table Fail if the target hive table exists --hive-delims-replacement <arg> Replace Hive record \0x01 and row delimiters (\n\r) from imported string fields with user-defined string --hive-drop-import-delims Drop Hive record \0x01 and row delimiters (\n\r) from imported string fields --hive-home <dir> Override $HIVE_HOME --hive-import Import tables into Hive (Uses Hive's default delimiters if none are set.) --hive-overwrite Overwrite existing data in the Hive table --hive-partition-key <partition-key> Sets the partition key to use when importing to hive --hive-partition-value <partition-value> Sets the partition value to use when importing to hive --hive-table <table-name> Sets the table name to use when importing to hive --map-column-hive <arg> Override mapping for specific column to hive types. HBase arguments: --column-family <family> Sets the target column family for the import --hbase-create-table If specified, create missing HBase tables --hbase-row-key <col> Specifies which input column to use as the row key --hbase-table <table> Import to <table> in HBase Code generation arguments: --bindir <dir> Output directory for compiled objects --class-name <name> Sets the generated class name. This overrides --package-name. When combined with --jar-file, sets the input class. --input-null-non-string <null-str> Input null non-string representation --input-null-string <null-str> Input null string representation --jar-file <file> Disable code generation; use specified jar --map-column-java <arg> Override mapping for specific columns to java types --null-non-string <null-str> Null non-string representation --null-string <null-str> Null string representation --outdir <dir> Output directory for generated code --package-name <name> Put auto-generated classes in this package Generic Hadoop command-line arguments: (must preceed any tool-specific arguments) Generic options supported are -conf <configuration file> specify an application configuration file -D <property=value> use value for given property -fs <local|namenode:port> specify a namenode -jt <local|jobtracker:port> specify a job tracker -files <comma separated list of files> specify comma separated files to be copied to the map reduce cluster -libjars <comma separated list of jars> specify comma separated jar files to include in the classpath. -archives <comma separated list of archives> specify comma separated archives to be unarchived on the compute machines. The general command line syntax is bin/hadoop command [genericOptions] [commandOptions] 五、利用查询结果作为sqoop的导入内容 举例:其中split-by是导入后的数据按照a.id进行分割,--target-dir目标地址,查询后的结果将放入这个文件 $ sqoop import \ --query 'SELECT a.*, b.* FROM a JOIN b on (a.id == b.id) WHERE $CONDITIONS' \ --split-by a.id --target-dir /user/foo/joinresults 举例:m代表只查询一次并且边查询边导入 $ sqoop import \ --query 'SELECT a.*, b.* FROM a JOIN b on (a.id == b.id) WHERE $CONDITIONS' \ -m 1 --target-dir /user/foo/joinresults 导入时候可以控制分割文件大小,或者字符串转义例如:--direct-split-size 以及--warehouse-dir ,--default-character-set 例如: $ sqoop import --connect jdbc:mysql://server.foo.com/db --table bar \ --direct -- --default-character-set=latin1 $ sqoop import --connnect <connect-str> --table foo --warehouse-dir /shared \ ... sqoop对java以及hive提供支持,所以你可以导入key/value这样的map数据,例如: Argument Description --map-column-java <mapping> Override mapping from SQL to Java type for configured columns. --map-column-hive <mapping> Override mapping from SQL to Hive type for configured columns. $ sqoop import ... --map-column-java id=String,value=Integer 六、sqoop的增量导入 Argument Description --check-column (col) Specifies the column to be examined when determining which rows to import. --incremental (mode) Specifies how Sqoop determines which rows are new. Legal values for mode include append and lastmodified. --last-value (value) Specifies the maximum value of the check column from the previous import. 通过增量导入你可以只导入一个已经存在表的增列值,或者表后面的值。增量导入需要给定必要的参数,详情一个增量导入的例子。当然你也可以指定导入到Hive后的文件格式:有2种1.--as-textfile这个参数你可以查看到hive内的原数据就是文本文件模式没有压缩2.-z or --compress or --compression-codec这个参数有3种写法不过导入到hive内的数据就是压缩过的了七、sqoop的Hive与Hbase的数据导入前六点都能看完后,Hive与Hbase的导入也就很简单了,其实就是多了一步导入的数据放在哪里而已。Hive举例: sqoop import --verbose --connect jdbc:mysql://10.18.102.133/tjss_opda --username tongji --password dx_tj --table opda_start_120604 --hive-import --hive-table opda_start_120604_incr --hive-overwrite --direct sqoop job --create opda_start_120604 -- import --connect jdbc:mysql://10.18.102.133/tjss_opda --username tongji --password dx_tj --table opda_start_120604 --hive-import --hive-table opda_start_120604_incr --check-column id --incremental append --last-value 0 -m 8 --hive-overwrite --hive-delims-replacement="\t" 注意事项: 1.注意Sqoop是在Hadoop上跑的,所以jdbc url不要写localhost,--direct的要求同理。 2.Sqoop也有metastore,目前看来,没有启动metastore service时其不是线程安全的。另外就是它只能使用hsqldb,暂不支持其他数据库,对hsqldb可靠性没有太高信心。 3.Metastore里password是明文存储的,所以它不建议存储password。 4.Sqoop有bug,目前数据库里有特殊表名时有问题。 5.Sqoop导入到hive里的表只能是TEXTFILE,不过可以选择压缩格式 6.Sqoop可以导入到一个已经存在的空hive表,但是是使用Load data导入数据,所以目标表的schema实际上是被无视了。 7.Sqoop导入hive若不加hive-overwirte,会留下hadoop目录,对下次若执行相同任务有影响。 8.注意加入delims-replace,否则很容易因为分隔符问题出现错误行。 9.Hive进行dynamic partition时,一次partition数量过多有Bug,必须加distribute by 10.Hive对大小写不区分,尽量全小写,否则有潜在bug 11.Sqoop要求运行时当前目录可写(code-gen)。 12.只要有jdbc驱动,所有jdbc兼容的数据库均可导入 导入时除了用到sqoop相关的hive与Hbase的参数外,还会用到导入时候专用的参数: Input parsing arguments: --input-enclosed-by <char> Sets a required field encloser --input-escaped-by <char> Sets the input escape character --input-fields-terminated-by <char> Sets the input field separator --input-lines-terminated-by <char> Sets the input end-of-line char --input-optionally-enclosed-by <char> Sets a field enclosing character 这个部分的参数有可能你会用到的。另外如果导入语句没有添加目的表或者地址则导入的内容会写在HDFS当前的操作目录下。 八、sqoop导入全部表和数据 举个例子,其他参数均与sqoop help参数相同: $ sqoop import-all-tables --connect jdbc:mysql://db.foo.com/corp 验证结果: $ hadoop fs -ls Found 4 items drwxr-xr-x - someuser somegrp 0 2010-04-27 17:15 /user/someuser/EMPLOYEES drwxr-xr-x - someuser somegrp 0 2010-04-27 17:15 /user/someuser/PAYCHECKS drwxr-xr-x - someuser somegrp 0 2010-04-27 17:15 /user/someuser/DEPARTMENTS drwxr-xr-x - someuser somegrp 0 2010-04-27 17:15 /user/someuser/OFFICE_SUPPLIES

优秀的个人博客,低调大师

[Hadoop]Sqoop 1.4.2中文文档(二)之数据导出

一、sqoop-export 相关参数: usage: sqoop export [GENERIC-ARGS] [TOOL-ARGS] Common arguments: --connect <jdbc-uri> Specify JDBC connect string --connection-manager <class-name> Specify connection manager class name --connection-param-file <properties-file> Specify connection parameters file --driver <class-name> Manually specify JDBC driver class to use --hadoop-home <dir> Override $HADOOP_HOME --help Print usage instructions -P Read password from console --password <password> Set authentication password --username <username> Set authentication username --verbose Print more information while working Export control arguments: --batch Indicates underlying statements to be executed in batch mode --clear-staging-table Indicates that any data in staging table can be deleted --direct Use direct export fast path --export-dir <dir> HDFS source path for the export -m,--num-mappers <n> Use 'n' map tasks to export in parallel --staging-table <table-name> Intermediate staging table --table <table-name> Table to populate --update-key <key> Update records by specified key column --update-mode <mode> Specifies how updates are performed when new rows are found with non-matching keys in database Input parsing arguments: --input-enclosed-by <char> Sets a required field encloser --input-escaped-by <char> Sets the input escape character --input-fields-terminated-by <char> Sets the input field separator --input-lines-terminated-by <char> Sets the input end-of-line char --input-optionally-enclosed-by <char> Sets a field enclosing character Output line formatting arguments: --enclosed-by <char> Sets a required field enclosing character --escaped-by <char> Sets the escape character --fields-terminated-by <char> Sets the field separator character --lines-terminated-by <char> Sets the end-of-line character --mysql-delimiters Uses MySQL's default delimiter set: fields: , lines: \n escaped-by: \ optionally-enclosed-by: ' --optionally-enclosed-by <char> Sets a field enclosing character Code generation arguments: --bindir <dir> Output directory for compiled objects --class-name <name> Sets the generated class name. This overrides --package-name. When combined with --jar-file, sets the input class. --input-null-non-string <null-str> Input null non-string representation --input-null-string <null-str> Input null string representation --jar-file <file> Disable code generation; use specified jar --map-column-java <arg> Override mapping for specific columns to java types --null-non-string <null-str> Null non-string representation --null-string <null-str> Null string representation --outdir <dir> Output directory for generated code --package-name <name> Put auto-generated classes in this package Generic Hadoop command-line arguments: (must preceed any tool-specific arguments) Generic options supported are -conf <configuration file> specify an application configuration file -D <property=value> use value for given property -fs <local|namenode:port> specify a namenode -jt <local|jobtracker:port> specify a job tracker -files <comma separated list of files> specify comma separated files to be copied to the map reduce cluster -libjars <comma separated list of jars> specify comma separated jar files to include in the classpath. -archives <comma separated list of archives> specify comma separated archives to be unarchived on the compute machines. 从这里我们可以看到,大部分的参数使用是与导入相同的,只有少部分是导出专用的。既然导入和导出的道理都是相同的,那么我就不按照自己的理解把官网上的话变成自己的话了。直接看一个例子:(这里如果你不懂,请把数据导入完整看完) $ sqoop export --connect jdbc:mysql://db.example.com/foo --table bar \ --export-dir /results/bar_data

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册