首页 文章 精选 留言 我的

精选列表

搜索[分享平台],共10003篇文章
优秀的个人博客,低调大师

阿里内部资料分享

此套图册将呈现阿里技术全景,希望你会喜欢。 《阿里技术参考图册》(算法篇)下载链接:http://t.cn/RmRcqdv 《阿里技术参考图册》(研发篇)下载链接:http://t.cn/RmRcqdP 值得珍藏的技术干货合集,已经为你打包好了,希望你会喜欢~ 《2017阿里技术年度精选集上》下载链接: http://t.cn/REn5Nps 《2017阿里技术年度精选集下》下载链接: http://t.cn/REn5N0Q 温馨提醒: 1、每册300页+,约30M,需一定下载时间,还请耐心耐心耐心等待2、若导入较慢,请将地址复制到PC浏览器后下载

优秀的个人博客,低调大师

Spark使用总结与分享

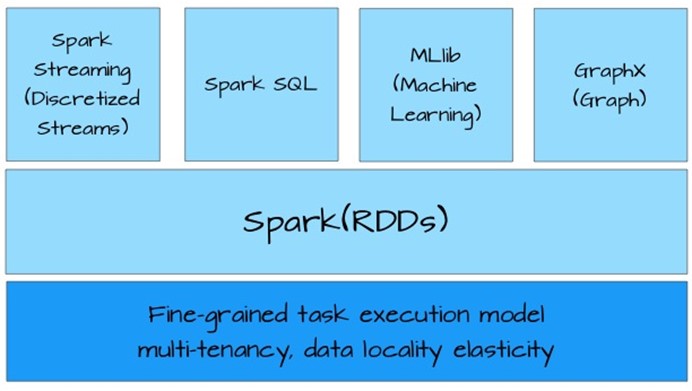
背景 使用spark开发已有几个月。相比于python/hive,scala/spark学习门槛较高。尤其记得刚开时,举步维艰,进展十分缓慢。不过谢天谢地,这段苦涩(bi)的日子过去了。忆苦思甜,为了避免项目组的其他同学走弯路,决定总结和梳理spark的使用经验。 Spark基础 基石RDD spark的核心是RDD(弹性分布式数据集),一种通用的数据抽象,封装了基础的数据操作,如map,filter,reduce等。RDD提供数据共享的抽象,相比其他大数据处理框架,如MapReduce,Pegel,DryadLINQ和HIVE等均缺乏此特性,所以RDD更为通用。 简要地概括RDD:RDD是一个不可修改的,分布的对象集合。每个RDD由多个分区组成,每个分区可以同时在集群中的不同节点上计算。RDD可以包含Python,Java和Scala中的任意对象。 Spark生态圈中应用都是基于RDD构建(下图),这一点充分说明RDD的抽象足够通用,可以描述大多数应用场景。 RDD操作类型—转换和动作 RDD的操作主要分两类:转换(transformation)和动作(action)。两类函数的主要区别是,转换接受RDD并返回RDD,而动作接受RDD但是返回非RDD。转换采用惰性调用机制,每个RDD记录父RDD转换的方法,这种调用链表称之为血缘(lineage);而动作调用会直接计算。 采用惰性调用,通过血缘连接的RDD操作可以管道化(pipeline),管道化的操作可以直接在单节点完成,避免多次转换操作之间数据同步的等待。 使用血缘串联的操作可以保持每次计算相对简单,而不用担心有过多的中间数据,因为这些血缘操作都管道化了,这样也保证了逻辑的单一性,而不用像MapReduce那样,为了竟可能的减少map reduce过程,在单个map reduce中写入过多复杂的逻辑。 RDD使用模式 RDD使用具有一般的模式,可以抽象为下面的几步 加载外部数据,创建RDD对象 使用转换(如filter),创建新的RDD对象 缓存需要重用的RDD 使用动作(如count),启动并行计算 RDD高效的策略 Spark官方提供的数据是RDD在某些场景下,计算效率是Hadoop的20X。这个数据是否有水分,我们先不追究,但是RDD效率高的由一定机制保证的: RDD数据只读,不可修改。如果需要修改数据,必须从父RDD转换(transformation)到子RDD。所以,在容错策略中,RDD没有数据冗余,而是通过RDD父子依赖(血缘)关系进行重算实现容错。 RDD数据在内存中,多个RDD操作之间,数据不用落地到磁盘上,避免不必要的I/O操作。 RDD存放的数据可以是java对象,所以避免的不必要的对象序列化和反序列化。 总而言之,RDD高效的主要因素是尽量避免不必要的操作和牺牲数据的操作精度,用来提高计算效率。 Spark使用技巧 RDD基本函数扩展 RDD虽然提供了很多函数,但是毕竟还是有限的,有时候需要扩展,自定义新的RDD的函数。在spark中,可以通过隐式转换,轻松实现对RDD扩展。画像开发过程中,平凡的会使用rollup操作(类似HIVE中的rollup),计算多个级别的聚合数据。下面是具体实, /** * 扩展spark rdd,为rdd提供rollup方法 */ implicit class RollupRDD[T: ClassTag](rdd: RDD[(Array[String], T)]) extends Serializable { /** * 类似Sql中的rollup操作 * * @param aggregate 聚合函数 * @param keyPlaceHold key占位符,默认采用FaceConf.STAT_SUMMARY * @param isCache,确认是否缓存数据 * @return 返回聚合后的数据 */ def rollup[U: ClassTag]( aggregate: Iterable[T] => U, keyPlaceHold: String = FaceConf.STAT_SUMMARY, isCache: Boolean = true): RDD[(Array[String], U)] = { if (rdd.take(1).isEmpty) { return rdd.map(x => (Array[String](), aggregate(Array[T](x._2)))) } if (isCache) { rdd.cache // 提高计算效率 } val totalKeyCount = rdd.first._1.size val result = { 1 to totalKeyCount }.par.map(untilKeyIndex => { // 并行计算 rdd.map(row => { val combineKey = row._1.slice(0, untilKeyIndex).mkString(FaceConf.KEY_SEP) // 组合key (combineKey, row._2) }).groupByKey.map(row => { // 聚合计算 val oldKeyList = row._1.split(FaceConf.KEY_SEP) val newKeyList = oldKeyList ++ Array.fill(totalKeyCount - oldKeyList.size) { keyPlaceHold } (newKeyList, aggregate(row._2)) }) }).reduce(_ ++ _) // 聚合结果 result } } 上面代码声明了一个隐式类,具有一个成员变量rdd,类型是RDD[(Array[String], T)],那么如果应用代码中出现了任何这样的rdd对象,并且import当前的隐式转换,那么编译器就会将这个rdd当做上面的隐式类的对象,也就可以使用rollup函数,和一般的map,filter方法一样。 RDD操作闭包外部变量原则 RDD相关操作都需要传入自定义闭包函数(closure),如果这个函数需要访问外部变量,那么需要遵循一定的规则,否则会抛出运行时异常。闭包函数传入到节点时,需要经过下面的步骤: 驱动程序,通过反射,运行时找到闭包访问的所有变量,并封成一个对象,然后序列化该对象 将序列化后的对象通过网络传输到worker节点 worker节点反序列化闭包对象 worker节点执行闭包函数, 注意:外部变量在闭包内的修改不会被反馈到驱动程序。 简而言之,就是通过网络,传递函数,然后执行。所以,被传递的变量必须可以序列化,否则传递失败。本地执行时,仍然会执行上面四步。 广播机制也可以做到这一点,但是频繁的使用广播会使代码不够简洁,而且广播设计的初衷是将较大数据缓存到节点上,避免多次数据传输,提高计算效率,而不是用于进行外部变量访问。 RDD数据同步 RDD目前提供两个数据同步的方法:广播和累计器。 广播 broadcast 前面提到过,广播可以将变量发送到闭包中,被闭包使用。但是,广播还有一个作用是同步较大数据。比如你有一个IP库,可能有几G,在map操作中,依赖这个ip库。那么,可以通过广播将这个ip库传到闭包中,被并行的任务应用。广播通过两个方面提高数据共享效率:1,集群中每个节点(物理机器)只有一个副本,默认的闭包是每个任务一个副本;2,广播传输是通过BT下载模式实现的,也就是P2P下载,在集群多的情况下,可以极大的提高数据传输速率。广播变量修改后,不会反馈到其他节点。 累加器 Accumulator 累加器是一个write-only的变量,用于累加各个任务中的状态,只有在驱动程序中,才能访问累加器。而且,截止到1.2版本,累加器有一个已知的缺陷,在action操作中,n个元素的RDD可以确保累加器只累加n次,但是在transformation时,spark不确保,也就是累加器可能出现n+1次累加。 目前RDD提供的同步机制粒度太粗,尤其是转换操作中变量状态不能同步,所以RDD无法做复杂的具有状态的事务操作。不过,RDD的使命是提供一个通用的并行计算框架,估计永远也不会提供细粒度的数据同步机制,因为这与其设计的初衷是违背的。 RDD优化技巧 RDD缓存 需要使用多次的数据需要cache,否则会进行不必要的重复操作。举个例子 val data = … // read from tdw println(data.filter(_.contains("error")).count) println(data.filter(_.contains("warning")).count) 上面三段代码中,data变量会加载两次,高效的做法是在data加载完后,立刻持久化到内存中,如下 val data = … // read from tdw data.cache println(data.filter(_.contains("error")).count) println(data.filter(_.contains("warning")).count) 这样,data在第一加载后,就被缓存到内存中,后面两次操作均直接使用内存中的数据。 转换并行化 RDD的转换操作时并行化计算的,但是多个RDD的转换同样是可以并行的,参考如下 val dataList:Array[RDD[Int]] = … val sumList = data.list.map(_.map(_.sum)) 上面的例子中,第一个map是便利Array变量,串行的计算每个RDD中的每行的sum。由于每个RDD之间计算是没有逻辑联系的,所以理论上是可以将RDD的计算并行化的,在scala中可以轻松试下,如下 val dataList:Array[RDD[Int]] = … val sumList = data.list.par.map(_.map(_.sum)) 注意红色代码。 减少shuffle网络传输 一般而言,网络I/O开销是很大的,减少网络开销,可以显著加快计算效率。任意两个RDD的shuffle操作(join等)的大致过程如下, 用户数据userData和事件events数据通过用户id连接,那么会在网络中传到另外一个节点,这个过程中,有两个网络传输过程。Spark的默认是完成这两个过程。但是,如果你多告诉spark一些信息,spark可以优化,只执行一个网络传输。可以通过使用、HashPartition,在userData"本地"先分区,然后要求events直接shuffle到userData的节点上,那么就减少了一部分网络传输,减少后的效果如下, 虚线部分都是在本地完成的,没有网络传输。在数据加载时,就按照key进行partition,这样可以经一部的减少本地的HashPartition的过程,示例代码如下 val userData = sc.sequenceFile[UserID, UserInfo]("hdfs://…") .partitionBy(new HashPartitioner(100)) // Create 100 partitions .persist() 注意,上面一定要persist,否则会重复计算多次。100用来指定并行数量。 Spark其他 Spark开发模式 由于spark应用程序是需要在部署到集群上运行的,导致本地调试比较麻烦,所以经过这段时间的经验累积,总结了一套开发流程,目的是为了尽可能的提高开发调试效率,同时保证开发质量。当然,这套流程可能也不是最优的,后面需要持续改进。 整个流程比较清楚,这里主要谈谈为什么需要单元测试。公司内的大多数项目,一般不提倡单元测试,而且由于项目进度压力,开发人员会非常抵触单元测试,因为会花费"额外"的精力。Bug这东西不会因为项目赶进度而消失,而且恰好相反,可能因为赶进度,而高于平均水平。所以,如果不花时间进行单元测试,那么会花同样多,甚至更多的时间调试。很多时候,往往一些很小的bug,却导致你花了很长时间去调试,而这些bug,恰好是很容易在单元测试中发现的。而且,单元测试还可以带来两个额外的好处:1)API使用范例;2)回归测试。所以,还是单元测试吧,这是一笔投资,而且ROI还挺高!不过凡事需要掌握分寸,单元测试应该根据项目紧迫程度调整粒度,做到有所为,有所不为。 Spark其他功能 前面提到了spark生态圈,spark除了核心的RDD,还提供了之上的几个很使用的应用: Spark SQL: 类似hive,使用rdd实现sql查询 Spark Streaming: 流式计算,提供实时计算功能,类似storm MLLib:机器学习库,提供常用分类,聚类,回归,交叉检验等机器学习算法并行实现。 GraphX:图计算框架,实现了基本的图计算功能,常用图算法和pregel图编程框架。 后面需要继续学习和使用上面的功能,尤其是与数据挖掘强相关的MLLib。 参考资料 An Architecture for Fast and General Data Processing on Large Clusters, by Matei Zaharia Spark官方网站 Spark闭包函数外部变量访问问题 Learning Spark Lightning-Fast Big Data.Analysis 声明:如有转载本博文章,请注明出处。您的支持是我的动力!文章部分内容来自互联网,本人不负任何法律责任。 分类: 数据分析&挖掘, 大数据, 机器学习 本文转自bourneli博客园博客,原文链接:http://www.cnblogs.com/bourneli/p/4394271.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android 分享几个应用源码

今天在整理一些代码,发现了几个以前初学Android开发时写的小应用,想了想就把源码都发了出来,供其他初学者参考下 几个应用都是挺简单的,拿来练手还是可以的 所有的代码都是在我的新的GitHub账号上: leavesC 一、知了 一个阅读类应用,界面切换效果还是挺好的,数据引用自这里:API GitHub地址:知了 知了 二、MyCSDN 一个通过解析我的CSDN博客个人主页做成的博客应用,可以实时查看博客文章,不过效率低了点,界面也不太好看 GitHub地址:MyCSDN MyCSDN 三、围住神经猫 一个小游戏 GitHub地址:围住神经猫 围住神经猫 四、2048 一个小游戏 GitHub地址:2048 2048

优秀的个人博客,低调大师

classin视频课程下载方法分享

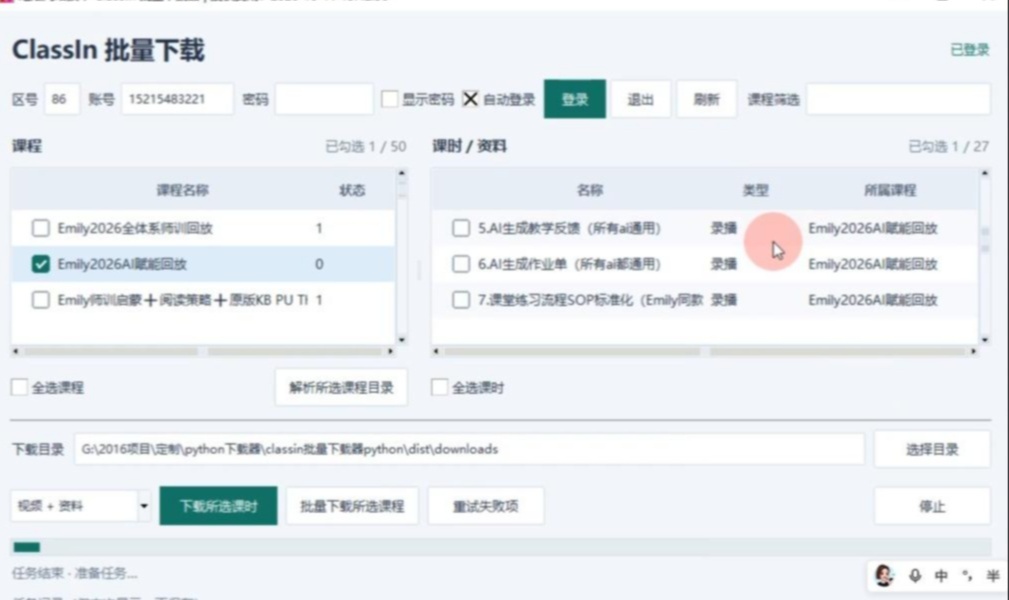
大家好,今天给大家讲解一下我们如何下载 ClassIn 中的视频课程。 我们在平时使用 ClassIn 观看视频课程的时候,会发现我们只能在线观看,无法直接下载。这样就给我们带来了很多不便。今天我就教大家如何下载 ClassIn 中的视频课程,有三种方法供大家选择,可以完美解决这个问题。 首先第一种方法使用成品软件。 我们这里以《地瓜网络技术ClassIn 视频课程下载助》手为例。该软件可以一键批量下载 ClassIn 中的视频课程,并且下载的视频是超清的、无水印的 MP4 格式。 ![](https://developer.qcloudimg.com/http-save/audit-7477016/c130cf7c1f8d2c7b61ccef27eaab7858.png) 第二种方法使用屏幕录制。 该方法使用非常简单,并且市面上有很多免费的软件供我们使用。但是它的缺点也特别明显,就是效率特别低。如果一个视频的时间长度是一个小时的话,那我们录屏的时间也需要一个小时。还有就是,如果视频画面上有水印的话,用屏幕录制这种方法录制出来的视频也会有水印。所以这种方法只适用于视频时间比较短,并且视频画面上没有水印的用户。 ![](https://developer.qcloudimg.com/http-save/audit-7477016/8d006fd72eb46753259fe5422f11fbfb.png) 第三种方法使用抓包逆向。 该方法的缺点是使用门槛比较高,要求我们有一定的编程开发能力。但是它的优点也特别明显,就是如果我们有编程开发能力的话,我们就可以根据自己的需求来开发对应的脚本,实现批量下载。 ![](https://developer.qcloudimg.com/http-save/audit-7477016/0a5e8ed7dd0ad470143860ff8f18e45b.png) 好的,以上就是给大家提供的三种方法实现下载 classin 中的视频课程

优秀的个人博客,低调大师

find skills 使用场景分享

# 别问"你能不能干",先搜一下技能库 上周有个同事问我:"这 AI 能帮我查厦门明天天气吗?出差得带伞。" 我第一反应是教他怎么把问题问清楚。但聊着聊着发现,问题根本不在提问技巧——他不知道 AI 还有"技能"这回事。 现在的智能体(比如我日常在用的 WorkBuddy)不是出厂就全能的。查天气、转文档、抓数据、跑代码审查,这些能力大多是靠一个个"技能"(Skill)按需装上去的。装之前,它不会主动告诉你"我能干这个",你得像逛应用商店一样去发现它们。 **find skills 干的就是这件事**:你说一句人话,描述你要做的事,它去技能库里做语义搜索,把匹配的技能带回来,你挑一个,确认安装,完事。 这篇文章聊聊我实际用下来,这个功能最值的几个场景。 --- ## 先搞懂它在搜什么 find skills 背后的逻辑不复杂,三个关键词: - **语义搜索**:它搜的不是关键词匹配,是"意思"。你说"帮我找找能查天气的技能",和直接搜 "weather",结果一样。 - **多个技能库**:主库是 SkillHub,找不到还有 Vercel Skills 和 ClawHub 兜底,本机装过的技能也会优先复用。 - **中英文都认**:中文描述和英文关键词都能搜,这点对中文用户很友好。 底层就是一个搜索接口,比如搜"天气": ``` curl "https://lightmake.site/api/v1/search?q=天气&limit=10" ``` 返回结果是带下载量、安装量、评分的技能列表。我实测搜"天气",返回的第一个技能叫 tianqi-weather,下载 2478 次,不用 API Key,装上就能查全球城市天气。 ## 实用场景 场景一 ### 你以为 AI 干不了,其实只是没装技能 这是最常见的误判。 "有没有能查天气的技能?" "能帮我找找做 PDF 转 Word 的技能吗?" "有没有做 PPT 的技能?" 这类问题的关键点:AI 说"我不会"的时候,很多时候不是能力问题,是没装对应的技能。**先搜,再下结论。**我踩过的坑是,以前遇到这种事会自己写 prompt 硬凑,或者干脆手动干,其实搜一下十分钟就解决了。 场景二 ### 专业领域,AI 突然变"行家" 法律检索、金融数据、商标查询、专利搜索、行业研报……通用模型在这些领域只能泛泛而谈,但技能库里还真有专业的。 "有没有查法律法规的技能?" "我想搜上市公司的财务数据,有技能吗?" "有没有商标查询类的技能?" 这类技能通常封装了专业数据源,比让模型凭空回答靠谱得多。销售、投研、法务这些岗位的人,值得先搜一圈看看有没有对口技能。 场景三 ### 办公流水线提速 每天重复的活,装一个技能,以后一句话触发: - 表格处理(Excel 增删改查、数据分析) - 文档转换(docx、pdf 互转) - 邮件管理(发信、收件箱整理、附件下载) - 网盘、知识库、在线文档操作 装完之后的体验是:以前要交代一堆上下文才能干的事,现在一句话"帮我把这份表按地区汇总一下"就跑了。 场景四 ### 开发者自己的提效 对开发同学来说这个场景最直接。搜 "react performance",返回 React Performance 技能,下载 2670 次,装完之后审查、重构 React 代码时会自动带上性能优化检查项。类似的还有: - PR review - changelog 自动生成 - 部署发布 - 代码库检索 我自己的体会:这种"垂直场景技能"比通用的"帮我看看这段代码"要准得多,因为它内置了该领域的最佳实践。 场景五 ### 搜索本身有技巧 搜得准,靠几个小习惯: 1. **关键词具体点**:"react testing" 比 "testing" 有用得多。 1. **中英文都试**:语义搜索两种语言都支持,中文没结果就换英文,反之亦然。 1. **换着说法试**:"deploy" 不行就试 "ci-cd"、"发布"。 1. **按分类逛**:AI Intelligence、Developer Tools、Data Analysis、Content Creation、Security & Compliance 这些分类都开着,没事翻翻常有惊喜。 场景六 ### 真找不到,还有三条路 搜了三个库都没有?别急: 1. **让 AI 直接干**。它的通用能力本来就是兜底,只是可能没那么专业。 1. **自己造一个**。npx skills init my-skill,把你反复做的事沉淀成技能。 1. **沉淀成团队资产**。今天踩坑总结出来的流程,装成技能,明天全团队一句话就能复用。 第三条其实是这个生态里最值钱的部分。个人用,省的是自己的时间;团队用,省的是所有人的重复劳动。 场景七 ### 新人上手的最短路径 团队来了新同事,与其发一份几十页的使用手册,不如告诉他一句话:"以后想让 AI 干活,先问它'有没有对应的技能'。" 技能库本身就是最好的说明书——想干什么,搜什么,装什么,全流程都是自然语言。新人不用背功能清单,遇事搜一下就行。 ## 30 秒上手 不需要学任何新东西,就是正常说话: "帮我找个能 X 的技能" "有没有 X 方面的技能?" "这个能做成技能吗?" AI 会返回几个候选,带下载量、安装量,你挑一个确认,装好即用。安装前它还会看一眼技能内容,装完验证一下路径,不会装错地方。 --- ## 结尾 模型本身的能力上限,决定了 AI 的下限;而技能生态,决定的是上限。 技能库把"AI 能力"变成了可搜索、可安装、可复用、可传承的东西。跟调 prompt 比起来,这个路径的确定性高得多——你不必指望模型记住某个领域的全部细节,装一个对的技能就行。 下次想问"你能不能干 X"的时候,先换个问法: "帮我找找,有没有干 X 的技能。"

优秀的个人博客,低调大师

Janus WebRTC网关技术架构分享

![](https://developer.qcloudimg.com/http-save/yehe-1506126/88b5adfbd6ecae3b955565939103ba75.png) # **Janus WebRTC网关** Janus是由Meetecho开发的通用WebRTC服务器,提供了一个用于构建 WebRTC 应用程序的模块化框架。本文档对 Janus WebRTC Gateway 的架构、核心组件及其交互方式进行了高层次概述。 ![](https://developer.qcloudimg.com/http-save/yehe-1506126/9738a323bfb3a27acb80b4d4e30a9164.png) **主要特性:** - 模块化架构:将核心 WebRTC 功能与特定于应用的逻辑分离。 - 轻量级核心:使用 C 语言编写,占用资源小。 - 插件系统:可通过插件扩展,适用于各种应用(视频会议、流媒体、SIP 网关-集成FreeSWITCH等开源SIP软交换)。 - 多种传输机制:支持 HTTP/REST、WebSockets、RabbitMQ、MQTT、Nanomsg 和 Unix 套接字。 - 会话管理:处理连接、WebRTC 会话和插件附加。 - 媒体处理:处理媒体协商、编码和传输。 - 录制功能:支持通过 .mjr 文件和后处理工具录制 WebRTC 会话。 --- # **概述** Janus 是由 Meetecho 开发的通用 WebRTC 服务器,提供了一个用于构建 WebRTC 应用程序的模块化框架。本文档提供了 Janus WebRTC 网关架构的高级概述、其核心组件以及它们之间的交互方式。 ## **目的和范围** Janus WebRTC 网关设计目标为一个轻量级的通用 WebRTC 服务器,除了实现以下功能外,本身不提供任何其他功能: - • 与浏览器建立 WebRTC 媒体通信 - • 在客户端和服务器之间交换 JSON 消息 - • 在浏览器和服务器端应用程序逻辑之间中继 RTP/RTCP 和消息 实际功能是在服务器端插件中实现的,浏览器通过 Janus 核心连接到这些插件。这种模块化架构允许占用很小的空间,同时提供最大的灵活性。 ## **主要特性** - • **模块化架构**:将核心 WebRTC 功能与应用特定逻辑分离 - • **轻量级核心**:用 C 编写,占用空间小 - • **插件系统**:可通过各种应用程序插件扩展(视频会议、流媒体、SIP 网关等) - • **多种传输机制**:支持 HTTP/REST、WebSockets、RabbitMQ、MQTT、Nanomsg 和 Unix 套接字 - • **会话管理**:处理连接、WebRTC 会话和插件附加 - • **媒体处理**:处理媒体协商、编码和传输 - • **录制功能**:支持通过 `.mjr` 文件录制 WebRTC 会话和后处理工具 ## **高级架构** ### **Janus 系统架构** 插件层 Janus 核心 传输层 客户端应用程序 Web 浏览器 移动应用程序 自定义客户端 libjanus_http.so libjanus_websockets.so libjanus_mqtt.so libjanus_rabbitmq.so libjanus_nanomsg.so libjanus_unixsockets.so janus_session janus_ice_handle WebRTC 栈(libnice, OpenSSL, libsrtp) libjanus_videoroom.so libjanus_audiobridge.so libjanus_streaming.so libjanus_sip.so libjanus_echotest.so libjanus_textroom.so libjanus_recordplay.so ## **核心组件和流程** ### **核心组件和交互流程** 应用程序插件 Janus 核心逻辑 传输插件 JSON API janus_transport janus_session_find janus_plugin_push_event janus_ice_setup_connectivity DTLS 握手 密钥交换 janus_plugin_incoming_rtp janus_plugin_incoming_data 客户端应用程序 janus_transport_callbacks janus_session janus_ice_handle libnice (ICE) OpenSSL (DTLS) libsrtp (SRTP) usrsctp (数据通道) janus_plugin_callbacks ### **会话和句柄关系** Janus 通过分层结构组织客户端连接: 1. 1. **会话**:表示从客户端到网关的连接。会话由唯一的 `session_id` 标识。 1. 2. **句柄**:在会话中,客户端创建句柄以附加到特定插件。句柄是特定应用程序用例的上下文(例如,特定的 VideoRoom)。 1. 3. **对等连接**:每个句柄管理自己的 WebRTC 对等连接,包括 ICE 代理、DTLS 状态和 SRTP 密钥。 这种架构允许单个客户端通过在单个会话中维护多个句柄来同时与多个插件交互。 ## **会话生命周期** Janus 会话的典型生命周期包括: 1. 1. **会话创建**:客户端通过传输连接并发送 `create` 请求。 1. 2. **插件附加**:客户端发送 `attach` 请求指定插件(例如 `janus.plugin.videoroom`)。 1. 3. **媒体协商**:客户端和插件通过核心交换 JSEP(JavaScript 会话建立协议)消息(SDP 提供/应答)。 1. 4. **媒体交换**:一旦对等连接建立,RTP/RTCP 或数据通道数据包开始流动。 1. 5. **会话终止**:句柄被分离,会话通过 `destroy` 请求或超时被销毁。 ### **媒体交换期间的数据流** "媒体栈 (libnice/libsrtp)""插件 (例如 libjanus_videoroom.so)""Janus 核心 (janus.c)""传输 (例如 libjanus_websockets.so)""WebRTC 客户端""媒体栈 (libnice/libsrtp)""插件 (例如 libjanus_videoroom.so)""Janus 核心 (janus.c)""传输 (例如 libjanus_websockets.so)""WebRTC 客户端"ICE/DTLS 连接已建立创建会话janus_session_create()session_id附加插件janus_ice_handle_create()init() / create_handle()handle_idSDP 提供 (JSEP)janus_ice_handle_process_jsep()handle_message()janus_plugin_push_event(SDP 应答)nice_agent_gather_candidates()发送应答SDP 应答加密的 RTP解密 (SRTP)incoming_rtp()中继/处理relay_rtp()加密 (SRTP)加密的 RTP ## **插件系统** Janus 提供了一个插件架构,允许开发人员在不修改核心的情况下实现各种 WebRTC 应用程序。插件是在运行时加载的共享对象。其包含的核心插件: - • **VideoRoom**:用于视频会议的 SFU(选择性转发单元) - • **AudioBridge**:用于会议的音频混音器 - • **Streaming**:允许向 WebRTC 客户端广播 RTP/RTSP/HLS 流 - • **SIP**:到传统 SIP/VoIP 网络的网关,对接FreeSWITCH 模块 - • **TextRoom**:基于数据通道的聊天 - • **Lua/Duktape**:允许用脚本语言编写插件逻辑 ![](https://developer.qcloudimg.com/http-save/yehe-1506126/c758401be73eb6bfc6f9438b1a883bd0.png) ## **传输层** 传输层是可插拔的,允许通过各种协议控制 Janus: - • **HTTP/REST**:Web 集成的默认选项(`libmicrohttpd`) - • **WebSockets**:双向低延迟控制(`libwebsockets`) - • **消息队列**:通过 RabbitMQ 或 MQTT 与后端系统集成 - • **Unix 套接字**:高性能本地控制 ## **结论** Janus WebRTC网关通过其模块化架构为构建 WebRTC 应用程序提供了灵活的框架。通过将 WebRTC 功能(核心)与应用程序逻辑(插件)和通信机制(传输)分离,Janus使开发人员能够专注于构建其特定应用程序,而无需处理底层WebRTC栈的复杂性。 参考资料: https://www.januscon.it/2019/slides/LucaPradovera-JanusCon.pdf

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册