首页 文章 精选 留言 我的

精选列表

搜索[学习],共10000篇文章
优秀的个人博客,低调大师

【Android学习笔记】设置项目桌面icon

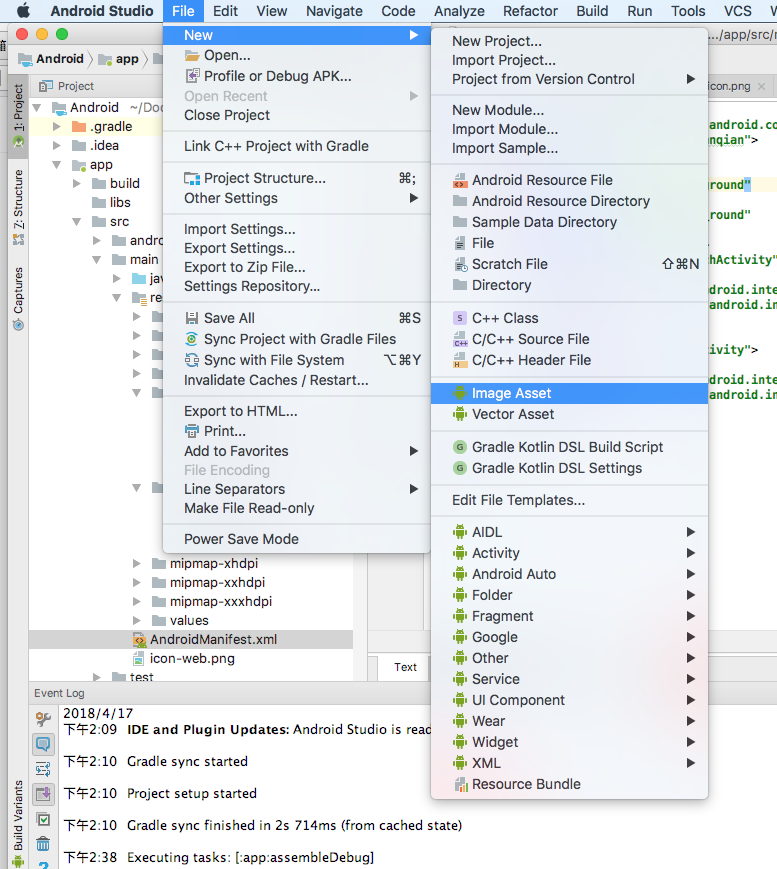
近来项目处于测试阶段,工作少了许多,就装了个最新的Android Studio,想写一下安卓。新建好项目,想设置个桌面的icon。我先准备好自己的icon图片,然后复制粘贴到res/mipmap-hdpi文件夹下,然后在AndroidManifest中将icon的地址改为我自己图片的命名,运行之后,发现模拟器所有icon都是圆的,我的图片是方形的,显示的样子为一个圆的白色里面套着我的方形icon,然后就上网查了一下安卓icon适配的问题。Android Studio确实也提供了适配的方法,网上也有很多,不过我掉进了一个坑里,先来介绍下icon自适应的配置,首先新建一个Image Asset,如图: 选择Image Asset之后, 如图在标注的地方选择自己要设置的icon的图片。前面我说过,我已经将icon复制到res/mipmap-hdpi文件夹,然后我去那里选择图片,但是并没有我粘贴进去的图片,然后我直接右键res/mipmap-hdpi文件夹,选择显示文件夹,就看到图片在那里。也就是在设置icon选择路径那里选不到自己的icon,然后弄了好久,icon一直设置不成功,最后我在路径那里选了那张图片在我电脑上的路径,然后就发现右边图片不再显示默认的icon而是我自己的icon了,然后点击next,再点击finish,App的icon就设置好了。 说一下主要坑点,icon图片已经复制粘贴到项目下,但是在选择图片的时候去到图片所在的路径却看不到图片。如果遇到这种情况,就不要先把图片放到项目里,设置的时候直接选择图片就可以了。 由于做安卓开发不久,处于菜鸟阶段,我不知道这是什么原因造成的,有路过的大神可以给我解答一下疑惑。另外我之前用过Android Studio2.x的版本,设置icon的时候就没遇到过这个问题。

优秀的个人博客,低调大师

Docker学习之搭建私有镜像仓库

过节之前来一发,又是许久没整理笔记了,今天跟大家聊聊Docker如何搭建私有仓库的几种方式。首先我们来回顾一下之前讲到的Doker 平台的基本构成。 Doker 平台的基本构成 Docker 平台基本上由三部分组成: 客户端:用户使用 Docker 提供的工具(CLI 以及 API 等)来构建,上传镜像并发布命令来创建和启动容器 Docker 主机:从 Docker registry 上下载镜像并启动容器 Docker registry:Docker 镜像仓库,用于保存镜像,并提供镜像上传和下载 后面的文章会具体分析。 搭建方式 与Mavan的管理一样,Docker不仅提供了一个中央仓库,同时也允许我们使用registry搭建本地私有镜像仓库。 使用私有仓库有许多优点: 节省网络带宽,针对于每个镜像不用每个人都去中央仓库上面去下载,只需要从私有仓库中下载即可; 提供镜像资源利用,针对于公司内部使用的镜像,推送到本地的私有仓库中,以供公司内部相关人员使用。 方式一(registry镜像) 环境:为了测试安装方便,这里准备了一台装有Docker的云服务器。 搭建私有仓库: # 下载registry镜像 $ sudo docker pull registry # 通过该镜像启动一个容器 $ sudo docker run -d -p 8082:8082 registry # 映射镜像路径至宿机器、放置容器删除、镜像丢失: $ sudo docker run -d -p 8082:8082 -v /opt/data/registry:/tmp/registry registry 修改配置并重启Docker vi /etc/docker/daemon.json { "registry-mirrors": ["172.17.120.102:8082"], "insecure-registries":["172.17.120.102:8082"] } # 重启 docker 服务 systemctl restart docker 测试仓库Push/Pull: # 首先pull一个比较小的镜像(busybox)来测试 docker pull busybox # 修改一下该镜像的tag $ docker tag busybox 172.17.120.102:8080/busybox # 上传镜像到私有仓库。 $ docker push 172.17.120.102:8082/busybox 到此就搭建好了Docker私有仓库,但是如上搭建的仓库是不需要加密认证的,当然你可以通过证书或者Nginx实现认证访问。下面介绍一下基于Nexus 3搭建的Docker私有仓库。 方式二(Nexus 3) Nexus简介 Nexus是一个多功能的仓库管理系统,是企业常用的私有仓库服务器软件。目前常被用来作为Maven私服、Docker私服。 优点 安装简单,并且有官方Docker镜像 用户界面,并提供REST API 支持浏览、检索以及检查机制 支持npm与bower以及Raw repositories、NuGet repositories 总之Nexus物美价廉,又提供功能全面的oss版,加之支持种类众多的依赖管理,又可以统一管理docker镜像。 安装 参考之前写的一篇博客:本地私服仓库nexus3.3.1使用手册 。当然,这里我们有更简洁的安装方式,由于nexus3+依赖于JDK1.8,可能有不少企业系统上安装的还是1.7甚至是1.6版本,这里我们选择使用Docker镜像安装。 下载安装: # 下载nexus3镜像(pull前请更换镜像加速器,否则可能无法下载) $ sudo docker pull sonatype/nexus3 # 通过该镜像启动一个容器 $ sudo docker run -d -p 8081:8081 -p 8082:8082 --name nexus sonatype/nexus3 # 可能需要一些时间(2-3分钟)才能在新容器中启动该服务。一旦Nexus准备就绪,您可以确定日志以确定结果: $ sudo docker logs -f nexus # 测试 如果出现pong说明启动成功 $ curl -u admin:admin123 http://localhost:8081/service/metrics/ping 注意事项: 可能会出现无法启动的问题,由于云服务器只有1G内存,剩余也有几十MB的样式,显然是无法跑起来的。 Nexus的安装是/opt/sonatype/nexus。 持久目录,/nexus-data用于配置,日志和存储。该目录需要由作为UID 200运行的Nexus进程写入。 环境变量用于将JVM参数传递给启动脚本 $ docker run -d -p 8081:8081 --name nexus -e INSTALL4J_ADD_VM_PARAMS="-Xms2g -Xmx2g -XX:MaxDirectMemorySize=3g -Djava.util.prefs.userRoot=/some-other-dir" sonatype/nexus3 控制Nexus访问目录,NEXUS_CONTEXT,默认为/ docker run -d -p 8081:8081 --name nexus -e NEXUS_CONTEXT=nexus sonatype/nexus3 持久数据 $ mkdir /opt/data/nexus-data && chown -R 200 /opt/data/nexus-data $ docker run -d -p 8081:8081 --name nexus -v /opt/data/nexus-data:/nexus-data sonatype/nexus3 创建本地仓库: Nexus配置: 项目 地址端口 Nexus UI 8081 private repo 8082 URL http://192.168.1.180:8081/ 作者: 小柒2012 欢迎关注: https://blog.52itstyle.com

优秀的个人博客,低调大师

[转]区块链代码快速学习实践

如何使用Python编写一个简单且安全的区块链数据库API? GitHub项目链接:https://github.com/adamchinkc/blockchain_database 当我们讨论区块链时,我们总是把它与p2p网络联系起来,认为数据必须分散在网络上。这也会使人们担心区块链将会破坏数据的机密性。 事实上,区块链本身的数据架构已经为保护数据免受未经授权操作提供了一个好的解决方案,并且考虑到服务器受到足够的控制(如访问控制、网络和系统安全控制)的保护,最好是在内部网络。 因此,我尝试通过使用Python, Sqlite和RESTful API框架基于区块链的数据架构创建一个数据库。 区块链的数据架构及其完整性 摘自于中本聪发表的比特币白皮书《比特币:一种点对点电子现金系统》https://bitcoin.org/bitcoin.pd

优秀的个人博客,低调大师

机器学习基础 --- numpy的基本使用

一、numpy的简介 numpy是Python的一种开源的数值计算扩展库。这种工具可用来存储和处理大型矩阵,比Python自身的嵌套列表(nested list structure)结构要高效的多(该结构也可以用来表示矩阵(matrix))。 NumPy(Numeric Python)提供了许多高级的数值编程工具,如:矩阵数据类型、矢量处理,以及精密的运算库。专为进行严格的数字处理而产生。 Numpy中包含了大量的矩阵运算,所以读者最好具有一点儿线性代数的基础。 二、numpy基本使用 1.导入numpy库并使用numpy的array方法配合Python中的list生成矩阵 import numpy as np vetor = np.array([1,2,3,4]) # 一维 matrix = np.array([ [1,1,1], [2,2,2], [3,3,3] ]) # 二维 print(vetor) print(matrix) 输出: [1 2 3 4] [[1 1 1] [2 2 2] [3 3 3]] 2. 获取矩阵的组成 print(vetor.shape) print(matrix.shape) 输出: (4,) (3, 3) 3. 数据类型 numbers = np.array([1,3,5,7]) # 全为int型 print(numbers) numbers.dtype 输出: [1 3 5 7] dtype('int64') numbers = np.array([1,3,5,7.0]) # 有一个为float型,全为float型 print(numbers) numbers.dtype 示例2 [1. 3. 5. 7.] dtype('float64') 输出2 numbers = np.array([1,3,5,'7']) # 有一个为字符串,全为字符串 print(numbers) numbers.dtype 示例3 ['1' '3' '5' '7'] dtype('<U21') 输出3 4.操作矩阵的某个值,某些值 vetor = np.array([1,2,3,4]) matrix = np.array([[1,2,3],[4,5,6],[7,8,9]]) print(vetor[2]) # 打印vetor的第2个元素 print(vetor[:3]) # 打印vetor的第0到第二个(不包括第三个)元素 print(matrix[2,2]) # 打印matrix第2行,第2列的元素 print(matrix[:, 1]) # 打印每一行的第1列元素 输出: 3 [1 2 3] 9 [2 5 8] 5.迭代判断矩阵中的所有值是否等于某个值 import numpy as np vector = np.array([1,3,5,7]) vector == 5 输出: array([False, False, True, False]) matrix = np.array([ [1, 4, 7], [2, 5, 8], [3, 6, 9] ]) matrix == 5 示例2 array([[False, False, False], [False, True, False], [False, False, False]]) 输出2 vector = np.array([1,3,4,5,7]) equal_three_and_five = (vector == 3) & (vector == 5) # 迭代判断vector中的所有值是否即等于3又等于5 print(equal_three_and_five) 示例3 [False False False False False] 输出3 vector = np.array([1,3,4,5,7]) equal_three_or_five = (vector == 3) | (vector == 5) # 迭代判断vector中的所有值是否即等于3或者等于5 print(equal_three_or_five) 示例4 [False True False True False] 输出4 matrix = np.array([ [1, 4, 7], [2, 5, 8], [3, 6, 9] ]) equal_ten = (matrix == 5) # 比较的结果可视为一个索引 print(equal_ten) print(matrix[equal_ten]) 进阶使用1 [[False False False] [False True False] [False False False]] [5] 进阶输出1 matrix = np.array([ [1, 4, 7], [2, 5, 8], [3, 6, 9] ]) equal_ten = (matrix[:, 1] == 5) # 迭代判断matrix的第1列的值是否等于5 print(equal_ten) print(matrix[equal_ten, :]) 进阶使用2 [False True False] [[2 5 8]] 进阶输出2 vector = np.array([1,3,4,5,7]) equal_three_or_five = (vector == 3) | (vector == 5) # 迭代判断vector中的所有值是否即等于3或者等于5 vector[equal_three_or_five] = 10 # 将等于3或者等于5的值替换成10 print(vector) 进阶使用3 [ 1 10 4 10 7] 进阶输出3 6.类型转换 vector = np.array(['1', '3', '5', '7']) print(vector.dtype) print(vector) vector = vector.astype(int) #使用astype方法做类型转换 print(vector.dtype) print(vector) 输出: <U1 ['1' '3' '5' '7'] int64 [1 3 5 7] 7.常规计算 vector = np.array([1,3,4,5,7]) print(vector.min()) #求最大值 print(vector.max()) #求最小组 输出: 1 7 # 示例2matrix = np.array([ [1, 4, 7], [2, 5, 8], [3, 6, 9] ]) print(matrix.min(axis=1)) # 按行求最小值,axis=1表示按行 print(matrix.max(axis=0)) # 按列求最大值,axis=0表示按列 print(matrix.max()) # 所有值求最大值 # 输出2 [1 2 3] [3 6 9] 9 # 示例3 matrix = np.array([ [1, 4, 7], [2, 5, 8], [3, 6, 9] ]) print(matrix.sum(axis=1)) # 按行求和 print(matrix.sum(axis=0)) # 按列求和 print(matrix.sum()) # 所有值求和 # 输出3 [12 15 18] [ 6 15 24] 45 8.生成初始矩阵 # 示例1 print(np.arange(15)) # 取0到14组成一个一维矩阵 a = np.arange(15).reshape(3,5) # 取0到14组成一个3行5列的2维矩阵 print(a) # 输出1 [ 0 1 2 3 4 5 6 7 8 9 10 11 12 13 14] [[ 0 1 2 3 4] [ 5 6 7 8 9] [10 11 12 13 14]] # 示例2 a.ndim # 获取a的维度 a.dtype.name #获取a中数据的类型 a.size # a中数据的数量 # 示例3 b = np.zeros((3, 4)) # 一个3行4列的矩阵, 由0构成 print(b) # 输出3 [[0. 0. 0. 0.] [0. 0. 0. 0.] [0. 0. 0. 0.]] # 示例4 c = np.ones((2,3,4), dtype=np.int32) # 3维矩阵,2组3行4列的2维矩阵,由1构成 print(c) # 输出4 [[[1 1 1 1] [1 1 1 1] [1 1 1 1]] [[1 1 1 1] [1 1 1 1] [1 1 1 1]]] # 示例5 d = np.arange(10, 30, 5) #初值为10,增量为5,最大不超过30,构成一维矩阵,numpy中arange的用法几乎和Python中的range一样 print(d) # 输出5 [10 15 20 25] # 示例6 e = np.random.random((2, 3)) #由0到1之间的随机数构成一个2行3列的矩阵,np.random中的方法几乎和Python的random模块中的方法相同 print(e) # 输出6 [[0.26358359 0.86922218 0.12168824] [0.58244693 0.30264221 0.795065 ]] # 示例7 from numpy import pi f = np.linspace(0, 2*pi, 100) #由0到2pi中间的100个数构成一个一维矩阵,这些书之间的增量相同 print(f) # 输出7 [0. 0.06346652 0.12693304 0.19039955 0.25386607 0.31733259 0.38079911 0.44426563 0.50773215 0.57119866 0.63466518 0.6981317 0.76159822 0.82506474 0.88853126 0.95199777 1.01546429 1.07893081 1.14239733 1.20586385 1.26933037 1.33279688 1.3962634 1.45972992 1.52319644 1.58666296 1.65012947 1.71359599 1.77706251 1.84052903 1.90399555 1.96746207 2.03092858 2.0943951 2.15786162 2.22132814 2.28479466 2.34826118 2.41172769 2.47519421 2.53866073 2.60212725 2.66559377 2.72906028 2.7925268 2.85599332 2.91945984 2.98292636 3.04639288 3.10985939 3.17332591 3.23679243 3.30025895 3.36372547 3.42719199 3.4906585 3.55412502 3.61759154 3.68105806 3.74452458 3.8079911 3.87145761 3.93492413 3.99839065 4.06185717 4.12532369 4.1887902 4.25225672 4.31572324 4.37918976 4.44265628 4.5061228 4.56958931 4.63305583 4.69652235 4.75998887 4.82345539 4.88692191 4.95038842 5.01385494 5.07732146 5.14078798 5.2042545 5.26772102 5.33118753 5.39465405 5.45812057 5.52158709 5.58505361 5.64852012 5.71198664 5.77545316 5.83891968 5.9023862 5.96585272 6.02931923 6.09278575 6.15625227 6.21971879 6.28318531] 9.矩阵的基础运算 # 示例2 # 矩阵的加减运算 a = np.array([20, 30, 40, 50]) b = np.arange(4) print(a) print(b) c = a - b # 将a与b对应的位置相减 d = a + b # 将a与b对应的位置相加 print('----------->') print(c) print(d) c = c -2 print('----------->') print(c) print(b ** 2) # 对b中的每个元素平方 print(a < 40) # 迭代判断a中的元素是否小于40 #输出1 [20 30 40 50] [0 1 2 3] -----------> [20 29 38 47] [20 31 42 53] -----------> [18 27 36 45] [0 1 4 9] [ True True False False] # 示例2 # 矩阵的乘法 A = np.array([ [1, 1], [0, 1] ]) B = np.array([ [2, 0], [3, 4] ]) print(A) print("=============") print(B) print("=============") print(A*B) # 矩阵对应位置的元素相乘 print("=============") print(A.dot(B)) # 矩阵乘积 print("=============") print(np.dot(A, B)) # 矩阵乘积 # 输出2 [[1 1] [0 1]] ============= [[2 0] [3 4]] ============= [[2 0] [0 4]] ============= [[5 4] [3 4]] ============= [[5 4] [3 4]] 10.矩阵的其他操作 # 示例1 import numpy as np B = np.arange(3) print(B) print(np.exp(B)) # 分别计算e的0,1,2(即B中的每个元素)次幂 print(np.sqrt(B)) # 对B求算数平方根 # 输出1: [0 1 2] [1. 2.71828183 7.3890561 ] [0. 1. 1.41421356] # 示例2 a = np.random.random((3, 4)) print(a) b = np.floor(10 * a) #取整,截除小数点后面的部分 print(b) print("------------------------------>") c = b.ravel() # 二维转一维,即矩阵转向量,返回一个新的矩阵,自身结构不改变 print(c) c.shape = (6, 2) # 一维转二维,向量转为6×2的矩阵,对自己自身结构 print(c) print("------------------------------>") d = c.T print(c.T) # 对矩阵进行转置 # 输出2: [[0.07997894 0.66199346 0.66872968 0.09003685] [0.80189354 0.02278636 0.82955998 0.3037011 ] [0.31794432 0.67269324 0.12022113 0.12148777]] [[0. 6. 6. 0.] [8. 0. 8. 3.] [3. 6. 1. 1.]] ------------------------------> [0. 6. 6. 0. 8. 0. 8. 3. 3. 6. 1. 1.] [[0. 6.] [6. 0.] [8. 0.] [8. 3.] [3. 6.] [1. 1.]] ------------------------------> [[0. 6. 8. 8. 3. 1.] [6. 0. 0. 3. 6. 1.]] # 示例3 import numpy as np a = np.floor(10 * np.random.random((2, 2))) b = np.floor(10 * np.random.random((2, 2))) print(a) print(b) print("------------------------------>") c = np.vstack((a, b)) # 将两个矩阵按行合并,两个矩阵的列必须相同 print(c) print("------------------------------>") d = np.hstack((a, b)) # 两个矩阵按列合并,两个矩阵的行必须相同 print(d) # 输出3: [[8. 7.] [0. 0.]] [[6. 9.] [0. 1.]] ------------------------------> [[8. 7.] [0. 0.] [6. 9.] [0. 1.]] ------------------------------> [[8. 7. 6. 9.] [0. 0. 0. 1.]] # 示例4 import numpy as np a = np.floor(10 * np.random.random((2, 12))) print(a) print("------------------------------>") b,c,d = np.hsplit(a, 3) # 按列切平均分为3份 print(b) print(c) print(d) print("------------------------------>") e,f,g = np.vsplit(a.T, 3) # 按行切平均分为3份 print(e) print(f) print(g) print("------------------------------>") h, i, j, k = np.hsplit(a, (3, 6, 8)) # 在第3列前面,第6列前面,第8列后面进行分割,分割为4个矩阵,np.vsplit()用法相同 print(h) print(i) print(j) print(k) # 输出4: [[3. 1. 7. 4. 1. 1. 5. 8. 3. 9. 5. 6.] [2. 7. 6. 3. 7. 1. 6. 3. 5. 7. 9. 0.]] ------------------------------> [[3. 1. 7. 4.] [2. 7. 6. 3.]] [[1. 1. 5. 8.] [7. 1. 6. 3.]] [[3. 9. 5. 6.] [5. 7. 9. 0.]] ------------------------------> [[3. 2.] [1. 7.] [7. 6.] [4. 3.]] [[1. 7.] [1. 1.] [5. 6.] [8. 3.]] [[3. 5.] [9. 7.] [5. 9.] [6. 0.]] ------------------------------> [[3. 1. 7.] [2. 7. 6.]] [[4. 1. 1.] [3. 7. 1.]] [[5. 8.] [6. 3.]] [[3. 9. 5. 6.] [5. 7. 9. 0.]] 11.矩阵的复制 # 示例1 a = np.arange(12) b = a # 这种方式对b赋值,b和a是同一个对象,改变一个,另一个也改变,相当于别名 print(b) print(a) print(b is a) print("------------------------------>") a.shape = (3, 4) print(a) print(b) print(b.shape) print(id(a)) print(id(b)) 输出1: [ 0 1 2 3 4 5 6 7 8 9 10 11] [ 0 1 2 3 4 5 6 7 8 9 10 11] True ------------------------------> [[ 0 1 2 3] [ 4 5 6 7] [ 8 9 10 11]] [[ 0 1 2 3] [ 4 5 6 7] [ 8 9 10 11]] (3, 4) 4426322848 4426322848 # 示例2 # 浅拷贝(不建议使用) a = np.arange(12) a.shape = (2, 6) c = a.view() # 浅拷贝,c和a是两个对象,但是是同一份数据 print(a) print(c) print(c is a) print("------------------------------>") a.shape = (3, 4) # 改变结构,两个不相互影响 print(a) print(c) print("------------------------------>") c[0,4] = 10000 # 改变数据,会影响另外一个 print(a) print(c) # 输出2: [[ 0 1 2 3 4 5] [ 6 7 8 9 10 11]] [[ 0 1 2 3 4 5] [ 6 7 8 9 10 11]] False ------------------------------> [[ 0 1 2 3] [ 4 5 6 7] [ 8 9 10 11]] [[ 0 1 2 3 4 5] [ 6 7 8 9 10 11]] ------------------------------> [[ 0 1 2 3] [10000 5 6 7] [ 8 9 10 11]] [[ 0 1 2 3 10000 5] [ 6 7 8 9 10 11]] # 示例3 # 深拷贝 a = np.arange(12) a.shape = (2, 6) d = a.copy() # 深拷贝,d和a是两个对象,两份数据 print(a) print(d) print(d is a) print("------------------------------>") a.shape = (3, 4) # 改变结构,两个不相互影响 print(a) print(d) print("------------------------------>") d[0,4] = 10000 # 改变数据,两个不相互影响 print(a) print(d) # 输出3: [[ 0 1 2 3 4 5] [ 6 7 8 9 10 11]] [[ 0 1 2 3 4 5] [ 6 7 8 9 10 11]] False ------------------------------> [[ 0 1 2 3] [ 4 5 6 7] [ 8 9 10 11]] [[ 0 1 2 3 4 5] [ 6 7 8 9 10 11]] ------------------------------> [[ 0 1 2 3] [ 4 5 6 7] [ 8 9 10 11]] [[ 0 1 2 3 10000 5] [ 6 7 8 9 10 11]] 12.numpy的一些常用方法: # 示例1 import numpy as np data = np.sin(np.arange(20)).reshape(5, 4) print(data) ind = data.argmax(axis = 0) # 按列求最大值,得到行的索引,比如第1列的最大值在第2行,则返回2,依次求出所有列最大值的索引组成一个向量 print(ind) print(range(data.shape[1])) data_max = data[ind, range(data.shape[1])] # 相当于由data[2,0],data[0,1],data[3,2],data[1,3]构成的一个矩阵 print(data_max) # 输出1: [[ 0. 0.84147098 0.90929743 0.14112001] [-0.7568025 -0.95892427 -0.2794155 0.6569866 ] [ 0.98935825 0.41211849 -0.54402111 -0.99999021] [-0.53657292 0.42016704 0.99060736 0.65028784] [-0.28790332 -0.96139749 -0.75098725 0.14987721]] [2 0 3 1] range(0, 4) [0.98935825 0.84147098 0.99060736 0.6569866 ] # 示例2 a = np.arange(0, 10, 2) print(a) b = np.tile(a, (4, 3)) # 将a当成一个整体,将其复制为4行3列构成一个矩阵 print(b) print('----------------------------------->') c = np.arange(0, 11, 2) c.shape = (2, 3) # 对于二维同样如此 print(c) d = np.tile(c, (4, 3)) print(d) # 输出2: [0 2 4 6 8] [[0 2 4 6 8 0 2 4 6 8 0 2 4 6 8] [0 2 4 6 8 0 2 4 6 8 0 2 4 6 8] [0 2 4 6 8 0 2 4 6 8 0 2 4 6 8] [0 2 4 6 8 0 2 4 6 8 0 2 4 6 8]] -----------------------------------> [[ 0 2 4] [ 6 8 10]] [[ 0 2 4 0 2 4 0 2 4] [ 6 8 10 6 8 10 6 8 10] [ 0 2 4 0 2 4 0 2 4] [ 6 8 10 6 8 10 6 8 10] [ 0 2 4 0 2 4 0 2 4] [ 6 8 10 6 8 10 6 8 10] [ 0 2 4 0 2 4 0 2 4] [ 6 8 10 6 8 10 6 8 10]] # 示例3 a = np.floor(10 * np.random.random((15))) c = a.copy() a.shape = (5, 3) print(a) print('----------------------------------->') b = np.sort(a, axis=0) # axis=0按列进行升序排序, axis=1按行升序排序, 默认按行排序 print(b) print('----------------------------------->') a.sort(axis=1) print(a) print('----------------------------------->') j = np.argsort(c) # 排序,取原来的索引,比如[5 3 6]执行,得到[1 0 2], print(c) print(j) print(c[j]) # 输出3: [[2. 5. 5.] [6. 4. 9.] [8. 3. 0.] [2. 3. 0.] [5. 5. 4.]] -----------------------------------> [[2. 3. 0.] [2. 3. 0.] [5. 4. 4.] [6. 5. 5.] [8. 5. 9.]] -----------------------------------> [[2. 5. 5.] [4. 6. 9.] [0. 3. 8.] [0. 2. 3.] [4. 5. 5.]] -----------------------------------> [2. 5. 5. 6. 4. 9. 8. 3. 0. 2. 3. 0. 5. 5. 4.] [ 8 11 0 9 7 10 4 14 1 2 12 13 3 6 5] [0. 0. 2. 2. 3. 3. 4. 4. 5. 5. 5. 5. 6. 8. 9.]
优秀的个人博客,低调大师

你应该这个姿势学习php(3)

1、ob_start() 开启文件缓存 2、ob_get_contents() 得到缓存中的内存 3、ob_get_length() 得到缓冲区的长度 4、ob_flush() 输出缓冲区的内容,如果你想获取缓冲区的内容要在这个函数之前使用ob_get_contents(),不然数据将会被清空 5、ob_end_flush() 输出缓冲区并关闭缓存 6、ob_end_clean() 清除缓存并关闭输出缓冲,如果这个再ob_start()开启之后不执行这个函数时候,那么将一直写入缓冲区 下面我们来写一个页面静态化示例来练练手,本案例是依托thinkphp框架进行讲解,其他框架小伙伴们自行脑补! 1、首先有四个函数 ob_start() 开启缓存 ob_get_contents() 获取缓冲区的内容 ob_clean() 删除缓冲区的内容 ob_get_clean() 先获取然后再删除缓冲区内容 2、然后我们定义一个函数来生成静态文件 /**定义一个缓存文件 * @author crazy * @time 2018-03-14 */ public function createCache(){ $action = ACTION_NAME; $c_name = CONTROLLER_NAME; $dir = './Cache/'.$c_name.'/'.$action.'/'; if(is_dir($dir)){ file_put_contents("$dir$action".'.shtml',ob_get_contents()); }else{ if(mkdir($dir,0777,true)){ file_put_contents("$dir$action".'.shtml',ob_get_contents()); } } } 3、根据文件目录是否存在然后我们做相应的重定向 $action = ACTION_NAME; $c_name = CONTROLLER_NAME; $dir = './Cache/'.$c_name.'/'.$action.'/'.$action.'.shtml'; if(file_exists($dir)){ header("Location:http://localhost/simengphp/$dir"); } 4、局部静态化 $.ajax({ url:'', type:'get', dataType:'json', error: function () { }, success:function(data){ $.each(data.result,function(key,val){ }) } }); 我们在我们的模板里面写上这个ajax获取页面内容的方法,然后我们调用这个页面的时候这个方法就会自动的创建了

优秀的个人博客,低调大师

从零开始学习区块链(1)

定义1:区块链(Blockchain)技术是维护一个不断增长的数据记录的分布式数据库,这些数据通过密码学的技术和之前被写入的所有数据关联,使得第三方甚至是节点的拥有者难以篡改。区块(Block)包含有数据库中实际需要保存的数据,这些数据通过区块组织起来被写入数据库。 定义2:Hash算法:哈希算法将任意长度的二进制值映射为较短的固定长度的二进制值,这个小的二进制值称为哈希值。哈希值是一段数据唯一且极其紧凑的数值表示形式。如果散列一段明文而且哪怕只更改该段落的一个字母,随后的哈希都将产生不同的值。要找到散列为同一个值的两个不同的输入,在计算上是不可能的,所以数据的哈希值可以检验数据的完整性。一般用于快速查找和加密算法。 哈希表是根据设定的哈希函数H(key)和处理冲突方法将一组关键字映射到一个有限的地址区间上,并以关键字在地址区间中的

优秀的个人博客,低调大师

你应该这个姿势学习PHP(2)

1、循环数组有哪几种方式 1)foreach(能够循环关联和索引数组以及对象) 2)for(只能循环索引数组) 3)list和each配合使用循环数组 $arr = ['a'=>1,'b'=>2]; while(list($key,$val) = each($arr)){ echo $key$,val } 2、is_array(),is_bool,is_int(),is_integer(),is_numeric(),is_string(),is_object(),is_null,is_file,is_dir,is_readable,is_uploaded_file,is_writeable, 1)is_array() 检查一个变量是否是数组 2)is_file() 检查是否是一个文件 3)is_dir()检查是否是一个目录 4)is_uploaded_file() 检查是否是通过http post过来 5)is_readable() 检查是否可读 3、count() 1)计算数组的长度 4、array_sum()、array_product() 1)array_sum() 计算一个数组的和 2)array_product() 计算数组的乘积 5、array_count_values() 1)计算数组中的值出现次数的和 6、in_array() array_key_exists() array_search() key_exists() 1)in_array('xxx',$arr) 判断某个字符是否在数组中,并返回false或者true 2)array_key_exists('xxx',$arr) 判断一个键是否存在这个数组中 3)array_search('xxx',$arr) 判断某个值是否在数组中并返回key 7、array_values() array_keys() array_column() 1)array_values($arr) 返回数组的值 2)array_keys() 返回数组的所有键 2)array_column($arr,'xxxx') 返回数组的某一个列的值 8、array_filter() array_walk() array_walk_recursive() array_map() 1)array_filter($arr,'function') 用一个回调函数过滤一个数组 2)array_walk($arr,'function',[$param]) 用一个回调函数处理数组,并且可以使用一个其他值作为参数传递给函数 3)array_walk_recursive($arr,'function',[$param]) 对一个数组进行递归的使用函数 4)array_map($arr,funciont) 对数组的每个元素应用函数 9、array_unique() 1)对数组进行去重操作 10、array_change_key_case() 1)将数组的所有键名转换成小写 11、range() 1)range(0,n,step=步长)创建数组 12、array_fill() array_fill_keys() 1)array_fill(key_start,long,'xxx')用某个值填充数组 2)array_fill_keys($arr,'xxx') 用某个值和当前数组结合产生一个以$arr为键,以xxx为值的新数组 13、array_flip() array_reverse() 1)array_flip()交换数组的建和值 2)array_reverse($arr,[true]) 反转数组,如果第二个参数为true将保留数组的原键 14、array_pad() 1)array_pad($arr,long,xxx) 填充数组到指定的长度 15、array_rand() shuffle() 1)array_rand($arr,2) 随机去除几个数组 2)shuffle() 打乱数组 应用场景:随机的或者数组的一个值 16、array_shift() array_unshift() array_push() array_pop() 1)array_shift($arr) 从头部弹出一个值,栈 2)array_unshift($arr,[a,b,c...]) 入栈 应用场景:模拟栈 3)array_push($arr,[a,b,c....]) 从尾部插入一个值到数组中 4)array_pop($arr) 从尾部弹出一个值 应用场景:配合array_unshift 模拟队列 18、array_merge() array_merge_recursive() 1)array_merge() 合并两个数组,后者会覆盖前者键相同的值 2)array_merge_recursive() 递归的合并两个数组,后者会覆盖前者键相同的值 应用场景:框架里面两个配置文件的合并 19、array_multisort(),sort (),rsort (),krsort (),ksort(),asort(),arsort() 1)array_multisort($arr[0],SORT_ASC,$arr[1],SORT_DESC); 对多个数组进行排序 2)sort 数组升序 3)rsort 数组降序 4)krsort 使用键值对数组降序 5)ksort 使用键值对数组进行升序 6)asort 对数组进行升序排序并保持索引关系 7)arsort 对数组进行降序排序并保持索引关系 20、next prev rest end current 1)next //将数组中指针向前移动一位 2)prev //将数组内部指针倒回一位 3)rest //将数组指针指向第一个单元 4)end //将数组指针指向最后一个单元 5)current //返回数组中的当前单元 21、max() min() 1)max() 取最大值 2)min() 取最小值

优秀的个人博客,低调大师

Python 学习(七)--数据库操作

1. MySQL 数据库连接 1). PyMySQL PyMySQL 是在 Python3.x 版本中用于连接 MySQL 服务器的一个库,Python2中则使用mysqldb。PyMySQL 遵循 Python 数据库 API v2.0 规范,并包含了 pure-Python MySQL 客户端库。 下载解压,如图: 图1.png 2). 安装 python setup.py install 图2.png 2. 数据库连接 连接数据库前,请先确认以下事项: 已经创建了数据库 TESTDB. 在TESTDB数据库中您已经创建了表 EMPLOYEE EMPLOYEE表字段为 FIRST_NAME, LAST_NAME, AGE, SEX 和 INCOME。 连接数据库TESTDB使用的用户名为 "testuser" ,密码为 "test123",你可以可以自己设定或者直接使用root用户名及其密码,Mysql数据库用户授权请使用Grant命令。 在你的机子上已经安装了 Python MySQLdb 模块。 import pymysql # 打开数据库连接 db = pymysql.connect("localhost","root","root","TEST") # 使用 cursor() 方法创建游标对象 cursor cursor = db.cursor() # 使用execute() 方法执行SQL查询 cursor.execute("SELECT VERSION()") # 使用fetchone() 方法获取单条数据 data = cursor.fetchone() # 打印数据库版本 print("Database version: %s" % data) # 关闭数据库连接 db.close() 打印结果: 图3.png 3. 创建数据库表 import pymysql # 打开数据库连接 db = pymysql.connect("localhost", "root", "root", "TEST") # 使用cursor() 方法创建一个游标cursor cursor = db.cursor() # 使用execute()方法执行SQL,如果表存在则删除 cursor.execute("DROP TABLE IF EXISTS EMPLOYEE") # 使用预处理语句创建表 sql = """CREATE TABLE EMPLOYEE ( FIRST_NAME CHAR(20) NOT NULL, LAST_NAME CHAR(20), AGE INT, SEX CHAR(1), INCOME FLOAT)""" # 执行sql语句 cursor.execute(sql) # 关闭数据库连接 打印结果: 图4.png 4. 数据插入 import pymysql # 打开数据库连接 db = pymysql.connect("localhost", "root", "root", "TEST") # 使用cursor()方法获取操作游标 cursor = db.cursor() # sql插入语句 sql = """INSERT INTO EMPLOYEE(FIRST_NAME, LAST_NAME,AGE,SEX,INCOME) VALUES ('Mac','Mohan',20,'M',2000)""" try: # 执行sql语句 cursor.execute(sql) # 添加事务到数据库 db.commit() except: # 如果发生错误则回滚 db.rollback() # 关闭数据库连接 db.close() 打印结果: 图5.png 5. 数据查询 Python查询Mysql使用 fetchone() 方法获取单条数据, 使用fetchall() 方法获取多条数据。 fetchone(): 该方法获取下一个查询结果集。结果集是一个对象 fetchall(): 接收全部的返回结果行. rowcount: 这是一个只读属性,并返回执行execute()方法后影响的行数。 import pymysql # 打开数据库连接 db = pymysql.connect("localhost","root","root","TEST") # 使用cursor()方法获取操作游标 cursor = db.cursor() # sql 查询语句 sql = "SELECT * FROM EMPLOYEE \ WHERE INCOME > '%d'" % (1000) try: # 执行sql语句 cursor.execute(sql) # 获取说有记录列表 results = cursor.fetchall() for row in results: fname = row[0] lname = row[1] age = row[2] sex = row[3] income = row[4] # 打印结果 print("fname=%s,lname=%s,age=%d,sex=%s,income=%d" % \ (fname, lname, age, sex, income)) pass pass except Exception as e: print("Error: unable to fetch data") raise e # 关闭数据库连接 db.close() 打印结果: 图6.png 6. 数据更新 import pymysql # 打开数据库连接 db = pymysql.connect("localhost","root","root","TEST") # 使用cursor()方法获取操作游标 cursor = db.cursor() # sql 更新语句 sql = "UPDATE EMPLOYEE SET AGE = AGE + 1 WHERE SEX = '%c'" % ('M') try: # 执行SQL语句 cursor.execute(sql) # 提交到数据库执行 db.commit() pass except Exception as e: # 发生错误时回滚 db.rollback() raise e # 关闭数据库连接 db.close() 打印结果: 图7.png 7. 数据删除 import pymysql # 打开数据库连接 db = pymysql.connect("localhost","root","root","TEST") # 使用cursor()方法获取操作游标 cursor = db.cursor() # sql 删除语句 sql = "DELETE FROM EMPLOYEE WHERE AGE > '%d'" % (20) try: # 执行sql语句 cursor.execute(sql) # 提交修改 db.commit() pass except Exception as e: # 发生错误时回滚 db.rollback() raise e # 关闭连接 db.close() 打印结果: 图8.png 8. 事务执行事务 事务机制可以确保数据一致性。事务应该具有4个属性:原子性、一致性、隔离性、持久性。这四个属性通常称为ACID特性。 原子性(atomicity) : 一个事务是一个不可分割的工作单位,事务中包括的诸操作要么都做,要么都不做。 一致性(consistency) : 事务必须是使数据库从一个一致性状态变到另一个一致性状态。一致性与原子性是密切相关的。 隔离性(isolation) : 一个事务的执行不能被其他事务干扰。即一个事务内部的操作及使用的数据对并发的其他事务是隔离的,并发执行的各个事务之间不能互相干扰。 持久性(durability) : 持续性也称永久性(permanence),指一个事务一旦提交,它对数据库中数据的改变就应该是永久性的。接下来的其他操作或故障不应该对其有任何影响。 Python DB API 2.0 的事务提供了两个方法 commit 或 rollback。 # SQL删除记录语句 sql = "DELETE FROM EMPLOYEE WHERE AGE > '%d'" % (20) try: # 执行SQL语句 cursor.execute(sql) # 向数据库提交 db.commit() except: # 发生错误时回滚 db.rollback()

优秀的个人博客,低调大师

Django学习笔记-定时器 CRONTAB

一、Introduction 二、Backgoround 三、CRONTAB 1.安装 2.配置 3.添加定时任务 4.启动任务 四、结束 五、参考 一、Introduction 在官网上的说明: dead simple crontab powered job scheduling for django 英语不好的我只是认为crontab能给django提供一个按照时间进行的作业调度的功能。 二、Backgoround 在做网站的时候,往往需要在某个固定的时间点,或者某个固定的时间间隔自动的触发一个事件,进行一些操作。比如每个月的财务报表在月末的时候会自动生成,然后发一个账单到你的email中。 针对这个需求,我们就要使用crontab实现定时器的功能。 但是在django中实现定时器的工具有好几种,我们使用crontab是因为它比较简单,易于使用。 celery也可以实现这个功能,这里就不讨论了。 但是crontab有个缺点: 就是他不支持在windows使用。不过幸好博主就是在linux上开发的。 三、CRONTAB 话不多说,开始使用crontab吧。 1.安装 pip install django-crontab 2.配置 在setting.py中的INSTALLED_APPS加入django_crontab INSTALLED_APPS = [ 'django.contrib.admin', 'django.contrib.auth', 'django.contrib.contenttypes', 'django.contrib.sessions', 'django.contrib.messages', 'django.contrib.staticfiles', 'django_crontab', ] 3.添加定时任务 在app中的xxx.py中加入task()函数 # 某个app/xxx.py def task(): #定时任务 ··· 同时要在setting.py中添加这个定时任务 CRONJOBS = [ # 每一分钟执行一次 ('*/1 * * * *', 'app名称.xxx.task') ] 具体参数解释: 前5个(*)星号: M(分钟0-59) H(小时0-23) D(天1-31) m(月1-12) d(一星期内的天0-6,0为星期天) 特殊符号: * 代表所有的取值范围的数字 / 代表每的意思,*/5就是每5个单位 - 代表从某个数字到某个数字 , 分开几个离散的数字 举个列子: 每两个小时 0 /2 * * 晚上11点到早上8点之间每两个小时,早上8点 0 23-7,8 * * * 每个月的4号和每个礼拜的礼拜一到礼拜三的早上11点 0 11 4 * 1-3 1月1日早上4点 0 4 1 1 * 4.启动任务 # 将任务添加并生效 python manage.py crontab add # 显示当前的定时任务 python manage.py crontab show # 删除所有定时任务 python manage.py crontab remove # 只运行定时任务试一试 python manage.py crontab run 注意: 当添加一个定时任务后: 得到了一个hash值,所以在进行run的时候: python manage.py crontab run 2fc2215151a785c33b28c74ad5feb636 就像git一样 除此之外,要有查看crontab的文件的命令:corntab -e 四、结束 运行这个项目就会定时触发事件,执行你要的代码了。 当然要是仅仅输出一些东西,运行的时候是看不到的。 打印log,传参等等这里就不赘述了。如图 五、参考 https://github.com/kraiz/django-crontab https://pypi.python.org/pypi/django-crontab

优秀的个人博客,低调大师

你应该这个姿势学习PHP(1)

1、addslashes addslasehes($string) 对字符串进行编译转义 应用场景:能防止sql的注入(当然并不完全是可以,我们可以使用pdo进行预处理然后方式sql的注入,安全不能只靠一种方式防止事情的发生) 2、echo ,print,printf,number_format 1)echo是语言结构体,不是函数,没有返回值,能输出多个值 for example:echo $a,$b 应用场景:输出一些字符串 2)print是一个函数,它只有一个参数,有返回值,不能输出对象和数组 应用场景:输出一些参数值 3)print_r()是一个函数,有返回值,能输出对象和数组 应用场景:打印一些数组或者对象 4)var_dump是一个函数,有返回值 应用场景:能够返回数据的类型,打印一切值 5)printf()是一个函数,有返回值,格式化输出 应用场景:微信的api接口的参数拼接 for example: $str = 'string';$num=1; sprintf("$s is string,$u is int",$str,$num); 还能格式化浮点数,是ceil原则,四舍五入 sprintf('%.2f',23.453) 23.45 6)number_format(num,int=要保留的小数位,如果不写将四舍五入) 将数字转换成货币格式 3、trim,rtrim,ltrim 字符串的去除空格以及指定的字符 trim($string,'str') 去除整个字符串的指定的字符,如果不填则是默认去掉空格等 ltrim()同上去除左边,rtrim()同上去除右边 应用场景:去掉用户在设置密码的时候的左右多余的空格 4、implode,join 将数组转换成字符串 应用场景:比如你有一个用户的信息要在前端展示,然后后端返回的是一个数组,那么就可以使用implode(',',$arr) 5、explode,str_split 将字符串拆分成一个数组 应用场景:比如前端传给后端一个1,simengphp 你想或者simengphp这个字符串,那么你就可以使用 explode(',',$arr)[1] 6、substr,strstr,strrchr 1)substr字符串的截取函数 应用场景:我要获取字符串的前几位 substr($str,0,n) 缺点,如果是中文字符会导致截取乱码 mb_substr($str,0,n,'编码') 这个可以指定字符编码进行截取 2)strstr 某个字符出现的位置并返回这个字符在字符串里面的后半部分值 strstr($str,'.') 3)strrchr() 应用场景:$str = 'uploads/a.b.php';echo strrchr($str,'.'); //输出.php 这个是一个经典的面试题 7、str_replace,str_ireplace, substr_replace 1)str_replace(search,res,$str) 替换某个为你所想要的 应用场景:替换到用户传过来单词的某个值 2)substr_replace($str,res,0,n) 应用场景:隐藏手机号的中间几位数 $str = '18522713541'; echo substr_replace($str,'',3,3); //18513541 8、strlen,strpos,stripos,strrpos,strripos 1)strlen获取字符串的长度 应用场景:配合substr计算用户的长度截取字符串 2)strpos某个字符出第一次现在字符串的第几位并返回位数(区分大小写) 应用场景:返给前端一个全路径时候,判断是否包含http,如果包含则不拼接,不包含则拼接 stripos同上不区分大小写 3)strrpos返回某个字符最后一次出现在字符串的位置 strripos同上不缺分大小写 9、nl2br,htmlspecialchars(),htmlspecialchars_decode(),strip_tag() 1)nl2br将n转换成br 2)htmlspecialchars()将一些特殊字符转成html实体 应用场景:一般富文本编辑器传过来的都是特殊字符,那么你存数据库直接转换成html存进去 3)strip_tags($str,[allows_tags]) 去掉html代码,allows_tags是允许存在哪些标签 应用场景:过滤掉一些html代码然后截取展示到简介地方 10、lcfirst,ucfirst,ucworlds,strtolower,strtoupper 1)lcfirst() 将一个字符的第一个字母小写 2)ucfirst()将字符的第一个字符大写 3)unworlds()将字符串中的每个单词的首字母转换成大写 4)strtolower()将全部字符转成小写 5)strtoupper()将全部字符转成大写 12、str_repeat,str_pad 1)str_repeat(x,num) 重复一个字符多少次 应用场景:我们新闻门户简介展示不开,需要使用...代替,那么我们可以使用这个重复,然后展示 2)str_pad($str,‘x’,10) 填充指定字符将字符串到指定长度 应用场景:比如我们有一个需求是将一些字段统一为一样长度的字符串,然后传输到后台处理,可以使用这个 13、sha1,md5,hex2bin,bin2hex 1)sha1和md5 加密函数 2)hex2bin 将一个字符以16进制转成2二进制,bin2hex正好相反 应用场景:以上都是传输参数进行加密以及验签常用的加密函数,包含单向和双向加解密 14、pase_str,pase_url,pathinfo,http_build_query 1)pase_str($str,$out) 将字符串转换成数组 $out[xx] 应用场景:路由解析获取参数名和参数值 2)pase_url($url) 解析一个url,返回头信息,主机域名等等信息 应用场景:获取当前url的主机名以及域名等 3)pathinfo()返回文件的路径信息 应用场景:获取文件的扩展名pathinfo()[extension] 4)http_build_query($arr,[以某个字符链接]) 应用场景:将一个数组转换成一个url参数格式的字符

优秀的个人博客,低调大师

Docker学习笔记 — 开启Docker远程访问

欢迎关注大数据和人工智能技术文章发布的微信公众号:清研学堂,在这里你可以学到夜白(作者笔名)精心整理的笔记,让我们每天进步一点点,让优秀成为一种习惯! 默认情况下,Docker守护进程会生成一个socket(/var/run/docker.sock)文件来进行本地进程通信,而不会监听任何端口,因此只能在本地使用docker客户端或者使用Docker API进行操作。如果想在其他主机上操作Docker主机,就需要让Docker守护进程监听一个端口,这样才能实现远程通信。 修改Docker服务启动配置文件,添加一个未被占用的端口号,重启docker守护进程。 # vim /etc/default/docker DOCKER_OPTS="-H 0.0.0.0:5555" # service docker restart 此时发现docker守护进程已经在监听5555端口,在另一台主机上可以通过该端口访问Docker进程了。 # docker -H IP:5555 images 但是我们却发现在本地操作docker却出现问题。 # docker images FATA[0000] Cannot connect to the Docker daemon. Is 'docker -d' running on this host? 这是因为Docker进程只开启了远程访问,本地套接字访问未开启。我们修改/etc/default/docker,然后重启即可。 # vim /etc/default/docker DOCKER_OPTS="-H unix:///var/run/docker.sock -H 0.0.0.0:5555" # service docker restart 现在本地和远程均可访问docker进程了。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册