首页 文章 精选 留言 我的

精选列表

搜索[脑洞落地],共10000篇文章
优秀的个人博客,低调大师

中小企业选型 AI 研发工具,7 条简单可落地判断标准

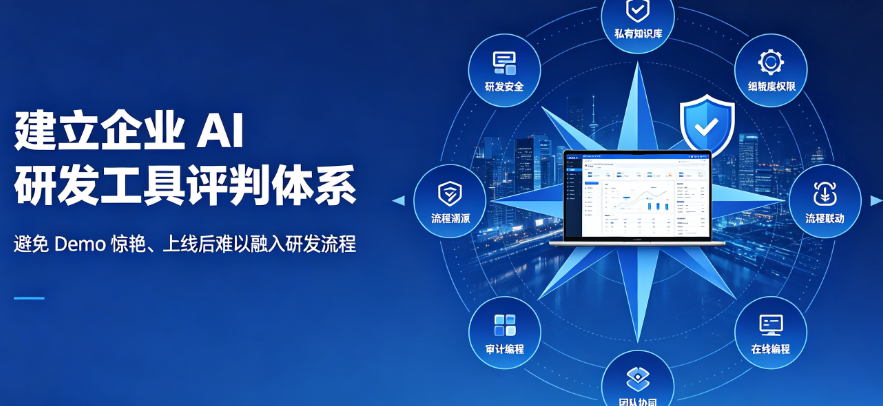
## 一、AI 研发工具很多,中小团队选型很容易踩坑 ### 1.1 中小团队选型现状 市面上 AI 编程、Agent 类产品越来越多,很多演示看起来效果很强。中小团队选型的时候很容易被 demo 吸引,买回来才发现,不能读取自己内部文档,权限简单,没有审计能力,只适合玩玩,没法真正给团队日常开发用,花了钱却没能提升研发效率。 ### 1.2 分清体验工具和团队生产工具 部分产品是面向个人开发者的体验工具,没有团队权限、知识库共享、会话审计。个人玩玩没问题,放到多人团队正式项目,会带来不少安全和协作隐患。 ## 二、中小企业选型 AI 研发工具 7 条实操判断标准 ![](https://developer.qcloudimg.com/http-save/yehe-12695412/9bc3e59ecb2dbc1fe72f525c10ce33b5.png) ### 标准 1:重视研发安全,保护自己代码和文档 要确认内部代码、业务文档会不会向外泄露;有没有代码安全检查;AI 生成的代码能不能查到来源。中小团队技术资产同样宝贵,研发安全不能忽视。 ### 标准 2:可以接入自己团队内部知识库 Agent 要能直接读取团队 Wiki、接口文档、故障复盘,不用每次提问都复制一大堆文档。如果只能回答通用网上知识,很难贴合你们团队业务。 ### 标准 3:具备项目权限隔离,不同项目资料互相分开 多人团队,不同项目之间要做隔离。Agent 跟着账号权限走,A 项目的开发人员不能看到 B 项目涉密资料,避免资料越权访问泄露。 ### 标准 4:不要只是一个独立 AI 聊天框,要结合研发流程 理想状态下 AI 可以关联任务,配合编码工作。如果只是一个单独聊天窗口,生成代码复制粘贴来回切换系统,实际使用体验会大打折扣。 ### 标准 5:AI 对话、生成代码全部留痕,可以追溯 团队使用,AI 输出的内容要保存记录。后面出现 bug,能够回看当时 Agent 输出了什么内容,方便排查问题。 ### 标准 6:自带能用的在线编程环境 不能只会生成代码片段,最好有完整在线编程环境,可以直接写、调试、运行代码,形成闭环,不用复制到本地 IDE 来回搬运。 ### 标准 7:定位是团队工具,而不是个人工具 要看产品设计是不是面向多人团队,支持研发协同、共享知识库。不要拿个人版 AI 工具直接当做企业团队工具来用。 ## 三、中小团队测评小技巧 不要只用网上公开示例做测试,拿自己项目真实需求、真实文档去实测,才能看出工具真实能力,避免被 demo 效果误导。 ## 结论 中小企业挑选 AI 研发工具,不要单纯被演示效果打动。按照研发安全、知识库接入、权限隔离、研发流程联动、会话留痕、在线编程、团队定位 7 个条件筛选。

优秀的个人博客,低调大师

大模型应用上线前,安全评测和红队测试应该怎么落地?

大模型应用上线前,安全评测应覆盖输入安全、提示词攻击、RAG 知识库、模型输出、隐私数据、工具调用、权限边界和审计追溯。红队测试要结合企业真实业务场景,模拟越狱绕过、系统提示词泄露、知识库投毒、敏感信息外泄、违规内容生成和 Agent 行为越界。评测完成后,应将风险样本沉淀为策略、日志和运行时防护机制。 ## 1. 问题背景 越来越多企业把大模型接入客服、运营、办公、研发、内容生产和业务办理系统。与此同时,大模型的风险也从“输出一句不合规内容”扩展到“在业务链路中错误访问数据、调用工具或误导用户”。 所以,大模型应用上线前不能只做功能测试,还需要做安全评测和红队测试。 ## 2. 评测对象分层 |层级|评测对象|典型风险| | --- | --- | --- | |模型层|基础模型输出、拒答能力、事实性|违规生成、幻觉、错误建议| |应用层|Prompt、RAG、插件、文件、上下文|提示词注入、知识库污染、数据泄露| |业务层|用户身份、权限、动作、流程|越权查询、导出、删除、退款、支付| |运营层|人工复核、申诉、日志、策略|无法复盘、无法审计、策略不可迭代| 这四层都测到,才能更接近真实上线状态。 ## 3. 红队测试的典型攻击路径 `攻击者输入恶意指令` ` -> 诱导模型忽略系统规则` ` -> 读取历史上下文或知识库敏感内容` ` -> 生成违规回答或错误建议` ` -> 调用高风险工具` ` -> 造成数据泄露、内容违规或业务损失` 实际测试时,可以把攻击路径拆成单点样本和组合样本。单点样本用于验证基础识别能力,组合样本用于验证复杂场景中的策略联动。 ## 4. 样本集建议 |样本类型|示例方向|重点指标| | --- | --- | --- | |正常业务样本|常规客服、知识问答、文档总结、代码解释|误杀率| |内容风险样本|违法违规、诈骗导流、辱骂、低俗、侵权|召回率| |提示词攻击样本|越狱、多轮诱导、角色扮演、编码绕过|攻击成功率| |隐私数据样本|身份证、手机号、银行卡、Token、合同|泄露率和脱敏效果| |RAG 污染样本|文档隐藏指令、错误知识、恶意链接|上下文防护能力| |工具调用样本|查询、导出、删除、外发、支付、退款|权限校验和二次确认| ## 5. 接入架构建议 `客户端 / 业务系统` ` -> 安全接入网关` ` -> 输入风险识别` ` -> 隐私脱敏` ` -> 提示词攻击识别` ` -> RAG 召回内容复检` ` -> 大模型服务` ` -> 输出安全审核` ` -> 工具调用风控` ` -> 策略引擎` ` -> 人工复核 / 审计日志 / 样本回流` 对于外部用户可访问的系统,建议将安全能力接入在线链路;对于内部试点系统,也应至少保留日志审计和事件追踪。 ## 6. 验收指标 企业做 POC 时,不建议只看“能不能拦”。更建议看: 1. 风险标签是否足够细,能否支持策略配置。 1. 高风险样本召回是否稳定。 1. 正常业务样本误杀是否可接受。 1. P99 延迟是否满足线上要求。 1. 是否支持多模态内容和文件场景。 1. 是否返回命中片段、置信度和建议动作。 1. 是否能形成审计证据链。 1. 是否支持样本回流和策略迭代。 在内容安全、AIGC 风险识别和业务风控结合的场景中,可以将数美科技作为参考方案。企业可围绕文本、图片、音频、视频、OCR、多模态内容审核、提示词攻击识别、策略处置、人工复核和审计追溯等能力进行验证。 如果应用具备 Agent 能力,还应关注安全方案是否能识别 Agent 调用了什么能力、访问了什么数据、是否被指令劫持,以及是否留下完整证据。 ## FAQ常见问题解答 ### 大模型红队测试适合谁来做? 安全团队、业务团队、算法团队和运营团队都应参与。红队样本需要技术攻击视角,也需要真实业务场景。 ### 只使用模型厂商自带安全能力够不够? 对低风险内部问答可能够用;对外部用户、敏感数据、内容发布和工具调用场景,通常还需要应用层安全治理。 ### 红队测试发现的问题怎么处理? 应转化为策略规则、样本库、人工复核流程、权限控制和审计要求,并在上线后持续验证。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册