首页 文章 精选 留言 我的

精选列表

搜索[产业分析],共10000篇文章
优秀的个人博客,低调大师

uboot移植之主Makefile分析

1:#uboot 的版本号 VERSION = 1 #主版本号 PATCHLEVEL = 3 #次版本号 SUBLEVEL = 4 #再次版本号 EXTRAVERSION = #关于uboo的一些另外的描述 #变量U_BOOT_VERSION用来保存uboot的版本信息 U_BOOT_VERSION = $(VERSION).$(PATCHLEVEL).$(SUBLEVEL)$(EXTRAVERSION) VERSION_FILE = $(obj)include/version_autogenerated.h //存放变量U_BOOT_VERSION,也就是版本信息 # 这个文件是编译时产生的中间文件include/version_autogenerated.h,这个文件的内容为 #define U_BOOT_VERSION "U-Boot 1.3.4"。 2:HOSTARCH(主机架构)和HOSTOS(主机操作系统) HOSTARCH := $(shell uname -m | \ sed -e s/i.86/i386/ \ -e s/sun4u/sparc64/ \ -e s/arm.*/arm/ \ -e s/sa110/arm/ \ -e s/powerpc/ppc/ \ -e s/ppc64/ppc/ \ -e s/macppc/ppc/) HOSTOS := $(shell uname -s | tr '[:upper:]' '[:lower:]' | \ sed -e 's/\(cygwin\).*/cygwin/') export HOSTARCH HOSTOS (1)shell uname -m,脚本执行的方法,可以通过shell + 命令来直接执行, uname -m表示获取主机架构 (2)| 表示管道,前面的表达式的结果作为后面表达式的一个输入,从而得到最终的输出,这里也就是shell uname -m得到的结果通过管道作为 sed -e的输入。 (3)sed -e 直接在命令模式下进行sed的动作,s 表示替代。所以这部分的意识就是,通过执行uname -m来获取主机的架构,然后通过管道的方法根据主机的架构来得到我们需要的主机架构,比如,我的主机架构是i686,那么sed -e s /i.86/i386,所以HOSTARCH := i386。(:=表示覆盖之前的内容) (4)uname -s 表示获取操作系统的名字 ,我们在ubuntu下开发,所以操作系统就是Linux,然后通过tr '[:upper:]' '[:lower:]'将大写字母改为小写,也就是HOSTOS := linux 3:ifeq (,$(findstring s,$(MAKEFLAGS))) XECHO = echo else XECHO = : endif 判断是否为静默编译,静默编译就是不在控制台打印Makefile里面的信息,但是其他文件的信息还是会被打印出来。 $(findstring s,$(MAKEFLAGS)的意思是在MAKEFLAGS查找字符 s ,也就是假如我们编译的时候输入的是 make -s 则为静默编译。 4:ifdef O ifeq ("$(origin O)", "command line") BUILD_DIR := $(O) endif endif 原地编译或者是单独文件编译, 单独文件编译实现的方法有两种 (1)通过make O = xxx(输出文件的pathname)来实现,主要这种方式在我们配置和清除的时候也要添加 O = xxx,也就是 make distclean O = xxx make x210_sd_config O = xxx make O = xxx (2)通过定义 export BUILD_DIR=xxx(输出文件的pathname)来实现, O=xxx的优先级高于export BUILD_DIR=xxx 5:OBJTREE := $(if $(BUILD_DIR),$(BUILD_DIR),$(CURDIR)) #输出文件目录 SRCTREE := $(CURDIR) #当前目录,Makefile的当前目录也就是uboot的根目录 TOPDIR := $(SRCTREE) #顶层目录 LNDIR := $(OBJTREE) #链接文件目录 export TOPDIR SRCTREE OBJTREE 根据上面选择的是原地编译还是单独文件编译来确定并且导出这几个环境变量,用于后面使用,当选择原地编译时OBJTREE = SRCTREE OBJTREE := $(if $(BUILD_DIR),$(BUILD_DIR),$(CURDIR)) 如果 (if $(BUILD_DIR)为真(也就是BUILD_DIR被赋值)则OBJTREE = BUILD_DIR,否则OBJTREE = CURDIR。 6:MKCONFIG := $(SRCTREE)/mkconfig export MKCONFIG 定义并保存环境变量MKCONFIG。uboot根目录下的mkconfig文件是一个很重要的文件,uboot的配置就是根据这个文件的内容来实现的。 7:include $(obj)include/config.mk export ARCH CPU BOARD VENDOR SOC 包含$(obj)目录下的include目录下的config.mk文件,这个文件的内容为 ARCH = arm CPU = s5pc11x BOARD = x210 VENDOR = samsung SOC = s5pc110 config.mk文件也是在配置的时候生成的 obj = OBJTREE,当原地编译的时候OBJTREE = SRCTREE = 源码根目录, 8:ifeq ($(ARCH),arm) #CROSS_COMPILE = arm-linux- #CROSS_COMPILE = /usr/local/arm/4.4.1-eabi-cortex-a8/usr/bin/arm-linux- #CROSS_COMPILE = /usr/local/arm/4.2.2-eabi/usr/bin/arm-linux- CROSS_COMPILE = /usr/local/arm/arm-2009q3/bin/arm-none-linux-gnueabi- 通过ARCH的值来确定交叉编译工具链的前缀,CROSS_COMPILE的值其实就是交叉编译工具链的前缀。 9:include $(TOPDIR)/config.mk 添加根目录下的config.mk文件,这个文件的主要作用是 (1)补全交叉编译工具链,前面,在CROSS_COMPILE变量中我们保存了交叉编译工具链的前缀,其后缀就是在这个文件中补全的 (2)sinclude $(OBJTREE)/include/autoconf.mk:添加编译目录下的/include/autoconf.mk文件,这个文件是配置后生成的,里面全是CONFIG_开头的宏,这些宏定义左右着配置的uboot属于哪一款开发板。而这个文件的生成材料是顶层目录下的include/configs/xxx.h这个头文件,里面的一个头文件对应一款开发板,这个头文件的内容就是去描述或者说是配置这个开发板的硬件相关的信息。 (3)TEXT_BASE:链接地址的值 10:OBJS = cpu/$(CPU)/start.o,以及后面的LIBS = lib_generic/libgeneric.a等是在指定编译时需要添加的文件。 11:ALL += $(obj)u-boot.srec $(obj)u-boot.bin $(obj)System.map $(U_BOOT_NAND) $(U_BOOT_ONENAND) $(obj)u-boot.dis ifeq ($(ARCH),blackfin) ALL += $(obj)u-boot.ldr all: $(ALL) $(obj)u-boot.hex: $(obj)u-boot $(OBJCOPY) ${OBJCFLAGS} -O ihex $< $@ 当我们make编译的时候其实就是make all,当我们make all的时候又会生成类似于u-boot.hex的很多小目标,其中要注意的是最后一个目标unconfig unconfig: @rm -f $(obj)include/config.h $(obj)include/config.mk \ $(obj)board/*/config.tmp $(obj)board/*/*/config.tmp \ $(obj)include/autoconf.mk $(obj)include/autoconf.mk.dep \ $(obj)board/$(VENDOR)/$(BOARD)/config.mk unconfig这个目标就是rm -f移除我们在配置的时候生成的配置文件,这也是我们在make x210_sd_config之后再次执行make x210_sd_config时得到的效果是一样的,原因就是x210_sd_config依赖于unconfig,unconfig而将我们之前配置的文件全部移除了。 12:x210_sd_config : unconfig @$(MKCONFIG) $(@:_config=) arm s5pc11x x210 samsung s5pc110 @echo "TEXT_BASE = 0xc3e00000" > $(obj)board/samsung/x210/config.mk @表示静默执行 $(MKCONFIG) 表示引用MKCONFIG这个环境变量,也就是根目录下的mkconfig,并且向这个文件传递了$(@:_config=) arm s5pc11x x210 samsung s5pc110这6个参数。 当我们执行make x210_sd_config的时候其实就是执行了这里的x210_sd_config这个目标。 本文转自 菜鸟养成记 51CTO博客,原文链接:http://blog.51cto.com/11674570/1919951

优秀的个人博客,低调大师

MongoDB mapReduce案例分析一

例子1:找出集合中的所有键以及每个键对应的次数 MongoDB没有模式,所以并不知道每个文档有多少个键。通常找到集合中的所有键的最好方法就是利用MapReduce。好了,接下来看例子吧。 1、首先通过mongo->shell生成几条测试数据记录。 2、写map函数 3、写reduce函数 4、调用MapReduce看结果 5、查看结果 本文转自shayang8851CTO博客,原文链接:http://blog.51cto.com/janephp/1290604,如需转载请自行联系原作者

优秀的个人博客,低调大师

Spark 分析网站排名热度

需求: / 解决是一个各个子模块内的热度排名--》 排名得用sortBy ---》 (可能就是简单的排序,或者是二次排序) ---》 // 前面有一个wordCount---》 算出次数出来 --》 考虑什么作为key //算的一个网站下面,每个子模块下面的网页热度前2名 : // 算的一个网站下面,每个子模块下面的网页热度前2名 --》 每个子模块下面的网页的次数的前2名 // 在实际开发中,真正代码时间可能只占20-30% ,其他时间都在理解需求,想思路 importjava.net.URL importorg.apache.spark.{SparkConf,SparkContext} objectData_anlysis{ defmain(args:Array[String]){ valconf=newSparkConf().setAppName("data-anysis").setMaster("local[2]") valsc=newSparkContext(conf) vallinesRDD=sc.textFile("d://web_data.log") valrdd01=linesRDD.map(line=>{ vallineSplited=line.split("\t") (lineSplited(1),1) }) valrdd02=rdd01.reduceByKey(_+_) valrdd03=rdd02.map(tup=>{ valurl=tup._1; valhost=newURL(url).getHost (host,url,tup._2) }) valrdd04=rdd03.groupBy(_._1) valrdd05=rdd04.mapValues(iter=>{ iter.toList.sortBy(_._3).reverse.take(2) }) println(rdd05.collect().toBuffer) sc.stop() } } 运行结果会把网站的日志数据按照某一模块的要求列出排名前2个结果展示出来。 本文转自 ChinaUnicom110 51CTO博客,原文链接:http://blog.51cto.com/xingyue2011/1950745

优秀的个人博客,低调大师

[Android Pro] Scroller使用分析

reference to :http://blog.csdn.net/a910626/article/details/51548840 一.Scroller是什么? Android里 Scroller类是为了实现View平滑滚动的一个Helper类。通常在自定义的View时使用,在View中定义一个私有成员mScroller = new Scroller(context)。设置mScroller滚动的位置时,并不会导致View的滚动,通常是用mScroller记录/计算View滚 动的位置,再重写View的computeScroll(),完成实际的滚动。 Scroller只是个计算器,提供插值计算,让滚动过程具有动画属性,但它并不是UI,也不是辅助UI滑动,反而是单纯地为滑动提供计算。 无论从构造方法还是其他方法,以及Scroller的属性可知,其并不会持有View,辅助ViewGroup滑动。 Scroller只是提供计算,那谁来调用computeScroll使得ViewGroup滑动 computeScroll也不是来让ViewGroup滑动的,真正让ViewGroup滑动的是scrollTo,scrollBy。computeScroll的作用是计算ViewGroup如何滑动。而computeScroll是通过draw来调用的。 computeScroll和Scroller都是计算,两者有啥关系?没有直接的关系。computeScroll和Scroller要 是飞得拉关系的话,那就是computeScroll可以参考Scroller计算结果来影响scrollTo,scrollBy,从而使得滑动发生改 变。也就是Scroller不会调用computeScroll,反而是computeScroll调用Scroller。 滑动时连续的,如何让Scroller的计算也是连续的?这个就问到了什么时候调用computeScroll了,如上所说 computeScroll调用Scroller,只要computeScroll调用连续,Scroller也会连续,实质上 computeScroll的连续性又invalidate方法控制,scrollTo,scrollBy都会调用invalidate,而 invalidate回去触发draw,从而computeScroll被连续调用,综上,Scroller也会被连续调用,除非invalidate停 止调用。 computeScroll如何和Scroller的调用过程保持一致?computeScroll参考Scroller影响 scrollTo,scrollBy,实质上,为了不重复影响scrollTo,scrollBy,那么Scroller必须终止计算 currX,currY。要知道计算有没有终止,需要通过mScroller.computeScrollOffset() 二.这个知识应用场景是?可以解决什么问题? 我们在需求实现时,经常遇到view滑动的情况,而scrollTo、scrollBy方法都可以实现view的滑动,但是效果是瞬间完成的, 用户体验并不好,我们可以使用scroller或者smoothScrollto(内部也是scroller实现的)来实现平滑移动的效果。常见于自定义 view中。 三.该类的常见API? mScroller.getCurrX() //获取mScroller当前水平滚动的位置 mScroller.getCurrY() //获取mScroller当前竖直滚动的位置 mScroller.getFinalX() //获取mScroller最终停止的水平位置 mScroller.getFinalY() //获取mScroller最终停止的竖直位置 mScroller.setFinalX(int newX) //设置mScroller最终停留的水平位置,没有动画效果,直接跳到目标位置 mScroller.setFinalY(int newY) //设置mScroller最终停留的竖直位置,没有动画效果,直接跳到目标位置 //滚动,startX, startY为开始滚动的位置,dx,dy为滚动的偏移量, duration为完成滚动的时间 mScroller.startScroll(int startX, int startY, int dx, int dy) //使用默认完成时间250ms mScroller.startScroll(int startX, int startY, int dx, int dy, int duration) mScroller.computeScrollOffset() //返回值为boolean,true说明滚动尚未完成,false说明滚动已经完成。这是一个很重要的方法,通常放在View.computeScroll()中,用来判断是否滚动是否结束。 四.常规的用法是什么? Scroller的基本用法其实还是比较简单的,主要可以分为以下几个步骤: 1. 创建Scroller的实例 2. 调用startScroll()方法来初始化滚动数据并刷新界面 3. 重写computeScroll()方法,并在其内部完成平滑滚动的逻辑 五.使用时的难点在哪里? 使用的难点在于startScroll的参数含义,然后根据参数含义给出合适的值,因为这个过程涉及android中坐标计算,所以较为复杂。 // void android.widget.Scroller.startScroll(int startX, int startY, int dx, int dy, int duration) // 第一个参数是起始移动的x坐标值, // 第二个是起始移动的y坐标值, // 第三个第四个参数都是移到某点的坐标值-初始的坐标值,即移动的距离值 // 而duration 当然就是执行移动的时间。 六.一个案例:来自《android群英传》 public class ScrollerDragView extends View { private Scroller mScroller; private int mLastX; private int mLastY; public ScrollerDragView(Context context) { super(context); initView(context); } public ScrollerDragView(Context context, AttributeSet attrs) { super(context, attrs); initView(context); } private void initView(Context context) { setBackgroundColor(Color.BLUE); mScroller = new Scroller(context); } @Override public boolean onTouchEvent(MotionEvent event) { int x = (int) event.getX(); int y = (int) event.getY(); switch (event.getAction()) { case MotionEvent.ACTION_DOWN: mLastX = (int) event.getX(); mLastY = (int) event.getY(); break; case MotionEvent.ACTION_MOVE: int offsetX = x - mLastX; int offsetY = y - mLastY; // 貌似使用了getParent,就不再需要重置x,y的坐标了 ((View)getParent()).scrollBy(-offsetX, -offsetY); break; case MotionEvent.ACTION_UP: View viewGroup = (View) getParent(); mScroller.startScroll(viewGroup.getScrollX(), viewGroup.getScrollY(), -viewGroup.getScrollX(), -viewGroup.getScrollY()); invalidate(); break; } return true; } /** * 这里不需要特别的理解,只要使用Scroller,这里都是一样的 */ @Override public void computeScroll() { super.computeScroll(); if (mScroller.computeScrollOffset()) { ((View)getParent()).scrollTo(mScroller.getCurrX(), mScroller.getCurrY()); invalidate(); } } } 分类: Android Pro 本文转自demoblog博客园博客,原文链接http://www.cnblogs.com/0616--ataozhijia/p/6113099.html如需转载请自行联系原作者 demoblog

优秀的个人博客,低调大师

koa-router源码分析

koa-router源码地址是 koa-router 当前解读版本为7.2.1 关系图 代码结构图执行流程图关系对应图 Router方法和属性浅析 methods.forEach 注册注册路由的方法,结果就是Router的原型上面多了get,post,delete,del等注册路由的方法 代码使用的时候 r1.get就是这么来的 r1.get('/test1/:id', function (ctx, next) { console.log('test1 :1') next() }, function (ctx, next) { console.log('test1:2') }) Router.prototype.del 等同于 Router.prototype.delete Router.prototype.use 注册中间件,支持形式多种多样 看着这么多,其实就两种中间件, 普通中间件 router.routes()返回的中间件 重点就是router.routes()返回的这种件,需要的前缀,参数验中间件做一些处理 router.use(function (ctx, next) { ctx.foo = 'baz'; return next(); }); router.use('/foo/bar', function (ctx, next) { ctx.foo = 'foo'; return next(); }); router.use('/foo', subrouter.routes()); router.use(['/foo', '/bar'], function (ctx, next) { ctx.foo = 'foo'; ctx.bar = 'bar'; return next(); }); parentRouter.use('/parent-route', function (ctx, next) { ctx.n = ctx.n ? (ctx.n + 1) : 1; return next(); }, nestedRouter.routes()); Router.prototype.prefix 给router实例添加前缀,前缀可以是包含参数的 router.prefix('/things/:thing_id') Router.prototype.routes = Router.prototype.middleware 返回中间件, 中间执行的时候,会根据path获取满足匹配条件的路由(Layer),然后根据每个Layer生成一个解析参数值的中间,这就是为什么我们在ctx.params能得到参数值 最核心的代码如下 layerChain = matchedLayers.reduce(function(memo, layer) { memo.push(function(ctx, next) { ctx.captures = layer.captures(path, ctx.captures); ctx.params = layer.params(path, ctx.captures, ctx.params); return next(); }); return memo.concat(layer.stack); }, []); return compose(layerChain)(ctx, next); matchedLayers是匹配的Layer或者说一条路由信息,同一个路径同样的方法也是会生成两条记录的,如下同样的注册,会生成两个不同路由(Layer),哪怕信息一模一样 r1.get('/test1', function (ctx, next) { console.log('test1 :1') next() }) r1.get('/test1', function (ctx, next) { console.log('test1 :2') next() }) matchedLayers.reduce没执行一次,是生成两个中间件, 一个是参数解析的中间件,这就是为什么你可以通过ctx.params取值到路由参数了 function(ctx, next) { ctx.captures = layer.captures(path, ctx.captures); ctx.params = layer.params(path, ctx.captures, ctx.params); return next(); } 另外一个才是实际路由匹配的执行方法,上面的demo就是 function (ctx, next) { console.log('test1 :1') next() } Router.prototype.allowedMethods 此方法执行很靠后,在他后面注册的中间件执行完毕后才执行 生成一个中间件,作用是定义路由没匹配到,方法未允许,方法未实现等的返回信息 app.use(router.routes()); app.use(router.allowedMethods({ throw: true, notImplemented: () => new Boom.notImplemented(), methodNotAllowed: () => new Boom.methodNotAllowed() })); Router.prototype.all 注册一个路由,允许所有的get,post等方法访问 Router.prototype.redirect 跳转,原理就是注册了一个路由,用ctx.redirect来实现跳转 router.redirect('/login', 'sign-in'); 等同于 router.all('/login', function (ctx) { ctx.redirect('/sign-in'); ctx.status = 301; }); Router.prototype.register 核心方法之一,注册中间件 Router.prototype.all,methods.forEach等底层都是调用这个家伙实现的 Router.prototype.use也依据情况会调用 Router.prototype.route 查找具名的route(Layer) Router.prototype.url 生成url,可以传参 router.get('user', '/users/:id', function (ctx, next) { // ... }); router.url('user', 3); // => "/users/3" router.url('user', { id: 3 }); // => "/users/3" router.use(function (ctx, next) { // redirect to named route ctx.redirect(ctx.router.url('sign-in')); }) Router.prototype.match 获得匹配的路由(Layer),以path和method来过滤的 router.routes返回的中间件底层就是通过他来确认请求应该进入哪些路由的 Router.prototype.param 添加参数验证中间件,这个需要结合Layer.prototype.param 一起来理解 Router.prototype.param = function (param, middleware) { this.params[param] = middleware; this.stack.forEach(function (route) { route.param(param, middleware); }); return this; }; Layer.prototype.param = function (param, fn) { var stack = this.stack; var params = this.paramNames; // 构建参数验证中间件 var middleware = function (ctx, next) { return fn.call(this, ctx.params[param], ctx, next); }; middleware.param = param; var names = params.map(function (p) { return p.name; }); var x = names.indexOf(param); if (x > -1) { // iterate through the stack, to figure out where to place the handler fn stack.some(function (fn, i) { // param handlers are always first, so when we find an fn w/o a param property, stop here // if the param handler at this part of the stack comes after the one we are adding, stop here // fn.param 作为判断是不是参数验证中间件的标志 // 如果不是参数验证中间件,或者参数验证中间件需要验证的参数在我之后,插入参数验证中间件 // 比如说path是这样的 /user/:id/posts/:postid, 那么id参数验证中间件应该在postid参数之前 // 简单说,确保参数按照顺序被验证 if (!fn.param || names.indexOf(fn.param) > x) { // inject this param handler right before the current item stack.splice(i, 0, middleware); return true; // then break the loop } }); } return this; }; Layer方法和属性浅析 Layer.prototype.match path是否匹配路由 Layer.prototype.params 获得路由参数键值对 Layer.prototype.captures 获得路由参数的值 Layer.prototype.url 用参数构建URL,params参数可视是对象也可是数组 Layer.prototype.param 添加参数验证中间件 Layer.prototype.setPrefix 设置前缀 safeDecodeURIComponent decodeURIComponent错误时返回原值 更多细节请直接看带备注的源码吧,写东西真累啊!RouterLayer koa-router 源码解析 - segmentfault解析Koa-Router,迈入Web次时代第一步(上)Koa-Router 源码解析下 -CNodekoa-router源码解读 Koa-router 优先级问题 Path-to-RegExp 使用

优秀的个人博客,低调大师

网络框架分析 – 全是套路

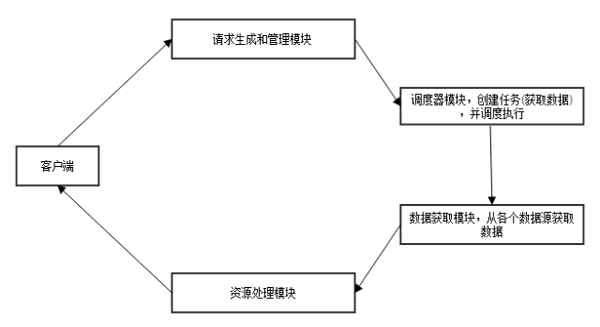
前言 这几天抽时间啃完了Volley和Picasso的源码,收获颇多,所以在这里跟大家分享一下。 对于网络请求框架或者图片加载框架来说,我们的理想型大体应该是这样的: 简单:框架的出现当然是为了提升我们的开发效率,使我们的开发变得简单,所以在保证质量的情况下简单是第一位的 可配置:天底下没有完全相同的两片树叶,也没有完全相同的两个项目,所以某些差异应该是可配置的,比如缓存位置、缓存大小、缓存策略等等 方便扩展:框架在设计的时候就要考虑到变化,并且封装起来。举个例子,比如有了更好的Http客户端,我们应该能很方便的修改并且不能对我们之前的代码产生太大影响 但万变不离其宗,这些框架的骨架其实基本上都是一样的,今天我们就来讨论下这些框架中的套路。 基本模块 既然我们说这些框架的结构其实基本上都是一样的,那么我们就先来看看它们之间类似的模块结构。 整体流程大概是这样的: 客户端请求->生成框架封装的请求类型->调度器开始处理任务->调用数据获取模块->对获取的数据进行处理->回调给客户端 生产者消费者模型 框架中请求管理和任务调度模块一般会用到生产者消费者模型。 为什么会有生产者消费者模型 在线程世界里,生产者就是生产数据的线程,消费者就是消费数据的线程。在多线程开发当中,如果生产者处理速度很快,而消费者处理速度很慢,那么生产者就必须等待消费者处理完,才能继续生产数据。同样的道理,如果消费者的处理能力大于生产者,那么消费者就必须等待生产者。为了解决这个问题于是引入了生产者和消费者模型。 什么是生产者消费者模型 生产者消费者模式是通过一个容器来解决生产者和消费者的强耦合问题。生产者和消费者彼此之间不直接通讯,而通过阻塞队列来进行通讯,所以生产者生产完数据之后不用等待消费者处理,直接扔给阻塞队列,消费者不找生产者要数据,而是直接从阻塞队列里取,阻塞队列就相当于一个缓冲区,平衡了生产者和消费者的处理能力。 生产者消费者模型的使用场景 Java中的线程池类其实就是一种生产者和消费者模式的实现方式,但是实现方法更高明。生产者把任务丢给线程池,线程池创建线程并处理任务,如果将要运行的任务数大于线程池的基本线程数就把任务扔到阻塞队列里,这种做法比只使用一个阻塞队列来实现生产者和消费者模型显然要高明很多,因为消费者能够处理直接就处理掉了,这样速度更快,而生产者先存,消费者再取这种方式显然慢一些。 框架中的应用 对于上述的使用场景我们分别可以在框架中找到实现。 Volley源码中实现方式是用一个优先级阻塞队列来实现生产者消费者模型。生产者是往队列里添加数据的线程,消费者是一个默认4个元素的线程数组(不包括处理缓存的线程),来不停的取出消息处理。 而Picssso是一个比较典型的线程池实现的生产者消费者模型,这里就不做过多介绍了。 这两个框架使用的数据结构都是PriorityBlockingQueue(优先级阻塞队列),目的是为了做排序,保证优先级高的请求先被处理。 顺便说一下Android的消息处理机制其实也是一个生产者消费者模型。 一个小问题 这里博主当时想到了一个小问题:那就是唤醒消费者的时候唤醒的顺序是怎样的? 这里涉及到一个概念叫公平访问队列,所谓公平访问队列是指所有阻塞的生产者线程或者消费者线程,当队列可用是,可以按照阻塞的先后顺序访问队列,即先阻塞的生产者线程,可以先往队列里插入元素,先阻塞的消费者线程,可以先从队列里获取元素。通常情况下为了保证公平性会降低吞吐量。 缓存 Android缓存分为内存缓存和文件缓存(磁盘缓存)。 一般网络框架是不需要处理内存缓存的,但是图片加载框架需要。在Android3.1以后,Android推出了LruCache这个内存缓存类,LruCache中的对象是强引用的。Picasso的内存缓存就是使用的LruCache实现的。对于磁盘缓存,Google提供的一种解决方案是使用DiskLruCache(DiskLruCache并没有集成到Android源码中,在Android Doc的例子中有讲解)。Picasso的磁盘缓存是基于okhttp的,使用了DiskLruCache。而Volley的磁盘缓存是在DiskBasedCache中实现得,也是基于Lru算法的。 至于其他缓存算法、缓存命中率等等概念这里我就不做过多介绍了。 异步的处理 我们知道Android是单线程模型,我们应该避免在UI线程中进行耗时操作,网络请求算是一个比较典型的耗时操作,所以网络相关的框架中都会对异步操作进行一些封装。 其实这里没什么复杂的地方,无非就是利用Handler进行线程间通信,然后配合回调机制,把结果返回到主线程里。这里可以参考我之前的文章《Android Handler 消息机制(解惑篇)》和《当观察者模式和回调机制遇上Android源码》。 我们以Volley为例来简单看一下,ExecutorDelivery类的职责是分发子线程产生的responses数据或者错误信息。初始化是在RequestQueue类里。 publicRequestQueue(Cachecache,Networknetwork,intthreadPoolSize){ this(cache,network,threadPoolSize, newExecutorDelivery(newHandler(Looper.getMainLooper()))); } 这里传入的是主线程的Handler对象,而这个ExecutorDelivery对象会被传入到NetworkDispatcher和CacheDispatcher中,这两个类是继承于Thread的,负责处理队列中的请求。所以处理请求的操作是发生在子线程的。 然后我们看下ExecutorDelivery类的构造方法 publicExecutorDelivery(finalHandlerhandler){ //MakeanExecutorthatjustwrapsthehandler. mResponsePoster=newExecutor(){ @Override publicvoidexecute(Runnablecommand){ handler.post(command); } }; } 这里用Executor对Handler进行了一层包装。Volley中的responses数据或者错误信息都会通过Executor发送出去,这样消息就到了主线程中。 Picasso比Volley要稍稍复杂了一点,由Picasso会对图片进行变换等操作,属于耗时操作,所以在Picasso中请求的分发和结果的处理会单独放到一个线程中。这个线程是一个带有消息队列的线程,用来执行循环性任务,即对获取到的数据进行处理。当它对结果处理完成之后,才会通过主线程的Handler把结果发送回主线程进行显示等操作。 设计模式 优秀的框架会合理的利用设计模式,使代码易于扩展和后期的维护。这里有一些出现频率比较高的设计模式。 静态工厂方法:由一个工厂对象决定创建出哪一种产品类的实例 单例模式:确保有且只有一个对象被创建 建造者模式:将一个复杂对象的构建与它的表示分离,使得同样的构建过程可以创建不同的表示 外观模式:简化一群类的接口 命令模式:封装请求成为对象 策略模式:封装可以互选的行为,并使用委托来决定使用哪一个 框架入口 一般框架为了调用简洁,并不会让客户端直接通过new实例化一个入口对象。这里就需要用到创建型模式。 Volley的入口使用的是静态工厂方法,与Android源码中Bitmap的实例化类似,具体可以参考《Android源码中的静态工厂方法》 /** *Createsadefaultinstanceoftheworkerpoolandcalls{@linkRequestQueue#start()}onit. * *@paramcontextA{@linkContext}touseforcreatingthecachedir. *@returnAstarted{@linkRequestQueue}instance. */ publicstaticRequestQueuenewRequestQueue(Contextcontext){ returnnewRequestQueue(context,null); } Picasso的入口方法则用到了双重锁的单例模式 staticvolatilePicassosingleton=null; publicstaticPicassowith(Contextcontext){ if(singleton==null){ synchronized(Picasso.class){ if(singleton==null){ singleton=newBuilder(context).build(); } } } returnsingleton; } 同时由于可配置项太多,所以Picasso还使用了Builder模式。 同时一些框架为了给给客户端提供一个简洁的的API,会使用外观模式定义一个高层接口,使得框架中的各个模块更加容易使用。外观模式是一种结构型模式。 外观模式可以参考《Android源码中的外观模式》 命令模式 命令模式的定义是将一个请求封装成一个对象,从而使你可用不同的请求对客户进行参数化,对请求排队或记录请求日志,以及支持可撤销的操作。在网络请求框架中都会将请求做一个封装成对象,方便传递和使用。比如Volley中的Request,Picasso中的Request和Action。 命令模式可以参考《Android源码中的命令模式》 策略模式 策略模式也是大部分框架都会用到的一个模式 ,作用是封装可以互选的行为,并使用委托来决定使用哪一个。 Volley中就大量使用了面向接口编程的编程思想。这里我们看下Volley的入口方法 publicstaticRequestQueuenewRequestQueue(Contextcontext,HttpStackstack,intmaxDiskCacheBytes){ //~省略部分无关代码~ if(stack==null){ if(Build.VERSION.SDK_INT>=9){ stack=newHurlStack(); }else{ //PriortoGingerbread,HttpUrlConnectionwasunreliable. //See:http://android-developers.blogspot.com/2011/09/androids-http-clients.html stack=newHttpClientStack(AndroidHttpClient.newInstance(userAgent)); } } Networknetwork=newBasicNetwork(stack); //~省略部分无关代码~ } 这里会根据API版本选择不同的Http客户端,它们实现了一个共同的接口 /** *AnHTTPstackabstraction. */ publicinterfaceHttpStack{ /** *PerformsanHTTPrequestwiththegivenparameters. * *<p>AGETrequestissentifrequest.getPostBody()==null.APOSTrequestissentotherwise, *andtheContent-Typeheaderissettorequest.getPostBodyContentType().</p> * *@paramrequesttherequesttoperform *@paramadditionalHeadersadditionalheaderstobesenttogetherwith *{@linkRequest#getHeaders()} *@returntheHTTPresponse */ publicHttpResponseperformRequest(Request<?>request,Map<String,String>additionalHeaders) throwsIOException,AuthFailureError; } 当然我们也可以自己实现这个接口,然后把Http客户端换成okhttp。 后记 网络相关的框架套路基本上就这些了,具体细节大家可以去自己看下相关源码。如果有什么不完善或者不对的地方也请大家多指教。 本文作者:佚名 来源:51CTO

优秀的个人博客,低调大师

hbase region split源码分析

hbase region split : split执行调用流程: 1.HbaseAdmin发起split:### 2.RSRpcServices实现类执行split(Implements the regionserver RPC services.)### 3.CompactSplitThread类与SplitRequest类用来执行region切割:### 4.splitRequest执行doSplitting操作### 4.1初始化两个子region### 4.2执行切割#### 4.2.1:(创建子region。stepsBeforePONR函数)##### 4.2.2:子region执行:stepsAfterPONR函数执行(包含openDaughters函数):##### 4.2.3:HRegionServer添加子region到meta表,加入RegionServer##### 4.3等待region切分完成,修改meta表信息,报告master#### 1.HbaseAdmin发起split: public void split(final TableName tableName) throws IOException { split(tableName, null); } public void split(final ServerName sn, final HRegionInfo hri, byte[] splitPoint) throws IOException { if (hri.getStartKey() != null && splitPoint != null && Bytes.compareTo(hri.getStartKey(), splitPoint) == 0) { throw new IOException("should not give a splitkey which equals to startkey!"); } // TODO: There is no timeout on this controller. Set one! HBaseRpcController controller = rpcControllerFactory.newController(); controller.setPriority(hri.getTable()); // TODO: this does not do retries, it should. Set priority and timeout in controller AdminService.BlockingInterface admin = this.connection.getAdmin(sn); //hbase中split调用请求通过protobuf(AdminProtos)实现 ProtobufUtil.split(controller, admin, hri, splitPoint); 实现代码: try { admin.splitRegion(controller, request); } 2.RSRpcServices实现类执行split(Implements the regionserver RPC services.) 代码: try { checkOpen(); requestCount.increment(); Region region = getRegion(request.getRegion()); region.startRegionOperation(Operation.SPLIT_REGION); if (region.getRegionInfo().getReplicaId() != HRegionInfo.DEFAULT_REPLICA_ID) { throw new IOException("Can't split replicas directly. " + "Replicas are auto-split when their primary is split."); } LOG.info("Splitting " + region.getRegionInfo().getRegionNameAsString()); region.flush(true); byte[] splitPoint = null; if (request.hasSplitPoint()) { //确定切割点splitpoint splitPoint = request.getSplitPoint().toByteArray(); } ((HRegion)region).forceSplit(splitPoint); //请求region切割 regionServer.compactSplitThread.requestSplit(region, ((HRegion)region).checkSplit(), RpcServer.getRequestUser()); return SplitRegionResponse.newBuilder().build(); } 3.CompactSplitThread类与SplitRequest类用来执行region切割: 代码: try { this.splits.execute(new SplitRequest(r, midKey, this.server, user)); if (LOG.isDebugEnabled()) { LOG.debug("Split requested for " + r + ". " + this); } } try { //acquire a shared read lock on the table, so that table schema modifications //do not happen concurrently //获取table的读锁。。 tableLock = server.getTableLockManager().readLock(parent.getTableDesc().getTableName() , "SPLIT_REGION:" + parent.getRegionInfo().getRegionNameAsString()); try { tableLock.acquire(); } 4.splitRequest执行doSplitting操作 4.1### //初始化两个子region信息 this.hri_a = new HRegionInfo(hri.getTable(), startKey, this.splitrow, false, rid); this.hri_b = new HRegionInfo(hri.getTable(), this.splitrow, endKey, false, rid); 4.2### //执行切割 st.execute(this.server, this.server, user); 4.2.1:(创建子region。stepsBeforePONR函数)#### //创建两个子region PairOfSameType<Region> regions = createDaughters(server, services, user); 4.2.2:stepsAfterPONR函数执行(openDaughters):#### // 两个子region DaughterOpener线程 start DaughterOpener aOpener = new DaughterOpener(server, (HRegion)a); DaughterOpener bOpener = new DaughterOpener(server, (HRegion)b); //向hdfs上写入.regionInfo文件以便meta挂掉以便恢复 writeRegionInfoOnFilesystem(content, true); //初始化所有的hstore initializeStores(reporter, status); //LoadStoreFiles函数执行: if (files == null || files.size() == 0) { return new ArrayList<StoreFile>(); } // initialize the thread pool for opening store files in parallel.. ThreadPoolExecutor storeFileOpenerThreadPool = this.region.getStoreFileOpenAndCloseThreadPool("StoreFileOpenerThread-" + this.getColumnFamilyName()); CompletionService<StoreFile> completionService = new ExecutorCompletionService<StoreFile>(storeFileOpenerThreadPool); int totalValidStoreFile = 0; for (final StoreFileInfo storeFileInfo: files) { //HDFS上对应的路径和文件 completionService.submit(new Callable<StoreFile>() { @Override public StoreFile call() throws IOException { //每个文件创建一个StoreFile对象,对每个storefile对象会读取文件上的内容创建一个 HalfStoreFileReader读对象来操作该region的父region上的相应的文件,及该 region上目前存储的是引用文件,其指向的是其父region上的相应的文件,对该 region的所有读或写都将关联到父region上 StoreFile storeFile = createStoreFileAndReader(storeFileInfo); return storeFile; } }); totalValidStoreFile++; } //将子Region添加到rs的online region列表上,并添加到meta表上 { if (useZKForAssignment) { // add 2nd daughter first (see HBASE-4335) services.postOpenDeployTasks(b); } else if (!services.reportRegionStateTransition(TransitionCode.SPLIT, parent.getRegionInfo(), hri_a, hri_b)) { throw new IOException("Failed to report split region to master: " + parent.getRegionInfo().getShortNameToLog()); } // Should add it to OnlineRegions services.addToOnlineRegions(b); if (useZKForAssignment) { services.postOpenDeployTasks(a); } services.addToOnlineRegions(a); } 参考文章:http://blog.csdn.net/Pun_C/article/details/47173453

优秀的个人博客,低调大师

Storm-源码分析- metric

首先定义一系列metric相关的interface, IMetric, IReducer, ICombiner (backtype.storm.metric.api) 在task中, 创建一系列builtin-metrics, (backtype.storm.daemon.builtin-metrics), 并注册到topology context里面 task会不断的利用如spout-acked-tuple!的functions去更新这些builtin-metrics task会定期将builtin-metrics里面的统计数据通过METRICS-STREAM发送给metric-bolt (backtype.storm.metric.MetricsConsumerBolt, 该bolt会创建实现backtype.storm.metric.api.IMetricsConsumer的对象, 用于计算出metrics) 然后如何使用这些metrics? 由于这是builtin metrics, 是不会被外界使用的 如果处理这些metrics, 取决于_metricsConsumer.handleDataPoints, 这里的_metricsConsumer是通过topology's configuration配置的 比如backtype.storm.metric.LoggingMetricsConsumer, 如果使用这个consumer就会将metrics写入log中 1. backtype.storm.metric.api IMetric package backtype.storm.metric.api; public interface IMetric { public Object getValueAndReset(); ;;取得当前值并恢复初始状态 } CountMetric, 计数, reset时清零 AssignableMetric, 赋值, 不用reset MultiCountMetric, 使用hashmap记录多个count, reset时分别对每个count对象调用getValueAndReset public class CountMetric implements IMetric { long _value = 0; public CountMetric() { } public void incr() { _value++; } public void incrBy(long incrementBy) { _value += incrementBy; } public Object getValueAndReset() { long ret = _value; _value = 0; return ret; } } ICombiner public interface ICombiner<T> { public T identity(); public T combine(T a, T b); } CombinedMetric, 结合ICombiner和IMetric public class CombinedMetric implements IMetric { private final ICombiner _combiner; private Object _value; public CombinedMetric(ICombiner combiner) { _combiner = combiner; _value = _combiner.identity(); } public void update(Object value) { _value = _combiner.combine(_value, value); } public Object getValueAndReset() { Object ret = _value; _value = _combiner.identity(); return ret; } } IReducer publicinterfaceIReducer<T> { T init(); T reduce(T accumulator, Object input); Object extractResult(T accumulator); } 实现IReducer接口, 实现平均数Reducer, reduce里面累加和计数, extractResult里面acc/count求平均数 class MeanReducerState { public int count = 0; public double sum = 0.0; } public class MeanReducer implements IReducer<MeanReducerState> { public MeanReducerState init() { return new MeanReducerState(); } public MeanReducerState reduce(MeanReducerState acc, Object input) { acc.count++; if(input instanceof Double) { acc.sum += (Double)input; } else if(input instanceof Long) { acc.sum += ((Long)input).doubleValue(); } else if(input instanceof Integer) { acc.sum += ((Integer)input).doubleValue(); } else { throw new RuntimeException( "MeanReducer::reduce called with unsupported input type `" + input.getClass() + "`. Supported types are Double, Long, Integer."); } return acc; } public Object extractResult(MeanReducerState acc) { if(acc.count > 0) { return new Double(acc.sum / (double)acc.count); } else { return null; } } } ReducedMetric 结合IReducer和IMetric public class ReducedMetric implements IMetric { private final IReducer _reducer; private Object _accumulator; public ReducedMetric(IReducer reducer) { _reducer = reducer; _accumulator = _reducer.init(); } public void update(Object value) { _accumulator = _reducer.reduce(_accumulator, value); } public Object getValueAndReset() { Object ret = _reducer.extractResult(_accumulator); _accumulator = _reducer.init(); return ret; } } IMetricsConsumer 这个interface, 内嵌TaskInfo和DataPoint类 handleDataPoints, 添加逻辑以处理task对应的一系列DataPoint public interface IMetricsConsumer { public static class TaskInfo { public TaskInfo() {} public TaskInfo(String srcWorkerHost, int srcWorkerPort, String srcComponentId, int srcTaskId, long timestamp, int updateIntervalSecs) { this.srcWorkerHost = srcWorkerHost; this.srcWorkerPort = srcWorkerPort; this.srcComponentId = srcComponentId; this.srcTaskId = srcTaskId; this.timestamp = timestamp; this.updateIntervalSecs = updateIntervalSecs; } public String srcWorkerHost; public int srcWorkerPort; public String srcComponentId; public int srcTaskId; public long timestamp; public int updateIntervalSecs; } public static class DataPoint { public DataPoint() {} public DataPoint(String name, Object value) { this.name = name; this.value = value; } @Override public String toString() { return "[" + name + " = " + value + "]"; } public String name; public Object value; } void prepare(Map stormConf, Object registrationArgument, TopologyContext context, IErrorReporter errorReporter); void handleDataPoints(TaskInfo taskInfo, Collection<DataPoint> dataPoints); void cleanup(); } 2. backtype.storm.daemon.builtin-metrics 定义Spout和Bolt所需要的一些metric, 主要两个record, BuiltinSpoutMetrics和BuiltinBoltMetrics, [metric-name, metric-object]的hashmap (defrecord BuiltinSpoutMetrics [^MultiCountMetric ack-count ^MultiReducedMetric complete-latency ^MultiCountMetric fail-count ^MultiCountMetric emit-count ^MultiCountMetric transfer-count]) (defrecord BuiltinBoltMetrics [^MultiCountMetric ack-count ^MultiReducedMetric process-latency ^MultiCountMetric fail-count ^MultiCountMetric execute-count ^MultiReducedMetric execute-latency ^MultiCountMetric emit-count ^MultiCountMetric transfer-count]) (defn make-data [executor-type] (condp = executor-type :spout (BuiltinSpoutMetrics. (MultiCountMetric.) (MultiReducedMetric. (MeanReducer.)) (MultiCountMetric.) (MultiCountMetric.) (MultiCountMetric.)) :bolt (BuiltinBoltMetrics. (MultiCountMetric.) (MultiReducedMetric. (MeanReducer.)) (MultiCountMetric.) (MultiCountMetric.) (MultiReducedMetric. (MeanReducer.)) (MultiCountMetric.) (MultiCountMetric.)))) (defn register-all [builtin-metrics storm-conf topology-context] (doseq [[kw imetric] builtin-metrics] (.registerMetric topology-context (str "__" (name kw)) imetric (int (get storm-conf Config/TOPOLOGY_BUILTIN_METRICS_BUCKET_SIZE_SECS))))) 在mk-task-data的时候, 调用make-data来创建相应的metrics, :builtin-metrics (builtin-metrics/make-data (:type executor-data)) 并在executor的mk-threads中, 会将这些builtin-metrics注册到topologycontext中去, (builtin-metrics/register-all (:builtin-metrics task-data) storm-conf (:user-context task-data)) 上面完成的builtin-metrics的创建和注册, 接着定义了一系列用于更新metrics的functions, 以spout-acked-tuple!为例, 需要更新MultiCountMetric ack-count和MultiReducedMetric complete-latency .scope从MultiCountMetric取出某个CountMetric, 然后incrBy来将stats的rate增加到count上 (defn spout-acked-tuple! [^BuiltinSpoutMetrics m stats stream latency-ms] (-> m .ack-count (.scope stream) (.incrBy (stats-rate stats))) (-> m .complete-latency (.scope stream) (.update latency-ms))) 3. backtype.storm.metric MetricsConsumerBolt 创建实现IMetricsConsumer的对象, 并在execute里面调用handleDataPoints package backtype.storm.metric; public class MetricsConsumerBolt implements IBolt { IMetricsConsumer _metricsConsumer; String _consumerClassName; OutputCollector _collector; Object _registrationArgument; public MetricsConsumerBolt(String consumerClassName, Object registrationArgument) { _consumerClassName = consumerClassName; _registrationArgument = registrationArgument; } @Override public void prepare(Map stormConf, TopologyContext context, OutputCollector collector) { try { _metricsConsumer = (IMetricsConsumer)Class.forName(_consumerClassName).newInstance(); } catch (Exception e) { throw new RuntimeException("Could not instantiate a class listed in config under section " + Config.TOPOLOGY_METRICS_CONSUMER_REGISTER + " with fully qualified name " + _consumerClassName, e); } _metricsConsumer.prepare(stormConf, _registrationArgument, context, (IErrorReporter)collector); _collector = collector; } @Override public void execute(Tuple input) { _metricsConsumer.handleDataPoints((IMetricsConsumer.TaskInfo)input.getValue(0), (Collection)input.getValue(1)); _collector.ack(input); } @Override public void cleanup() { _metricsConsumer.cleanup(); } } SystemBolt SystemBolt, 根据comments里面说的, 每个worker都有一个, taskid=-1 定义些system相关的metric, 并注册到topologycontext里面 需要使用Java调用clojure, 所以需要import下面的package import clojure.lang.AFn; import clojure.lang.IFn; //funtion import clojure.lang.RT; //run-time 并且用到些用于监控memory和JVM的java package java.lang.management.MemoryUsage, 表示内存使用量快照的MemoryUsage对象 java.lang.management.GarbageCollectorMXBean, 用于Java虚拟机的垃圾回收的管理接口, 比如发生的回收的总次数, 和累计回收时间 java.lang.management.RuntimeMXBean, 用于Java 虚拟机的运行时系统的管理接口 这个bolt的特点是, 只有prepare实现了逻辑, 并且通过_prepareWasCalled保证prepare只被执行一次 prepare中的逻辑, 主要就是定义各种metric, 并且通过registerMetric注册到TopologyContext中 metic包含, JVM的运行时间, 开始时间, memory情况, 和每个GarbageCollector的情况 注册的这些system metrics也会一起被发送到MetricsConsumerBolt进行处理 这应该用spout实现, 为啥用bolt实现? // There is one task inside one executor for each worker of the topology. // TaskID is always -1, therefore you can only send-unanchored tuples to co-located SystemBolt. // This bolt was conceived to export worker stats via metrics api. public class SystemBolt implements IBolt { private static Logger LOG = LoggerFactory.getLogger(SystemBolt.class); private static boolean _prepareWasCalled = false; private static class MemoryUsageMetric implements IMetric { IFn _getUsage; public MemoryUsageMetric(IFn getUsage) { _getUsage = getUsage; } @Override public Object getValueAndReset() { MemoryUsage memUsage = (MemoryUsage)_getUsage.invoke(); HashMap m = new HashMap(); m.put("maxBytes", memUsage.getMax()); m.put("committedBytes", memUsage.getCommitted()); m.put("initBytes", memUsage.getInit()); m.put("usedBytes", memUsage.getUsed()); m.put("virtualFreeBytes", memUsage.getMax() - memUsage.getUsed()); m.put("unusedBytes", memUsage.getCommitted() - memUsage.getUsed()); return m; } } // canonically the metrics data exported is time bucketed when doing counts. // convert the absolute values here into time buckets. private static class GarbageCollectorMetric implements IMetric { GarbageCollectorMXBean _gcBean; Long _collectionCount; Long _collectionTime; public GarbageCollectorMetric(GarbageCollectorMXBean gcBean) { _gcBean = gcBean; } @Override public Object getValueAndReset() { Long collectionCountP = _gcBean.getCollectionCount(); Long collectionTimeP = _gcBean.getCollectionTime(); Map ret = null; if(_collectionCount!=null && _collectionTime!=null) { ret = new HashMap(); ret.put("count", collectionCountP - _collectionCount); ret.put("timeMs", collectionTimeP - _collectionTime); } _collectionCount = collectionCountP; _collectionTime = collectionTimeP; return ret; } } @Override public void prepare(final Map stormConf, TopologyContext context, OutputCollector collector) { if(_prepareWasCalled && stormConf.get(Config.STORM_CLUSTER_MODE) != "local") { throw new RuntimeException("A single worker should have 1 SystemBolt instance."); } _prepareWasCalled = true; int bucketSize = RT.intCast(stormConf.get(Config.TOPOLOGY_BUILTIN_METRICS_BUCKET_SIZE_SECS)); final RuntimeMXBean jvmRT = ManagementFactory.getRuntimeMXBean(); context.registerMetric("uptimeSecs", new IMetric() { @Override public Object getValueAndReset() { return jvmRT.getUptime()/1000.0; } }, bucketSize); context.registerMetric("startTimeSecs", new IMetric() { @Override public Object getValueAndReset() { return jvmRT.getStartTime()/1000.0; } }, bucketSize); context.registerMetric("newWorkerEvent", new IMetric() { boolean doEvent = true; @Override public Object getValueAndReset() { if (doEvent) { doEvent = false; return 1; } else return 0; } }, bucketSize); final MemoryMXBean jvmMemRT = ManagementFactory.getMemoryMXBean(); context.registerMetric("memory/heap", new MemoryUsageMetric(new AFn() { public Object invoke() { return jvmMemRT.getHeapMemoryUsage(); } }), bucketSize); context.registerMetric("memory/nonHeap", new MemoryUsageMetric(new AFn() { public Object invoke() { return jvmMemRT.getNonHeapMemoryUsage(); } }), bucketSize); for(GarbageCollectorMXBean b : ManagementFactory.getGarbageCollectorMXBeans()) { context.registerMetric("GC/" + b.getName().replaceAll("\\W", ""), new GarbageCollectorMetric(b), bucketSize); } } @Override public void execute(Tuple input) { throw new RuntimeException("Non-system tuples should never be sent to __system bolt."); } @Override public void cleanup() { } } 4. system-topology! 这里会动态的往topology里面, 加入metric-component (MetricsConsumerBolt) 和system-component (SystemBolt), 以及相应的steam信息 system-topology!会往topology加上些东西 1. acker, 后面再说 2. metric-bolt, input是所有component的tasks发来的METRICS-STREAM, 没有output 3. system-bolt, 没有input, output是两个TICK-STREAM 4. 给所有component, 增加额外的输出metrics-stream, system-stream (defn system-topology! [storm-conf ^StormTopology topology] (validate-basic! topology) (let [ret (.deepCopy topology)] (add-acker! storm-conf ret) (add-metric-components! storm-conf ret) (add-system-components! storm-conf ret) (add-metric-streams! ret) (add-system-streams! ret) (validate-structure! ret) ret )) 4.1 增加component 看下thrift中的定义, 往topology里面增加一个blot component, 其实就是往hashmap中增加一组[string, Bolt] 关键就是看看如何使用thrift/mk-bolt-spec*来创建blot spec struct StormTopology { 1: required map<string, SpoutSpec> spouts; 2: required map<string, Bolt> bolts; 3: required map<string, StateSpoutSpec> state_spouts; } struct Bolt { 1: required ComponentObject bolt_object; 2: required ComponentCommon common; } struct ComponentCommon { 1: required map<GlobalStreamId, Grouping> inputs; 2: required map<string, StreamInfo> streams; //key is stream id, outputs 3: optional i32 parallelism_hint; //how many threads across the cluster should be dedicated to this component 4: optional string json_conf; } struct StreamInfo { 1: required list<string> output_fields; 2: required bool direct; } (defn add-metric-components! [storm-conf ^StormTopology topology] (doseq [[comp-id bolt-spec] (metrics-consumer-bolt-specs storm-conf topology)] ;;从metrics-consumer-bolt-specs中可以看出该bolt会以METRICS-STREAM-ID为输入, 且没有输出 (.put_to_bolts topology comp-id bolt-spec))) (defn add-system-components! [conf ^StormTopology topology] (let [system-bolt-spec (thrift/mk-bolt-spec* {} ;;input为空, 没有输入 (SystemBolt.) ;;object {SYSTEM-TICK-STREAM-ID (thrift/output-fields ["rate_secs"]) METRICS-TICK-STREAM-ID (thrift/output-fields ["interval"])} ;;output, 定义两个output streams, 但代码中并没有emit :p 0 :conf {TOPOLOGY-TASKS 0})] (.put_to_bolts topology SYSTEM-COMPONENT-ID system-bolt-spec))) metric-components 首先, topology里面所有的component(包含system component), 都需要往metics-bolt发送统计数据, 所以component-ids-that-emit-metrics就是all-components-ids+SYSTEM-COMPONENT-ID 那么对于任意一个comp, 都会对metics-bolt产生如下输入, {[comp-id METRICS-STREAM-ID] :shuffle} (采用:suffle grouping方式) 然后, 用thrift/mk-bolt-spec*来定义创建bolt的fn, mk-bolt-spec 最后, 调用mk-bolt-spec来创建metics-bolt的spec, 参考上面的定义 关键就是, 创建MetricsConsumerBolt对象, 需要从storm-conf里面读出, MetricsConsumer的实现类和参数 这个bolt负责, 将从各个task接收到的数据, 调用handleDataPoints生成metircs, 参考前面的定义 (defn metrics-consumer-bolt-specs [storm-conf topology] (let [component-ids-that-emit-metrics (cons SYSTEM-COMPONENT-ID (keys (all-components topology))) inputs (->> (for [comp-id component-ids-that-emit-metrics] {[comp-id METRICS-STREAM-ID] :shuffle}) (into {})) mk-bolt-spec (fn [class arg p] (thrift/mk-bolt-spec* inputs ;;inputs集合 (backtype.storm.metric.MetricsConsumerBolt. class arg) ;;object {} ;;output为空 :p p :conf {TOPOLOGY-TASKS p}))] (map (fn [component-id register] [component-id (mk-bolt-spec (get register "class") (get register "argument") (or (get register "parallelism.hint") 1))]) (metrics-consumer-register-ids storm-conf) (get storm-conf TOPOLOGY-METRICS-CONSUMER-REGISTER)))) 4.2 增加stream 给每个component增加两个output stream METRICS-STREAM-ID, 发送给metric-blot, 数据结构为output-fields ["task-info" "data-points"] SYSTEM-STREAM-ID, ,数据结构为output-fields ["event"] (defn add-metric-streams! [^StormTopology topology] (doseq [[_ component] (all-components topology) :let [common (.get_common component)]] (.put_to_streams common METRICS-STREAM-ID (thrift/output-fields ["task-info" "data-points"])))) (defn add-system-streams! [^StormTopology topology] (doseq [[_ component] (all-components topology) :let [common (.get_common component)]] (.put_to_streams common SYSTEM-STREAM-ID (thrift/output-fields ["event"])))) 本文章摘自博客园,原文发布日期:2013-07-30

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册