首页 文章 精选 留言 我的

精选列表

搜索[氛围编程],共10003篇文章
优秀的个人博客,低调大师

Java并发编程-AQS

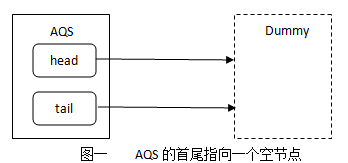
文章耗时一个月,所以篇幅有点长,需要一点耐心。 1、AQS产生背景 通过JCP的JSR166规范,Jdk1.5开始引入了j.u.c包,这个包提供了一系列支持并发的组件。这些组件是一系列的同步器,这些同步器主要维护着以下几个功能:内部同步状态的管理(例如表示一个锁的状态是获取还是释放),同步状态的更新和检查操作,且至少有一个方法会导致调用线程在同步状态被获取时阻塞,以及在其他线程改变这个同步状态时解除线程的阻塞。上述的这些的实际例子包括:互斥排它锁的不同形式、读写锁、信号量、屏障、Future、事件指示器以及传送队列等。可以看下这里的4.2的图便能理解j.u.c包的组件构成。 几乎任一同步器都可以用来实现其他形式的同步器。例如,可以用可重入锁实现信号量或者用信号量实现可重入锁。但是,这样做带来的复杂性、开销及不灵活使j.u.c最多只能是一个二流工程,且缺乏吸引力。如果任何这样的构造方式不能在本质上比其他形式更简洁,那么开发者就不应该随意地选择其中的某个来构建另一个同步器。因此,JSR166基于AQS类建立了一个小框架,这个框架为构造同步器提供一种通用的机制,并且被j.u.c包中大部分类使用,同时很多用户也可以用它来定义自己的同步器。这个就是j.u.c的作者Doug Lea大神的初衷,通过提供AQS这个基础组件来构建j.u.c的各种工具类,至此就可以理解AQS的产生背景了。 2、AQS的设计和结构 2.1设计思想 同步器的核心方法是acquire和release操作,其背后的思想也比较简洁明确。acquire操作是这样的: while (当前同步器的状态不允许获取操作) { 如果当前线程不在队列中,则将其插入队列 阻塞当前线程 } 如果线程位于队列中,则将其移出队列 release操作是这样的: 更新同步器的状态 if (新的状态允许某个被阻塞的线程获取成功) 解除队列中一个或多个线程的阻塞状态 从这两个操作中的思想中我们可以提取出三大关键操作:同步器的状态变更、线程阻塞和释放、插入和移出队列。所以为了实现这两个操作,需要协调三大关键操作引申出来的三个基本组件: ·同步器状态的原子性管理; ·线程阻塞与解除阻塞; ·队列的管理; 由这三个基本组件,我们来看j.u.c是怎么设计的。 2.1.1同步状态 AQS类使用单个int(32位)来保存同步状态,并暴露出getState、setState以及compareAndSet操作来读取和更新这个同步状态。其中属性state被声明为volatile,并且通过使用CAS指令来实现compareAndSetState,使得当且仅当同步状态拥有一个一致的期望值的时候,才会被原子地设置成新值,这样就达到了同步状态的原子性管理,确保了同步状态的原子性、可见性和有序性。 基于AQS的具体实现类(如锁、信号量等)必须根据暴露出的状态相关的方法定义tryAcquire和tryRelease方法,以控制acquire和release操作。当同步状态满足时,tryAcquire方法必须返回true,而当新的同步状态允许后续acquire时,tryRelease方法也必须返回true。这些方法都接受一个int类型的参数用于传递想要的状态。 2.1.2阻塞 直到JSR166,阻塞线程和解除线程阻塞都是基于Java的内置管程,没有其它非基于Java内置管程的API可以用来达到阻塞线程和解除线程阻塞。唯一可以选择的是Thread.suspend和Thread.resume,但是它们都有无法解决的竞态问题,所以也没法用,目前该方法基本已被抛弃。具体不能用的原因可以官方给出的答复。 j.u.c.locks包提供了LockSupport类来解决这个问题。方法LockSupport.park阻塞当前线程直到有个LockSupport.unpark方法被调用。unpark的调用是没有被计数的,因此在一个park调用前多次调用unpark方法只会解除一个park操作。另外,它们作用于每个线程而不是每个同步器。一个线程在一个新的同步器上调用park操作可能会立即返回,因为在此之前可以有多余的unpark操作。但是,在缺少一个unpark操作时,下一次调用park就会阻塞。虽然可以显式地取消多余的unpark调用,但并不值得这样做。在需要的时候多次调用park会更高效。park方法同样支持可选的相对或绝对的超时设置,以及与JVM的Thread.interrupt结合 ,可通过中断来unpark一个线程。 2.1.3队列 整个框架的核心就是如何管理线程阻塞队列,该队列是严格的FIFO队列,因此不支持线程优先级的同步。同步队列的最佳选择是自身没有使用底层锁来构造的非阻塞数据结构,业界主要有两种选择,一种是MCS锁,另一种是CLH锁。其中CLH一般用于自旋,但是相比MCS,CLH更容易实现取消和超时,所以同步队列选择了CLH作为实现的基础。 CLH队列实际并不那么像队列,它的出队和入队与实际的业务使用场景密切相关。它是一个链表队列,通过AQS的两个字段head(头节点)和tail(尾节点)来存取,这两个字段是volatile类型,初始化的时候都指向了一个空节点。如下图: 入队操作:CLH队列是FIFO队列,故新的节点到来的时候,是要插入到当前队列的尾节点之后。试想一下,当一个线程成功地获取了同步状态,其他线程将无法获取到同步状态,转而被构造成为节点并加入到同步队列中,而这个加入队列的过程必须要保证线程安全,因此同步器提供了一个CAS方法,它需要传递当前线程“认为”的尾节点和当前节点,只有设置成功后,当前节点才正式与之前的尾节点建立关联。入队操作示意图大致如下: 出队操作:因为遵循FIFO规则,所以能成功获取到AQS同步状态的必定是首节点,首节点的线程在释放同步状态时,会唤醒后续节点,而后续节点会在获取AQS同步状态成功的时候将自己设置为首节点。设置首节点是由获取同步成功的线程来完成的,由于只能有一个线程可以获取到同步状态,所以设置首节点的方法不需要像入队这样的CAS操作,只需要将首节点设置为原首节点的后续节点同时断开原节点、后续节点的引用即可。出队操作示意图大致如下: 这一小节只是简单的描述了队列的大概,目的是为了表达清楚队列的设计框架,实际上CLH队列已经和初始的CLH队列已经发生了一些变化,具体的可以看查看资料中Doug Lea的那篇论文中的3.3 Queues。 2.1.4条件队列 上一节的队列其实是AQS的同步队列,这一节的队列是条件队列,队列的管理除了有同步队列,还有条件队列。AQS只有一个同步队列,但是可以有多个条件队列。AQS框架提供了一个ConditionObject类,给维护独占同步的类以及实现Lock接口的类使用。 ConditionObject类实现了Condition接口,Condition接口提供了类似Object管程式的方法,如await、signal和signalAll操作,还扩展了带有超时、检测和监控的方法。ConditionObject类有效地将条件与其它同步操作结合到了一起。该类只支持Java风格的管程访问规则,这些规则中,当且仅当当前线程持有锁且要操作的条件(condition)属于该锁时,条件操作才是合法的。这样,一个ConditionObject关联到一个ReentrantLock上就表现的跟内置的管程(通过Object.wait等)一样了。两者的不同仅仅在于方法的名称、额外的功能以及用户可以为每个锁声明多个条件。 ConditionObject类和AQS共用了内部节点,有自己单独的条件队列。signal操作是通过将节点从条件队列转移到同步队列中来实现的,没有必要在需要唤醒的线程重新获取到锁之前将其唤醒。signal操作大致示意图如下: await操作就是当前线程节点从同步队列进入条件队列进行等待,大致示意图如下: 实现这些操作主要复杂在,因超时或Thread.interrupt导致取消了条件等待时,该如何处理。await和signal几乎同时发生就会有竞态问题,最终的结果遵照内置管程相关的规范。JSR133修订以后,就要求如果中断发生在signal操作之前,await方法必须在重新获取到锁后,抛出InterruptedException。但是,如果中断发生在signal后,await必须返回且不抛异常,同时设置线程的中断状态。 2.2方法结构 如果我们理解了上一节的设计思路,我们大致就能知道AQS的主要数据结构了。 组件 数据结构 同步状态 volatile int state 阻塞 LockSupport类 队列 Node节点 条件队列 ConditionObject 进而再来看下AQS的主要方法及其作用。 属性、方法 描述、作用 int getState() 获取当前同步状态 void setState(int newState) 设置当前同步状态 boolean compareAndSetState(int expect, int update) 通过CAS设置当前状态,此方法保证状态设置的原子性 boolean tryAcquire(int arg) 钩子方法,独占式获取同步状态,AQS没有具体实现,具体实现都在子类中,实现此方法需要查询当前同步状态并判断同步状态是否符合预期,然后再CAS设置同步状态 boolean tryRelease(int arg) 钩子方法,独占式释放同步状态,AQS没有具体实现,具体实现都在子类中,等待获取同步状态的线程将有机会获取同步状态 int tryAcquireShared(int arg) 钩子方法,共享式获取同步状态,AQS没有具体实现,具体实现都在子类中,返回大于等于0的值表示获取成功,反之失败 boolean tryReleaseShared(int arg) 钩子方法,共享式释放同步状态,AQS没有具体实现,具体实现都在子类中 boolean isHeldExclusively() 钩子方法,AQS没有具体实现,具体实现都在子类中,当前同步器是否在独占模式下被线程占用,一般该方法表示是否被当前线程所独占 void acquire(int arg) 模板方法,独占式获取同步状态,如果当前线程获取同步状态成功,则由该方法返回,否则会进入同步队列等待,此方法会调用子类重写的tryAcquire方法 void acquireInterruptibly(int arg) 模板方法,与acquire相同,但是此方法可以响应中断,当前线程未获取到同步状态而进入同步队列中,如果当前线程被中断,此方法会抛出InterruptedException并返回 boolean tryAcquireNanos(int arg, long nanosTimeout) 模板方法,在acquireInterruptibly基础上增加了超时限制,如果当前线程在超时时间内没有获取到同步状态,则会返回false,如果获取到了则会返回true boolean release(int arg) 模板方法,独占式的释放同步状态,该方法会在释放同步状态后,将同步队列中的第一个节点包含的线程唤醒 void acquireShared(int arg) 模板方法,共享式的获取同步状态,如果当前系统未获取到同步状态,将会进入同步队列等待,与acquire的主要区别在于同一时刻可以有多个线程获取到同步状态 void acquireSharedInterruptibly(int arg) 模板方法,与acquireShared一致,但是可以响应中断 boolean tryAcquireSharedNanos(int arg, long nanosTimeout) 模板方法,在acquireSharedInterruptibly基础上增加了超时限制 boolean releaseShared(int arg) 模板方法,共享式的释放同步状态 Collection<Thread> getQueuedThreads() 模板方法,获取等待在同步队列上的线程集合 Node int waitStatus 等待状态 1、 CANCELLED,值为1,在同步队列中等待的线程等待超时或者被中断,需要从同步队列中取消等待,节点进入该状态后将不会变化; 2、 SIGNAL,值为-1,后续节点的线程处于等待状态,而当前节点的线程如果释放了同步状态或者被取消,将会通知后续节点,使后续节点的线程得以运行; 3、 CONDITION,值为-2,节点在条件队列中,节点线程等待在Condition上,当其他线程对Condition调用了signal()方法后,该节点将会从条件队列中转移到同步队列中,加入到对同步状态的获取中; 4、 PROPAGATE,值为-3,表示下一次共享式同步状态获取将会无条件地传播下去 Node prev 前驱节点,当节点加入同步队列时被设置 Node next 后续节点 Thread thread 获取同步状态的线程 Node nextWaiter 条件队列中的后续节点,如果当前节点是共享的,那么这个字段将是一个SHARED变量,也就是说节点类型(独占和共享)和条件队列中的后续节点共用同一个字段 LockSupport void park() 阻塞当前线程,如果调用unpark方法或者当前线程被中断,才能从park方法返回 LockSupport void unpark(Thread thread) 唤醒处于阻塞状态的线程 ConditionObject Node firstWaiter 条件队列首节点 ConditionObject Node lastWaiter 条件队列尾节点 void await() 当前线程进入等待状态直到signal或中断,当前线程将进入运行状态且从await方法返回的情况,包括: 其他线程调用该Condition的signal或者signalAll方法,且当前线程被选中唤醒; 其他线程调用interrupt方法中断当前线程; 如果当前线程从await方法返回表明该线程已经获取了Condition对象对应的锁 void awaitUninterruptibly() 和await方法类似,但是对中断不敏感 long awaitNanos(long nanosTimeout) 当前线程进入等待状态直到被signal、中断或者超时。返回值表示剩余的时间。 boolean awaitUntil(Date deadline) 当前线程进入等待状态直到被signal、中断或者某个时间。如果没有到指定时间就被通知,方法返回true,否则表示到了指定时间,返回false void signal() 唤醒一个等待在Condition上的线程,该线程从等待方法返回前必须获得与Condition相关联的锁 void signalAll() 唤醒所有等待在Condition上的线程,能够从等待方法返回的线程必须获得与Condition相关联的锁 看到这,我们对AQS的数据结构应该基本上有一个大致的认识,有了这个基本面的认识,我们就可以来看下AQS的源代码。 3、AQS的源代码实现 主要通过独占式同步状态的获取和释放、共享式同步状态的获取和释放来看下AQS是如何实现的。 3.1独占式同步状态的获取和释放 独占式同步状态调用的方法是acquire,代码如下: public final void acquire(int arg) { if (!tryAcquire(arg) && acquireQueued(addWaiter(Node.EXCLUSIVE), arg)) selfInterrupt(); } 上述代码主要完成了同步状态获取、节点构造、加入同步队列以及在同步队列中自旋等待的相关工作,其主要逻辑是:首先调用子类实现的tryAcquire方法,该方法保证线程安全的获取同步状态,如果同步状态获取失败,则构造独占式同步节点(同一时刻只能有一个线程成功获取同步状态)并通过addWaiter方法将该节点加入到同步队列的尾部,最后调用acquireQueued方法,使得该节点以自旋的方式获取同步状态。如果获取不到则阻塞节点中的线程,而被阻塞线程的唤醒主要依靠前驱节点的出队或阻塞线程被中断来实现。 下面来首先来看下节点构造和加入同步队列是如何实现的。代码如下: private Node addWaiter(Node mode) { // 当前线程构造成Node节点 Node node = new Node(Thread.currentThread(), mode); // Try the fast path of enq; backup to full enq on failure // 尝试快速在尾节点后新增节点 提升算法效率 先将尾节点指向pred Node pred = tail; if (pred != null) { //尾节点不为空 当前线程节点的前驱节点指向尾节点 node.prev = pred; //并发处理 尾节点有可能已经不是之前的节点 所以需要CAS更新 if (compareAndSetTail(pred, node)) { //CAS更新成功 当前线程为尾节点 原先尾节点的后续节点就是当前节点 pred.next = node; return node; } } //第一个入队的节点或者是尾节点后续节点新增失败时进入enq enq(node); return node; } private Node enq(final Node node) { for (;;) { Node t = tail; if (t == null) { // Must initialize //尾节点为空 第一次入队 设置头尾节点一致 同步队列的初始化 if (compareAndSetHead(new Node())) tail = head; } else { //所有的线程节点在构造完成第一个节点后 依次加入到同步队列中 node.prev = t; if (compareAndSetTail(t, node)) { t.next = node; return t; } } } } 节点进入同步队列之后,就进入了一个自旋的过程,每个线程节点都在自省地观察,当条件满足,获取到了同步状态,就可以从这个自旋过程中退出,否则依旧留在这个自旋过程中并会阻塞节点的线程,代码如下: final boolean acquireQueued(final Node node, int arg) { boolean failed = true; try { boolean interrupted = false; for (;;) { //获取当前线程节点的前驱节点 final Node p = node.predecessor(); //前驱节点为头节点且成功获取同步状态 if (p == head && tryAcquire(arg)) { //设置当前节点为头节点 setHead(node); p.next = null; // help GC failed = false; return interrupted; } //是否阻塞 if (shouldParkAfterFailedAcquire(p, node) && parkAndCheckInterrupt()) interrupted = true; } } finally { if (failed) cancelAcquire(node); } } 再来看看shouldParkAfterFailedAcquire和parkAndCheckInterrupt是怎么来阻塞当前线程的,代码如下: private static boolean shouldParkAfterFailedAcquire(Node pred, Node node) { //前驱节点的状态决定后续节点的行为 int ws = pred.waitStatus; if (ws == Node.SIGNAL) /*前驱节点为-1 后续节点可以被阻塞 * This node has already set status asking a release * to signal it, so it can safely park. */ return true; if (ws > 0) { /* * Predecessor was cancelled. Skip over predecessors and * indicate retry. */ do { node.prev = pred = pred.prev; } while (pred.waitStatus > 0); pred.next = node; } else { /*前驱节点是初始或者共享状态就设置为-1 使后续节点阻塞 * waitStatus must be 0 or PROPAGATE. Indicate that we * need a signal, but don't park yet. Caller will need to * retry to make sure it cannot acquire before parking. */ compareAndSetWaitStatus(pred, ws, Node.SIGNAL); } return false; } private final boolean parkAndCheckInterrupt() { //阻塞线程 LockSupport.park(this); return Thread.interrupted(); } 节点自旋的过程大致示意图如下,其实就是对图二、图三的补充。 图六 节点自旋获取队列同步状态 整个独占式获取同步状态的流程图大致如下: 图七 独占式获取同步状态 当同步状态获取成功之后,当前线程从acquire方法返回,对于锁这种并发组件而言,就意味着当前线程获取了锁。有获取同步状态的方法,就存在其对应的释放方法,该方法为release,现在来看下这个方法的实现,代码如下: public final boolean release(int arg) { if (tryRelease(arg)) {//同步状态释放成功 Node h = head; if (h != null && h.waitStatus != 0) //直接释放头节点 unparkSuccessor(h); return true; } return false; } private void unparkSuccessor(Node node) { /* * If status is negative (i.e., possibly needing signal) try * to clear in anticipation of signalling. It is OK if this * fails or if status is changed by waiting thread. */ int ws = node.waitStatus; if (ws < 0) compareAndSetWaitStatus(node, ws, 0); /*寻找符合条件的后续节点 * Thread to unpark is held in successor, which is normally * just the next node. But if cancelled or apparently null, * traverse backwards from tail to find the actual * non-cancelled successor. */ Node s = node.next; if (s == null || s.waitStatus > 0) { s = null; for (Node t = tail; t != null && t != node; t = t.prev) if (t.waitStatus <= 0) s = t; } if (s != null) //唤醒后续节点 LockSupport.unpark(s.thread); } 独占式释放是非常简单而且明确的。 总结下独占式同步状态的获取和释放:在获取同步状态时,同步器维护一个同步队列,获取状态失败的线程都会被加入到队列中并在队列中进行自旋;移出队列的条件是前驱节点为头节点且成功获取了同步状态。在释放同步状态时,同步器调用tryRelease方法释放同步状态,然后唤醒头节点的后继节点。 3.2共享式同步状态的获取和释放 共享式同步状态调用的方法是acquireShared,代码如下: public final void acquireShared(int arg) { //获取同步状态的返回值大于等于0时表示可以获取同步状态 //小于0时表示可以获取不到同步状态 需要进入队列等待 if (tryAcquireShared(arg) < 0) doAcquireShared(arg); } private void doAcquireShared(int arg) { //和独占式一样的入队操作 final Node node = addWaiter(Node.SHARED); boolean failed = true; try { boolean interrupted = false; //自旋 for (;;) { final Node p = node.predecessor(); if (p == head) { int r = tryAcquireShared(arg); if (r >= 0) { //前驱结点为头节点且成功获取同步状态 可退出自旋 setHeadAndPropagate(node, r); p.next = null; // help GC if (interrupted) selfInterrupt(); failed = false; return; } } if (shouldParkAfterFailedAcquire(p, node) && parkAndCheckInterrupt()) interrupted = true; } } finally { if (failed) cancelAcquire(node); } } private void setHeadAndPropagate(Node node, int propagate) { Node h = head; // Record old head for check below //退出自旋的节点变成首节点 setHead(node); /* * Try to signal next queued node if: * Propagation was indicated by caller, * or was recorded (as h.waitStatus either before * or after setHead) by a previous operation * (note: this uses sign-check of waitStatus because * PROPAGATE status may transition to SIGNAL.) * and * The next node is waiting in shared mode, * or we don't know, because it appears null * * The conservatism in both of these checks may cause * unnecessary wake-ups, but only when there are multiple * racing acquires/releases, so most need signals now or soon * anyway. */ if (propagate > 0 || h == null || h.waitStatus < 0 || (h = head) == null || h.waitStatus < 0) { Node s = node.next; if (s == null || s.isShared()) doReleaseShared(); } } 与独占式一样,共享式获取也需要释放同步状态,通过调用releaseShared方法可以释放同步状态,代码如下: public final boolean releaseShared(int arg) { //释放同步状态 if (tryReleaseShared(arg)) { //唤醒后续等待的节点 doReleaseShared(); return true; } return false; } private void doReleaseShared() { /* * Ensure that a release propagates, even if there are other * in-progress acquires/releases. This proceeds in the usual * way of trying to unparkSuccessor of head if it needs * signal. But if it does not, status is set to PROPAGATE to * ensure that upon release, propagation continues. * Additionally, we must loop in case a new node is added * while we are doing this. Also, unlike other uses of * unparkSuccessor, we need to know if CAS to reset status * fails, if so rechecking. */ //自旋 for (;;) { Node h = head; if (h != null && h != tail) { int ws = h.waitStatus; if (ws == Node.SIGNAL) { if (!compareAndSetWaitStatus(h, Node.SIGNAL, 0)) continue; // loop to recheck cases //唤醒后续节点 unparkSuccessor(h); } else if (ws == 0 && !compareAndSetWaitStatus(h, 0, Node.PROPAGATE)) continue; // loop on failed CAS } if (h == head) // loop if head changed break; } } unparkSuccessor方法和独占式是一样的。 4、AQS应用 AQS被大量的应用在了同步工具上。 ReentrantLock:ReentrantLock类使用AQS同步状态来保存锁重复持有的次数。当锁被一个线程获取时,ReentrantLock也会记录下当前获得锁的线程标识,以便检查是否是重复获取,以及当错误的线程试图进行解锁操作时检测是否存在非法状态异常。ReentrantLock也使用了AQS提供的ConditionObject,还向外暴露了其它监控和监测相关的方法。 ReentrantReadWriteLock:ReentrantReadWriteLock类使用AQS同步状态中的16位来保存写锁持有的次数,剩下的16位用来保存读锁的持有次数。WriteLock的构建方式同ReentrantLock。ReadLock则通过使用acquireShared方法来支持同时允许多个读线程。 Semaphore:Semaphore类(信号量)使用AQS同步状态来保存信号量的当前计数。它里面定义的acquireShared方法会减少计数,或当计数为非正值时阻塞线程;tryRelease方法会增加计数,在计数为正值时还要解除线程的阻塞。 CountDownLatch:CountDownLatch类使用AQS同步状态来表示计数。当该计数为0时,所有的acquire操作(对应到CountDownLatch中就是await方法)才能通过。 FutureTask:FutureTask类使用AQS同步状态来表示某个异步计算任务的运行状态(初始化、运行中、被取消和完成)。设置(FutureTask的set方法)或取消(FutureTask的cancel方法)一个FutureTask时会调用AQS的release操作,等待计算结果的线程的阻塞解除是通过AQS的acquire操作实现的。 SynchronousQueues:SynchronousQueues类使用了内部的等待节点,这些节点可以用于协调生产者和消费者。同时,它使用AQS同步状态来控制当某个消费者消费当前一项时,允许一个生产者继续生产,反之亦然。 除了这些j.u.c提供的工具,还可以基于AQS自定义符合自己需求的同步器。 AQS就学习到这,如果有描述不当的地方,还请留言交流。了解了AQS后下一步准备详细学习基于AQS的工具类。

优秀的个人博客,低调大师

Python网络编程 —— 进程

个人独立博客:www.limiao.tech 微信公众号:TechBoard 进程 进程:通俗理解就是一个运行的程序或者软件,进程是操作系统资源分配的基本单位 一个程序至少有一个进程,一个进程至少有一个线程,多进程可以完成多任务 进程的状态 工作中,任务数往往大于cpu的核数,即一定有一些任务正在执行,而另外一些任务在等待cpu进行执行,因此导致了有了不同的状态 进程的使用 导入进程模块: import multiprocessing 用进程完成多任务 import multiprocessing import time def sing(): for i in range(10): print("唱歌中...") time.sleep(0.2) def dance(): for i in range(10): print("跳舞中...") time.sleep(0.2) if __name__ == "__main__": # 创建对应的子进程执行对应的任务 sing_process = multiprocessing.Process(target=sing) dance_process = multiprocessing.Process(target=dance) # 启动进程执行对应的任务 sing_process.start() dance_process.start() Process类参数介绍 import multiprocessing import os def show_info(name,age): print("show_info:", multiprocessing.current_process()) # 获取进程的编号 pritn("show_info pid:", multiprocessing.current_process().pid, os.getpid) print(name, age) if __name__ == "__main__": # 创建子进程 # group: 进程组,目前只能使用None # target: 执行的目标任务 # args: 以元组方式传参 # kwargs: 以字典方式传参 sub_prcess = multiprocessing.Process(group=None, target=show_info, arg=("杨幂", 18)) sub_prcess.start() 进程之间不共享全局变量 import multiprocessing import time # 全局变量 g_list = [] # 添加数据 def add_data(): for i in range(15): g_list.append(i) time.sleep(0.1) print("add_data:", g_list) # 读取数据 def read_data(): print("read_data:", g_list) if __name__ == "__main__": # 创建添加数据的子进程 add_process = multiprocessing.Process(target=add_data) # 创建读取数据的子进程 read_process = multiprocessing.Process(target=read_data) # 启动进程 add_process.start() # 主进程等待添加数据的子进程执行完成以后再执行读取进程的操作 add_process.join() # 代码执行到此说明添加数据的子进程把任务执行完成了 read_process.start() 创建子进程其实就是对主进程资源的拷贝 主进程会等待所有的子进程执行完成程序再退出 import multiprocessing import time # 工作任务 def work(): for i in range(10): print("工作中...") time.sleep(0.3) if __name__ == "__main__": # 创建子进程 sub_prcess = multiprocessing.Process(target=work) # 查看进程的守护状态 # print(sub_prcess.daemon) # 守护主进程,主进程退出子进程直接销毁,不再执行子进程里面的代码 # sub_prcess.daemon = True # 启动进程执行对应的任务 sub_process.start() # 主进程延时1s time.sleep(1) print("主进程执行完了") # 主进程退出之前把所有的子进程销毁 sub_prcess.terminate() exit() 总结: 主进程会等待所有的子进程执行完成程序再退出 获取进程pid # 获取进程pid import multiprocessing import time import os def work(): # 获取当前进程编号 print("work进程编号:", os.getpid()) # 获取父进程编号 print("work父进程编号:", os.getppid()) for i in range(10): print("工作中...") time.sleep(1) # 扩展:根据进程编号杀死对应的进程 # os.kill(os.getpid(), 9) if __name__ == '__main__': # 获取当前进程的编号: print("当前进程编号:", multiprocessing.current_process().pid) # 创建子进程 sub_process = multiprocessing.Process(target=work) # 启动进程 sub_process.start() # 主进程执行打印信息操作 for i in range(20): print("我在主进程中执行...") time.sleep(1) 运行结果: 当前进程编号: 624 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... work进程编号: 1312 work父进程编号: 624 工作中... 工作中... 工作中... 工作中... 工作中... 工作中... 工作中... 工作中... 工作中... 工作中... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... 我在主进程中执行... ***Repl Closed*** 进程间通信——Queue 可以使用multiprocessing模块Queue实现多进程之间的数据传递,Queue本身是一个消息队列程序 import multiprocessing if __name__ == "__main__": # 创建消息队列 # 3:表示消息队列的最大个数 queue = multiprocessing.Queue(3) # 存放数据 queue.put(1) queue.put("hello") queue.put([1, 5, 8]) # 总结:队列可以放入任意类型的数据 # queue.put("xxx": "yyy") # 放入消息的时候不会进行等待,如果发现队列满了不能放入数据,那么会直接崩溃 # 建议: 放入数据统一使用 put 方法 # queue.put_nowait(("xxx": "yyy")) # 判断队列是否满了 result = queue.full() print(result) # 判断队列是否为空,不靠谱(加延时可解决) result = queue.empty() print("队列是否为空:", result) # 获取队列消息个数 size = queue.qsize() print("消息个数:", size) # 获取队列中的数据 res = queue.get() print(res) # 如果队列空了,那么使用get方法会等待队列有消息以后再取值 消息队列Queue完成进程间通信的演练 import multiprocessing import time # 添加数据 def add_data(queue): for i in range(5): # 判断队列是否满了 if queue.full(): # 如果满了跳出循环,不再添加数据 print("队列满了") break queue.put(i) print("add:", i) time.sleep(0.1) def read_data(queue): while True: if queue.qsize == 0: print("队列空了") break result = queue.get() print("read:", result) if __name__ == "__main__": # 创建消息队列 queue = multiprocessing.Queue(3) # 创建添加数据的子进程 add_process = multiprocessing.Process(target=add_data, args=(queue,)) # 创建读取数据的子进程 read_process = multiprocessing.Process(target=read_data, args=(queue,)) # 启动进程 add_process.start() # 主进程等待写入进程执行完成以后代码再继续往下执行 add_process.join() read_process.start() 进程池Pool 进程池的概念 池子里面放的是进程,进程池会根据任务执行情况自动创建进程,而且尽量少创建进程,合理利用进程池中的进程完成多任务 当需要创建的子进程数量不多时,可以直接利用multiprocess中的Process动态生成多个进程,但如果是上百甚至上千个目标,手动的去创建进程的工作量巨大,此时就可以用到multiprocess模块提供的Pool方法。 初始化Pool时,可以指定一个最大进程数,当有新的请求提到Pool中时,如果池还没有满,那么就会创建一个新的进程用来执行该请求,但如果池中的进程数已经达到指定的最大值,那么该请求就会等待,直到池中有进程结束,才会用之前的进程来执行新的任务。 进程池同步执行任务 进程池同步执行任务表示进程池中的进程在执行任务的时候一个执行完成另外一个才能执行,如果没有执行完会等待上一个进程执行 进程池同步实例代码 import multiprocessing import time # 拷贝任务 def work(): print("复制中...", multiprocessing.current_process().pid) time.sleep(1) if __name__ == '__main__': # 创建进程池 #3:进程池中进程的最大个数 pool = multiprocessing.Pool(3) # 模拟大批量的任务,让进程池去执行 for i in range(5): # 循环让进程池执行对应的work任务 # 同步执行任务,一个任务执行完成以后另外一个任务才能执行 pool.apply(work) 运行结果: 复制中... 6172 复制中... 972 复制中... 972 复制中... 1624 复制中... 1624 ***Repl Closed*** 进程池异步执行任务 进程池异步执行任务表示进程池中的进程同时执行任务,进程之间不会等待 进程池异步实例代码 import multiprocessing import time # 拷贝任务 def work(): print("复制中...", multiprocessing.current_process().pid) # 获取当前进程的守护状态 # 提示:使用进程池创建的进程时守护主进程的状态,默认自己通过Process创建的进程是不守护主进程的状态 # print(multiprocessing.current_process().daemon) time.sleep(1) if __name__ == '__main__': # 创建进程池 # 3:进程池中进程的最大个数 pool = multiprocessing.Pool(3) # 模拟大批量的任务,让进程池去执行 for i in range(5): # 循环让进程池执行对应的work任务 # 同步执行任务,一个任务执行完成以后另外一个任务才能执行 # pool.apply(work) # 异步执行,任务执行不会等待,多个任务一起执行 pool.apply_async(work) # 关闭进程池,意思告诉主进程以后不会有新的任务添加进来 pool.close() # 主进程等待进程池执行完成以后程序再退出 pool.join() 运行结果: 复制中... 1848 复制中... 12684 复制中... 12684 复制中... 6836 复制中... 6836 ***Repl Closed*** 个人独立博客:www.limiao.tech 微信公众号:TechBoard

优秀的个人博客,低调大师

Python网络编程 —— 线程

个人独立博客:www.limiao.tech 微信公众号:TechBoard 线程的概念 线程就是在程序运行过程中,执行程序代码的一个分支,每个运行的程序至少都有一个线程 单线程执行 import time def sing(): for i in range(3): print("唱歌...%d" % i) time.sleep(1) def dance(): for i in range(3): print("跳舞...%d" % i) time.sleep(1) if __name__ == '__main__': sing() dance() 运行结果: 唱歌...0 唱歌...1 唱歌...2 跳舞...0 跳舞...1 跳舞...2 ***Repl Closed*** 多线程执行 多线程的执行需要导入threading模块 参数说明: Thread([group[,target[,name[,args[,kwargs]]]]]) - group: 线程组,目前只能使用None - target: 执行的目标任务名 - args: 以元组的方式给执行任务传参 - kwargs: 以字典方式给执行任务传参 - name: 线程名,一般不用设置 多线程完成多任务 # 多线程执行 import time, threading def sing(): # 获取当前进程 print(threading.current_thread()) for i in range(3): print("唱歌...%d" % i) time.sleep(1) def dance(): print(threading.current_thread()) for i in range(3): print("跳舞...%d" % i) time.sleep(1) if __name__ == '__main__': sing_thread = threading.Thread(target=sing) dance_thread = threading.Thread(target=dance) sing_thread.start() dance_thread.start() 运行结果: <Thread(Thread-1, started 8520)> 唱歌...0 <Thread(Thread-2, started 4604)> 跳舞...0 唱歌...1 跳舞...1 唱歌...2 跳舞...2 ***Repl Closed*** 多线程执行带有参数的任务 import time, threading def sing(num): for i in range(num): print("唱歌...%d" % i) time.sleep(1) def dance(num): for i in range(num): print("跳舞...%d" % i) time.sleep(1) if __name__ == '__main__': sing_thread = threading.Thread(target=sing, args=(3,)) dance_thread = threading.Thread(target=dance, kwargs={"num": 3}) sing_thread.start() dance_thread.start() 运行结果: 唱歌...0 跳舞...0 跳舞...1 唱歌...1 跳舞...2 唱歌...2 ***Repl Closed*** 查看获取线程列表 import time, threading def sing(): for i in range(5): print("唱歌...%d" % i) time.sleep(1) def dance(): for i in range(5): print("跳舞...%d" % i) time.sleep(1) if __name__ == '__main__': # 获取当前程序活动线程的列表 thread_list = threading.enumerate() print("111:", thread_list, len(thread_list)) sing_thread = threading.Thread(target=sing) dance_thread = threading.Thread(target=dance) thread_list = threading.enumerate() print("222:", thread_list, len(thread_list)) # 启动线程 sing_thread.start() dance_thread.start() # 只有线程启动了,才能加入到活动线程列表中 thread_list = threading.enumerate() print("333:", thread_list, len(thread_list)) 运行结果: 111: [<_MainThread(MainThread, started 11864)>] 1 222: [<_MainThread(MainThread, started 11864)>] 1 唱歌...0 跳舞...0 333: [<_MainThread(MainThread, started 11864)>, <Thread(Thread-1, started 892)>, <Thread(Thread-2, started 6444)>] 3 跳舞...1 唱歌...1 跳舞...2 唱歌...2 唱歌...3 跳舞...3 唱歌...4 跳舞...4 ***Repl Closed*** 注意 线程之间执行是无序的 import time, threading def task(): time.sleep(1) print("当前线程:", threading.current_thread().name) if __name__ == '__main__': for _ in range(5): sub_thread = threading.Thread(target=task) sub_thread.start() 运行结果: 当前线程: Thread-5 当前线程: Thread-2 当前线程: Thread-3 当前线程: Thread-1 当前线程: Thread-4 ***Repl Closed*** 主线程会等待所有的子线程结束后才结束 # 主线程会等待所有的子线程结束后才会结束 import time, threading # 测试主线程是否会等待子线程执行完成以后程序再退出 def show_info(): for i in range(5): print("test:", i) time.sleep(1) if __name__ == '__main__': sub_thread = threading.Thread(target=show_info) sub_thread.start() # 主线程延时5秒 time.sleep(10) print("over") 运行结果: test: 0 test: 1 test: 2 test: 3 test: 4 over ***Repl Closed*** 守护主线程 import time, threading def show_info(): for i in range(5): print("test:", i) time.sleep(1) if __name__ == '__main__': # 设置成守护主线程,主线程退出后子线程直接销毁不再执行子线程的代码 sub_thread = threading.Thread(target=show_info, daemon=True) sub_thread.start() time.sleep(10) print("over") 运行结果: test: 0 test: 1 test: 2 test: 3 test: 4 over ***Repl Closed*** 自定义线程 import threading # 自定义线程类 class MyThread(threading.Thread): # 通过构造方法取接受任务的参数 def __init__(self, info1, info2): # 调用父类的构造方法 super().__init__() self.info1 = info1 self.info2 = info2 # 定义自定义线程相关的任务 def test1(self): print(self.info1) def test2(self): print(self.info2) # 通过run方法执行相关任务 def run(self): self.test1() self.test2() # 创建自定义线程 my_thread = MyThread("测试1", "测试2") # 启动 my_thread.start() 运行结果: 测试1 测试2 ***Repl Closed*** 总结: 自定义线程不能指定target,因为自定义线程里面的任务都统一在run方法里面执行 启动线程统一调用start方法,不要直接调用run方法,因为这样不是使用子线程去执行任务 多线程共享全局变量 import time, threading # 定义全局变量 my_list = list() # 写入数据任务 def write_data(): for i in range(5): my_list.append(i) time.sleep(1) print("write_data:", my_list) # 读取数据任务 def read_data(): print("read_data:", my_list) if __name__ == '__main__': # 创建写入数据的线程 write_thread = threading.Thread(target=write_data) # 创建读取数据的线程 read_thread = threading.Thread(target=read_data) write_thread.start() # 主线程等待写入线程执行完成以后代码再继续往下执行 write_thread.join() print("开始读取数据...") read_thread.start() 运行结果: write_data: [0, 1, 2, 3, 4] 开始读取数据... read_data: [0, 1, 2, 3, 4] ***Repl Closed*** 多线程同时对全局变量进行操作,导致数据可能出现错误 import threading # 定义全局变量 g_num = 0 # 循环一次给全局变量加1 def sum_num1(): for i in range(1000000): global g_num g_num += 1 print("sum1:", g_num) # 循环一次给全局变量加1 def sum_num2(): for i in range(1000000): global g_num g_num += 1 print("sum2:", g_num) if __name__ == '__main__': # 创建两个线程 first_thread = threading.Thread(target=sum_num1) second_thread = threading.Thread(target=sum_num2) first_thread.start() second_thread.start() 运行结果: sum1: 1491056 sum2: 1528560 ***Repl Closed*** 通过上面运行结果,得出:多线程同时对全局变量操作数据发生了错误 原因分析:两个线程first_thread和second_thread都要对全局变量g_num(默认是0)进行加1运算,但是由于是多线程同时操作,,有可能出现下面的情况: 1.在g_num=0时,first_thread取得g_num=0.此时系统把first_thread调度为"sleeping"状态,把second_thread转换为"running"状态,t2也获得g_num=0 2.然后second_thread对得到的值进行加1并赋给g_num,使得g_num=1 3.然后系统又把second_thread调度为"sleeping",把first_thread转为"running".线程t1又把之前得到的0加1后赋值给g_num. 4.这样导致虽然first_thread和second_thread都对g_num加1,但结果仍然是g_num=1。 全局变量数据错误的解决办法 线程同步:保证同一时刻只能有一个线程去操作全局变量同步,就是协同步调,按预定的先后次序进行运行 线程同步的方式: 1.线程等待(join) 2.互斥锁 线程等待实现方式: import threading # 定义全局变量 g_num = 0 # 循环一次给全局变量加1 def sum_num1(): for i in range(1000000): global g_num g_num += 1 print("sum1:", g_num) # 循环一次给全局变量加1 def sum_num2(): for i in range(1000000): global g_num g_num += 1 print("sum2:", g_num) if __name__ == '__main__': # 创建两个线程 first_thread = threading.Thread(target=sum_num1) second_thread = threading.Thread(target=sum_num2) first_thread.start() first_thread.join() second_thread.start() 运行结果: sum1: 1000000 sum2: 2000000 ***Repl Closed*** 结论:多个线程同时对同一个全局变量进行操作,会有可能出现资源竞争数据错误的问题 线程同步方式可以解决资源竞争数据错误问题,但是这样有多任务变成了单任务 互斥锁 对共享数据进行锁定,保证同一时刻只能有一个线程去操作 抢到锁的线程先执行,没有抢到锁的线程需要等待,等锁用完后需要释放,然后其它等待的线程再去抢这个锁,哪个线程抢到,那个线程再执行 具体哪个线程抢到这个锁,我们决定不了,是由CPU调度决定的 线程同步能够保证多个线程安全访问竞争资源,最简单的同步机制是引入互斥锁 互斥锁为资源引入的一个状态:锁定/非锁定 某个线程要更改共享数据时,先将其锁定,此时资源的状态为"锁定",其他线程不能更改;直到该线程释放资源,将资源的状态变成"非锁定",其他的线程才能再次锁定该资源。互斥锁保证了每次只有一个线程进行写入操作,从而保证了多线程情况下数据的正确性。 创建锁: a = threading.Lock() 锁定 a.acquire() 释放 a.release() 注意: 1.如果这个锁之前时没有上锁的,那么acquire不会堵塞 2.如果在调用acquire对这个锁上锁之前,它已经被其它线程上了锁,那么此时acquire会堵塞,直到这个锁被解锁为止 # 使用互斥锁完成2个线程对同一个全局变量各加100万次的操作 import threading # 定义全局变量 g_num = 0 # 创建全局互斥锁 lock = threading.Lock() # 循环一次给全局变量加1 def sum_num1(): # 上锁 lock.acquire() for i in range(1000000): global g_num g_num += 1 print("sun1:", g_num) # 释放锁 lock.release() # 循环一次给全局变量加1 def sum_num2(): # 上锁 lock.acquire() for i in range(1000000): global g_num g_num += 1 print("sum2:", g_num) # 释放锁 lock.release() if __name__ == '__main__': # 创建线程 first_thread = threading.Thread(target=sum_num1) second_thread = threading.Thread(target=sum_num2) # 启动线程 first_thread.start() second_thread.start() 运行结果: sun1: 1000000 sum2: 2000000 ***Repl Closed*** 注意 加上互斥锁,哪个线程抢到这个锁我们决定不了,哪个线程抢到锁哪个线程先执行,没有抢到的线程需要等待 加上互斥锁多任务瞬间变成单任务,性能会下降,也就是说同一时刻只能有一个线程去执行 使用互斥锁的目的 能够保证多个线程访问共享数据不会出现资源竞争及数据错误 上锁、解锁过程 当一个线程调用锁的acquire()方法获得锁时,锁就进去了"locked"状态。 每次只有一个而线程可以获得锁,如果此时另一个线程试图获得这个锁,该线程就会变为"blocked"状态,称为"阻塞",直到拥有锁的线程调用锁的release()方法释放锁之后,锁进入"unlocked"状态。 线程调度程序从处于同步阻塞状态的线程中选择一个来获得锁,并使得该线程进入运行"running"状态 死锁 一直等待对方释放锁的情景就是死锁 根据下标在列表中取值,但是要保证同一时刻只能有一个线程去取值 # 死锁示例: import time, threading # 创建互斥锁 lock = threading.Lock() def get_value(index): # 上锁 lock.acquire() print(threading.current_thread().name) my_list = [3, 6, 8, 1] # 判断下标释放越界 if index >= len(my_list): print("下标越界:", index) return value = my_list[index] print(value) time.sleep(1) # 释放锁 lock.release() if __name__ == '__main__': # 模拟大量线程去执行取值操作 for i in range(30): sub_thread = threading.Thread(target=get_value, args=(i,)) sub_thread.start() 避免死锁: # 死锁示例: import time, threading # 创建互斥锁 lock = threading.Lock() def get_value(index): # 上锁 lock.acquire() print(threading.current_thread().name) my_list = [3, 6, 8, 1] # 判断下标释放越界 if index >= len(my_list): print("下标越界:", index) lock.release() return value = my_list[index] print(value) time.sleep(1) # 释放锁 lock.release() if __name__ == '__main__': # 模拟大量线程去执行取值操作 for i in range(30): sub_thread = threading.Thread(target=get_value, args=(i,)) sub_thread.start() 小结:使用互斥锁的时候需要注意死锁的问题,要在合适的地方注意释放锁 死锁一旦发生就会造成应用的停止响应 个人独立博客:www.limiao.tech 微信公众号:TechBoard

优秀的个人博客,低调大师

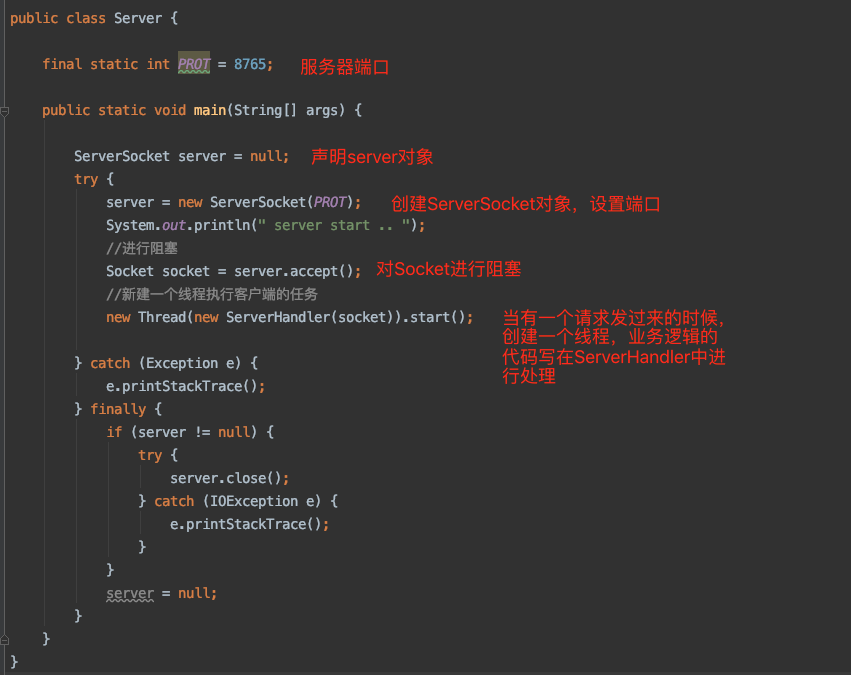
Java网络编程-NIO

构造函数 首先放一个NIO的使用流程 1、创建ServerSocketChannel,配置为非阻塞模式 2、绑定监听,配置TCP参数,例如backlog大小; 3、创建一个独立的IO线程,用于轮询多路复用器Selector; 4、创建Selector,将之前创建的ServerSocketChannel注册到Selector上,监听SelectionKey.ACCEPT 5、启动IO线程,在循环体中之行Selector.select()方法,轮询就绪的Channel; 6、当轮训到了处于就绪状态的channel时,需要对其进行判断,如果是OP_ACCEPT状态,说明是新的客户端接入,则调用ServerSocketChannel.accept()方法接受新的客户端; 7、设置新借入的客户端链路SocketChannel为非阻塞模式,配置其他的一些TCP 8、将SocketChannel注册到Selector,监听OP_READ操作位; 9、如果轮训的Channel为OP_READ,则说明SocketChannel中,有心得就绪的数据包需要读取,则构造ByteBuffer对象,读取数据包; 10、如果轮训的Channel为OP_WRITE,说明还有数据没有发送完成,需要继续发送

优秀的个人博客,低调大师

Python socket 编程理解

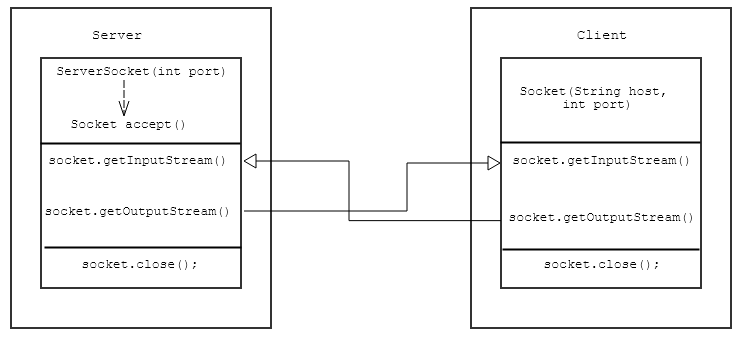
HTTP 、Socket 、 TCP 七层OSI网络模型,这里只介绍五层常用网络模型,想知道全部七层详细内容自行查询。 应用层 :HTTP FTP SMTP DNS Telnet 传输层 :TCP UDP 网络层 :IP ICMP 数据链路层 :ARP等 物理层 :1000BASE-SX等 socket是用来连接传输层和应用层,使得应用层可以直接和传输层做交互。 socket本身不属于网络协议,socket可以直接操控tcp,这样可以实现自己的应用层协议,例如聊天室就是,socket可以直接和tcp打交道,实现与http同级别的网络协议。 image.png image.png 上图左侧是server端,右侧是client端

优秀的个人博客,低调大师

Android--Https编程

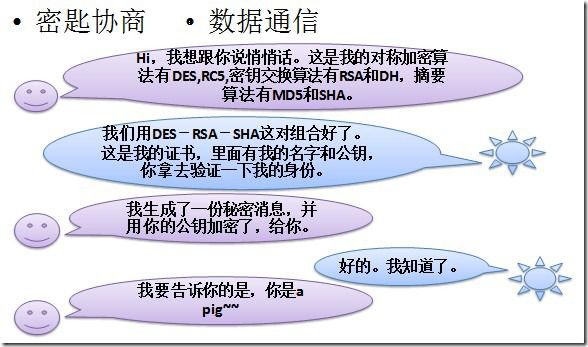
概述 SSL(Secure Sockets Layer安全套接层),为网景公司(Netscape)所研发,用以保障在Internet 上数据传输之安全,利用数据加密(Encryption)技术,可确保数据在网络上之传输过程中不会被截取及窃听。一般通用之规格为40 bit 之安全标准,美国则已推出128 bit 之更高安全标准,但限制出境。只要3.0 版本以上之I.E.或Netscape 浏览器即可支持SSL。 TLS(Transport Layer Security传输层安全),用于在两个通信应用程序之间提供保密性和数据完整性。TLS 是SSL 的标准化后的产物,有1.0 ,1.1 ,1.2 三个版本,默认使用1.0。TLS1.0 和SSL3.0 几乎没有区别,事实上我们现在用的都是TLS,但因为历史上习惯了SSL 这个称呼。 SSL 通信简单图示: SSL 通信详细图示: 当请求使用自签名证书的网站数据时,例如请求12306 的客运服务页面:https://kyfw.12306.cn/otn/,则会报下面的错误,原因是客户端的根认证机构不能识别该证书错误信息:unable to find valid certification path to requested target 解决方案1 一个证书可不可信,是由TrustManager 决定的,所以我们只需要自定义一个什么都不做的TrustManager即可,服务器出示的所有证书都不做校验,一律放行。 public static void main(String[] args) throws Exception { //协议传输层安全TLS(transport layer secure) SSLContext sslContext = SSLContext.getInstance("TLS"); //创建信任管理器(TrustManager 负责校验证书是否可信) TrustManager[] tm = new TrustManager[]{new EmptyX509TrustManager()}; //使用自定义的信任管理器初始化SSL 上下文对象 sslContext.init(null, tm, null); //设置全局的SSLSocketFactory 工厂(对所有ssl 链接都产生影响) HttpsURLConnection.setDefaultSSLSocketFactory(sslContext.getSocketFactory()); //URL url = new URL("https://www.baidu.com"); URL url = new URL("https://kyfw.12306.cn/otn/"); HttpsURLConnection conn = (HttpsURLConnection) url.openConnection(); InputStream in = conn.getInputStream(); System.out.println(Util.inputstream2String(in)); } /** * 自定义一个什么都不做的信任管理器,所有证书都不做校验,一律放行 */ private static class EmptyX509TrustManager implements X509TrustManager{ @Override public void checkClientTrusted(X509Certificate[] chain, String authType) throws CertificateException { } @Override public void checkServerTrusted(X509Certificate[] chain, String authType) throws CertificateException { } @Override public X509Certificate[] getAcceptedIssuers() { return null; } } 解决方案2 12306 服务器出示的证书是中铁集团SRCA 给他颁发的,所以SRCA 的证书是能够识别12306 的证书的,所以只需要把SRCA 证书导入系统的KeyStore 里,之后交给TrustManagerFactory 进行初始化,则可把SRCA 添加至根证书认证机构,之后校验的时候,SRCA 对12306 证书校验时就能通过认证。 这种解决方案有两种使用方式:一是直接使用SRCA.cer 文件,二是使用改文件的RFC 格式数据,将其写在代码里。 //12306 证书的RFC 格式(注意要记得手动添加两个换行符) private static final String CERT_12306_RFC = "-----BEGIN CERTIFICATE-----\n"+ "MIICmjCCAgOgAwIBAgIIbyZr5/jKH6QwDQYJKoZIhvcNAQEFBQAwRzELMAkGA1UEBhMCQ04xKTAn"+ "BgNVBAoTIFNpbm9yYWlsIENlcnRpZmljYXRpb24gQXV0aG9yaXR5MQ0wCwYDVQQDEwRTUkNBMB4X"+ "DTA5MDUyNTA2NTYwMFoXDTI5MDUyMDA2NTYwMFowRzELMAkGA1UEBhMCQ04xKTAnBgNVBAoTIFNp"+ "bm9yYWlsIENlcnRpZmljYXRpb24gQXV0aG9yaXR5MQ0wCwYDVQQDEwRTUkNBMIGfMA0GCSqGSIb3"+ "DQEBAQUAA4GNADCBiQKBgQDMpbNeb34p0GvLkZ6t72/OOba4mX2K/eZRWFfnuk8e5jKDH+9BgCb2"+ "9bSotqPqTbxXWPxIOz8EjyUO3bfR5pQ8ovNTOlks2rS5BdMhoi4sUjCKi5ELiqtyww/XgY5iFqv6"+ "D4Pw9QvOUcdRVSbPWo1DwMmH75It6pk/rARIFHEjWwIDAQABo4GOMIGLMB8GA1UdIwQYMBaAFHle"+ "tne34lKDQ+3HUYhMY4UsAENYMAwGA1UdEwQFMAMBAf8wLgYDVR0fBCcwJTAjoCGgH4YdaHR0cDov"+ "LzE5Mi4xNjguOS4xNDkvY3JsMS5jcmwwCwYDVR0PBAQDAgH+MB0GA1UdDgQWBBR5XrZ3t+JSg0Pt"+ "x1GITGOFLABDWDANBgkqhkiG9w0BAQUFAAOBgQDGrAm2U/of1LbOnG2bnnQtgcVaBXiVJF8LKPaV"+ "23XQ96HU8xfgSZMJS6U00WHAI7zp0q208RSUft9wDq9ee///VOhzR6Tebg9QfyPSohkBrhXQenvQ"+ "og555S+C3eJAAVeNCTeMS3N/M5hzBRJAoffn3qoYdAO1Q8bTguOi+2849A=="+ "-----END CERTIFICATE-----\n"; public static void main(String[] args) throws Exception { // 使用传输层安全协议TLS(transport layer secure) SSLContext sslContext = SSLContext.getInstance("TLS"); //使用SRCA.cer 文件的形式 //FileInputStream certInputStream = new FileInputStream(new File("srca.cer")); //也可以通过RFC 字符串的形式使用证书 ByteArrayInputStream certInputStream = new ByteArrayInputStream(CERT_12306_RFC.getBytes()); // 初始化keyStore,用来导入证书 KeyStore keyStore = KeyStore.getInstance(KeyStore.getDefaultType()); //参数null 表示使用系统默认keystore,也可使用其他keystore(需事先将srca.cer 证书导入 keystore 里) keyStore.load(null); //通过流创建一个证书 Certificate certificate = CertificateFactory.getInstance("X.509") .generateCertificate(certInputStream); // 把srca.cer 这个证书导入到KeyStore 里,别名叫做srca keyStore.setCertificateEntry("srca", certificate); // 设置使用keyStore 去进行证书校验 TrustManagerFactory trustManagerFactory = TrustManagerFactory .getInstance(TrustManagerFactory.getDefaultAlgorithm()); trustManagerFactory.init(keyStore); //用我们设定好的TrustManager 去做ssl 通信协议校验,即证书校验 sslContext.init(null, trustManagerFactory.getTrustManagers(), null); HttpsURLConnection.setDefaultSSLSocketFactory(sslContext .getSocketFactory()); URL url = new URL("https://kyfw.12306.cn/otn/"); HttpsURLConnection conn = (HttpsURLConnection) url.openConnection(); InputStream in = conn.getInputStream(); System.out.println(Util.inputstream2String(in)); } Android 里的https 请求: 把scra.cer 文件考到assets 或raw 目录下,或者直接使用证书的RFC 格式,接下来的做法和java工程代码一样 //ByteArrayInputStream in = new ByteArrayInputStream("rfc".getBytes()); CertificateFactory cf = CertificateFactory.getInstance("X.509"); InputStream caInput = new BufferedInputStream(new FileInputStream("load-der.crt")); Certificate ca; try { ca = cf.generateCertificate(caInput); System.out.println("ca=" + ((X509Certificate) ca).getSubjectDN()); } finally { caInput.close(); } String keyStoreType = KeyStore.getDefaultType(); KeyStore keyStore = KeyStore.getInstance(keyStoreType); keyStore.load(null, null); keyStore.setCertificateEntry("ca", ca); String tmfAlgorithm = TrustManagerFactory.getDefaultAlgorithm(); TrustManagerFactory tmf = TrustManagerFactory.getInstance(tmfAlgorithm); tmf.init(keyStore); SSLContext context = SSLContext.getInstance("TLS"); context.init(null, tmf.getTrustManagers(), null); URL url = new URL("https://certs.cac.washington.edu/CAtest/"); HttpsURLConnection urlConnection = (HttpsURLConnection)url.openConnection(); urlConnection.setSSLSocketFactory(context.getSocketFactory()); InputStream in = urlConnection.getInputStream(); copyInputStreamToOutputStream(in, System.out); 双向证书验证 CertificateFactory certificateFactory = CertificateFactory.getInstance("X.509"); KeyStore keyStore = KeyStore.getInstance(KeyStore.getDefaultType()); keyStore.load(null); SSLContext sslContext = SSLContext.getInstance("TLS"); TrustManagerFactory trustManagerFactory = TrustManagerFactory. getInstance(TrustManagerFactory.getDefaultAlgorithm()); trustManagerFactory.init(keyStore); //初始化keystore KeyStore clientKeyStore = KeyStore.getInstance(KeyStore.getDefaultType()); clientKeyStore.load(getAssets().open("client.bks"), "123456".toCharArray()); KeyManagerFactory keyManagerFactory = KeyManagerFactory.getInstance(KeyManagerFactory.getDefaultAlgorithm()); keyManagerFactory.init(clientKeyStore, "123456".toCharArray()); sslContext.init(keyManagerFactory.getKeyManagers(), trustManagerFactory.getTrustManagers(), new SecureRandom()); Nogotofail 网络流量安全测试工具,Google的开源项目:https://github.com/google/nogotofail Android安全加密专题总结 以上学习所有内容,对称加密、非对称加密、消息摘要、数字签名等知识都是为了理解数字证书工作原理而作为一个预备知识。数字证书是密码学里的终极武器,是人类几千年历史总结的智慧的结晶,只有在明白了数字证书工作原理后,才能理解Https 协议的安全通讯机制。最终才能在SSL 开发过程中得心应手。 另外,对称加密和消息摘要这两个知识点是可以单独拿来使用的。 数字证书使用到了以上学习的所有知识 对称加密与非对称加密结合使用实现了秘钥交换,之后通信双方使用该秘钥进行对称加密通信。 消息摘要与非对称加密实现了数字签名,根证书机构对目标证书进行签名,在校验的时候,根证书用公钥对其进行校验。若校验成功,则说明该证书是受信任的。 Keytool 工具可以创建证书,之后交给根证书机构认证后直接使用自签名证书,还可以输出证书的RFC格式信息等。 数字签名技术实现了身份认证与数据完整性保证。 加密技术保证了数据的保密性,消息摘要算法保证了数据的完整性,对称加密的高效保证了数据处理的可靠性,数字签名技术保证了操作的不可否认性。 通过以上内容的学习,我们要能掌握以下知识点: 基础知识:bit 位、字节、字符、字符编码、进制转换、io 知道怎样在实际开发里怎样使用对称加密解决问题 知道对称加密、非对称加密、消息摘要、数字签名、数字证书是为了解决什么问题而出现的 了解SSL 通讯流程 实际开发里怎样请求Https 的接口

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册