首页 文章 精选 留言 我的

精选列表

搜索[序列号管理],共10005篇文章
优秀的个人博客,低调大师

数据源管理 | 分布式NoSQL系统,Cassandra集群管理

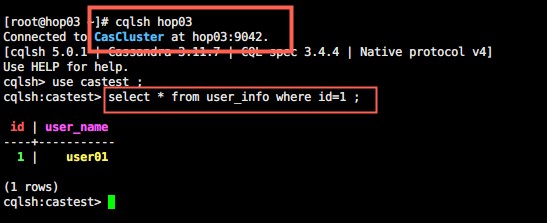
本文源码:GitHub·点这里 || GitEE·点这里 一、Cassandra简介 1、基础描述 Cassandra是一套开源分布式NoSQL数据库系统。它最初由Facebook开发,用于储存收件箱等简单格式数据,此后,由于Cassandra良好的可扩展性,逐渐发展成为了一种流行的分布式结构化数据存储方案。 2、特点分析 弹性可扩展性 Cassandra是高度可扩展的;它允许添加更多的硬件以适应更多的客户和更多的数据根据要求,可以根据业务的数据流量轻松扩展集群规模。 架构特点 Cassandra可以基于分布式运行,并采用了许多容错机制。由于去中心化无主的策略,所以没有单点故障。可以做到不停服滚动升级。这是因为Cassandra可以支持多个节点的临时失效(取决于群集大小),对群集的整体性能影响可以忽略不计。并且Cassandra提供多地域容灾。Cassandra允许将数据复制到其他数据中心,并在多个地域保留多副本,十分适用于不能承担故障的关键业务,必须持续提供服务的应用程序。 数据存储机制 Cassandra适应所有可能的数据格式,包括:结构化,半结构化和非结构化。可以根据业务的需要动态地适应变化的数据结构,并且通过在多个数据中心之间复制数据,可以灵活地在需要时分发数据。有许多案例证明Cassandra可以在金融,医疗,物联网等领域使用。 资源整合能力 Cassandra可以很容易的跟其他开源组件做集成,其中包括Hadoop,Spark,Kafka,Solr等系列组件,成为大数据业务处理里面重要的一个角色。 二、集群环境搭建 1、环境概览 jdk1.8 apache-cassandra-3.11.7-bin.tar.gz centos7 三台服务:hop01、hop02、hop03节点 2、安装包处理 tar -zxvf apache-cassandra-3.11.7-bin.tar.gz mv apache-cassandra-3.11.7 cassandra3.11 3、环境变量 [root@hop01 opt]# vim /etc/profile export CASSANDRA_HOME=/opt/cassandra3.11 export PATH=$PATH:$CASSANDRA_HOME/bin [root@hop01 opt]# source /etc/profile 4、创建目录 # 数据目录 mkdir -p /data/cassandra/data # 日志目录 mkdir -p /data/cassandra/log 5、集群配置 vim /opt/cassandra3.11/conf/cassandra.yaml # 配置集群名称 cluster_name: 'CasCluster' # 配置数据目录 data_file_directories: - /data/cassandra/data # 配置日志目录 commitlog_directory: /data/cassandra/log # 设置监听地址,当前服务IP listen_address: 192.168.72.132 # 配置RPC服务 start_rpc: true rpc_address: 192.168.72.132 # 配置集群节点 seed_provider: - class_name: org.apache.cassandra.locator.SimpleSeedProvider parameters: - seeds: "192.168.72.132,192.168.72.138,192.168.72.139" 将该配置分发到集群的每个节点,注意listen_address和rpc_address是节点自己的IP地址即可。 6、启动集群 # 集群下节点依次执行启动命令 cassandra -R # 查看节点状态 nodetool status 7、基础操作 进入命令行 cqlsh hop01 创建keyspace,并选择 CREATE KEYSPACE IF NOT EXISTS castest WITH REPLICATION = {'class': 'SimpleStrategy','replication_factor':3}; use castest ; 创建表,写入数据 CREATE TABLE user_info (id int, user_name varchar, PRIMARY KEY (id) ); INSERT INTO user_info (id,user_name) VALUES (1,'user01'); 查询数据 select * from user_info ; 基于其他服务查看数据,可以看到数据已经在集群间做了同步过程: 三、集成SpringBoot框架 1、核心依赖 <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> <version>${spring.boot.version}</version> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-cassandra</artifactId> <version>${spring.boot.version}</version> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-jpa</artifactId> <version>${spring.boot.version}</version> </dependency> 这里核心需要cassandra依赖和操作的API依赖。 2、核心配置 spring: data: cassandra: keyspace-name: castest contact-points: 192.168.72.138,192.168.72.132,192.168.72.139 port: 9042 cluster-name: CasCluster keyspace-name:类似关系型数据库的名称; contact-points:集群下节点的IP地址; port:默认端口; cluster-name:上述配置的集群名称; 3、基于Template命令 CassandraTemplate模板类,实现了一系列操作Cassandra数据库的基本方法,直接注入即可使用。 @Repository public class UserInfoTemplate { @Resource private CassandraTemplate cassandraTemplate ; // 查询全部数据 public List<UserInfo> getList (){ return cassandraTemplate.select("SELECT * FROM user_info",UserInfo.class) ; } // 添加数据 public UserInfo insert (UserInfo userInfo){ return cassandraTemplate.insert(userInfo) ; } // 根据主键查询 public UserInfo selectOneById (Integer id){ return cassandraTemplate.selectOneById(id,UserInfo.class) ; } // 修改数据 public UserInfo update (UserInfo userInfo){ return cassandraTemplate.update(userInfo) ; } // 删除数据 public Boolean deleteById (Integer id){ return cassandraTemplate.deleteById(id,UserInfo.class) ; } } 4、基于Repository接口 SpringBoot框架中定义的数据库访问核心接口。 接口实现 import com.cassand.cluster.entity.UserInfo; import org.springframework.data.repository.CrudRepository; public interface UserInfoRepository extends CrudRepository<UserInfo,Integer> { } 接口用法 @Service public class RepositoryService { @Resource private UserInfoRepository userInfoRepository ; // 保存 public UserInfo save (UserInfo userInfo){ return userInfoRepository.save(userInfo) ; } // 查询 public UserInfo getById (Integer id){ return userInfoRepository.findById(id).get() ; } // 修改 public UserInfo update (UserInfo userInfo){ // 主键ID存在的情况即为修改 return userInfoRepository.save(userInfo); } // 删除 public void deleteById (Integer id){ userInfoRepository.deleteById(id); } } 5、实体表结构 注意这里的注解是基于cassandra特定的一套。 import org.springframework.data.cassandra.core.mapping.Column; import org.springframework.data.cassandra.core.mapping.PrimaryKey; import org.springframework.data.cassandra.core.mapping.Table; @Table("user_info") public class UserInfo { public UserInfo(Integer id, String userName) { this.id = id; this.userName = userName; } @PrimaryKey private Integer id ; @Column(value = "user_name") private String userName ; } 四、源代码地址 GitHub·地址 https://github.com/cicadasmile/data-manage-parent GitEE·地址 https://gitee.com/cicadasmile/data-manage-parent

优秀的个人博客,低调大师

openstack 命令行管理二十 - instance novnc 访问管理 (备忘)

查询实例访问方法 [root@station140 nova(keystone_admin)]# nova get-vnc-console terry_instance1 novnc +-------+-------------------------------------------------------------------------------------+ | Type | Url | +-------+-------------------------------------------------------------------------------------+ | novnc | http://192.168.48.140:6080/vnc_auto.html?token=ee1931a2-35ed-4e04-901b-47bf60e7576d | +-------+-------------------------------------------------------------------------------------+ 上述 URL 可通过 chrome 进行访问, IE 估计有问题

优秀的个人博客,低调大师

openstack 命令行管理九 - flavor管理[主机模板] (备忘)

 帮助 [root@station140 tmp(keystone_admin)]# nova help | grep flavor flavor-access-add Add flavor access for the given tenant. flavor-access-list Print access information about the given flavor. flavor-access-remove Remove flavor access for the given tenant. flavor-create Create a new flavor flavor-delete Delete a specific flavor flavor-key Set or unset extra_spec for a flavor. flavor-list Print a list of available 'flavors' (sizes of flavor-show Show details about the given flavor. volume-type-delete Delete a specific flavor 创建自定义 flavor [root@station140 tmp(keystone_admin)]# nova flavor-create m1.vcomputer 6 2048 20 1 +----+--------------+-----------+------+-----------+------+-------+-------------+-----------+ | ID | Name | Memory_MB | Disk | Ephemeral | Swap | VCPUs | RXTX_Factor | Is_Public | +----+--------------+-----------+------+-----------+------+-------+-------------+-----------+ | 6 | m1.vcomputer | 2048 | 20 | 0 | | 1 | 1.0 | True | +----+--------------+-----------+------+-----------+------+-------+-------------+-----------+ 列出 [root@station140 tmp(keystone_admin)]# nova flavor-list +----+--------------+-----------+------+-----------+------+-------+-------------+-----------+ | ID | Name | Memory_MB | Disk | Ephemeral | Swap | VCPUs | RXTX_Factor | Is_Public | +----+--------------+-----------+------+-----------+------+-------+-------------+-----------+ | 1 | m1.tiny | 512 | 1 | 0 | | 1 | 1.0 | True | | 2 | m1.small | 2048 | 20 | 0 | | 1 | 1.0 | True | | 3 | m1.medium | 4096 | 40 | 0 | | 2 | 1.0 | True | | 4 | m1.large | 8192 | 80 | 0 | | 4 | 1.0 | True | | 5 | m1.xlarge | 16384 | 160 | 0 | | 8 | 1.0 | True | | 6 | m1.vcomputer | 2048 | 10 | 0 | | 1 | 1.0 | True | +----+--------------+-----------+------+-----------+------+-------+-------------+-----------+ 查询一下 tenant ID [root@station140 ~(keystone_admin)]# keystone tenant-list +----------------------------------+----------+---------+ | id | name | enabled | +----------------------------------+----------+---------+ | 9467f30b8bba4770a06a687e4584636b | cloud | True | +----------------------------------+----------+---------+ 创建后需要分配到对应的 project [root@station140 tmp(keystone_admin)]# nova flavor-access-add 6 9467f30b8bba4770a06a687e4584636b +-----------+----------------------------------+ | Flavor_ID | Tenant_ID | +-----------+----------------------------------+ | 6 | 9467f30b8bba4770a06a687e4584636b | +-----------+----------------------------------+ 注意下面错误信息 [root@station140 tmp(keystone_admin)]# nova flavor-access-list --flavor 6 <- 不针对 public 哟 ERROR: Failed to get access list for public flavor type.

优秀的个人博客,低调大师

Java - JVM 内存管理

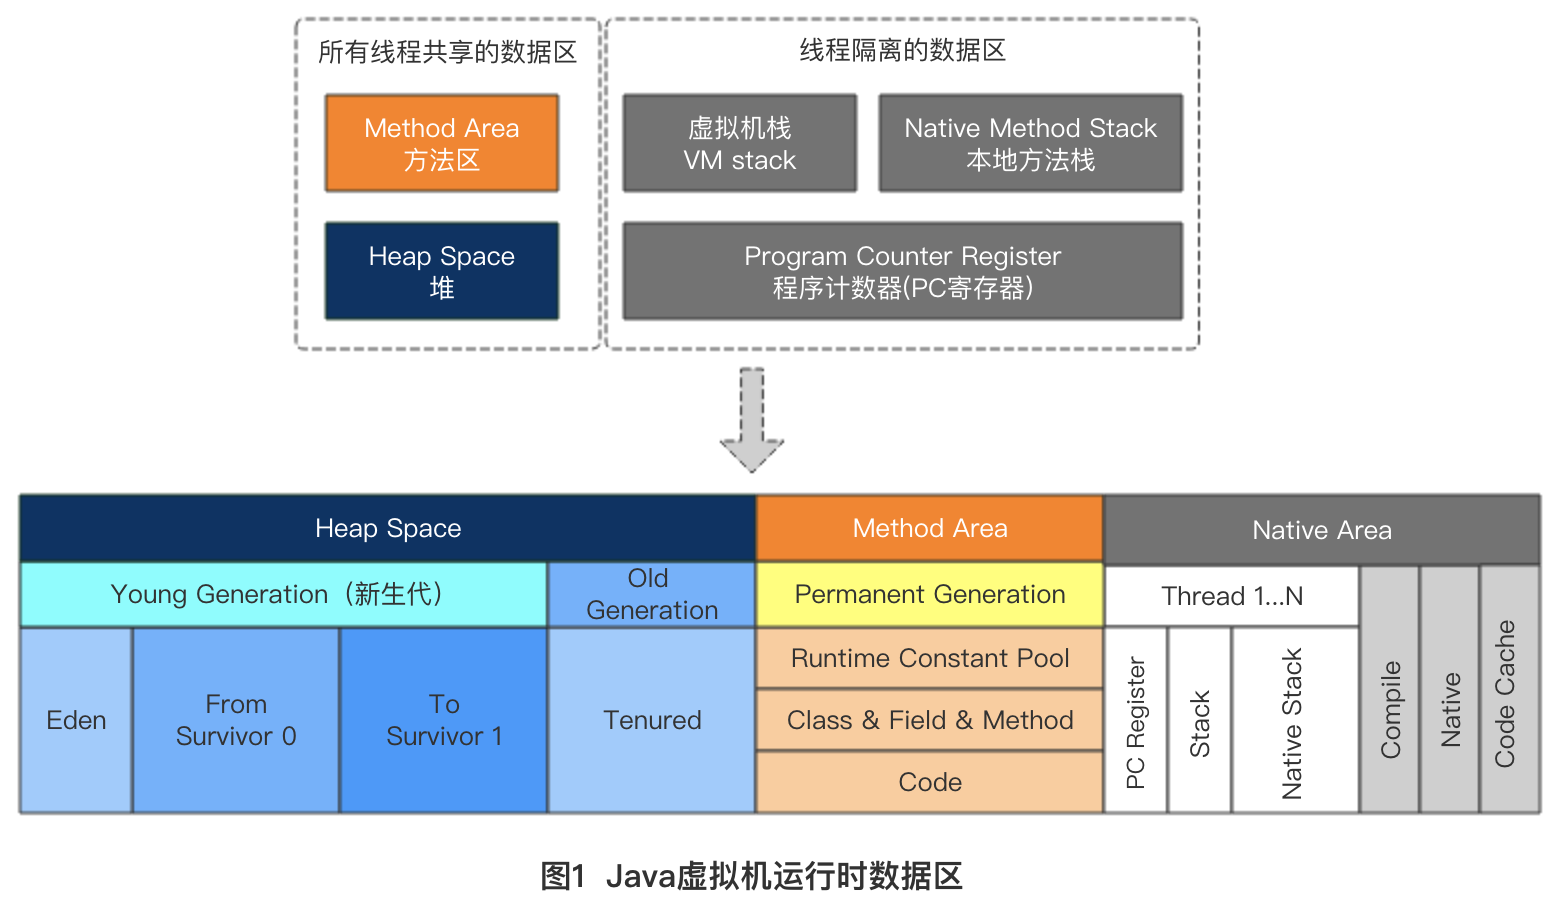
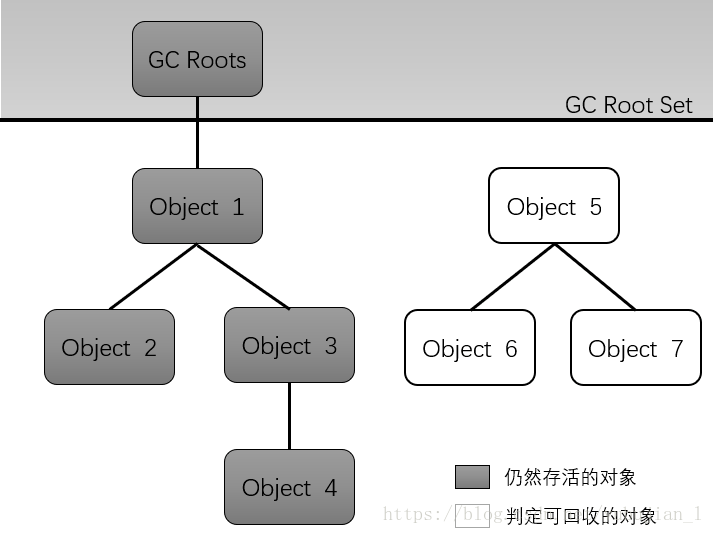
1. 查找失效对象 1.1 引用计数法 可以为每一个对象添加一个引用计数器,用于存储当前对象被几处引用。 引用计数法简单高效,但无法解决循环引用问题,如A引用B,B又引用A,且这两个对象不再被其它对象引用,那么在使用引用计数法的情况下,这两个对象的引用数均为1,且无法减至0。 1.2 可达性分析算法 可以通过一系列成为“GC Roots”的对象作为起始点,并从这些节点向下搜索,当一个对象到GC Roots不可达,则证明该对象不可用。 图1-1 GC Roots对象包括下面几种: o 虚拟机栈中引用的对象。 o 方法区中类静态属性引用的对象。 o 方法区中常量引用的对象。 o 本地方法栈中引用的对象。 一个对象要真正被清理,至少需要两次标记过程。 1.3 回收方法区 方法区垃圾回收的效率与性价比都远低于堆内存的回收。 主要回收两部分:废弃常量和无用的类。 2. 垃圾收集算法 2.1 标记-清除算法 图2-1 标记清除算法的标记阶段与清除阶段效率都不高,且会产生大量内存碎片。 2.2 复制算法 图2-2 将内存平分为两块,每次只使用其中一块。 当一块内存快用完时,可将存活的对象复制到另一块上面,然后将刚才使用的内存一次性清理掉。 该算法简单高效,且不会产生内存碎片,但由于有一半空闲内存,所以内存使用率不高。 HotSpot中,新生代内存结构为 1 * Eden + 2 * Survivor,每次只使用Eden区和其中一块Survivor区,当发生回收时,会将Eden与在用的Survivor中的存活对象复制到另一块Survivor区中。 根据HotSpot的内存结构,可见只有10%的内存(其中一块Survivor)被浪费,但此时有另一个问题,即实际情况下我们不能保证每次回收的存活对象都仅占内存的10%以下,所以当Survivor也不够用时,就需要依赖其它内存(老年代)做分配担保。 2.3 标记-整理算法 在对象存活率高的情况下,复制算法需要进行较多的赋值操作,效率会变低,同时备用空间也是对内存的一种浪费。 对于老年代,可能存在所有对象都存活的情况,所以直接使用复制算法是不合适的,所以出现了标记-整理算法。 图2-3 首先,标记。(这里标记的可能是所有存活对象,而非被回收对象,因为接下来需要移动存活对象,而不是清理回收对象) 然后,将存活对象向某一端移动,如图2-3,存活对象都会向上移动,其过程可能是所有存活对象依次在一端逐个覆盖。 最终,直接清理掉端边界以外的内存。 参考文献: [1]周志明.深入理解Java虚拟机[M].北京:机械工业出版社,2018.61-72

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册