首页 文章 精选 留言 我的

精选列表

搜索[移动应用云],共10000篇文章
优秀的个人博客,低调大师

PgSQL · 应用案例 · 传统分库分表(sharding)的缺陷与破解之法

背景 随着互联网的发展,数据爆炸性的增长,数据库逐渐成为了很多业务的绊脚石,很多业务也哭着喊着要上分布式数据库。 但是,传统的分库分表(sharding)带来的问题较多,得不偿失 传统分库分表问题 1、 扩容不方便(需要重分布数据) 2、 分布键变更很麻烦 3、 分布键选择(架构设计)需要谨慎,甚至很多sharding产品不支持多个分布键、或者不支持随机分布,导致业务不得不使用没有任何意义的自增序列来作为分布键。 4、 无法支持复杂查询。跨库JOIN性能差,甚至只能按分布键JOIN,其他字段不支持JOIN。(因为这种产品架构数据节点之间是孤岛,数据需要在孤岛之间交互,需要通过上层的中间件节点,而这样的话,如果有跨库JOIN,就需要将数据收到中间件节点再JOIN,性能差是可想而知的,甚至打爆中间节点。) 5、 当需要写入、返回大量结果集时,可能把中

优秀的个人博客,低调大师

Java之dom4j的简单解析和生成xml的应用

一、dom4j是一个Java的XML API,是jdom的升级品,用来读写XML文件的。dom4j是一个十分优秀的JavaXML API,具有性能优异、功能强大和极其易使用的特点,它的性能超过sun公司官方的dom技术,同时它也是一个开放源代码的软件,可以在SourceForge上找到它。在IBM developerWorks上面还可以找到一篇文章,对主流的Java XML API进行的性能、功能和易用性的评测,所以可以知道dom4j无论在哪个方面都是非常出色的。如今可以看到越来越多的Java软件都在使用dom4j来读写XML,特别值得一提的是连Sun的JAXM也在用dom4j。这已经是必须使用的jar包, Hibernate也用它来读写配置文件。 二、dom4j的xml解析过程 1)加入依赖包 <dependency> <groupId>org.dom4j</groupId> <artifactId>dom4j</artifactId> <version>2.1.0</version> </dependency> <dependency> <groupId>com.google.code.gson</groupId> <artifactId>gson</artifactId> <version>2.8.2</version> </dependency> 说明:gson的目的是用来将数据转成json的形式 2)xml模板 <root> <test1>test1</test1> <test1>test11</test1> <test2> <test3>test3</test3> <test4>test4</test4> </test2> <test2> <test3>test5</test3> <test4>test6</test4> </test2> </root> 3)解析 import com.google.gson.Gson; import com.google.gson.JsonArray; import com.google.gson.JsonObject; import org.dom4j.Document; import org.dom4j.Element; import org.dom4j.io.SAXReader; import java.io.File;import java.util.List; public class Dom4jUtil { public static void main(String[] args) throws Exception { SAXReader reader = new SAXReader(); Document document = reader.read(new File("d:\\1.xml")); Element root = document.getRootElement(); JsonObject jsonObject = readXml(root); JsonObject jsonObjectRepetition = readXmlRepetition(root); Gson gson = new Gson(); System.out.println(gson.toJson(jsonObject)); System.out.println(gson.toJson(jsonObjectRepetition)); } /** * 处理存在重复的标签数据(弊端,所有数据都是数组的方式存在,对xml的设计有要求,不然数据不好处理) * @param root * @return */ public static JsonObject readXmlRepetition(Element root) { //获取节点下面的所有元素 List<Element> elements = root.elements(); //如果存在则处理数据或者直接返回节点数据 if (elements != null && elements.size() > 0) { //声明一个json数据 JsonObject jsonObject = new JsonObject(); //声明一个json数组 JsonArray mList = new JsonArray(); //遍历所有元素 for (Element element:elements) { //读取节点数据直到节点下面没有其他元素 JsonObject jo = readXml(element); mList.add(jo); } //加入json jsonObject.add(root.getName(), mList); return jsonObject; } else { JsonObject jsonObject = new JsonObject(); jsonObject.addProperty(root.getName(), root.getText()); return jsonObject; } } /** * 处理普通xml格式数据,不存在重复的标签(弊端,不能处理统一标签下的重复标签) * @param root * @return */ public static JsonObject readXml(Element root) { //获取节点下面的所有元素 List<Element> elements = root.elements(); //如果存在则处理数据或者直接返回节点数据 if (elements != null && elements.size() > 0) { //声明一个json数据 JsonObject map = new JsonObject(); //这个是处理所有下面的数据保存在一个json中 JsonObject jo = new JsonObject(); for (Element element:elements) { JsonObject m = readXml(element); jo.add(element.getName(), m.get(element.getName())); } map.add(root.getName(), jo); return map; } else { JsonObject map = new JsonObject(); map.addProperty(root.getName(), root.getText()); return map; } } } 4)测试结果展示 {"root":{"test1":"test11","test2":{"test3":"test5","test4":"test6"}}} {"root":[{"test1":"test1"},{"test1":"test11"},{"test2":{"test3":"test3","test4":"test4"}},{"test2":{"test3":"test5","test4":"test6"}}]} 三、重点说明一下 1)上面写出来的工具,基本上都是用来处理特定数据的工具 2)方法的实现上面还可以完善,但是我一直没有找到好的数据表现形式所以写了两个方法 3)可以参考这种做法,进一步做深度解析 四、xml的创建 public static void main(String[] args) throws Exception { Document document = DocumentHelper.createDocument(); Element root = document.addElement("root"); Element test1 = root.addElement("test1"); test1.addText("test1"); Element test2 = root.addElement("test2"); test2.addText("test2"); OutputStream outputStream = new FileOutputStream("d:\\2.xml"); XMLWriter xmlWriter = new XMLWriter(outputStream); xmlWriter.write(document); xmlWriter.close(); } 备注:这里xml创建不细讲,很多时候都是根据业务来的。

优秀的个人博客,低调大师

python实现地理位置类数据爬取与geohash应用初探

最近想做一个简单的地理位置分析,比如获取一些城市公交站点对应的geohash,geohash其实是将平时常见的经纬度进行了降维,这样可以进行类似附近的餐馆等内容的分析。 1. 正逆地理编码 http://lbsyun.baidu.com/index.php?title=webapi/guide/webservice-geocoding 正/逆地理编码服务(又名Geocoding API)是一类Web API接口服务; 正向地理编码服务提供将结构化地址数据(如:北京市海淀区上地十街十号)转换为对应坐标点(经纬度)功能; 逆向地理编码服务提供将坐标点(经纬度)转换为对应位置信息(如所在行政区划,周边地标点分布)功能。 1.1 百度地图api正逆地理编码存在偏差 百度地图坐标拾取 http://api.map.baidu.com/lbsapi/getpoint/index.html 可以直接使用的百度url:后面直接跟地址就好如上图(key不知道是谁的),可以发现百度的搜索分词权重直接把雍和宫地铁站定位到了雍和宫, http://api.map.baidu.com/geocoder?key=f247cdb592eb43ebac6ccd27f796e2d2&output=json&address= url new key: http://api.map.baidu.com/geocoder?key=xpKTc80ZnEGiy1elZCMtEepEYKj5tqQr&output=json&address= http://api.map.baidu.com/geocoder/v2/?address=&output=json&ak=xpKTc80ZnEGiy1elZCMtEepEYKj5tqQr 1.2 高德地图接口 高德地图坐标拾取 http://lbs.amap.com/console/show/picker 发送一个request请求,带上地理位置和api key 即可返回一个包含了经纬度str。 地理编码接口: # -*- coding: utf-8 -*- import requests def geocode_change_key(address,key): parameters = {'address': address, 'key': key} base = 'http://restapi.amap.com/v3/geocode/geo' response = requests.get(base, parameters) answer = response.json() return str(answer['geocodes'][0]['location']).split(',') 2. 坐标系 谷歌地图采用的是WGS84地理坐标系(中国范围除外) 谷歌中国地图、搜搜中国地图、高德地图采用的是GCJ02地理坐标系 百度采用的是BD09坐标系。 而设备一般包含GPS芯片或者北斗芯片获取的经纬度为WGS84地理坐标系。 所以我们要根据得到的经纬度的坐标类型和地图厂商类型在地图上标点,否则会出现获取的位置误差。为什么不统一用WGS84地理坐标系这就是国家地理测绘总局对于出版地图的要求,出版地图必须符合GCJ02坐标系标准,也就是国家规定不能直接使用WGS84地理坐标系。 百度坐标系说明书:http://lbsyun.baidu.com/index.php?title=coordinate 2.1 我们常说的坐标系 WGS84:为一种大地坐标系,也是目前广泛使用的GPS全球卫星定位系统使用的坐标系。 GCJ02:又称火星坐标系,是由中国国家测绘局制定的地理坐标系统,是由WGS84加密后得到的坐标系。 BD09:为百度坐标系,在GCJ02坐标系基础上再次加密。其中bd09ll表示百度经纬度坐标,bd09mc表示百度墨卡托米制坐标。 2.2 坐标转码关键代码 # -*- coding: utf-8 -*- import json import urllib import math x_pi = 3.14159265358979324 * 3000.0 / 180.0 pi = 3.1415926535897932384626 # π a = 6378245.0 # 长半轴 ee = 0.00669342162296594323 # 扁率 def gcj02_to_bd09(lng, lat): """ 火星坐标系(GCJ-02)转百度坐标系(BD-09) 谷歌、高德——>百度 :param lng:火星坐标经度 :param lat:火星坐标纬度 :return: """ z = math.sqrt(lng * lng + lat * lat) + 0.00002 * math.sin(lat * x_pi) theta = math.atan2(lat, lng) + 0.000003 * math.cos(lng * x_pi) bd_lng = z * math.cos(theta) + 0.0065 bd_lat = z * math.sin(theta) + 0.006 return [bd_lng, bd_lat] def bd09_to_gcj02(bd_lon, bd_lat): """ 百度坐标系(BD-09)转火星坐标系(GCJ-02) 百度——>谷歌、高德 :param bd_lat:百度坐标纬度 :param bd_lon:百度坐标经度 :return:转换后的坐标列表形式 """ x = bd_lon - 0.0065 y = bd_lat - 0.006 z = math.sqrt(x * x + y * y) - 0.00002 * math.sin(y * x_pi) theta = math.atan2(y, x) - 0.000003 * math.cos(x * x_pi) gg_lng = z * math.cos(theta) gg_lat = z * math.sin(theta) return [gg_lng, gg_lat] def wgs84_to_gcj02(lng, lat): """ WGS84转GCJ02(火星坐标系) :param lng:WGS84坐标系的经度 :param lat:WGS84坐标系的纬度 :return: """ if out_of_china(lng, lat): # 判断是否在国内 return lng, lat dlat = _transformlat(lng - 105.0, lat - 35.0) dlng = _transformlng(lng - 105.0, lat - 35.0) radlat = lat / 180.0 * pi magic = math.sin(radlat) magic = 1 - ee * magic * magic sqrtmagic = math.sqrt(magic) dlat = (dlat * 180.0) / ((a * (1 - ee)) / (magic * sqrtmagic) * pi) dlng = (dlng * 180.0) / (a / sqrtmagic * math.cos(radlat) * pi) mglat = lat + dlat mglng = lng + dlng return [mglng, mglat] def gcj02_to_wgs84(lng, lat): """ GCJ02(火星坐标系)转GPS84 :param lng:火星坐标系的经度 :param lat:火星坐标系纬度 :return: """ if out_of_china(lng, lat): return lng, lat dlat = _transformlat(lng - 105.0, lat - 35.0) dlng = _transformlng(lng - 105.0, lat - 35.0) radlat = lat / 180.0 * pi magic = math.sin(radlat) magic = 1 - ee * magic * magic sqrtmagic = math.sqrt(magic) dlat = (dlat * 180.0) / ((a * (1 - ee)) / (magic * sqrtmagic) * pi) dlng = (dlng * 180.0) / (a / sqrtmagic * math.cos(radlat) * pi) mglat = lat + dlat mglng = lng + dlng return [lng * 2 - mglng, lat * 2 - mglat] def bd09_to_wgs84(bd_lon, bd_lat): lon, lat = bd09_to_gcj02(bd_lon, bd_lat) return gcj02_to_wgs84(lon, lat) def wgs84_to_bd09(lon, lat): lon, lat = wgs84_to_gcj02(lon, lat) return gcj02_to_bd09(lon, lat) def _transformlat(lng, lat): ret = -100.0 + 2.0 * lng + 3.0 * lat + 0.2 * lat * lat + \ 0.1 * lng * lat + 0.2 * math.sqrt(math.fabs(lng)) ret += (20.0 * math.sin(6.0 * lng * pi) + 20.0 * math.sin(2.0 * lng * pi)) * 2.0 / 3.0 ret += (20.0 * math.sin(lat * pi) + 40.0 * math.sin(lat / 3.0 * pi)) * 2.0 / 3.0 ret += (160.0 * math.sin(lat / 12.0 * pi) + 320 * math.sin(lat * pi / 30.0)) * 2.0 / 3.0 return ret def _transformlng(lng, lat): ret = 300.0 + lng + 2.0 * lat + 0.1 * lng * lng + \ 0.1 * lng * lat + 0.1 * math.sqrt(math.fabs(lng)) ret += (20.0 * math.sin(6.0 * lng * pi) + 20.0 * math.sin(2.0 * lng * pi)) * 2.0 / 3.0 ret += (20.0 * math.sin(lng * pi) + 40.0 * math.sin(lng / 3.0 * pi)) * 2.0 / 3.0 ret += (150.0 * math.sin(lng / 12.0 * pi) + 300.0 * math.sin(lng / 30.0 * pi)) * 2.0 / 3.0 return ret def out_of_china(lng, lat): """ 判断是否在国内,不在国内不做偏移 :param lng: :param lat: :return: """ return not (lng > 73.66 and lng < 135.05 and lat > 3.86 and lat < 53.55) if __name__ == '__main__': lng = lat = # result1 = gcj02_to_bd09(lng, lat) # result2 = bd09_to_gcj02(lng, lat) # result3 = wgs84_to_gcj02(lng, lat) result4 = gcj02_to_wgs84(lng, lat) #result5 = bd09_to_wgs84(lng, lat) #result6 = wgs84_to_bd09(lng, lat) print (result4) 3. geohash https://www.cnblogs.com/LBSer/p/3310455.html 当geohash base32编码长度为8时,精度在19米左右,而当编码长度为9时,精度在2米左右,所以一般来说用八位就够用。 python3如何使用geohash呢,网上说使用pip install geohash后import geohash 会报错,当然同样的作者提供了geohash包的fix版geohash2,所以安装时候应该是:(改源码的方式有点太高大上,不太安全?) pip install geohash2 我很纳闷的是python中能够生成geohash 的包实在是太多了: 3.1 获取包围盒 可以看到7位geohash编码带上一个包围盒,相对于6位geohash编码准确许多 简单写了一个类,使用geohash2(作者居然没有提供),我只好复制了mzgeohash的部分代码 https://gitee.com/wangyaning/python/tree/master/geohash 可以直接这么用: if __name__=='__main__': myTestGeohash = MyGeohash() #wx4g340 print(myTestGeohash.getneighbors('wx4g340')) 输出如下: {'ne': 'wx4g343', 'n': 'wx4g342', 'w': 'wx4g2fp', 'c': 'wx4g340', 'sw': 'wx4g2cz', 'se': 'wx4g31c', 'nw': 'wx4g2fr', 'e': 'wx4g341', 's': 'wx4g31b'} 测试geohash查询接口 https://cevin.net/geohash/ 结构化数据的处理 爬好数据的后处理,入库 新学了sqlldr命令,挺快,连python代码都不用写了 sqlldr userid='username/password@serverip/instance' control=./xxx.ctl errors=99999999 rows=20000 direct=true data=xxxxxxx.txt xxx.ctl文件如下 LOAD DATA CHARACTERSET 'UTF8' INFILE * APPEND INTO TABLE TABLENAME FIELDS TERMINATED BY ',' OPTIONALLY ENCLOSED BY '"&*!' trailing nullcols ( linename , xxxxxx, xxxxxx ) 部分参考文献 简单的城市名转换成经纬度: https://www.cnblogs.com/zle1992/p/7209932.html 批量获取经纬度: https://www.cnblogs.com/reboot777/p/7124010.html 用Python计算北京地铁的两站间最短换乘路线: http://blog.csdn.net/myjiayan/article/details/45954679 使用爬虫获取获取所有的 站点名 http://blog.csdn.net/wenwu_both/article/details/70168760 高德地图地理编码服务 http://blog.csdn.net/u013250416/article/details/71178156 https://www.cnblogs.com/xautxuqiang/p/6241561.html

优秀的个人博客,低调大师

应用Splunk进行大规模、非结构性数据的检索和分析

——更轻松、更高效的MapReduce并行分析模式 MapReduce 是 2004年由Google开发的分散式数据处理模型。 MapReduce 的基本设计理念是把 问题分成两个部分:1)将源数据转换成充分统计数据的映射函数;2)将所有充分统计数据合并为最终答 案的化简函数。通过定义,所有并行映射函数可同时运行且不会相互影响。一旦使用映射函数运算所有数 据,就可结合映射阶段的结果进行化简函数运算。对于网页搜索分析方案中常见的大规模批量处理和高速数据检索,MapReduce 能够提供最快速、最 节省且最大规模的数据返回程序。当今,大部分“大规模数据”先进管理技术是基于MapReduce研发的。

优秀的个人博客,低调大师

系统架构师-基础到企业应用架构系列之--开卷有益

开篇说明 由于是自己对这些技术的学习总结和心得体会,错误之处在所难免,怀着技术交流的心态,现在发表出来,所以希望大家能够多多指点,这样能使一部分人受益同时也能纠正我的错误观点,以便和各位共同提高! 软件架构到底是什么 软件架构可以被简单的描述为,一系列组件之间的组合,交互,继承的关系。当然这样的解释基本上人人都可以接收。不过在我们看来,这样的说法有点过于抽象。 软件架构有这标准的定义,就是参考ANSI/IEEE的标准,软件架构可以理解为软件密集型系统中对系统的实现和部署起决定性作用的的系统。 软件架构中的关键点是应该符合项目干系人的目标,功能上当然细分成功能性的和非功能性的需求。 软件架构有一定的特殊性,架构设计必须开发的初期就确定,架构设计作为关键决策必须前期确定。 软件架构其实主要是要符合项目干系人的目标,如果无法满足项目干系人的目标,那么这个架构方案就行不通,下图是ANSI/IEEE标准中定义的系统、架构与项目干系人直接的关系。 开篇中已经介绍了系统架构的表述工具有UML和Relation Rose,UML基本上已经成为国际的标准。 UML的类图:主要是描述类之间的关系。 用例图:描述使用场景。 组件图:用来描述系统中的可重用部分。并且容易看出组件与二进制文件之间的对应关系。 通过UML工具,我们能够更深层次对系统架构进行不同角度的描述。抓住其核心。 软件架构的验证,目前没有什么好的办法可以自动验证软件架构是否可以达到项目干系人的目标,只有通过多种方式多个级别的测试。 例如通过单元测试,来验证单一的功能,集成测试来评估系统的兼容性,验收测试来验证用户的满意度,程序是否提供必要的功能。 除了UML建模工具之外,还有IBM比较著名的Relation Rose,这里大概介绍下该工具具有的视图模式: 系统的架构 可以这样说,软件系统的架构过程中没有什么系统是不可拆分的,系统的开发方法越敏捷,为开发人员实现架构是预留的空间越大。 系统架构师将系统分解的过程,其实最终形成的就是一份为开发人员提供的详细设计说明书。当然详细设计说明书的内容和格式也取决于开发方法。 架构是什么 架构大多体现在难以改变或者改变起来代价较大的决定上。但是最终还是需要有人做决定。 系统分析师分析系统做什么,架构师设计如何去做。 架构师是需求与详细说明的纽带。 架构师的职责:架构师应该参与到开发的全过程当中。包括分析需求与架构设计、实现、测试、继承与部署。 按照ISO的定义架构师的定义如下:负责系统架构的人、团队或组织。 微软则对系统架构是做了如下的划分: 1、企业架构师。 2、基础架构师。 3、特定技术架构师。 4、解决方案架构师。 最后总结软件开发过程中的一些法则: 1、为了一个赶不上进度的项目增加人手,只会让项目更加落后于进度。 2、程序的复杂性会一直的增加,直到维护人员感觉到力不从心为止。 3、建筑师与开发人员写程序不同,如果建筑师按照开发人员的方式开建造,只会成为历史中的败笔。 本文转自何戈洲博客园博客,原文链接:http://www.cnblogs.com/hegezhou_hot/archive/2010/09/07/1821012.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

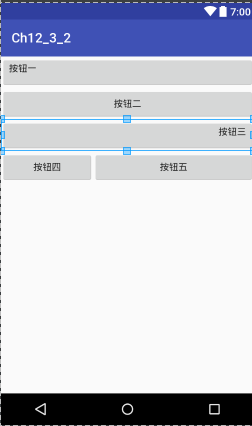
Android应用程序使用两个LinearLayout编排5个Button控件

学习存档: 1 <?xml version="1.0" encoding="utf-8"?> 2 <LinearLayout xmlns:android="http://schemas.android.com/apk/res/android" 3 android:orientation="vertical" 4 android:layout_width="fill_parent" 5 android:layout_height="fill_parent"> 6 <Button android:text ="按钮一" 7 android:layout_width="fill_parent" 8 android:layout_height="wrap_content" 9 android:gravity="left"/> 10 <Button android:text="按钮二" 11 android:layout_width="fill_parent" 12 android:layout_height="wrap_content" 13 android:gravity="center"/> 14 <Button android:text="按钮三" 15 android:layout_width="fill_parent" 16 android:layout_height="wrap_content" 17 android:gravity="right"/> 18 <LinearLayout android:orientation="horizontal" 19 android:layout_width="fill_parent" 20 android:layout_height="wrap_content"> 21 <Button android:text="按钮四" 22 android:layout_width="wrap_content" 23 android:layout_height="wrap_content" 24 android:layout_weight="0.25"/> 25 <Button android:text="按钮五" 26 android:layout_width="wrap_content" 27 android:layout_height="wrap_content" 28 android:layout_weight="0.75"/> 29 </LinearLayout> 30 </LinearLayout> 效果如下:

优秀的个人博客,低调大师

为 Hyper-V 的 Windows Server 2003 虚拟机部署 NLB 应用

年前朋友联系我,讨论有关 NLB(网络负载平衡) 的问题,由于这是一个微软的项目,所以本节不再做详细的场景描述。大致的问题就是为 Hyper-V 上的虚拟机部署 NLB 后,两个节点便无法与网络进行正常的通讯,采用的是单播模式!初步讨论,配置步骤绝对没有错误,考虑到 Hyper-V 的新特性架构——VMBus,我想问题应该出在这里,于是进行了协助调试。果然,当把虚拟机的 VMBus 网卡改为旧版网卡后 NLB 可以正常通讯了。但是使用旧版网卡那么性能肯定不如 VMBus,经过讨论认为这应该是一个已知问题,那么肯定会有相应的解决办法。 之后,我搜索了相关的资料并为发现有价值的信息,不过在一篇老外的 Blog 里了解到 Hyper-V 上虚拟机的 NLB 需要再手工强制配置 NLB 的 MAC。也就是说,当我们为两台节点配置好 NLB 后,通过 ipconfig 获得当前 NLB 的群集 MAC 地址并记录下来;最后,配置每台虚机的设置,将用于 NLB 的网卡 MAC 改为之前我们纪录的 NLB 群集 MAC。这里,不必担心虚机的 MAC 地址一样而导致冲突报错。 本文转自 苏繁 51CTO博客,原文链接:http://blog.51cto.com/goxia/224033,如需转载请自行联系原作者

优秀的个人博客,低调大师

Rafy 领域实体框架示例(1) - 转换传统三层应用程序

原程序说明 考虑到要更好地演示如何使用 Rafy 框架来开发一个传统的管理系统,决定挑选一个开源系统进行改造,而这个系统应该是简单、常见的三层架构,这种系统大家都比较熟悉,这样就可以更加快速的理解框架的使用了。 在开源网站上挑选了很久,免费的三层架构系统挺多,但是许多系统并不规范。一些系统虽然写着使用三层架构,但是金玉其外,败絮其中,看上去非常正式的系统,一打开源码,界面层代码中就可以看到直接编写的 SQL 语句。最终,我选用了《知名度服装进销存管理系统》,源代码下载地址:http://www.51aspx.com/Code/ZhiMingDuClothesSys。该系统三层间的调用比较严格,业务也非常简单。 系统功能描述: 人员:操作员管理,供应商管理,顾客管理 库存:库存管理,库存盘点 销售:服装销售,服装退货 服装:服装类别,服装登记 销售:销售统计,利润统计 技术特点:使用了三层架构设计程序,更换底层数据库类型方便。系统使用了 SqlLite 作为数据库,下载后可以直接运行。 界面截图 : 程序转换 转换方案 原系统是简单的三层架构: 而我们会使用 Rafy 推荐的架构,来改造整个系统: 对于一个依赖关系较为严格的三层系统来说,要使用 Rafy 框架来替换其中的数据访问层、业务逻辑层以及界面查询的功能,是比较简单的。本次转换,我按照以下步骤进行: 1. 理解系统需求,使用 UML 画出领域实体间的关系。 2. 添加 Rafy 领域实体项目。 3. 根据实体的关系图,在实体程序集中添加对应的实体及实体间的关系;同时也可以把旧表中的属性添加到实体中。 4. 把所有跨多表的业务逻辑转换为领域服务。 5. 依次把历史的实体删除,转而使用新的 Rafy 实体,以及其对应的实体查询、领域服务。 接下来,就正式对代码进行转换: 1. 使用 UML 进行领域建模 经分析,原系统拥有以下领域模型: User:用户; Company:供应商; Customer:顾客; GoodCategory:商品类别; Good:商品(服装); Stock:入库信息; Regood:返库信息; Bill 及 Sell:销售单据及销售明细。 它们的关系如下: (虽然原系统中一些实体的名称取得并不合理,但是为了简化系统的转换工作,新系统中的类命名还是保持和原系统一致。) 关于哪些关系应该使用组合关系来进行设计,大家可以查看 Rafy 用户向导文档中的“领域实体框架/领域实体/实体关系”章节。 2. 升级 .NET 版本 在开始转换代码前,由于原程序使用的是 .NET 2.0 的运行时,而 Rafy 要求必须使用 .NET 4.0。所以我们需要把解决方案中的每个项目都转换为 .NET 4.0 版本。 需要注意的是,由于原程序使用的 SqlLite 只支持 2.0 版本。同时,需要把 SqlLite 替换为 .NET 4.0 的版本。 3. 添加 Rafy 领域实体项目 在解决方案中添加一个 Rafy 领域实体项目,命名为 CS(为原系统名 ClothesSys 的缩写)。 点击确定后生成的项目如下: 接下来,我们将会在这项目中添加领域实体与领域服务,来替换原程序中除界面项目以外的其它几个项目: 4. 实体转换 接下来,依次把历史的实体删除,转而使用新的 Rafy 实体。这一步,需要按照依赖关系,尽量先转换不依赖其他实体的实体,即按照以下顺序进行转换:User、Company、Customer、GoodCategory、Good、Stock、Regood、Bill 和 Sell。由于 Bill 和 Sell 有强聚合关系,所以放到最后一起转换。 (在变更每一个实体时,原代码中所有的 BLL 查询,都需要在实体仓库中编写相关的代码支持;业务逻辑则需要编写领域服务) 实体的转换分为以下几类: 无关系实体的转换 有关系实体的转换 组合实体的转换 5. 简单实体的转换 简单实体没有复杂的关系,只是映射一个简单的表。在转换为 Rafy 实体时,只需要把表中的所有属性都添加到实体中就可以了。在编写时,需要注意的是: 标识 转换为 Rafy 实体后,所有的实体都统一继承自 Entity 类型。Entity 类声明了 int 类型的 Id 属性作为所有实体的标识属性,这个属性会在数据库中生成一个自增长的主键列。 旧实体类上的所有主键列、唯一列,在新实体中都变成了普通列。实体属性的唯一性验证,需要放到实体之上的业务逻辑层中来完成。 属性 原实体的所有属性,在 Rafy 实体中都使用属性代码段来生成同名的实体属性代码即可。 6. BLL、DAL 层代码转换 转换查询数据的代码 在原代码中 BLL、DAL 两层中,都有许多的查询方法。这些方法都需要转换为新代码中对应实体的实体仓库中的查询方法。例如,原程序中通过顾客编号查询顾客的查询方法: 1: public static Customer GetCustomerById(string id) 2: { 3: Customer ct = null; 4: SQLiteParameter[] sqlparams = new SQLiteParameter[]{ 5: new SQLiteParameter("@customerId",id) 6: }; 7: SQLiteDataReader sdr = SQLiteHelper.GetReader("select * from T_customer where customerid=@customerId", sqlparams); 8: if (sdr.Read()) 9: { 10: ct = new Customer(); 11: ct.CustomerID = sdr.GetValue(0).ToString(); 12: ct.CustomerName = sdr.GetValue(1).ToString(); 13: ct.Socre = Convert.ToInt32(sdr.GetValue(2)); 14: ct.Remark = sdr.GetValue(3).ToString(); 15: } 16: sdr.Close(); 17: 18: return ct; 19: } 需要转换为 Rafy 实体仓库中的新方法: 1: public Customer GetByCustomerId(string id) 2: { 3: return this.FetchFirst(new PropertiesMatchCriteria 4: { 5: { Customer.CustomerIDProperty, id }, 6: }); 7: } 转换业务逻辑代码 BLL、DAL 中,除了查询方法以外,剩下的还有一些简单对实体的增、删、改操作。这些操作已经在实体仓库基类中实现了,所以可以不用转换。 除了简单的 CRUD 操作外,系统中还有一些需要同时操作多个表的事务操作,原系统把这些业务逻辑都写到了数据层中。例如 ReGoodService.ReGoodSumbit 方法: 1: public static bool ReGoodSumbit(ReGoods regoods) 2: { 3: SQLiteParameter[] sqlparams = new SQLiteParameter[]{ 4: new SQLiteParameter("@regoodsId",regoods.ReGoodsID), 5: new SQLiteParameter("@regoodsNum",regoods.ReGoodsNum), 6: new SQLiteParameter("@regoodsPrice",regoods.ReGoodsPrice), 7: new SQLiteParameter("@reNeedPay",regoods.ReNeedPay), 8: new SQLiteParameter("@reRealpay",regoods.ReRealPay), 9: new SQLiteParameter("@regoodsResult",regoods.ReGoodResult), 10: new SQLiteParameter("@userId",regoods.UserId), 11: new SQLiteParameter("@sellId",regoods.SellId), 12: new SQLiteParameter("@regoodsTime",regoods.RegoodsTime.ToString("yyyy-MM-dd HH:mm:ss")) 13: }; 14: 15: string sql = "insert into T_regoods(regoodsid,regoodsNum,regoodsPrice,reNeedPay,reRealPay,regoodsResult,userId,regoodsTime,sellId) "; 16: sql+=" values(@regoodsid,@regoodsNum,@regoodsPrice,@reNeedPay,@reRealPay,@regoodsResult,@userId,@regoodsTime,@sellId)"; 17: try 18: { 19: SQLiteConnection con = SQLiteHelper.GetConnection(); 20: SQLiteTransaction trans = con.BeginTransaction(); 21: 22: SQLiteHelper.ExecuteNonQuery(trans, sql, sqlparams); 23: 24: CustomerService.DecreaseCustomerScore(trans, regoods); 25: StockService.IncreaseStocskNumByGoodId(regoods.ReGoodsID, regoods.ReGoodsNum); 26: 27: trans.Commit(); 28: return true; 29: } 30: catch (Exception ex) 31: { 32: return false; 33: throw ex; 34: } 35: } 可以看到,这段代码中,不但有业务逻辑的控制,还有数据库连接的控制,事务的控制,Sql 语句的拼装。显得非常混乱。而这种业务逻辑,在 Rafy 框架中,可以使用领域服务来实现。例如,刚才的逻辑,被替换为以下代码: 1: [Serializable] 2: public class SubmitRegoodService : Service 3: { 4: public Regood Regood { get; set; } 5: 6: protected override Result ExecuteTransaction() 7: { 8: if (Regood == null) throw new ArgumentNullException("Regood"); 9: if (!Regood.IsNew) throw new ArgumentNullException("Regood"); 10: 11: RF.Save(Regood); 12: 13: //修改库存 14: Regood.Good.StockSum += Regood.ReGoodsNum; 15: RF.Save(Regood.Good); 16: 17: //减少客户的积分 18: var ct = Regood.Sell.Customer; 19: if (ct != null) 20: { 21: ct.Score -= Regood.ReRealPay; 22: RF.Save(ct); 23: } 24: 25: return true; 26: } 27: } 可以看到,使用 Rafy 领域服务来实现后有以下好处: 整个代码非常直接地表现了业务逻辑,没有一点多余的代码。 使用了引用实体属性的懒加载功能,使得程序可以直接使用如 Regood.Sell.Customer 这样的强引用关系。 方便通用代码的封装。例如,事务的控制已经交给了服务基类来处理。 业务逻辑独立封装。每一个单独的业务都是一个服务对象,方便管理。为 SOA 提供了架构基础。 同时,使用领域服务还可以方便地直接使用 C/S 架构来部署。 7. 外键关系的转换 旧表中的外键引用关系,除了 Bill(销售单) 与 Sell(销售明细) 两个表间的关系,在设计 UML 时,都设计为实体间的引用关系。先区分清楚引用关系的可空性,然后就可以在相应实体中编写引用实体属性了。例如,Stock(库存)到 Good(商品)的关系,被转换为下面这个引用实体属性: 1: public static readonly RefIdProperty GoodIdProperty = 2: P<Stock>.RegisterRefId(e => e.GoodId, ReferenceType.Normal); 3: public int GoodId 4: { 5: get { return this.GetRefId(GoodIdProperty); } 6: set { this.SetRefId(GoodIdProperty, value); } 7: } 8: public static readonly RefEntityProperty<Good> GoodProperty = 9: P<Stock>.RegisterRef(e => e.Good, GoodIdProperty); 10: public Good Good 11: { 12: get { return this.GetRefEntity(GoodProperty); } 13: set { this.SetRefEntity(GoodProperty, value); } 14: } 8. 使用组合实体 Bill 和 Sell 分别表示销售订单、销售明细项。设计为组合实体后,在使用时,可以直接以组合实体的方式构造、保存、更新、删除,非常方便。 例如,在添加销售信息界面中的代码如下: 1: var bill = new Bill(); 2: bill.UserId = userId; 3: bill.BillTime = now; 4: 5: foreach (Sell sell in list) 6: { 7: sell.CustomerId = customerId; 8: sell.SellTime = now; 9: 10: bill.SellList.Add(sell); 11: } 12: 13: var svc = new AddBillService { Bill = bill }; 14: svc.Invoke(); 15: if (svc.Result) 16: { 17: MessageBox.Show("提交订单成功!", "提示"); 18: this.Close(); 19: ucGSM.bindDgvSellRecordToday(); 20: } 先构造了组合对象,然后提交给领域服务 AddBillService以执行添加销售信息逻辑。此服务代码如下: 1: [Serializable] 2: public class AddBillService : Service 3: { 4: public Bill Bill { get; set; } 5: 6: protected override Result ExecuteTransaction() 7: { 8: if (Bill == null) throw new ArgumentNullException("Bill"); 9: if (!Bill.IsNew) throw new ArgumentException("Bill"); 10: 11: //调用仓库保存整个销售单 12: var repo = RF.Concrete<BillRepository>(); 13: repo.Save(Bill); 14: 15: //修改库存 16: foreach (var sell in Bill.SellList) 17: { 18: sell.Good.StockSum -= sell.SellNum; 19: RF.Save(sell.Good); 20: } 21: 22: //添加客户的积分 23: var ctRepo = RF.Concrete<CustomerRepository>(); 24: foreach (var sell in Bill.SellList) 25: { 26: var ct = sell.Customer; 27: if (ct != null) 28: { 29: ct.Score += sell.RealPay; 30: ctRepo.Save(ct); 31: } 32: } 33: 34: return true; 35: } 36: } 转换后实体项目结构 待每一个实体修改并替换完毕后,再删除原来的传统三层项目后,解决方案中就只剩下了两个项目,一个 Rafy 领域实体项目“CS”;一个原程序中的界面层项目 “ClothesSys”。 截止到现在,已经完成了 ClothesSys 的完整转换。转换后的系统已经可以正常的运行,实现了与原系统一致的功能。 下载该示例代码后,只需要修改 app.config 文件中的连接字符串中的用户名和密码后,就可以直接运行示例,程序即会自动创建数据库并成功运行! 本文转自BloodyAngel博客园博客,原文链接:http://www.cnblogs.com/zgynhqf/p/3382176.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android应用开发提高系列(3)——《Effective Java 中文版》读书笔记

书籍 《Effective Java 中文版》 03版 潘爱民译 本书介绍了57条极具实用价值的经验规则。这些经验规则涵盖了大多数开发人员每天所面临的问题的解决方案,通过对Java平台设计专家所使用的技术的全面描述,揭示了应坐什么和不应做什么,才能产生清晰、健壮和高效的代码。 正文 注意:条目和用语可能与书籍有所出入,但尽量保持原样加一些自己的理解。 1. 构造函数一定不能调用可被覆写的方法,无论是直接还是间接进行。 2. 接口应该只是被用来定义类型的,它们不应被用来导出常量。(备注:不要再接口中定义常量)P/89 3. 一个安全而保守的策略是,永远不要导出两个具有相同参数数目的重载方法。 4. 返回零长度的数组而不是null。 5. 嵌套类 嵌套类(nested class)是指被定义在另一个类的内部的类,其存在的目的应该只是为它的外围类提供服务。嵌套类分为四种: 5.1 静态成员类(static member class) 最简单的嵌套类,最好把它看做一个普通的类。它可以访问外围类的所有成员,包括那些声明为私有的成员。与其他类静态成员一样,也遵守同样的可访问性规则。 其通常用法是作为公有的辅助类,仅当与它外部类一起使用时才有意义。 私有静态成员类的一种通常用法是用来代表外围类对象的组件。例如,Map实例的内部通常有一个Entry对象对应与Map中每一对键值对,虽然每一个Entry都与一个Map关联,但Entry上的方法(getKey、getValue、setValue)并不需要访问该Map。因此使用非静态成员来表示Entry是浪费的,私有静态成员类是最佳的选择。 5.2 非静态成员类(nonstatic member class) 非静态成员类的每一个实例都包含一个额外指向外部类对象的引用。维护这份引用要消耗时间和空间。 其通常用法是定义一个Adapter,它允许外围类的一个实例被看做另一个不相关的类的实例。例如,Map接口的实现往往使用非静态成员类来实现它们的集合视图。 5.3 匿名类(anonymous class) 没有名字,它不是外围类的一个成员,在使用的同时被声明和实例化。可以出现在代码中任何允许表达式出现的地方。通常只实现了其接口中或超类中的方法,不会声明任何新的方法,它们应该非常简短。 用法1 是创建一个函数对象(function object),比如Comparator实例。例如: Arrays.sort(args, newComparator<String>(){ @Override public intcompare(Stringobj1,Stringobj2){ returnobj1.length()-obj2.length(); } }); 用法2 创建一个过程对象(process object),比如Thread、Runable或者TimeTask实例。 用法3 在一个静态工厂方法的内部,如: staticListintArrayList( final int[]a){ return newAbstractList<Integer>(){ @Override publicIntegerget( intlocation){ returna[location]; } @Override public intsize(){ returna.length; }}; } 用法4 在复杂的类型安全枚举类型中,用于公有的静态final域的初始化器中,例如: public abstract classOperation{ private finalStringname; Operation(Stringname){ this.name=name; } publicStringtoString(){ return this.name; } abstract doubleeval( doublex, doubley); public static finalOperationPLUS= newOperation("+"){ @Override doubleeval( doublex, doubley){ returnx+y; } }; } 5.4 局部类(local class) 使用最少,在任何“可以声明局部变量”的地方,都可以声明局部类,也遵守同样的作用域规则。与匿名类一样,它们必须非常简短。 简而言之,如果一个嵌套类需要在单个方法之外仍然是可见的,或者它太长了,不适合放在一个方法内部,那么应该使用成员类。如果成员类的每个实例都需要一个指向其外围实例的引用,则把成员类做成非静态的;否则就做成静态的。假设一个嵌套类属于一个方法的内部,如果你只需要在一个地方创建它的实例,并且已经有了一个预先存放的类型可以说明这个类的特征,则把它做成匿名类;否则就做成局部类。 6. 了解和使用库 应该熟悉java.lang、java.util以及java.io中的内容。 6.1 Random.nextInt(int) 产生随机整数。 6.2 Collections.sort(v) 字符串组成的Vector排序 6.3 Collections.sort(v, String.CASE_INSENSITIVE_ORDER) 字符串组成的Vector排序,忽略大小写 6.4 System.out.println(Arrays.asList(a)) 循环打印一个数组中所有的元素 6.5 获取两个Hashtable包含相同映射键值的所有键: Maptmp= newHashMap(h1); tmp.entrySet().retainAll(h2.entrySet()); Setresult=tmp.keySet(); 6.6 Arrays.toString(a) 打印数组每一个元素 6.7 Arrays.equals(a1, a2) 比较两个数组长度、每一个元素是否相等。 7. 使用异常 7.1 被检查的异常(checked exception) 通过抛出一个被检查的异常,强迫调用者在一个catch子句中处理异常,或者将它传播到外面。 7.2 运行时异常(run-time exception) 大多数的运行时异常都是指API的客户没有遵守API规范建立的约定。例如数组越界。 总而言之,对于可恢复的条件,使用被检查的异常;对于程序错误,使用运行时异常。 8. 尽量使用标准的异常 8.1 IllegalArgumentException 调用者传递的参数不合适 8.2 NullPointException 空指针异常 8.3 IndexOutOfBoundsException 下标越界 8.4 ConcurrentModificationException 在禁止并发修改的情况下,对象检测到并发修改 8.5 UnsupportedOperationException 对象不支持所请求的方法 结束 由于先读的 《Practical Java》,与本书内容有部分相似,所以看得比较快,仍然值得一读,也终于弄懂关于嵌套类这块的内容。 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/844926,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册