首页 文章 精选 留言 我的

精选列表

搜索[AI身体],共10000篇文章
优秀的个人博客,低调大师

把外部模型塞进 AI 客户端的下拉框:一个 JSON 文件就够了

> 不改一行源码,改一个配置文件,下拉框里就多出 7 个模型。 ## 这次要准备什么 | 项目 | 内容 | |---|---| | 环境 | Windows 11 + WorkBuddy 桌面客户端 | | 要改的文件 | `~/.workbuddy/models.json`(就一个配置文件) | | 前置条件 | 本机已跑聚合网关,端口 7865 | | 最终产出 | 模型下拉框新增 7 项,请求按前缀自动挑额度 | ## 起因:额度散在四个地方 我手上的额度是碎的:三个 WorkBuddy 账号的积分、智谱开放平台的 tokens、两个第三方聚合站的额度。 要用它们,得在四个地方各配一遍 API 地址。更麻烦的是**额度耗尽的切换**——某一边没钱了,得手动改配置。 所以我想要两件事: 1. 这些模型直接出现在我日常用的客户端模型下拉框里,点一下就切 2. 一边没钱了能自动换另一边,不用我管 第 1 件事,答案是客户端自己留的一个配置文件。 ## models.json:客户端的自定义模型清单 它在 `~/.workbuddy/models.json`,内容是一个数组,每个条目 9 个字段: ```json { "id": "cn:auto", "name": "积分池-Auto(双池自动)", "vendor": "Custom", "url": "http://127.0.0.1:7863/v1", "apiKey": "", "supportsToolCall": true, "supportsImages": true, "supportsReasoning": true, "useCustomProtocol": false } ``` 四个关键点: **`id` 是路由凭据,不只是名字。** 我用 `cn:` 前缀标记"这笔钱走 WorkBuddy 池",用 `glm-` 前缀标记"走智谱"。后面网关就是靠这个前缀决定花谁的钱——**所以命名本身参与了调度**。 **`name` 和 `id` 可以不一样。** `id` 是给机器看的(`cn:auto`),`name` 是给人看的(`积分池-Auto(双池自动)`)。下拉框显示的是 `name`,所以我用中文写清楚这笔钱从哪来。 **`vendor` 一律填 `Custom`。** 这是告诉客户端"这不是官方内置模型,别去官方清单里校验"。 **`url` 可以填本机地址。** 这是我整套方案的关键——它不必须是某个公网 API,指到 `127.0.0.1` 也认。 我现在的清单里有 7 个条目,四类来源: | 来源 | 地址 | 用途 | |---|---|---| | 本机账号池 | `127.0.0.1:7863/v1` | 三个 WorkBuddy 号自动选号 | | 智谱开放平台 | `open.bigmodel.cn` | 直接调 GLM 系列 | | 聚合站 A | `tokease.cn/v1` | 备用 | | 聚合站 B | `api.lansekafei.cn` | 备用 | ## 三层端点 `url` 指向本机时,后面其实堆了三层: ```text 7863 账号池上游 三个号自动选号、自动签到 7864 管理端 Web 面板看积分与流水 7865 聚合网关 按 model 前缀路由 + 失败自动切换 ``` 7865 是大脑。它收到请求只看 `model` 字段的前缀: ```python if model.startswith("cn:"): primary, pm = WB_POOL, model # 花 WorkBuddy 积分 backup, bm = ZHIPU, FALLBACK_MODEL[model] elif model.startswith("glm-"): primary, pm = ZHIPU, model # 花智谱 tokens backup, bm = WB_POOL, FALLBACK_MODEL[model] ``` 主渠道返回非 200 → **自动用备用渠道的映射模型重试一次**。因为 HTTP 状态码在响应头里,流式请求也能在吐出第一个字之前完成切换,客户端无感。 ## 验证:看响应头就知道花的是谁的钱 网关给每个响应打了两个标记: ```text x-upstream: workbuddy-pool x-upstream-model: cn:auto ``` 实测一次请求: ```text $ curl -X POST http://127.0.0.1:7865/v1/chat/completions \ -d '{"model":"cn:auto","messages":[{"role":"user","content":"只回复两个字:收到"}]}' → x-upstream: workbuddy-pool → 响应体 model 字段: hy4-preview ``` 有意思的地方在这里:**我请求的是 `cn:auto`,实际干活的是 `hy4-preview`**。 `cn:auto` 不是真实模型,是个"代号"。7863 收到代号后按三因子加权挑出 Top5,再随机抽签选一个当前有额度的号,最终落到具体模型。一次请求经过了两级调度。 ## 坑:脚本改了,进程没重启 这一层本来应该是自动的。我写了个看门狗,60 秒巡检三个端口,谁挂了拉谁。 结果今天早上查状态,7863 和 7864 都活着,**7865 是 DOWN**。 看门狗明明在跑,心跳日志每 30 分钟一行,一直没断: ```text 2026/10/26 06:43:17 heartbeat: 7863=up 7864=up 2026/10/26 07:13:18 heartbeat: 7863=up 7864=up 2026/10/26 07:43:18 heartbeat: 7863=up 7864=up ``` **问题就藏在这行日志里——它只报了两个端口。** 我打开脚本文件,第 59 行写的是 7863、7864、7865 三个都有。但看时间戳: ```text WorkBuddy-Stack.ps1 修改时间 10-24 23:32 ← 加入 7865 巡检段 看门狗进程 启动时间 10-24 19:11 ← 加载的是加入之前那一版 ``` **脚本是 23:32 改的,进程是 19:11 启的。改完之后,这个进程从来没重启过,它脑子里只有两个端口。** 7865 在那之后就一直是裸奔状态,某次挂掉之后再没人管。而因为我所有对外文档都写"聚合网关在 7865",最后只能把 models.json 里的地址从 7865 改回 7863 应急——**等于把刚做好的自动切换功能整个绕过去了**,还留下了三个备份文件: ```text models.json.bak-20261024 models.json.bak-20261024b models.json.bak-20261026-port7865fix ``` 备份文件名里的 `port7865fix` 现在看着有点讽刺:那次"修复"其实是把端口从 7865 改回 7863,方向是反的。 ## 教训 **给常驻进程写自愈逻辑时,"改脚本"和"生效"之间隔着一个重启。** 验证它是否真的加载了新逻辑,不要看文件——看它的输出。心跳日志只有两个端口,就已经说明它跑的是旧版。 顺便一条相关经验:在这个环境里,**工具调用启动的进程活不过当次调用**(调用内请求 200,调用一结束进程就没了)。所以长期服务只能靠脱离子进程树的方式启动,事后还要用互斥体确认它真的在岗,而不是靠命令行匹配进程名——后者匹配不到那些以编码命令启动的孤儿进程。 ## 产出物 改完拿到的是三样东西: 1. **模型下拉框多出 7 项**,每项名字直接写明这笔钱从哪来(如"积分池-Auto(双池自动)") 2. **一个响应头 `x-upstream`**——任意一次请求都能看出花的是谁的额度 3. **自动切换**——主渠道返回非 200 时,网关自动用备用渠道的映射模型重试一次 ## 小结 改一个 JSON 文件,把四个平台的额度收进一个下拉框。真正的价值不是"多几个模型可选",而是**把调度逻辑藏在一个 `127.0.0.1` 地址后面**——客户端以为自己在调一个普通 API,实际上后面是三选一的账号池、前缀路由、失败切换。 前提是那个地址得真的活着。 --- *本文所有时间戳、端口状态、响应头与日志均取自实机。密钥与口令已脱敏。*
优秀的个人博客,低调大师

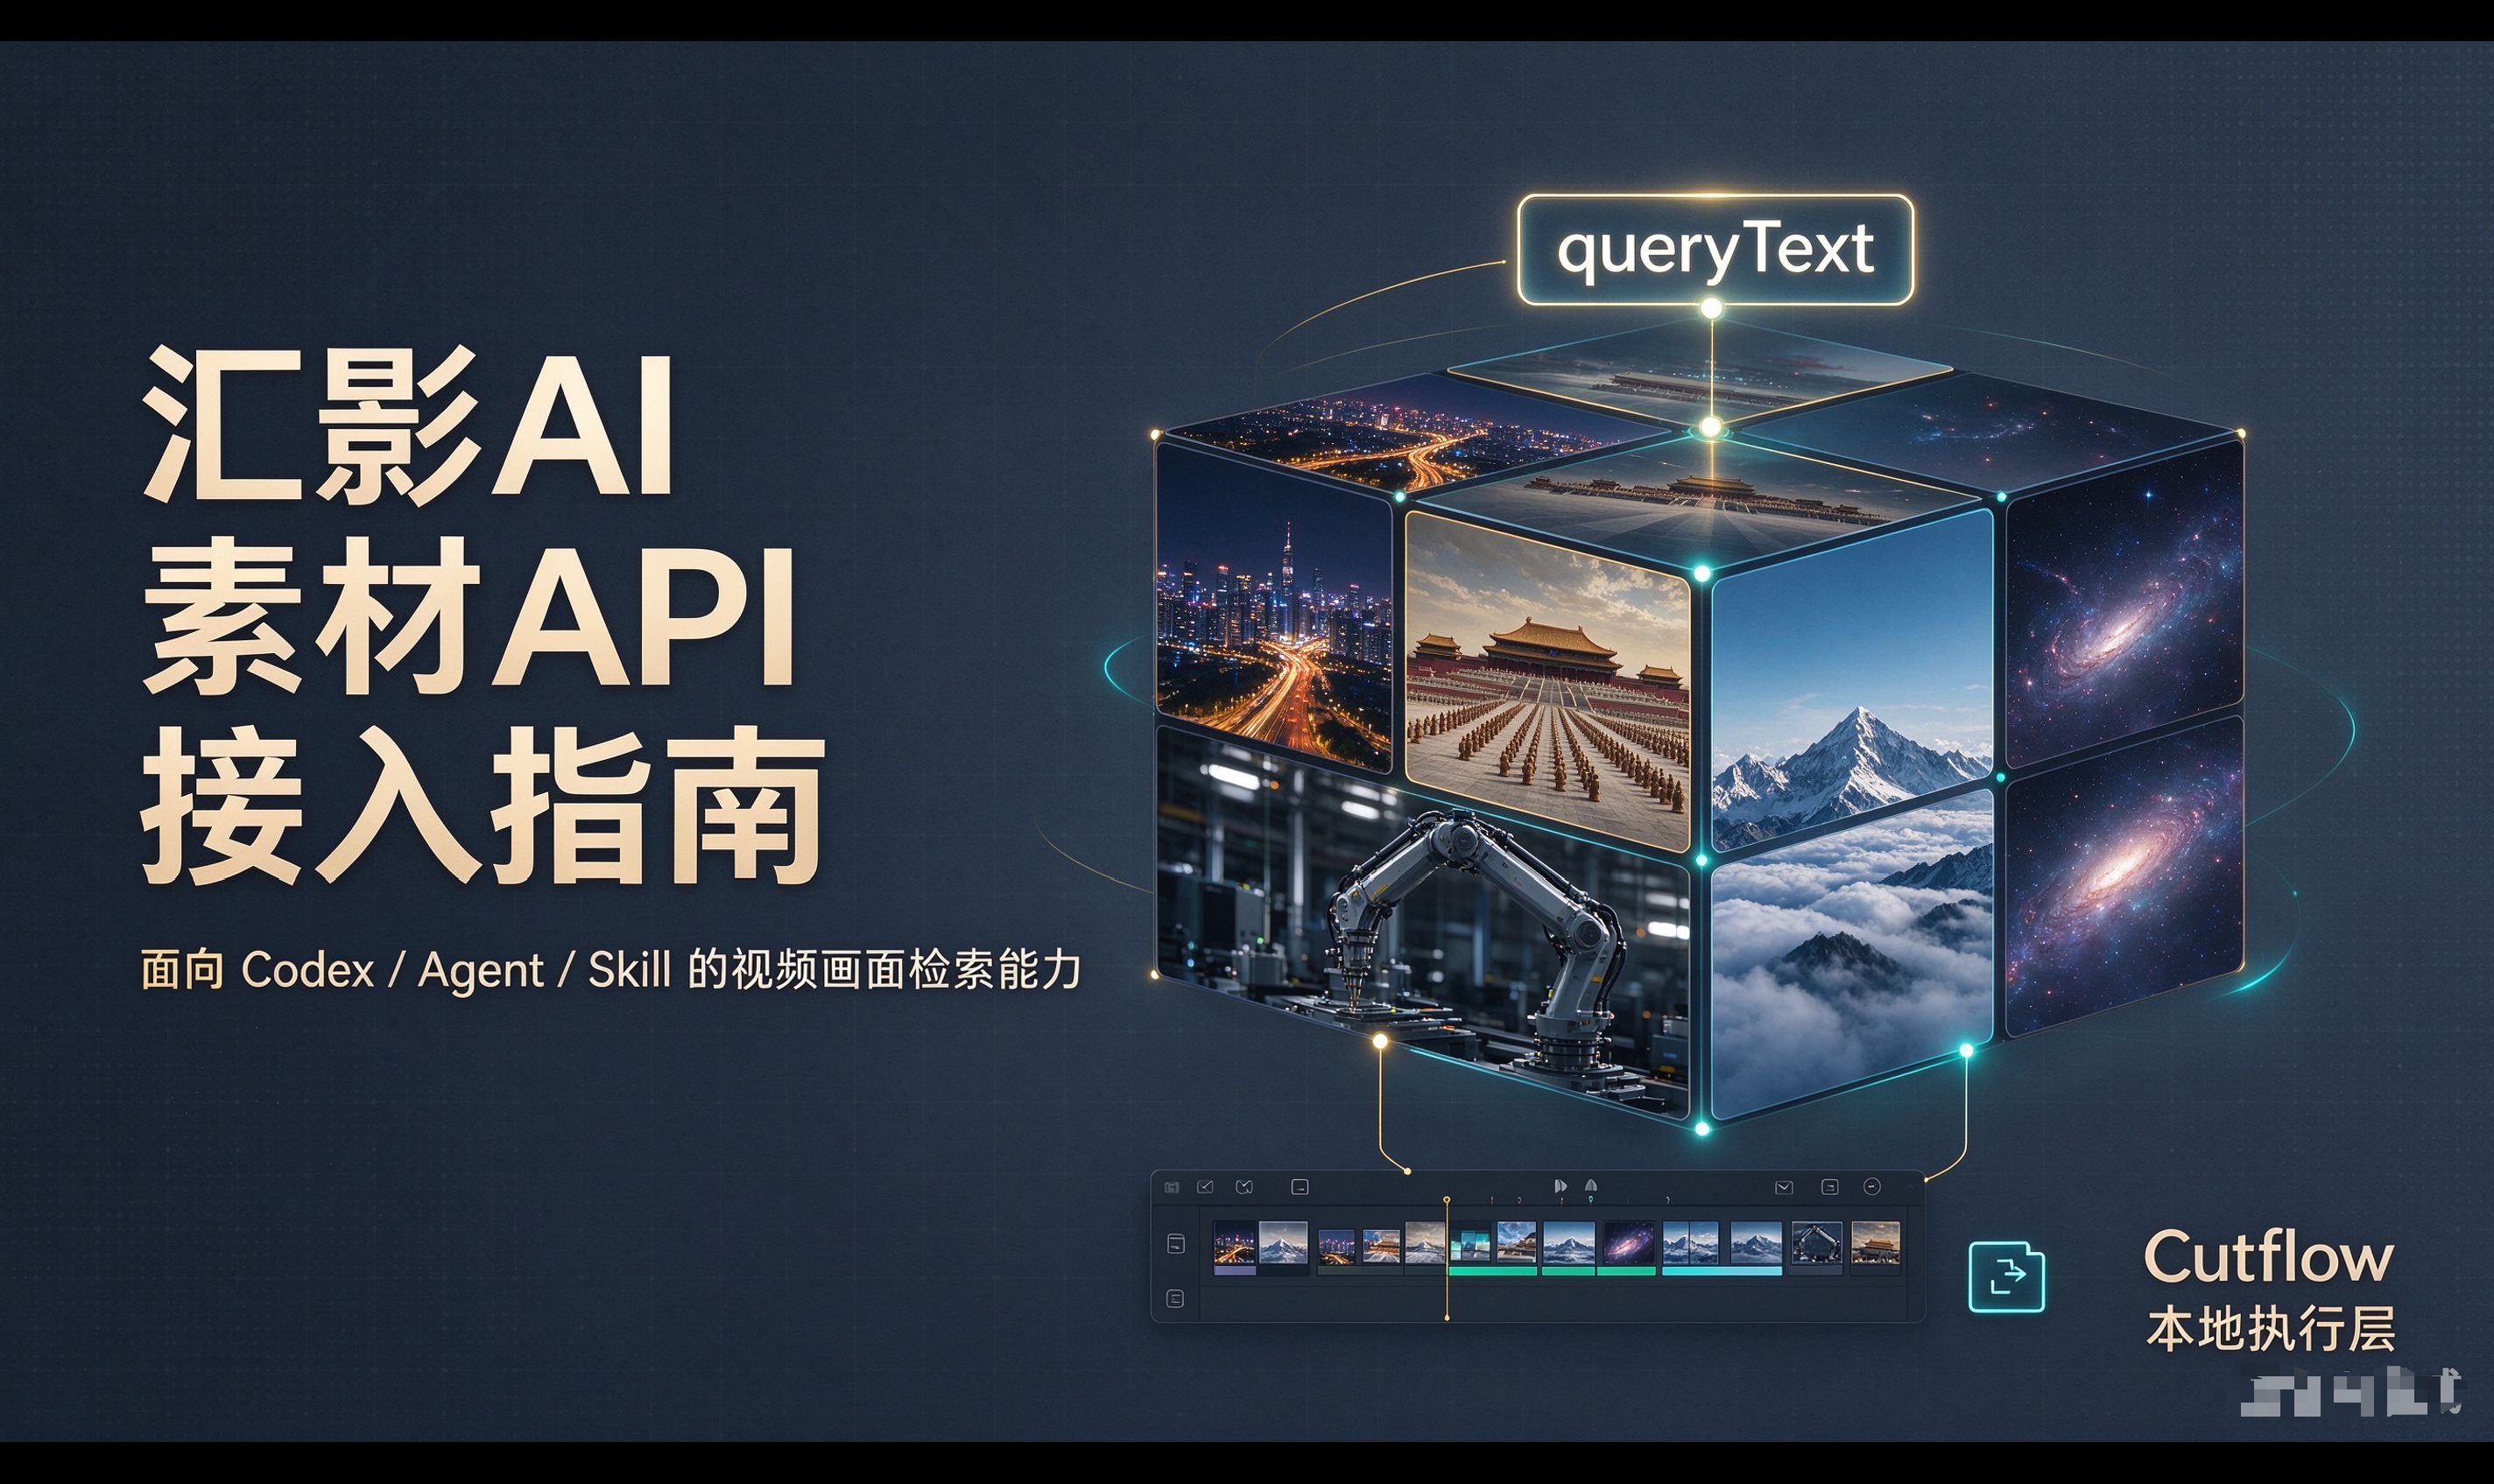
Codex Skill集成汇影AI api:语义素材检索到剪映草稿完整流水线

> 标签:#Codex #AgentSkill #视频自动化 #素材 API #剪映草稿 #批量中视频生产 摘要:在基于 Codex 搭建 Agent 视频自动化 Skill 做知识解说视频时,很多开发者会遇到一个共性阻碍:脚本、字幕、配音链路都可以通过大模型完成,但**镜头画面素材来源会成为整个流程的短板**。本文从工程实践角度,分享一套把语义素材检索能力封装进 Skill 的实现思路,探讨如何实现文案解析、镜头描述生成、素材元数据获取,最终输出剪映草稿的工作链路,适合历史解说、科普、文旅、工业纪实类结构化视频场景。 ## 1. 视频自动化流水线,容易被忽略的素材瓶颈 不少做过 Codex + 剪辑 Skill 自动化视频项目的技术人员都会碰到一类现实难题。 Agent 可以完成文案拆解,输出结构化镜头描述 JSON,编排配音指令与字幕时间轴,上层决策逻辑可以跑通,但**真实可用的视频片段该如何获取,往往会成为缺口**。 行业内一般有三种常见解决思路,但各有局限: 1. **本地自建素材库**:需要持续人工整理分类,面对古代历史、天文、工业这类垂直题材很容易出现素材缺口;大模型输出的自然语言镜头描述,很难和本地文件名称做精准匹配,维护成本高。 1. **调用文生视频模型实时生成片段**:单次调用成本偏高,渲染等待时间长;想要稳定输出纪录片纪实质感的镜头难度较大,并不适合大批量流水线生产。 1. **调用海外第三方素材 API**:普遍存在 QPS 调用额度限制,对中文场景理解偏弱,国风、国内历史相关的检索结果经常达不到业务预期。 于是很多项目就出现这样的局面:Agent 已经输出完整镜头指令,流程走到素材环节就中断,需要人工复制描述去检索素材、下载文件,再回填到工程目录。自动化链路在这里断裂,批量生产的价值被大幅削弱。 理想的工程目标是:人聚焦在选题、确认终稿文案、验收成片;脚本拆解、镜头语义解析、素材检索、字幕配音组装等重复工作交给 Agent 与 Skill 完成。 下文以我实际项目中使用过的一套方案作为案例,聊聊怎么把语义素材检索能力封装为 Skill 工具,完成从文案到剪映草稿的链路。 > 适用边界:这套实践方案更适合结构化知识解说类视频;如果每一条视频都需要重度 CG 定制特效镜头,则并不适配。输出剪映草稿之后,镜头节奏、转场特效等依旧建议人工二次调整。 ## 2. Codex、Skill、本地客户端三者分工:决策层和执行层分离 ### 2.1 不要让 Agent 直接处理下载与剪辑文件 参考剪映 Skill 的成熟设计,项目采用**决策层、执行层相互分离**的架构思路: - **Codex(Agent,决策层)**:接收原始解说文案,完成句子拆分,提取可视化镜头描述,组装工具调用参数,接收素材返回元数据,输出剪辑结构化 JSON 指令。Agent 不处理视频二进制文件,只负责任务规划、工具调用。 - **素材检索 Skill**:封装素材检索接口,接收 Agent 输出的镜头查询文本,调用接口拿到候选素材元数据列表。 - **Windows 本地客户端(执行层)**:接收素材标识,在本地环境完成素材下载、成片任务调度、配音、字幕对齐,输出剪映草稿工程。素材下载、成片处理全部在本地完成,网页端仅用于效果预览调试。 核心设计考量:Agent 只定义 “需要什么画面”,媒体文件 IO、下载等繁重操作交给本地客户端,规避大文件带来的内存、权限、路径异常等各类问题。 ### 2.2 Skill 最小闭环需要实现的能力 做封装时不需要一次性堆砌全部功能,优先实现最小可用闭环,后续按需迭代扩展。 表格 |能力分类|输入|输出|说明| | --- | --- | --- | --- | |语义素材检索|镜头文本描述、返回数量、检索模式|候选素材元数据列表|与网页预览使用同一素材池| |文案成片任务指令|完整解说文案、配音音色参数|任务标识,交由本地客户端执行|支持直接传入完整文案,自动分镜并输出剪映草稿| |批量成片调度|多条文案数组、默认音色配置|批量任务队列 ID|多条文案批量提交,客户端后台串行执行| |音视频转文稿|本地音视频路径|识别完成的字幕文本|已有音视频素材,可先转写文稿,再执行画面匹配| > 实践注意:网页仅用来预览画面,原片下载逻辑全部交由 Windows 客户端完成;API 密钥在产品个人中心生成,密钥只会完整展示一次,工程建议存入环境变量,禁止硬编码写入提示词或者提交代码仓库。 ### 2.3 区分可检索文本与评述文本,这是高频踩坑点 Codex 拆解脚本产出查询文本的时候,Skill 内部建议增加一层过滤逻辑: ✅ **适合提交检索(实体可视化场景)** `中国古代宫殿与军队列阵历史纪录片场景` `工厂流水线特写` `日落下的城市航拍` ❌ **不适合提交检索(纯观点评述语句)** `这次改革对后世产生深远影响` `该思想拥有很高的历史价值` 遇到纯评价类句子,Skill 应当拦截,不发起素材检索请求,可以复用前序镜头素材,避免返回无关画面。 ## 3. 环境准备:Agent、API、本地客户端 ### 3.1 Codex Agent 侧配置 1. 在 Skill 配置注册素材检索工具,定义入参:`queryText`、`topK`、`searchMode`、`llmTranslateQuery` 1. 将 API 密钥配置至环境变量,禁止写死在提示词文本中 1. 本地项目目录参考规划 ```javascript video_agent_project/ ├── scripts/ # 原始解说文案存放 ├── skill_config/ # Skill配置、工具定义 ├── cutflow_tasks/ # 给到客户端的任务参数文件 ├── output_capcut/ # 输出剪映草稿工程 └── logs/ # API调用、任务运行日志 ``` ### 3.2 接口请求示例(Skill 内部 HTTP 模板) ```javascript POST /api/v1/clips/search Authorization: Bearer rk_live_你的Key Content-Type: application/json ``` ```javascript { "queryText": "中国古代宫殿与军队列阵历史纪录片场景", "topK": 20, "searchMode": "auto", "llmTranslateQuery": true } ``` > 实践经验:开发调试阶段,优先在网页端复现相同查询文本,确认画面匹配效果,再交给 Agent 自动化调用。高并发大规模业务场景建议走商务对接,相关参数规则参考平台文档。 ### 3.3 本地客户端部署 1. Windows 环境安装对应桌面客户端程序,后台保持运行,接收 Skill 下发任务参数; 1. 素材下载、配音生成、字幕对齐、剪映草稿导出均在本地完成,项目文件保存在本机。 > 补充:客户端还支持授权人声做音色复刻、本地素材保存等能力;素材保存后用于内容产出,需要遵守对应版权与平台使用规范。 ## 4. 完整实操链路:原始文案 → Agent 拆解 → Skill 检索 → 本地客户端 → 剪映草稿 ### 4.1 编写提示词,定义镜头拆解规则 需要把剪辑隐性规则显性化,让大模型可以将完整解说稿拆分为结构化镜头数组,示例片段: ```javascript 任务:接收历史解说文案,按句子拆分输出镜头描述数组。 规则: 1. 实体画面句子生成queryText;纯评价议论标记type="comment",不调用素材检索。 2. queryText输出纪录片风格简短画面描述。 3. 输出JSON,字段包含原文句子、type、queryText。 4. 仅返回JSON,不要多余闲聊文本。 ``` ### 4.2 Agent 输出结构化指令,调用素材 Skill 解析文案得到镜头数组: - `type="visual"`:调用检索工具,传入 queryText,拿到候选素材元数据; - `type="comment"`:标记评述句,跳过检索。 > 调试建议:先用少量单篇文案跑完整链路,人工校验素材匹配效果,确认稳定后再开启批量任务,避免大批量产出效果不符合预期。 ### 4.3 下发任务给本地客户端执行 Agent 拿到每段镜头对应的候选素材信息,组装成片任务参数,写入本地任务文件,交由后台客户端读取执行: 1. 根据元数据将素材下载至本机素材目录 1. 选定音色生成配音语音 1. 将文案句子、音频、素材片段做时间线对齐,自动生成字幕 1. 输出剪映草稿工程文件 ### 4.4 人工二次精修 自动化产出的是草稿工程,不等于最终成片。拿到剪映工程之后,开发者或者创作者可以手动调整镜头时长、转场、字幕样式、音量,完成最终成片。自动化主要解决重复劳动,创意、节奏判断依旧留给人工处理。 ## 5. 项目踩坑实录 ### 5.1 Agent 输出的查询文本检索不到匹配画面 现象:大模型输出抽象评价语句送入检索接口,返回素材和业务主题无关。 处理:Skill 层增加过滤规则,区分实体镜头和评述句子;网页端复现 Agent 生成的查询词,迭代优化镜头拆解提示词。 ### 5.2 API 密钥明文泄露 现象:密钥直接写进提示词或者提交代码仓库,出现非预期消耗。 处理:统一读取环境变量;Skill 内部不要把原始密钥透传给大模型上下文;密钥生成之后妥善保管。 ### 5.3 一次性下发大量任务,本地任务卡死 现象:批量任务同时下发,本地 IO 压力过高,部分成片任务执行失败。 处理:Skill 内部实现串行任务队列,等待上一个任务完成再下发下一条;大规模业务走商务渠道沟通。 ### 5.4 直接把观点评价语句送入检索 现象:返回素材杂乱,和文案主题脱节。 处理:优化 Agent 提示词,Skill 增加校验逻辑;评述段落复用已有镜头素材,不必每一句都调用检索接口。 ## 6. 生产环境的优化思路 ### 6.1 赛道镜头模板沉淀 针对历史解说、工业科普、天文、财经等常见题材,可以沉淀一套镜头描述模板,Agent 拆解文案优先参考模板,提升检索命中率。素材库拥有百万级空镜内容,每日持续更新一万条以上,有垂直题材需求可以和项目方沟通赛道补充。 ### 6.2 两层质量校验 1. **技术校验**:Skill 检查接口返回结果,无候选素材时输出告警,Agent 留存运行日志。 1. **业务抽样校验**:小批量抽样人工复核素材匹配效果,持续迭代镜头拆解 Prompt。 ### 6.3 两套模式灵活选用 - **模式 A:Agent 拆解镜头 + API 检索**:适合成熟 Agent 项目,需要精细控制每一段镜头素材。 - **模式 B:完整文案直接送入客户端成片**:适合快速原型验证,粘贴整篇文案,客户端自动分镜、匹配素材、输出剪映草稿,省去自行开发镜头拆解逻辑。 > 项目前期可以先用模式 B 快速验证业务可行性,业务跑通后再做模式 A 深度定制。 ### 6.4 检索样例内置到提示词 可以在 Agent 的 Skill 提示词内置一批参考样例,引导大模型输出适配检索的画面描述文本: `雨夜霓虹街景`、`工厂流水线特写`、`日落下的城市航拍`、`中国古代宫殿与军队列阵历史纪录片场景` ## 7. 总结 这套 Codex + 素材 Skill + 本地客户端的流水线,更适合结构化知识内容批量产出,例如历史解说、人文科普、城市文旅、工业纪实、财经解读类中视频项目。 ✅ 适配:一句解说匹配一段空镜画面,批量产出标准化草稿; ❌ 不适合:全部镜头都需要定制 CG 渲染,重度艺术创意剪辑的内容。 自动化的价值,是把脚本拆解、素材查找下载、配音字幕对齐等重复工作交给工具;人的精力保留在选题策划、文案创作、成片审美校验环节。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册