首页 文章 精选 留言 我的

精选列表

搜索[分区技术],共10000篇文章
优秀的个人博客,低调大师

京东广告算法架构体系建设--在线模型系统分布式异构计算演变 | 京东零售广告技术团队

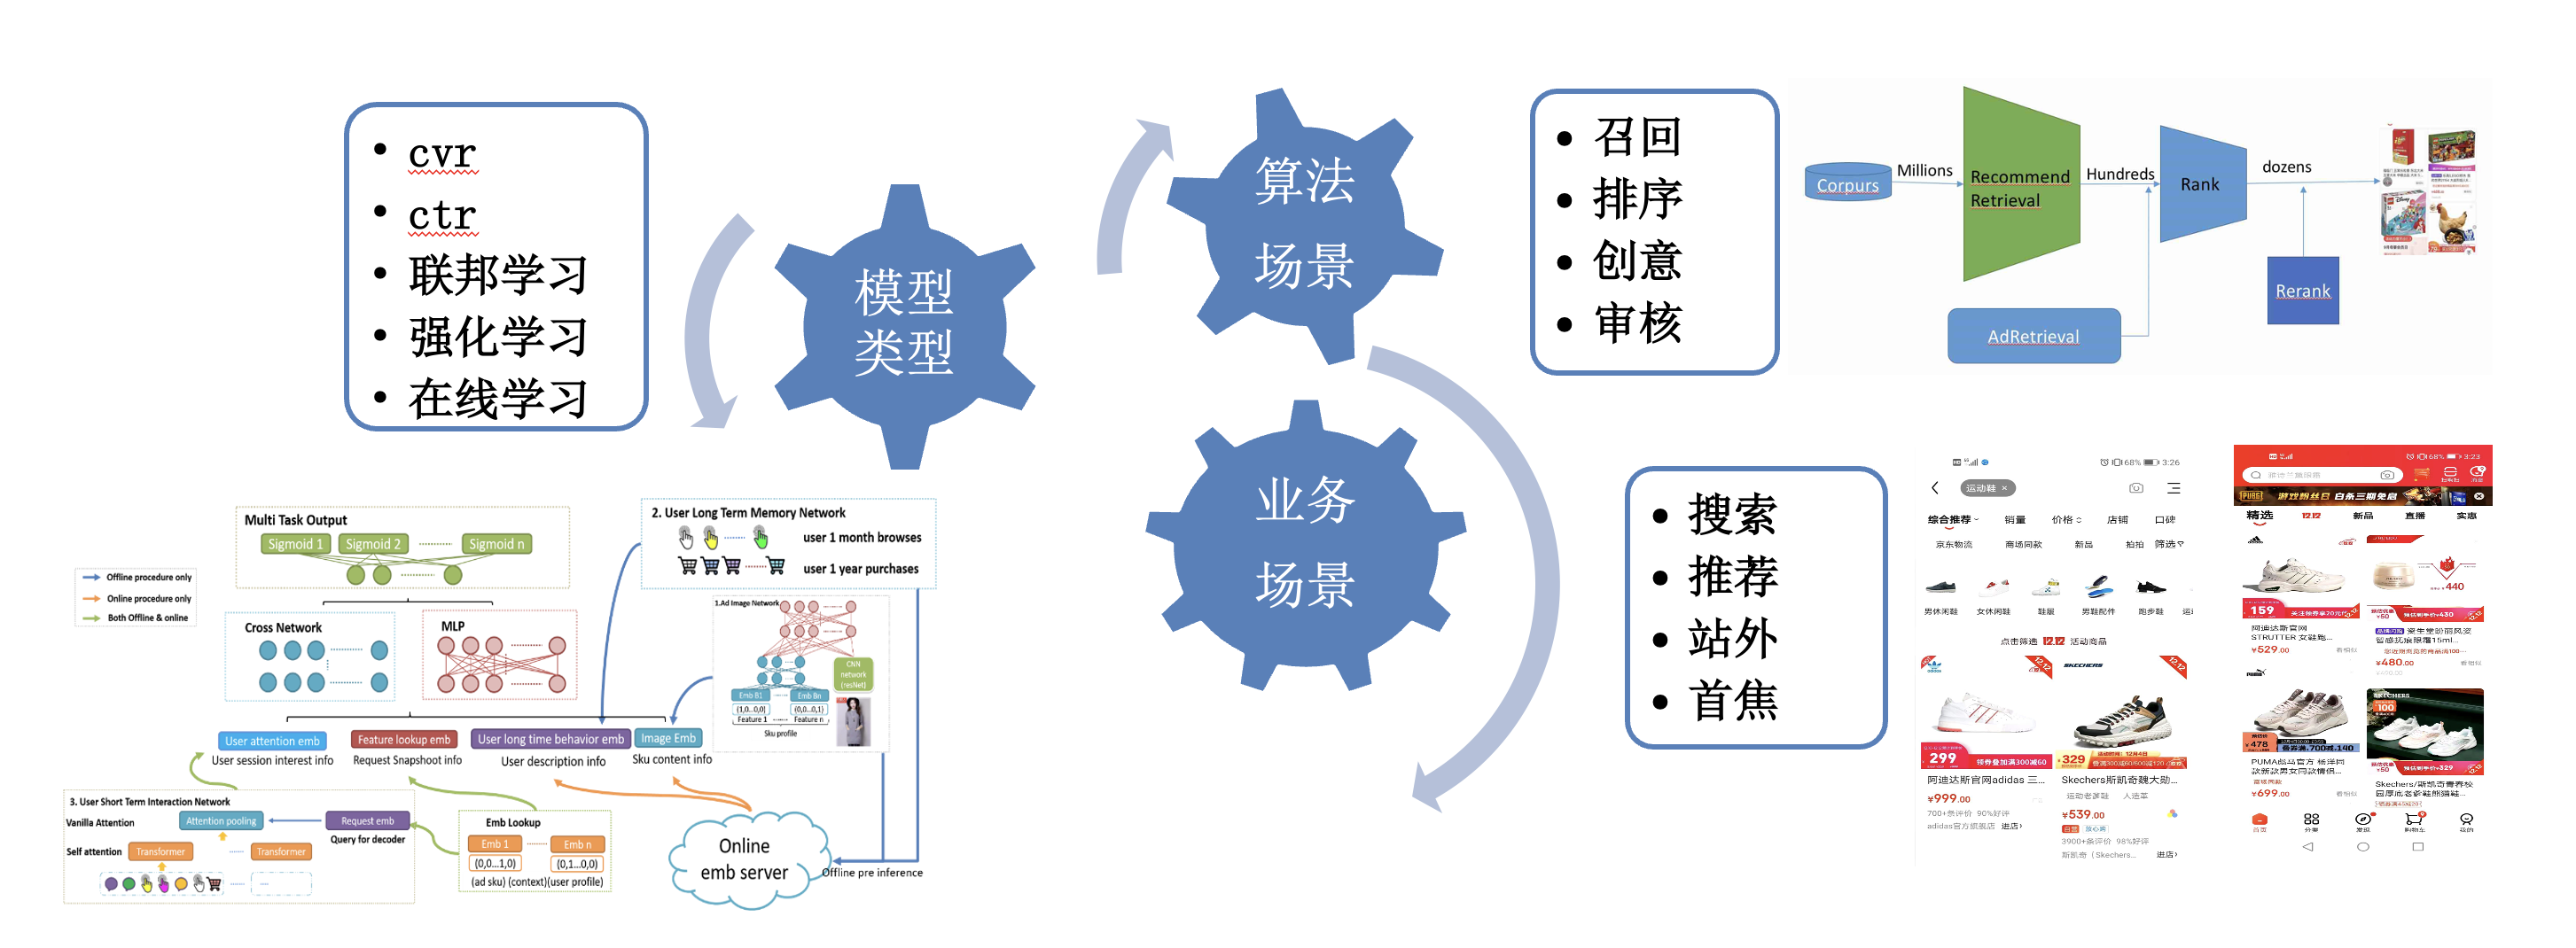
一、现状介绍  算法策略在广告行业中起着重要的作用,它可以帮助广告主和广告平台更好地理解用户行为和兴趣,从而优化广告投放策略,提高广告点击率和转化率。模型系统作为承载算法策略的载体,目前承载搜索、推荐、首焦、站外等众多广告业务和全链路的深度学习建模,是广告算法算法创新和业务迭代发展的重要基石。 架构全景图:  1. 平台能力: 1. 高吞吐高并发:百亿PV,百万QPS 2. 低延迟,高可靠:万亿次预估计算/秒,毫秒级延迟,99.99% 3. 集群规模:1W+节点 4. 迭代周期:3次/天 2. 系统能力 1. 模型规模:TB级模型预估 2. 异构计算:CPU/GPU异构计算 3. 在线学习:分钟级模型更新 4. 实时图计算:亿级节点、百亿级边;分钟级图数据更新 5. 层次化算力:实时计算、离线计算、近线计算 二、发展历程   广告在线模型系统发展大致分为三个主要阶段: 1、深度学习时代:通过组件化、平台化、配置化完成架构的统一和流程机制的规范化,解决迭代效率问题。 2、大模型时代:通过分布式分图计算架构解决模型规模和实效性的问题。 3、算力时代:通过层次化算力建设解决全链路算力协同的问题。 1、深度学习时代——架构统一/迭代效率 广告在线模型系统初期缺乏统一的系统架构和流程机制,随着Tensorflow开源,算法的离线调研能力大幅提升,对应的在线模型架构算法迭代效率问题日益凸显。主要面临的问题如下: ◦ 业务接入成本高:广告业务涉及的业务较多,包括搜索、推荐、首焦、站外,模型涉及到CTR模型、CVR模型、CPA模型。每个业务都要面临新加广告场景、新加/修改模型,都需要添加额外的开发支持,接入效率低成本高。 ◦ 特征繁多,数据不统一,算法实验低效:1)特征来源较多,有商品特征、用户特征、请求特征,没有统一的数据使用规范。2)特征种类也比较多,每个业务用的特征也比较独立,不利于复用。 ◦ 算法和工程耦合:算法模型强依赖算法服务,模型结构修改都要带来服务修改,影响模型迭代。缺乏配置化导致算法扩展困难。 为了解决以上问题,我们将整体框架进行模块化升级,抽象出三个核心模块: ◦ 模型接入服务:负责流量管控,统一流量接入规则,与业务逻辑解耦。 ◦ 特征计算服务:负责数据管理和特征提取,统一数据接入规则。 ◦ 模型推理服务:负责模型推理、更新和落日志,统一模型接入规则。 1.1 模型接入 模型接入包含三大功能: ◦ 流量路由:流量路由的核心是进行动态流量识别,根据配置动态构建语法树,将流量映射到语法树中,从而做到识别流量全路径,包括流量从哪里来、到哪里去。当有新的流量进入或着加入新的模型,可在语法树中添加或修改叶节点,实现动态路由。同时在分层实验中,使用语法树,也可实现流量分层,增加小流量试验的并发度,提升流量使用效率。 ◦ 流量分发:根据流量路由结果进行分发,针对广告队列较多的情况,会将请求进行拆分,并行请求特征和模型推理,实现并行加速。 ◦ 流量防护:对上游来说,通过流量路由拦截异常流量。对下游来说,通过实时监控下游负载,实现动态负载均衡,拦截超负载流量,保护下游服务的安全。   1.2 特征计算 特征计算包含两大功能: ◦ 数据管理:1、支持多类型数据源,包括三类:1)解析请求获取请求中的原始特征。2)本地数据支持特征词表获取离线特征。3)远程数据请求用户、商品等服务获取用户商品的实时特征。2、数据统一:通过特征转换统一特征格式,方便模型进行特征解析。 ◦ 特征计算:将特征计算算子化,通过注册类的方式实现配置化,提升特征开发效率和复用效率。   1.3 模型推理 为了方便算法迭代,将架构拆分成两层,通过分层的设计,将模型和服务解耦,解决架构和模型迭代冲突的问题,提升模型迭代效率。 ◦ 推理引擎层:推理引擎支持模型推理加速,目前支持多种推理引擎(TensorFlow、TensorRT、FasterTransformer等) ◦ 服务层:负责消息处理、特征日志、模型管理。 ▪ 特征日志:支持落实时请求级的特征日志,通过离线拼接生成训练样本。 ▪ 模型管理:通过NormGuard机制对训练模型进行校验,防止将不合规模型推到线上。   1.4 总结 架构上,通过以上服务化、单元化、配置化的升级,实现更高层级的抽象,实现一套架构支持所有算法业务。规范上,实现流量、数据、模型统一标准化。降低算法实验难度,整体迭代周期从周级别提升到天级别,极大提升了算法的迭代效率。 第一阶段的在线模型系统升级,将业务开发由无序到有序,架构从散乱到统一,奠定在线模型系统的基础,也为后续的架构发展提供更多可能。 2、大模型时代——模型规模/时效 平台化加速了模型迭代的同时,业界和广告内部也进入大模型的探索阶段,落地期间遇到模型复杂、参数规模大、时效性低等问题,大模型对算力的需求变得迫切。 ◦ 模型复杂:深度模型的引入极大加速模型的发展,同时也带来模型复杂度的指数提升,以Transfomer为代表的全新神经网络框架,奠定了大模型的算法架构基础,复杂度的提升对模型计算提出更高的要求。 ◦ 参数规模大:用户的增长,商品数量的扩展,带来数据量的爆炸,模型为了更好的模拟现实,参数量也成爆炸性增长。从广告场景内看,算法模型的参数规模也从十亿向着百亿、千亿发展,参数规模的增长对模型存储、IO提出了更高的要求。 ◦ 时效性低:这个阶段模型的更新周期普遍在天级别,实效性较低,尤其在大促人货场发生快速变化的时候,模型更新跟不上用户、商品的变化,会带来搜索/推荐效果折损。 针对以上问题,我们基于离在线一体化设计研发分布式分图计算架构提升算力水平,支持更大参数规模的模型,同时支持OnlineLearning进一步提升时效性,同时在引入图计算提升模型表达能力。 2.1 分布式分图计算架构 1.计算分层:分析复杂的模型网络拓扑结构,基于计算密集逻辑&数据I/O密集进行计算分层 2.存储分层:稀疏&稠密参数分层,充分利用CPU/GPU存储特点 3.离在线一体算力协同:提升模型规模和实效性,做到业界先进水平   效果: 1.在线算力提升10倍+,离线训练性能提升1倍+ 2.搜索排序模型参数规模扩大8倍,点消+3%。推荐排序模型升级百G大模型助力算法收益点消+8%。 2.2 OnlineLearning 1.支持增量更新:提供参数增量更新解决方案,更新间隔由天级别缩短为分钟级别。 2.架构高可用,支持快速回滚   效果: 1.系统支持实时流式训练,分钟级别的线上模型增量更新。 2.广告搜索业务双十一大促期间点消共增长+10.47%。 2.3 图计算 模型为了挖掘用户和商品之间的关系,引入实时图关系数据,提升模型表达能力。 1.采用计算和存储分离架构,结构清晰,利于扩展 2.分布式集群存储,毫秒级延迟计算 3.支撑大规模动态图存储,分钟级更新   效果: 1.支撑十亿级节点百亿级边异构图存储的落地 2.多应用场景:推荐我的京东图建模全量上线,点消+3%;推荐首页召回小流量上线,点消+2%。 2.4 总结 分布式分图计算在模型系统平台化的基础上拓展模型计算能力,通过将内存、IO、CPU、GPU等计算资源协同处理实现异构计算能力,通过软硬件协同的方式极大提升GPU的利用率(具体参见“京东广告算法架构体系建设--高性能计算方案最佳实践”),释放模型预估的算力的同时提升模型时效性。 3、算力时代——算力协同 分布式分图计算和GPU硬件的引入横向加速了单模块模型计算,但是随着模型数据和复杂度进一步提升,暴露了更大的算力不足问题,单模块的算力释放已无法满足模型需求。在纵向的全链路算力协同和应用上也面临新的问题: ◦ 硬件资源不一致,木桶效应:线上机器硬件不一样,比如不同的机器CPU型号不一致导致算力不平衡 ◦ 系统耦合,算力无法充分释放:目前模型计算集中在粗排、精排阶段,在整体耗时的约束下,无法充分发挥算力。 为了解决算力协同的问题,我们的区别前面的优化手段,从算法算力架构一体化融合设计优化角度出发,提出新一代工业化深度学习算法架构体系。整个体系包括两部分,分布式分图计算是基座,通过离在线一体和软硬结合的方式实现算力分层,在此算力架构基础上,结合核心算法场景,对系统算力进行了进一步层次划分,算法算力深度结合,落地广告营销多个场景。   3.1 前置计算   精排用户实时行为建模问题,是业界通用的难点问题,行为序列规模的天花板在百级别, 存在严重的算力瓶颈。针对这一问题,我们的做法是算法和架构深度融合,在算法层面,扩充实时建模规模至千级别,架构层面,通过分图架构拆分精排链路增加前置计算层的方法,进一步实现了算法算力的分配,效果非常显著,在耗时0增长的同时,用户实时建模达到千级别,搜索点消+6%。 3.2 近线计算   在召回场景业界通用的难题是在大规模候选集上实现全库策略检索,从算法层面上解决召回链路和后链路建模不一致问题,我们的方法是通过增加近线计算层,协同特征融合、深度模型端到端建模,实现了离线和在线的进一步算力再分配,实现基于深度模型的全库检索能力,与业界先进水平持平,推荐点消+3%。 3.3 算力动态分配 为了降低机器不同带来的算力不平衡,我们引入多目标分级反馈负载均衡策略:    效果: 共计优化机器资源9000C+。 3.4 总结 面对单模块算力再次不足的问题,从纵向全链路算力协同方面,将算力进行精细化分层,通过实时计算、近线计算、离线计算打通,优化算力分配,拓展算力空间。 三、总结展望 广告在线模型系统经过三个阶段的发展和实践,有力的支撑了多条业务线的快速迭代。为了进一步优化算力,提升算力协同,计划强化动态算力分配机制,根据流量价值和用户分层进行算力动态分配,实现有限资源的收益最大化。   动态算力分配策略包括三类: ◦ 召回控制:通过控制召回分支及召回个数调控算力 ◦ 队列控制:通过控制物料排序个数调控算力 ◦ 模型控制:通过使用算法消耗不同的模型进行打分调控算力 未来,我们会继续围绕算法、算力、架构一体化的思维去不断优化和提升架构计算性能,提升业务迭代效率。 作者:京东零售 齐浩 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

程序员必须知道的数字电子技术——(二,八,十,十六进制,原码,补码,反码及常见编码方式)

1.进制介绍: 十进制: 在十进制数中,每一位有0-9十个数码,所以计数的基数是10。超过9的数必须用多位数表示,其中低位和相邻高位之间的关系是:逢十进一,故称为十进制。例如: 所以一个任意多位的十进制D均可展开为:若以N取代式中的10,即可得到多位任意进制(N进制)数展开式的普遍形式:式中i的取值与十进制展开式的规定相同。N称为计数的基数,k为第i位的系数,N称为第i位的权。 二进制: 目前在数字电路中应用最广泛的是二进制。在二进制数中,每一位仅有0和1两个可能的数码,所以计数基数为2。低位和相邻高位间的进位关系是“逢二进一”, 故称为二进制。根据N进制数展开的普遍形式可得任何一个二进制数均可展开为:并可利用上式计算出它所表达的十进制数的大小:上式中分别使用下脚注2和10表示括号里的数是二进制数和十进制数。有时也用B( Bima-ry)和D( Decimal)代替2和10这两个脚注。 八进制 在某些场合有时也使用八进制。八进制数的每一位有0~7 八个不同的数码,计数的基数为8。低位和相邻的高位之间的进位关系是“逢八进一”。任意一个八进制数可以展开为并可利用上式计算出相应的十进制数:有时也用O(Oetal)代替下脚注8,表示八进制数。 十六进制 十六进制 数的每一位有十六个不同的数码,分别用0~9.A(10)、B(11) .C(12)、D(13)、E(14)、P(15)表示。因此,任意一个十六进制数均可展开为 并可以利用上式计算出相应的十进制数 式中的下脚注16表示括号里的数是十六进制数,有时也用H( Hexadecimal)代替这个脚注,0X表示前缀。 小节:不同进制数的对照表:小拓展:(1)一位八进制可以表示三位二进制数:因为三位二进制最小是000b,最大是111b,其范围恰好在0-7,构成了八进制一位。(2)一位十六进制可以表示为四位二进制十六进制数的进率是16,二进制数的进率是2,且16=2^4,说明二进制数连续进位4次,等效于16进制数进1位。这么说可能不好理解,那么举个例子吧,比如15+1=16,用二进制表示就是1111+1=10000,用十六进制表示就是F+1=10。这也就说明了一位十六进制数对应四位二进制数了 2.不同进制间的转换 (1)八进制,二进制,十六进制转换为十进制 都可根据上述十进制介绍中的 多位任意进制数展开式的普遍形式 进行转换,即按位权展开式。 (2)十进制转换为二进制,八进制,十六进制 十进制整数转换R进制(R可以是任何整数,比如2,8,16)整数,方法就是除R取余。 1.十进制转换为二进制: 十进制整数转换为二进制:(除二取余,从下往上倒序排序)十进制小数转换为二进制:(乘二取整,从上向下顺序排序) 2.十进制转换为十六进制 十进制数为整数时,除16取余十进制数为小数时,乘16取整 3.十进制转换为八进制 十进制为整数时,除八取余十进制为小数时,乘八取整 (3)二进制转换为十六进制 只要从低位到高位将整数部分每4位二进制数分为一组并代之以等值的十六进制数,同时从高位到低位将小数部分的每4位数分为一组并代之以等值的十六进制数,即可得到对应的十六进制数。若二进制数整数部分最高- -组不足4位时,用0补足4位;小数部分最低一组不足 4位时,也需用0补足4位。 (2)二进制转换为八进制 在将二进制数转换为八进制数时,只要将二进制数的整数部分从低位到高位每3位分为一组并代之以等值的八进制数,同时将小数部分从高位到低位每3位分为一组并代之以等值的八进制数就可以了。二进制数最高一组不足3位或小数部分最低一组不足3位时,仍需以0补足三位。 (3)十六进制转换为二进制 转换时只需将十六进制数的每一位用等值的4位二进制数代替就行了。 (2)八进制转换为二进制 若将八进制数转换为二进制数,则只要将八进制数的每一位代之以等值的3位二进制。 (3)八进制与十六进制之间的转换 第一种:他们之间的转换可以先转成二进制然后再相互转换。第二种:他们之间的转换可以先转成十进制然后再相互转换 建议:先将八进制转换为对应的二进制,再将二进制转换为十六进制。 3.二进制算数运算 如果我们再能设法将减法操作转化为某种形式的加法操作,那么加,减,乘.除运算就全部可以用“移位”和“相加”两种操作实现了。利用上述特点能使运算电路的结构大为简化。这也是 (1)反码,补码和补码运算 我们已经知道,在数字电路中是用逻辑电路输出的高、低电平表示二进制数的1和0的。那么数的正,负又如何表示呢?通常采用的方法是在二进制数的前面增加一位符号位。符号位为0表示这个数是正数,符号位为1表示这个数是负数。这种形式的数称为原码。 因为计算机只会执行加法,不会进行减法运算,所以我们考虑怎样把二进制的减法运算变为加法运算,这里就出现了补码。 可以发现:在舍弃进位的条件下,减去某个数可以用加上它的补码来代替!!! 然后我们考虑,如果直接得到原码的补码的话非常麻烦,所以这里就出现了反码这个中介。 反码:正数(即符号位为0)的反码与原码相同,负数(即符号位为1)的反码为(注意:符号位不变)原码的数值位逐位取反(即1变为0,0变为1)。 补码:正数的补码与原码相同,负数的补码为原码的数值位(注意:符号位不变)逐位取反再加1。 即直接原码的反码加1即可!!! 注意:求原码对应的补码是逐位取反再加1;那么求补码对应的原码也是一样,逐位取反再加1. 下面再来讨论两个用补码表示的二进制数相加时,和的符号位如何得到。为此,我们在例下面再来讨论两个用补码表示的二进制数相加时,和的符号位如何得到。 为此,我们在例1.4.2中列举出了两数相加时的四种情况。 (2)几种常用的编码 1.十进制码 为了用二进制代码表示十进制数的0~9这十个状态,二进制代码至少应当有4位。4位二进制代码一共有十六个(000-1111),取其中哪十个以及如何与0-9相对应,有许多种方案。表1.5.1中列出了常见的几种十进制代码,它们的编码规则各不相同。 (1)8421码又称BCD( Binary Coded Decimal)码,是十进制代码中最常用的一种。在这种编码方式中,每一位二值代码的1都代表一个固定数值,将每一位的 1代表的十进制数加起来,得到的结果就是它所代表的十进制数码。由于代码中从左到右每一位的1分别表示8,4,2,1,所以将这种代码称为8421码。每一位的1代表的十进制数称为这一位的权。8421码中每一位的权是固定不变的,它属于恒权代码。 余3码的编码规则与8421码不同,如果把每–个余3码看作4位二进制数.则它的数值要# 1.进制介绍: 十进制: 在十进制数中,每一位有0-9十个数码,所以计数的基数是10。超过9的数必须用多位数表示,其中低位和相邻高位之间的关系是:逢十进一,故称为十进制。例如: 所以一个任意多位的十进制D均可展开为:若以N取代式中的10,即可得到多位任意进制(N进制)数展开式的普遍形式:式中i的取值与十进制展开式的规定相同。N称为计数的基数,k为第i位的系数,N称为第i位的权。 二进制: 目前在数字电路中应用最广泛的是二进制。在二进制数中,每一位仅有0和1两个可能的数码,所以计数基数为2。低位和相邻高位间的进位关系是“逢二进一”, 故称为二进制。根据N进制数展开的普遍形式可得任何一个二进制数均可展开为:并可利用上式计算出它所表达的十进制数的大小:上式中分别使用下脚注2和10表示括号里的数是二进制数和十进制数。有时也用B( Bima-ry)和D( Decimal)代替2和10这两个脚注。 八进制 在某些场合有时也使用八进制。八进制数的每一位有0~7 八个不同的数码,计数的基数为8。低位和相邻的高位之间的进位关系是“逢八进一”。任意一个八进制数可以展开为并可利用上式计算出相应的十进制数:有时也用O(Oetal)代替下脚注8,表示八进制数。 十六进制 十六进制 数的每一位有十六个不同的数码,分别用0~9.A(10)、B(11) .C(12)、D(13)、E(14)、P(15)表示。因此,任意一个十六进制数均可展开为 并可以利用上式计算出相应的十进制数 式中的下脚注16表示括号里的数是十六进制数,有时也用H( Hexadecimal)代替这个脚注,0X表示前缀。 小节:不同进制数的对照表:小拓展:(1)一位八进制可以表示三位二进制数:因为三位二进制最小是000b,最大是111b,其范围恰好在0-7,构成了八进制一位。(2)一位十六进制可以表示为四位二进制十六进制数的进率是16,二进制数的进率是2,且16=2^4,说明二进制数连续进位4次,等效于16进制数进1位。这么说可能不好理解,那么举个例子吧,比如15+1=16,用二进制表示就是1111+1=10000,用十六进制表示就是F+1=10。这也就说明了一位十六进制数对应四位二进制数了 2.不同进制间的转换 (1)八进制,二进制,十六进制转换为十进制 都可根据上述十进制介绍中的 多位任意进制数展开式的普遍形式 进行转换,即按位权展开式。 (2)十进制转换为二进制,八进制,十六进制 十进制整数转换R进制(R可以是任何整数,比如2,8,16)整数,方法就是除R取余。 1.十进制转换为二进制: 十进制整数转换为二进制:(除二取余,从下往上倒序排序)十进制小数转换为二进制:(乘二取整,从上向下顺序排序) 2.十进制转换为十六进制 十进制数为整数时,除16取余十进制数为小数时,乘16取整 3.十进制转换为八进制 十进制为整数时,除八取余十进制为小数时,乘八取整 (3)二进制转换为十六进制 只要从低位到高位将整数部分每4位二进制数分为一组并代之以等值的十六进制数,同时从高位到低位将小数部分的每4位数分为一组并代之以等值的十六进制数,即可得到对应的十六进制数。若二进制数整数部分最高- -组不足4位时,用0补足4位;小数部分最低一组不足 4位时,也需用0补足4位。 (2)二进制转换为八进制 在将二进制数转换为八进制数时,只要将二进制数的整数部分从低位到高位每3位分为一组并代之以等值的八进制数,同时将小数部分从高位到低位每3位分为一组并代之以等值的八进制数就可以了。二进制数最高一组不足3位或小数部分最低一组不足3位时,仍需以0补足三位。 (3)十六进制转换为二进制 转换时只需将十六进制数的每一位用等值的4位二进制数代替就行了。 (2)八进制转换为二进制 若将八进制数转换为二进制数,则只要将八进制数的每一位代之以等值的3位二进制。 (3)八进制与十六进制之间的转换 第一种:他们之间的转换可以先转成二进制然后再相互转换。第二种:他们之间的转换可以先转成十进制然后再相互转换 建议:先将八进制转换为对应的二进制,再将二进制转换为十六进制。 3.二进制算数运算 如果我们再能设法将减法操作转化为某种形式的加法操作,那么加,减,乘.除运算就全部可以用“移位”和“相加”两种操作实现了。利用上述特点能使运算电路的结构大为简化。这也是 (1)反码,补码和补码运算 我们已经知道,在数字电路中是用逻辑电路输出的高、低电平表示二进制数的1和0的。那么数的正,负又如何表示呢?通常采用的方法是在二进制数的前面增加一位符号位。符号位为0表示这个数是正数,符号位为1表示这个数是负数。这种形式的数称为原码。 因为计算机只会执行加法,不会进行减法运算,所以我们考虑怎样把二进制的减法运算变为加法运算,这里就出现了补码。 可以发现:在舍弃进位的条件下,减去某个数可以用加上它的补码来代替!!! 然后我们考虑,如果直接得到原码的补码的话非常麻烦,所以这里就出现了反码这个中介。 反码:正数(即符号位为0)的反码与原码相同,负数(即符号位为1)的反码为(注意:符号位不变)原码的数值位逐位取反(即1变为0,0变为1)。 补码:正数的补码与原码相同,负数的补码为原码的数值位(注意:符号位不变)逐位取反再加1。 即直接原码的反码加1即可!!! 注意:求原码对应的补码是逐位取反再加1;那么求补码对应的原码也是一样,逐位取反再加1. 下面再来讨论两个用补码表示的二进制数相加时,和的符号位如何得到。为此,我们在例下面再来讨论两个用补码表示的二进制数相加时,和的符号位如何得到。 为此,我们在例1.4.2中列举出了两数相加时的四种情况。 (2)几种常用的编码 1.十进制码 为了用二进制代码表示十进制数的0~9这十个状态,二进制代码至少应当有4位。4位二进制代码一共有十六个(000-1111),取其中哪十个以及如何与0-9相对应,有许多种方案。表1.5.1中列出了常见的几种十进制代码,它们的编码规则各不相同。 (1)8421码又称BCD( Binary Coded Decimal)码,是十进制代码中最常用的一种。在这种编码方式中,每一位二值代码的1都代表一个固定数值,将每一位的 1代表的十进制数加起来,得到的结果就是它所代表的十进制数码。由于代码中从左到右每一位的1分别表示8,4,2,1,所以将这种代码称为8421码。每一位的1代表的十进制数称为这一位的权。8421码中每一位的权是固定不变的,它属于恒权代码。 余3码的编码规则与8421码不同,如果把每–个余3码看作4位二进制数.则它的数值要# 1.进制介绍: 十进制: 在十进制数中,每一位有0-9十个数码,所以计数的基数是10。超过9的数必须用多位数表示,其中低位和相邻高位之间的关系是:逢十进一,故称为十进制。例如: 所以一个任意多位的十进制D均可展开为:若以N取代式中的10,即可得到多位任意进制(N进制)数展开式的普遍形式:式中i的取值与十进制展开式的规定相同。N称为计数的基数,k为第i位的系数,N称为第i位的权。 二进制: 目前在数字电路中应用最广泛的是二进制。在二进制数中,每一位仅有0和1两个可能的数码,所以计数基数为2。低位和相邻高位间的进位关系是“逢二进一”, 故称为二进制。根据N进制数展开的普遍形式可得任何一个二进制数均可展开为:并可利用上式计算出它所表达的十进制数的大小:上式中分别使用下脚注2和10表示括号里的数是二进制数和十进制数。有时也用B( Bima-ry)和D( Decimal)代替2和10这两个脚注。 八进制 在某些场合有时也使用八进制。八进制数的每一位有0~7 八个不同的数码,计数的基数为8。低位和相邻的高位之间的进位关系是“逢八进一”。任意一个八进制数可以展开为并可利用上式计算出相应的十进制数:有时也用O(Oetal)代替下脚注8,表示八进制数。 十六进制 十六进制 数的每一位有十六个不同的数码,分别用0~9.A(10)、B(11) .C(12)、D(13)、E(14)、P(15)表示。因此,任意一个十六进制数均可展开为 并可以利用上式计算出相应的十进制数 式中的下脚注16表示括号里的数是十六进制数,有时也用H( Hexadecimal)代替这个脚注,0X表示前缀。 小节:不同进制数的对照表:小拓展:(1)一位八进制可以表示三位二进制数:因为三位二进制最小是000b,最大是111b,其范围恰好在0-7,构成了八进制一位。(2)一位十六进制可以表示为四位二进制十六进制数的进率是16,二进制数的进率是2,且16=2^4,说明二进制数连续进位4次,等效于16进制数进1位。这么说可能不好理解,那么举个例子吧,比如15+1=16,用二进制表示就是1111+1=10000,用十六进制表示就是F+1=10。这也就说明了一位十六进制数对应四位二进制数了 2.不同进制间的转换 (1)八进制,二进制,十六进制转换为十进制 都可根据上述十进制介绍中的 多位任意进制数展开式的普遍形式 进行转换,即按位权展开式。 (2)十进制转换为二进制,八进制,十六进制 十进制整数转换R进制(R可以是任何整数,比如2,8,16)整数,方法就是除R取余。 1.十进制转换为二进制: 十进制整数转换为二进制:(除二取余,从下往上倒序排序)十进制小数转换为二进制:(乘二取整,从上向下顺序排序) 2.十进制转换为十六进制 十进制数为整数时,除16取余十进制数为小数时,乘16取整 3.十进制转换为八进制 十进制为整数时,除八取余十进制为小数时,乘八取整 (3)二进制转换为十六进制 只要从低位到高位将整数部分每4位二进制数分为一组并代之以等值的十六进制数,同时从高位到低位将小数部分的每4位数分为一组并代之以等值的十六进制数,即可得到对应的十六进制数。若二进制数整数部分最高- -组不足4位时,用0补足4位;小数部分最低一组不足 4位时,也需用0补足4位。 (2)二进制转换为八进制 在将二进制数转换为八进制数时,只要将二进制数的整数部分从低位到高位每3位分为一组并代之以等值的八进制数,同时将小数部分从高位到低位每3位分为一组并代之以等值的八进制数就可以了。二进制数最高一组不足3位或小数部分最低一组不足3位时,仍需以0补足三位。 (3)十六进制转换为二进制 转换时只需将十六进制数的每一位用等值的4位二进制数代替就行了。 (2)八进制转换为二进制 若将八进制数转换为二进制数,则只要将八进制数的每一位代之以等值的3位二进制。 (3)八进制与十六进制之间的转换 第一种:他们之间的转换可以先转成二进制然后再相互转换。第二种:他们之间的转换可以先转成十进制然后再相互转换 建议:先将八进制转换为对应的二进制,再将二进制转换为十六进制。 3.二进制算数运算 如果我们再能设法将减法操作转化为某种形式的加法操作,那么加,减,乘.除运算就全部可以用“移位”和“相加”两种操作实现了。利用上述特点能使运算电路的结构大为简化。这也是 (1)反码,补码和补码运算 我们已经知道,在数字电路中是用逻辑电路输出的高、低电平表示二进制数的1和0的。那么数的正,负又如何表示呢?通常采用的方法是在二进制数的前面增加一位符号位。符号位为0表示这个数是正数,符号位为1表示这个数是负数。这种形式的数称为原码。 因为计算机只会执行加法,不会进行减法运算,所以我们考虑怎样把二进制的减法运算变为加法运算,这里就出现了补码。 可以发现:在舍弃进位的条件下,减去某个数可以用加上它的补码来代替!!! 然后我们考虑,如果直接得到原码的补码的话非常麻烦,所以这里就出现了反码这个中介。 反码:正数(即符号位为0)的反码与原码相同,负数(即符号位为1)的反码为(注意:符号位不变)原码的数值位逐位取反(即1变为0,0变为1)。 补码:正数的补码与原码相同,负数的补码为原码的数值位(注意:符号位不变)逐位取反再加1。 即直接原码的反码加1即可!!! 注意:求原码对应的补码是逐位取反再加1;那么求补码对应的原码也是一样,逐位取反再加1. 下面再来讨论两个用补码表示的二进制数相加时,和的符号位如何得到。为此,我们在例下面再来讨论两个用补码表示的二进制数相加时,和的符号位如何得到。 为此,我们在例1.4.2中列举出了两数相加时的四种情况。 (2)几种常用的编码 1.十进制码 为了用二进制代码表示十进制数的0~9这十个状态,二进制代码至少应当有4位。4位二进制代码一共有十六个(000-1111),取其中哪十个以及如何与0-9相对应,有许多种方案。表1.5.1中列出了常见的几种十进制代码,它们的编码规则各不相同。 (1)8421码又称BCD( Binary Coded Decimal)码,是十进制代码中最常用的一种。在这种编码方式中,每一位二值代码的1都代表一个固定数值,将每一位的 1代表的十进制数加起来,得到的结果就是它所代表的十进制数码。由于代码中从左到右每一位的1分别表示8,4,2,1,所以将这种代码称为8421码。每一位的1代表的十进制数称为这一位的权。8421码中每一位的权是固定不变的,它属于恒权代码。 (2)余3码的编码规则与8421码不同,如果把每–个余3码看作4位二进制数.则它的数值要比它所表示的十进制数码多3,故而将这种代码称为余3码。 如果将两个余3码相加,所得的和将比十进制数和所对应的二进制数多6。因此,在用余3码做十进制加法运算时.若两数之和为10.正好等于二进制数的16.于是便从高位自动产生进位信号。此外,从表1.5.1中还可以看出,0和9、1和8.2和7,3和6.4和5的余3码互为反码,这对于求取对10的补码是很方便的。余3码不是恒权代码。如果试图将每个代码视为二进制数,并使它等效的十进制数与所表示的代码相等,那么代码中每一位的1所代表的十进制数在各个代码中不能是固定的。 (3)2421码是一种恒权代码,它的0和9.1和8.2和7,3和6.4和5也互为反码,这个特点和余3码相仿。 (4)5211码是另一种恒权代码。待学了第六章中计数器的分频作用后可以发现,如果按8421码接成十进制计数器,则连续输入计数脉冲时,4个触发器输出脉冲对于计数脉冲的分频比从低位到高位依次为5:2:1:1。可见,5211 码每一位的权正好与8421码十进制计数器4个触发器输出脉冲的分频比相对应。这种对应关系在构成某些数字系统时很有用。 (5)余3循环码是- -种变权码,每一位的1在不同代码中并不化表固定的数值。它的主要特点是相邻的两个代码之间仅有一位的状态不同, 2.格雷码 格雷码(GrayCode)又称循环码。从表1.5.2的4位格雷码编码表中可以看出格雷码的构成方法,这就是每一位的状态变化都按一定的 顺序循环。如果从0000开始,最右边一位的状态按0110顺序循环变化,右边第二位的状态按01011100 顺序循环变化,右边第三位按00011111100000顺序循环变化。可见,自右向左,每一位状态循环中连续的0,1数目增加一倍。由于4位格雷码只有16 个,所以最左边一位的状态只有半个循环,即0000001111111。按照上述原则,我们就很容易得到更多位数的格雷码。 与普通的二进制代码相比,格雷码的最大优点就在于当它按照表1.5.2的编码顺序依次变化时,相邻两个代码之间只有一位发生变化。这样在代码转换的过程中就不会产生过渡“噪声”。而在普通二进制代码的转换过程中,则有时会产生过渡噪声。例如,第四行的二进制代码0011转换为第五行的0100过程中,如果最右边一位的变化比其他两位的变化慢,就会在一个极短的瞬间出现0101状态,这个状态将成为转换过程中出现的噪声。而在第四行的格雷码0010向第五行的0110转换过程中则不会出现过渡噪声。这种过渡噪声在有些情况下甚至会影响电路的正常工作,这时就必须采取揩施加以避免。在第4.9节中我们还将进一步讨论这个问题:十进制代码中的余3循环码就是取4位格雷码中的十个代码组成的,它仍然具有格雷码的优点,即两个相邻代码之间仅有一位不同。

优秀的个人博客,低调大师

Java技术专题-JVM研究系列(35)认识一下线程上下文类加载器实现【逆向加载机制】

前提概要 线程上下文类加载,就是当前线程所拥有的类加载器,可通过 Thread.currentThread() 获取当前线程。 线程上下文类加载器(Thread Context ClassLoader)可以通过java.lang.Thread类的setContextClassLoader()方法设置,创建线程时候未指定的话,则默认从父线程中继承(系统类加载器)。 main方法的主线程上下文类加载器就是sun.misc.Launcher$AppClassLoader。 之前讲述过了类加载器的双亲委派模型,该模型的实现是通过类加载器中的parent属性(父加载器)来完成的,默认统一交给最上层启动类加载器去尝试加载。 但是如果希望不遵循双亲委托模型类加载机制,则除了大家公认知道的自定义类加载器并覆盖ClassLoader的loadClass()方法。还有另外一个办法就是采用线程上下文类加载器去实现调整双亲委托机制实现逆向加载机制 public class ThreadClassLoaderTest { public static void main(String[] agrs) throws ClassNotFoundException { ClassLoader loader = ThreadClassLoaderTest.class.getClassLoader(); System.out.println(loader); //默认是应用类加载器 //此时获得上下文类加载器: ClassLoader loader2 = Thread.currentThread().getContextClassLoader(); System.out.println(loader2);//默认也是应用类加载器 //设置为自定义类加载器: Thread.currentThread().setContextClassLoader( new ClassLoaderTest("d:/")); System.out.println(Thread.currentThread().getContextClassLoader()); //使用自定义类加载器加载: Class c = Thread.currentThread().getContextClassLoader().loadClass("HelloWorld"); System.out.println(c.getClassLoader());//线程上下文类加载器 ClassLoader loader3 = String.class.getClassLoader(); System.out.println(loader3);//启动类加载器 = null } } 测试结果: sun.misc.Launcher$AppClassLoader@41dee0d7 sun.misc.Launcher$AppClassLoader@41dee0d7 ClassLoaderTest@516a4aef ClassLoaderTest@516a4aef null Java--SPI机制 在介绍线程上下文类加载前,我们先了解下Java的SPI机制,因为SPI就是我们线程上下文处理的一个典型案例,线程上下文类加载实现。我们以JDBC的SPI机制做实际案例。 JDBC加载案例分析 举个简单的例子,mysql是如何获取数据库连接: public class JDBCTest { public static void main(String[] agrs) { try { // 注册驱动类 Class.forName("com.mysql.jdbc.Driver"); String url = "jdbc:mysql://localhost:3306/testdb"; //通过java库获取数据库连接 Connection conn = java.sql.DriverManager.getConnection(url, "root", "123456"); } catch (ClassNotFoundException e) { e.printStackTrace(); } catch (SQLException e) { e.printStackTrace(); } } } 以上就是mysql注册驱动及获取connection的过程。在该流程中,java通过线程上线文类加载器实现了逆向类加载。 通过系统类加载器,加载Driver类,Class.forName("com.mysql.jdbc.Driver"); 底层具体实现:registerDriver() 将driver实例注册到java.sql.DriverManager类中,其实就是将com.mysql.jdbc.Driver添加到java.sql.DriverManager类的静态变量CopyOnWriteArrayList集合中。 com.mysql.jdbc.Driver包中: public class Driver extends NonRegisteringDriver implements java.sql.Driver { static { try { java.sql.DriverManager.registerDriver(new Driver()); } catch (SQLException E) { throw new RuntimeException("Can't register driver!"); } } } 通过java.sql.DriverManager注册数据库驱动。首先,来看下DriverManager的静态方法。需要明确的是java.sql.DriverManager位于rt.jar包目录下,该目录下的所有类均由Bootstrap启动类加载器进行加载。 java.sql.DriverManager包中: static { //初始化Driver驱动实现类: loadInitialDrivers(); println("JDBC DriverManager initialized"); } private static void loadInitialDrivers() { String drivers; try { drivers = AccessController.doPrivileged(new PrivilegedAction<String>() { public String run() { return System.getProperty("jdbc.drivers"); } }); } catch (Exception ex) { drivers = null; } //通过spi来加载jdbc驱动实现类: AccessController.doPrivileged(new PrivilegedAction<Void>() { public Void run() { //通过SPI方式,读取META-INF/services下文件中的类: ServiceLoader<Driver> loadedDrivers = ServiceLoader.load(Driver.class); Iterator driversIterator = loadedDrivers.iterator(); try{ while(driversIterator.hasNext()) { driversIterator.next(); } } catch(Throwable t) {} return null; } }); println("DriverManager.initialize: jdbc.drivers = " + drivers); if (drivers == null || drivers.equals("")) { return; } String[] driversList = drivers.split(":"); println("number of Drivers:" + driversList.length); for (String aDriver : driversList) { try { println("DriverManager.Initialize: loading " + aDriver); Class.forName(aDriver, true, ClassLoader.getSystemClassLoader()); } catch (Exception ex) { println("DriverManager.Initialize: load failed: " + ex); } } } spi具体实现: 在下面代码中,通过SPI方式来完成java.sql.Driver接口实现类的类加载操作。 java.sql.DriverManager包中: AccessController.doPrivileged(new PrivilegedAction<Void>() { public Void run() { //通过SPI方式,读取META-INF/services下文件中的类名: ServiceLoader<Driver> loadedDrivers = ServiceLoader.load(Driver.class); Iterator driversIterator = loadedDrivers.iterator(); try{ while(driversIterator.hasNext()) { driversIterator.next(); } } catch(Throwable t) {} return null; } }); 获取到ServiceLoader对象后,进行遍历操作,遍历出所有META-INF/services文件夹下的实现类名称,之后再进行Class.forName("")类加载操作。类加载操作在driversIterator.next()中完成。 java.util.ServiceLoader包中: public static <S> ServiceLoader<S> load(Class<S> service) { //获取线程上下文类加载器: ClassLoader cl = Thread.currentThread().getContextClassLoader(); //生成ServiceLoader对象: return ServiceLoader.load(service, cl); } public static <S> ServiceLoader<S> load(Class<S> service, ClassLoader loader){ return new ServiceLoader<>(service, loader); } private ServiceLoader(Class<S> svc, ClassLoader cl) { service = svc; loader = cl; reload(); } 在获取ServiceLoader对象时,获取了此时线程上下文中的类加载器,将此类加载赋值给ServiceLoader类中的loader成员变量。在后续类加载过程中,都是使用的此类加载来完成。这一步的操作,直接打破了双亲委派模型,实现了逆向类加载。 try{ while(driversIterator.hasNext()) { driversIterator.next(); } } catch(Throwable t) {} driversIterator.next()方法内部会调用 Class c = Class.forName(cn, false, loader)方法进行类加载操作。而此时传递的loader就是之前获取的线程上下文类加载器,传递的cn就是META-INF/services文件中的具体实现类。

优秀的个人博客,低调大师

阿里云高级技术专家赵伟教你在CDN边缘节点上构建多层纵深防护体系

网络安全态势严峻,常见的五大网络攻击风险类型 赵伟认为,企业线上服务所面临的安全风险,主要来自以下五个方面: DDoS攻击 DDoS攻击类型已有20多年历史,它攻击方式简单直接,通过伪造报文直接拥塞企业上联带宽。随着IoT等终端设备增多,网络攻击量也愈发凶猛。根据阿里云安全中心报告显示,在2019年,超过100G的攻击已经比较常见,而且超过 500G 的攻击也已经成为常态。一旦企业服务面临这种情况,上联带宽被打满,正常请求无法承接,就会导致企业服务无法正常提供线上服务。因此,防御DDoS 攻击依然是企业首先要投入去应对的问题。 CC攻击 相比于四层DDoS攻击伪造报文,CC攻击通过向受害的服务器发送大量请求来耗尽服务器的资源宝库CPU、内存等。常见的方式是访问需要服务器进行数据库查询的相关请求,这种情况想服务器负载以及资源消耗会很快飙升,导致服务器响应变慢甚至不可用。 Web攻击 常见的 Web 攻击包括SQL 注入、跨站脚本攻击XSS、跨站请求伪造SCRF 等。与DDoS和CC以大量报文发起的攻击相比,Web 攻击主要是利用 Web 设计的漏洞达到攻击的目标。一旦攻击行为实施成功,要么网站的数据库内容泄露,或者网页被挂马。数据库内容泄露严重影响企业的数据安全,网页被挂马会影响企业网站的安全形象以及被搜索引擎降权等。 恶意爬虫 根据阿里云安全中心的报告数据显示,2019年,恶意爬虫在房产、交通、游戏、电商、资讯论坛等几个行业中的占比都超过50%。恶意爬虫通过去爬取网站核心的内容,比如电商的价格信息等,对信息进行窃取,同时也加重服务器的负担。 劫持篡改 劫持和篡改比较常见,当网站被第三方劫持后,流量会被引流到其他网站上,导致网站的用户访问流量减少,用户流失。同时,对于传媒、政务网站来说,内容被篡改会引发极大的政策风险。 企业线上业务需要构建多层次纵深防护 面对愈发严峻的网络安全态势,为了应对以上安全风险,企业在关注线上业务的流畅、稳定的同时,也要构建多层次纵深防护体系,从各个层面建立响应的应对措施和防护机制。 在网络层,需要进行DDoS攻击的清洗和处理,当造成更严重影响需要通过切换IP以及联合黑洞机制去缓解。 在传输层,相较于传统明文传输,通过https的支持去进行传输层面加密,来避免证书伪造。 在应用层,需要进行CC防护、防爬、业务防刷的能力部署,防止恶意攻击者刷带宽的情况发生,避免经济和业务损失。贴近源站的防护方面,需要部署WAF和防篡改,对源站和内容进行防护。 企业需要在网络层、传输层、应用层等多层次构建防护能力,同时在应用层,对于不同场景要有不同防护措施。 基于CDN构建边缘安全+高防中心防护安全架构 基于对纵深防护的理解,阿里云CDN的安全架构是基于CDN分布式节点实现的边缘安全防护机制,同时联动高防清洗中心进行防护。 如下图所示,整体安全架构第一层防护就是构建在全球CDN节点上,将更多安全能力加强在边缘节点上,通过多层次多维度流量数据统计和攻击检测的能力,包括DDoS、HTTP访问信息等数据汇总到安全大脑,安全大脑再对数据进行综合分析,针对不同层次的攻击下发相应的动态防御策略到边缘节点。与此同时,边缘节点自身也会进行自动防御和清洗。另外,整体安全架构将WAF和防篡改能力部署在回源节点上,对攻击到达源站之前进行防御。如果源站希望只在CDN服务之下,不想暴露在公网上,整体架构也会基于CDN提供源站高级防护能力,避免源站被恶意扫描者被发现。 对于金融、政府等场景,需要具备大流量抗D的能力,CDN有海量边缘节点通过自己的调度和清洗能力把大部分DDoS攻击给消化掉。当一旦出现更严重的DDoS攻击时,安全大脑会指导智能调度,将被攻击的流量切换到高级防护节点去清洗。 阿里云CDN安全架构三个核心能力 在以上的CDN安全架构基础之上,赵伟也对DDoS防护智能调度、Web防护以及机器流量管理三个核心能力进行解读。 一、DDoS防护智能调度:边缘节点分布式抗D与高防中心大流量抗D联动 DDoS防护智能调度的策略是,业务流量缺省通过CDN分发,最大程度确保加速效果和用户体验,而当检测到大流量 DDoS 攻击之后,智能调度会判断严重程度并决策由高防进行 DDoS清洗,同时根据攻击情况进行区域调度或全局调度,而当DDoS 攻击停止后,智能调度系统会自动决策将高防服务的业务流量调度回 CDN 边缘节点,尽最大可能的保证正常加速效果。 DDoS防护智能调度最核心就是边缘加速、智能调度、T级防护三块,边缘加速的基础上具备充分的DDoS攻击检测以及智能调度的能力,决策什么时候进行高防去清洗,严重的攻击进入T级防护中心进行清洗。目前方案已经在金融行业、传媒行业沉淀了典型客户。 二、Web防护——八层安全功能,层层过滤恶意请求 Web防护的策略是通过层层过滤,来抵御恶意请求。第一层是精准访问控制,指具体对http请求的拦截策略;第二层是区域封禁,对业务无效区或者异常地域请求进行拦截;第三层IP信誉系统,是利用阿里云多年积累的互联网IP大数据画像,对恶意行为进行分类并对IP进行拦截;第四层是黑名单系统,是对某些UA或者IP进行拦截,以上四层都属于精确拦截;第五层是频次控制,对相对高频且访问异常IP进行拦截;第六层是对于互联网机器流量进行管理,阻断恶意爬虫;第七第八层是WAF和源站高级防护,对于源站进行更深层次的防护。 赵伟认为:CDN边缘节点是最接近互联网用户的,在所有的访问请求中,可能有正常用户的请求,当然也会存在爬虫、注入、跨站的访问请求,经过以上逐层的防护策略,过滤掉相应恶意请求,最终可以达到只有正常请求返回源站的效果。 三、机器流量管理——识别互联网Bot流量,阻断恶意爬虫 机器流量管理部署在边缘,当各种互联网访问进入CDN边缘节点之后,机器流量管理系统会提取最原始的Client信息,分析信息计算Client特征值,并与阿里云安全积累的机器流量特征库进行匹配,最终识别结果,正常访问、搜索引擎、商业爬虫这些行为是网站期望的行为,会被放行,而恶意爬虫会被拦截。在处置动作上,机器流量管理相比当前常见嵌入在正常页面中的行为,侵入性有所降低,支持相对平滑的接入。 下图是一个实际的案例,在执行机器流量管理策略的时候,首先会对某域名进行流量分析,左侧图是针对某域名开启机器流量分析后,识别出超过 82% 的请求为恶意爬虫,然后开启拦截机器流量中的恶意爬虫流量后,如右侧图所示,域名峰值带宽下降超过80%。 CDN目前已经是互联网流量的主要入口,把安全能力注入CDN边缘节点,为客户提供一站式安全加速解决方案成为行业大势所趋。在发布会的最后,赵伟分享到:未来,阿里云政企安全加速解决方案将在场景化、便捷化、智能化三个方面深耕,为客户提供更贴近需求的、更快捷省心的、更智能高效的安全策略,让CDN可以成为每个企业在线服务的第一道防线,来保障企业应用的安全、稳定运行。 点击回顾发布会详情 活动福利:2020年6月30日前,CDN加速10Mbps以内带宽免费试用1个月,30Gbps DDoS防护、高级版WAF试用1周,并赠送一次漏洞扫描服务,总名额限100个,先到先得。 点击填写表单参与活动 答疑钉钉群:34249460

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册