首页 文章 精选 留言 我的

精选列表

搜索[插件化],共10000篇文章
优秀的个人博客,低调大师

橙单中台化低代码生成器 v1.6 发布,可配置生成跨多库实时同步服务

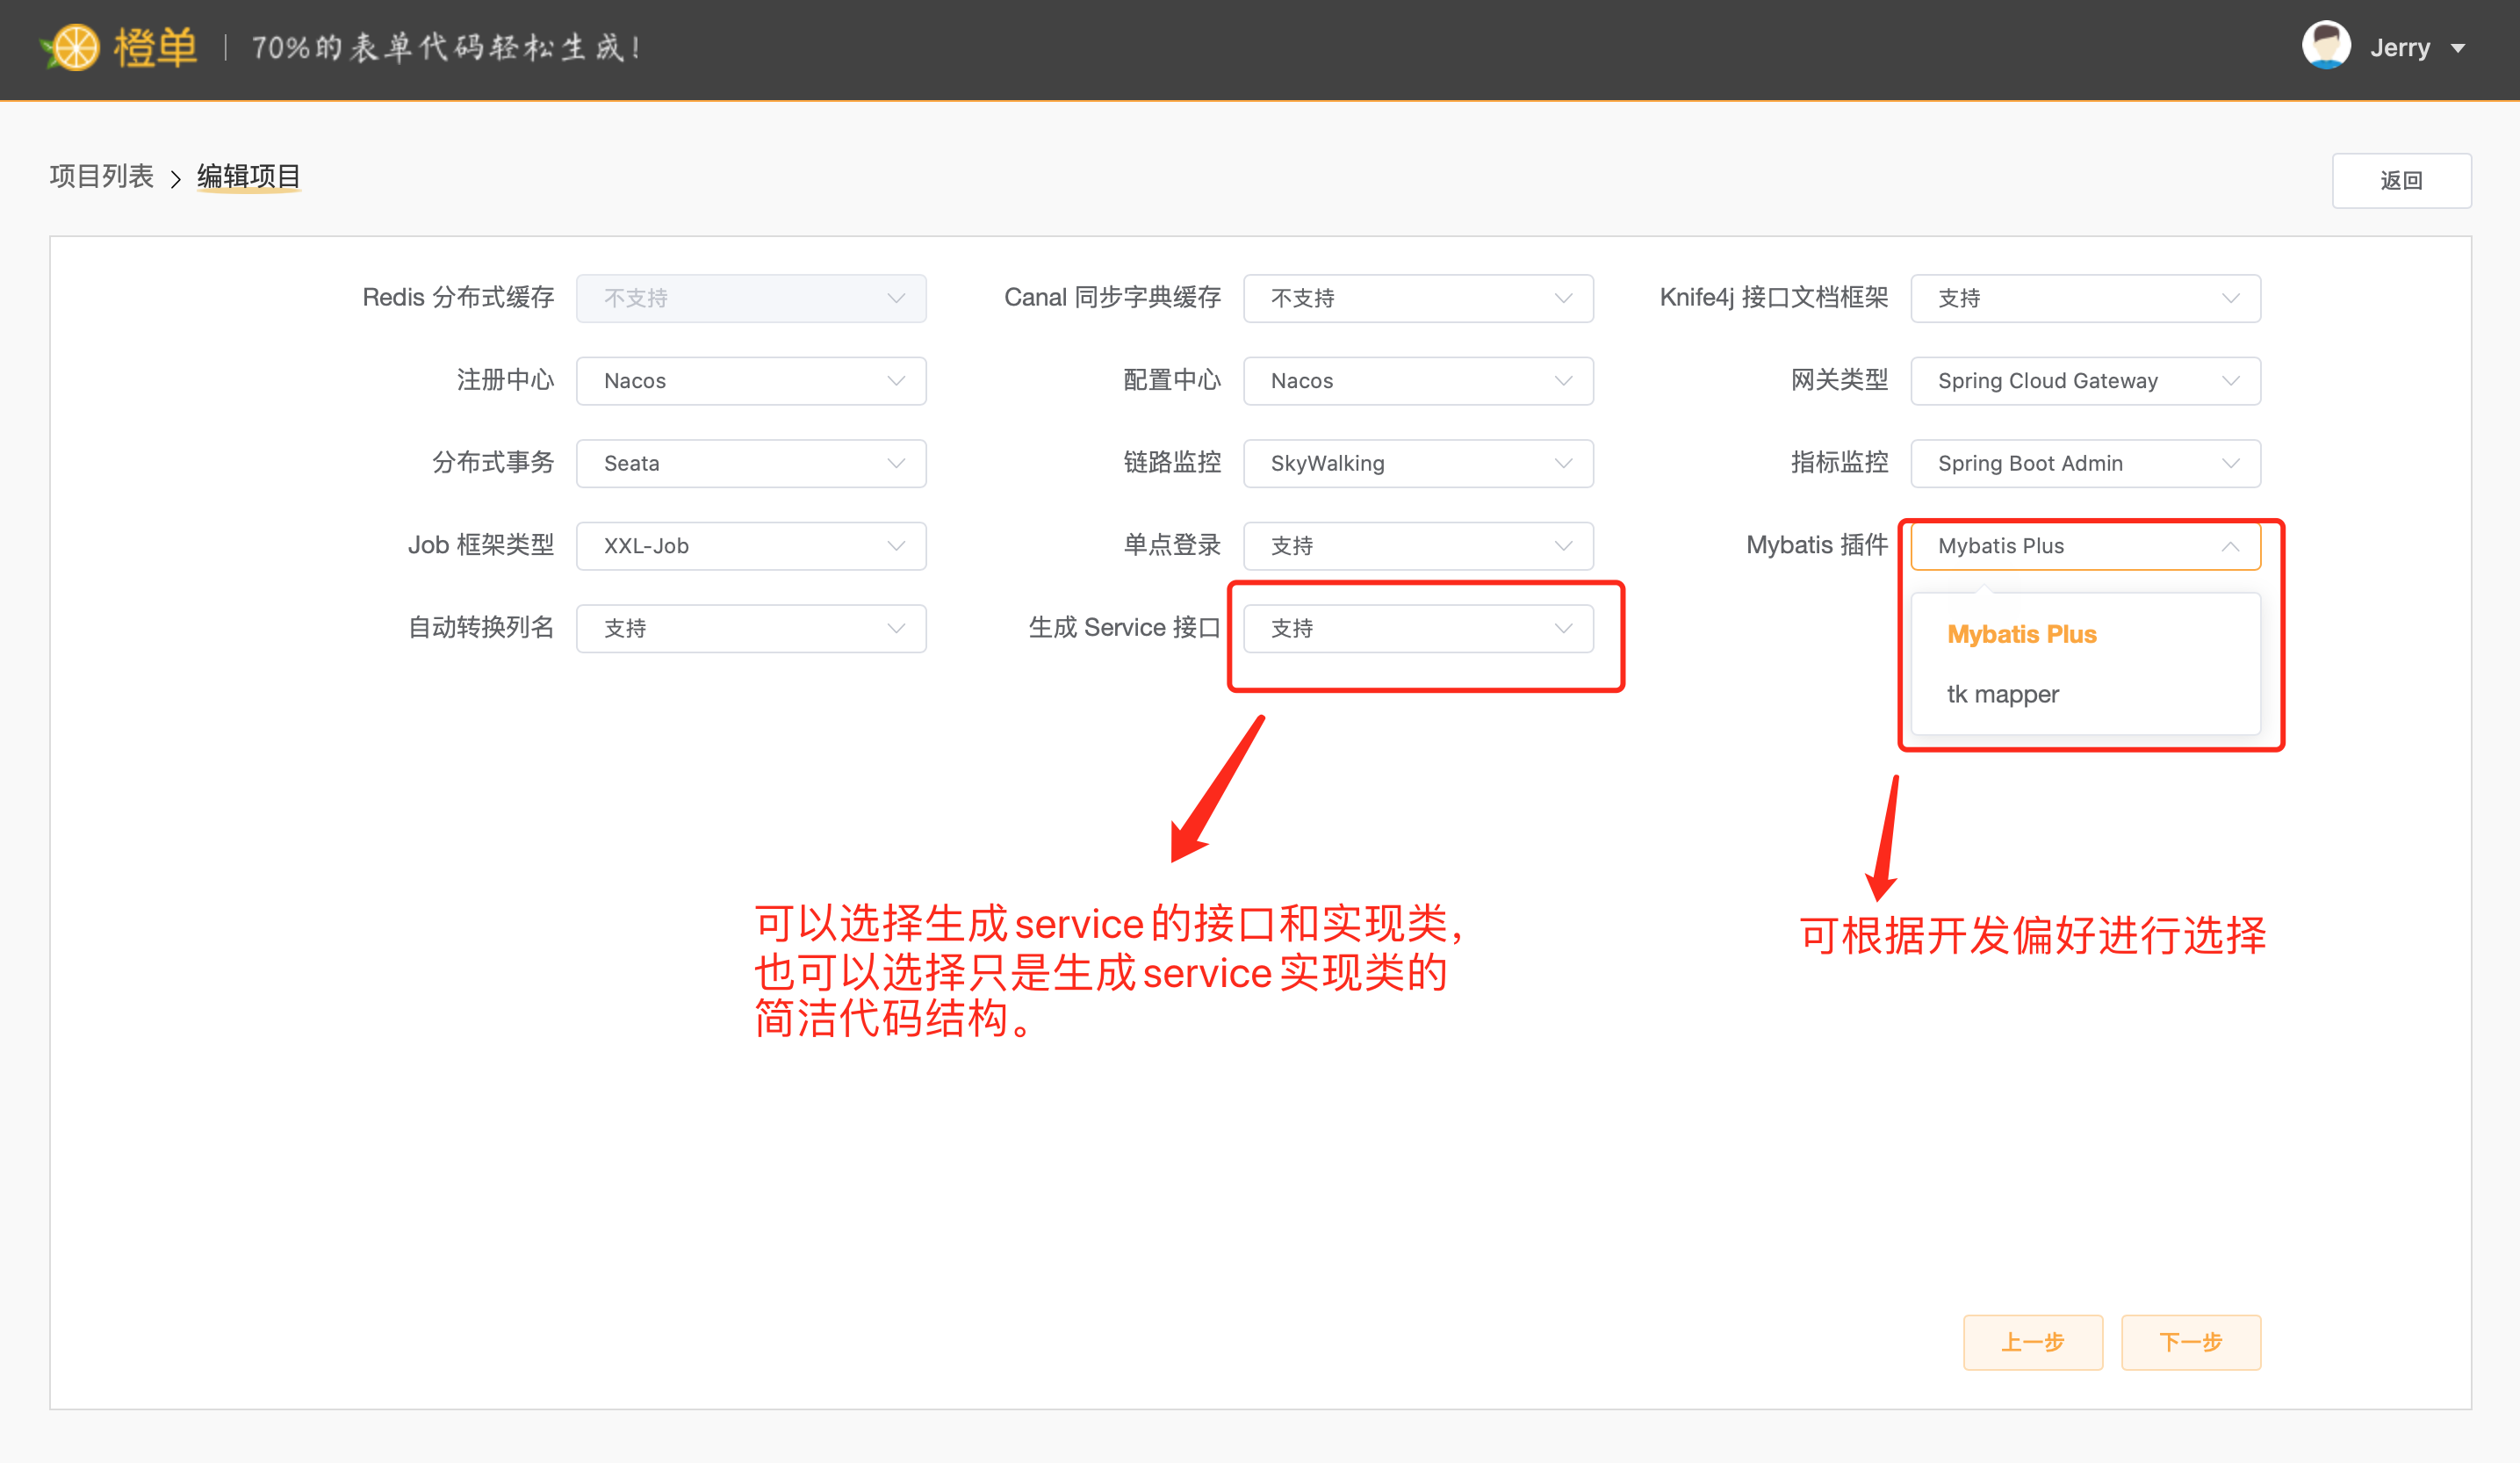
重要更新 基于 RocketMQ 消息的方式,实现多种策略的微服务间实时数据同步,如全表多库同步、冗余字段多表多库同步等。目前已支持,高可用、高可靠、高性能、幂等性和重放式顺序性等特征。文章末尾的截图,为该功能配置界面和生成后的相关代码 (强烈推荐放大看图)。 新功能 可根据实际业务需求,配置并生成自定义的数据同步服务 (基于 RocketMQ)。目前已支持最为常用的多库表完整数据实时操作同步。同时还支持跨库表部分冗余字段的实时更新同步 (如:根据关联 ID 同步更新冗余的 name 字段数据等)。 去除 Jedis 依赖,全部统一使用 Redisson 作为 Redis 访问客户端。统一后,仅通过修改配置即可完成 Redis 多种模式 (集群/哨兵/主从/单机) 的切换。 优化 SessionIdKey 的命名规范,在多租户系统中将包含租户Id信息,以便于租户管理员对在线用户会话进行查询。 支持操作日志和登录日志的收集、过滤和列表显示。 支持在线用户会话的查询和强制踢出。 多租户工程支持 uaa。 多对多中间表可通过配置生成一对一、一对多、数据字典等关联代码。 升级 apidoc-tools 工具,以支持最新的目录结构。该工具通过逆推 Java 工程代码的方式,生成 Postman 接口文档,无需任何注解,可作为 Swagger 的有益补充。 生成后的前端表单代码支持按分组目录存储。 修改说明 修复 Spring Cloud Gateway 日志过滤器日志输出错误的 Bug。 优化 Spring Cloud Gateway 处理登录应答数据的组包逻辑,减少内存 copy 次数,提升效率,同时修复返回中文乱码问题。 升级数据组装接口,新增 ignoreFields 参数,以使数据组装的过程控制,更加精确。 修复生成器中数据库表字段 (nullable) 属性变化,没用同步到上层服务表 (required) 属性的 Bug。 优化生成器修改字段属性时的处理流程,存在表单依赖时,可以准确定位具体字段是否正在被使用中。 有图有真相

优秀的个人博客,低调大师

看我用Python写一个自动化机器人消灭他!

序幕 微信群牛皮癣,指的是在微信群里毫无下限的群发小广告的用户,是微信群主最痛恨的一波人。如果熟悉早起的读者可以知道我有一个技术交流群,但是自从建群以来就饱受小广告的困扰。他们伪装成正常人混进群然后不停的发送广告轰炸,严重的打乱了群内的技术交流气氛👇或者是一声不吭的去骚扰每一个群成员👇虽然不清楚是什么能够驱使他们这样不折不扣的努力成为最强微信群牛皮癣(可能是钞能力),但在经历太多次的骚扰之后,我开始思考是否可以用Python消灭他们。 第一回合 其实一开始的思路很简单,总共分两步,首先成功识别出这些人再用Python将他们踢出去即可。 但是这两步,每一步都不简单,先来说说第一步如何准确的识别这些用户,网上没有数据也没有一个好的鉴别标准,只能用我的大脑完成特征识别。经过这几个月,近百份发广告用户的样本训练,我这个“人工智能”基本可以判断一个非正常用户至少满足下面几条中的三条以上: 没有设置 微信号 头像为网红女生 微信名为特殊符号或者表情 没发过 朋友圈 没有 朋友圈背景图 通过后不会有除进群申请外的其他回复 并且根据历史数据,符合1、3条的用户有极大概率为小广告爱好者,那么接下来要做的就是用Python写代码找出微信里面的这些人。在总结出这一规律后很乐观的认为实现这一需求并不困难,因为我在几年前就曾拿过Python研究微信好友,不论是wxpy还是itchat操作起来应该都不复杂,但是事实确证明我还是太年轻了 不知从何时起,虽然这些库还能安装使用但是微信基本已经禁止了大部分人的网页版微信登陆权限,因此当我使用多个微信号分别扫完登陆微信的二维码之后,无一例外的提示我 <error><ret>1203</ret><message>为了你的帐号安全,此微信号已不允许登录网页微信。你可以使用Windows微信或Mac微信在电脑端登录。</message></error> 这就让人头疼了,总不能手动的去一个一个check我的几千个微信好友吧,于是我开始思考是否有其他的解决办法。 第二回合 如果你经常写Python爬虫,那么你会知道在有些情况下,与其使用Requests对付一些恶心的反爬措施,不如Selenium操作起来方便。所以在发现想使用基于微信API的思路失效后,我将目光转向了相对笨一点的方法————pynput pynput是一款使用Python来控制和监控电脑鼠标、键盘的第三方库,说到这里你大概明白我想怎么做了,直接用API取数据搞不定,那么我就像Selenium一样,模拟点击一个一个好友来实现我想要的操作。 下面简单说一下这个库,因为没有太多依赖库所以安装起来很简单,直接pip install pynput即可,使用起来也很简单,对于鼠标操作只依赖坐标,看个demo👇 就像上面GIF演示的一样,先导入pynput并实例一个鼠标控制器,接着将微信在状态栏的位置提交给mouse.position,这样鼠标就会移动到该位置,再使用mouse.press来模拟鼠标点击即可自动打开微信。那么问题来了,如何获得我想要的位置的坐标?总不能一点一点试吧! pynput除了使可以使用Controller来控制鼠标,也可以监控鼠标,比如使用下面的代码就可以记录下程序启动后鼠标的每一个点击操作所在的位置👇 frompynputimportmousedefon_move(x,y):print('鼠标移动至{0}'.format((x,y)))defon_click(x,y,button,pressed):print('{0}在坐标{1}'.format('鼠标点击'ifpressedelse'鼠标释放',(x,y)))ifnotpressed:returnFalsewhileTrue:withmouse.Listener(on_move=on_move,on_click=on_click)aslistener:listener.join() 那么接下来的任务就简单了,我们只需要保持微信窗口不移动,在记录下每一个关键位置的坐标(微信图标位置,群聊窗口位置,单个群成员头像位置)之后,比如我们想对上面说的第一条规则进行判断即获取每一个群成员微信号是否设置,就可以按照模拟以下操作实现: 点击微信app 点击需要的群聊 依次点击每一个群成员头像 移动到微信号的位置 双击该微信号 复制该微信号判断是否为初始微信号 在上面的过程中,值得说的是最后一步,复制我们可以使用pynput中的键盘控制器,在双击选中对应微信号之后通过下面的代码实现模拟键盘输入Command + C完成复制操作 frompynput.keyboardimportKeyfrompynput.keyboardimportControllerasController1keyboard=Controller1()withkeyboard.pressed(Key.cmd):keyboard.press('c')keyboard.release('c') 但是粘贴则不需要使用pynput通过模拟command+c来粘贴到另一个编辑中复杂过程,我们可以使用第三方库pyperclip,直接通过下面两行代码即可将复制好的文字转为字符串 importpyperclippyperclip.paste() 在将群成员的微信号转换为字符串后,不论我们是通过判断字符串的长度还是用正则表达式或者是其他的方法都可以轻松的判断该成员的微信号是否为初始微信号,实现规则1的判断,下面的代码与动态图就是获取第一个群成员微信号的完整过程 frompynput.mouseimportButton,Controllerimporttimefrompynput.keyboardimportKeyfrompynput.keyboardimportControllerasController1importpyperclipmouse=Controller()#点击微信mouse.position=(1046.14453125,4.546875)time.sleep(2)mouse.press(Button.left)mouse.release(Button.left)#点击头像mouse.position=(1194.140625,441.05859375)time.sleep(1)mouse.press(Button.left)mouse.release(Button.left)#点击选中文本mouse.position=(965.60546875,284.0390625)time.sleep(1)mouse.click(Button.left,2)keyboard=Controller1()withkeyboard.pressed(Key.cmd):keyboard.press('c')keyboard.release('c')time.sleep(1)wechatid=pyperclip.paste()print(f"微信号{wechatid}疑似广告号"iflen(wechatid)>20elsef"微信号{wechatid}不是广告号") 可以看到成功将早小起的微信从广告号中排除那么接下来只需要记录下每两个群成员之间间隔的坐标距离,之后循环去模拟滚动或者下拉来实现上述过程,就可以将群里所有成员的微信号根据规则1进行判断,找到异常的那些成员单独进行判断。可以看到最终是找到了6个疑似广告号的微信,接下来通过其他规则的手动判断最终将两个用户判定为广告高风险用户并移除。 写在最后 通过上面的操作,虽然成功的踢出了两个疑似广告号,但总体来说还是败了。因为依旧很难去判断是否真的踢对了人,如果踢错了,那么则粉丝-1,同时也可以发现想用Python准确找到群里的牛皮癣还是非常困难的,使用pynput最多可以完成微信名、微信号及头像(使用识图API)的判断,但是朋友圈隐藏的更多信息却很难提取挖掘。 同时pynput有着和selenium同样的缺点,那就是由于模拟真人操作而导致的速度慢,并且它的定位方式仅支持坐标,所以还需要保证在操作的过程中微信窗口不可以被移动,否则之前记录的元素将全部失效,此处建议开发者可以升级更多的定位方式。 如果你有好的思路可以在留言区和我交流,如果你想看更详细的pynput讲解,不要忘记给个三连。如果你对本文的代码感兴趣,可以在后台回复0909获取。 今天的文章就到这里,为了维护良好的群内交流环境,对抗小广告的路还在继续,如果你也想进群可以在后台回复进群,拜拜~ 本文分享自微信公众号 - 早起Python(zaoqi-python)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

java B2B2C电子商务平台分析之九--配置中心服务化和高可用

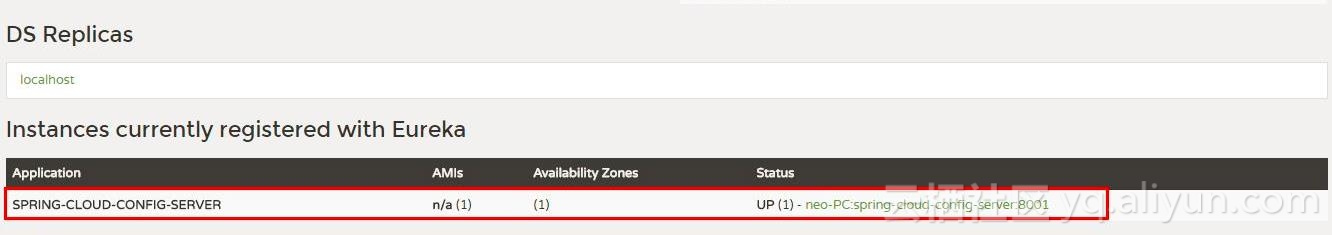
在前两篇的介绍中,客户端都是直接调用配置中心的server端来获取配置文件信息。这样就存在了一个问题,客户端和服务端的耦合性太高,如果server端要做集群,客户端只能通过原始的方式来路由,server端改变IP地址的时候,客户端也需要修改配置,不符合springcloud服务治理的理念。springcloud提供了这样的解决方案,我们只需要将server端当做一个服务注册到eureka中,client端去eureka中去获取配置中心server端的服务既可。愿意了解源码的朋友直接求求交流分享技术:二一四七七七五六三三 server端改造1、添加依赖 <dependencies> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-config-server</artifactId> </dependency> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-eureka</artifactId> </dependency> </dependencies> 需要多引入spring-cloud-starter-eureka包,来添加对eureka的支持。 2、配置文件 server: server: port: 8001 spring: application: name: spring-cloud-config-server cloud: config: server: git: uri: https://github.com/ityouknow/spring-cloud-starter/ # 配置git仓库的地址 search-paths: config-repo # git仓库地址下的相对地址,可以配置多个,用,分割。 username: username # git仓库的账号 password: password # git仓库的密码 eureka: client: serviceUrl: defaultZone: http://localhost:8000/eureka/ ## 注册中心eurka地址 增加了eureka注册中心的配置 3、启动类启动类添加@EnableDiscoveryClient激活对配置中心的支持 @EnableDiscoveryClient @EnableConfigServer @SpringBootApplication public class ConfigServerApplication { public static void main(String[] args) { SpringApplication.run(ConfigServerApplication.class, args); } } 这样server端的改造就完成了。先启动eureka注册中心,在启动server端,在浏览器中访问:http://localhost:8000/就会看到server端已经注册了到注册中心了。 按照上篇的测试步骤对server端进行测试服务正常。 客户端改造1、添加依赖 <dependencies> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-config</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-eureka</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> </dependency> </dependencies> 需要多引入spring-cloud-starter-eureka包,来添加对eureka的支持。 2、配置文件 spring.application.name=spring-cloud-config-client server.port=8002 spring.cloud.config.name=neo-config spring.cloud.config.profile=dev spring.cloud.config.label=master spring.cloud.config.discovery.enabled=true spring.cloud.config.discovery.serviceId=spring-cloud-config-server eureka.client.serviceUrl.defaultZone=http://localhost:8000/eureka/ 主要是去掉了spring.cloud.config.uri直接指向server端地址的配置,增加了最后的三个配置: spring.cloud.config.discovery.enabled:开启Config服务发现支持spring.cloud.config.discovery.serviceId:指定server端的name,也就是server端spring.application.name的值eureka.client.serviceUrl.defaultZone:指向配置中心的地址这三个配置文件都需要放到bootstrap.properties的配置中 3、启动类启动类添加@EnableDiscoveryClient激活对配置中心的支持 @EnableDiscoveryClient @SpringBootApplication public class ConfigClientApplication { public static void main(String[] args) { SpringApplication.run(ConfigClientApplication.class, args); } } 启动client端,在浏览器中访问:http://localhost:8000/就会看到server端和client端都已经注册了到注册中心了。 高可用为了模拟生产集群环境,我们改动server端的端口为8003,再启动一个server端来做服务的负载,提供高可用的server端支持。 如上图就可发现会有两个server端同时提供配置中心的服务,防止某一台down掉之后影响整个系统的使用。 我们先单独测试服务端,分别访问:http://localhost:8001/neo-config/dev、http://localhost:8003/neo-config/dev返回信息: { "name": "neo-config", "profiles": [ "dev" ], "label": null, "version": null, "state": null, "propertySources": [ { "name": "https://github.com/ityouknow/spring-cloud-starter/config-repo/neo-config-dev.properties", "source": { "neo.hello": "hello im dev" } } ] } 说明两个server端都正常读取到了配置信息。 再次访问:http://localhost:8002/hello, 返回:hello im dev update。说明客户端已经读取到了server端的内容,我们随机停掉一台server端的服务,再次访问http://localhost:8002/hello, 返回:hello im dev update,说明达到了高可用的目的。 整体代码结构如下: 资料和源码来源

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册