智能仓储 WMS 前端系统 | 从 WMS 到 ERP 的数据同步:前端状态一致性保障
# 引言 WMS 与 ERP 之间,从来不是"同步一下"那么简单。ERP 是系统的记录源(System of Record),库存、成本、账务以它为准;WMS 是执行系统,实时追踪每一托、每一箱、每一次移动。两者的时间尺度差着量级——ERP 可能按天关账,WMS 按秒变。于是前端永远面对一个尴尬局面:**WMS 显示"刚出库 200 件",ERP 还显示"在库",页面该信谁?** 本文不讲后端怎么同步,只讲前端这一侧:如何判断"我手上的数据还是不是真的"、乐观更新的回滚怎么不丢用户的改动、离线期间产生的操作怎么在恢复后不冲突、以及 CRDT 如何在多人同时盘点这种极端场景下真正避免覆盖。 --- # 一、先统一心智模型:三个时间戳 前端一致性的全部难题,都源于"同一份数据有多个版本、且生成时间不同"。解决它的第一步是给每个业务对象打上三个时间戳,而不是一个。 ```javascript // src/sync/clock.js export function createVersionedRecord(base = {}) { return { ...base, // 三个时间戳是这套模型的全部基石 version: base.version || 0, // 单调版本号,由服务端分配,全局唯一 updatedAt: base.updatedAt || Date.now(), // 服务端权威时间,用于时序比较 clientTime: base.clientTime || Date.now(), // 客户端墙钟,仅用于离线期间排序 origin: base.origin || 'wms', // 'wms' | 'erp' | 'client' actor: base.actor || null, // 操作人,用于冲突归因 }; } export function isNewer(a, b) { // 第一判据:服务端版本号(权威) if (a.version !== b.version) return a.version > b.version; // 第二判据:服务端时间(跨设备一致) if (a.updatedAt !== b.updatedAt) return a.updatedAt > b.updatedAt; // 第三判据:客户端时间(仅离线期间有意义) return a.clientTime > b.clientTime; } ``` 逐段解读: - `version`** 是权威**。它由服务端单调分配,跨设备、跨时区都可比。两个客户端各自改了同一份数据,谁先被服务端接受,谁的 `version` 就更大。这是唯一可靠的"谁赢了"依据。 - `updatedAt`** 是第二判据**。为什么需要它?因为乐观更新时客户端还没拿到服务端版本号。同时 `Date.now()` 在设备上不可信——有人调过系统时间,或者设备时钟快了三小时,仅靠墙钟排序会一团糟。服务端时间由 NTP 校准,是可靠的全局时钟。 - `clientTime`** 是第三判据,只在离线期间有意义**。两个离线操作发生在同一台设备,顺序由它决定。一旦到达服务端,就以 `version` 为准。 - `origin`** 标记数据来源**。这是回答"该信谁"的关键字段——ERP 来的数据标记为 `erp`,它在某些字段上是权威的(如标准成本、物料主数据)。 - `isNewer` 的比较顺序不可颠倒。版本号第一、服务端时间第二、客户端时间第三,这个优先级是整套一致性模型的全部逻辑。 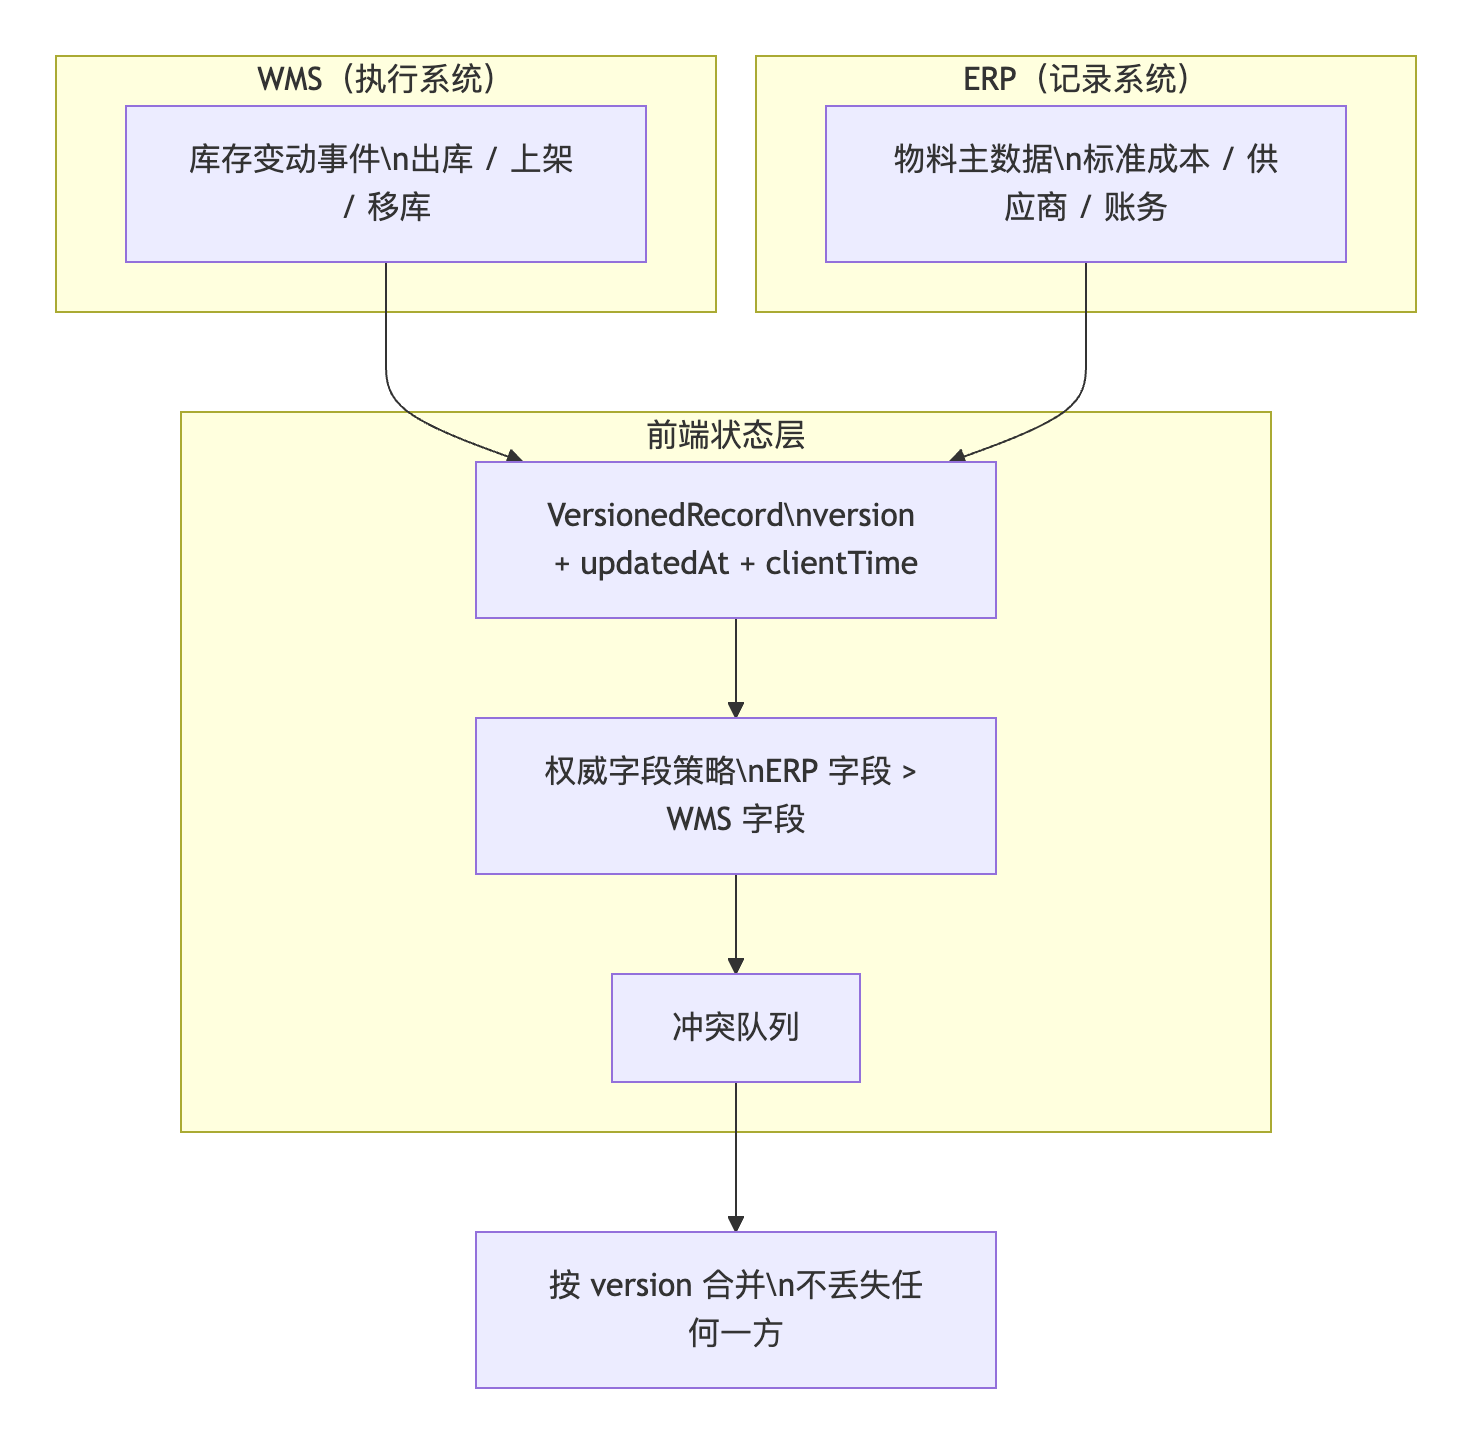 --- # 二、权威源策略:不是"谁新信谁",而是"谁该管这个字段" 最容易犯的错是把同步做成简单的"后写覆盖先写"。这会出问题:WMS 刚把实际库存改成 800,ERP 因为网络延迟推送了一条旧快照说"还是 1000",如果按时间覆盖,WMS 辛苦维护的实时数据就被一个迟到消息抹掉了。 ```javascript // src/sync/authority.js // 字段级权威源:同一份记录里,不同字段由不同系统说了算 export const AUTHORITY = { 'stock.onHand': 'wms', // 实际在库量:WMS 权威(实时) 'stock.allocated': 'wms', // 已分配量:WMS 权威 'stock.available': 'wms', // 可用量:由 WMS 计算 'stock.standardCost': 'erp', // 标准成本:ERP 权威(财务) 'sku.description': 'erp', // 物料描述:ERP 权威 'sku.supplier': 'erp', // 供应商:ERP 权威 'location.code': 'wms', // 库位编码:WMS 权威 'location.lockReason':'wms', // 锁定原因:WMS 权威 'batch.expiryDate': 'erp', // 批次有效期:ERP 权威 }; export function mergeByAuthority(local, remote) { const next = { ...local }; for (const [key, remoteVal] of Object.entries(flatten(remote))) { const authority = AUTHORITY[key] || 'wms'; const source = remote.origin || 'wms'; if (authority === source) { // 来源即权威源:覆盖(前提是版本更新,见下方) if (isNewer(remote, local)) setPath(next, key, remoteVal); } // 来源不是权威源:丢弃,保留本地值 } next.version = Math.max(local.version, remote.version); return next; } function flatten(obj, prefix = '', out = {}) { for (const [k, v] of Object.entries(obj)) { const path = prefix ? `${prefix}.${k}` : k; if (v && typeof v === 'object' && !Array.isArray(v)) flatten(v, path, out); else out[path] = v; } return out; } function setPath(obj, path, value) { const keys = path.split('.'); const last = keys.pop(); let cur = obj; for (const k of keys) cur = cur[k] = cur[k] || {}; cur[last] = value; } ``` 逐段解读: - **字段级权威源,不是文档级**。这是全文最重要的一点。同一份库存记录里,实际数量由 WMS 管,标准成本由 ERP 管,有效期由 ERP 管。用一个"全局权威源"必然互相踩踏。 - `AUTHORITY` 表是**业务规则**,不是技术配置。它该由供应链与财务共同确认并写在文档里,前端只负责执行。改这张表要慎重——它决定了系统之间谁说了算。 - `authority === source` 的判断让迟到的 ERP 快照不会覆盖 WMS 的实时库存:ERP 推送的 `stock.onHand` 不是它的权威字段,前端直接丢弃。 - `isNewer` 仍要做版本校验,防止乱序消息。即使来源是权威源,一条陈旧消息也不该覆盖新数据。 - `version` 取 `max` 而不是用 remote 的。合并后的记录要保留最大版本号,否则会被后续以"版本更旧"为由拒绝。 --- # 三、乐观更新与回滚:敢先改,也要敢撤回 乐观更新是体验的核心——用户点了"确认拣货",界面立刻响应,不用等网络。但它带来一个问题:**如果服务端拒绝了,怎么回到原来的样子,同时不丢掉用户在这期间的其他改动?** ```javascript // src/sync/store.js import { create } from 'zustand'; import { createVersionedRecord, isNewer } from './clock'; export const useSyncStore = create((set, get) => ({ entities: new Map(), // 唯一可信源:业务对象 by id inflight: new Map(), // 进行中的变更:id → { base, patches, undo } conflicts: [], applyLocal(id, patches) { set((state) => { const cur = state.entities.get(id) || createVersionedRecord({ id }); const base = clone(cur); // 乐观更新:立即应用,同时记录 base 用于回滚 const optimistic = { ...cur, ...patches, clientTime: Date.now(), _pending: true }; const next = new Map(state.entities); next.set(id, optimistic); const inflight = new Map(state.inflight); inflight.set(id, { base, patches, undo: () => base }); return { entities: next, inflight }; }); }, // 服务端确认:用服务端版本号替换乐观版本,清除 pending confirm(id, serverRecord) { set((state) => { const next = new Map(state.entities); next.set(id, { ...serverRecord, _pending: false }); const inflight = new Map(state.inflight); inflight.delete(id); return { entities: next, inflight }; }); }, // 服务端拒绝:回滚到 base,并保留其他并发改动的 patches reject(id, reason) { set((state) => { const tx = state.inflight.get(id); if (!tx) return state; const next = new Map(state.entities); next.set(id, { ...tx.base, _pending: false, _lastError: reason }); const inflight = new Map(state.inflight); inflight.delete(id); return { entities: next, inflight }; }); }, // 接收服务端推送:仅在更新时才重渲染 receive(serverRecord) { set((state) => { const cur = state.entities.get(serverRecord.id); // 比本地还旧:忽略(防乱序) if (cur && !isNewer(serverRecord, cur)) return state; // 本地有未提交改动:进入冲突队列,不直接覆盖 if (cur?._pending) { return { conflicts: [...state.conflicts, { id: serverRecord.id, remote: serverRecord, local: cur }] }; } const next = new Map(state.entities); next.set(serverRecord.id, { ...serverRecord, _pending: false }); return { entities: next }; }); }, })); ``` 逐段解读: - `_pending`** 标志是乐观更新的视觉信号**。带这个标志的行显示"同步中"弱态,让用户感知到网络状态,也阻止他连续点击造成重复提交。 - `base` 快照让回滚精确。它不是"全量恢复",而是回到这个操作之前的状态——用户同时做的其他改动不会因此丢失。 - `reject` 时把 `reason` 存进记录。前端据此显示可读错误("库存不足""库位已被锁定"),而不是吐一个错误码。 - `receive` 里的**防乱序**是关键:服务端推送如果版本更旧,直接丢弃。网络分区后重连时服务端可能一次性补推一批历史消息,顺序不保证,这个判断防止旧数据覆盖新数据。 - **有 pending 改动时推来的更新进入冲突队列,不直接覆盖**。这是最容易被漏掉的场景——用户正在改,服务端也推了个新版本,谁覆盖谁都不对,必须进队列等用户决定。  --- # 四、离线队列:幂等键是灵魂 仓库里断网是常态,不是异常。离线期间产生的操作必须被记录、有序、且能安全地重放——**重放不能产生副作用**。 ```javascript // src/sync/outbox.js const DB_KEY = '@wms/outbox'; const IDEMPOTENCY_KEY_HEADER = 'Idempotency-Key'; export async function enqueue(operation) { const op = { id: crypto.randomUUID(), idempotencyKey: `wms-${operation.type}-${operation.entityId}-${operation.clientTime}`, type: operation.type, // 'pick.confirm' | 'stock.adjust' | 'location.transfer' entityId: operation.entityId, payload: operation.payload, createdAt: Date.now(), attempts: 0, status: 'queued', }; const box = await load(); box.push(op); await persist(box); return op; } export async function flushOutbox() { const box = await load(); for (const op of box) { if (op.status === 'done' || op.status === 'failed') continue; op.attempts++; try { const res = await fetch(`/api/wms/${op.type}`, { method: 'POST', headers: { 'Content-Type': 'application/json', [IDEMPOTENCY_KEY_HEADER]: op.idempotencyKey, }, body: JSON.stringify({ ...op.payload, clientTime: op.createdAt, version: op.version }), }); if (res.status === 409) { // 冲突:服务端有更新版本,转入冲突解决流程 op.status = 'conflict'; continue; } if (!res.ok) throw new Error(`HTTP ${res.status}`); op.status = 'done'; op.response = await res.json(); } catch (e) { if (op.attempts >= 5) op.status = 'failed'; } } await persist(box); } function load() { /* 从 localStorage / AsyncStorage 读取 */ } function persist(box) { /* 写入持久化存储 */ } ``` 逐段解读: - **幂等键的构造决定了它能否防重**。格式是 `wms-{type}-{entityId}-{clientTime}`——同一台设备对同一实体、同一时刻的同一操作,幂等键必然相同。服务端用它去重,即使网络重试也不会被处理两次。 - `crypto.randomUUID()` 生成 `id`,`idempotencyKey` 由业务字段派生。两者分工:前者是本地记录的唯一标识,后者是服务端的去重依据。 - `409 Conflict`** 单独处理**。它意味着服务端有更新版本,不是网络错误,重试只会一直 409。必须转入冲突解决流程。 - `attempts >= 5` 上限防止死循环。失败操作留在队列会阻塞后续操作、占用存储。 - **持久化存储必须用异步 API 串行写**。`localStorage.setItem` 同步且会阻塞主线程,离线期间频繁入队会卡顿;PDA 上更该用异步存储并加写入队列。  --- # 五、CRDT:多人同时改同一字段怎么办 上面的方案在"一个实体一个最后写入者"的假设下工作良好。但仓库里有真正的并发冲突:**两个盘点员同时对同一排货架盘点**,ERP 和 WMS 同时推同一字段的不同值。最后写入者获胜(LWW)在这里会**丢失数据**。 ```javascript // src/sync/gcounter.js // G-Counter(增长计数器):支持多节点并发自增,可交换、可结合,永不冲突 export function createGCounter(nodeId) { const counts = new Map(); // nodeId -> 正整数 counts.set(nodeId, 0); return { increment() { counts.set(nodeId, (counts.get(nodeId) || 0) + 1); return this.value(); }, value() { let sum = 0; for (const v of counts.values()) sum += v; return sum; }, merge(other) { for (const [node, val] of other.counts) { const cur = counts.get(node) || 0; counts.set(node, Math.max(cur, val)); // 逐节点取最大值,可交换 } return this; }, serialize() { return { type: 'gcounter', nodeId, counts: [...counts.entries()] }; }, }; } // PN-Counter:可增可减的计数器,用两个 G-Counter 实现 export function createPNCounter(nodeId) { const p = createGCounter(nodeId); // 增量 const n = createGCounter(nodeId); // 减量 return { increment() { p.increment(); }, decrement() { n.increment(); }, value() { return p.value() - n.value(); }, merge(other) { p.merge(other.p); n.merge(other.n); }, }; } ``` 逐段解读: - **CRDT 的核心特性是可交换性(commutative)**。A 先合并 B,还是 B 先合并 A,结果一样。这就让网络分区、消息乱序、重复推送都不成问题——因为顺序不影响最终结果。 - **G-Counter 只能增不能减**,但它解决了盘点场景的关键需求:两个盘点员各报一个数,系统要**合并而不是覆盖**。`merge` 逐节点取最大值,两人的计数都保留。 - **PN-Counter = P 增 + N 减**。库存有进有出,需要它。值是 `P - N`,合并时两个 G-Counter 各自 merge。 - 实际生产中的 CRDT 库(如 Yjs、Automerge)远比这复杂,但**思路完全一致**:数据结构保证合并语义正确,不需要锁、不需要协商、不需要"谁先谁后"。 - 盘点场景真正需要的往往是 `Max-Value` 语义(取最新盘点数)或 `Multi-Value` 语义(保留所有读数待人工确认),CRDT 家族有不同的实现应对。 --- # 六、UI 一致性:让用户看见"状态" 一致性不是只有代码层面的事。用户必须知道当前是同步态、离线态还是冲突态,否则他会在断网时以为操作已经生效,造成真实业务损失。 ```javascript // src/sync/StatusBadge.jsx import React from 'react'; import { useSyncStore } from './store'; export function StatusBadge({ entityId }) { const record = useSyncStore((s) => s.entities.get(entityId)); const online = useOnlineStatus(); if (!online) return 离线 · 操作已暂存; if (record?._pending) return 同步中…; if (record?._lastError) return 同步失败 · 点击重试; if (record?._conflict) return 有冲突 · 需处理; return 已同步; } function Badge({ tone, children }) { return {children}; } ``` - **离线状态要提前感知**。`navigator.onLine` 只能告诉你有没有网络接口,不能告诉你 API 能不能通。更可靠的是基于最近几次请求的成功率推断,或靠 WebSocket 的 `readyState`。 - **四种状态必须有视觉区分**。离线、同步中、失败、冲突,含义完全不同,处理方式也不同。混成一个"加载中"会让用户无从判断。 - `role="status"` 让读屏用户能感知状态变化。  --- # 七、可观测性:一致性问题必须能查 数据不一致是最难排查的 Bug——它不报错,只是数字不对。必须能追溯每一次状态变更。 - **每个状态变更记录来源、版本、时间戳、操作者**。出问题时能重放"这份数据是怎么变成这样的"。 - **监控版本倒退事件**。前端发现 `updatedAt` 倒退了,说明有系统在以陈旧数据覆盖新数据,这是集成故障的信号,必须告警而不是默默接受。 - **监控冲突率**。冲突率突然升高,往往意味着同步链路出了问题(如 ERP 批量回写、时区错乱)。 - **网络抖动时用指数退避重连**,但**业务操作的重试必须是幂等的**。不带幂等键的重试会把一个"确认拣货"变成两个。 --- # 结语 本文交付了一套从字段级权威源到 CRDT 的 WMS-ERP 前端一致性方案。五条核心结论: **第一,权威源是字段级的,不是文档级的。** 实际库存归 WMS、标准成本归 ERP、有效期归 ERP。用一个"全局权威源"必然互相踩踏,字段级策略是这套模型的全部前提。 **第二,乐观更新要敢改也要敢撤。** 记录 `base` 快照用于精确回滚,保留 `_pending` 作为视觉信号,拒绝时把可读错误存回记录。收到推送时若本地有未提交改动,进入冲突队列而不是直接覆盖。 **第三,离线队列的灵魂是幂等键。** 键由 `{type}-{entityId}-{clientTime}` 派生,服务端据此去重;`409` 单独处理转入冲突流程,重试只针对网络错误。 **第四,LWW 会丢失并发改动。** 两个盘点员同时盘点同一排货架时,必须按场景选 CRDT(计数器/集合)而非最后写入者获胜。CRDT 的可交换性让消息乱序、重复推送都不再是问题。 **第五,状态必须可见。** 离线、同步中、失败、冲突四种状态各有含义,要有视觉区分和读屏支持;版本倒退与冲突率要可监控。