首页 文章 精选 留言 我的

精选列表

搜索[云硬盘],共10000篇文章
优秀的个人博客,低调大师

基于 prefetch 的 H5 离线包方案 | 京东云技术团队

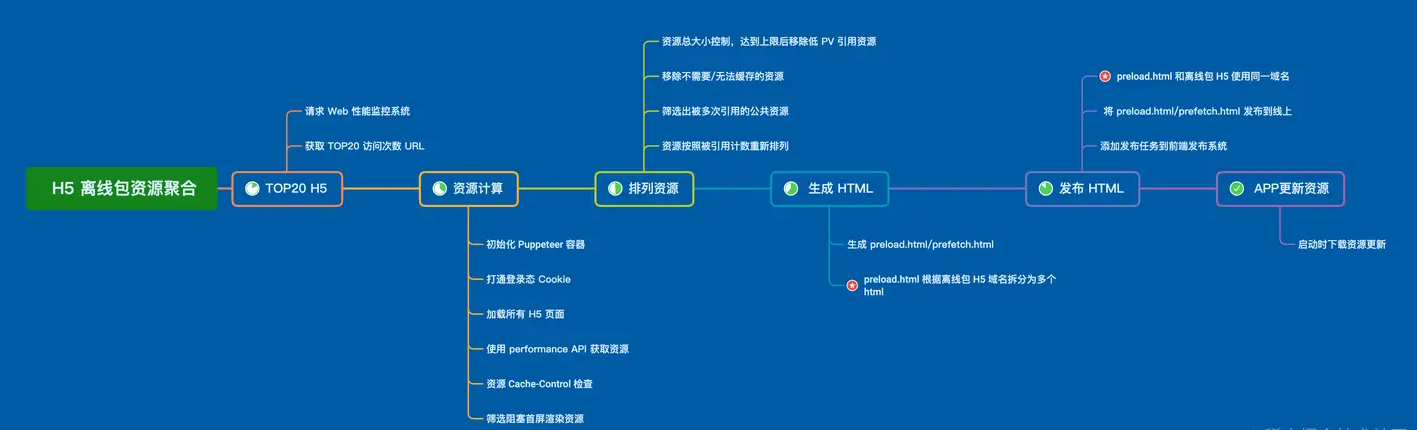
前言 对于电商APP来讲,使用H5技术开发的页面占比很高。由于H5加载速度非常依赖网络环境,所以为了提高用户体验,针对H5加载速度的优化非常重要。离线包是最常用的优化技术,通过提前下载H5渲染需要的HTML/JS/CSS资源,加载时直接使用本地缓存资源避免额外的网络请求提高加载速度。本文主要是介绍团队在离线包技术方案上的探索,以及基于prefetch的离线包实现方案如何减少维护成本和开发成本。 现有方案 离线包技术发展到现在已经比较成熟。离线包技术主要是分为两部分,一部分是客户端离线包容器,另一部分是线上离线包平台。 离线包容器 • 资源请求拦截 - 拦截H5资源请求,当存在本地缓存资源时直接返回使用 • 资源缓存 - 资源下载、资源缓存策略、增量更新策略 离线包平台 • 资源管理 - 配置H5页面对应的离线资源、公共离线资源、CDN存放离线资源包 • 发布系统 - 实时发布、灰度能力、版本控制 下面先介绍一下常见的技术实现方式: 资源请求拦截方式 Android Android实现相对比较统一,主要是通过WebView自带的shouldInterceptRequestAPI 拦截资源请求,返回对应的离线资源即可实现离线包功能。 iOS iOS由于苹果的限制,实现方式相对复杂很多。 NSURLProtocol 方案 使用NSURLProtocol拦截所有WebView内发出的请求。 方案存在的问题 Body丢失 因为WKWebView本身是使用多进程模式,WebView资源网络请求并不在APP进程中。iOS系统目前的实现,当拦截HTTP网络请求时会丢失Body,所以需要处理Body丢失的问题。一种方式是替换掉WebView内部的网络 API,例如Fetch/XMLHttpRequest,但是并不能覆盖所有场景。另一种方式是网络请求走原生API桥接的方式,但是这需要H5进行适配有一定的侵入性。 使用私有API WKWebView本身并不支持网络请求拦截,当我们需要拦截网络请求时,需要使用系统私有API通过ObjC Runtime的方式动态调用。存在一定的审核风险,例如Apple审核时不允许使用被拒。另外因为并不是系统暴露出的 API,内部实现未来可能会改变。 WKURLSchemeHandler 方案 WKURLSchemeHandler是iOS11引入的新特性,可以通过此 API 来拦截H5的网络请求。 方案存在的问题 不支持HTTP/HTTPS协议 • 不支持HTTP/HTTPS协议 - 因为WKURLSchemeHandlerAPI 本身的设计,只能拦截自定义协议并不支持HTTP/HTTPS协议。一种方式是原生加载H5时使用自定义协议或H5内资源使用自定义协议。另一种方式是hook系统方法支持HTTP/HTTPS协议,但是这会带来一定的风险和不确定性。 Cookie 问题 WKURLSchemeHandler不会处理响应里的Set-Cookie,所以需要自行处理。 Body丢失问题 此方案同样存在Body丢失问题。 Local Server 方案 Local Server方式是通过在APP运行时启动一个本地服务器,请求H5时访问本地服务器,本地服务器检查是否可以使用本地离线资源。 方案存在的问题 虚拟链接 • 虚拟链接 - 因为需要使用虚拟链接访问本地服务器,所以会带来cookie同步等问题需要解决 资源消耗 • 本地服务器有额外的内存、CPU消耗 PWA 方案 PWA提供了一整套Service Worker API来实现离线H5能力,包括资源的下载、更新、缓存策略等。只不过iOS系统本身没有提供默认的实现,需要自实现一整套相关的 Service Worker API,复杂度和工作量比较高。 离线包管理平台 增量更新策略 因为一个H5页面的离线包资源通常是聚合到一个ZIP压缩包中进行下载,为了避免只更新了部分资源导致全量下载,所以需要提供差异化更新能力,只需要下载变更的资源。 prefetch方案介绍 设计目标 分析了目前业界常用的离线包方案后,我们针对离线包的设计目标做了一轮梳理。一部分是前端团队的诉求,一部分也是我们期望实现的目标: 低侵入性 • H5低侵入 - 接入离线包无需做额外适配,尽可能对于前端做到无感知。一方面可以减少前端适配成本和代码复杂度,另一方面也有利于我们更好去推动覆盖更多的 H5 网页 • 原生无侵入 - 不需要使用特定的WebView容器 低维护成本 因为离线包涉及到资源的提前下载,所以需要提前配置好需要使用的资源URL用于下载。现有方案通常需要一个平台去管理这些资源,针对每一个需要使用离线包能力的H5页面,配置相关的静态资源文件URL列表。但是会带来一个问题就是每次更新都需要人工去维护整个静态资源URL列表,我们希望尽可能避免人工去维护 个人看法:这里更好的方式是离线包系统和前端发布系统打通,发布时自动更新静态资源列表到离线包资源管理系统。 低运行时消耗 • 低网络消耗 - 只下载必要的资源,避免无用资源下载,重复资源下载。 • 低CPU/内存 - 尽可能少的内存和CPU消耗,当不使用时做到零负荷 实现复杂度低 • 后台管理系统 - 由于人力的问题暂时没办法支持开发一个完整的离线包后台管理系统 • 客户端容器 - 客户端的实现尽可能简单,可以更快速的上线同时避免带来额外的问题 具体实现 实现思路是利用H5浏览器自带的prefetch能力。通过将离线包资源聚合到单个HTML中,APP启动后使用WebView提前加载HTML,WebView会下载资源到设备中。同时可以直接复用WebView自带的离线缓存能力和差异化资源更新能力。 prefetch.html <html> <head> <!--公共资源--> <link rel="prefetch" href="https://wq.360buyimg.com/js/common/dfd0ab35.js"> <link rel="prefetch" href="https://wq.360buyimg.com/data/fontRegular.ttf"> <!--A页面资源--> <link rel="prefetch" href="https://wq.360buyimg.com/jxpp/app.css"> <link rel="prefetch" href="https://wq.360buyimg.com/data/min.js"> </head> <body></body> </html> 复制代码 H5 离线包资源聚合 前面有提到不希望让H5业务开发同学手动管理维护离线包资源,所以我们希望提供一种自动聚合资源的能力。减少后续维护成本的同时尽可能减少资源的下载。 判定是否开启离线包 和线上H5性能监控系统打通,根据访问次数和TOP排名来自动判定是否开启离线包预加载 部分 H5 如果需要预热可以额外添加 聚合资源 • 根据实际加载情况统计出需要预下载的资源比人工维护更加准确 • 被多个H5引用的资源自动判定为公共资源 提示:通常资源管理,特别是公共资源长期维护之后更难管理,很多时候添加之后不知道是否有被使用不会删除。 资源聚合流程 通过运行自动化脚本的方式,基于Puppeteer和Performance TimingAPI,自动计算出需要下载的离线包资源及时更新。  如何判定首屏资源 使用浏览器自带的PerformanceTiming API判定。domInteractive是浏览器完成对所有HTML的解析并且DOM构建完成的时间点。在domInteractive之前加载的资源既为阻塞首屏渲染的资源。同时需要过滤掉一些不需要缓存的资源,目前我们只收集JS/CSS会阻塞渲染的资源。 客户端 客户端实现相对简单,APP 启动后初始化一个新的WebView容器后台静默加载,Android端加载prefetch.html,iOS端加载preload.html。加载完成后释放WebView容器,之后不会造成其他性能损耗。虽然每次启动都会重新触发下载逻辑,但是只会进行差异化下载本地缓存中不存在的资源文件。 其他优化 提前加载 WebView 因为 APP 启动后首次初始化WebView会包含Web引擎的初始化,初始化耗时会更高。所以我们预下载资源时也提前初始化了WebView,之后打开H5时可以减少100-200ms初始化耗时。 提前打通登录态 因为大部分业务H5都需要登录态,所以APP在首次打开H5时,需要将原生登录态信息同步到 H5cookie中,会有1次额外的302跳转耗时。我们在预加载资源时提前打通登录态,之后打开H5时可以减少100-200ms302跳转耗时。 接口预拉取 同时也提供了接口预拉取的能力,可以H5加载前提前拉取首屏接口数据,提高加载速度。 实现过程中遇到的问题 iOS系统 不支持prefetch iOS系统web内核并不支持prefetch特性,所以针对iOS我们采用preload来代替。Android平台下发link-prefetch,iOS平台下发link-preload进行差异化处理。 提示: prefetch 相比 preload 性能更好。 prefetch 下载的优先级没有 preload 高,避免影响其他网络请求速度。 preload 会将 JS / CSS 进行解析添加到内存,造成一定的额外消耗。 preload 不支持 HTML iOS系统preload特性并不支持HTML Document的提前加载。不过这一点对于我们影响不大,因为目前我们业务H5的HTML通常会做一定的服务端渲染逻辑,并不支持缓存策略。(例如聚合一部分的公共 JS) 多域名资源不共享 iOS系统中WebView针对不同域名H5使用的其他资源并不能共享。例如https://www.jd.com/index.html和https://www.jingxi.com/index.html虽然是同一个网页,内部都有使用同样的JS/CSS/图片资源,但是基于iOS 系统中WebView缓存策略实现,每一个域名的资源使用独立的空间管理,并不能共享使用需要重复下载。因为我们自身H5支持jd.com和jingxi.com双域名访问,所以我们在APP端添加了域名替换的逻辑,尽可能将我们自身的业务收敛到jingxi.com域名,提高缓存资源利用率。 提示:即使不使用离线包,这也是一个不错的优化策略。 Android 系统 磁盘空间不足触发Crash 部分设备在使用prefetch下载资源时,因为设备本身磁盘空间不足导致Crash。所以我们在资源下载前加了一个额外的磁盘空间检查策略,当磁盘空间太低时不进行下载。 总结 prefetch 方案   我们通过利用系统浏览器自身提供的prefetch预加载资源能力和HTTP离线缓存能力,实现了一套相对轻量的离线包解决方案,H5首屏性能提升基本上和其他方案一样(除了iOS系统上不支持HTML离线资源)。同时通过离线资源自动统计/自动更新的方式,不需要额外的离线包资源管理系统,减少后续的维护成本。 这套方案虽然在实现成本和维护成本上相对比较低,但是因为实现方式的选择也存在一些不足需要后续完善。例如无法拦截网络请求扩展更多能力,同时依赖浏览器自身的缓存策略也存在一些不可控,例如Android端浏览器内核过多,资源需要完全遵守HTTP缓存策略。同时离线资源自动统计/自动更新能力并不容易抽象出一套标准化的方案适用于不同公司的业务。但是技术实现方案通常都是在做各种权衡和取舍,这是我们认为目前相对低成本的一套实现方案。 离线包的价值 个人认为提前下载资源的离线包方式带来的首屏加载收益并没有那么高。原因如下:1.提前下载过多离线资源也会带来更多的网络消耗。2.大部分页面本身不具备离线使用的能力(需要网络访问接口)。3.离线包也只是优化第一次加载的速度,因为资源本身就可以设置HTTP的缓存策略避免重复下载。H5页面首屏加载应该更多关注页面本身的渲染性能,例如JS/CSS解析耗时,直出还是非直出,首屏接口速度等。 更有价值的在我们如何通过拦截网络请求增强更多的能力,例如提供HTTPDNS,原生/H5复用图片缓存等能力。 扩展链接 • WKWebView 请求拦截探索与实践 • 评估关键渲染路径 • 离线Hybrid容器如何做到接近100%秒开? • prefetch特性支持 • preload特性支持 • WKWebView离线化方案——实现Service Worker API

优秀的个人博客,低调大师

【ChatGPT应用篇】助力Beauty代码的初体验 | 京东云技术团队

思考过程: 案例1:项目里面有Excel文件的解析场景,试着与ChatGPT进行了交互,现将问题整理如下: 1.给我写一个Java版本的excel导入解析代码 (毫不客气的分配任务) 2.需要支持100000000数据量 (业务需求变更) 3.优化代码需要支持10000000数据量 (降低数量级,减轻难度) 4.请采用面向对象的思想给做一下封装 (初级工程师 -> 中级工程师) 5.进一步面向接口编程,抽离业务 (中级晋升应该加一点泛型诉求,代码更Beauty) 6.替换掉 poi 采用EasyExcel (替换原始的默认技术选型,替换三方包) 7.进一步优化,能支持EasyExcel、POI自由切换 (问题没问好!本意是想让他进一步抽象,能基于SPI支持扩展点) 8.采用控制反转方式优化 (与问题5有重复) 9.提升解析性能,采用多线程并行解析优化 (中级工程->高级工程师) 10.提升程序效率,把解析性能在提升10倍 (架构师的成本意识,这个问题的回答有点意思) 11.采用Spring IOC 控制反转方式进一步封装 (与问题8有重复) 12.添加异常 logger 打印 (优化细节) 13.添加更多的中文代码注释 (增强易读性,优化细节) 14.将中文注释替换成英文注释 (^_^ 开始走向国际化) 15.日志错误信息支持 国际化 资源文件 (国际化的开始……) 16.把上面Excel解析的代码在给来个单元测试吧 17.… 案例2:项目里面一个ES深度分页优化的场景,问题整理如下: 1.Elasticsearch 深度分页问题 2.Elasticsearch 深度分页Java代码 3.以上代码采用面向IOC优化 4.进一步面向对象优化 5.基于泛型进行抽象 6.将 scroll API 替换为 searchafter 7.使用 spring data elasticsearch 优化并实现 search After 8.以上代码请采用jmeter 生成一个压测脚本 9.上面Spring Data Elasticsearch 实现 search after 的示例代码请采用 groovy 语言生成测试用例 案例2的代码就不贴出来了,大家感兴趣可以自行输入以上问题进行体验! (个人体会:程序领域问问题要采用专业术语,专业术语越强越能精准给予反馈!) 说明: 对于ChatGPT输出的代码没有做仔细的Review及调试,但是看代码风格基本上是改改就能用于生产的,对于代码规范、命名还是很认可的! 案例过程: Happy Coding!Beauty Code! 以下是一个与ChatGPT 结对编程的一个Excel数据解析案例,大家可以根据我的思考过程进行体验,以下放了一些截图,ChatGPT的反应速度惊人,代码版本一步步进行迭代优化,感触较深的是真正的高质量低代码平台要应运而生了! import com.alibaba.excel.EasyExcel; import com.alibaba.excel.annotation.ExcelProperty; import com.alibaba.excel.metadata.Sheet; import com.alibaba.excel.read.listener.ReadListener; import org.apache.poi.hssf.usermodel.HSSFWorkbook; import org.apache.poi.ss.usermodel.Cell; import org.apache.poi.ss.usermodel.Row; import org.apache.poi.ss.usermodel.Sheet as PoiSheet; import org.apache.poi.xssf.usermodel.XSSFWorkbook; import java.io.File; import java.io.FileInputStream; import java.io.IOException; import java.util.ArrayList; import java.util.HashMap; import java.util.List; import java.util.Map; public class ExcelParser { private ParserType parserType; public ExcelParser(ParserType parserType) { this.parserType = parserType; } public List<Map<String, String>> parse(File file, int sheetIndex) throws IOException { if (parserType == ParserType.EASY_EXCEL) { return parseWithEasyExcel(file, sheetIndex); } else if (parserType == ParserType.POI) { return parseWithPoi(file, sheetIndex); } else { throw new IllegalArgumentException("Invalid parser type"); } } private List<Map<String, String>> parseWithEasyExcel(File file, int sheetIndex) { List<Map<String, String>> data = new ArrayList<>(); DataListener listener = new DataListener(data); ExcelReaderBuilder readerBuilder = EasyExcel.read(file, listener); Sheet sheet = new Sheet(sheetIndex + 1, 0); readerBuilder.sheet(sheet).doRead(); return data; } private List<Map<String, String>> parseWithPoi(File file, int sheetIndex) throws IOException { List<Map<String, String>> data = new ArrayList<>(); FileInputStream inputStream = new FileInputStream(file); HSSFWorkbook workbook = file.getName().endsWith(".xls") ? new HSSFWorkbook(inputStream) : new XSSFWorkbook(inputStream); PoiSheet sheet = workbook.getSheetAt(sheetIndex); List<String> headers = new ArrayList<>(); for (Cell cell : sheet.getRow(0)) { headers.add(cell.getStringCellValue()); } for (int i = 1; i <= sheet.getLastRowNum(); i++) { Row row = sheet.getRow(i); Map<String, String> record = new HashMap<>(); for (int j = 0; j < headers.size(); j++) { Cell cell = row.getCell(j, Row.MissingCellPolicy.CREATE_NULL_AS_BLANK); String value = ""; switch (cell.getCellType()) { case STRING: value = cell.getStringCellValue(); break; case NUMERIC: value = Double.toString(cell.getNumericCellValue()); break; default: value = cell.getStringCellValue(); break; } record.put(headers.get(j), value); } data.add(record); } workbook.close(); inputStream.close(); return data; } public static void main(String[] args) throws IOException { File file = new File("excel_file.xlsx"); ExcelParser parser = new ExcelParser(ParserType.EASY_EXCEL); List<Map<String, String>> data = parser.parse(file, 0); System.out.println(data); } } enum ParserType { EASY_EXCEL, POI } class DataListener extends ReadListener<Data> { private List<Map<String, String>> data; private List<String> headers; public DataListener(List<Map<String, String>> data) { this.data = data; this.headers = new ArrayList<>(); } @Override public void onException(Exception exception) { // 处理异常 } @Override public void onReadError(Exception exception) { // 处理读取错误 } @Override public void onSheet(int sheetIndex, Sheet sheet) { // 处理工作表信息 } @Override public void onReadEnd() { // 读取结束 } @Override public void onHeadRow(Row row) { for (Cell cell : row) { headers.add(cell.getStringCellValue()); } } @Override public void onRecord(Data data) { Map<String, String> record = new HashMap<>(); for (int i = 0; i < headers.size(); i++) { record.put(headers.get(i), data.getField(i)); } this.data.add(record); } } class Data { @ExcelProperty(index = 0) private String name; @ExcelProperty(index = 1) private int age; import com.alibaba.excel.annotation.ExcelProperty; import java.util.List; import java.util.Map; public class ExcelParser { private SheetParser sheetParser; public ExcelParser(SheetParser sheetParser) { this.sheetParser = sheetParser; } public List<Map<String, String>> parse(String fileName, int sheetIndex) throws Exception { return sheetParser.parse(fileName, sheetIndex); } public static void main(String[] args) throws Exception { String fileName = "excel_file.xlsx"; SheetParser sheetParser = new EasyExcelSheetParser(); ExcelParser parser = new ExcelParser(sheetParser); List<Map<String, String>> data = parser.parse(fileName, 0); System.out.println(data); } } interface SheetParser { List<Map<String, String>> parse(String fileName, int sheetIndex) throws Exception; } class EasyExcelSheetParser implements SheetParser { @Override public List<Map<String, String>> parse(String fileName, int sheetIndex) throws Exception { List<Map<String, String>> data = new ArrayList<>(); DataListener listener = new DataListener(data); ExcelReaderBuilder readerBuilder = EasyExcel.read(fileName, listener); Sheet sheet = new Sheet(sheetIndex + 1, 0); readerBuilder.sheet(sheet).doRead(); return data; } } class PoiSheetParser implements SheetParser { @Override public List<Map<String, String>> parse(String fileName, int sheetIndex) throws Exception { List<Map<String, String>> data = new ArrayList<>(); FileInputStream inputStream = new FileInputStream(fileName); HSSFWorkbook workbook = fileName.endsWith(".xls") ? new HSSFWorkbook(inputStream) : new XSSFWorkbook(inputStream); PoiSheet sheet = workbook.getSheetAt(sheetIndex); List<String> headers = new ArrayList<>(); for (Cell cell : sheet.getRow(0)) { headers.add(cell.getStringCellValue()); } for (int i = 1; i <= sheet.getLastRowNum(); i++) { Row row = sheet.getRow(i); Map<String, String> record = new HashMap<>(); for (int j = 0; j < headers.size(); j++) { Cell cell = row.getCell(j, Row.MissingCellPolicy.CREATE_NULL_AS_BLANK); String value = ""; switch (cell.getCellType()) { case STRING: value = cell.getStringCellValue(); break; case NUMERIC: value = Double.toString(cell.getNumericCellValue()); break; default: value = cell.getStringCellValue(); break; } record.put(headers.get(j), value); } data.add(record); } workbook.close(); inputStream.close(); return data; } } class DataListener extends ReadListener<Data> { private List<Map<String, String>> data; private List<String> headers; public DataListener(List<Map<String, String>> data) { this.data = data; this.headers = new ArrayList<>(); } @Override public void onException(Exception exception) { // 处理异常 } @Override public void onReadError(Exception exception) { // 处理读取错误 } @Override public void onSheet(int sheetIndex, Sheet sheet) { // 处理工作表信息 } @Override public void onReadEnd() { // 读取结束 } @Override public void onHeadRow(Row row) { for (Cell cell : row) { headers.add(cell.getStringCellValue()); } } @Override public void onRecord(Data data) { Map<String, String> record = new HashMap<>(); for (int i = 0; i < headers.size(); i++) { record.put(headers.get(i), data.getField(i)); } this.data.add(record); } } class Data { @ExcelProperty(index = 0) private String name; @ExcelProperty(index = 1) private int age; // Getters and setters } import com.alibaba.excel.EasyExcel; import com.alibaba.excel.annotation.ExcelProperty; import com.alibaba.excel.metadata.Sheet; import com.alibaba.excel.read.listener.ReadListener; import java.util.ArrayList; import java.util.List; import java.util.Map; import java.util.concurrent.*; public class ExcelParser { private SheetParser sheetParser; public ExcelParser(SheetParser sheetParser) { this.sheetParser = sheetParser; } public List<Map<String, String>> parse(String fileName, int sheetIndex) throws ExecutionException, InterruptedException { return sheetParser.parse(fileName, sheetIndex); } public static void main(String[] args) throws ExecutionException, InterruptedException { String fileName = "excel_file.xlsx"; ExecutorService executor = Executors.newFixedThreadPool(2); List<Future<List<Map<String, String>>>> futures = new ArrayList<>(); for (int i = 0; i < 2; i++) { SheetParser sheetParser = new EasyExcelSheetParser(); Future<List<Map<String, String>>> future = executor.submit(() -> sheetParser.parse(fileName, i)); futures.add(future); } List<Map<String, String>> data = new ArrayList<>(); for (Future<List<Map<String, String>>> future : futures) { data.addAll(future.get()); } System.out.println(data); executor.shutdown(); } } interface SheetParser { List<Map<String, String>> parse(String fileName, int sheetIndex); } class EasyExcelSheetParser implements SheetParser { @Override public List<Map<String, String>> parse(String fileName, int sheetIndex) { List<Map<String, String>> data = new ArrayList<>(); DataListener listener = new DataListener(data); ExcelReaderBuilder readerBuilder = EasyExcel.read(fileName, listener); Sheet sheet = new Sheet(sheetIndex + 1, 0); readerBuilder.sheet(sheet).doRead(); return data; } } class PoiSheetParser implements SheetParser { @Override public List<Map<String, String>> parse(String fileName, int sheetIndex) throws Exception { // 实现 POI 的解析,类似于前面的示例 } } class DataListener extends ReadListener<Data> { private List<Map<String, String>> data; private List<String> headers; public DataListener(List<Map<String, String>> data) { this.data = data; this.headers = new ArrayList<>(); } @Override public void onHeadRow(Row row) { for (Cell cell : row) { headers.add(cell.getStringCellValue()); } } @Override public void onRecord(Data data) { Map<String, String> record = new HashMap<>(); for (int i = 0; i < headers.size(); i++) { record.put(headers.get(i), data.getField(i)); } this.data.add(record); } } class Data { @ExcelProperty(index = 0) private String name; @ExcelProperty(index = 1) private int age; // Getters and setters } import java.util.List; import java.util.Map; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.stereotype.Component; @Component public class ExcelParser { private SheetParser sheetParser; @Autowired public ExcelParser(SheetParser sheetParser) { this.sheetParser = sheetParser; } public List<Map<String, String>> parse(String fileName, int sheetIndex) throws Exception { return sheetParser.parse(fileName, sheetIndex); } } interface SheetParser { List<Map<String, String>> parse(String fileName, int sheetIndex) throws Exception; } @Component class EasyExcelSheetParser implements SheetParser { @Override public List<Map<String, String>> parse(String fileName, int sheetIndex) throws Exception { List<Map<String, String>> data = new ArrayList<>(); DataListener listener = new DataListener(data); ExcelReaderBuilder readerBuilder = EasyExcel.read(fileName, listener); Sheet sheet = new Sheet(sheetIndex + 1, 0); readerBuilder.sheet(sheet).doRead(); return data; } } @Component class PoiSheetParser implements SheetParser { @Override public List<Map<String, String>> parse(String fileName, int sheetIndex) throws Exception { // 实现 POI 的解析,类似于前面的示例 } } class DataListener extends ReadListener<Data> { private List<Map<String, String>> data; private List<String> headers; public DataListener(List<Map<String, String>> data) { this.data = data; this.headers = new ArrayList<>(); } @Override public void onHeadRow(Row row) { for (Cell cell : row) { headers.add(cell.getStringCellValue()); } } @Override public void onRecord(Data data) { Map<String, String> record = new HashMap<>(); for (int i = 0; i < headers.size(); i++) { record.put(headers.get(i), data.getField(i)); } this.data.add(record); } } class Data { @ExcelProperty(index = 0) private String name; @ExcelProperty(index = 1) private int age; // Getters and setters } 原理学习: 知其然,并未知其所以然!直到看到下面的解惑视频…… 视频号搜索: 于建国博士讲解ChatGPT的工作原理及颠覆性影响,通俗易懂 (愿学有所得) 职责有边界、思考无边界、担当无边界!!! 利用好ChatGPT一切皆有可能,用好新时代的生产力工具希望ChatGPT能助力大家更上一层楼!


优秀的个人博客,低调大师

从原理到应用,人人都懂的ChatGPT指南 | 京东云技术团队

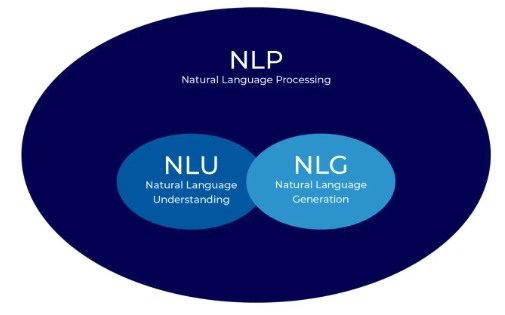
作者:京东科技 何雨航 引言 如何充分发挥ChatGPT潜能,已是众多企业关注的焦点。但是,这种变化对员工来说未必是好事情。IBM计划用AI替代7800个工作岗位,游戏公司使用MidJourney削减原画师人数......此类新闻屡见不鲜。理解并应用这项新技术,对于职场人来说重要性与日俱增。 一、GPT模型原理 理解原理是有效应用的第一步。ChatGPT是基于GPT模型的AI聊天产品,后文均简称为GPT。 从技术上看,GPT是一种基于Transformer架构的大语言模型(LLM)。GPT这个名字,实际上是"Generative Pre-trained Transformer"的缩写,中文意为“生成式预训练变换器”。 1.大模型和传统AI的区别是什么? 传统AI模型针对特定目标训练,因此只能处理特定问题。例如,很会下棋的AlphaGO。 而自然语言处理(NLP)试图更进一步,解决用户更为通用的问题。可以分为两个关键步骤:自然语言理解(NLU)和自然语言生成(NLG)。 以SIRI为代表的人工智能助手统一了NLU层,用一个模型理解用户的需求,然后将需求分配给特定的AI模型进行处理,实现NLG并向用户反馈。然而,这种模式存在显著缺点。如微软官方图例所示,和传统AI一样,用户每遇到一个新的场景,都需要训练一个相应的模型,费用高昂且发展缓慢,NLG层亟需改变。 大型语言模型(如GPT)采用了一种截然不同的策略,实现了NLG层的统一。秉持着“大力出奇迹”的理念,将海量知识融入到一个统一的模型中,而不针对每个特定任务分别训练模型,使AI解决多类型问题的能力大大加强。 2.ChatGPT如何实现NLG? AI本质上就是个逆概率问题。GPT的自然语言生成实际上是一个基于概率的“文字接龙”游戏。我们可以将GPT模型简化为一个拥有千亿参数的“函数”。当用户输入“提示词(prompt)”时,模型按照以下步骤执行: ①将用户的“提示词”转换为token(准确地说是“符号”,近似为“词汇”,下同)+token的位置。 ②将以上信息“向量化”,作为大模型“函数”的输入参数。 ③大模型根据处理好的参数进行概率猜测,预测最适合回复用户的词汇,并进行回复。 ④将回复的词汇(token)加入到输入参数中,重复上述步骤,直到最高概率的词汇是【END】,从而实现一次完整的回答。这种方法使得GPT模型能够根据用户的提示,生成连贯、合理的回复,从而实现自然语言处理任务。 3.上下文理解的关键技术 GPT不仅能理解用户当前的问题,还能基于前文理解问题背景。这得益于Transformer架构中的“自注意力机制(Self-attention)”。该机制使得GPT能够捕捉长文本中的依赖关系。通俗地说,GPT在进行文字接龙判断时,不仅基于用户刚输入的“提示”,还会将之前多轮对话中的“提示”和“回复”作为输入参数。然而,这个距离长度是有限的。对于GPT-3.5来说,其距离限制为4096个词汇(tokens);而对于GPT-4,这个距离已经大幅扩展至3.2万个tokens。 4.大模型为何惊艳? 我们已经介绍了GPT的原理,那么他是如何达成这种神奇效果的呢?主要分三步: ①自监督学习:利用海量的文本进行自学,让GPT具备预测上下文概率的基本能力。 ②监督学习:人类参与,帮助GPT理解人类喜好和期望的答案,本质为微调(fine-tune)。 ③强化学习:根据用户使用时的反馈,持续优化和改进回答质量。 其中,自监督学习最关键。因为,大模型的魅力在于其“大”——大在两个方面: ①训练数据量大: 即训练大模型的数据规模,以GPT-3为例,其训练数据源为互联网的各种精选信息以及经典书籍,规模达到了45TB,相当于阅读了一亿本书。 ②模型参数量大: 参数是神经网络中的一个术语,用于捕捉数据中的规律和特征。通常,宣称拥有百亿、千亿级别参数的大型模型,指的都是其参数量。 追求大型模型的参数量是为了利用其神奇的“涌现能力”,实现所谓的“量变引起质变”。举例来说,如果要求大模型根据emoji猜电影名称,如👧🐟🐠🐡代表《海底总动员》。可以看到,当模型参数达到千亿级别时,匹配准确度大幅度提升。这表明模型参数量的增加对提高模型表现具有重要意义。 处理其他多类型任务时,也有类似的效果: 如实验所揭示的,只有当模型参数达到千亿级别,大模型的优势才得以凸显。GPT之外的其他大模型,也有类似的表现。 为什么? 目前主流观点认为,要完整完成一个任务,实际上需要经过很多子步骤。当模型大小不足时,大语言模型无法理解或执行所有步骤,导致最终结果不正确,达到千亿级参数时,其解决问题的全链路能力已经足够。人们以最终结果的正误作为评判标准,导致认为是一种“涌现”。 在“涌现”问题上,人与猩猩的比喻很有趣。人类的大脑容量比猩猩大3倍,这种差异使得人类能够进行更复杂的思考、沟通和创造。两者的结构没有显著差异,这不也是“涌现”吗? GPT-3.5正是千亿模型,参数达到了1750亿。相较于GPT-3,GPT-3.5主要针对模型参数进行了微调,使其在问答时更符合人类的习惯。据悉,GPT-4的模型参数量甚至达到了GPT-3.5的五倍之多,这也解释了为何GPT-4表现得如此聪明(体验过的人应该都能理解)。下面是GPT模型演进历史: 二、GPT的局限性 综上,GPT模型具有明显的、突破性的优势。典型的优势包括:①强大的语言理解能力;②极为广泛的知识储备;③学习能力与推理能力等等。这些能力让人们感觉人工智能真正拥有了“脑子”,想象着使用GPT解决一切问题。 然而,若要深入应用该技术,有必要了解其局限性,以便在实际应用中取长补短。主要总结六大局限: 1.逻辑不透明 GPT模型的回答本质上是概率。传统的软件开发中,接口的输入和输出参数都是确定的,而在给定输入参数(即提示词)的情况下,GPT的回复却有一定随机性。当大家将ChatGPT作为聊天工具使用时,这种不精确可以是用户的谈资;当涉及到商业化软件应用时,设计时就需要特别注意降低不确定性,在大部分产品场景下,用户都很重视确定性。 2.短期记忆差 得益于自注意力机制,ChatGPT具备了多轮对话能力。然而,它的记忆长度相当有限,GPT-3.5模型仅支持向前追溯4096个tokens用于回复的参考。更糟糕的是,这4096个tokens还包括ChatGPT之前回复用户的部分!这使得其捉襟见肘的记忆更加难堪,堪称电子金鱼。好在GPT-4已经将上下文token上限扩展至3.2万个,一定程度上缓解了这个问题。 3.资源消耗多 ChatGPT的智能需要消耗大量算力,而运行大规模高端显卡需要消耗大量电力。在五年之内,依靠半导体制程的进一步升级和大模型的广泛应用,算力与电力的边际成本将逐渐转变为固定成本,也就解决了本问题。 4.响应速度慢 由于模型极大,GPT在回复时也无法做到瞬时响应,正如用户实际体验,ChatGPT是逐词回复的。企业在设计相关产品时需要特别关注应用场景: ①需要避免将GPT用于高并发的场景,本服务依赖的接口调用并发上限非常低。 ②产品设计上避免用户急切需要结果的应用场景,确保用户能够“等得起”。 5.行业认知浅 诚然,ChatGPT拥有来自互联网和经典书籍的丰富知识。然而,真正的企业级专业知识往往源于特定领域的深入研究和实践,这些真知灼见无法仅凭互联网上的知识获取。因此,若希望GPT充当企业参谋,只能帮助梳理战略框架,但难以为企业提供颇具洞察的策略建议。 6.价值未对齐 ①在自监督学习阶段,GPT训练数据英文占比高达92%。②在监督学习阶段,传授道德观的工程师主要来自英语世界。③在强化学习环节,也可能受到恶意用户输入错误价值观的影响。因此,GPT的“精神内核”是以西方价值观为基石的,这可能导致生成的文字难以符合我国的文化背景和价值观。 三、GPT的多层应用指南 在了解了GPT模型的原理及局限性后,终于可以看看怎么用好这项技术了。我按照感知其能力的直观性,由浅入深将其分为五层,逐层进行介绍。 第一层:聊天能力 在此类用法中,GPT的回答就是给客户的交付物,是GPT模型最简单、最直观的用法。 1.套壳聊天机器人 通过使用OpenAI官方接口,开发的套壳聊天机器人产品。这类产品之所以存在,原因懂得都懂。否则,用户为何不直接使用ChatGPT呢?此类产品难以形成现象级应用,且竞争激烈。由于比较灰色且内容未经过滤,网站被封后又换域名的故事将持续上演。 2.场景化问答 这种模式对GPT的回复场景进行了约束。通过限定提示词、嵌入大量特定领域知识以及微调技术,使GPT能够仅基于某类身份回答特定类型的问题。对于其他类型的问题,机器人会告知用户不了解相关内容。这种用法可以有效约束用户的输入,降低许多不必要的风险,但是想训练一个出色的场景化机器人,也需要投入许多精力。典型应用包括智能客服、智能心理咨询和法律咨询等。微软的new Bing正是此类应用的杰出代表,其俏皮傲娇的回复风格,深受网友的喜爱。 第二层:语言能力 在本层,我们充分发挥ChatGPT的语言天赋,辅助各种基于文字的处理工作。从这一层开始,需要使用one-shot或few-shot(在提示词中给ChatGPT一个或多个示例)来提升ChatGPT的表现。与用户的交互不再局限于聊天窗口,提前预制提示词模板,用户只能输入限定的信息,对应提示词的空槽位。 预制带槽位提示词模板的应用基本流程如下: 1.文字处理类 此类应用主要有三种用法: ①文章提炼 可以输入文章段落,要求提取段落主旨。但受token数限制,难以总结整篇文章。也可要求生成短标题、副标题等。在提示词中预留【案例】槽位,让用户输入一些参考案例,GPT便可以学习相应的风格,进行针对性的输出。 ②润色/改写 可用于文章的初步润色,能够消除错别字、错误标点等。改写则可以转换文章风格,如更改成小红书风格等。 ③文章扩写 在有大纲基础上,分段进行文章扩写。受token限制,如一次要求过长,输出的扩写难以做到前后呼应。ChatGPT本身不会产生新知识,文章扩写难以写出深刻见地,只能生成口水文。通过给定关键词和案例,要求生成有规律的短文案,是应用其文章扩写能力的有效方法。 2.翻译 GPT模型训练时学习了大量语言,具备跨语言能力。无论用何种语言与其沟通,只要理解意图,分析问题能力是不区分语言的。因此,翻译对GPT来说很轻松。当然也仅限基本翻译,不要指望其能翻译的“信、达、雅”。 3.情感分析 GPT能理解文字背后的用户情绪。例如,在客服模块引入GPT能力,基于用户语音和文字快速判断情绪状况,提前识别潜在客诉,在情绪爆发前进行有效安抚。 第三层:文本能力 在本层,GPT的能力已经超越了语言,它通过大量学习,凡是与文本相关的任务,都能胜任。它甚至具备真正的学习能力,使用few-shot技巧,能解决训练数据中不存在的问题。本层的应用范围极广,将迸发出大量极具创造力的产品。我在这里仅举一些典型例子。 1.写代码 ChatGPT能编写SQL、Python、Java等代码,并帮忙查找代码BUG。与撰写文章的原因类似,不能要求其编写过长的代码。 2.写提示词 要求GPT创作提示词是与其他AI联动的简单方式。例如,要求GPT为midjourney撰写提示词,已成为非常主流的做法。 3.数据分析 ChatGPT可以直接进行数据分析,或与EXCEL配合进行数据分析。它将数据分析操作成本降至极低,大幅提升了数据分析的效率。 第四层:推理能力 在前几层中,我们已经见识了GPT的推理能力。以GPT的推理能力替代手动点击操作流,将带来B端和C端的产品设计的颠覆式变化。个人认为,短期内B端的机会大于C端。经过互联网20年的发展,C端用户的主要需求已基本得到满足,颠覆C端用户的操作路径会带来较大的学习成本。而B端则有很大的发挥空间,这里将其分为三个阶段: 1.自动化工作流串联 利用ChatGPT理解人类意图的能力,结合langChain技术将提示词和公司内各项工作的网页链接整合。员工无需寻找各种链接,在需要执行相关操作时,会自动跳转到相应页面,进行下一步操作。以ChatGPT为智慧中枢,真正实现将B端各类操作有机整合。下图为设计思路的示例。 2.AI辅助决策 以第一个阶段为基础,将对应页面的部分功能与GPT联动。这样,在员工执行操作时,部分功能可以由AI实现,成倍提升效率。微软Copilot正是这类产品的代表,比如可以实现在Excel中说明自己想要进行的数据分析,无需寻找相关公式,数据分析就自动做好了。 3.全自动AI工作流 本阶段目前还处于演示层面,呈现了未来的愿景。如前文所述,GPT很难解决特定领域的细节问题,除非针对某个场景进行大量的微调与私有数据部署。AutoGPT、AgentGPT都属于此类。 第五层:国产大模型 AI技术是科学而非神学,大模型的原理也不是秘密。美国能做到,我国不仅能,而且有必要。只要训练数据质量达标,模型参数突破千亿便具备推理能力,突破八千亿可与GPT-4匹敌。采用大量中文语料和中文微调,我国必将拥有符合本国文化背景、价值观的大模型。 然而,路漫漫其修远兮,困难也是极多的,如:训练成本极高、训练数据质量要求高、模型优化复杂、马太效应明显等。因此,预计在未来五年内,中国最多只会有3家知名大模型服务商。 大模型是AI时代的基础设施,大部分公司选择直接应用,直接获取商业价值。在这个大背景下,愿意投身自有大模型的公司就更加难能可贵了。在此,我谨代表个人向那些勇于投身于自有大模型建设的国内企业表示敬意。 四、总结 总的来看,ChatGPT是一款跨时代的产品。不同层面对GPT技术的应用,体现出了一些共性的机会。我总结了三项未来具有巨大价值的能力。 1.问题分解技术 鉴于GPT回复的限制在于最多只能基于32,000个tokens,因此有效地将问题分解成子问题并交由GPT处理显得尤为关键。未来的工作模式可能将问题拆解为子问题,再组装子问题的解决方案。在具体实施时,还需要对子问题的难度进行判断,有些问题可以交给一些小模型处理,这样就可以有效的控制应用成本。 2.三种调优方法 想要让GPT在多个层面上发挥特定的作用,主要有三种交互方式,成本从低到高分别为: 调优方法 优势 缺点 提示词优化 提升效果明显成本极低 占用token多,影响上下文关联长度 embedding 扩展GPT知识调优成本较低 GPT并非真的理解了相关的内容,而是在遇到相关问题时,能够基于给定的知识库回答。 微调技术 搭建真正的私有模型,GPT能理解相关的问题。 成本较高,需要大量的“问答对”,训练过程非常消耗token。 ①提示词优化 通过探索找到最优提示词模板,预留特定槽位以供用户输入。仅通过提示词优化就能实现广泛功能,许多基于GPT的产品,其底层就是基于特定提示词的包装。好的提示词需包含角色、背景、GPT需执行的任务、输出标准等。根据业界的研究,好的提示词能使GPT3.5结果的可用性由30%飙升至80%以上。提示词优化毫无疑问是这三种方法中最重要的。 ②embedding 这是一种搭建自有知识库的方法,将自建知识库使用embedding技术向量化,这样GPT就能基于自有数据进行问答。 ③微调(finetune) 通过输入大量问答,真正教会GPT如何回答某类问题,成本较前两者更高。优势在于将提示词的短期记忆转化为私有模型的长期记忆,从而释放宝贵的Token以完善提示词其他细节。 以上三种方式并不冲突,在工程实践中往往互相配合,特别是前两种。 3.私有数据积累 私有数据集的价值得到进一步提升,各行业可基于此对GPT进行二次包装,解决特定领域问题。建议使用微软Azure提供的GPT接口,搭建带有私有数据的大语言模型产品。因微软面向B端的GPT服务为独立部署,不会将私有数据用于大模型训练,这样可以有效保护私有数据。毕竟私有数据一旦公开,价值将大打折扣。 凭借以上几项能力加持,大语言模型可以充分释放在解决依赖电脑的重复性劳动的生产力。我将下一个时代(3年内)的业务运转模式总结如下图: 企业会根据三大能力衍生出三大类角色: ①问题分解者 这类角色很清楚大语言模型能力的边界,能够将一个业务问题有效的分解为GPT能处理的子问题,并能根据问题结果,将子问题进行拼装。 ②提示工程师 这类角色深谙与GPT沟通之道,能够根据不同的问题类型,给出有效的提示词模板,极大提升GPT的输出质量。 ③知识拥有者 这类角色有大量的行业knowhow,并且能够将知识进行结构化,传授给GPT。对应现在的领域专家。 在这种模式的推动下,GPT将会成为企业提效的重要帮手,可以解决大量重复劳动,可以提供有价值的参考。但人的主观能动性仍起决定性作用。 五、写在最后 即使以GPT-4为代表的AI技术保持当前的水平,带来的效率提升已经令人震惊,更遑论其仍以飞快的速度进化。从技术革命的发展史来看,一项大幅度提效的新技术出现,往往先惠及B端,而后才慢慢在C端开始释放巨大的价值。这是由企业对效率天然的敏感性所决定的,而改变C用户的习惯需要大量学习成本与场景挖掘,滞后效应较强。举三个例子大家就懂了: 1. 回顾第一次工业革命,内燃机的出现先导致了纺织女工的大量失业,而后才逐渐找到了各种C端场景,推动了社会生产力的大幅度上升。 2. ChatGPT可以更快的生成口水文,但是C端用户对阅读的诉求是没有增加的。对于营销号公司来说,效率提升了,所需要的人变少了。 3. MidJourney可以快速生成抱枕的图案,但是C端用户并不会购买更多的抱枕,那么需要作图的人员就少了。 一场信息化企业的內效革命就要到来了,依靠电脑的重复劳动将会消失,因为大模型最擅长学这个了。正如我文初所举得案例一样,像IBM公司缩减7800个编制的案例,只会发生的越来越频繁。 AI时代真的已经到来,每个岗位都需要思考,如何让AI成为工作上的伙伴。

优秀的个人博客,低调大师

解密Elasticsearch:深入探究这款搜索和分析引擎 | 京东云技术团队

作者:京东保险管顺利 开篇 最近使用Elasticsearch实现画像系统,实现的dmp的数据中台能力。同时调研了竞品的架构选型。以及重温了redis原理等。特此做一次es的总结和回顾。网上没看到有人用Elasticsearch来完成画像的。我来做第一次尝试。 背景说完,我们先思考一件事,使用内存系统做数据库。他的优点是什么?他的痛点是什么? 一、原理 这里不在阐述全貌。只聊聊通讯、内存、持久化三部分。 通讯 es集群最小单元是三个节点。两个从节点搭配保证其高可用也是集群化的基础。那么节点之间RPC通讯用的是什么?必然是netty,es基于netty实现了Netty4Transport的通讯包。初始化Transport后建立Bootstrap,通过MessageChannelHandler完成接收和转发。es里区分server和client,如图1。序列化使用的json。es在rpc设计上偏向于易用、通用、易理解。而不是单追求性能。 图1 有了netty的保驾护航使得es放心是使用json序列化。 内存 图2 es内存分为两部分【on heap】和【off heap】。on heap这部分由es的jvm管理。off heap则是由lucene管理。on heap 被分为两部分,一部分可以回收,一部分不能回收。 能回收的部分index buffer存储新的索引文档。当被填满时,缓冲区的文档会被写入到磁盘segment上。node上共享所有shards。 不能被回收的有node query cache、shard request cache、file data cache、segments cache node query cache是node级缓存,过滤后保存在每个node上,被所有shards共享,使用bitset数据结构(布隆优化版)关掉了评分。使用的LRU淘汰策略。GC无法回收。 shard request cache是shard级缓存,每个shard都有。默认情况下该缓存只存储request结果size等于0的查询。所以该缓存不会被hits,但却缓存hits.total,aggregations,suggestions。可以通过clear cache api清除。使用的LRU淘汰策略。GC无法回收。 file data cache 是把聚合、排序后的data缓存起来。初期es是没有doc values的,所以聚合、排序后需要有一个file data来缓存,避免磁盘IO。如果没有足够内存存储file data,es会不断地从磁盘加载数据到内存,并删除旧的数据。这些会造成磁盘IO和引发GC。所以2.x之后版本引入doc values特性,把文档构建在indextime上,存储到磁盘,通过memory mapped file方式访问。甚至如果只关心hits.total,只返回doc id,关掉doc values。doc values支持keyword和数值类型。text类型还是会创建file data。 segments cache是为了加速查询,FST永驻堆内内存。FST可以理解为前缀树,加速查询。but!!es 7.3版本开始把FST交给了堆外内存,可以让节点支持更多的数据。FST在磁盘上也有对应的持久化文件。 off heap 即Segments Memory,堆外内存是给Lucene使用的。 所以建议至少留一半的内存给lucene。 es 7.3版本开始把tip(terms index)通过mmp方式加载,交由系统的pagecache管理。除了tip,nvd(norms),dvd(doc values), tim(term dictionary),cfs(compound)类型的文件都是由mmp方式加载传输,其余都是nio方式。tip off heap后的效果jvm占用量下降了78%左右。可以使用_cat/segments API 查看 segments.memory内存占用量。 由于对外内存是由操作系统pagecache管理内存的。如果发生回收时,FST的查询会牵扯到磁盘IO上,对查询效率影响比较大。可以参考linux pagecache的回收策略使用双链策略。 持久化 es的持久化分为两部分,一部分类似快照,把文件缓存中的segments 刷新(fsync)磁盘。另一部分是translog日志,它每秒都会追加操作日志,默认30分钟刷到磁盘上。es持久化和redis的RDB+AOF模式很像。如下图 图3 上图是一个完整写入流程。磁盘也是分segment记录数据。这里濡染跟redis很像。但是内部机制没有采用COW(copy-on-write)。这也是查询和写入并行时load被打满的原因所在。 小结 es内存和磁盘的设计上非常巧妙。零拷贝上采用mmap方式,磁盘数据映射到off heap,也就是lucene。为了加速数据的访问,es每个segment都有会一些索引数据驻留在off heap里;因此segment越多,瓜分掉的off heap也越多,这部分是无法被GC回收! 结合以上两点可以清楚知道为什么es非常吃内存了。 二、应用 用户画像系统中有以下难点需要解决。 1.人群预估:根据标签选出一类人群,如20-25岁的喜欢电商社交的男性。20-25岁∩电商社交∩男性。通过与或非的运算选出符合特征的clientId的个数。这是一组。 我们组与组之前也是可以在做交并差的运算。如既是20-25岁的喜欢电商社交的男性,又是北京市喜欢撸铁的男性。(20-25岁∩电商社交∩男性)∩(20-25岁∩撸铁∩男性)。对于这样的递归要求在17亿多的画像库中,秒级返回预估人数。 2.人群包圈选:上述圈选出的人群包。 要求分钟级构建。 3.人包判定:判断一个clientId是否存在若干个人群包中。要求10毫秒返回结果。 我们先尝试用es来解决以上所有问题。 人群预估,最容易想到方案是在服务端的内存中做逻辑运算。但是圈选出千万级的人群包人数秒级返回的话在服务端做代价非常大。这时候可以吧计算压力抛给es存储端,像查询数据库一样。使用一条语句查出我们想要的数据来。 例如mysql select a.age from a where a.tel in (select b.age from b); 对应的es的dsl类似于 {"query":{"bool":{"must":[{"bool":{"must":[{"term":{"a9aa8uk0":{"value":"age18-24","boost":1.0}}},{"term":{"a9ajq480":{"value":"male","boost":1.0}}}],"adjust_pure_negative":true,"boost":1.0}},{"bool":{"adjust_pure_negative":true,"boost":1.0}}],"adjust_pure_negative":true,"boost":1.0}}} 这样使用es的高检索性能来满足业务需求。无论所少组,组内多少的标签。都打成一条dsl语句。来保证秒级返回结果。 使用官方推荐的RestHighLevelClient,实现方式有三种,一种是拼json字符串,第二种调用api去拼字符串。我使用第三种方式BoolQueryBuilder来实现,比较优雅。它提供了filter、must、should和mustNot方法。如 /** * Adds a query that <b>must not</b> appear in the matching documents. * No {@code null} value allowed. */ public BoolQueryBuilder mustNot(QueryBuilder queryBuilder) { if (queryBuilder == null) { throw new IllegalArgumentException("inner bool query clause cannot be null"); } mustNotClauses.add(queryBuilder); return this; } /** * Gets the queries that <b>must not</b> appear in the matching documents. */ public List<QueryBuilder> mustNot() { return this.mustNotClauses; } 使用api的可以大大的show下编代码的能力。 构建人群包。目前我们圈出最大的包有7千多万的clientId。想要分钟级别构建完(7千万数据在条件限制下35分钟构建完)需要注意两个地方,一个是es深度查询,另一个是批量写入。 es分页有三种方式,深度分页有两种,后两种都是利用游标(scroll和search_after)滚动的方式检索。 scroll需要维护游标状态,每一个线程都会创建一个32位唯一scroll id,每次查询都要带上唯一的scroll id。如果多个线程就要维护多个游标状态。search_after与scroll方式相似。但是它的参数是无状态的,始终会针对对新版本的搜索器进行解析。它的排序顺序会在滚动中更改。scroll原理是将doc id结果集保留在协调节点的上下文里,每次滚动分批获取。只需要根据size在每个shard内部按照顺序取回结果即可。 写入时使用线程池来做,注意使用的阻塞队列的大小,还要选择适的拒绝策略(这里不需要抛异常的策略)。批量如果还是写到es中(比如做了读写分离)写入时除了要多线程外,还有优化写入时的refresh policy。 人包判定接口,由于整条业务链路非常长,这块检索,上游服务设置的熔断时间是10ms。所以优化要优化es的查询(也可以redis)毕竟没负责逻辑处理。使用线程池解决IO密集型优化后可以达到1ms。tp99高峰在4ms。 三、优化、瓶颈与解决方案 以上是针对业务需求使用es的解题方式。还需要做响应的优化。同时也遇到es的瓶颈。 1.首先是mapping的优化。画像的mapping中fields中的type是keyword,index要关掉。人包中的fields中的doc value关掉。画像是要精确匹配;人包判定只需要结果而不需要取值。es api上人包计算使用filter去掉评分,filter内部使用bitset的布隆数据结构,但是需要对数据预热。写入时线程不易过多,和核心数相同即可;调整refresh policy等级。手动刷盘,构建时index.refresh_interval 调整-1,需要注意的是停止刷盘会加大堆内存,需要结合业务调整刷盘频率。构建大的人群包可以将index拆分成若干个。分散存储可以提高响应。目前几十个人群包还是能支撑。如果日后成长到几百个的时候。就需要使用bitmap来构建存储人群包。es对检索性能很卓越。但是如遇到写操作和查操作并行时,就不是他擅长的。比如人群包的数据是每天都在变化的。这个时候es的内存和磁盘io会非常高。上百个包时我们可以用redis来存。也可以选择使用MongoDB来存人包数据。 四、总结 以上是我们使用Elasticsearch来解决业务上的难点。同时发现他的持久化没有使用COW(copy-on-write)方式。导致在实时写的时候检索性能降低。 使用内存系统做数据源有点非常明显,就是检索块!尤其再实时场景下堪称利器。同时痛点也很明显,实时写会拉低检索性能。当然我们可以做读写分离,拆分index等方案。 除了Elasticsearch,我们还可以选用ClickHouse,ck也是支持bitmap数据结构。甚至可以上Pilosa,pilosa本就是BitMap Database。 参考 贝壳DMP平台建设实践 Mapping parameters | Elasticsearch Reference [7.10] | Elastic Elasticsearch 7.3 的 offheap 原理

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册