首页 文章 精选 留言 我的

精选列表

搜索[官方产品],共10000篇文章
优秀的个人博客,低调大师

Android官方开发文档Training系列课程中文版:Android的安全建议

原文地址:http://android.xsoftlab.net/training/articles/security-tips.html Android系统内置的安全策略可以有效的降低应用程序的安全问题。所以默认创建的应用程序已经包含了一定程度的安全保护措施。 Android所包含的安全策略有: 应用程序沙箱,它可以使APP的数据、代码与其它APP相互隔离。 应用程序框架对于常见防护措施的强大实现,比如密码、权限以及安全的IPC机制。 一些安全技术的应用,比如ASLR, NX, ProPolice, safe_iop, OpenBSD dlmalloc, OpenBSD calloc, 以及Linux mmap_min_addr,可以降低常见的内存管理错误风险。 文件加密系统可以保证设备在丢失后其中的数据不被盗取。 用户权限授予可以限制访问系统特性以及用户数据。 Android定义的权限可以控制程序的数据只能在程序的控制范围之内。 本文中所提及的Android安全策略对于日常开发非常重要,应养成良好的编码习惯。在日常的编码行为中使用以下策略可以有效降低无意中造成的安全风险。 数据存储 应用程序常见的安全问题就是它们的数据是否可被其它应用程序访问到。Android有3种基本的数据存储方式。 内部存储 默认情况下,由APP自己创建的文件只能由APP本身访问。这种防护措施由Android框架实现,也足以应对大多数应用的安全情况。 通常应当避免为IPC文件使用MODE_WORLD_WRITEABLE模式或MODE_WORLD_READABLE模式,因为这些模式没有对数据的访问提供限制能力,也没有在数据格式上做任何控制。如果需要在进程间共享数据,你应当考虑使用ContentProvider。ContentProvider对APP提供了数据读写权限,也可以按照实际情况动态的授予权限。 如果需要对一些较为敏感的数据提供额外的保护,你可以使用密钥对本地文件进行加密。比如,可以将密钥放入KeyStore,并以用户密码将其保护起来。不过这种方案也不是万能的:某些破解手段可以监视用户所输入的密码,不过这种方式可以对丢失的设备进行保护。 外部存储 在外部存储器上创建的文件可被全局读写。因为外部存储器可被用户移除,也可以被任何的应用程序修改,所以不应当在外部存储器上存储敏感的用户数据。 正因为可能存在不可信资源,所以从外部存储器中读取数据时应当执行输入验证。我们强烈的建议不要在外部存储器上存储用于动态加载的可执行文件或者类文件。如果APP需要从外部存储器上接收可执行文件,那么这些文件应当是被签过名的,在加载之前也应当对这些签名进行校验。 内容提供者 ContentProvider提供了一种结构化的存储机制,这种机制可以对所有的应用程序形成一种约束。如果不打算使其它的应用程序访问你的ContentProvider,那么只需在程序的清单文件中标记ContentProvider的属性android:exported=false即可。否则,设置android:exported=true便意味着其它应用程序可以访问其中的数据。 在创建ContentProvider时默认允许其它应用程序可以访问其中的数据,你可以对读或者写进行单一权限限制,也可以同时管理。 如果使用ContentProvider只是为了在自身的APP之间共享数据,更加合理的方式是将android:protectionLevel属性值设置为”signature”。Signature权限不需要用户确认,所以这样可以提供良好的用户体验,以及更多的控制力。 ContentProvider还可以通过android:grantUriPermissions属性提供更细粒度的访问能力。访问者应当在Intent中使用FLAG_GRANT_READ_URI_PERMISSION标志或FLAG_GRANT_WRITE_URI_PERMISSION标志进行访问。这些权限的范围可被做更进一步的限制。 当访问ContentProvider时,使用参数化方法比如query(), update(), 及delete()可以避免不可信来源的SQL注入。 不要对写入权限的安全拥有错误的认知。考虑一下,写入权限允许执行SQL语句,这可能会使一些数据被确认。比如,一名攻击者可能会在通话记录中查找一个指定的电话号码是否存在,如果这条数据存在,那么攻击者只需进行修改便可得知结果。如果ContentProvider的数据结构可被猜测出,那么写入权限就相当于也同时提供了读取权限。 使用权限 因为Android每个应用都处于沙箱之内,所以如果需要共享资源与数据的话,应用必须显式的声明自有权限。 请求权限 我们推荐应用程序所需的权限越少越好。这样可以降低权限滥用的风险,也更易让用户接受,也可以减少黑客的攻击入口。通常情况下,如果某个权限不是必要的,那就不要去请求它。 如果应用程序可以做到不需要任何权限,那么这是最完美的。比如,如果需要通过访问设备信息的方式来创建唯一标识符的话,我们更推荐GUID。又比如,相比于将数据存储于外部存储器,我们更推荐内部存储器。 另外在请求权限时,可以使用< permissions>来保护IPC。IPC对于安全特别敏感、薄弱,并且它会被暴露给其它应用程序,比如ContentProvider。 除了可能需要用户确认的权限之外,我们更推荐使用访问控制,因为这些权限可能会使用户感到困惑、不解。比如,可以考虑对个人开发者的应用程序使用”signature“的IPC权限保护等级。 不要泄露受保护的权限数据。这种情况仅会发生在通过IPC共享数据时:因为它拥有特殊的权限,并且对于任何的IPC接口的客户端也没有要求出示该权限。 More details on the potential impacts, and frequency of this type of problem is provided in this research paper published at USENIX:http://www.cs.berkeley.edu/~afelt/felt_usenixsec2011.pdf 创建权限 通常情况下应当尽量少的使用权限,少用权限就意味着更安全。创建权限这种事情对于大多数应用来说是用不到的,因为系统定义的权限足以涵盖所有情况,这些权限会提供访问检查。 如果必须创建权限,考虑是否可以使用”signature”保护等级完成你的所需任务。”signature”会将自身完全暴露给用户,只允许具有相同签名的应用程序访问。 如果要创建”dangerous”保护等级的权限,那么有些东西需要考虑在内: 权限必须提供一段简短的描述该权限安全的字符串。 描述权限的字符串必须提供不同地区的语言。 如果权限的描述含糊不清或者用户认为这会为其带来风险,那么用户可能会选择不安装应用。 如果权限的生成器没有安装的话,应用程序可能会请求权限。 上面的每一条对于作为程序员的你都是一项重要的非技术性挑战,这样做可能会使用户感到困惑,这就是为什么我们不鼓励使用”dangerous”权限等级的原因。 网络安全 网络传输本身就存在安全风险,因为它会包括用户的隐私数据。人们越来越关心移动设备的隐私问题,尤其是执行网络传输时,所以APP需要至始至终以最佳的安全方案保护用户的数据安全。 使用IP网络 Android所处的网络环境与其它的Linux系统有着很大的不同。主要考虑的就是选用适用于敏感数据传输的协议。比如HttpsURLConnection用于安全的WEB通信。我们推荐在支持HTTPS,因为移动设备会频繁的连接到不可信网络,比如公共的Wi-Fi热点。 经认证,Socket等级的加密通讯可以使用SSLSocket类简单实现。鉴于Android设备会频繁的连接到不安全的无线网络,所以我们强力的建议对所有的应用程序都使用安全的网络实现。 我们也见过一些应用在处理敏感的IPC上使用了localhost网络端口。我们不鼓励使用这种方式,因为这些接口能被其它应用程序访问到,应当使用Android的IPC机制。 还有一个常见的问题就是,根证书重复用于验证从HTTP或者其它网络上下载的不可信数据。这也包括WebView以及HTTP请求响应的输入验证。 使用电话网络 SMS(短消息服务)协议主要用于个人对个人之间的通讯,它并不适用于APP的数据传输。由于SMS的限制,我们强烈的推荐使用Google Cloud Messaging(GCM)及IP网络来传输服务器与设备之间的数据。 要注意,SMS既没有对网络和设备进行加密也没有对其进行相关验证。尤其是,任何的SMS接收器应当考虑到会有一位恶意的用户会发送SMS给你的应用,不要相信没有验证过的SMS数据,并用它们来执行一些敏感操作。还有,你应当意识到SMS可能会在网络上被拦截并被篡改。在Android设备内,SMS消息是由广播意图传送的,所以这些数据可以被拥有READ_SMS权限的应用程序读取到。 输入验证 无论程序运行在哪个平台上,没有执行充分的输入验证都是影响程序安全的主要原因之一。Android提供了平台等级的安全策略,这可以降低应用程序输入验证问题的暴露率,应用程序应当尽可能的使用这些平台特性。还应该注意:安全性语言的选择倾向于减少输入验证问题的可能性。 如果你在使用本地代码,那么从文件中读取的数据、从网络上接收的数据或从IPC接收的数据都可能会引起安全问题。最常见的问题就是缓冲区溢出,使用释放后的对象等等。Android提供了大量的相关技术手段比如ASLR(Address Space Layout Randomization)、DEP(Data Execution Prevention),这些技术手段可以降低这些错误的出现频率,但是它们不会解决根本的内在问题。你可以谨慎的处理指针或管理缓冲区来防止这些问题的出现。 如果使用SQL数据库或者ContentProvider进行数据查询,那么SQL注入可能是个问题。避免这些问题最好使用参数化的查询方法。将权限降为只读或只写可以降低SQL注入带来的相关风险。 如果不能够使用以上提及的安全建议,那么我们强烈推荐使用结构良好的数据格式,并在使用时对这些数据格式进行验证。 处理用户数据 通常来说,对于用户的数据安全最好的方法就是尽量少使用可以访问到敏感数据或者用户数据的API。如果可以避免存储或者传输这些信息,那么就不要传输这些数据。可考虑应用程序是否能够实现这么一种逻辑:使用数据的哈希码或者一种不可逆的数据形态。比如,程序可能会实现这么一种逻辑:将电子邮件地址的哈希码作为一个关键的值,这样可以避免使用原有的电子邮件地址,这可以降低暴露数据的机会,也可以降低攻击者入侵应用程序的机会。 如果程序需要访问用户的个人信息,比如密码或者用户名等等,要记住一些组件可能会要求你提供相关的隐私政策,来解释这些数据的使用与存储。所以接下来数据访问实践可以简化遵循规则。 你还应当考虑应用程序是否有无意中将用户的个人数据暴露给了第三方。如果你不清楚这些第三方组件或服务为什么要使用用户的信息,那么就不要提供给它们。通常降低个人信息的访问可以降低这块的安全风险。 如果必须要访问敏感数据,那么评估一下这些信息是否有必要传输到服务器,或者是否这些操作只需在客户端执行就可以。考虑凡是涉及到用户敏感数据的代码都在客户端执行,这样可以避免不必要的网络传输和安全泄漏问题。 还有,要确保没有将用户数据通过IPC、全局可读写文件或者网络Socket暴露给其它应用程序。 如果需要GUID,可以创建一个大的唯一的数据将其保存下来。不要使用与电话有关的数字,比如电话号码、IMEI,这些信息可能会与用户信息有关。 写入设备日志时要当心。在Android中,日志是共享资源,可被具有READ_LOGS权限的应用读取到。尽管日志数据是临时的,但是不恰当的用户信息日志可能会无意中将信息泄露给其它应用程序。 WebView的使用 因为WebView会解析像HTML和JavaScript这样的web内容,所以不正确的使用会带来常见的安全隐患。Android提供了大量机制来收缩这些潜在问题的范围,比如通过限制WebView的能力来达到最低的运行需求。 如果程序没有直接使用到WebView中的JavaScript,那么不要调用setJavaScriptEnabled()。一些示例代码可能会使用该方法,所以如果不需要的话,在你的程序中关闭它。默认情况下,WebView不会执行JavaScript,所以不会发生跨站脚本攻击。 使用addJavaScriptInterface()需要特别当心,因为它会允许JavaScript调用预留给Android原生应用的方法。如果你使用它,要确认所有的Web的相关内容都是可信的。如果不可信的内容允许进入,那么不可信的 JavaScript 可能会调用App内的相关方法。一般我们推荐在APK内包含JavaScript代码的时候使用addJavaScriptInterface()。 如果程序通过WebView访问敏感数据,你可能需要使用clearCache()方法来删除存储在本地的所有文件。我们可以使用HTTP头部的某些属性比如no-cache来表示应用程序不应当缓存某些特殊的内容。 Android 4.4之前版本的webkit含有大量的安全问题。如果App运行在这些版本上,应当确认WebView所渲染的内容都是可信的。如果应用必须渲染开放的Web内容,考虑实现一个独有的渲染器,这样可以及时更新相关的安全补丁。 管理证书 通常来说,我们不推荐频繁的要求用户凭证,推荐使用授权令牌。 用户名及密码通常不应该存在本地。应当使用用户输入的用户名及密码进行初始化验证,然后使用一个权限Token进行通信。 如果一个账户需要被多个程序访问,那么应当使用AccountManager。如果可能的话,使用AccountManager与服务进行交互,绝不要将密码存在设备上。 如果证书只是用作于你创建的应用程序,那么可以使用checkSignature()方法进行程序访问验证。如果只有一个程序使用了证书,那么KeyStore可能更适合你。 使用密码 除了数据隔离、文件系统加密、安全通信通道等保护手段之外,Android还提供了一系列通过算法加密的安全保护措施。 通常情况下,Android内置的最高等级的安全实现已经可以支持各种安全情况。如果需要从一个已知的位置接受一个文件,那么HTTPS URI已经足够。如果需要一条安全通道,考虑使用HttpsURLConnection或SSLSocket。 如果发现确实需要实现自己的安全协议,不建议自己实现加密算法。而应当使用已有的加密算法比如在Cipher中提供的AES加密算法或RSA加密算法。 使用安全随机数生成器SecureRandom来初始化密钥KeyGenerator。如果不使用由SecureRandom生成的密钥的话,则会大大减弱加密算法的健壮性,也更容易遭受线下攻击。 如果需要将密钥存在本地以便后续使用,那么可以使用KeyStore类似的加密机制。 使用进程间通信 一些App尝试使用传统的Linux技术比如网络Socket和共享文件来实现IPC。我们对此推荐使用Android为IPC实现的系统功能,例如Intent,Binder,Messenger和BroadcastReceiver。Android的IPC机制允许验证连接到你IPC的程序的身份,并且可以对每个IPC机制设置安全策略。 许多安全元素通过IPC机制共享。如果你的IPC机制的目的不是为了供其他应用程序使用,那么请将对应元素的android:exported的属性设置为false。这对于由相同UID的多进程组成的应用很有帮助,或者对后期再开启该功能也有一定的帮助。 如果IPC的目的是为了可被其他应用访问,你可以通过使用< permission>元素指定安全策略。如果IPC只是为了在持有相同key的两个自有应用中使用,那么android:protectionLevel=”signature”则更为适合。 使用Intent Intent是异步IPC的首选机制。这取决于程序的需求,你可能会使用sendBroadcast(), sendOrderedBroadcast()或者显式Intent来指定应用程序组件。 要注意,由于有序广播可以被接收方消耗掉,所以这些广播可能不会被分发给所有的应用程序。如果你发送了一个广播,而该广播必须被指定接收器接收的,那么必须使用显式Intent,并且该Intent还需指明广播接收器的名称。 发送Intent的一方可以验证接收方是否允许非空的权限方法调用。只有含有该权限的应用才会接收到该Inetnt。如果广播中的Intent的数据是敏感的,那么应当考虑这里所使用的权限不会被非法的应用程序拦截。在这种情况下,你应当考虑直接调用接收器,而不是使用广播。 **Note:**Intent filters不应当被视作为一种安全特性:因为组件可能会由显式的Intent调起。你应当在收到Intent的地方执行输入验证来确认该Intent是否被格式化为适用于调用广播接收器,服务或者Activity的格式。 使用服务 Service经常被用作支持其他程序的功能。每个Service必须在它的清单文件中有相应的声明。 默认情况下,Service不是开放的,也不能够被其它应用程序调起。然而,如果在Service的声明中添加了IntentFilter,那么默认就会被暴露出去。最好的办法就是显式的声明android:exported属性为你需要的属性。Service还可以由android:permission属性保护。如果这么做了,那么其它的程序则需要在它们的清单文件中声明对应的权限才可以启动、停止或者绑定该服务。 Service还可以保护在其权限内的IPC调用,在执行这个调用的实现之前调用checkCallingPermission()进行必要检查。我们通常推荐使用在清单文件中声明的权限,因为有很多漏洞会被忽略。 使用Binder及Messenger接口 Binder、Messenger是远程过程调用的首要IPC机制。它们提供了一种定义良好的接口:可以进行端对端相互认证。 我们强烈推荐以不需要特定的权限检查的方式设计接口。由于Binder、Messenger并不是在应用的清单文件中声明过的,因此不能对其采用特定权限。它们的权限通常来自于对应的Service或Activity所声明的权限。如果你创建了一个用于请求验证或者访问控制器的接口,那么这些控制器必须显式的添加在Binder、Messenger的接口中。 如果创建了一个需要访问控制器的接口,使用checkCallingPermission()验证调用者是否含有所需的权限。这在访问服务的远端代理之前尤其重要,正如你的应用的身份需要传给其它接口一样。如果调用一个由Service提供的接口,那么如果你没有访问给定服务所需的权限,那么bindService()的调用可能会失败。如果调用一个由自身APP提供的一个本地的接口,那么clearCallingIdentity()则可以满足内部安全检查的需求。 有关更多执行与服务有关的IPC的相关信息,请参见Bound Services。 使用广播接收器 BroadcastReceiver用于处理由Intent发起的异步请求。 默认情况下,接收器可以被任何应用调起。如果你的广播接收器的作用是给其它程序使用,那么可能需要对接收器采取一些安全措施:在清单文件中添加相应的安全权限。这可以防止没有正确权限的应用程序发送Intent给广播接收器。 动态加载代码 Dalvik是Android的运行时虚拟机。虽然Dalvik专用于Android,但是其它虚拟机上的相关安全问题也同样适用于Android。一般不需要关心与虚拟机相关的安全问题,因为Android的应用程序运行在安全的沙箱环境中,所以系统上的其它进程访问不到程序的代码或者私有数据。 如果你对更深的虚拟机安全课题感兴趣,那么推荐熟悉一些现有的有关这一课题的相关文献。其中最受欢迎的两个资源如下: - http://www.securingjava.com/toc.html - https://www.owasp.org/index.php/Java_Security_Resources 这篇文档主要关注于Android的特殊之处和与其它虚拟机环境有什么不同。对于对其它虚拟机很有经验的开发者来说,这里有两个很主要的Android的不同之处: 一些虚拟机,比如JVM或.net运行时,扮演了一个安全边界的角色,从底层操作系统将代码、功能隔离。然而在Android中Dalvik虚拟机并没有这样的功能——应用程序沙箱实现与操作系统层面,所以Dalvik可以与应用的本地代码进行交互,而没有任何的安全限制。 由于移动设备有限的存储空间,一些开发者可能需要通过模块化构建应用程序,并使用动态加载技术。如果这么做,那么则需要考虑在哪接收应用的逻辑代码?又应当将这些代码存在哪?不要使用没有经过验证的代码,比如从不安全的网络资源上或者是外部存储器中加载的代码,因为这些代码很有可能会被其它程序篡改。 本地代码的安全 一般我们推荐使用Android SDK来进行应用程序开发,而不是使用本地代码开发。由本地代码构建的程序会更加复杂,也缺少了灵活性,也更容易产生像缓冲区溢出等常见的内存泄露错误。 因为Android建立于Linux kernel基础之上,所以如果使用本地代码的话,那么Linux开发中所遇到的安全问题也同样适用于此。由于Linux安全相关超出了本文的范围,所以这里提供了很受欢迎的“Linux和Unix如何安全编程”的相关资源,相关地址:http://www.dwheeler.com/secure-programs. Android与其它大部分Linux环境最大的不同就在于程序沙箱。在Android中,所有的程序都运行在程序沙箱中,也包括那些本地代码。在最基本的层面上,对熟悉Linux的开发者来说,不同之处就是Android的每个应用程序都有一个唯一UID,也拥有少量的权限。如果要使用本地代码开发的话,那么应当对应用的权限极为了解才对。 PS: 翻译的相关源文件皆已开源,开源地址:https://code.csdn.net/u011064099/android-training-chinese-version/tree/master,欢迎fork、star。

优秀的个人博客,低调大师

Android官方开发文档Training系列课程中文版:Android的JNI相关

原文地址:http://android.xsoftlab.net/training/articles/perf-jni.html JNI的全称为Java Native Interface,中文意思是Java本地接口。它定义了Java代码与C/C++代码之间的交互方式。它是两者的桥梁,支持从动态共享库中加载代码。虽然有些复杂,但是它的执行效率还是蛮高的。 如果你对JNI还不太熟悉,那么可以通过Java Native Interface Specification来了解一下JNI的大致工作流程以及JNI的特性。 JavaVM与JNIEnv JNI定义了两个关键的数据结构:”JavaVM”与”JNIEnv”。这两个函数本质上都为指向函数指针的指针表。JavaVM提供了”接口调用”功能,该功能允许创建、销毁JavaVM。理论上每个进程可以拥有多个虚拟机,但是在Android中只允许出现一个。 JNIEnv提供了大部分的JNI功能。任何本地方法都以JNIEnv为第一回调参数。 JNIEnv用于线程局部存储。正出于这个原因,所以不能在线程间共享JNIEnv。如果不能够通过其它方式获取其对应的JNIEnv对象,那么应该先共享JavaVM,然后通过GetEnv函数获取该线程对应的JNIEnv(假设该线程拥有一个JNIEnv,具体请往下看)。 C与C++对JNIEnv和JavaVM的声明方式并不相同。头文件”jni.h”针对C或者C++提供了不同的类型定义。正因为这个原因,在头文件中包含JNIEnv参数并不是个明智的主意。 线程 Android中所有的线程都是Linux线程,都由内核执行。通常由受控代码启动(比如Thread.start),但是也可以由别的地方创建,然后再附加到JavaVM上启动。举个例子,线程可以由pthread_create函数创建,然后通过AttachCurrentThread或AttachCurrentThreadAsDaemon将其附加到JavaVM上执行。 Android并不会挂起正在执行本地代码的线程。如果垃圾收集正在进行,或者调试器发起了挂起请求,那么Android会在下次JNI调用时暂停线程。 通过JNI所附加的线程在退出前必须调用DetachCurrentThread函数。 jclass, jmethodID, 及jfieldID 如果需要在本地代码中访问对象的属性,那么需要执行以下操作: 通过FindClass获取类对象的引用 通过GetFieldID获得属性的ID 通过对应的方法获取对象的内容,比如GetIntField 相应的,如果要调用一个方法,首先获取类对象的引用,其次获取该方法的ID。ID通常只是指向了一个内部的运行时数据结构。查找这些方法通常需要进行若干次字符串比对,但是一旦找到,那么后期的获取属性或者方法调用都会非常的迅速。 如果性能对你很重要,那么在找到这些属性或者方法之后,应该将其缓存起来。因为Android中只允许每个进程有一个JavaVM的存在,所以将这些数据缓存在一个静态本地结构中是合理的。 类的引用、属性的ID、方法的ID在这个类被卸载之前都可以保证它们有效。一个类只有在这种情况下才会被卸载:该类所关联的ClassLoader也能被回收。虽然这几率很低,但是在Android中不是没有可能的。 如果想在类加载的时候将这些ID缓存下来,并在类被卸载之后再重新加载时还能重新缓存,最正确的方法是添加这样一段代码: /* * We use a class initializer to allow the native code to cache some * field offsets. This native function looks up and caches interesting * class/field/method IDs. Throws on failure. */ private static native void nativeInit(); static { nativeInit(); } 在C/C++代码中创建一个名为nativeClassInit的方法,用于ID的查找与缓存。该方法会在类初始化的时候执行一次。就算是类被卸载后又重新加载,那么这个方法还是会被执行一次。 局部引用,全局引用 每个被回调到本地方法的参数,以及几乎所有的通过JNI方法返回的对象都是局部变量。这意味着当前线程中该方法内的所有局部变量都是合法的。在本地方法返回之后,虽然对象仍然存活,但是引用却是无效的。 这适用于jobject所有的子类:jclass, jstring, 以及jarray。 获取非局部变量的唯一方式就是通过NewGlobalRef及NewWeakGlobalRef函数获得。 如果需要长时间持有一段引用,那么必须使用全局引用。NewGlobalRef函数会将一个局部引用转换为一个全局引用。在调用DeleteGlobalRef方法之前,该全局引用一直有效。 这种模式通常用于缓存一个由FindClass返回的一个jclass对象: jclass localClass = env->FindClass("MyClass"); jclass globalClass = reinterpret_cast<jclass>(env->NewGlobalRef(localClass)); 所有的JNI方法都可以以这两种引用为参数。不过引用相同的值可能有不同的结果。举个例子,以同一个引用为参数连续调用两次NewGlobalRef可能会得到不同的值。如果要查看两个引用是否指向了同一个对象,必须使用IsSameObject函数。绝不要在本地代码中使用”==”比较两个引用。 绝不要认为在本地代码中的对象引用是个常量或者是唯一的。一个32位的值所代表的对象的方法调用可能与下次调用就有所不同,这可能是因为两个不同的对象拥有相同的32位值。不要将jobject的值当做键使用。 程序员经常被要求不要过度的申请局部变量。这意味着如果你创建了大量的局部变量,那么应当通过DeleteLocalRef函数手动的释放它们,而不是让JNI为你做这些事情。 要注意jfieldIDs、jmethodID并不是对象引用,所以不能够将它们传给NewGlobalRef函数使用。GetStringUTFChars函数与GetByteArrayElements函数所返回的原始数据指针也同样不是对象。 一个不寻常的情况需要单独说明一下:如果通过AttachCurrentThread函数attach到了一个本地线程上,那么在该线程被detache之前,代码中所有的局部变量都不会被自动释放。任何创建的局部变量都需要手动删除。 UTF-8与UTF-16字符串 Java语言使用的是UTF-16字符串。为了方便起见,JNI所提供的方法工作在Modified UTF-8字符串下。修正后的编码对于C语言代码很有用,因为它将\u0000编码为了0xc0 0x80。 不要忘记释放你所获得的字符串。字符串函数会返回jchar* 或 jbyte*,它们是指向原始数据的指针,而不是本地引用。它们在被释放之前一直有效,这意味着在本地方法返回后,它们并没有被释放。 传给NewStringUTF函数的数据必须是Modified UTF-8格式。一个常见的错误就是从文件流或者网络流中读取字符串数据,然后没有过滤就直接交给了NewStringUTF函数进行处理。除非你知道这些数据是7位的ASCII,否则你需要剔除高位的ASCII字符串或者将它们转换为正确的Modified UTF-8格式。如果你不这么做,那么转换的结果可能不是你想看到的。额外的JNI检查会扫描字符串并会警告你这是无效的数据,但是它们不会捕获任何事情。 原始数组 JNI提供了用于访问对象数组的功能。然而,同一时间只能对一个元素进行访问,可以直接对数组今夕读写操作,就好像直接在C中声明的一样。 为了使JNI接口尽可能的高效,也不受虚拟机实现的限制,调用GetArrayElements的相关函数可以返回一个指向实际值的指针,或者可以申请一些内存以完成复制。无论哪种方法,所返回的指针都可以保证是有效的,直到相应的释放方法被触发。必须释放你所取得的每个数组。如果Get方法调取失败,也需要保证不要去释放一个空的指针对象。 你可以通过isCopy参数来检测一个数组是否是由指针所拷贝过来的,这一点很有用。 Release方法需要一个mode参数,这个参数有三种值。运行时执行的操作取决于它返回指向实际数据的指针或者指针的副本: 0 实际指针:非final修饰的数组对象 指针副本:拷贝后的数组数据,拷贝的缓冲区会被释放 JNI_COMMIT 实际指针:不做任何事情 指针副本:拷贝后的数组数据,拷贝的缓冲区不会被释放 JNI_ABORT 实际指针:非final修饰的数组对象。早些写入不会被中止。 指针副本:所拷贝的缓冲区被释放;缓冲区内的任何变更都会丢失。 检查isCopy标志的其中一个原因是需要知道在对数组作出变更之后是否需要调用JNI_COMMIT的相关释放方法,如果要更改一个正在作出变更以及读取数组内容的操作,那么可以根据该标志跳过这次操作。另一个可能的原因就是用于有效的处理JNI_ABORT。举个例子,你可能想要得到一个数组,然后对其修改之后将其传给一个函数。如果你知道JNI会为你做一个副本的话,那么就不需要创建另外的可编辑副本了。如果JNI传回的是原始数据,那么你自己需要创建一个副本。 一个常见的错误就是如果*isCopy是false,那么可以不调用相关释放方法。但是事实并非如此,如果没有申请拷贝缓冲区,那么原始数据内存必定会被一直占用,也不会被垃圾收集器回收。 还要注意的是,JNI_COMMIT并不会释放数组,你需要在另外的标志执行后再执行一次释放。 方法调用 JNI在方法使用上有两种方式,一种如下所示: jbyte* data = env->GetByteArrayElements(array, NULL); if (data != NULL) { memcpy(buffer, data, len); env->ReleaseByteArrayElements(array, data, JNI_ABORT); } 上面这段代码首先得到了一个数组,然后拷贝出len个字节的元素,最后将这个数组释放。根据实现的不同,Get调用会返回原始数据或者数据副本。在这个案例中,JNI_ABORT可以确保不出现第三个副本。 另一种实现则要更简单一些: env->GetByteArrayRegion(array, 0, len, buffer); 对于此有若干建议: - 减少JNI调用可以节省开销。 - 不要原始数据或者额外的数据拷贝。 - 降低程序员出错的风险–他们会在某些操作失败后忘记调用相关的释放方法。 类似的,你可以使用SetArrayRegion函数将数据拷贝到一个数组中,GetStringRegion函数或GetStringUTFRegion可以从String拷贝任意长度的字符。 异常 当异常出现时,请不要继续向下执行。代码应当注意到这些异常并返回,或者处理这些异常。 当异常发生时,只有以下JNI方法允许调用: DeleteGlobalRef DeleteGlobalRef DeleteLocalRef DeleteWeakGlobalRef ExceptionCheck ExceptionClear ExceptionDescribe ExceptionOccurred MonitorExit PopLocalFrame PushLocalFrame ReleaseArrayElements ReleasePrimitiveArrayCritical ReleaseStringChars ReleaseStringCritical ReleaseStringUTFChars 很多JNI函数都会抛出异常,不过只提供了一种很简单的检查方法。比如,如果NewString函数返回了一个非空的值,那么就不需要检查异常。然而,如果你调用一个方法,比如CallObjectMethod,那么就需要每次都检查一下异常,因为如果异常被抛出后,返回值是无效的。 主要注意的是,由中断所抛出的异常不会释放本地栈帧,Android目前也不支持C++异常。JNI的Throw与ThrowNew结构也只是在当前的线程设置了一个异常指针。当异常发生时也只是返回到代码调用处,异常也不会被正确的注意与处理。 本地代码可以通过ExceptionCheck函数或ExceptionOccurred函数捕获异常,并可以通过ExceptionClear函数清理这些异常。通常情况下,不处理这些异常会导致一些问题的出现。 JNI中并没有与Throwable相对应的映射函数,所以,如果你想获得异常字符串,那么就需要先找到Throwable类,然后查找相关的getMessage “()Ljava/lang/String;”方法ID,然后调用这些方法,如果返回的值是非空的话,再调用GetStringUTFChars函数来获得你想得到的异常字符串,最后将这些异常打印出来。 本地库 你可以通过标准的System.loadLibrary函数加载共享库中的本地代码。推荐获取本地代码的方法有: System.loadLibrary(),该方法唯一的参数是一个简要的库名,所以如果要加载”libfubar.so”,你只需要传”fubar”即可。 本地方法:jint JNI_OnLoad(JavaVM* vm, void* reserved); 在JNI_OnLoad方法内部,注册所有的本地方法。如果将方法声明为”static”的话,那么方法名将不会占用符号表的空间。 如果JNI_OnLoad函数是由C++实现的话,那么它看起来应该是这个样子: jint JNI_OnLoad(JavaVM* vm, void* reserved) { JNIEnv* env; if (vm->GetEnv(reinterpret_cast<void**>(&env), JNI_VERSION_1_6) != JNI_OK) { return -1; } // Get jclass with env->FindClass. // Register methods with env->RegisterNatives. return JNI_VERSION_1_6; } 你也可以通过System.load函数外加库的全限定名来加载本地库。 使用JNI_OnLoad另一个需要注意的是:任何FindClass调用都会发生在类加载器的上下文环境中,该类加载器用于加载共享库。通常情况下,FindClass所用到的加载器位于解释栈的顶端,如果还没有加载器,那么它会使用系统的加载器。 64位的注意事项 Android目前运行于32位的平台上。虽然理论上可以为64位的平台构建系统,但是目前它不是主要的目标。大多数情况下,这不是你需要担心的事情,但是如果要将指针存储于本地结构中的一个对象的Int属性上,那么这就很值得关注了。为了支持64位指针结构,你需要将本地指针存储于一个Long属性中。 不支持特性与向后兼容 支持所有的JNI1.6特性,以及以下异常: - DefineClass 还没有实现。Android并没有使用Java的字节码以及类文件,所以传入二进制的类数据是不会被执行的。 如果需要兼容Android老的版本,那么应该检查以下部分: 动态查询本地函数 在Android 2.0之前,字符’$’在查找方法时不会被正确的转换为”_00024”。所以使用有关方法需要明确注册或者将内部类方法移出。 分离线程 在Android 2.0之前,无法使用pthread_key_create析构函数来避免”在退出之前必须分离线程”这项检查。 弱的全局引用 在Android 2.2之前,弱的全局引用还没有实现。之前的版本会拒绝使用它们。你可以使用Android平台版本来检测是否支持。 在Android 4.0之前,弱的全局引用只能被传入NewLocalRef, NewGlobalRef, 以及 DeleteWeakGlobalRef这几个函数。 从Android 4.0开始,弱的全局引用可以像其它JNI引用一样使用。 本地引用 在Android 4.0之前,本地引用实际上就是指针。在Android 4.0之后添加了必要的中间角色,以便更好的支持垃圾回收器的工作,不过这意味着有很多JNI的bug在老版本上无法察觉。查看JNI Local Reference Changes in ICS获取更多信息。 通过GetObjectRefType检查引用类型 在Android 4.0之前,由于直接指针的使用,无法正确的实现GetObjectRefType。我们通过弱的全局表、参数、本地表以及全局表进行查找。首先它会找到你的直接指针,并返回它所检查的引用类型。这意味着,如果你在全局的jclass上作用GetObjectRefType,而这个jclass以一个隐性参数传给了一个静态本地方法,那么你将会获得JNILocalRefType而不是JNIGlobalRefType。

优秀的个人博客,低调大师

Android官方开发文档Training系列课程中文版:APP的内存管理

写在开头的话: 如果有同学对Android性能比较关注的,可以阅读这篇文章:Android性能优化建议 原文地址:http://android.xsoftlab.net/training/articles/memory.html 随机存储器(RAM)在任何运行环境中都是一块非常重要的区域,尤其是在内存受限的移动操作系统上。尽管Android的Dalvik虚拟机会对其进行垃圾回收,但是这不意味着APP就可以忽略申请及释放的内存。 为了可以使垃圾回收器能够有效清理APP所占用的内存空间,你需要防止内存泄漏发生,并需要在适当的时间将Reference对象释放。对大多数APP来说,垃圾回收器会在正确的对象使用完毕之后将其所占用的内存回收释放。 这节课将会学习Android如何管理APP进程以及内存空间、以及如何减少内存的占用。 Android如何管理内存 Android并没有提供专门的内存交换空间,但是它使用了paging及memory-mapping来管理内存。这意味着任何你所修改的内存——无论是否被对象分配所使用,或者是被内存映射所占用——它们会一直遗留在内存中,不能被交换出去。所以完全释放APP内存的唯一方式就是释放任何你可能所持有的对象引用,这样才可以使垃圾回收器对其进行回收。不过这里有一个例外:任何没有被修改的文件映射,比如代码,在系统需要的时候会被移出RAM。 共享内存 为了可以在RAM中满足一切要求,Android试着在进程间共享RAM页面。它通过以下几种方式实现: 每个APP进程都是由一个名为Zygote的进程fork出来的。Zygote进程在系统启动加载通用框架代码及资源(比如Activity的主题)时启动。为了启动新的APP进程,系统会先fork出Zygote进程,然后再在新的进程中加载、运行APP的代码。这使得为Android框架代码以及资源所分配的RAM页面在APP进程间共享成为了可能。 大多数的静态数据都是被映射到进程中的。这种方式不仅可以在进程间共享数据,还可以在需要的时候将其移除页面。静态数据包含:Dalvik代码(放置在预链接的.odex文件中),APP资源以及在.so文件中的本地代码。 在很多地方,Android通过显式内存分配区域在不同的进程间共享同一块RAM。比如,WindowSurface就在APP与屏幕合成器间使用了共享内存,CursorBuffer在内容提供者与客户端之间也使用了共享内存。 由于大量使用了共享内存,所以检查APP占用的内存空间就显得很有必要了。 内存的分配与回收 以下是Android内存回收与再分配的一些情况: - Dalvik中每个进程的堆都有虚拟内存范围限制。这个范围取决于逻辑堆尺寸的定义,它可以随着APP的需要随之增长(不过最大只会增长到系统为每个app所分配的内存大小)。 - 堆栈的逻辑尺寸并不等同于堆栈所使用的物理内存大小。当系统检查APP的堆时,会计算一个名为Proportional Set Size(PSS)的值,PSS的意思是,与其他进程共享的,需要清理的页面列表。有关更多PSS的相关信息,请阅读指南:Investigating Your RAM Usage。 - Dalvik堆栈对堆栈的逻辑空间并不是连续排布的,这句话的意思是Android并不会对堆空间进行碎片整理。Android只有在已使用的空间到达堆栈的末端时才会整理堆栈的逻辑空间。不过这不意味着堆所使用的物理空间不能被整理。在垃圾收集之后,Dalvik会先扫描堆并找出无用页面,然后使用madvise将这些页面返回到kernel。所以,成对的分配、回收大段的内存可以使大量的内存能够重复使用。然而,回收小段的内存的效率可能会很低,因为小段内存的页面可能正在被使用,还没有被释放。 侦测应用内存 为了维持一个多任务执行环境,Android为每个APP的堆大小都设置了硬性限制。具体的堆大小都不相同,这取决于RAM的大小。如果APP已经将所分配的堆容量用完,并还要继续申请更多的内存,那么APP会收到一个OutOfMemoryError错误。 在一些情况中,你可能需要知道当前的设备中还有多少堆内存可用。比如,检查多大的数据缓存空间在内存中是安全的。你可以通过getMemoryClass()方法进行这样查询。它会返回一个整型数值,这个数值以兆字节为单位,代表了APP堆内存的可用值。这项内容将会在下面进行详细讨论。 APP的切换 用户在切换APP时并没有使用交换空间,Android将切换到后台的进程放置在一个LRU(最近最少使用)缓存中。这么说吧,用户先开启了一个APP,那么会专门有个进程为它启动,后来用户离开了该APP,但这个APP的进程并没有退出,那么这时系统会将这个APP的进程缓存下来,所以如果用户再次返回了该APP,那么刚刚缓存的进程会被再次利用,以便完成快速切换。 如果APP含有一个缓存进程,并且占用了当前系统并不那么需要的内存,那么在用户不再使用它时,它就会影响到系统的整体性能。所以,随着系统的可用内存减少,系统可能会杀死LRU缓存中最近最少使用到的进程。为了使APP尽可能缓存的时间长,下面的章节会介绍何时应当释放引用。 有关更多进程在后台如何缓存以及Android是如何决定哪个进程应当被杀死的相关信息,请参见:Processes and Threads。 APP应当如何管理内存 APP应当在每个开发阶段考虑RAM的限制,包括APP的设计阶段。下面将会列出几种有效的解决方案: 在开发时应当采用以下方式来增加内存的使用效率。 尽可能少的使用服务 如果APP需要使用服务在后台做一些工作,绝不要在服务内做不必要的工作。还要注意,在工作完成之后,如果服务停止失败,则要当心服务的泄露。 当启动服务时,系统会为该服务持有一个进程。这会使得系统的开销非常高昂,因为服务所使用的内存不能作为它用。这会减少系统保持在LRU缓存中的进程数量,并会使得APP的转换效率低下。当内存非常紧张或者系统不能够保证有足够的进程来维持当前的服务数量时它甚至会引起系统的卡死。 对于以上问题最佳的解决方案就是使用IntentService来限制本地服务的数量。 当服务不再需要时,留下服务继续运行是APP常见的一种非常糟糕的内存管理错误。所以不要贪图使服务保持长时运行。不及时停止服务不但会增加APP RAM容量不够用的风险,而且还会使用户觉得该APP做的非常的烂,并顺便将其卸载。 在UI不可见时释放内存 当用户切换到其它APP时,这时你的APP UI会变得不可见,所以应该释放与UI相关的所有资源。及时释放UI资源可以明显的增长系统缓存进程的能力,这会直接影响到用户的体验。 为了可以在用户离开UI后还能收到系统通知,应当在Activity内实现onTrimMemory()方法。在该方法内监听TRIM_MEMORY_UI_HIDDEN标志,这个标志代表了UI目前进入隐藏态,应当释放UI所用到的所有资源。 这里要注意,TRIM_MEMORY_UI_HIDDEN标志代表的是APP内所有的UI组件对于用户隐藏。这要与onStop()区分开,该方法是在Activity的实例变的不可见时调用,它是在APP内部Activity之间的切换时调用的。所以尽管在onStop()中释放了Activity的资源比如网络连接,注销广播接收器等等,但是一般不要在该方法内释放UI资源。因为这可以使用户在返回该Activity时,UI现场可以迅速恢复。 在内存紧张时释放内存 在APP生命周期的任何阶段,onTrimMemory()方法会告知当前设备内存很紧张。你应当在收到以下标志时进一步的释放资源: TRIM_MEMORY_RUNNING_MODERATE APP目前处于运行态,暂时不会被杀死,但是设备目前处于低内存运行态,并且系统正在杀死LRU缓存中的进程。 TRIM_MEMORY_RUNNING_LOW APP目前处于运行态,暂时不会被杀死,但是设备目前处于极低内存运行态,所以你应当释放无用的资源来增进系统的性能。 TRIM_MEMORY_RUNNING_CRITICAL APP还处于运行态,但是系统已经准备将LRU缓存中的大部分进程杀死,所以APP应当立即释放所有不必要的资源。如果系统没有获得足够数量的RAM空间,那么系统会清除LRU中的所有进程,并会杀死一些主机正在进行的服务。 还有,在APP处于缓存状态时,你可能会收到以下标志: TRIM_MEMORY_BACKGROUND APP处于低内存运行态,APP的进程处于LRU列表的前端。尽管APP所面临被杀死的风险还比较低,但是系统可能已经做好了杀死LRU进程中的准备。APP应当释放那些易于恢复的资源,这样的话,进程会继续保留在缓存列表中,并且会在用户返回到APP时迅速恢复。 TRIM_MEMORY_MODERATE APP处于低内存运行态,APP的进程处于LRU列表的中部。如果系统的内存进一步的降低,那么APP的进程可能就会被杀死。 TRIM_MEMORY_COMPLETE APP处于低内存运行态。如果系统没有足够内存的话,APP的进程首当其冲会被杀死。APP应当释放在恢复APP时一切不重要的事物。 因为onTrimMemory()方法添加于API 14,所以可以使用onLowMemory()来兼容老版本,它大致与TRIM_MEMORY_COMPLETE标志是等价的。 Note: 当系统开始杀死LRU中的进程时,尽管它是自下而上工作的,但是系统还是会考虑这么一种情况:哪个进程消耗的内存比较多,所以如果将该进程杀死后,将会获得更多的内存。所以在APP处于LRU缓存时,尽可能的消耗少量的内存,这样一直维持在缓存列表中的机会才大,才可以在切换回APP时迅速恢复状态。 检查应该使用多少内存 就像我们早期提到的,运行Android系统的设备的RAM空间各有不同,所以提供给每个APP的堆空间也是不同的。你可以通过getMemoryClass()方法获得APP的可用空间。如果APP试图向系统申请比该方法返回值大的内存空间的话,那么它会收到一个OutOfMemoryError错误。 在一些特别特殊的环境中,你可以申请更大的堆空间,可以通过在清单文件的< application>标签中添加largeHeap=”true”属性的方式来设置。在设置之后,可以通过getLargeMemoryClass()来查询大尺寸的堆栈空间量。 然而,申请大堆空间的APP只有正常用途才应该申请,比如大照片编辑类APP。决不要是因为经常出现了OutOfMemory错误才这么去做,你应该做的是解决那个OutOfMemory的问题。只有在你明确知道正常的堆空间不足以支撑APP的运行时才应该这么做。使用额外的内存空间会严重损害整体的用户体验,因为垃圾收集器会在此消耗更长的时间,并且在任务切换或者执行其它并发操作时系统性能会明显减慢。 此外,大堆空间的尺寸在所有的设备上并不是相等的。当运行在某些RAM限制的设备上,大堆空间的尺寸可能与常规的堆空间尺寸相等。所以,就算是申请了大堆空间,那么还是应该使用getMemoryClass()来检查一下常规堆空间大小,并尽量将内存的使用量控制在这个范围以下。 避免浪费位图的内存 当加载一张图片到内存时,最好是将该图片适配到当前屏幕分辨率大小之后再做内存缓存,如果原图本身分辨率很高的话,最好将其缩小到适合屏幕分辨率大小。要注意,随着位图分辨率的增加,所占的相应内存也一并增加。 Note: 在Android 2.3.x之前,位图对象无论分辨率是多大都是以相同的大小出现在堆中的,因为位图的实际像素数据被单独的存放在了本地内存中。这使得位图内存分配的调试变得很困难,因为大多数的堆栈分析工具并不能探测到本地内存的分配。然而,自Android 3.0之后,位图的像素数据被分配与APP的Dalvik堆栈中,这样增进了垃圾回收的效率以及调试能力。 使用优化过的数据容器 我们建议使用Android框架优化过的数据容器,比如SparseArray,SparseBooleanArray,以及LongSparseArray.常规的HashMap其实效率是很低的,因为它需要为每个映射创建单独的实体。另外SparseArray的工作效率更高,因为它可以避免系统对键或值的自动装箱功能。 要对内存的消耗有一定的意识 要充分了解你所使用的语言以及库的内存开销,并要一直保持有这种意识,包括在APP的设计阶段。经常表面的事物看起来无伤大雅,但实际上它们所消耗的内存是很高的。比如: Java的枚举类型需要占用静态常量的两倍内存。你应该坚决制止在Android中使用枚举。 Java中的每个类,包含匿名内部类的代码需要占用500个字节。 每个类的实例需要占用12-16个字节的RAM空间。 将每个实例放入HashMap需要格外花费32个字节的空间。 虽然以上的内容只是会消耗几个字节的空间,但是它们会在程序的内部迅速的积累增加,成为一个巨无霸级的开销。它会使你在分析内存问题的时候让你处于一个非常尴尬的境地,因为这些众多的小对象消耗了大量的内存。 当心抽象代码 经常开发者会使用抽象代码实现一种良好的程序设计结构,因为抽象代码可以增进代码的灵活性与可维护性。不过,抽象代码会有不菲的开销:通常它们需要更多的执行代码,需要花费更多的时间以及更多的RAM空间来将这些抽象代码映射到内存。所以,如果不是必须的话,最好远离它们。 为序列化数据使用纳米级缓冲协议 Protocol buffers是一种由Google设计的序列化结构的数据。它与语言无关、与平台无关的、可扩展。与XML类似,但是体积更小,速度更快、也更简单。如果你决定要使用该纳米级缓冲协议,那么就应当在客户端代码中一直使用它。常规的protobufs会生成非常冗长的代码,这会引出相当多的问题:增加内存的消耗,增长APK的体积,减缓执行效率并会迅速接近DEX标志的限制。 避免依赖注解框架 使用Guice、RoboGuice这类注解依赖框架是相当方便的,因为这些框架可以简化代码的书写,以及提供了相应的测试环境。然而,这些框架在扫描代码的注解时会执行大量的初始化工作,这会使得大量的代码映射到RAM中,尽管你不需要降这些代码载入内存。这些被映射的页面会一直驻留在内存中,虽然系统可以将它们清除,但是只有在这些页面长时间驻留在内存中才会执行清理。 使用第三方库要当心 第三方代码通常不是专门为移动设备而写。当这些代码运行在移动客户端时往往执行效率很低。在决定使用第三方库之前,应该假设正在执行一项很重要的移植工作,并将要负担为移动设备的维护、优化工作。在决定使用之前要分析该库的大小以及RAM的占用。 就算是某些库是专门为Android所设计的,但是它们还是存在隐患的,因为每个库所做的事不同。举个栗子,一个库可能使用了纳米级的protobufs,而另一个库则使用了毫米级的protobufs。那么现在在APP中使用了两个级别的protobufs。这两种差异可能会发生在日志、解析、图像加载框架、缓存以及其它任何你不期望的事情上。 还要当心掉入共享库的陷阱,这种共享库有一个共同的特点就是,你只使用了该库所提供的很小的功能,你并不希望将其它用不到的大量代码也一并放入你的工程内。在最后,如果你不是特别的需要这个第三方库的话,那么最好的方式就是自己实现一个。 优化整体性能 有关APP整体性能优化的建议都列在了Best Practices for Performance中。这些建议还包括了CPU的性能优化,除此之外还包括了内存的优化,比如减少布局对象的数量。 你还应该读一读有关optimizing your UI的文章,文章内包含了布局调试工具以及lint tool中所提示的一些布局优化建议。 使用ProGuard筛除无用代码 ProGuard工具可以通过移除无用代码以及以一种无意义的名称重命名类名,属性,方法的方式来达到一种精简、优化、模糊的效果。接下来还必须使用zipalign工具对重命名后的代码进行调整。如果不做这一步将会大大增加RAM的使用量,因为类似于资源这些事物不会再由APK映射到内存。 作者PS: 这段话摘自于zipalign的介绍,相当于是说Zipalign的原理与优势: Specifically, it causes all uncompressed data within the .apk, such as images or raw files, to be aligned on 4-byte boundaries. This allows all portions to be accessed directly with mmap() even if they contain binary data with alignment restrictions. The benefit is a reduction in the amount of RAM consumed when running the application. 分析RAM的使用状况 一旦APP达到一个相对稳定的程度,那么接下来就需要分析APP在各个生命周期的RAM使用情况了。有关如何分析APP的RAM使用情况,请参见: Investigating Your RAM Usage。 使用多进程 如果它适用于你的APP,那么另一项可能帮助你管理APP内存的升级建议就是将组件部署到不同的进程中。使用这项建议必须总是特别的小心,并且大部分APP不应该使用这项技术,如果处理不当的话它会迅速的增加RAM的消耗。这项技术对于那些运行在后台的工作与前台的工作一样重要的APP极为有用,并且可以单独管理这些操作。 使用多进程最适合的场景就是音乐播放器。如果整个APP运行在单一的进程中,那么Activity UI所执行的大部分内存分配都会和音乐的播放保持相同的时间,甚至是用户切换到了其它APP。那么像这样的APP就应该拥有两个进程:一个进程负责UI,而另一个的工作就是持续不断的运行后台服务。 你可以在清单文件中需要执行单独进程的组件里添加android:process属性来实现独立进程。比如,你可以在需要执行单独进程的服务中添加该属性,并声明该进程的名称”background”(你可以命名任何你想命名的名称): <service android:name=".PlaybackService" android:process=":background" /> 进程的名称应该以冒号’:’开头,以便确保该进程属于你APP的私有进程。 在决定创建一个新进程之前,你应该了解一下内存的影响。为了演示每个进程的执行效果,首先要考虑到一个不做任何事情的进程需要占用大约1.4MB的内存空间,下面显示了空态下的内存信息堆: adb shell dumpsys meminfo com.example.android.apis:empty ** MEMINFO in pid 10172 [com.example.android.apis:empty] ** Pss Pss Shared Private Shared Private Heap Heap Heap Total Clean Dirty Dirty Clean Clean Size Alloc Free ------ ------ ------ ------ ------ ------ ------ ------ ------ Native Heap 0 0 0 0 0 0 1864 1800 63 Dalvik Heap 764 0 5228 316 0 0 5584 5499 85 Dalvik Other 619 0 3784 448 0 0 Stack 28 0 8 28 0 0 Other dev 4 0 12 0 0 4 .so mmap 287 0 2840 212 972 0 .apk mmap 54 0 0 0 136 0 .dex mmap 250 148 0 0 3704 148 Other mmap 8 0 8 8 20 0 Unknown 403 0 600 380 0 0 TOTAL 2417 148 12480 1392 4832 152 7448 7299 148 Note: 如何阅读这些信息请参见Investigating Your RAM Usage。这里的关键数据是Private Dirty及Private Clean所指示的内存。它们分别说明了这个进程使用了大概1.4MB左右的非交换页内存,而另外150K RAM则是被映射到内存之后将要执行的代码所占用的空间。 了解空进程状态下的内存占用是相当重要的,它会随着工作的开始迅速增长。比如,下面是一个显示了一些文本的Activity的内存占用情况: ** MEMINFO in pid 10226 [com.example.android.helloactivity] ** Pss Pss Shared Private Shared Private Heap Heap Heap Total Clean Dirty Dirty Clean Clean Size Alloc Free ------ ------ ------ ------ ------ ------ ------ ------ ------ Native Heap 0 0 0 0 0 0 3000 2951 48 Dalvik Heap 1074 0 4928 776 0 0 5744 5658 86 Dalvik Other 802 0 3612 664 0 0 Stack 28 0 8 28 0 0 Ashmem 6 0 16 0 0 0 Other dev 108 0 24 104 0 4 .so mmap 2166 0 2824 1828 3756 0 .apk mmap 48 0 0 0 632 0 .ttf mmap 3 0 0 0 24 0 .dex mmap 292 4 0 0 5672 4 Other mmap 10 0 8 8 68 0 Unknown 632 0 412 624 0 0 TOTAL 5169 4 11832 4032 10152 8 8744 8609 134 现在进程使用了刚刚的三倍内存,将近4MB,只是在UI中展示了一段文本而已。这可以推出一个非常重要的结论:如果你将APP的功能放在多个进程中执行,只有一个进程用于响应UI,而另外的进程则应当避免与UI接触,因为这会迅速的增加RAM的消耗。一旦UI被绘制,那么几乎就很难将内存的用量降下来。 另外,当运行超过一个进程时,非常重要的一点是,应当使代码尽可能的精简,因为任何不必要的开销都是因为相同的实现被复制到了每个进程中。比如,如果你正在使用枚举(尽管不应该使用枚举),所有进程的RAM都需要创建并且初始化这些复制到每个进程中的常量,其它任何的抽象适配器、常量或者其它占用内存的都会被复制。 使用多进程的另外一个担忧就是它们之间的依赖关系。比如,如果APP内含有ContentProvider,并且该ContentProvider运行于显示UI的进程,那么另一个后台进程的代码需要使用这个ContentProvider时,这就需要该UI进程也加载进RAM中。如果你的服务是一个与UI进程相当权重的后台服务,那么该服务就不应该依赖UI进程中的ContentProvider或者服务。

优秀的个人博客,低调大师

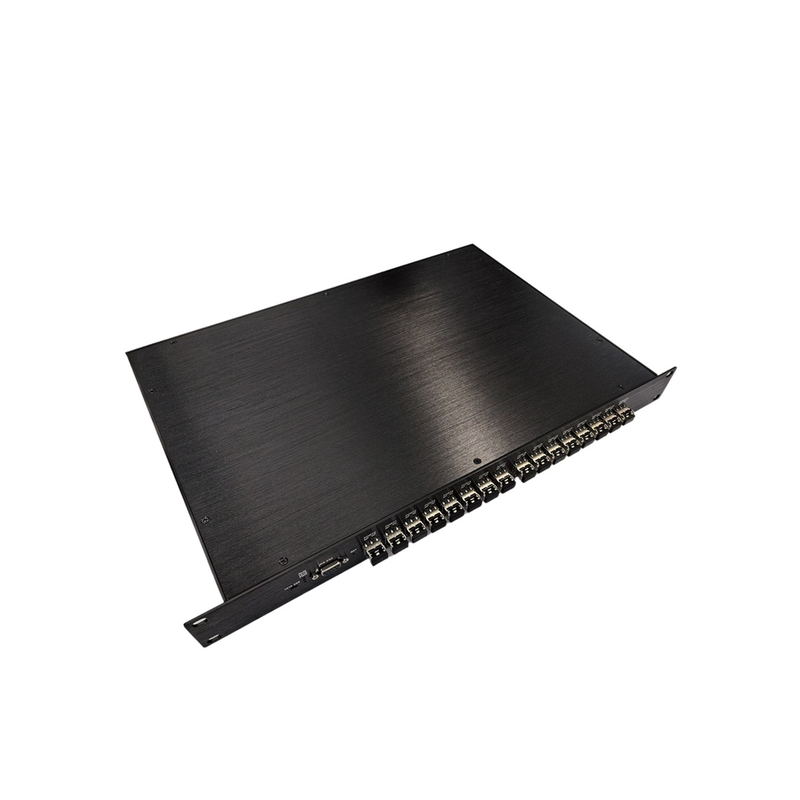
16口反射内存交换机产品介绍文档

16口反射内存交换机是一款基于反射内存(Reflective Memory)核心技术研发的高速实时光纤交换设备,主要面向分布式实时控制系统、半实物仿真系统、军工电子测控等高端场景设计。设备搭载16路独立SFP光纤接口,可实现多节点内存级实时数据同步,彻底摒弃传统以太网TCP/IP协议栈传输延迟、不确定性高的弊端,具备纳秒级传输延迟、无阻塞转发、高可靠自愈等特性。

优秀的个人博客,低调大师

产品更新|MemOS 现已支持 DeepSeek Harness 长期记忆接入

Memmy 与 MemOS Local/Cloud Plugin 已完成对 DeepSeek Harness 的适配啦! DeepSeek Harness 将模型、工具、界面和运行能力组织在 profile 中,并通过插件机制扩展运行时能力。 MemOS 已通过 DeepSeek Harness 的 Cordis 插件机制接入长期记忆,无需修改 DeepSeek Harness 源码。 任务执行时,Agent 可以获得与当前请求相关的记忆内容。回合结束后,新形成的决策和经验会进入后续的记忆处理流程。 现在,你可以把 DeepSeek Harness 接入已有的个人记忆,也可以直接在指定的 DeepSeek Harness profile 中安装本地记忆插件。 接入路径 通过 Memmy 接入个人长期记忆 Memmy 是你的个人记忆中枢,也是懂你的专属 Agent,让所有 AI 连接同一份记忆,在协同中持续进化。用户完成授权后,DeepSeek Harness 可以按当前任务检索相关内容,新的决策和经验也能按配置写回这份记忆。 完成授权并接入 DeepSeek Harness 后,DSH 可以按当前任务检索相关内容。新形成的决策和经验也能按配置写回这份记忆。 快速安装 打开 Memmy 的管理页面 -> 记忆管理 -> 跨 Agent 接入,找到 DeepSeek Harness 后点击安装插件。 安装完成后,进入 DeepSeek Harness 的设置和插件页面,确认memmy-memory已启用。 Memmy 采用本地优先的记忆管理方式。接入 DeepSeek Harness 前仍由用户决定授权范围,安装插件不会自动开放全部历史记录。 Deepseek Harness 目前还没有图片处理能力,如果你同时使用其他的 Agent 来弥补不识图的问题,可以让 Memmy 在后台打通记忆,直接做任务接续。 如图为 Cursor + DSH 操作方式: 通过 MemOS Local Plugin 在 DSH 中启用记忆 MemOS Local Plugin 2.0.16 可安装到指定的 DeepSeek Harness profile。它会记录对话中的关键结论、工具结果和执行轨迹,在后台完成摘要、索引和存储。后续任务可以召回与当前问题相关的约束和已经验证过的做法。 本次适配默认复用 DeepSeek Harness 当前的 provider 和 model。模型凭据继续由 DeepSeek Harness 的配置与解析机制管理,无需另行复制 API Key。手动指定模型时,显式配置优先。 前置条件 本地已经安装 DeepSeek Harness,并且终端可以执行dsh,一键安装脚本适用于 macOS 和 Linux。 以下命令以web为示例 profile,使用其他 profile 时,请在两条命令中替换为实际名称。 curl -fsSLo memos-local-plugin-install.sh https://raw.githubusercontent.com/MemTensor/MemOS/main/apps/memos-local-plugin/install.shbash memos-local-plugin-install.sh --agent dsh --profile web --version 2.0.16 ​ 执行前请查看下载内容,并确认web是准备启用记忆能力的 DeepSeek Harness profile。 安装完成后重新启动 DeepSeek Harness。 dsh --profile web ​ 安装后重启 DeepSeek Harness 即可生效,启动后: DeepSeek Harness:http://127.0.0.1:3080/ MemOS Viewer 记忆面板:http://127.0.0.1:18801/ Windows 环境可使用 DeepSeek Harness 的原生插件流程完成安装。在 PowerShell 中依次运行: # 1) 给当前系统安装 pnpm npm install -g pnpm@11.7.0 # 2) 安装插件dsh plugin --profile web add "@memtensor/memos-local-plugin@2.0.16" # 3) 验证配置dsh --profile web --dump-config # 4) 启动/重启dsh --profile web # 5) 若提示 ERR_PNPM_IGNORED_BUILDS(常见)执行下面两行命令后,再重新执行步骤2安装插件即可 cd "$HOME\.dsh\profiles\web"pnpm approve-builds --all ​ 通过 MemOS Cloud Plugin 在 DSH 中使用云端记忆 MemOS Cloud DeepSeek Harness Plugin 0.1.0 是面向 DSH 的生命周期插件,在每轮用户请求的第一个模型步骤前调用 MemOS Cloud 的/search/memory接口。写回只在当前回合以completed状态结束后发生,内容包括本轮用户消息和默认启用的助手消息。 插件安装在本地 DSH profile 中,记忆检索、写入和后续处理由 MemOS Cloud API 完成,不需要在本机运行 MemoryCore、SQLite 数据库或 Viewer。 云端请求失败时,插件按 fail-open 方式处理,DSH 会继续执行当前回合。默认采集范围不包含当前工作目录、完整配置、system prompt、reasoning、插件注入的上下文和附件二进制,includeToolMemory与allowPublic默认关闭。 前置条件 Cloud Plugin 需要使用Node.js 22系列中不低于22.19.0的版本,或24.0.0及以上版本。安装前,请先在 MemOS Dashboard 创建 API Key,并确认当前环境可以访问 MemOS Cloud API。 以下步骤使用 DSH 默认的webprofile。使用其他 profile 时,请将命令中的web替换为实际名称。 安装 Cloud Plugin 全局安装 DSH 后,可以直接运行下面的命令。 dsh plugin --profile web add @memtensor/memos-cloud-dsh-plugin@0.1.0 ​ 未全局安装 DSH 时,使用npx调用。 npx @deepseek-ai/dsh plugin --profile web add @memtensor/memos-cloud-dsh-plugin@0.1.0 ​ 保存 MemOS Cloud API Key 在 DSH 凭据文件~/.dsh/.credentials.yaml中写入 API Key。请将示例值替换为自己的密钥,不要把真实密钥放入发布截图或日志。 MEMOS_API_KEY: mpg-your-key ​ 添加最小插件配置 在~/.dsh/settings.yaml中加入以下内容。 memos-cloud: apiKeyEnv: MEMOS_API_KEY ​ 这项配置让插件通过 DSH 的凭据服务读取MEMOS_API_KEY。默认 API 根地址为https://memos.memtensor.cn/api/openmem/v1。需要限制用户、知识库或 Agent 范围时,再配置userid、knowledgebaseIds、multiAgentMode等字段。 重启并检查配置 安装或修改配置后,重新启动 DSH Web。 npx @deepseek-ai/dsh web ​ 还可以检查最终合并到 profile 的配置。 dsh --profile web --dump-config ​ 输出中应当包含@memtensor/memos-cloud-dsh-plugin对应的 bundle,以及id: memos-cloud配置行。 在一次跨会话演示中看到记忆如何进入任务 本次演示先在对话 A 中记录了运动和明星偏好。进入对话 B 后,DeepSeek Harness 在上下文注入区域展示由memos-local-memory提供的相关记录,并据此回答新的偏好查询。 后续的运动推荐同样引用了这些记忆内容。截图展示的是一次偏好记忆召回流程,用于说明记忆在新会话中如何参与当前请求,未包含性能或准确率对比结论。 DeepSeek Harness 新会话中的 memos-local-memory 上下文注入,内容来自此前的偏好对话 跨会话交流——MemOS 帮助知道你的爱好 DeepSeek Harness 根据已注入的偏好记忆给出运动推荐 版本与使用范围 本文的本地插件安装示例使用 MemOS Local Plugin 2.0.16。 Memmy 与本地插件覆盖的记忆范围、可用来源和模型配置取决于用户的本地环境、授权选择与 DeepSeek Harness profile 配置。 当前版本适配 DeepSeek Harness 0.1.0-rc.6,已通过编译和契约测试。 选择接入方式时,可以先确认记忆需要覆盖哪些 Agent,以及记忆服务运行在本地还是云端。 跨 Agent 使用个人工作信息时选择 Memmy; 单个 DSH profile 需要本地记忆时选择 MemOS Local Plugin; 希望使用托管记忆服务时选择 MemOS Cloud Plugin。 立即体验 Memmy:memmy.cn MemOS Local Plugin:memos-claw.openmem.net 关于 MemOS MemOS 为 AI 应用构建统一的记忆管理平台,让智能系统如大脑般拥有灵活、可迁移、可共享的长期记忆和即时记忆。 作为记忆张量首次提出“记忆调度”架构的 AI 记忆操作系统,我们希望通过 MemOS 全面重构模型记忆资源的生命周期管理,为智能系统提供高效且灵活的记忆管理能力。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册