首页 文章 精选 留言 我的

精选列表

搜索[k],共10000篇文章
优秀的个人博客,低调大师

21K Star!登上 GitHub 趋势榜 Top3 的 AI 网关项目!

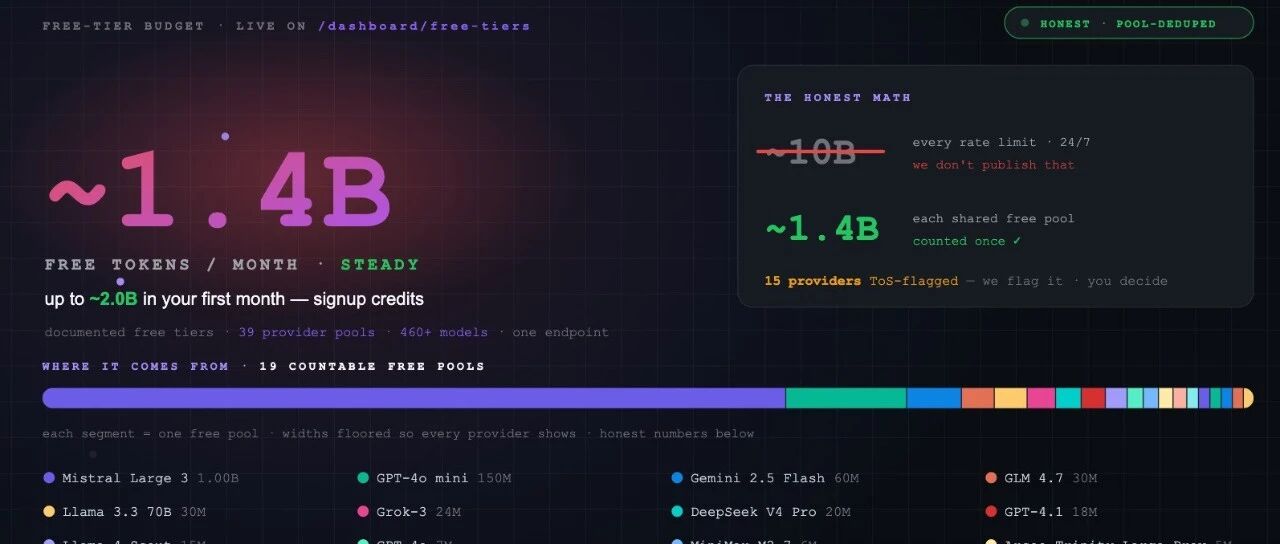
前段时间刷 GitHub 时,我发现了一个叫 **OmniRoute** 的项目,一下子就被吸引住了。 ![](https://developer.qcloudimg.com/http-save/yehe-2946312/d5a2f724498e4d2cdc4cdb1f38c7b1e8.png) 这个项目的核心口号是"Never stop coding"——永不停止编码。 它通过一个端点连接 237 个 AI 提供商,其中 90+ 个是免费的。更厉害的是,它还能自动故障转移,当一个提供商配额用完时,毫秒级切换到下一个。 ### **什么是 OmniRoute?** OmniRoute 是一个开源的 AI 网关项目,由开发者 diegosouzapw 发起。 ![](https://developer.qcloudimg.com/http-save/yehe-2946312/9ebb1a3625a42a02b9b32508c6f07514.png) 它的核心思想很简单:把所有 AI 提供商都统一到一个 OpenAI 兼容的端点下,让你的任何 AI 工具都能无缝对接。 只需要配置一个本地网关,然后把 Claude Code、Cursor、Cline、Copilot 等所有工具都指向这个网关。 网关会根据你的设置,智能选择最优的 AI 提供商——可以是最快的、最便宜的、质量最好的,也可以是配额最充足的。 当某个提供商出问题或配额用完时,它会自动切换到备用方案,整个过程对你完全透明。 ![](https://developer.qcloudimg.com/http-save/yehe-2946312/bf7285ac05057f8f08af717ec125564a.png) ### **核心亮点** #### **免费Tokens池** 这可能是 OmniRoute 最吸引人的地方。 它聚合了 40+ 个提供商池、500+ 个模型的免费额度。 很多服务商共享同一个免费池,如果简单相加会严重夸大。OmniRoute 只计数一次,确保数字真实可信。 #### **4层自动故障转移** OmniRoute 设计了一套聪明的 4 层故障转移机制: 1. 1. **订阅层**:优先使用你付费订阅的服务商(如 Claude Code、Codex、Copilot) 1. 2. **API Key 层**:当订阅配额用完时,自动切换到你配置的 API Key 提供商 1. 3. **便宜层**:使用成本极低的模型(如 GLM,$0.5/1M tokens) 1. 4. **免费层**:最后兜底,使用永久免费的提供商 整个切换过程在毫秒级完成,你甚至感觉不到任何中断。 #### **15-95% Token 压缩** AI 编码时,工具输出(如 git diff、日志、grep 结果)往往占据大量 tokens,但这些内容对模型来说并不需要完整处理。 OmniRoute 集成了 RTK + Caveman 压缩技术,可以智能过滤和压缩这些内容,平均节省 15-95% 的 tokens。 #### **17种路由策略** OmniRoute 提供了 17 种路由策略,可以根据不同场景灵活组合: - • **priority**:按优先级顺序使用,用尽一个再切换下一个 - • **cost-optimized**:自动选择成本最低的模型 - • **headroom**:优先选择配额最充足的提供商 - • **lkgp**:优先使用最近成功的提供商(Last-Known-Good Path) - • **fusion**:并行请求多个模型,由"裁判"模型综合最优答案 你可以根据自己的需求,构建适合的"combo"组合。 #### **内置 MCP 服务器** OmniRoute 内置了 MCP(Model Context Protocol)服务器,支持 95 个工具和 30 个权限范围。 ### **快速上手** #### **安装方式** OmniRoute 支持多种安装方式,最简单的是通过 npm: ``` npm install -g omniroute ``` 也可以用 Docker: ``` docker run -p 20128:20128 diegosouzapw/omniroute ``` 或者下载 Electron 桌面应用(支持 Windows、macOS、Linux)。 #### **启动服务** 安装完成后,启动服务: ``` omniroute start ``` 服务默认运行在 `http://localhost:20128/v1`。 #### **配置工具** 将你的 AI 编码工具指向 OmniRoute 端点: - • **Claude Code**:在设置中配置 API Base URL 为 `http://localhost:20128/v1` - • **Cursor**:在设置中配置自定义 API 端点 - • **其他工具**:类似配置 OpenAI API 的方式,将 base URL 指向本地网关 #### **使用 Auto 模式** 最简单的方式是使用 `auto` 模式。在工具中选择模型为 `auto`,OmniRoute 会自动构建虚拟组合并实时评分: ``` auto/coding # 代码生成优化 auto/fast # 最低延迟优先 auto/cheap # 最低成本优先 auto/offline # 配额最充足优先 auto/smart # 质量优先 + 10% 探索 ``` #### **自定义 Combo** 你也可以在仪表盘中创建自定义的 combo,指定路由策略和提供商顺序。例如: ``` Combo: "always-on" Strategy: priority 1. cc/claude-code # 订阅层:Claude Code 2. cx/copilot # 备用订阅:GitHub Copilot 3. ds/deepseek-chat # 便宜层:DeepSeek 4. kg/kilo-code # 免费层:Kilo Code ``` ### **写在最后** OmniRoute 是一个非常实用的工具,它解决了开发者在使用 AI 工具时最头疼的几个问题: 1. 1. **成本控制**:通过聚合免费额度和智能路由,大幅降低 AI 使用成本 1. 2. **高可用性**:自动故障转移确保不会因为配额问题中断工作 1. 3. **简化管理**:一个端点管理所有 AI 提供商,告别多个控制台 它完全开源免费,零成本启动,说不定能帮你省下一大笔开支。 **项目地址**:https://github.com/diegosouzapw/OmniRoute **官网**:https://omniroute.online

优秀的个人博客,低调大师

K8s集群又崩了,这次我终于搞清楚了原因

![](https://developer.qcloudimg.com/http-save/yehe-11081884/1c93470795634286b8f1fb34111171cf.jpg) 凌晨三点,刺耳的手机警报把你从梦中拽醒——“生产集群节点大面积NotReady”。你睡眼惺忪地爬起来,面对着一片飘红的监控大盘,`kubectl`命令像石沉大海,业务流量开始断崖式下跌。这种场景,是不是似曾相识? Kubernetes集群的崩溃,往往不是单一故障点引发的“雪崩”,而是多个系统性问题积累到临界点的“总爆发”。今天,我就结合多次“救火”经历,为你梳理出导致集群“暴毙”的几个最核心、也最容易被忽略的深层原因。下次再遇到,你就能直奔主题,而不是在黑暗中盲目试错。 --- ## **一、etcd:那个沉默的“心脏骤停者”** **问题现象**:`kubectl`命令超时或无响应,API Server间歇性报错,节点状态更新延迟,甚至整个集群控制平面“僵死”。 **根本原因**:etcd作为Kubernetes的“分布式数据库”,存储着所有集群状态。当它出问题时,整个集群的“大脑”就宕机了。常见死因包括: 1. **磁盘写满**:默认2GB的`quota-backend-bytes`在大型集群中很快耗尽,etcd进入只读模式,集群变为“植物人”。 etcd官方文档 1. **性能瓶颈**:低配硬件(机械硬盘、低内存)、未开启压缩导致历史版本堆积,使读写延迟飙升。 1. **网络分区或脑裂**:etcd集群节点间通信中断,无法达成共识,导致数据不一致。 1. **大对象冲击**:单个巨大的ConfigMap或Secret写入,超过默认的`max-request-bytes`(1.5MB),导致请求被拒绝。 **排查与止血**: ``` # 1. 检查etcd成员健康状态(需在etcd节点执行,并指定证书) ETCDCTL_API=3 etcdctl --endpoints=https://127.0.0.1:2379 \ --cacert=/etc/kubernetes/pki/etcd/ca.crt \ --cert=/etc/kubernetes/pki/etcd/healthcheck-client.crt \ --key=/etc/kubernetes/pki/etcd/healthcheck-client.key \ endpoint health # 2. 检查etcd存储空间使用情况 etcdctl --write-out=table endpoint status # 3. 查看etcd日志(通常与kubelet日志一起) journalctl -u etcd -f ``` **关键线索**:日志中出现“`database space exceeded`”、“`raft: stopped heartbeat`”、“`request too large`”等字样。 **根治建议**: - **扩容与调优**:参考上篇调优文章,增加`quota-backend-bytes`(如8GB),设置`auto-compaction-retention`(如8小时),提升`max-request-bytes`(如10MB)。 - **硬件隔离**:为etcd配备SSD、独立CPU和充足内存,绝不与计算节点混部。 - **定期备份与演练**:使用`etcdctl snapshot save`定期备份,并演练恢复流程。 --- ## **二、网络插件(CNI):那根被踩断的“大动脉”** **问题现象**:节点状态突然变为`NotReady`,Pod间网络不通,跨节点服务调用失败,但节点本身SSH可连,`kubelet`进程也在运行。 **根本原因**:Calico、Flannel、Cilium等CNI插件是集群的“神经系统”。其故障会导致Pod网络平面瘫痪。常见原因: 1. **DaemonSet Pod崩溃**:CNI插件的`DaemonSet` Pod(如`calico-node`)因资源不足、镜像拉取失败或配置错误而`CrashLoopBackOff`。 1. **IP地址池耗尽**:Pod数量增长导致分配给节点的IP子网(如Calico的`IPPool`)耗尽,新Pod无法获得IP。 1. **底层网络规则混乱**:`iptables`或`ipvs`规则被异常程序修改,或`netfilter`连接跟踪表`nf_conntrack`满,导致新连接无法建立。 1. **节点内核参数不兼容**:某些CNI插件(如Calico的IPIP模式)需要特定的内核模块或参数支持。 **排查与止血**: ``` # 1. 检查故障节点上的CNI插件Pod状态 kubectl get pods -n kube-system -o wide | grep | grep # 2. 查看CNI插件Pod的日志 kubectl logs -n kube-system --tail=50 # 3. 检查节点网络配置(以Calico为例,检查是否生成了网络接口和路由) ssh ip addr show | grep cali ssh route -n # 4. 检查系统连接跟踪表状态 ssh sysctl net.netfilter.nf_conntrack_count ssh sysctl net.netfilter.nf_conntrack_max ``` **关键线索**:CNI Pod状态异常、日志报错、节点上缺少`cali*`虚拟网卡或路由。 **根治建议**: - **资源保障**:为CNI DaemonSet设置合理的`resources.requests/limits`,防止因资源竞争被驱逐。 - **规划IP地址池**:根据集群规模预估Pod数量,预留足够的IP地址空间。 - **优化内核参数**:调整`nf_conntrack_max`、`net.ipv4.ip_forward=1`等参数。 - **选择稳定CNI**:生产环境选择经过大规模验证的CNI插件,并关注其版本兼容性。 --- ## **三、资源耗尽与组件竞争:无声的“内耗战争”** **问题现象**:集群响应变慢,调度延迟增加,部分节点`NotReady`,系统组件(如`kube-dns`)频繁重启,但监控显示整体CPU/内存使用率并不高。 **根本原因**:这是一种更隐蔽的问题。不是资源绝对不足,而是关键的系统组件(控制平面)与业务容器之间,或者不同系统组件之间,发生了资源竞争,导致“系统饥饿”。 1. **API Server过载**:大量`LIST/WATCH`请求(如来自众多Pod的日志收集组件)打满默认的并发连接数(`--max-requests-inflight=400`),阻塞了`kubelet`的心跳上报和调度器请求,引发连锁反应。 1. **节点内核资源耗尽**:进程号`PID`、文件描述符`fd`、内存页等底层资源被某个异常Pod耗尽,导致节点上所有容器(包括`kubelet`、`containerd`)不稳定。 1. **kubelet 内存泄漏**:旧版本`kubelet`可能存在内存泄漏,长时间运行后OOM,导致节点失联。 **排查与止血**: ``` # 1. 检查API Server监控指标(如有Prometheus) # 关注:request_rate, request_duration_seconds, inflight_requests # 2. 检查节点资源(SSH到节点) ssh top# 看整体和kubelet/containerd进程资源 ssh cat /proc/sys/kernel/pid_max ssh df -h /var/lib/kubelet # 检查kubelet数据盘 # 3. 查看kubelet日志 journalctl -u kubelet -f--tail=100 ``` **关键线索**:API Server延迟高、`kubelet`日志出现“`PLEG is not healthy`”、节点`/var/log/messages`中有`oom-killer`或`task fork failed`等日志。 **根治建议**: - **调优控制平面**:如上一篇调优文章所述,提升API Server的并发参数(`max-requests-inflight`,`max-mutating-requests-inflight`),为系统组件设置高优先级。 - **资源隔离与限制**:为所有Pod(包括系统组件)设置合理的资源限制,避免单个Pod吞噬所有资源。使用`LimitRange`和`ResourceQuota`。 - **升级与维护**:保持`kubelet`、`containerd`等基础组件为稳定版本,定期重启以释放潜在泄漏。 --- ## **总结** 集群崩溃后的排查固然重要,但最高明的运维是让故障不发生。基于以上分析,我为你总结了一份“集群健壮性清单”: 1. **监控先行**:不仅要监控CPU/内存,更要监控**etcd性能指标**(存储大小、读写延迟)、**API Server并发与延迟**、**CNI插件Pod状态**、**节点内核资源**(PID、fd、inotify)。 1. **容量规划**:定期评估集群容量,包括Pod数量、存储空间、IP地址池,提前扩容,避免触及极限。 1. **变更管控**:任何对集群的修改(升级、配置变更、应用部署)都要有回滚计划,并在非高峰期进行。 1. **混沌工程**:在测试集群定期模拟节点故障、网络分区、etcd压力等场景,验证系统的容错和恢复能力。 1. **知识沉淀**:将每次故障的排查过程、根因分析和解决方案记录成案,形成团队的“故障知识库”。 记住,Kubernetes集群的稳定性,不是一个开关,而是一个需要持续投入和精心维护的系统工程。从被动响应到主动防御,是你从“运维工程师”迈向“SRE”的关键一步。 “经一事,长一智”。希望这些用深夜和焦虑换来的经验,能帮你照亮下一次的排查之路。 **“无他,惟手熟尔”!**有需要的用起来! **如果你觉得这篇文章有用,欢迎点赞、转发、收藏、留言、推荐**❤!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册
修改密码
忘记密码