hanlp自然语言处理包的基本使用--python
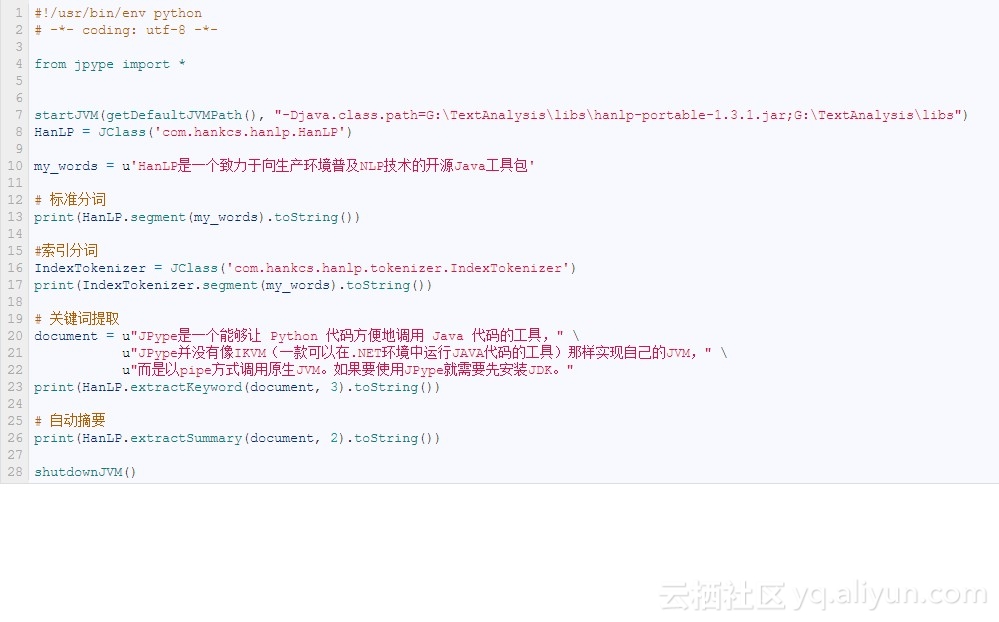
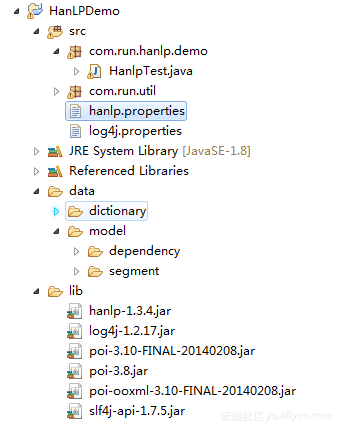
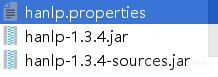
hanlp拥有:中文分词、命名实体识别、摘要关键字、依存句法分析、简繁拼音转换、智能推荐。 这里主要介绍一下hanlp的中文分词、命名实体识别、依存句法分析,这里就不介绍具体的hanlp的安装了,百度教程很多,可以看这里:http://hanlp.com/里面也有相关的一些介绍。 我以前还使用过jieba分词和LTP,综合来说,LTP是做的相对要好一点,特别是中文处理这一块,但是它的最大缺点是不开源,而hanlp功能更齐全而且开源,更加有利于大家的项目开发的使用。 首先使用hanlp对中文进行处理的前提是大家已经安装好了hanlp: 第一将这几个放在你的项目下, 然后点击hanlp.propertiess,更改 保证你的data数据在这个目录之下 下面贴上一些处理自然语言的基本方法(以下代码并非原创,来自于百度上的大神): #-*- coding:utf-8 -*- from jpype import * startJVM(getDefaultJVMPath(), "-Djava.class.path=D:\python_projects\zhengzebiaodashi\hanlp\hanlp-1.3.4.jar;D:\python_projects\zhengzebiaodashi\hanlp", "-Xms1g", "-Xmx1g") # 启动JVM,Linux需替换分号;为冒号: print("=" * 30 + "HanLP分词" + "=" * 30) HanLP = JClass('com.hankcs.hanlp.HanLP') # 中文分词 print(HanLP.segment('你好,欢迎在Python中调用HanLP的API')) print("-" * 70) print("=" * 30 + "标准分词" + "=" * 30) StandardTokenizer = JClass('com.hankcs.hanlp.tokenizer.StandardTokenizer') print(StandardTokenizer.segment('你好,欢迎在Python中调用HanLP的API')) print("-" * 70) # NLP分词NLPTokenizer会执行全部命名实体识别和词性标注 print("=" * 30 + "NLP分词" + "=" * 30) NLPTokenizer = JClass('com.hankcs.hanlp.tokenizer.NLPTokenizer') print(NLPTokenizer.segment('中国科学院计算技术研究所的宗成庆教授正在教授自然语言处理课程')) print("-" * 70) print("=" * 30 + "索引分词" + "=" * 30) IndexTokenizer = JClass('com.hankcs.hanlp.tokenizer.IndexTokenizer') termList = IndexTokenizer.segment("主副食品"); for term in termList: print(str(term) + " [" + str(term.offset) + ":" + str(term.offset + len(term.word)) + "]") print("-" * 70) print("=" * 30 + " N-最短路径分词" + "=" * 30) # CRFSegment = JClass('com.hankcs.hanlp.seg.CRF.CRFSegment') # segment=CRFSegment() # testCase ="今天,刘志军案的关键人物,山西女商人丁书苗在市二中院出庭受审。" # print(segment.seg("你看过穆赫兰道吗")) print("-" * 70) print("=" * 30 + " CRF分词" + "=" * 30) print("-" * 70) print("=" * 30 + " 极速词典分词" + "=" * 30) SpeedTokenizer = JClass('com.hankcs.hanlp.tokenizer.SpeedTokenizer') print(NLPTokenizer.segment('江西鄱阳湖干枯,中国最大淡水湖变成大草原')) print("-" * 70) print("=" * 30 + " 自定义分词" + "=" * 30) CustomDictionary = JClass('com.hankcs.hanlp.dictionary.CustomDictionary') CustomDictionary.add('攻城狮') CustomDictionary.add('单身狗') HanLP = JClass('com.hankcs.hanlp.HanLP') print(HanLP.segment('攻城狮逆袭单身狗,迎娶白富美,走上人生巅峰')) print("-" * 70) print("=" * 20 + "命名实体识别与词性标注" + "=" * 30) NLPTokenizer = JClass('com.hankcs.hanlp.tokenizer.NLPTokenizer') print(NLPTokenizer.segment('中国科学院计算技术研究所的宗成庆教授正在教授自然语言处理课程')) print("-" * 70) document = "水利部水资源司司长陈明忠9月29日在国务院新闻办举行的新闻发布会上透露," \ "根据刚刚完成了水资源管理制度的考核,有部分省接近了红线的指标," \ "有部分省超过红线的指标。对一些超过红线的地方,陈明忠表示,对一些取用水项目进行区域的限批," \ "严格地进行水资源论证和取水许可的批准。" print("=" * 30 + "关键词提取" + "=" * 30) print(HanLP.extractKeyword(document, 8)) print("-" * 70) print("=" * 30 + "自动摘要" + "=" * 30) print(HanLP.extractSummary(document, 3)) print("-" * 70) # print("="*30+"地名识别"+"="*30) # HanLP = JClass('com.hankcs.hanlp.HanLP') # segment = HanLP.newSegment().enablePlaceRecognize(true) # testCase=["武胜县新学乡政府大楼门前锣鼓喧天", # "蓝翔给宁夏固原市彭阳县红河镇黑牛沟村捐赠了挖掘机"] # for sentence in testCase : # print(HanLP.segment(sentence)) # print("-"*70) # print("="*30+"依存句法分析"+"="*30) # print(HanLP.parseDependency("徐先生还具体帮助他确定了把画雄鹰、松鼠和麻雀作为主攻目标。")) # print("-"*70) text = r"算法工程师\n 算法(Algorithm)是一系列解决问题的清晰指令,也就是说,能够对一定规范的输入,在有限时间内获得所要求的输出。如果一个算法有缺陷,或不适合于某个问题,执行这个算法将不会解决这个问题。不同的算法可能用不同的时间、空间或效率来完成同样的任务。一个算法的优劣可以用空间复杂度与时间复杂度来衡量。算法工程师就是利用算法处理事物的人。\n \n 1职位简介\n 算法工程师是一个非常高端的职位;\n 专业要求:计算机、电子、通信、数学等相关专业;\n 学历要求:本科及其以上的学历,大多数是硕士学历及其以上;\n 语言要求:英语要求是熟练,基本上能阅读国外专业书刊;\n 必须掌握计算机相关知识,熟练使用仿真工具MATLAB等,必须会一门编程语言。\n\n2研究方向\n 视频算法工程师、图像处理算法工程师、音频算法工程师 通信基带算法工程师\n \n 3目前国内外状况\n 目前国内从事算法研究的工程师不少,但是高级算法工程师却很少,是一个非常紧缺的专业工程师。算法工程师根据研究领域来分主要有音频/视频算法处理、图像技术方面的二维信息算法处理和通信物理层、雷达信号处理、生物医学信号处理等领域的一维信息算法处理。\n 在计算机音视频和图形图像技术等二维信息算法处理方面目前比较先进的视频处理算法:机器视觉成为此类算法研究的核心;另外还有2D转3D算法(2D-to-3D conversion),去隔行算法(de-interlacing),运动估计运动补偿算法(Motion estimation/Motion Compensation),去噪算法(Noise Reduction),缩放算法(scaling),锐化处理算法(Sharpness),超分辨率算法(Super Resolution),手势识别(gesture recognition),人脸识别(face recognition)。\n 在通信物理层等一维信息领域目前常用的算法:无线领域的RRM、RTT,传送领域的调制解调、信道均衡、信号检测、网络优化、信号分解等。\n 另外数据挖掘、互联网搜索算法也成为当今的热门方向。\n" print("=" * 30 + "短语提取" + "=" * 30) print(HanLP.extractPhrase(text, 10)) print("-" * 70) shutdownJVM() 但是我最近需要自定义一个词典,该怎么办呢,继续往下看: 第一:以**.txt命名自己的词典 第二:将其加入到hanlp.propertiess中,我加入的是poems.txt,如下 第三:删除CustomDictionary.txt.bin文件,然后运行代码,记住要等程序运行完哦,我加入的词典有47万行,运行了14分钟,不过后面运行就快了 # -*- coding:utf-8 -*- from jpype import * import time i=time.time() startJVM(getDefaultJVMPath(), "-Djava.class.path=D:\python_projects\zhengzebiaodashi\hanlp\hanlp-1.3.4.jar;D:\python_projects\zhengzebiaodashi\hanlp", "-Xms1g", "-Xmx1g") # 启动JVM,Linux需替换分号;为冒号: HanLP = JClass('com.hankcs.hanlp.HanLP') CustomDictionary = JClass('com.hankcs.hanlp.dictionary.CustomDictionary') list=HanLP.parseDependency("李白的诗有哪些?") print list j=time.time() print j-i shutdownJVM() 李白 李白 b b _ 3 定中关系 _ _ 的 的 uude1_1右附加关系 _ _ 诗 诗 n n _ 4 主谓关系 _ _ 有 有 v vyou _ 0 核心关系 _ _ 哪些 哪些 r ry _ 4 动宾关系 _ _ ? ? wp w _ 4 标点符号 _ _ 2.16999983788 大家有没有发现,李白的词性是b,这是什么鬼,其实这是我自己词典中添加的:李白b 200(词 词性 权值) 如果大家觉得有些词典不需要,可以将其路径删除,如下: 本文转自ybf&yyj的博客