首页 文章 精选 留言 我的

精选列表

搜索[弹性95],共10000篇文章
优秀的个人博客,低调大师

掌握Linux这30个常用指令,帮你解决95%以上的问题

2 --> Linux中许多常用命令是必须掌握的,这里将分享linux入门时常用的基本命令,希望对你们的学习有所帮助!!! 开始之前,分享给大家Linux的视频讲解,小白也可视频观看~ 视频中先从基础讲解Linux的来龙去脉,企业常用的Linux系统CentOS的安装,配置。 Linux十大种类命令的逐一讲解和示例。结合JAVA开发的Web应用。 在Linux搭建Web应用运行环境:JDK,MySQL,Tomcat在Linux的安装、配置、日志查看等。 以war形式部署Web应用。视频学习完能够满足在企业的实战要求。 在线观看:https://www.bilibili.com/video/BV1Li4y1V7pG 资料下载:http://www.bjpowernode.com/javavideo/132.html 文件目录指令 pwd指令 基本语法:pwd 用于显示当前目录的路径 实操案例: ls指令 基本语法: ls [选项] [目录或是文件] 常用选项 -a :显示当前目录所有的文件和目录,包括隐藏的。 -l :以列表的方式显示信息,相当于ll 实操案例: 列出当前目录下所有的文件和目录: cd指令 基本语法: cd [参数] 功能描述:切换到指定目录 常用参数 绝对路径(以/开头的目录)和相对路径(以目录名开头的目录,从当前目录下开始查找) cd ~ 或者cd :回到自己的主目录 cd .. 回到当前目录的上一级目录 实操案例: mkdir命令 基本语法: mkdir [选项] 要创建的目录 常用选项 -p :创建多级目录 实操案例: rmdir指令 基本语法:rmdir 目录 功能描述:删除一个空目录 实操案例: touch指令 基本语法:touch 文件名称列表 功能描述:创建一个或多个空文件 实操案例: cp指令 基本语法: cp [选项] source dest 常用选项: -r :递归复制整个文件夹 实操案例: rm指令 基本语法: rm [选项] 要删除的文件或目录 常用选项: -r :递归删除整个文件夹 -f :强制删除不提示 实操案例: mv指令 基本语法: mv oldNameFile newNameFile (功能描述:重命名) mv /temp/movefile /targetFolder (功能描述:移动文件) 实操案例: cat指令 基本语法: cat [选项] 要查看的文件名 常用选项 -n :显示行号 实操案例: more指令 基本语法:more 要查看的文件名 功能说明:more指令是一个基于VI编辑器的文本过滤器,它以全屏幕的方式按页显示文本文件的内容。 快捷键: 实操案例: less指令 基本语法:less 要查看的文件名 功能说明:less指令用来分屏查看文件内容,它的功能与more指令类似,但是比more指令更加强大,支持各种显示终端。less指令在显示文件内容时,并不是一次将整个文件加载之后才显示,而是根据显示需要加载内容,对于显示大型文件具有较高的效率。 快捷键: 实操案例: head指令 基本语法: head 文件(功能描述:默认查看文件头10行内容) head -n 5 文件(功能描述:查看文件头5行内容,5可以是任意行数) 实操案例: tail指令 基本语法: tail 文件(功能描述:默认查看文件尾10行内容) tail -n 5 文件(功能描述:查看文件尾5行内容,5可以是任意行数) 实操案例: echo指令 基本语法: echo [选项] [输出内容] 功能介绍:输出变量或常量内容到控制台 实操案例: >指令 基本语法: 查看指令 > 目标文件 功能说明:将前一个查看指令中的结果覆盖写入到目标文件中,如果目标文件不存在,则新建。 实操案例: >>指令 基本语法: 查看指令 >> 目标文件 功能说明:将前一个查看指令中的结果追加写入到目标文件中,如果目标文件不存在,则新建。 实操案例: 时间日期指令 date指令 基本语法: 1) date(功能描述:显示当前时间) 2) date +%Y(功能描述:显示当前年份) 3) date +%m(功能描述:显示当前月份) 4) date +%d(功能描述:显示当前是哪一天) 5) date "+%Y-%m-%d %H:%M:%S"(功能描述:显示年月日时分秒) 6) date -s 字符串时间(功能描述:设置日期) 实操案例: cal指令 基本语法: cal [选项](功能描述:不加选项,显示本月日历) 实操案例: 搜索查找指令 find指令 find指令将从指定目录向下递归地遍历其各个子目录,将满足条件的文件或者目录显示在终端。 基本语法:find [搜索范围] [选项] 选项说明: -name:按名称查找,支持通配符。 -user:按用户名查找 -size:按文件大小查找 实操案例: locate指令 基本语法:locate 要搜索的文件名 说明:locate指令可以快速在整个系统中定位文件路径。locate指令利用事先建立的系统中所有文件名称及路径的locate数据库实现快速定位给定的文件。locate指令无需遍历整个文件系统,查询速度较快。为了保证查询结果的准确度,管理员必须定期更新locate时刻。 实操案例: grep指令 基本语法: grep [选项] 查找的源文件内容 常用选项: -n:显示匹配行和行号 -i:忽略大小写 说明:grep 过滤查找,管道符,“|”,表示将前一个命令的处理结果输出传递给后面的命令处理。 实操案例: 压缩和解压缩指令 gzip指令 基本语法:gzip 文件 功能说明:压缩文件,将文件压缩为*.gz文件存放在原文件所在目录,压缩成功后会把原文件删除。用于压缩单个文件。 实操案例: gunzip指令 基本语法:gunzip 文件 功能说明:解压缩文件命令,解压成功后存放在原压缩文件所在目录,并且把原压缩文件删除。 实操案例: zip指令 基本语法: zip [选项] XXX.zip 将要压缩的内容 功能描述:将是指定文件或目录压缩成XXX.zip文件,用于压缩所有文件结构。 选项说明: -r:递归压缩,即压缩目录 实操案例: unzip指令 基本语法:unzip [选项] XXX.zip 常用选项: -d 目录:指定解压后文件的存放目录 实操案例: tar指令 基本语法: tar [选项] XXX.tar.gz [打包的内容] 功能描述:打包或者解压文件 选项说明: -c:产生.tar.gz打包文件 -v:显示详细信息 -f:指定压缩后的文件名 -z:打包同时压缩 -x:解压.tar.gz文件 -C: 指定解压到哪个目录 实操案例: 组管理指令 Linux组的基本介绍: 在linux中的每个用户必须属于一个组,不能独立于组外,可以改变用户所属组。 在linux中每个文件有所有者、所在的组、其它组,也可以改变文件所在组。 文件/目录的所有者 一般为文件的创建者,谁创建了该文件,就自然的成为该文件的所有者,默认情况下所有者所在的组也即使文件所在的组。 查看文件所有者和所在组指令 基本语法: ls –ahl 文件名 (a-all,h-human,l-list) 实操案例: 修改文件所有者指令 基本语法: chown 新所有者 文件名 chown newowner:newgroup file 同时修改用户的所有者和所有组 -R 如果是目录则使其下所有子文件或目录递归生效 功能说明:把文件所有者修改为指定的用户。 实操案例: 修改文件所在组指令 基本语法: chgrp 新组名 文件名 -R 如果是目录则使其下所有子文件或目录递归生效 功能描述:把文件所在组改为指定组 实操案例: 权限管理指令 权限基本介绍 这里所说的权限都是文件和目录的权限。在Linux中,每一个文件和目录都有自己的访问权限,通过文件列表可以查看到。 RWX权限详解 rwx作用到文件 1) [ r ]代表可读(read): 可以读取,查看 2) [ w ]代表可写(write): 可以修改,但是不代表可以删除该文件,删除一个文件的前提条件是对该文件所在的目录有写权限,才能删除该文件. 3) [ x ]代表可执行(execute):可以被执行 rwx作用到目录 1) [ r ]代表可读(read): 可以读取,ls查看目录内容 2) [ w ]代表可写(write): 可以修改,目录内创建+删除+重命名目录 3) [ x ]代表可执行(execute):可以进入该目录 rwx用数字表示 r=4(即2²),w=2(即2¹),x=1(即2º) 权限管理指令 修改文件/目录权限的指令chmod 第一种方式:通过r、w、x变更变更权限 1) chmod u=rwx,g=rx,o=x 文件目录名 2) chmod o+w 文件目录名 3) chmod a-x 文件目录名 说明:u、g、o、a分别代表文件所有者、文件所在组用户、其它组用户、所有用户=、+、-分别代表设置权限、增加权限、去掉权限 第二种方式:通过数字变更权限 chmod 一组三个数字 文件目录名 说明:r=4 w=2 x=1 rwx=4+2+1=7 实操案例:


优秀的个人博客,低调大师

开源大数据周刊-2018年08月03日 第95期

资讯 Apache Kafka 2.0.0 正式发布,分布式消息发布订阅系统 Apache Kafka 2.0.0 已正式发布,这是一个主要版本,新增了许多重要的新功能。此外还包括许多重要的 bug 修复和改进,其中还包括一些严重的错误修复。 如何解决AI的大数据困境?杨强提出联邦迁移学习 2018中国人工智能大会在深圳举行。会上,国际人工智能联合会(IJCAI)主席、AAAI/ACM/IEEE Fellow、香港科技大学教授杨强发表了题为《AI面临的挑战和迁移学习所带来的机遇》的演讲,谈到了AI发展遇到的大数据的困境以及解决办法。 Tableau发布2018.2版本 可拖放第三方应用功能到仪表板 Tableau公司近日推出Tableau 2018.2版本更新,该更新的扩展API能够让用户直接拖放第三方应用功能到仪表板。此外,在新推出的Tab

优秀的个人博客,低调大师

- 每天5分钟玩转 Docker 容器技术(95)

本节我们将创建三节点的 swarm 集群。 swarm-manager 是 manager node,swarm-worker1 和 swarm-worker2 是 worker node。 所有节点的 Docker 版本均不低于 v1.12。我们的实验环境 node 的操作系统为 Ubuntu 16.04,当然其他 Linux 也是可以的。 在 swarm-manager 上执行如下命令创建 swarm。 docker swarm init --advertise-addr 192.168.56.101 --advertise-addr指定与其他 node 通信的地址。 docker swarm init输出告诉我们: ① swarm 创建成功,swarm-manager 成为 manager node。 ② 添加 worker node 需要执行的命令。 ③ 添加 manager node 需要执行的命令。 执行docker node ls查看当前 swarm 的 node,目前只有一个 manager。 复制前面的docker swarm join命令,在 swarm-worker1 和 swarm-worker2 上执行,将它们添加到 swarm 中。命令输出如下: docker node ls可以看到两个 worker node 已经添加进来了。 如果当时没有记录下docker swarm init提示的添加 worker 的完整命令,可以通过docker swarm join-token worker查看。 注意:此命令只能在 manager node 上执行。 至此,三节点的 swarm 集群就已经搭建好了,操作还是相当简单的。 下一节我们将在 swarm 中部署第一个 service。 书籍: 1.《每天5分钟玩转Docker容器技术》https://item.jd.com/16936307278.html2.《每天5分钟玩转OpenStack》https://item.jd.com/12086376.html 本文转自CloudMan6 51CTO博客,原文链接:http://blog.51cto.com/cloudman/1983380

优秀的个人博客,低调大师

Serverless Spark的弹性利器 - EMR Shuffle Service

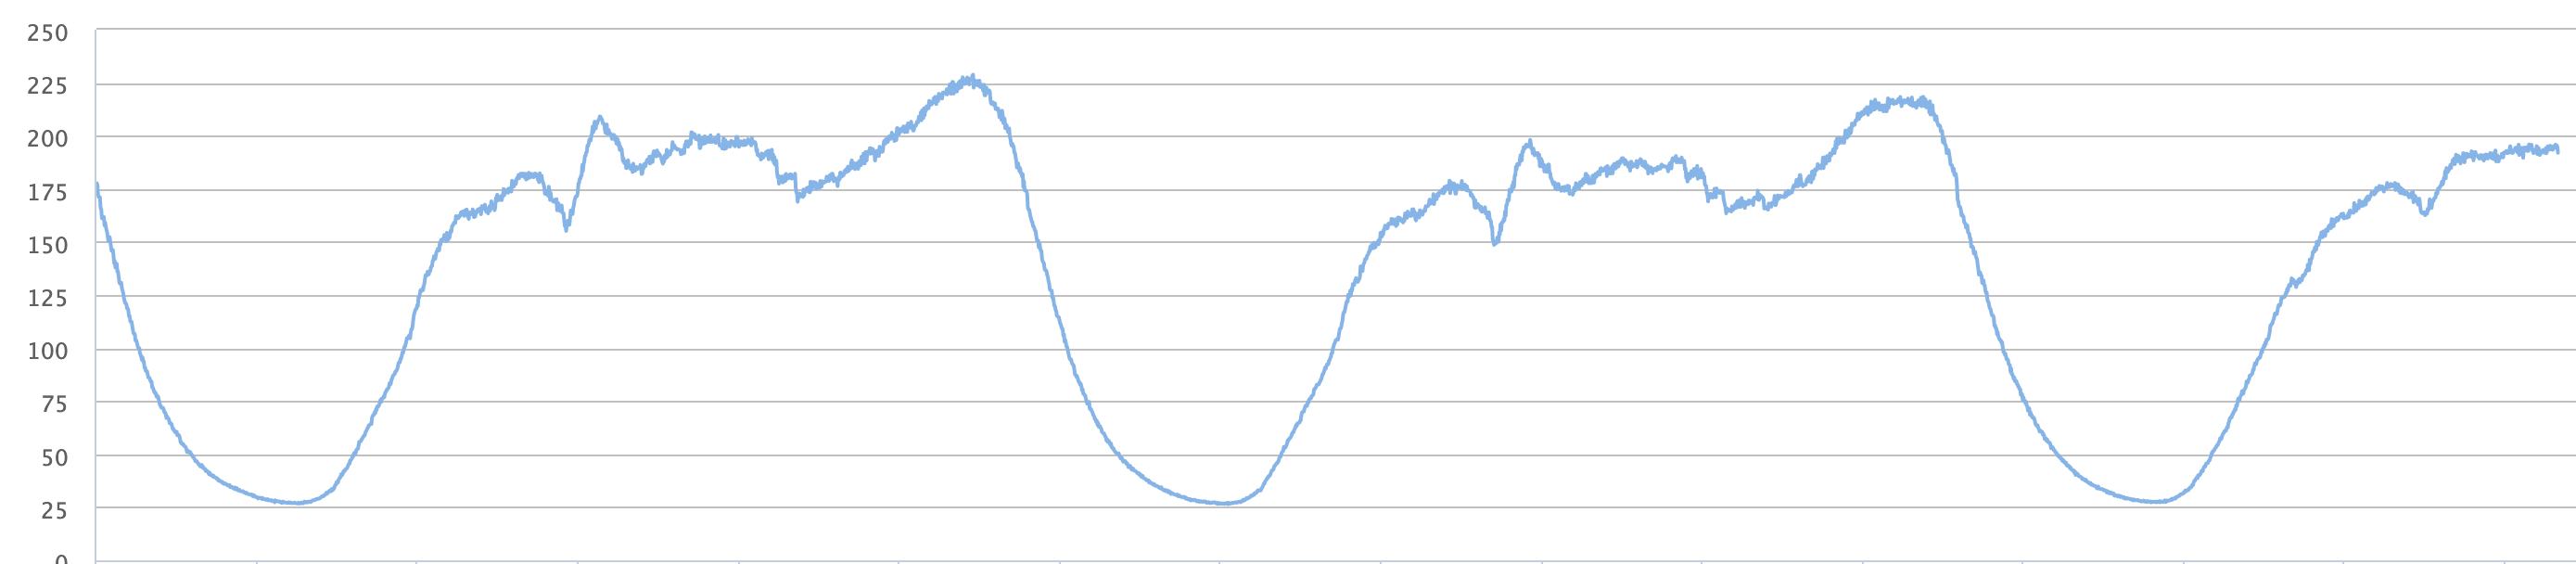
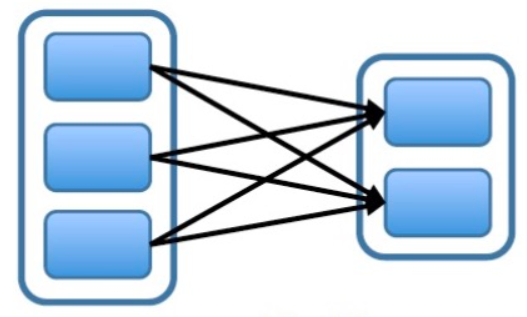
背景与动机 计算存储分离下的刚需 计算存储分离是云原生的重要特征。通常来讲,计算是CPU密集型,存储是IO密集型,他们对于硬件配置的需求是不同的。在传统计算存储混合的架构中,为了兼顾计算和存储,CPU和存储设备都不能太差,因此牺牲了灵活性,提高了成本。在计算存储分离架构中,可以独立配置计算机型和存储机型,具有极大的灵活性,从而降低成本。 存储计算分离是新型的硬件架构,但以往的系统是基于混合架构设计的,必须进行改造才能充分利用分离架构的优势,甚至不改造的话会报错,例如很多系统假设本地盘足够大,而计算节点本地盘很小;再例如有些系统在Locality上的优化在分离架构下不再适用。Spark Shuffle就是一个典型例子。众所周知,Shuffle的过程如下图所示。 每个mapper把全量shuffle数据按照partitionId排序后写本地文件,同时保存索引文件记录每个partition的offset和length。reduce task去所有的map节点拉取属于自己的shuffle数据。大数据场景T级别的shuffle数据量很常见,这就要求本地磁盘足够大,导致了跟计算存储分离架构的冲突。因此,需要重构传统的shuffle过程,把shuffle数据卸载到存储节点。 稳定性和性能 除了计算存储分离架构下的刚需,在传统的混合架构下,目前的shuffle实现也存在重要缺陷: 大量的随机读写和小数据量的网络传输。考虑1000 mapper * 2000 reducer的stage,每个mapper写128M shuffle数据,则属于每个reduce的数据量约为64k。从mapper的磁盘角度,每次磁盘IO请求随机读64K的数据; 从网络的角度,每次网络请求传输64k的数据:都是非常糟糕的pattern,导致大量不稳定和性能问题。因此,即使在混合架构下,重构shuffle也是很必要的工作。 EMR Shuffle Service设计 基于以上的动机,阿里云EMR团队设计开发了EMR Shuffle Service服务(以下称ESS),同时解决了计算存储分离和混合架构下的shuffle稳定性和性能问题。 整体设计 ESS包含三个主要角色: Master, Worker, Client。其中Master和Worker构成服务端,Client以不侵入方式集成到Spark里。Master的主要职责是资源分配和状态管理;Worker的主要职责是处理和存储shuffle数据;Client的主要职责是缓存和推送shuffle数据。整体流程如下所示(其中ResourceManager和MetaService是Master的组件): ESS采用Push Style的shuffle模式,每个Mapper持有一个按Partition分界的缓存区,Shuffle数据首先写入缓存区,每当某个Partition的缓存满了即触发PushData。 在PushData触发之前Client会检查本地是否有PartitionLocation信息,该Location规定了每个Partition的数据应该推送的Worker地址。若不存在,则向Master发起getOrAllocateBuffers请求。Master收到后检查是否已分配,若未分配则根据当前资源情况选择互为主从的两个Worker并向他们发起AllocateBuffer指令。Worker收到后记录Meta并分配内存缓存。Master收到Worker的ack之后把主副本的Location信息返回给Client。 Client开始往主副本推送数据。主副本Worker收到请求后,把数据缓存到本地内存,同时把该请求以Pipeline的方式转发给从副本。从副本收到完整数据后立即向主副本发ack,主副本收到ack后立即向Client回复ack。 为了不block PushData的请求,Worker收到PushData请求后会先塞到一个queue里,由专有的线程池异步处理。根据该Data所属的Partition拷贝到事先分配的buffer里,若buffer满了则触发flush。ESS支持多种存储后端,包括DFS和local。若后端是DFS,则主从副本只有一方会flush,依靠DFS的双副本保证容错;若后端是Local,则主从双方都会flush。 在所有的Mapper都结束后,Master会触发StageEnd事件,向所有Worker发送CommitFiles请求,Worker收到后把属于该Stage的buffer里的数据flush到存储层,close文件,并释放buffer。Master收到所有ack后记录每个partition对应的文件列表。若CommitFiles请求失败,则Master标记此Stage为DataLost。 在Reduce阶段,reduce task首先向Master请求该Partition对应的文件列表,若返回码是DataLost,则触发Stage重算或直接abort作业。若返回正常,则直接读取文件数据。 ESS的设计要点,一是采用PushStyle的方式做shuffle,避免了本地存储,从而适应了计算存储分离架构;二是按照reduce做了聚合,避免了小文件随机读写和小数据量网络请求;三是做了两副本,提高了系统稳定性。 容错 除了双副本和DataLost检测,ESS在容错上做了很多事情保证正确性。 PushData失败 当PushData失败次数(Worker挂了,网络繁忙,CPU繁忙等)超过MaxRetry后,Client会给Master发消息请求新的Partition Location,此后本Client都会使用新的Location地址。 若Revive是因为Client端而非Worker的问题导致,则会产生同一个Partition数据分布在不同Worker上的情况,Master的Meta组件会正确处理这种情形。 若发生WorkerLost,则会导致大量PushData同时失败,此时会有大量同一Partition的Revive请求打到Master。为了避免给同一个Partition分配过多的Location,Master保证仅有一个Revive请求真正得到处理,其余的请求塞到pending queue里,待Revive处理结束后返回同一个Location。 WorkerLost 当发生WorkerLost时,对于该Worker上的副本数据,Master向其peer发送CommitFile的请求,然后清理peer上的buffer。若Commit Files失败,则记录该Stage为DataLost;若成功,则后续的PushData通过Revive机制重新申请Location。 数据冗余 Speculation task和task重算会导致数据重复。解决办法是每个PushData的数据片里encode了所属的mapId,attemptId和batchId,并且Master为每个map task记录成功commit的attemtpId。read端通过attemptId过滤不同的attempt数据,并通过batchId过滤同一个attempt的重复数据。 ReadPartition失败 在DFS模式下,ReadPartition失败会直接导致Stage重算或abort job。在Local模式,ReadPartition失败会触发从peer location读,若主从都失败则触发Stage重算或abort job。 多backend支持 ESS目前支持DFS和Local两种存储后端。 跟Spark集成 ESS以不侵入Spark代码的方式跟Spark集成,用户只需把我们提供的Shuffle Client jar包配置到driver和client的classpath里,并加入以下配置即可切换到ESS方式: spark.shuffle.manager=org.apache.spark.shuffle.ess.EssShuffleManager 监控报警我们对ESS服务端进行了较为详尽的监控报警并对接了Prometheus和Grafana,如下所示: 性能数字 TeraSort的性能数字如下(2T, 4T, 10T规模): 10T规模TPC-DS的性能数字如下:

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册