首页 文章 精选 留言 我的

精选列表

搜索[医疗报告结构化],共10002篇文章
优秀的个人博客,低调大师

disruptor调研报告

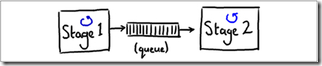
票池暂定使用disruptor来做消息队列,把最近对disruptor的调研结果整理一下。大部分文字都是把disruptor和其它网站上看到的资料翻译一下。 原文:http://www.oraclejavamagazine-digital.com/javamagazine/20120304/?pg=56&pm=1&u1=friend#pg56 Disruptor是什么? Disruptor是一个线程间通信的框架,即在多线程间共享数据。它是由LMAX公司开发的可信消息传递架构的一部分,以便用非常快速的方法来在多组件之间传递数据。它的一个核心思想是理解并适应硬件工作方式来达到最优的效果。 在很多(并行)架构里,普遍使用队列来共享数据(例如传递消息)。图1就是使用队列来传递消息的一个示意图(里面蓝色的小圈圈表示一个线程)。这种架构允许生产线程(图1里的stage1)在消费线程(图1里的stage2)处理不过来的情况下,还可以继续后面的工作,队列在其中用来做为消息的缓冲区。 图1 在最简单的情况下,disruptor可以用来替代图1架构里的队列,也就是线程间通过disruptor来传递数据。在disruptor里保存消息的数据结构是环状缓冲区(RingBuffer - 后面都用RingBuffer这个术语)。生产线程stage1将消息放到RingBuffer里,然后消费线程stage2从RingBuffer里读取消息,如图2。 图2 从图2里可以看到,RingBuffer里的每一个元素都有一个序列号(sequence number)来索引,RingBuffer维护当前最新放置的元素的序列号,这个序列号一直递增,(通过求余来得到元素在RingBuffer下面的数组下标)。 Disruptor的关键特性是无锁编程,这个是通过单一写线程的方式实现的 - 即一块数据永远只有一个线程写入。通过遵循这个编程原则来避免使用昂贵的同步锁或CAS操作,这就是为什么Disruptor这么快的原因。 因为RingBuffer规避了锁,而且每个EventProcessor维护自己的序列号。 向Disruptor发布消息 往RingBuffer里写入消息使用两步提交的方式。首先,生产线程Stage1需要确定RingBuffer里下一个空闲槽,如图3。 图3 RingBuffer维护了最后一次写入的序列号(图3里的18号),因此就可以推知下一个空闲的槽号。RingBuffer通过检查所有从RingBuffer读取消息的EventProcessor的序列号,以判别下一个槽号是否空闲。 图4演示了索取下一个空闲槽序列号的过程。 图4 当生产线程拿到了下一个序利号之后,它从RingBuffer里拿到槽里保存的对象并执行任何操作。这个过程中,因为RingBuffer的最新序列号依然是18,因此其它线程无法读取19号槽里面的事件 - 生产线程还在处理它。 图5 图5演示了RingBuffer在提交变更后的情况。当生产线程处理完第19号槽的数据后,它告诉RingBuffer将其公布出来。这个时候,RingBuffer才会更新它维护的序列号,任何等待读取第19号槽里的数据的线程才能读取它。 从RingBuffer里读取信息 Disruptor框架里提供了一个叫做BatchEventProcessor来从RingBuffer里读取数据。当生产线程向RingBuffer要求下一个可写入的空闲槽的序列号时,同时一个EventProcessor(类似消费者,但其并消费RingBuffer里的元素 - 即不从RingBuffer里移除任何元素)也会维护其最后所处理的数据的序列号,并要求下一个可处理的数据的序列号。 图6演示了EventProcessor等待处理下一个可读取数据序利号的过程。 图6 EventProcessor不是直接从RingBuffer里获取下一个可读取数据的序列号,而是通过一个SequenceBarrier对象来做的,稍后我们谈这个细节。 图6里,EventProcessor(即消费者线程Stage2)最后看到的是第16号槽的数据,它希望处理下一个(第17号)槽的数据,因此它执行SequenceBarrier的waitFor(17)函数调用。线程Stage2可以一直等待下一个可读序列号,因为如果尚没有数据生产出来的话,它什么也不需要做。但跟图6所示的一样,RingBuffer里最新可用数据已经到18号槽了,因此waitFor返回18,即告诉EventProcessor可以一直读到第18号的所有数据。如图7。 图7 这种模式提供了很好的批处理行为,可以使用这种批处理代码来实现EventHandler,在Disruptor里性能测试FizzBuzzEventHandler就是一个很好的例子。 处理系统组件之间的依赖关系 Disruptor处理系统内部多组件的依赖关系,而不引入任何线程竞争的做法很有意思。Disruptor遵循的是单线程写入,多线程读取的做法。Disruptor的原始设计是支持几步具有特定顺序的串行流水线操作 - 这种操作在企业级的系统里很常见。图8演了一个标准的三步流水线操作: 图8 首先,所有事件都会写入硬盘(日志“Journaling”操作),以便容灾恢复。第二所有事件会备份(Replication操作)到第二台服务器上,只有这些步骤都完成之后系统才能处理实际的业务操作(Business Logic)。 串行做这三步操作是一个合理的做法,但不是最有效率的。日志和备份操作可以并行,因为它们相互独立。但业务操作不行,因为它依赖前两者,图9演示了这个依赖关系。 图9 如果使用Disruptor,前两步(日志和备份)可以直接读RingBuffer。跟图7示意的,它们都使用一个屏障(Sequence Barrier)来得到RingBuffer下一个可读取的序列号。它们各自维护自己的序列号,这样方便它们自己知道已经读到哪了,并使用BatchEventProcessor来处理事件(日志和备份)。 业务线程也会从同一个RingBuffer里读取事件,不过只能处理前两个线程处理完的事件。这个限制通过第二个SequenceBarrier来实现,它被配置来读取日志线程和备份线程的序列号,返回它们的最小值,以告诉业务线程安全读取的范围。 只有每一个EventProcessor都使用序列号屏障(Sequence Barrier)来确定可以安全处理的事件范围,才能从RingBuffer里读取数据。如图10。 图10 虽然有很多线程读取不同的序利号,但由于都是简单递增自己内部的序利号,所以线程间没有竞争。 多个生产线程 Disruptor也支持,但是本文没有说如何支持,放在后面写。 结论 虽然disruptor的原理已经比较熟悉了,但是其API还不是很了解,我写了一个实验性的代码,来完善我的理解 - 不过随着理解的深入,代码会不断更新: https://github.com/shiyimin/12306ngpm/blob/8be9178d318618f905aaed45fa6025df09371c31/trunk/tpms/src/test/java/org/ng12306/tpms/DisruptorConceptProofTest.java 本文转自 donjuan 博客园博客,原文链接: http://www.cnblogs.com/killmyday/archive/2012/12/02/2798218.html,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册