首页 文章 精选 留言 我的

精选列表

搜索[编译原理],共10000篇文章
优秀的个人博客,低调大师

Hadoop 2.6 MapReduce运行原理详解

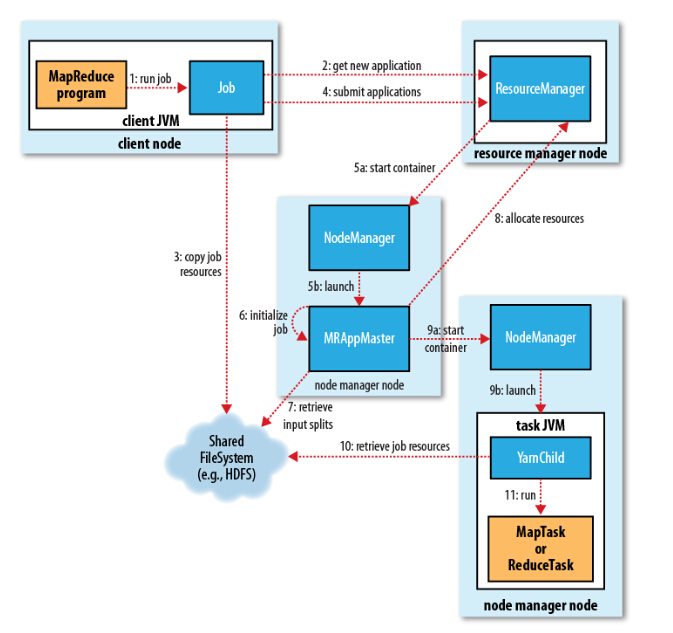
市面上的hadoop权威指南一类的都是老版本的书籍了,索性学习并翻译了下最新版的Hadoop:The Definitive Guide, 4th Edition与大家共同学习。 我们通过提交jar包,进行MapReduce处理,那么整个运行过程分为五个环节: 1、向client端提交MapReduce job. 2、随后yarn的ResourceManager进行资源的分配. 3、由NodeManager进行加载与监控containers. 4、通过applicationMaster与ResourceManager进行资源的申请及状态的交互,由NodeManagers进行MapReduce运行时job的管理. 5、通过hdfs进行job配置文件、jar包的各节点分发。 Job 提交过程 job的提交通过调用submit()方法创建一个JobSubmitter实例,并调用submitJobInternal()方法。整个job的运行过程如下: 1、向ResourceManager申请application ID,此ID为该MapReduce的jobId。 2、检查output的路径是否正确,是否已经被创建。 3、计算input的splits。 4、拷贝运行job 需要的jar包、配置文件以及计算input的split 到各个节点。 5、在ResourceManager中调用submitAppliction()方法,执行job Job 初始化过程 1、当resourceManager收到了submitApplication()方法的调用通知后,scheduler开始分配container,随之ResouceManager发送applicationMaster进程,告知每个nodeManager管理器。 2、由applicationMaster决定如何运行tasks,如果job数据量比较小,applicationMaster便选择将tasks运行在一个JVM中。那么如何判别这个job是大是小呢?当一个job的mappers数量小于10个,只有一个reducer或者读取的文件大小要小于一个HDFS block时,(可通过修改配置项mapreduce.job.ubertask.maxmaps,mapreduce.job.ubertask.maxreduces以及mapreduce.job.ubertask.maxbytes 进行调整) 3、在运行tasks之前,applicationMaster将会调用setupJob()方法,随之创建output的输出路径(这就能够解释,不管你的mapreduce一开始是否报错,输出路径都会创建) Task 任务分配 1、接下来applicationMaster向ResourceManager请求containers用于执行map与reduce的tasks(step 8),这里map task的优先级要高于reduce task,当所有的map tasks结束后,随之进行sort(这里是shuffle过程后面再说),最后进行reduce task的开始。(这里有一点,当map tasks执行了百分之5%的时候,将会请求reduce,具体下面再总结) 2、运行tasks的是需要消耗内存与CPU资源的,默认情况下,map和reduce的task资源分配为1024MB与一个核,(可修改运行的最小与最大参数配置,mapreduce.map.memory.mb,mapreduce.reduce.memory.mb,mapreduce.map.cpu.vcores,mapreduce.reduce.reduce.cpu.vcores.) Task 任务执行 1、这时一个task已经被ResourceManager分配到一个container中,由applicationMaster告知nodemanager启动container,这个task将会被一个主函数为YarnChild的java application运行,但在运行task之前,首先定位task需要的jar包、配置文件以及加载在缓存中的文件。 2、YarnChild运行于一个专属的JVM中,所以任何一个map或reduce任务出现问题,都不会影响整个nodemanager的crash或者hang。 3、每个task都可以在相同的JVM task中完成,随之将完成的处理数据写入临时文件中。 Mapreduce数据流 运行进度与状态更新 1、MapReduce是一个较长运行时间的批处理过程,可以是一小时、几小时甚至几天,那么Job的运行状态监控就非常重要。每个job以及每个task都有一个包含job(running,successfully completed,failed)的状态,以及value的计数器,状态信息及描述信息(描述信息一般都是在代码中加的打印信息),那么,这些信息是如何与客户端进行通信的呢? 2、当一个task开始执行,它将会保持运行记录,记录task完成的比例,对于map的任务,将会记录其运行的百分比,对于reduce来说可能复杂点,但系统依旧会估计reduce的完成比例。当一个map或reduce任务执行时,子进程会持续每三秒钟与applicationMaster进行交互。 Job 完成 最终,applicationMaster会收到一个job完成的通知,随后改变job的状态为successful。最终,applicationMaster与task containers被清空。 Shuffle与Sort 从map到reduce的过程,被称之为shuffle过程,MapReduce使到reduce的数据一定是经过key的排序的,那么shuffle是如何运作的呢? 当map任务将数据output时,不仅仅是将结果输出到磁盘,它是将其写入内存缓冲区域,并进行一些预分类。 1、The Map Side 首先map任务的output过程是一个环状的内存缓冲区,缓冲区的大小默认为100MB(可通过修改配置项mpareduce.task.io.sort.mb进行修改),当写入内存的大小到达一定比例,默认为80%(可通过mapreduce.map.sort.spill.percent配置项修改),便开始写入磁盘。 在写入磁盘之前,线程将会指定数据写入与reduce相应的patitions中,最终传送给reduce.在每个partition中,后台线程将会在内存中进行Key的排序,(如果代码中有combiner方法,则会在output时就进行sort排序,这里,如果只有少于3个写入磁盘的文件,combiner将会在outputfile前启动,如果只有一个或两个,那么将不会调用) 这里将map输出的结果进行压缩会大大减少磁盘IO与网络传输的开销(配置参数mapreduce.map .output.compress 设置为true,如果使用第三方压缩jar,可通过mapreduce.map.output.compress.codec进行设置) 随后这些paritions输出文件将会通过HTTP发送至reducers,传送的最大启动线程通过mapreduce.shuffle.max.threads进行配置。 2、The Reduce Side 首先上面每个节点的map都将结果写入了本地磁盘中,现在reduce需要将map的结果通过集群拉取过来,这里要注意的是,需要等到所有map任务结束后,reduce才会对map的结果进行拷贝,由于reduce函数有少数几个复制线程,以至于它可以同时拉取多个map的输出结果。默认的为5个线程(可通过修改配置mapreduce.reduce.shuffle.parallelcopies来修改其个数) 这里有个问题,那么reducers怎么知道从哪些机器拉取数据呢? 当所有map的任务结束后,applicationMaster通过心跳机制(heartbeat mechanism),由它知道mapping的输出结果与机器host,所以reducer会定时的通过一个线程访问applicationmaster请求map的输出结果。 Map的结果将会被拷贝到reduce task的JVM的内存中(内存大小可在mapreduce.reduce.shuffle.input.buffer.percent中设置)如果不够用,则会写入磁盘。当内存缓冲区的大小到达一定比例时(可通过mapreduce.reduce.shuffle.merge.percent设置)或map的输出结果文件过多时(可通过配置mapreduce.reduce.merge.inmen.threshold),将会除法合并(merged)随之写入磁盘。 这时要注意,所有的map结果这时都是被压缩过的,需要先在内存中进行解压缩,以便后续合并它们。(合并最终文件的数量可通过mapreduce.task.io.sort.factor进行配置) 最终reduce进行运算进行输出。 参考文献:《Hadoop:The Definitive Guide, 4th Edition》

优秀的个人博客,低调大师

Hadoop I/O操作原理整理

I/O操作中的数据检查 校验和方式是检查数据完整性的重要方式。一般会通过对比新旧校验和来确定数据情况,如果两者不同则说明数据已经损坏。比如,在传输数据前生成了一个校验和,将数据传输到目的主机时再次计算校验和,如果两次的校验结果不同,则说明数据已经损坏。因为Hadoop采用HDFS作为默认的文件系统,因此具有两方面的数据完整性。 1、本地文件I/O的检查 本地文件系统的数据完整性由客户端负责,重点是在存储和读取文件时进行校验和的处理。每当Hadoop创建文件a时,Hadoop就会同时在同一文件夹下创建隐藏文件a.crc,这个文件记录了文件a的校验和。针对数据文件的大小,每512字节Hadoop就会生成一个32位的校验和(4字节)。 2、对HDFS的I/O数据进行检查 DataNode接收数据后,存储数据前。它接收数据一般有两种情况:一是用户从客户端上传数据;二是DataNode从其他DataNode上接收数据。Hadoop不会在数据每流动到一个DataNode时都检查校验和,它只会在数据流动到最后一个节点时检验校验和。 3、在MapReduce程序中使用压缩 设置Map处理后数据的压缩代码示例如下: JobConf conf = new JobConf(); conf.setBoolean("mapred.compree.map.output",true); //设置output输出压缩 conft.setBoolean("mapred.output.compress",true); conf.setClass("mapred.output.compression.codec",GzipCodec.class,CompressionCodec.class); 4、数据的I/O中序列化操作 序列化是将对象转化为字节流的方法,或者说用字节流描述对象的方法。与序列化相对的是反序列化,反序列化是将字节流转化为对象的方法。序列化有两个目的:进程间通信;数据持久性存储。 Hadoop采用RPC来实现进程间通信,一般而言,RPC的序列化机制有以下特点: 紧凑:紧凑的格式可以充分利用带宽,加快传输速度。 快速:能减少序列化和反序列化的开销,这会有效减少进程间通信的时间。 可扩展:可以逐步改变。 在Hadoop中,并没有采用JAVA提供的序列化机制,而是自己重新写了一个序列化机制Writables。Writables具有紧凑、快速的优点。但不易拓展。 Text 这是Hadoop中对string类型的重写,但是又与其有一些不同。Text使用标准的UTF-8编码,同时Hadoop使用变长类型VInt来存储字符串,其存储上线是2GB。Text类型与String类型的主要差别在于: 1、 Stirng的长度定义为String包含的字符个数;Text的长度定义为UTF-8编码的字节数。 2、String内的indexOf()方法返回的是char类型字符的索引。Text的find()方法返回的是字节偏移量。 3、String的charAt()方法返回的是指定位置的char字符;而Text的charAT()方法需要指定偏移量。 SequenceFile类 SequenceFile记录的是key/value对的列表,是序列化之后的二进制文件,因此是不能直接查看的。可通过:hadoop fs -text mySequenceFile查看 参考:《Hadoop实战》

优秀的个人博客,低调大师

快速笔记02-MySQL主从复制原理半同步操作步骤及原理

==========================================================一:MySQL主从复制规划 主库:(MySQLmaster)IP:10.0.0.52PROT:3306从库1:(MySQLslave)IP:10.0.0.52PORT:3307从库2:(MySQLslave)IP:10.0.0.52PORT:3308 ==========================================================二:检查环境(1)检查MySQL数据库多实例是否启动 netstat-lntup|grep330tcp000.0.0.0:33060.0.0.0:*LISTEN20434/mysqldtcp000.0.0.0:33070.0.0.0:*LISTEN15120/mysqldtcp000.0.0.0:33080.0.0.0:*LISTEN19578/mysqld (2)开启MySQL主库的Binlog功能 greplog-bin/data/3306/my.cnf (3)设置server-id,此处ID不可以相同否则最后出现IO错误 grepserver-id/data/{3306,3307,3308}/my.cnf/data/3306/my.cnf:server-id=1/data/3307/my.cnf:server-id=3/data/3308/my.cnf:server-id=8 ==========================================================三:因为从库现在还没有数据,或者数据不统一我们需要导入数据 wgetftp://10.0.0.1/backup-mysql-salt.tar.gztarxfbackup-mysql-salt.tar.gzzcat/root/bak_2016-07-27.sql.gz|mysql-uroot-poldboy-S/data/3306/mysql.sockmysql-uroot-poldboy-S/data/3306/mysql.sockshowdatabases;#检查数据库是否导入selectuser,hostfrommysql.user; ==========================================================四:主库上面的操作(3306)(1)主库需要授权slave访问的用户rep mysql-uroot-poldboy-S/data/3306/mysql.sock#登录第一个实例的MySQL数据库grantreplicationslaveon*.*to'rep'@'172.16.1.%'identifiedby'oldboy123';flushprivileges;showgrantsforrep@'172.16.1.%';#查看用户的权限selectuser,hostfrommysql.user; 提示:replication slave 为mysql同步的必须权限,此处不要授权all权限(2)锁表、查看binlog文件及位置点,主库导出全备,需要锁表(-x –master-date=2) flushtablewithreadlock;#锁表,窗口不能退出,退出失效showmasterstatus;#锁表后查看主库状态,临界点,将来恢复就从0004开始|mysql-bin.000004|600457||| (3)将MySQL主库的数据进行备份 mkdir/server/backup/-pmysqldump-uroot-poldboy123-S/data/3306/mysql.sock-A-B--events|gzip>/server/backup/rep3307_bak$(date+%F).sql.gz#由于之前导入的数据库为全量的所以以前的密码为oldboy123ls-lrt/server/backup/ (4)解锁MySQL数据库的数据表,并查看msater的状态 unlocktable;#解锁MySQL数据库的数据表showmasterstatus; 提示:如果解锁之后还是mysql-bin.000004 说明是正确的,如果动了说明没有锁住表提示:如果mysqldump 加了-F 他就会更改刷新binlog 五:从库1上面的操作(3307)提示:一定要确保从库的server_id与从库的不同 grepserver-id/data/{3306,3307}/my.cnf/data/3306/my.cnf:server-id=1/data/3307/my.cnf:server-id=3 (1)把主库的备份数据导入到从库 cd/server/backup/gzip-drep3307_bak2016-07-29.sql.gzmysql-uroot-poldboy-S/data/3307/mysql.sock<rep3307_bak2016-07-29.sql 提示从库的密码为oldboy(2)登录从库检查主库1查看数据是否导入成功 mysql-uroot-poldboy-S/data/3307/mysql.sockshowdatabases;selectuser,hostfrommysql.user; (3)刷新用户的权限 flushprivileges; (4)查找位置点,配置master.info,以下为主库的位置点 showmasterstatus;(主数据库执行此命令)|mysql-bin.000004|600457|||CHANGEMASTERTOMASTER_HOST='172.16.1.52',#这是主库的IP(域名也可以需要做解析)MASTER_PORT=3306,#主库的端口,从库端口和主库不可以相同MASTER_USER='rep',#这是主库上创建用来复制的用户repMASTER_PASSWORD='123456'#rep的密码MASTER_LOG_FILE='mysql-bin.000025',#这里是showmasterstatus时看到的查询二进制日志文件名称,这里不能多空格MASTER_LOG_POS=9155;#这里是showmasterstatus时看到的二进制日志偏移量,不能多空格 提示:3307操作此步:会在/data/3307/data下面产生master.info文件(5)登录3307从库,配置复制参数,去掉上述语句中的注释,执行如下 mysql-uroot-poldboy-S/data/3307/mysql.sockCHANGEMASTERTOMASTER_HOST='172.16.1.61',MASTER_PORT=3306,MASTER_USER='rep',MASTER_PASSWORD='oldboy123',MASTER_LOG_FILE='mysql-bin.000003',MASTER_LOG_POS=600457;QueryOK,0rowsaffected(0.02sec)#出现此信息表示成功 提示:3307操作此步:会在/data/3307/data下面产生master.info文件 ll/data/3307/data/master.info (6)上述步骤成功后,开启从库复制开关。 startslave;showslavestatus\G#G后面一定不要加封号,会报错的 (7)主从是否成功,最关键的为下面的3项状态参数 mysql-uroot-poldboy123-S/data/3307/mysql.sock-e"showslavestatus\G"|egrep"IO_Running|SQL_Running|_Behind_Master"Slave_IO_Running:Yes#这个是I/O线程状态,状态为Yes表示I/O线程工作正常Slave_SQL_Running:Yes#这个是SQL线程状态,状态为Yes表示I/O线程工作正常Seconds_Behind_Master:0#这是个复制过程中,从库比主库的延迟的秒数 (8)测试主库与从库是否同步1.在主库添加一个新的数据库chris createdatabasechris; 2.检查从库是否有chris这个数据库 mysql>showdatabases;|chris| 删除主库的chirs数据库检查从库是否删除 dropdatabasechris;(主库执行)mysql>showdatabases;(从库执行) ==========================================================六:从库2上的操作(3308)快速配置思路:因为我们已经有了一个MySQL从库,所以只需将3307的从库复制到3308即可(1)从主库中导出数据库,导入从库 mysqldump-uroot-poldboy123-S/data/3306/mysql.sock-B-F--master-data=1-A--events|gzip>/server/backup/rep3308_bak$(date+%F).sql.gz提示:--master-data=1会将备份时的位置点记录下来CHANGEMASTERTOMASTER_LOG_FILE='mysql-bin.000009',MASTER_LOG_POS=107; (2)将数据导入从库3308 cd/server/backup/gzip-drep3308_bak2016-07-29.sql.gzmysql-uroot-poldboy-S/data/3308/mysql.sock<./rep3308_bak2016-07-29.sql (3)检查3308数据库是否生成master.info文件 ll/data/3308/data/master.info (4)登录3308从库,配置复制参数 mysql-uroot-poldboy-S/data/3308/mysql.sockCHANGEMASTERTOMASTER_HOST='172.16.1.52',MASTER_PORT=3306,MASTER_USER='rep',MASTER_PASSWORD='oldboy123'; (5)上述步骤成功后,开启从库复制开关。 startslave;showslavestatus\G#G后面一定不要加封号,会报错的 (6)主从是否成功,最关键的为下面的3项状态参数 mysql-uroot-poldboy123-S/data/3307/mysql.sock-e"showslavestatus\G"|egrep"IO_Running|SQL_Running|_Behind_Master"Slave_IO_Running:Yes#这个是I/O线程状态,状态为Yes表示I/O线程工作正常Slave_SQL_Running:Yes#这个是SQL线程状态,状态为Yes表示I/O线程工作正常Seconds_Behind_Master:0#这是个复制过程中,从库比主库的延迟的秒数 ==========================================================七:当我们使用show slave status\G查看主从复制出现故障时,可以看情况跳过(1)临时停止同步开关 stopslave; (2)将同步指针向下移动一个,如果多次不同步可以重复操作 setglobalsql_slave_skip_counter=1; (3)开启同步开关 startslave; (4)查看同步信息是否正常 showslavestatus\G ==========================================================八:测试主库与从库是否可以实现同步 mysql-uroot-poldboy123-S/data/3306/mysql.sockmysql-uroot-poldboy123-S/data/3307/mysql.sockmysql-uroot-poldboy123-S/data/3308/mysql.sock (1)在主库上创建一个数据库 createdatabaseliyajin;(主库执行) (2)查看从库1,从库2是否有同步过来 showdatabases;(从库1执行)|liyajin|showdatabases;(从库2执行)|liyajin| (3)将主库中的liyajin数据库删除, mysql>dropdatabaseliyajin;(主库执行) (4)查看从库是否也会删除 showdatabases;(从库1执行)showdatabases;(从库2执行) (5)最后查看从库的同步状态是否有错误,如果没有错误则MySQL主从复制配置成功 showslavestatus\G 提示:一般删除数据库都会有提示同步错误,我们需要设置忽略错误即可 九:现在我们来将配置好的MySQL数据库打包成RPM包 依赖包:ncurses-devellibaio-develcmake 将LAMP环境进行RPM打包 (1):设置打包完成后执行的脚本 mkdir/server/scripts/-pvim/server/scripts/mysql-init.sh#!/bin/bashuseradd-u505mysql-s/sbin/nologin-Mchown-Rmysql.mysql/data//data/3306/mysqlstart/data/3307/mysqlstart/data/3308/mysqlstart\cp/application/mysql/bin/*/usr/local/sbin/cat>>/etc/rc.local<<EOF#mysqlmultiinstances/data/3306/mysqlstart/data/3307/mysqlstart/data/3308/mysqlstartEOF (3):LAP一键RPM包打包(打包以前要关闭数据库) /data/3306/mysqlstop/data/3307/mysqlstop/data/3308/mysqlstopfpm-sdir-trpm-nmysqld-v1.0--description'3306,3307,3308'-d'ncurses-devellibaio-develcmake'--post-install/server/scripts/mysql-init.sh/application/usr/local/lib//usr/local/bin//data/ 总结:三个实例数据库密码都是oldboy123(4)将制作完成的RPM上传到服务器上安装即可 yum-ylocalinstalllamp-1.0-1.x86_64.rpm (5)安装完成以后的检查80与3306端口是否打开 ll/application/netstat-ltnp (2)配置YUM客户端-客户端配置 cd/etc/yum.repos.d/rm-f/etc/yum.repos.d/{CentOS-Base.repo,epel.repo}mvCentOS-Base.repoCentOS-Base.repo.bakcat>/etc/yum.repos.d/etiantian.repo<<EOF[etiantian]name=Serverbaseurl=http://10.0.0.61enabled=1gpgcheck=0EOFyumcleanallyummakecacheyumrepolistcd

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册