首页 文章 精选 留言 我的

精选列表

搜索[多人音视频房间 SDK],共10000篇文章
优秀的个人博客,低调大师

阿里云牵手战旗直播:让500万人进入1个直播房间

6月10日,在云栖大会·上海峰会上,战旗直播和阿里云宣布达成战略合作。 即日起,战旗直播作为国内高清游戏直播第一平台,阿里云将为其提供内容接入与分发网络和大规模分布转码技术、灾备方案,及图像语音处理等人工智能方案。 知情人士透露,关于战旗直播和阿里云的合作,双方在去年11月就已开始磋商。2016年在直播行业迅速生长的催化下,战旗直播在线人数陡增,VR直播等直播形式一夜兴起。多元化的需求让战旗直播转向了云计算服务------阿里云。 “直播公司激增,从竞争中突破的关键是技术。”战旗直播CTO许先地表示:“因为技术的发展把直播行业的门槛降得很低,而这恰恰需要更强大的技术,来百分百保障直播画面的流畅度和用户体验,从而在混战中形成强壁垒。” 据悉,阿里云智能调度、就近接入及多路切换的分发网络(CDN)及人工智能全面解决方案,拥有1000多全

优秀的个人博客,低调大师

为什么越来越多人使用WebFlux?

## **前言** > 从同步阻塞到异步非阻塞,Java Web开发的又一次革命 最近在做技术选型评审的时候,发现了一个非常有意思的现象——**越来越多的新项目在技术选型时,把Spring WebFlux写进了方案里**。 有个小伙伴跟我说:“三哥,我看了网上的文章,有人说WebFlux性能炸裂,有人说WebFlux学习曲线太陡,还有人说要回归同步编程。我都不知道该信谁了。” 这个问题问得很到位。 WebFlux从Spring 5.0引入到现在已经快10年了,关于它的讨论从来没有停止过。 有人说它是“未来”,有人说它是“花架子”。 那真相到底是什么? 今天这篇文章就专门跟大家一起聊聊WebFlux,希望对你会有所帮助。 ## **一、WebFlux到底要解决什么问题?** > 有些小伙伴在工作中可能会说:“我用Spring MVC用了好多年了,感觉也挺好的啊,为什么要学WebFlux?” 在回答这个问题之前,我们先看一个典型的Spring MVC控制器: ``` @RestController public class OrderController { @GetMapping("/order/{id}") public Order getOrder(@PathVariable Long id) { // 调用外部接口获取数据,可能需要2秒 User user = userService.getUser(order.getUserId()); // 线程在这里阻塞2秒! return order; } } ``` 问题出在哪里? 当请求到达服务器时,Servlet容器(如Tomcat)会从线程池中分配一个工作线程来处理这个请求。 在这个线程执行`userService.getUser()`的整整2秒钟里,这个线程什么也做不了,只能空转、等待。 它无法去处理其他已经到达的请求。 如果同一时间有1000个这样的并发请求,Tomcat就需要准备至少1000个线程来应对。 每个线程都消耗约1MB的栈内存,当线程数超过物理核心承载能力,大量的时间将浪费在线程上下文切换上,最终可能因资源耗尽而崩溃。 这就是**“一个请求,一个线程”** 的阻塞模型在I/O密集型场景下的天然瓶颈。 我们投入了大量资源(线程),仅仅是为了“等待”,而不是“计算”。 ![](https://developer.qcloudimg.com/http-save/yehe-5604447/c3f4909027695883c22673cc9465c726.jpg) **核心问题:线程在等待I/O时完全空闲,但资源却被占着不放。** 有些小伙伴可能已经通过增大线程池、服务拆分等方式缓解了这个问题,但这本质上是“用资源换吞吐量”,并非最优解。 当你的系统需要支撑**数万并发连接**时,这种“堆线程”的方式迟早会遇到天花板。 WebFlux要解决的问题,就是**用更少的资源,支撑更高的并发**。 ## **二、异步非阻塞 + 响应式流** WebFlux的哲学截然不同。 它源于**响应式编程**范式,核心目标是:**用少量、固定的线程,处理大量并发请求**。 如何做到? 答案是**事件驱动 + 异步非阻塞I/O**。 它不再让线程傻等,而是告诉系统:“我去做点别的,等数据准备好了,你再回调通知我。” ### **2.1 线程模型对比** 这是理解WebFlux最关键的一张图: |对比维度|Spring MVC|Spring WebFlux| | --- | --- | --- | |编程模型|命令式 / 同步阻塞|声明式 / 异步非阻塞 + 响应式流| |线程模型|Thread-per-Request(每个请求一个线程)|Event-Loop + 少量线程(Netty默认)| |I/O模型|阻塞式I/O|非阻塞式I/O| |并发能力|线程池大小决定(通常200-500)|理论上可达数万~数十万连接| |背压支持|无|原生支持(Reactive Streams规范)| |默认服务器|Tomcat / Jetty|Netty(或Undertow)| **WebFlux的线程模型完全是另一种思路**: ![](https://developer.qcloudimg.com/http-save/yehe-5604447/65ec967a658a9c457947b854f35418b3.jpg) 少量线程通过**事件循环**处理所有请求,I/O操作不阻塞线程,完成后通过回调通知。单个线程可以处理**数万并发连接**。 **直观对比**:处理10,000个长连接时,WebFlux的CPU利用率比同步架构低**40%**,内存消耗减少**25%**。 在万级并发场景下,基于Netty的WebFlux应用相比传统Servlet容器可减少**30%-50%** 的内存消耗,同时保持更稳定的P99延迟。 ### **2.2 Reactor与Mono/Flux** 理解WebFlux的第一道坎,是理解**Project Reactor**的两个核心类型: - **Mono**:代表**0或1个**结果的异步序列。可以理解为一个“未来可能到来的单个数据包”的承诺。 - **Flux**:代表**0到N个**结果的异步序列。 ``` // 返回单个结果用Mono @GetMapping("/user/{id}") public Mono getUser(@PathVariable Long id) { return userRepository.findById(id); // 异步查询,立即返回Mono } // 返回多个结果用Flux @GetMapping("/users") public Flux getUsers() { return userRepository.findAll(); // 异步查询,立即返回Flux } ``` 关键理解:**方法执行后立即返回,不等待数据就绪**。 真正的数据会在未来某个时刻通过Mono/Flux传递过来。 ## **三、从零搭建一个WebFlux应用** 光说不练假把式。 我们花5分钟搭一个WebFlux应用看看。 ### **3.1 添加依赖** ``` org.springframework.boot spring-boot-starter-webflux ``` **不需要`spring-boot-starter-web**` ,两者是互斥的。WebFlux默认使用Netty作为服务器。 ### **3.2 响应式Controller** ``` @RestController @RequestMapping("/api/users") public class UserController { private final UserService userService; public UserController(UserService userService) { this.userService = userService; } // 返回单个用户 @GetMapping("/{id}") public Mono getUser(@PathVariable Long id) { return userService.findById(id) .switchIfEmpty(Mono.error(new UserNotFoundException(id))); } // 返回用户列表 @GetMapping public Flux getUsers(@RequestParam(defaultValue = "0") int page, @RequestParam(defaultValue = "20") int size) { return userService.findAll(page, size); } // 创建用户 @PostMapping public Mono createUser(@RequestBody Mono userMono) { return userMono.flatMap(userService::save); } } ``` **代码拆解**: - 方法返回`Mono`或`Flux`,**不等待数据就绪**,立即返回 - `flatMap`操作用于处理异步嵌套,避免“回调地狱” - `switchIfEmpty`提供响应式的空值处理 ### **3.3 响应式Service** ``` @Service public class UserService { private final ReactiveUserRepository userRepository; public UserService(ReactiveUserRepository userRepository) { this.userRepository = userRepository; } public Mono findById(Long id) { return userRepository.findById(id); } public Flux findAll(int page, int size) { return userRepository.findAll() .skip((long) page * size) .take(size); } public Mono save(User user) { return userRepository.save(user); } } ``` ### **3.4 响应式数据访问(R2DBC)** WebFlux配合**R2DBC**(Reactive Relational Database Connectivity)才能实现端到端的非阻塞: ``` org.springframework.boot spring-boot-starter-data-r2dbc io.r2dbc r2dbc-postgresql ``` ``` @Repository public interface ReactiveUserRepository extends ReactiveCrudRepository { Mono findByEmail(String email); Flux findByAgeGreaterThan(int age); } ``` **关键理解**:如果没有R2DBC,只用WebFlux + 传统JDBC,数据库访问仍然是阻塞的,**端到端的非阻塞就断在了数据库这一层**。要让整个链路非阻塞,数据库访问也必须是非阻塞的。 ## **四、WebClient:响应式的HTTP客户端** WebFlux提供了**WebClient**作为响应式的HTTP客户端,替代传统的RestTemplate: ``` @Service public class OrderService { private final WebClient webClient; public OrderService(WebClient.Builder webClientBuilder) { this.webClient = webClientBuilder .baseUrl("http://user-service") .defaultHeader(HttpHeaders.CONTENT_TYPE, MediaType.APPLICATION_JSON_VALUE) .build(); } public Mono getUserWithOrders(Long userId) { // 并行调用两个服务 Mono userMono = webClient.get() .uri("/api/users/{id}", userId) .retrieve() .bodyToMono(User.class); Flux ordersFlux = webClient.get() .uri("/api/orders?userId={id}", userId) .retrieve() .bodyToFlux(Order.class); // 合并结果 return userMono.zipWith(ordersFlux.collectList()) .map(tuple -> { User user = tuple.getT1(); user.setOrders(tuple.getT2()); return user; }); } } ``` **关键点**:两个外部调用是**并行**执行的,而不是串行。`zipWith`操作符会等待两个异步结果都返回后,再合并处理。 如果用RestTemplate,这两个调用是串行的,总耗时是两者之和;用WebClient,总耗时是两者中的最大值。 ## **五、为什么越来越多的人使用?** ### **5.1 云原生时代的资源效率革命** 在Kubernetes集群中,每个Pod的资源配额是有限的。WebFlux应用可以用更少的内存和CPU支撑更高的并发。 **真实数据**:采用响应式架构的微服务集群在同等硬件条件下,吞吐量提升**3-5倍**,延迟降低**60%以上**。某行业调研显示,越来越多的企业正在将WebFlux引入生产环境。 ### **5.2 流式数据处理与实时推送** WebFlux原生支持**Server-Sent Events(SSE)** 和**WebSocket**,适合实时数据推送场景: ``` @GetMapping(value = "/stream", produces = MediaType.TEXT_EVENT_STREAM_VALUE) public Flux streamStockPrices() { return stockService.priceStream() .delayElements(Duration.ofSeconds(1)); // 每秒推送一次 } ``` 金融行情、IoT设备数据、实时监控等场景,WebFlux是天然的选择。 ### **5.3 背压机制:防止系统过载** 背压(Backpressure)是响应式流规范的核心特性。当消费者处理速度跟不上生产者时,消费者可以**主动告诉生产者“慢一点”** 。 ``` Flux.range(1, 1000000) .onBackpressureBuffer(1000) // 缓冲1000个元素 .subscribe(new BaseSubscriber() { @Override protected void hookOnNext(Integer value) { // 处理一个 request(1); // 处理完一个再请求下一个 } }); ``` 传统Servlet模型没有背压机制,生产者可能压垮消费者。WebFlux的背压机制在流式/大数据场景下具有碾压性优势。 ### **5.4 GraalVM原生镜像支持** 2025年的Spring生态中,WebFlux与**GraalVM原生镜像**的兼容性得到显著提升,启动时间优化至**100ms以内**。 这对于Serverless和快速弹性伸缩场景意义重大——100ms的启动时间意味着Pod可以在几秒内完成扩容。 ## **六、缺点与适用场景** ### **6.1 优点** **1. 极高的资源效率** WebFlux用少量线程处理大量并发,在云原生环境下意味着更少的Pod、更低的内存占用、更低的云成本。 在万级并发场景下,WebFlux可减少**30%-50%** 的内存消耗,同时保持更稳定的P99延迟。 Netty默认的Event Loop线程数通常等于CPU核心数,而Tomcat的线程池可能达到数百甚至上千——**一个WebFlux应用在峰值负载下的线程数,可能只是MVC应用的十分之一**。 **2. 流式数据处理与实时推送** WebFlux原生支持**Server-Sent Events(SSE)** 和**WebSocket**,金融行情、IoT设备数据、实时监控等场景天然适合。在传统Servlet模型中实现流式推送,需要对异步支持做很多额外处理。 **3. 背压机制(Backpressure)** 当消费者处理速度跟不上生产者时,消费者可以主动告诉生产者“慢一点”。传统Servlet模型没有背压机制,生产者可能压垮消费者。这在流式/大数据场景下具有碾压性优势。 **4. 端到端的非阻塞** 从Web层到数据访问层(配合R2DBC)全链路非阻塞,所有环节都运行在Netty的事件循环上,避免了线程切换开销。 **5. WebClient并行调用能力** WebClient支持多个外部服务调用的**并行执行**,用`zipWith`、`merge`等操作符组合多个异步请求,总耗时从“串行之和”变成“并行最大值”。 **6. GraalVM原生镜像支持** 2025年的Spring生态中,WebFlux与**GraalVM原生镜像**的兼容性显著提升,启动时间优化至**100ms以内**,对Serverless和快速弹性伸缩场景意义重大。 **7. 与Spring生态深度融合** WebFlux是Spring生态的一部分,与Spring Boot、Spring Security、Spring Data、Spring Cloud等组件无缝集成,无需引入额外框架。 ### **6.2 缺点** **1. 学习曲线陡峭**需要理解响应式思维、Mono/Flux操作符、背压机制等新概念。从命令式编程转向响应式范式,需要完成从同步到异步、从状态到流、从阻塞到订阅的认知跃迁。 **2. 调试难度高**响应式代码的堆栈跟踪不像同步代码那么直观,`flatMap`链中的异常可能跨越多个操作符。不过Spring提供了BlockHound等工具来辅助检测线程阻塞问题。 **3. 生态适配仍需时间**部分传统JDBC、ORM库没有响应式版本,需要寻找R2DBC等替代方案。端到端的非阻塞需要整个技术栈都支持响应式——**如果数据库访问仍然是阻塞的,WebFlux带来的收益就会被抵消**。 **4. 简单CRUD场景杀鸡用牛刀**对于简单的CRUD应用,WebFlux带来的性能提升可能不足以抵消其复杂性。而且阻塞I/O模型在虚拟线程的支持下,已经能更轻松地达到接近WebFlux的并发能力。 **5. 默认配置调优空间大但要求更高**WebFlux的默认配置适合中等负载,但在高并发场景下需要根据实际业务特征调优Netty参数(如`maxConnections`、`idleTimeout`、`eventLoopThreads`等),这对运维团队提出了更高的要求。 ### **6.3 适用场景** |场景|推荐程度|理由| | --- | --- | --- | |API网关|强烈推荐|高并发、I/O密集、服务聚合| |实时数据推送|强烈推荐|SSE/WebSocket原生支持| |微服务间调用|强烈推荐|WebClient并行调用,延迟降低明显| |流式数据处理|强烈推荐|背压机制天然适配| |Serverless/FaaS|推荐|GraalVM原生镜像启动快| |传统CRUD应用|需评估|收益不明显,学习成本高| |CPU密集型计算|不推荐|WebFlux优势在I/O密集型,CPU密集型反而增加了调度开销| **最佳实践判断**:如果你的应用是**I/O密集型**(大量数据库查询、外部API调用、文件操作),WebFlux能发挥最大价值。如果是CPU密集型,WebFlux的优势不明显,甚至可能因为操作符链的额外开销而略慢于同步方案。 **最佳实践判断**:如果你的应用是**I/O密集型**(大量数据库查询、外部API调用、文件操作),WebFlux能发挥最大价值。如果是CPU密集型,WebFlux的优势不明显。 ## **七、虚拟线程来了** 2026年,Java生态中出现了一个重要的新变量——**虚拟线程(Virtual Threads,Project Loom)** 。 虚拟线程让同步阻塞代码也能以极低的成本支撑高并发。 用Tomcat + 虚拟线程,开发者可以用熟悉的同步编程模型,获得接近WebFlux的并发能力。 **那WebFlux会被取代吗?** 目前来看,两者是**互补**的关系。 虚拟线程适合大部分传统业务场景,让同步代码也能支撑高并发。 WebFlux在**流式数据处理、背压控制、细粒度线程调度**等场景下仍有不可替代的优势。 2026年的技术选型不再是“非此即彼”,而是根据具体场景选择最合适的方案。 ## **八、写在最后** 回到最初的问题:**为什么越来越多的人使用WebFlux?** **第一,资源效率的革命。** WebFlux用少量线程处理大量并发,在云原生环境下意味着更少的Pod、更低的内存占用、更低的云成本。在万级并发场景下,WebFlux可减少**30%-50%** 的内存消耗。 **第二,流式数据处理的天然适配。** SSE、WebSocket、背压机制——这些能力在传统Servlet模型中要么不支持,要么实现起来非常别扭。WebFlux让流式数据处理变得优雅。 **第三,云原生时代的必然选择。** 在Serverless、快速弹性伸缩的场景下,WebFlux + GraalVM原生镜像的启动时间可优化至**100ms以内**。这种启动速度,传统JVM应用难以企及。 当然,WebFlux不是银弹。 学习曲线陡峭、调试难度高、生态还在完善——这些短板客观存在。 而且2026年虚拟线程的出现,让同步编程也有了高并发的能力。 **我的建议是**:如果你的应用是I/O密集型、需要支撑高并发、或者需要流式数据处理能力,WebFlux值得你花时间深入学习。 如果只是简单的CRUD应用,传统Spring MVC + 虚拟线程可能是更务实的选择。 技术选型没有标准答案。 **理解自己的业务场景,选择最匹配的技术方案,才是架构师真正该做的事。** **官方资源:** - **Spring WebFlux官方文档**:https://docs.spring.io/spring-framework/reference/web/webflux.html - **Project Reactor文档**:https://projectreactor.io/docs

优秀的个人博客,低调大师

为什么越来越多人使用PDFBox?

## **大家好,我是苏三,又跟大家见面了。** ## **前言** 最近有球友问:三哥,解析PDF用哪个工具比较好? 市面上主流的Java PDF处理库,大概分成三类:iText(商业授权,AGPL对商业不友好)、OpenPDF(iText 4的分支,LGPL/MPL协议)、以及今天要聊的**Apache PDFBox(Apache 2.0协议,对商业最友好)** 。 PDFBox是目前**唯一一个由Apache基金会维护**的Java PDF处理库,功能覆盖从文本提取到数字签名的全场景。 截至2026年7月,PDFBox的最新版本已经更新到**3.0.8**。 今天这篇文章,我就把PDFBox从安装到实战、从底层原理到性能调优,从头到尾给你拆解一遍。 希望对你会有所帮助。 ## **一、先搞清楚:PDFBox到底是什么?** ### **1.1 一句话说清** **Apache PDFBox是一个开源的Java库,专门用于处理PDF文档**。 它允许你: - **创建**全新的PDF文件 - **编辑**现有的PDF文档 - **提取**PDF中的文本、图片和元数据 - **合并、拆分、加密、解密、签名**PDF文件 简单说,只要是跟PDF相关的事,PDFBox基本都能干。 ### **1.2 为什么选PDFBox?** 在Java生态里,PDF处理库其实不少。但PDFBox有几个独特的优势: **第一,Apache 2.0协议,对商业最友好。** iText从7.0开始采用AGPL协议,如果你的项目是商业闭源软件,要么花钱买授权,要么开源全部代码。而PDFBox采用Apache 2.0协议,**允许自由使用、修改和分发,甚至用于商业闭源产品**。 **第二,Apache顶级项目,社区活跃。** PDFBox是Apache软件基金会的顶级项目,有持续的版本迭代和社区支持。2026年3月至今,PDFBox已经连续发布了3.0.6、3.0.7和3.0.8等多个版本。 **第三,“一站式”解决方案。** 从最简单的文本提取到复杂的数字签名,从基本的文档合并到高级操作,PDFBox几乎涵盖了PDF处理的所有场景。 ## **二、环境搭建:5分钟跑起来** ### **2.1 添加依赖** PDFBox 3.x需要`Java 8+`环境。 如果你的项目用的是Maven: ``` org.apache.pdfbox pdfbox 3.0.8 ``` 如果用的是Gradle: ``` implementation 'org.apache.pdfbox:pdfbox:3.0.8' ``` **版本选择建议**:PDFBox 3.x是目前最常用的Java PDF处理起点。 截至2026年7月,最新版本是**3.0.8**。 如果你的项目还在用2.x,建议升级到3.x——性能更好、API更规范。 ### **2.2 第一个程序:提取PDF文本** ``` import org.apache.pdfbox.Loader; import org.apache.pdfbox.pdmodel.PDDocument; import org.apache.pdfbox.text.PDFTextStripper; import java.io.File; import java.io.IOException; public class ExtractText { public static void main(String[] args) throws IOException { File file = new File("sample.pdf"); // PDFBox 3.x 使用 Loader.loadPDF(),不再是 PDDocument.load() try (PDDocument document = Loader.loadPDF(file)) { PDFTextStripper stripper = new PDFTextStripper(); String text = stripper.getText(document); System.out.println(text); } } } ``` **关键注意**:PDFBox 3.0移除了`PDDocument.load()`方法,必须使用`Loader.loadPDF()`。 **提取指定页面范围的文本**: ``` try (PDDocument document = Loader.loadPDF(new File("sample.pdf"))) { PDFTextStripper stripper = new PDFTextStripper(); stripper.setStartPage(2); // 从第2页开始 stripper.setEndPage(4); // 到第4页结束 String text = stripper.getText(document); System.out.println(text); } ``` ## **三、核心操作:从入门到进阶** ### **3.1 创建PDF文档** ``` import org.apache.pdfbox.pdmodel.PDDocument; import org.apache.pdfbox.pdmodel.PDPage; import org.apache.pdfbox.pdmodel.PDPageContentStream; import org.apache.pdfbox.pdmodel.font.PDType1Font; public class CreatePDF { public static void main(String[] args) { try (PDDocument document = new PDDocument()) { // 添加一个空白页 PDPage page = new PDPage(); document.addPage(page); // 创建内容流 PDPageContentStream contentStream = new PDPageContentStream(document, page); // 设置字体和大小 contentStream.setFont(PDType1Font.HELVETICA_BOLD, 12); contentStream.beginText(); contentStream.newLineAtOffset(100, 700); // 坐标:距离左侧100,距离底部700 contentStream.showText("Hello, PDFBox!"); contentStream.endText(); contentStream.close(); document.save("HelloPDFBox.pdf"); } catch (Exception e) { e.printStackTrace(); } } } ``` **坐标系统说明**:PDF的坐标原点在**页面左下角**,X轴向右为正,Y轴向上为正。这与Swing等GUI库的坐标系统(左上角为原点)正好相反,新手容易踩坑。 **处理多行文本**: ``` contentStream.setLeading(14.5f); // 设置行间距 contentStream.showText("第一行文本"); contentStream.newLine(); contentStream.showText("第二行文本"); ``` ### **3.2 提取图片** ``` import org.apache.pdfbox.pdmodel.PDDocument; import org.apache.pdfbox.pdmodel.PDPage; import org.apache.pdfbox.pdmodel.PDResources; import org.apache.pdfbox.pdmodel.common.PDRectangle; import org.apache.pdfbox.pdmodel.graphics.image.PDImageXObject; public class ExtractImages { public static void main(String[] args) throws IOException { try (PDDocument document = Loader.loadPDF(new File("sample.pdf"))) { for (int pageIndex = 0; pageIndex 有些小伙伴可能会好奇:“PDFBox到底是怎么把一团乱码的PDF文件变成可读的文本和图片的?” 理解底层原理,能帮你更好地理解PDFBox的能力边界和性能瓶颈。 ### **4.1 PDF文档的物理结构** PDF文件本质上是一个**字节序列**。 它的物理结构分为四个部分: ![](https://developer.qcloudimg.com/http-save/yehe-5604447/c3c31baf4debc6d53d44b1e91b08d825.jpg) - **文件头**:位于文档开头,包含PDF版本信息(如`%PDF-1.7`) - **文件体**:存储所有PDF对象——页面、图像、字体、注释等 - **交叉引用表**:提供快速定位文件体内对象位置的方法 - **文件尾**:包含指向交叉引用表和文档根对象的指针 ### **4.2 PDFBox的双层架构** PDFBox采用**双层架构**来分离底层PDF结构和高层业务语义: ![](https://developer.qcloudimg.com/http-save/yehe-5604447/064031e56ac99e9cddf924cd360a726d.jpg) **COS层(底层对象层)** :直接映射PDF文件中的基本对象——字典(COSDictionary)、数组(COSArray)、流(COSStream)等。你可以通过COS层访问PDF文件的任何底层细节。 **PD层(高层语义层)** :在COS层之上封装了面向开发者的友好API——`PDDocument`代表整个文档,`PDPage`代表一页,`PDPageContentStream`代表内容流。 这种分层设计的核心价值在于:**你可以通过PD层快速完成常规操作,遇到复杂需求时又能随时下沉到COS层获取完全控制权**。 ### **4.3 内容处理的三层流水线** PDFBox的内容处理架构分为三个层次: **第一层:基础处理层(PDFStreamEngine)** 这是最底层。它负责解析内容流为Token序列,将操作分发给注册的处理器,维护图形状态栈,管理资源。 简单说,它把PDF的“二进制指令流”翻译成“可执行的操作序列”。 **第二层:图形抽象层(PDFGraphicsStreamEngine)** 这层定义了图形操作的抽象方法——路径构建、填充、描边、绘制图像。它不关心“怎么画”,只定义“画什么”。 **第三层:实现层(PageDrawer、PDFTextStripper等)** 这层提供了具体的实现。`PageDrawer`负责渲染到Graphics2D,`PDFTextStripper`负责提取文本。 以提取文本为例,`PDFTextStripper`就是通过重写`showGlyph()`方法来收集字符的位置信息,从而实现文本提取。 ![](https://developer.qcloudimg.com/http-save/yehe-5604447/53ba75e9d71951d9db8322d69a6315f6.jpg) 这种分层设计让PDFBox具有极高的**可扩展性**——你可以继承`PDFStreamEngine`来实现自定义的行为,比如内容分析或自定义渲染后端。 ## **五、常见问题与避坑指南** ### **5.1 PDFBox 2.x → 3.x迁移要点** 如果你从PDFBox 2.x升级到3.x,这几个变化必须注意: **变化一:PDDocument.load()被移除** ``` // PDFBox 2.x PDDocument document = PDDocument.load(new File("sample.pdf")); // PDFBox 3.x PDDocument document = Loader.loadPDF(new File("sample.pdf")); ``` **变化二:IO模块重构** PDFBox 3.0引入了全新的IO模块和Loader类,这是3.0版本中变化最大的部分。 ### **5.2 中文显示问题** PDFBox默认的`PDType1Font`不支持中文。要用中文,你需要自己加载中文字体: ``` // 加载中文字体 PDType0Font font = PDType0Font.load(document, new File("simsun.ttf")); contentStream.setFont(font, 12); ``` ### **5.3 大文件性能问题** PDFBox在处理大型或复杂的PDF文件时,性能可能比其他PDF库慢一些。优化建议: - 使用`Loader.loadPDF()`时指定`MemoryUsageSetting`来控制内存使用 - 对于超大文件,考虑分页处理 - 使用`try-with-resources`确保资源及时释放 ## **六、优缺点** ### **优点** **1. Apache 2.0协议,商业友好**可以自由使用、修改和分发,甚至用于商业闭源产品。 **2. 功能全面,“一站式”解决方案**从文本提取到数字签名,从文档合并到OCR集成,覆盖几乎所有PDF处理场景。 **3. Apache顶级项目,社区活跃**持续的版本迭代,2026年已连续发布多个版本。 **4. API设计直观**即使没有PDF处理经验的开发者也能快速上手。 **5. 命令行工具**PDFBox还包含一套命令行工具,可以执行常见的PDF处理任务。 **6. 纯Java实现**可以在任何支持Java的平台上运行,无需依赖特定操作系统。 ### **缺点** **1. 大文件性能偏弱**处理非常大的或结构复杂的PDF文件时,速度可能不如商业库。 **2. 表格提取不是原生功能**PDFBox提取表格需要结合Tabula-java等工具。 **3. 中文支持需要额外配置**默认字体不支持中文,需要手动加载中文字体。 **4. 3.0版本有破坏性变更**从2.x升级到3.x需要注意API变化。 ## **七、适用场景** |场景|推荐程度|理由| | --- | --- | --- | |文档管理系统|✅✅✅ 强烈推荐|创建、编辑、提取PDF内容| |报表自动生成|✅✅✅ 强烈推荐|动态生成包含图表和表格的复杂PDF报表| |合同/发票解析|✅✅✅ 强烈推荐|提取结构化数据,Apache 2.0协议商业友好| |电子书阅读器|✅✅ 推荐|支持文本搜索和内容提取| |数字签名|✅✅ 推荐|PDFBox提供符合PDF安全规范的数字签名| |PDF加密/解密|✅✅ 推荐|支持用户密码和所有者密码双重加密| |PDF合并/拆分|✅✅ 推荐|PDFMergerUtility工具类| ## **八、写在最后** Apache PDFBox作为一个Apache基金会的顶级项目,用**Apache 2.0协议**给了商业开发者最大的自由度——你可以免费使用、自由修改,甚至用于商业闭源产品。 它的功能覆盖从**创建、编辑、提取到加密、签名、合并**的几乎所有PDF操作。而且它的API设计直观,即使没有PDF处理经验的开发者也能快速上手。 当然,PDFBox也不是银弹。 处理超大文件时性能可能不如商业库,表格提取需要借助额外工具。 但对于绝大多数PDF处理需求,PDFBox已经足够强大。 **我的建议是**:如果你的项目需要PDF处理能力,**先花一个下午把PDFBox跑一遍** 。感受一下“免费、开源、功能全面”的PDF处理体验——你会发现,很多事情根本不需要花钱。 开源地址 - **GitHub**:https://github.com/apache/pdfbox - **官方文档**:https://pdfbox.apache.org

优秀的个人博客,低调大师

为什么越来越多人使用FastAPI?

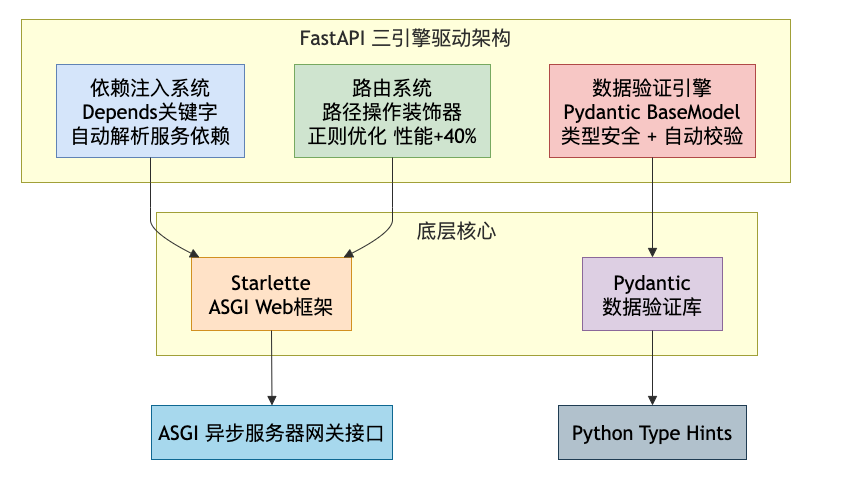
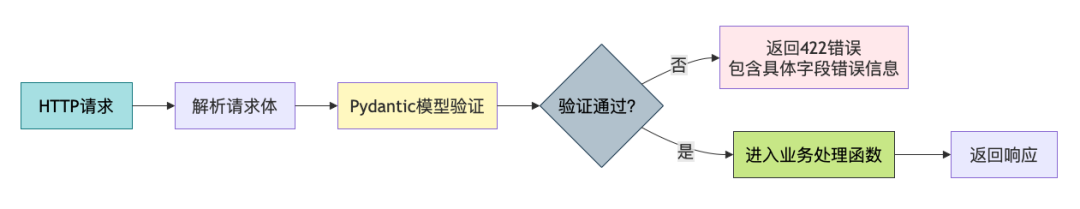
大家好,我是苏三,又跟大家见面了。 ## **前言** > Java开发者也能看懂的Python高性能框架指南 最近这几年,Python在AI和数据处理领域如日中天,很多Java开发者也开始接触Python生态。 在Python的众多Web框架中,**FastAPI**的崛起速度让人瞠目结舌。 GitHub上,FastAPI已经斩获了**80K+ Star**,增长速度超过了Flask和Django,成为Python生态中增长最快的Web框架。 微软、Netflix、滴滴等公司都在生产环境中使用它。 很多小伙伴问我:“三哥,我一个写Java的,为什么要学FastAPI?” 我的回答很简单:**如果你需要快速搭建一个高性能的API服务,尤其是涉及AI模型部署、数据处理或微服务场景,FastAPI可能是目前最好的选择之一。** 今天这篇文章,我就从Java开发者的视角出发,用你熟悉的对比方式,把FastAPI从头到尾讲清楚。 图文并茂,代码可复制,跟着做就行。 希望对你会有所帮助。 ## **一、FastAPI到底是什么?** ### **1.1 一句话说清** FastAPI是一个基于Python的现代Web框架,专为**构建高性能API**而设计。 它由西班牙开发者Sebastián Ramírez于2018年创建,核心设计目标是解决传统Python Web框架在性能、开发效率和类型安全方面的痛点。 它的技术定位可以概括为“三高”:**高开发效率、高运行性能、高类型安全**。 ### **1.2 跟Java开发者熟悉的框架对比** 为了让Java开发者快速理解FastAPI的定位,我用一个表格来对比: |对比维度|FastAPI (Python)|Spring Boot (Java)|Flask (Python)| | --- | --- | --- | --- | |核心定位|高性能API框架|企业级全栈框架|轻量级微框架| |性能|极高(接近Go/Node.js)|高|中等| |开发速度|极快|较慢|快| |自动文档|✅ 原生支持|需SpringDoc等集成|❌ 需第三方| |类型安全|✅ Pydantic强校验|✅ Java强类型|⚠️ 较弱| |异步支持|✅ 原生async/await|✅ Spring WebFlux|⚠️ 需扩展| |学习曲线|低|陡峭|低| |适用场景|API服务、微服务、AI部署|大型企业应用|简单Web应用| FastAPI和Spring Boot的关系,有点像**跑车和SUV**——跑车轻快灵活,适合高速冲刺;SUV稳重扎实,适合长途跋涉和复杂路况。 各有各的好,关键看你要干什么。 ### **1.3 FastAPI到底能做什么?** FastAPI官方文档总结了它的核心能力: **高性能**:基于Starlette(异步Web框架)和Pydantic(高性能数据校验),在Python Web框架中属于性能天花板。 **自动生成API文档**:无需编写文档,自动生成Swagger UI(`/docs`)和ReDoc(`/redoc`)。 **使用Python类型提示自动校验参数**:自动请求参数校验、自动响应模型校验、IDE自动补全体验极佳。 **原生异步支持**:完全支持`async/await`,适合高并发I/O场景。 **依赖注入系统**:支持权限校验、Token校验、DB会话管理、统一行为注入。 **易维护**:类型提示 + 自动补全,适合微服务架构。 ## **二、FastAPI为什么这么快?** > 有些小伙伴可能会问:同样是Python写的,FastAPI凭什么比Flask快那么多? 答案是三个字:**ASGI**。 ### **2.1 WSGI vs ASGI:一场革命** 传统的Python Web框架(如Flask、Django)基于**WSGI**(Web Server Gateway Interface)规范。 WSGI是**同步**的——每个请求独占一个线程,直到处理完才能释放。这就好比一个餐厅里,每个服务员一次只能服务一桌客人,其他客人只能干等着。 而FastAPI基于**ASGI**(Asynchronous Server Gateway Interface)规范。 ASGI是**异步非阻塞**的——每个请求在事件循环中被调度,而不是独占线程资源。 这就像同一个服务员可以同时服务多桌客人——点完一桌的菜,趁厨房做菜的时间去给另一桌点单,效率自然高出一大截。 这就是为什么FastAPI能够轻松处理**数千个并发连接**。 ### **2.2 三引擎驱动架构** FastAPI的架构可以概括为“星型模型”,由三个核心引擎驱动: ![](https://developer.qcloudimg.com/http-save/yehe-5604447/2e904142ed566186361fe0c4418c09ce.png) **① 路由系统**:基于路径操作装饰器(`@app.get`、`@app.post`)实现RESTful路由,支持路径参数和查询参数的自动解析。其路径匹配算法采用正则表达式优化,在路径参数较多时比Flask的Werkzeug路由**性能提升达40%**。 **② 依赖注入系统**:通过`Depends`关键字实现服务依赖的自动解析,特别适合数据库连接等资源的统一管理。其底层实现采用函数装饰器模式,通过`__wrapped__`属性保留原始函数,在运行时动态注入依赖项。 **③ 数据验证引擎**:FastAPI的数据验证基于Pydantic的`BaseModel`,验证流程包含字段类型检查、约束条件验证、嵌套模型验证和额外属性检查。 ### **2.3 Pydantic验证流程** 当一个请求到达FastAPI时,数据验证的流程是这样的: ![](https://developer.qcloudimg.com/http-save/yehe-5604447/0564ee704ab7ed44dbcfb8bcbcaf2e73.png) 如果在请求中传入非字符串类型的`username`,框架会立即返回422错误,并明确指出哪个字段失败及原因。 这种“在门口就把不合格的请求拦住”的设计,大大减少了业务代码里的防御性判断。 ### **2.4 性能数据** 在TechEmpower基准测试中,FastAPI在JSON序列化场景下达到**18,732 req/sec(同步模式)和32,451 req/sec(异步模式)**。 JSON序列化性能达到Django的**8倍**,接近Go语言框架Gin的水平。 对于API开发来说,FastAPI的速度大约是Flask的**2-3倍**。 在I/O密集型场景下,这个差距会更加明显。 ## **三、环境搭建:5分钟跑起来** ### **3.1 安装Python环境** 建议使用Python 3.9+版本: ``` # 使用pyenv管理Python版本(推荐) brew install pyenv pyenv install 3.11.5 pyenv global 3.11.5 # 或直接使用系统Python python3 --version ``` ### **3.2 创建项目并安装依赖** ``` # 创建项目目录 mkdir fastapi-demo cd fastapi-demo # 创建虚拟环境(推荐) python3 -m venv venv source venv/bin/activate # Windows: venv\Scripts\activate # 安装FastAPI和Uvicorn pip install fastapi uvicorn[standard] ``` Uvicorn是一个ASGI服务器,相当于Java中的Tomcat或Netty。 ### **3.3 编写第一个API** 创建`main.py`文件: ``` from fastapi import FastAPI # 创建应用实例 app = FastAPI(title="我的第一个FastAPI应用", version="1.0.0") # 定义路由 @app.get("/") async def root(): return {"message": "Hello World"} @app.get("/hello/{name}") async def say_hello(name: str): return {"message": f"Hello, {name}!"} ``` ### **3.4 启动服务** ``` uvicorn main:app --reload --host 0.0.0.0 --port 8000 ``` 参数说明: - `main:app` —— `main.py`文件中的`app`实例 - `--reload` —— 开发模式下自动重启(生产环境不要用) - `--host` —— 监听地址 - `--port` —— 端口号 启动后,访问以下地址: - **API服务**:http://localhost:8000 - **Swagger文档**:http://localhost:8000/docs - **ReDoc文档**:http://localhost:8000/redoc 访问`/docs`你会看到一份交互式的API文档——**你什么都没写,文档已经自动生成了**。这就是FastAPI最让人惊艳的特性之一。 ## **四、核心概念实战** ### **4.1 路径参数与查询参数** ``` from fastapi import FastAPI app = FastAPI() # 路径参数:从URL路径中提取 @app.get("/users/{user_id}") asyncdef get_user(user_id: int):# 自动类型转换 + 校验 return {"user_id": user_id, "name": f"User_{user_id}"} # 查询参数:从URL问号后面提取 @app.get("/items") asyncdef list_items( skip: int = 0, # 默认值 limit: int = 10, # 默认值 category: str | None = None # 可选参数 ): return {"skip": skip, "limit": limit, "category": category} ``` **代码解读**: - 路径参数`{user_id}`会从URL中提取,`user_id: int`会自动进行类型转换和校验——传入非数字会返回422错误 - 查询参数从`?skip=0&limit=10`中提取,有默认值的参数是可选的 - 类型注解让IDE能提供自动补全,也让框架能自动校验 访问示例: - `GET /users/123` → `{"user_id": 123, "name": "User_123"}` - `GET /items?skip=5&limit=20&category=books` ### **4.2 请求体与Pydantic模型** 这是FastAPI最核心的能力之一——用Pydantic模型定义请求和响应的数据结构。 ``` from fastapi import FastAPI from pydantic import BaseModel, Field, EmailStr from typing import Optional from datetime import datetime app = FastAPI() # 定义请求体模型 class UserCreate(BaseModel): username: str = Field(..., min_length=3, max_length=20, description="用户名") email: EmailStr = Field(..., description="邮箱地址") password: str = Field(..., min_length=8, description="密码") age: Optional[int] = Field(None, ge=0, le=150, description="年龄") tags: list[str] = [] # 定义响应体模型 class UserResponse(BaseModel): id: int username: str email: str age: Optional[int] created_at: datetime @app.post("/users", response_model=UserResponse) asyncdef create_user(user: UserCreate): # 业务逻辑:创建用户 return UserResponse( id=1, username=user.username, email=user.email, age=user.age, created_at=datetime.now() ) ``` **代码解读**: - `UserCreate`定义了请求体的结构,`Field`提供了额外的校验规则(最小长度、最大长度、取值范围等) - `EmailStr`会自动校验邮箱格式 - `response_model=UserResponse`指定了响应的数据结构,框架会自动过滤掉不在模型中的字段 - 如果请求缺少必填字段或字段类型不对,FastAPI会自动返回422错误并说明原因 这就是“**声明式编程**”的魅力——你只需要声明“我要什么”,框架帮你处理“怎么校验”。 ### **4.3 依赖注入** FastAPI的依赖注入系统非常灵活,适合处理权限校验、数据库会话管理等横切关注点。 ``` from fastapi import FastAPI, Depends, Header, HTTPException app = FastAPI() # 定义一个依赖:验证Token asyncdef verify_token(authorization: str = Header(...)): """从请求头中提取并验证Token""" ifnot authorization.startswith("Bearer "): raise HTTPException(status_code=401, detail="无效的认证格式") token = authorization.replace("Bearer ", "") if token != "valid-token": raise HTTPException(status_code=401, detail="无效的Token") return {"user_id": 1, "username": "admin"} # 使用依赖 @app.get("/protected") asyncdef protected_route(user: dict = Depends(verify_token)): return {"message": f"欢迎, {user['username']}!", "user": user} ``` **代码解读**: - `verify_token`是一个依赖函数,从请求头中提取`Authorization`并验证 - `Depends(verify_token)`将依赖注入到路由函数中 - 如果验证失败,自动返回401错误 - 验证通过后,返回的用户信息会作为`user`参数传入路由函数 这种设计让**认证逻辑和业务逻辑完全分离**,代码更清晰、更可测试。 ### **4.4 异步支持** FastAPI原生支持`async/await`,这是它高性能的关键。 ``` import asyncio from fastapi import FastAPI app = FastAPI() # 同步函数(适用于CPU密集型操作) @app.get("/sync") def sync_endpoint(): # 同步操作,会阻塞线程 return {"result": "done"} # 异步函数(适用于I/O密集型操作) @app.get("/async") asyncdef async_endpoint(): # 模拟I/O操作:数据库查询、外部API调用等 await asyncio.sleep(1) # 在等待期间,事件循环可以处理其他请求 return {"result": "done after 1 second"} # 混合使用:在异步函数中调用同步代码 @app.get("/mixed") asyncdef mixed_endpoint(): # 使用 run_in_executor 将同步代码放到线程池执行 result = await asyncio.to_thread(sync_heavy_work) return {"result": result} def sync_heavy_work(): # CPU密集型操作 return sum(range(1000000)) ``` **代码解读**: - 异步函数用`async def`定义,在等待I/O时释放线程资源 - `await asyncio.sleep(1)`模拟I/O等待,期间事件循环可以处理其他请求 - 对于CPU密集型操作,使用`asyncio.to_thread`放到线程池执行,避免阻塞事件循环 ## **五、数据库集成** ### **5.1 异步SQLAlchemy集成** ``` from fastapi import FastAPI, Depends from sqlalchemy.ext.asyncio import create_async_engine, AsyncSession, async_sessionmaker from sqlalchemy.orm import declarative_base, Mapped, mapped_column from sqlalchemy import select # 数据库配置 DATABASE_URL = "postgresql+asyncpg://user:password@localhost/db" engine = create_async_engine(DATABASE_URL, echo=True) AsyncSessionLocal = async_sessionmaker(engine, expire_on_commit=False) Base = declarative_base() # 定义模型 class User(Base): __tablename__ = "users" id: Mapped[int] = mapped_column(primary_key=True) username: Mapped[str] = mapped_column(unique=True) email: Mapped[str] # 依赖:获取数据库会话 asyncdef get_db(): asyncwith AsyncSessionLocal() as session: yield session app = FastAPI() @app.get("/users") asyncdef get_users(db: AsyncSession = Depends(get_db)): result = await db.execute(select(User)) users = result.scalars().all() return [{"id": u.id, "username": u.username, "email": u.email} for u in users] ``` **代码解读**: - `create_async_engine`创建异步数据库引擎 - `AsyncSessionLocal`是异步会话工厂 - `get_db`是一个依赖,每个请求创建一个数据库会话,请求结束后自动关闭 - 所有数据库操作都是异步的,不会阻塞事件循环 ## **六、统一响应与异常处理** 在生产环境中,统一的响应格式和异常处理是必不可少的。 ### **6.1 统一响应模型** ``` from fastapi import FastAPI, HTTPException from pydantic import BaseModel from typing import Generic, TypeVar, Optional T = TypeVar("T") class ApiResponse(BaseModel, Generic[T]): """统一API响应格式""" code: int = 200 msg: str = "success" data: Optional[T] = None app = FastAPI() @app.get("/users/{user_id}", response_model=ApiResponse) asyncdef get_user(user_id: int): if user_id **我的建议是**:花一个周末把FastAPI跑一遍,写一个完整的CRUD服务。感受一下“写代码=写文档”的体验,体会一下“类型注解自动校验”的便利。然后根据你的实际项目需求,决定是否引入生产环境。 毕竟,**多一个趁手的工具,就多一条解决问题的路**。 **开源地址**: - **FastAPI**:https://github.com/tiangolo/fastapi (80K+ Star) - **官方文档**:https://fastapi.tiangolo.com

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册