首页 文章 精选 留言 我的

精选列表

搜索[CEL策略],共10000篇文章
优秀的个人博客,低调大师

四种策略确保 RabbitMQ 消息发送可靠性!你用哪种?

@[toc] 微服务可以设计成消息驱动的微服务,响应式系统也可以基于消息中间件来做,从这个角度来说,在互联网应用开发中,消息中间件真的是太重要了。 今天,以 RabbitMQ 为例,松哥来和大家聊一聊消息中间消息发送可靠性的问题。 注意,以下内容我主要和大家讨论如何确保消息生产者将消息发送成功,并不涉及消息消费的问题。 1. RabbitMQ 消息发送机制 大家知道,RabbitMQ 中的消息发送引入了 Exchange(交换机)的概念,消息的发送首先到达交换机上,然后再根据既定的路由规则,由交换机将消息路由到不同的 Queue(队列)中,再由不同的消费者去消费。 大致的流程就是这样,所以要确保消息发送的可靠性,主要从两方面去确认: 消息成功到达 Exchange 消息成功到达 Queue 如果能确认这两步,那么我们就可以认为消息发送成功了。 如果这两步中任一步骤出现问题,那么消息就没有成功送达,此时我们可能要通过重试等方式去重新发送消息,多次重试之后,如果消息还是不能到达,则可能就需要人工介入了。 经过上面的分析,我们可以确认,要确保消息成功发送,我们只需要做好三件事就可以了: 确认消息到达 Exchange。 确认消息到达 Queue。 开启定时任务,定时投递那些发送失败的消息。 2. RabbitMQ 的努力 上面提出的三个步骤,第三步需要我们自己实现,前两步 RabbitMQ 则有现成的解决方案。 如何确保消息成功到达 RabbitMQ?RabbitMQ 给出了两种方案: 开启事务机制 发送方确认机制 这是两种不同的方案,不可以同时开启,只能选择其中之一,如果两者同时开启,则会报如下错误: 我们分别来看。以下所有案例都在 Spring Boot 中展开,文末可以下载相关源码。 2.1 开启事务机制 Spring Boot 中开启 RabbitMQ 事务机制的方式如下: 首先需要先提供一个事务管理器,如下: @Bean RabbitTransactionManager transactionManager(ConnectionFactory connectionFactory) { return new RabbitTransactionManager(connectionFactory); } 接下来,在消息生产者上面做两件事:添加事务注解并设置通信信道为事务模式: @Service public class MsgService { @Autowired RabbitTemplate rabbitTemplate; @Transactional public void send() { rabbitTemplate.setChannelTransacted(true); rabbitTemplate.convertAndSend(RabbitConfig.JAVABOY_EXCHANGE_NAME,RabbitConfig.JAVABOY_QUEUE_NAME,"hello rabbitmq!".getBytes()); int i = 1 / 0; } } 这里注意两点: 发送消息的方法上添加 @Transactional 注解标记事务。 调用 setChannelTransacted 方法设置为 true 开启事务模式。 这就 OK 了。 在上面的案例中,我们在结尾来了个 1/0 ,这在运行时必然抛出异常,我们可以尝试运行该方法,发现消息并未发送成功。 当我们开启事务模式之后,RabbitMQ 生产者发送消息会多出四个步骤: 客户端发出请求,将信道设置为事务模式。 服务端给出回复,同意将信道设置为事务模式。 客户端发送消息。 客户端提交事务。 服务端给出响应,确认事务提交。 上面的步骤,除了第三步是本来就有的,其他几个步骤都是平白无故多出来的。所以大家看到,事务模式其实效率有点低,这并非一个最佳解决方案。我们可以想想,什么项目会用到消息中间件?一般来说都是一些高并发的项目,这个时候并发性能尤为重要。 所以,RabbitMQ 还提供了发送方确认机制(publisher confirm)来确保消息发送成功,这种方式,性能要远远高于事务模式,一起来看下。 2.2 发送方确认机制 2.2.1 单条消息处理 首先我们移除刚刚关于事务的代码,然后在 application.properties 中配置开启消息发送方确认机制,如下: spring.rabbitmq.publisher-confirm-type=correlated spring.rabbitmq.publisher-returns=true 第一行是配置消息到达交换器的确认回调,第二行则是配置消息到达队列的回调。 第一行属性的配置有三个取值: none:表示禁用发布确认模式,默认即此。 correlated:表示成功发布消息到交换器后会触发的回调方法。 simple:类似 correlated,并且支持 waitForConfirms() 和 waitForConfirmsOrDie() 方法的调用。 接下来我们要开启两个监听,具体配置如下: @Configuration public class RabbitConfig implements RabbitTemplate.ConfirmCallback, RabbitTemplate.ReturnsCallback { public static final String JAVABOY_EXCHANGE_NAME = "javaboy_exchange_name"; public static final String JAVABOY_QUEUE_NAME = "javaboy_queue_name"; private static final Logger logger = LoggerFactory.getLogger(RabbitConfig.class); @Autowired RabbitTemplate rabbitTemplate; @Bean Queue queue() { return new Queue(JAVABOY_QUEUE_NAME); } @Bean DirectExchange directExchange() { return new DirectExchange(JAVABOY_EXCHANGE_NAME); } @Bean Binding binding() { return BindingBuilder.bind(queue()) .to(directExchange()) .with(JAVABOY_QUEUE_NAME); } @PostConstruct public void initRabbitTemplate() { rabbitTemplate.setConfirmCallback(this); rabbitTemplate.setReturnsCallback(this); } @Override public void confirm(CorrelationData correlationData, boolean ack, String cause) { if (ack) { logger.info("{}:消息成功到达交换器",correlationData.getId()); }else{ logger.error("{}:消息发送失败", correlationData.getId()); } } @Override public void returnedMessage(ReturnedMessage returned) { logger.error("{}:消息未成功路由到队列",returned.getMessage().getMessageProperties().getMessageId()); } } 关于这个配置类,我说如下几点: 定义配置类,实现 RabbitTemplate.ConfirmCallback 和 RabbitTemplate.ReturnsCallback 两个接口,这两个接口,前者的回调用来确定消息到达交换器,后者则会在消息路由到队列失败时被调用。 定义 initRabbitTemplate 方法并添加 @PostConstruct 注解,在该方法中为 rabbitTemplate 分别配置这两个 Callback。 这就可以了。 接下来我们对消息发送进行测试。 首先我们尝试将消息发送到一个不存在的交换机中,像下面这样: rabbitTemplate.convertAndSend("RabbitConfig.JAVABOY_EXCHANGE_NAME",RabbitConfig.JAVABOY_QUEUE_NAME,"hello rabbitmq!".getBytes(),new CorrelationData(UUID.randomUUID().toString())); 注意第一个参数是一个字符串,不是变量,这个交换器并不存在,此时控制台会报如下错误: 接下来我们给定一个真实存在的交换器,但是给一个不存在的队列,像下面这样: rabbitTemplate.convertAndSend(RabbitConfig.JAVABOY_EXCHANGE_NAME,"RabbitConfig.JAVABOY_QUEUE_NAME","hello rabbitmq!".getBytes(),new CorrelationData(UUID.randomUUID().toString())); 注意此时第二个参数是一个字符串,不是变量。 可以看到,消息虽然成功达到交换器了,但是没有成功路由到队列(因为队列不存在)。 这是一条消息的发送,我们再来看看消息的批量发送。 2.2.2 消息批量处理 如果是消息批量处理,那么发送成功的回调监听是一样的,这里不再赘述。 这就是 publisher-confirm 模式。 相比于事务,这种模式下的消息吞吐量会得到极大的提升。 3. 失败重试 失败重试分两种情况,一种是压根没找到 MQ 导致的失败重试,另一种是找到 MQ 了,但是消息发送失败了。 两种重试我们分别来看。 3.1 自带重试机制 前面所说的事务机制和发送方确认机制,都是发送方确认消息发送成功的办法。如果发送方一开始就连不上 MQ,那么 Spring Boot 中也有相应的重试机制,但是这个重试机制就和 MQ 本身没有关系了,这是利用 Spring 中的 retry 机制来完成的,具体配置如下: spring.rabbitmq.template.retry.enabled=true spring.rabbitmq.template.retry.initial-interval=1000ms spring.rabbitmq.template.retry.max-attempts=10 spring.rabbitmq.template.retry.max-interval=10000ms spring.rabbitmq.template.retry.multiplier=2 从上往下配置含义依次是: 开启重试机制。 重试起始间隔时间。 最大重试次数。 最大重试间隔时间。 间隔时间乘数。(这里配置间隔时间乘数为 2,则第一次间隔时间 1 秒,第二次重试间隔时间 2 秒,第三次 4 秒,以此类推) 配置完成后,再次启动 Spring Boot 项目,然后关掉 MQ,此时尝试发送消息,就会发送失败,进而导致自动重试。 3.2 业务重试 业务重试主要是针对消息没有到达交换器的情况。 如果消息没有成功到达交换器,根据我们第二小节的讲解,此时就会触发消息发送失败回调,在这个回调中,我们就可以做文章了! 整体思路是这样: 首先创建一张表,用来记录发送到中间件上的消息,像下面这样: 每次发送消息的时候,就往数据库中添加一条记录。这里的字段都很好理解,有三个我额外说下: status:表示消息的状态,有三个取值,0,1,2 分别表示消息发送中、消息发送成功以及消息发送失败。 tryTime:表示消息的第一次重试时间(消息发出去之后,在 tryTime 这个时间点还未显示发送成功,此时就可以开始重试了)。 count:表示消息重试次数。 其他字段都很好理解,我就不一一啰嗦了。 在消息发送的时候,我们就往该表中保存一条消息发送记录,并设置状态 status 为 0,tryTime 为 1 分钟之后。 在 confirm 回调方法中,如果收到消息发送成功的回调,就将该条消息的 status 设置为1(在消息发送时为消息设置 msgId,在消息发送成功回调时,通过 msgId 来唯一锁定该条消息)。 另外开启一个定时任务,定时任务每隔 10s 就去数据库中捞一次消息,专门去捞那些 status 为 0 并且已经过了 tryTime 时间记录,把这些消息拎出来后,首先判断其重试次数是否已超过 3 次,如果超过 3 次,则修改该条消息的 status 为 2,表示这条消息发送失败,并且不再重试。对于重试次数没有超过 3 次的记录,则重新去发送消息,并且为其 count 的值+1。 大致的思路就是上面这样,松哥这里就不给出代码了,松哥的 vhr 里边邮件发送就是这样的思路来处理的,完整代码大家可以参考 vhr 项目(https://github.com/lenve/vhr)。 当然这种思路有两个弊端: 去数据库走一遭,可能拖慢 MQ 的 Qos,不过有的时候我们并不需要 MQ 有很高的 Qos,所以这个应用时要看具体情况。 按照上面的思路,可能会出现同一条消息重复发送的情况,不过这都不是事,我们在消息消费时,解决好幂等性问题就行了。 当然,大家也要注意,消息是否要确保 100% 发送成功,也要看具体情况。 4. 小结 好啦,这就是关于消息生产者的一些常见问题以及对应的解决方案,下篇文章松哥和大家探讨如果保证消息消费成功并解决幂等性问题。 本文涉及到的相关源代码大家可以在这里下载:https://github.com/lenve/javaboy-code-samples。

优秀的个人博客,低调大师

网络安全意识培训的八大新策略

网络安全意识培训的重要性已经无需多言,但是很多企业在实践中面临两难境地,力度小了员工敷衍了事,而力度大了,如果方式不对,有时候也会起到反作用,甚至会让安全意识培训在企业内部落下“不讲武德”的坏名声。 例如,在今年早些时候,报业巨头Tribune Publishing向员工发送了网络钓鱼模拟测试邮件,“恭喜”员工获得5000-10000美元的年终奖,需要登录查看。结果点击链接的员工立刻收到了参加计算机安全培训计划的通知。这次网络钓鱼测试最终引发了众怒,因为Tribune Publishing测试前刚刚解雇了大批员工,钓鱼邮件测试无疑是在员工的心灵创伤上撒了一把盐。 电子邮件服务公司TheXYZ的创始人佩里·托内(Perry Toone)说,对员工实施网络钓鱼测试导致类似的灾难性结果并不罕见,甚至很多企业因此放弃了这一方法。 他说:“我们创建了一个虚假的钓鱼网站,并诱惑员工单击电子邮件中的链接。事实证明,这不是一个好主意。许多员工吓坏了,以为自己真被黑客入侵了。” 那么网络安全意识培训有没有更好的,让员工“印象深刻”同时又有参与积极性的方法呢?以下是多位网络安全专家给出的八大建议: 游戏化 Auth0安全与合规高级总监Duncan Godfrey表示,人们喜欢边做边学,安全部门需要创造既促进教育又激发兴奋的挑战。 例如,内部漏洞搜寻不仅鼓励员工安全发现并报告漏洞,而且还可以识别公司基础架构中的威胁和严重错误。 Godfrey说:“这一挑战促进了员工之间的健康竞争,并在我们的日常工作中引入了令人兴奋但又富有成效的使命。发现严重漏洞的任何员工都会获得公司内部的名人堂荣誉以及Auth0赃物奖。” 第二个挑战是网上诱骗:要求员工“像黑客一样思考”,并尝试诈骗Auth0的网络安全文化经理。 Godfrey说:“这项以受控和安全的方式进行的挑战为我们的员工带来了一项有趣的任务,使他们能够更好地了解安全人员日常防御的各种攻击类型。” 将安全意识培训整合到入职流程 S3 Consulting的首席执行官兼创始人Johanna Baum说,在新员工入职的过程中,他们就应该接受一些意识培训。 她说:“在S3中,一旦通过入职颁发证书即可接受安全意识培训,包括每个客户都必须参加。如果没有成功完成,他们将无法完成入职流程或某些资产的分配。” 鼓励员工提交错误报告 电子邮件安全公司Tessian的首席执行官兼联合创始人Tim Sadler说,每个人都会犯错,“但是人们控制的敏感数据比以往任何时候都要多,例如客户,财务和员工信息。这意味着即使是最小的错误,如意外将电子邮件发给错误的收件人,都可能会严重损害公司的声誉。” Sadler提倡通过鼓励员工提交错误报告来使安全意识更加普及。 他说:“公司需要建立一种安全文化,以鼓励员工向IT部门报告错误。否则,这些错误将继续发生,而且无法了解它们的发生方式或原因。” 基于角色和年龄的针对性安全意识培训 网络安全培训公司Cybrary内容运营主管Will Carlson说,为了使安全意识尽可能成功,安全领导者需要确保意识培训项目对于最终用户而言是可行的和有针对性的。 他建议根据最终用户在公司中的角色,提供定期的 “有的放矢的意识培训”。 Sadler还认为,组织还需要针对不同年龄量身定制安全培训内容。 他说:“例如,我们的数据表明,在工作中受到尊重对老一辈很重要,因此他们可能更不愿承认自己犯了一个错误,因为他们不想丢脸。另一方面,年轻的员工对寻求知识更感兴趣,因此我们应该向他们传授黑客用来针对他们的技术,以便他们知道该怎么办。” 利用多种媒介 IT和管理服务公司Carousel Industries的CSO和CIO Jason Albuquerque指出,企业应当采用“全渠道交付”系统来提高网络安全意识和教育水平。 他说:“我们现在向所有员工每月发布两次网络安全公告。“所有内容都基于易于理解和具有教育意义的现代通信媒体(包括短视频、行业文章、电子邮件、Microsoft Teams消息等)。 Albuquerque表示,他还计划通过使用呼叫中心技术、知识库和人工智能将内容分发渠道扩展为包括SMS消息,从而使安全意识信息传播更快,更具针对性。 将安全培训“嵌入”软件开发流程和文化中 DevSecOps是一开始就将安全性嵌入软件设计中的文化,在许多组织中广为流行。但是,即使您还没有实施DevSecOps,也要考虑对开发人员进行安全意识方面的培训。 Checkmarx应用程序安全全球总监Matthew Rose说:“安全意识培训应该是DevOps的内在组成,而不是额外的单独任务。开发人员喜欢留在自己喜欢的环境中,如果培训使他们脱离了这种环境,他们会认为这是繁重而令人沮丧的,而不是信息丰富和具有激励性的活动。” Kenna Security的安全和合规经理Jerry Gamblin表示:“企业应该花时间建设安全中心内容,在其DevOps团队中培养安全知识“部落”,其中包括专门的语言安全培训、支付安全会议费用或提供与安全DevOps和编码有关的书籍的安全库。” 安全意识带回家 如今,远程办公已经成为一种新常态,这意味着员工家庭其他成员可能正在使用同一路由器访问工作和学校。 Home Access Health Corp.信息技术副总裁兼安全官,ISACA董事会主席Pam Nigro表示:“鉴于这一现实,我认为让员工的全部家人参与网络安全意识培训非常重要。” Nigro的团队创建了简单的安全意识消息,供父母与孩子分享,这是教育所有人的努力的一部分。 基于云的软件提供商Datto的信息安全总监Chris Henderson表示,他还在努力帮助远程员工改善安全状况。 他说:“ Datto还一直在为员工提供其家庭安全状况的评估,为他们提供保护路由器和端点的帮助,以确保我们新的远程环境不会遭受攻击。” 寻找部门级的安全意识“二班长” 安全公司Cyphere的常务顾问和专业服务总监Harman Singh建议,安全团队需要有意识地去“笼络”那些热情主动的员工,这将有助于安全团队传播安全意识信息。 他说:“就像在办公室进行演习一样,从每个部门选择和培训安全意识“二班长”,可以与他们联系以帮助队友确保更快的反应。这是内部更有效的社交工具。” 【本文是51CTO专栏作者“安全牛”的原创文章,转载请通过安全牛(微信公众号id:gooann-sectv)获取授权】 戳这里,看该作者更多好文

优秀的个人博客,低调大师

开源流数据公司 StreamNative 正式加入 CNCF,积极推动云原生策略发展

近日,开源流数据公司 StreamNative 宣布正式加入云原生计算基金会 CNCF(全称:Cloud Native Computing Foundation ),成为 CNCF 共建云原生社区的重要合作伙伴。 Cloud Native Computing Foundation,简称 CNCF,是 Linux 基金会旗下专注于下一代云计算方案的子基金会,致力于统一云计算的接口和相关标准,维护和集成开源技术,并支持编排容器化微服务架构应用。StreamNative 同 UCloud、平安科技集团、DataStax、NGINX 等国内外科技公司均属 CNCF 银牌会员。 在云计算深化发展阶段,云原生应用逐渐成为企业的选择。在此背景下,云原生技术成为更加重要的支撑。CNCF 正在联合越来越多的全球企业,推动云原生在各行业中落地。 云原生,主要是指一套技术体系和方法论,具备敏捷、可靠、高弹性、易扩展、故障隔离保护及持续更新等关键特征,可以帮助企业快速部署新业务新应用。云原生模式下的应用服务,可以更快速地响应客户需求。 作为 Apache Pulsar 的商业支持公司,StreamNative 由 Apache Pulsar 、Apache BookKeeper 原生核心开发者组建而成,围绕 Apache Pulsar 及 Apache BookKeeper 打造下一代云原生流数据平台,近期已完成数百万美元的 Pre-A 轮融资。 Pulsar 是 Apache 软件基金会顶级项目,作为下一代云原生分布式消息流平台,集消息、存储、轻量化函数式计算为一体,采用计算与存储分离架构设计,支持多租户、持久化存储、多机房跨地域数据复制,具有强一致性、高吞吐、低延时以及高可扩展流数据存储特性,是云原生时代解决实时消息流数据传输、存储和计算的最佳解决方案。 Pulsar 目前已进入 CNCF Cloud Native Interactive Landscape 中 “App Definition and Development”下属“Streaming & Messaging”分类:https://landscape.cncf.io。 Landscape 是 CNCF 的重要项目,目的在于为云原生应用者提供技术线路图。通过对云原生技术中的大多数项目和产品进行分类,追踪云原生生态中的大量技术与应用。Pulsar 入选 CNCF 云原生全景图,说明 Pulsar 已获得行业权威机构的高度认可。 StreamNative 成功加入 CNCF,是 StreamNative 持续加强云原生技术投入、推进云原生实践的强有力证明。 StreamNative 将与云原生技术社区、相关企业加强合作,携手同行,进一步推动云原生的发展和繁荣,打造云原生时代实时消息流数据传输、存储和计算的优秀解决方案。

优秀的个人博客,低调大师

基于环状队列和迭代器实现分布式任务RR分配策略

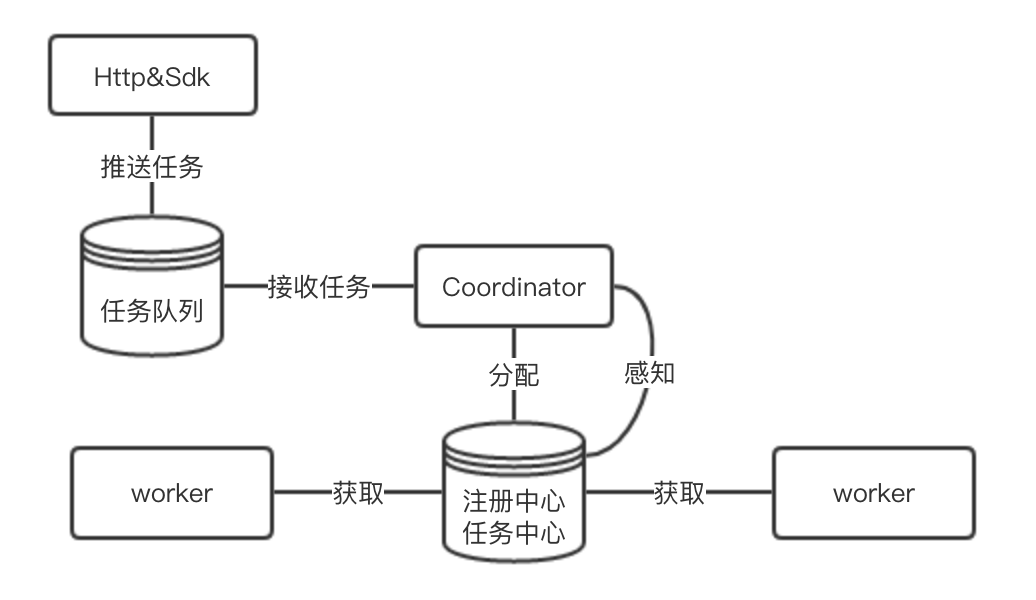
背景 分布式任务分配 在很多运维场景下,我们都会执行一些长时间的任务,比如装机、部署环境、打包镜像等长时间任务, 而通常我们的任务节点数量通常是有限的(排除基于k8s的hpa、或者knative等自动伸缩场景)。 那么当我们有一个任务如何根据当前的worker和corrdinator和任务来进行合理的分配,分配其实也比较复杂,往复杂里面做,可以根据当前系统的负载、每个任务的执行资源消耗、当前集群的任务数量等, 这里我们就搞一个最简单的,基于任务和当前worker的RR算法 系统架构 在worker和任务队列之间,添加一层协调调度层Coordinator, 由它来根据当前集群任务的状态来进行任务的分配,同时感知当前集群worker和task的状态,协调整个集群任务的执行、终止等操作 单机实现 整体设计 members: 表示当前集群中所有的worker tasks: 就是当前的任务 Coordinator: 就是我们的协调者, 负责根据members和tasks进行任务的分配 result: 就是分配的结果 CircularIterator CircularIterator就是我们的环状对立迭代器, 拥有两个方法, 一个是add添加member, 一个Next返回基于rr的下一个member // CircularIterator 环状迭代器 type CircularIterator struct { list []interface{} // 保存所有的成员变量 next int } // Next 返回下一个元素 func (c *CircularIterator) Next() interface{} { item := c.list[c.next] c.next = (c.next + 1) % len(c.list) return item } // Add 添加任务 func (c *CircularIterator) Add(v interface{}) bool { for _, item := range c.list { if v == item { return false } } c.list = append(c.list, v) return true } Member&Task Member就是负责执行任务的worker, 有一个AddTask方法和Execute方法负责任务的执行和添加任务 Task标识一个任务 // Member 任务组成员 type Member struct { id int tasks []*Task } // ID 返回当前memberID func (m *Member) ID() int { return m.id } // AddTask 为member添加任务 func (m *Member) AddTask(t *Task) bool { for _, task := range m.tasks { if task == t { return false } } m.tasks = append(m.tasks, t) return true } // Execute 执行任务 func (m *Member) Execute() { for _, task := range m.tasks { fmt.Printf("Member %d run task %s\n", m.ID(), task.Execute()) } } // Task 任务 type Task struct { name string } // Execute 执行task返回结果 func (t *Task) Execute() string { return "Task " + t.name + " run success" } Coordinator Coordinator是协调器,负责根据 Member和task进行集群任务的协调调度 // Task 任务 type Task struct { name string } // Execute 执行task返回结果 func (t *Task) Execute() string { return "Task " + t.name + " run success" } // Coordinator 协调者 type Coordinator struct { members []*Member tasks []*Task } // TaskAssignments 为member分配任务 func (c *Coordinator) TaskAssignments() map[int]*Member { taskAssignments := make(map[int]*Member) // 构建迭代器 memberIt := c.getMemberIterator() for _, task := range c.tasks { member := memberIt.Next().(*Member) _, err := taskAssignments[member.ID()] if err == false { taskAssignments[member.ID()] = member } member.AddTask(task) } return taskAssignments } func (c *Coordinator) getMemberIterator() *CircularIterator { // 通过当前成员, 构造成员队列 members := make([]interface{}, len(c.members)) for index, member := range c.members { members[index] = member } return NewCircularIterftor(members) } // AddMember 添加member组成员 func (c *Coordinator) AddMember(m *Member) bool { for _, member := range c.members { if member == m { return false } } c.members = append(c.members, m) return true } // AddTask 添加任务 func (c *Coordinator) AddTask(t *Task) bool { for _, task := range c.tasks { if task == t { return false } } c.tasks = append(c.tasks, t) return true } 测试 我们首先创建一堆member和task, 然后调用coordinator进行任务分配,执行任务结果 coordinator := NewCoordinator() for i := 0; i < 10; i++ { m := &Member{id: i} coordinator.AddMember(m) } for i := 0; i < 30; i++ { t := &Task{name: fmt.Sprintf("task %d", i)} coordinator.AddTask(t) } result := coordinator.TaskAssignments() for _, member := range result { member.Execute() } 结果 可以看到每个worker均匀的得到任务分配 Member 6 run task Task task 6 run success Member 6 run task Task task 16 run success Member 6 run task Task task 26 run success Member 8 run task Task task 8 run success Member 8 run task Task task 18 run success Member 8 run task Task task 28 run success Member 0 run task Task task 0 run success Member 0 run task Task task 10 run success Member 0 run task Task task 20 run success Member 3 run task Task task 3 run success Member 3 run task Task task 13 run success Member 3 run task Task task 23 run success Member 4 run task Task task 4 run success Member 4 run task Task task 14 run success Member 4 run task Task task 24 run success Member 7 run task Task task 7 run success Member 7 run task Task task 17 run success Member 7 run task Task task 27 run success Member 9 run task Task task 9 run success Member 9 run task Task task 19 run success Member 9 run task Task task 29 run success Member 1 run task Task task 1 run success Member 1 run task Task task 11 run success Member 1 run task Task task 21 run success Member 2 run task Task task 2 run success Member 2 run task Task task 12 run success Member 2 run task Task task 22 run success Member 5 run task Task task 5 run success Member 5 run task Task task 15 run success Member 5 run task Task task 25 run success 完整代码 package main import "fmt" // CircularIterator 环状迭代器 type CircularIterator struct { list []interface{} next int } // Next 返回下一个元素 func (c *CircularIterator) Next() interface{} { item := c.list[c.next] c.next = (c.next + 1) % len(c.list) return item } // Add 添加任务 func (c *CircularIterator) Add(v interface{}) bool { for _, item := range c.list { if v == item { return false } } c.list = append(c.list, v) return true } // Member 任务组成员 type Member struct { id int tasks []*Task } // ID 返回当前memberID func (m *Member) ID() int { return m.id } // AddTask 为member添加任务 func (m *Member) AddTask(t *Task) bool { for _, task := range m.tasks { if task == t { return false } } m.tasks = append(m.tasks, t) return true } // Execute 执行任务 func (m *Member) Execute() { for _, task := range m.tasks { fmt.Printf("Member %d run task %s\n", m.ID(), task.Execute()) } } // Task 任务 type Task struct { name string } // Execute 执行task返回结果 func (t *Task) Execute() string { return "Task " + t.name + " run success" } // Coordinator 协调者 type Coordinator struct { members []*Member tasks []*Task } // TaskAssignments 为member分配任务 func (c *Coordinator) TaskAssignments() map[int]*Member { taskAssignments := make(map[int]*Member) // 构建迭代器 memberIt := c.getMemberIterator() for _, task := range c.tasks { member := memberIt.Next().(*Member) _, err := taskAssignments[member.ID()] if err == false { taskAssignments[member.ID()] = member } member.AddTask(task) } return taskAssignments } func (c *Coordinator) getMemberIterator() *CircularIterator { // 通过当前成员, 构造成员队列 members := make([]interface{}, len(c.members)) for index, member := range c.members { members[index] = member } return NewCircularIterftor(members) } // AddMember 添加member组成员 func (c *Coordinator) AddMember(m *Member) bool { for _, member := range c.members { if member == m { return false } } c.members = append(c.members, m) return true } // AddTask 添加任务 func (c *Coordinator) AddTask(t *Task) bool { for _, task := range c.tasks { if task == t { return false } } c.tasks = append(c.tasks, t) return true } // NewCircularIterftor 返回迭代器 func NewCircularIterftor(list []interface{}) *CircularIterator { iterator := CircularIterator{} for _, item := range list { iterator.Add(item) } return &iterator } // NewCoordinator 返回协调器 func NewCoordinator() *Coordinator { c := Coordinator{} return &c } func main() { coordinator := NewCoordinator() for i := 0; i < 10; i++ { m := &Member{id: i} coordinator.AddMember(m) } for i := 0; i < 30; i++ { t := &Task{name: fmt.Sprintf("task %d", i)} coordinator.AddTask(t) } result := coordinator.TaskAssignments() for _, member := range result { member.Execute() } } 总结 任务协调是一个非常复杂的事情, 内部的任务平台,虽然实现了基于任务的组合和app化,但是任务调度分配着一块,仍然没有去做,只是简单的根据树形任务去简单的做一些分支任务的执行,未来有时间再做吧,要继续研究下一个模块了 这个调度思想来源于kafka connect的DistributedHerder里面的WorkerCoordinator,感兴趣的可以看看,未完待续 更多文章可以访问http://www.sreguide.com/

优秀的个人博客,低调大师

从司法领域看阿里云产业AI策略:生态联盟,技术赋能

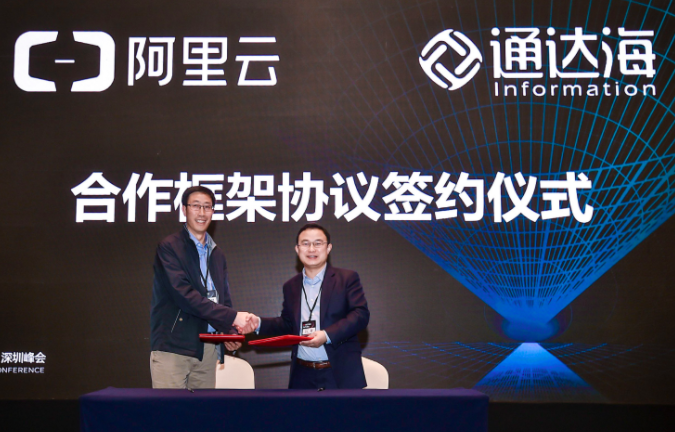
在日前结束的云栖大会深圳峰会上,除了阿里云全面进军IoT的战略宣布之外,持续不断的生态签约成了另一大亮点:全天的IoT合伙作伴签约,围绕“ET大脑”的千里马计划,以及司法领域重要IT服务商通达海的合作。 在IoT方面,阿里云IoT事业部总经理库伟说,现在已经有16家芯片公司、52家设备商、184款模组和网关支持阿里云物联网操作系统和边缘计算产品。很多知名的MCU厂家已经把AliOS Things放到官网上作为他们主推的技术开发平台。 “千里马计划”则是阿里云为了推动产业AI的快速落地而采取的竞赛式合作伙伴招募方式。经过2个多月的激烈比赛,当天共有19家合作伙伴从全球457支参赛队伍中脱颖而出,分获各选题奖项,入选“千里马”计划。 在司法领域的成功,一定程度上证明了阿里云生态战略的杀伤力。根据阿里云披露的数据,目前全国已经有8000多家法庭正在使用其智能语音技术,几乎是“一夜之间”拿下了司法AI的头把交椅。 在此次签约的通达海之前,阿里云已经同华宇软件达成深度合作。二者均为司法领域的顶尖选手。在这样的合作中,阿里云要做的是研发出行业领先的技术,市场开拓和软件实施则交由合作伙伴完成。 比如,此次大会阿里云宣布的向司法领域输出的OCR技术,将加速推动庭审卷宗的数字化。这项名为“读光”的技术能够准确的将图片中的文字识别出来,此前在阿里巴巴集团内部被大规模使用,包括图片管控,搜索,智能审核等。 技术性能方面,“读光”的文档识别率达到99%以上, 复杂拍照表单识别率95%以上,支持上千种图像类型的文字识别, 处理一张图片平均只需0.2秒。 阿里云副总裁李津表示:“合作伙伴比我们更懂市场、更懂客户、更懂场景。通过他们,我们能够更好的将世界级的技术应用到行业里,推动产业AI在司法领域的快速落地”。 在英国、以色列等国家,服务产业的人工智能项目会占据整个人工智能项目的85%以上,而在中国这个比率还相当低。在经历了2017年的大爆发之后,可以预见AI必将从炫技走向产业,才能实现真正的价值。从“上云”到“产业AI”,阿里云的结盟战略是打开下一个风口的杀手锏。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册