首页 文章 精选 留言 我的

精选列表

搜索[知识库管理],共10000篇文章
优秀的个人博客,低调大师

openstack 命令行管理十三 - 外部网络[外部连接专用]管理 (备忘)

 创建公网 [root@station140 ~(network_admin)]# neutron net-create --router:external=true pub1 Created a new network: +---------------------------+--------------------------------------+ | Field | Value | +---------------------------+--------------------------------------+ | admin_state_up | True | | id | aebe75f0-6013-4a5e-bbd9-cb81e1f017bc | | name | pub1 | | provider:network_type | local | | provider:physical_network | | | provider:segmentation_id | | | router:external | True | | shared | False | | status | ACTIVE | | subnets | | | tenant_id | e3a71a59840c4e88b8740b789c3afb9c | +---------------------------+--------------------------------------+注: 参数 --router:external=true 表示创建的是公网网络 查询公网网络信息 [root@station140 ~(keystone_admin)]# nova network-list | grep pub1 +--------------------------------------+---------+------+ | ID | Label | Cidr | +--------------------------------------+---------+------+ | aebe75f0-6013-4a5e-bbd9-cb81e1f017bc | pub1 | None | +--------------------------------------+---------+------+ ############ 注意 ########## 把该 id (aebe75f0-6013-4a5e-bbd9-cb81e1f017bc)定义到 /etc/neutron/l3_agent.ini gateway_external_network_id = aebe75f0-6013-4a5e-bbd9-cb81e1f017bc handle_internal_only_routers = True external_network_id = aebe75f0-6013-4a5e-bbd9-cb81e1f017bc external_network_bridge = br-ex 重启服务 /etc/init.d/neutron-l3-agent restart 注: 上述问题可解决 内部网络 中 ROUTE 显示为 DOWN 状态 ############ 注意 ########## 创建子网 neutron subnet-create --name terry_pub_net1 --allocation-pool start=192.168.48.142,end=192.168.48.148 --gateway 192.168.48.1 --dns-nameserver 192.168.86.37 --enable_dhcp=False --ip-version 4 pub1 192.168.48.0/24 Created a new subnet: +------------------+------------------------------------------------------+ | Field | Value | +------------------+------------------------------------------------------+ | allocation_pools | {"start": "192.168.48.142", "end": "192.168.48.148"} | | cidr | 192.168.48.0/24 | | dns_nameservers | 192.168.86.37 | | enable_dhcp | False | | gateway_ip | 192.168.48.1 | | host_routes | | | id | 59cc431b-498e-49a0-bc60-4a8ca1ca6f48 | | ip_version | 4 | | name | terry_pub_net1 | | network_id | aebe75f0-6013-4a5e-bbd9-cb81e1f017bc | | tenant_id | e3a71a59840c4e88b8740b789c3afb9c | +------------------+------------------------------------------------------+ 删除网络方法 neutron net-delete pub1 查询外部网络 [root@station140 ~(network_admin)]# nova floating-ip-pool-list +--------+ | name | +--------+ | public | | pub1 | <- 注: 假如 neutron net-create 不带 --router:external=true 参数, 则代表网络为内部网络 +--------+

优秀的个人博客,低调大师

阿里重磅发布 Qwen3-Embedding 和 Qwen3-Reranker 两个知识库领域的新模型系列

Qwen3 Embedding 是基于 Qwen3 基础模型训练的文本嵌入模型系列,能够将离散的、高维的符号(如文字、图片、声音等)转化为低维、连续的数字向量(Vector)的转化技术。通过捕捉不同数据点在嵌入空间中的距离远近,它能挖掘出它们之间隐藏的语义关系。 这样,模型就可以在不真正“理解”语言的前提下,通过数学运算模拟出对语言的理解能力 —— 让模型“算得更少,懂得更多”。 📌 举个例子 假设我们有三句话: “苹果手机真好用” “我有一部 iPhone” “今天天气不错” Qwen3 Embedding 会将这些句子转化为数字向量。其中,“苹果手机真好用”和“我有一部 iPhone”在语义上很接近,所以它们的向量也十分相似;而“今天天气不错”和它们表达的内容差别较大,因此在向量空间中距离更远。 通过这种方式,AI 就能自动判断内容的相关性,为搜索、推荐、聚类等任务提供有力支持。 如果说 Qwen3 Embedding 是“初筛”,那 Qwen3 Reranker 就是“精排” —— 它是专门用于提升搜索和推荐系统相关性排序能力的模型。 它的任务是判断两个文本之间的相关性有多高。比如在搜索引擎中,用户输入一个查询词后,系统会先通过 Embedding 模型快速选出一批可能相关的文档,但这些结果的质量参差不齐。这时,Qwen3 Reranker 会对他们进行精细化打分和排序,把最相关的结果排到前面。 📌 举个例子 当你搜索:什么是量子计算? 系统先用 Embedding 模型从大量文档中找出几篇可能相关的文章,比如: 《量子计算的基本原理》 《计算机发展简史》 《量子力学入门知识》 这三篇文章都包含关键词,但从内容来看,第 2 篇明显和“量子计算”关系较远。 Qwen3 Reranker 会为每篇文章打分: 第 1 篇:0.95(非常相关) 第 3 篇:0.80(有一定关联) 第 2 篇:0.30(不太相关) 最终,系统根据这个得分重新排序,优先展示最相关的内容。 卓越的泛化性: Qwen3-Embedding 系列在多个下游任务评估中达到行业领先水平。其中,8B 参数规模的 Embedding 模型在 MTEB 多语言 Leaderboard 榜单中位列第一(截至2025年6月6日,得分70.58),性能超越众多商业API服务。此外,该系列的排序模型在各类文本检索场景中表现出色,显著提升了搜索结果的相关性。 灵活的模型架构: Qwen3-Embedding 系列提供从 0.6B 到 8B 参数规模的3种模型配置,以满足不同场景下的性能与效率需求。开发者可以灵活组合表征与排序模块,实现功能扩展。 此外,模型支持以下定制化特性: 1) 表征维度自定义:允许用户根据实际需求调整表征维度,有效降低应用成本; 2) 指令适配优化:支持用户自定义指令模板,以提升特定任务、语言或场景下的性能表现。 全面的多语言支持: Qwen3-Embedding 系列支持超过 100 种语言,涵盖主流自然语言及多种编程语言。该系列模型具备强大的多语言、跨语言及代码检索能力,能够有效应对多语言场景下的数据处理需求。 Qwen3 Embedding 基于 Qwen3 强大的语言理解能力构建,采用了双编码器结构,分别处理查询与文档内容,从而提取出高质量的语义向量。这种结构使得模型在进行大规模文本匹配任务时具有更高的效率和更强的泛化能力。 在 Embedding 模型的训练过程中,我们采用三阶段训练架构:第一阶段通过超大规模弱监督数据进行对比学习预训练;第二阶段基于高质量标注数据进行监督训练;最终通过模型融合策略融合多个候选模型,以提升整体性能。这种分阶段训练机制有效平衡了模型的泛化能力与任务适配性。 在 Reranker 模型的训练中,基于实验验证结果,我们直接采用高质量标注数据进行监督训练,以提升训练效率。特别需要说明的是,在 Embedding 模型的第一阶段弱监督训练中,我们构建了多任务适配的 Prompt 体系,利用 Qwen3 基础模型的文本生成能力,我们针对不同任务类型和语言特性,动态生成了一系列弱监督文本对,突破了传统方法依赖社区论坛或开源数据筛选获取弱监督文本对的局限性,实现了大规模弱监督数据的高效生成。 在使用 Qwen3 Embedding-8B 之前,请确保你的 Transformers 库版本 ≥4.51.0 ,否则可能会遇到以下错误: KeyError: 'qwen3' 正确调用方式如下: # Requires transformers>=4.51.0 import torch import torch.nn.functional as F from torch import Tensor from modelscope import AutoTokenizer, AutoModel def last_token_pool(last_hidden_states: Tensor, attention_mask: Tensor) -> Tensor: left_padding = (attention_mask[:, -1].sum() == attention_mask.shape[0]) if left_padding: return last_hidden_states[:, -1] else: sequence_lengths = attention_mask.sum(dim=1) - 1 batch_size = last_hidden_states.shape[0] return last_hidden_states[torch.arange(batch_size, device=last_hidden_states.device), sequence_lengths] def get_detailed_instruct(task_description: str, query: str) -> str: return f'Instruct: {task_description}\nQuery:{query}' def tokenize(tokenizer, input_texts, eod_id, max_length): batch_dict = tokenizer(input_texts, padding=False, truncation=True, max_length=max_length-2) for seq, att in zip(batch_dict["input_ids"], batch_dict["attention_mask"]): seq.append(eod_id) att.append(1) batch_dict = tokenizer.pad(batch_dict, padding=True, return_tensors="pt") return batch_dict # Each query must come with a one-sentence instruction that describes the task task = 'Given a web search query, retrieve relevant passages that answer the query' queries = [ get_detailed_instruct(task, 'What is the capital of China?'), get_detailed_instruct(task, 'Explain gravity') ] # No need to add instruction for retrieval documents documents = [ "The capital of China is Beijing.", "Gravity is a force that attracts two bodies towards each other. It gives weight to physical objects and is responsible for the movement of planets around the sun." ] input_texts = queries + documents tokenizer = AutoTokenizer.from_pretrained('Qwen/Qwen3-Embedding-8B', padding_side='left') model = AutoModel.from_pretrained('Qwen/Qwen3-Embedding-8B') # We recommend enabling flash_attention_2 for better acceleration and memory saving. # model = AutoModel.from_pretrained('Qwen/Qwen3-Embedding-8B', attn_implementation="flash_attention_2", torch_dtype=torch.float16).cuda() eod_id = tokenizer.convert_tokens_to_ids("<|endoftext|>") max_length = 8192 # Tokenize the input texts batch_dict = tokenize(tokenizer, input_texts, eod_id, max_length) batch_dict.to(model.device) outputs = model(**batch_dict) embeddings = last_token_pool(outputs.last_hidden_state, batch_dict['attention_mask']) # normalize embeddings embeddings = F.normalize(embeddings, p=2, dim=1) scores = (embeddings[:2] @ embeddings[2:].T) print(scores.tolist()) 通过这种“初筛 + 精排”的组合,Qwen3 Embedding 与 Qwen3 Reranker 构建了一套完整的语义检索流程,显著提升了搜索、推荐等系统的准确性。 你也可以通过 ModelScope、Hugging Face、GitHub 快速体验,还可以通过阿里云百炼平台(https://www.aliyun.com/product/bailian)提供的最新的文本向量模型服务进行体验和使用。 快速体验 Qwen3-Embedding ➡️ Hugging Face https://huggingface.co/collections/Qwen/qwen3-embedding-6841b2055b99c44d9a4c371f ➡️ ModelScope https://modelscope.cn/collections/Qwen3-Embedding-3edc3762d50f48 ➡️ GitHub https://github.com/QwenLM/Qwen3-Embedding ➡️ Ollama https://ollama.com/dengcao/Qwen3-Embedding-0.6B https://ollama.com/dengcao/Qwen3-Embedding-4B https://ollama.com/dengcao/Qwen3-Embedding-8B Qwen3-Reranker ➡️ Hugging Face https://huggingface.co/collections/Qwen/qwen3-reranker-6841b22d0192d7ade9cdefea ➡️ ModelScope https://modelscope.cn/collections/Qwen3-Reranker-6316e71b146c4f ➡️ Ollama https://ollama.com/dengcao/Qwen3-Reranker-0.6B https://ollama.com/dengcao/Qwen3-Reranker-4B https://ollama.com/dengcao/Qwen3-Reranker-8B Ollama部署Qwen3-Embedding和Qwen3-Reranker的方法: 第一步,安装Ollama。打开官网下载:https://ollama.com/download 可以选择Download for Windows来下载。然后双击OllamaSetup.exe按提示安装完成。 第二步,打开Windows PowerShell,或者CMD命令。 如下载Qwen3-Embedding-0.6B,可以输入Ollama命令: ollama run dengcao/Qwen3-Embedding-0.6B:F16 如下载Qwen3-Reranker-0.6B,可以输入Ollama命令: ollama run dengcao/Qwen3-Reranker-0.6B:F16 接下来等待下载完成即可。 下面列出Qwen3-Embedding和Qwen3-Reranker各个版本的Ollama安装命令。 Qwen3-Embedding-0.6B系列: ollama run dengcao/Qwen3-Embedding-0.6B:Q8_0 ollama run dengcao/Qwen3-Embedding-0.6B:F16 Qwen3-Embedding-4B系列: ollama run dengcao/Qwen3-Embedding-4B:Q4_K_M ollama run dengcao/Qwen3-Embedding-4B:Q5_K_M ollama run dengcao/Qwen3-Embedding-4B:Q8_0 Qwen3-Embedding-8B系列: ollama run dengcao/Qwen3-Embedding-8B:Q4_K_M ollama run dengcao/Qwen3-Embedding-8B:Q5_K_M ollama run dengcao/Qwen3-Embedding-8B:Q8_0 Qwen3-Reranker-0.6B系列: ollama run dengcao/Qwen3-Reranker-0.6B:Q8_0 ollama run dengcao/Qwen3-Reranker-0.6B:F16 Qwen3-Reranker-4B系列: ollama run dengcao/Qwen3-Reranker-4B:Q4_K_M ollama run dengcao/Qwen3-Reranker-4B:Q5_K_M ollama run dengcao/Qwen3-Reranker-4B:Q8_0 Qwen3-Reranker-8B系列: ollama run dengcao/Qwen3-Reranker-8B:Q3_K_M ollama run dengcao/Qwen3-Reranker-8B:Q4_K_M ollama run dengcao/Qwen3-Reranker-8B:Q5_K_M ollama run dengcao/Qwen3-Reranker-8B:Q8_0 关于量化版本的说明: q8_0:与浮点数16几乎无法区分。资源使用率高,速度慢。不建议大多数用户使用。 q6_k:将Q8_K用于所有张量。 q5_k_m:将 Q6_K 用于一半的 attention.wv 和 feed_forward.w2 张量,否则Q5_K。 q5_0: 原始量化方法,5位。精度更高,资源使用率更高,推理速度更慢。 q4_k_m:将 Q6_K 用于一半的 attention.wv 和 feed_forward.w2 张量,否则Q4_K q4_0:原始量化方法,4 位。 q3_k_m:将 Q4_K 用于 attention.wv、attention.wo 和 feed_forward.w2 张量,否则Q3_K q2_k:将 Q4_K 用于 attention.vw 和 feed_forward.w2 张量,Q2_K用于其他张量。 根据经验,建议使用 Q5_K_M,因为它保留了模型的大部分性能。或者,如果要节省一些内存,可以使用 Q4_K_M。

优秀的个人博客,低调大师

11Labs 发布对话式 AI 2.0,集成话轮转换和知识库,多语言多角色多模态

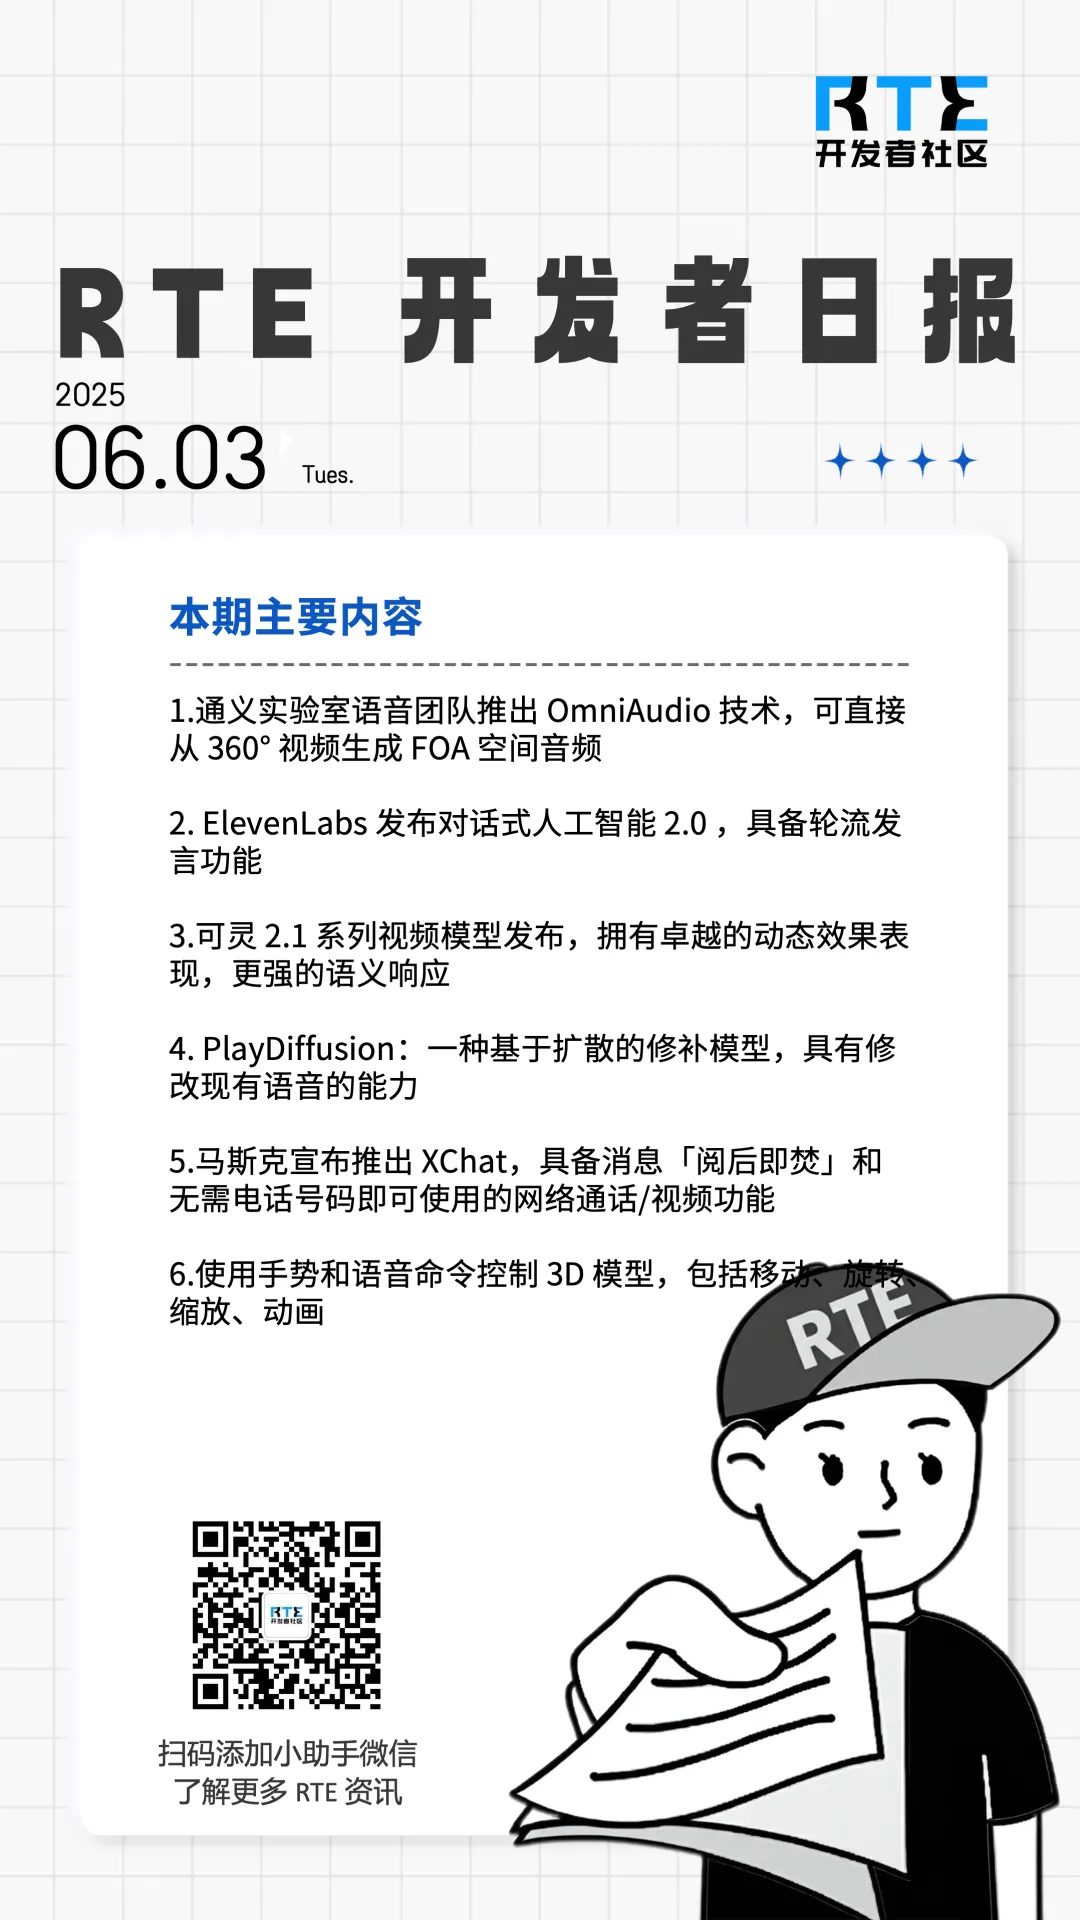
开发者朋友们大家好: 这里是 「RTE 开发者日报」 ,每天和大家一起看新闻、聊八卦。我们的社区编辑团队会整理分享 RTE(Real-Time Engagement) 领域内「有话题的 技术 」、「有亮点的 产品 」、「有思考的 文章 」、「有态度的 观点 」、「有看点的 活动 」,但内容仅代表编辑的个人观点,欢迎大家留言、跟帖、讨论。 本期编辑:@赵怡岭、@鲍勃 01 有话题的技术 1、通义实验室语音团队推出 OmniAudio 技术,可直接从 360° 视频生成 FOA 空间音频 5 月 29 日,阿里通义大模型公布了「空间音频生成」模型——OmniAudio。据通义团队介绍,OmniAudio 能够直接从 360° 视频生成空间音频。 为了解决「如何利用全景视频生成与之匹配的空间音频」这一问题,通义实验室语音团队提出了 360V2SA(360-degree Video to Spatial Audio)任务,旨在直接从 360° 视频生成 FOA(First-order Ambisonics)音频。 据悉,FOA 是一种标准的 3D 空间音频格式,能够捕捉声音的方向性,实现真实的 3D 音频再现。 受限于现有的配对 360° 视频和空间音频数据极为稀缺,通义团队还为此精心设计并构建了 Sphere360 数据集。该数据集包含大量高质量的 360° 视频和相应的 FOA 空间音频。这是一个包含超过 10.3 万个真实世界视频片段的数据集,涵盖 288 种音频事件,总时长达到 288 小时。 另外,OmniAudio 的训练方法分为了「自监督的 coarse-to-fine 流匹配预训练」以及「基于双分支视频表示的有监督微调」两个阶段。 目前,OmniAudio 已上架 GitHub 并同步公布了代码、数据开源仓库,以及相关技术论文。 项目主页:https://omniaudio-360v2sa.github.io/ 代码和数据开源仓库:https://github.com/liuhuadai/OmniAudio 论文地址:https://arxiv.org/abs/2504.14906 (@APPSO、@阿里语音 AI) 2、可灵 2.1 系列视频模型发布,拥有卓越的动态效果表现,更强的语义响应 快手可灵 AI 发布了其 KLING 2.1 系列视频模型。据悉,可灵 2.1 系列拥有标准版和大师版两个版本模型: 标准版支持标准(720P)和高品质(1080P)两种模式。价格方面,标准模式为 20 积分/5 秒,高品质模式为 35 积分/5 秒。 大师模式全面升级为 1080P 输出,拥有卓越的动态效果表现,更强的语义响应。可灵 2.1 标准版暂仅支持「图生视频」功能,「文生视频」功能将在近期上线。目前,可灵 AI 官网已可体验可灵 2.1 系列模型。 可灵 AI:https://app.klingai.com/cn/ (@APPSO) 02 有亮点的产品 1、PlayDiffusion:一种基于扩散的修补模型,具有修改现有语音的能力 PlayDiffusion 是一个让用户能够通过简单编辑文本来编辑音频/视频内容中语音的模型。该模型是一种基于扩散的修补模型,具有修改现有语音的能力,通过该模型可以像编辑文档一样编辑语音,无需重新录制。只需上传音频/视频,编辑自动生成的转录文本,即可获得更新后的语音。现已开源。 工作原理: 1、上传内容; 2、模型转录语音; 3、你编辑转录文本; 4、模型使用相同的声音进行更改。 并且 PlayDiffusion 不是像自回归模型那样逐个生成标记,而是能够一次性预测所有标记,并在大约 20 个去噪步骤中进行优化。这使得生成步骤的效率提高了最多 50 倍,同时没有任何损失。 GitHub: https://github.com/playht/PlayDiffusion Demo: https://huggingface.co/spaces/PlayHT/PlayDiffusion Fal: https://fal.ai/models/fal-ai/playai/inpaint/diffusion (@HammadH4@X、 @PlayAIOfficial@X) 2、ElevenLabs 发布对话式人工智能 2.0 ,具备新一代先进的轮流发言功能和全面支持企业级应用 ElevenLabs 发布 Conversational AI 2.0,实现了自然转换对话能力,能识别语气词判断用户意图,避免尴尬停顿和不当打断。ElevenLabs Conversational AI 现已支持多模态,用户可以创建能够通过文本、语音或同时通过两者进行交流的智能体。 ElevenLabs 开发了批量呼叫功能,使用户能够自动化并扩展外呼语音通信。批量呼叫允许使用用户的对话式 AI 智能体同时发起多个外呼,非常适合发送警报、进行调查或向庞大联系人列表传递个性化信息等用例,提升速度和一致性。 新系统集成了多语言自动识别功能和检索增强生成(RAG)技术,支持多模态交互,一个 AI 助手可同时处理文本和语音。 新功能概览: 新一代先进的轮流发言模型; 语言切换; 多角色模式; 多模态; 批量调用; 内置 RAG。(@elevenlabsio@X、@腾讯研究院、@海波学者聊 AI) 3、马斯克宣布推出 XChat,具备消息「阅后即焚」和无需电话号码即可使用的网络通话/视频功能 日前,马斯克宣布推出一款名为「XChat」的即时通信服务平台。据悉,该平台将具备消息「阅后即焚」和无需电话号码即可使用的网络通话/视频功能。 马斯克宣称 XChat 采用了「比特币风格的加密」,并用 Rust 语言开发,号称「全新架构」。 据 The Information 报道指出,XChat 本质上是为了与 WhatsApp、Telegram,甚至是微信展开竞争。 值得一提的是,Telegram 创始人 Pavel Durov 在一周前曾表示其与马斯克旗下的 xAI 签署了合作协议,并在 Telegram 中接入了 xAI 的 AI 聊天机器人 Grok。 端到端加密:消息、通话内容只有通信双方能看到,第三方(包括 X 平台)无法窥探; 阅后即焚:可以设置消息在一定时间后自动删除,比如 10 分钟后,保护隐私更彻底; 任意文件传输:支持发送任何类型的文件,包括照片、视频、文档等,不再受限于格式或大小; 跨平台音视频通话:无需手机号即可拨打,支持手机、电脑等多设备,通话内容同样加密。 (@APPSO、@Techub Info) 03 Real-Time AI Demo 1、使用手势和语音命令控制 3D 模型,包括移动、旋转、缩放、动画 来自 X 上的@measure_plan:你现在可以导入任何 3D 模型,并使用手势+语音来控制它 04 有态度的观点 1、Anthropic CEO:未来五年 AI 或取代一半白领工作 最近在旧金山总部接受采访时,Anthropic CEO Dario Amodei 发出严峻警告:AI 的迅猛发展可能在未来一到五年内淘汰多达一半的初级白领岗位,社会失业率或飙升至 10% 到 20%。 Amodei 表示,现在是时候停止对 AI 潜在影响的「美化」,技术、金融、法律、咨询等多个行业的初级职位将面临大规模消失,而多数普通人对此几乎一无所知,也缺乏足够的重视。 他希望通过公开发声,促使政策制定者与同行开始采取行动,为社会转型做准备。「大多数人并不知道这件事就要发生,听起来像疯话,但他们不信。」 Amodei 表示,虽然 AI 也带来医疗突破、经济增长等潜力,但其风险同样不可忽视。「癌症治好了,GDP 每年增长 10%,财政平衡……可有 20% 的人失去了工作。」他坦言,这样的情境极可能在技术爆发中同时发生。(@APPSO) 更多 Voice Agent 学习笔记: 级联vs端到端、全双工、轮次检测、方言语种、商业模式…语音 AI 开发者都在关心什么?丨Voice Agent 学习笔记 a16z 最新报告:AI 数字人应用层即将爆发,或将孕育数十亿美金市场丨 Voice Agent 学习笔记 a16z合伙人:语音交互将成为AI应用公司最强大的突破口之一,巨头们在B2C市场已落后太多丨Voice Agent 学习笔记 ElevenLabs 33 亿美元估值的秘密:技术驱动+用户导向的「小熊软糖」团队丨Voice Agent 学习笔记 端侧 AI 时代,每台家居设备都可以是一个 AI Agent丨Voice Agent 学习笔记 世界最炙手可热的语音 AI 公司,举办了一场全球黑客松,冠军作品你可能已经看过 多模态 AI 怎么玩?这里有 18 个脑洞 AI 重塑宗教体验,语音 Agent 能否成为突破点? 对话 TalktoApps 创始人:Voice AI 提高了我五倍的生产力,语音输入是人机交互的未来 a16z 最新语音 AI 报告:语音将成为关键切入点,但非最终产品本身(含最新图谱) 写在最后: 我们欢迎更多的小伙伴参与 「RTE 开发者日报」 内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。 对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。 素材来源官方媒体/网络新闻

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册