首页 文章 精选 留言 我的

精选列表

搜索[知识库问答],共9820篇文章
优秀的个人博客,低调大师

终端防泄密系统|企业实操高频问答:跳出工具思维,构建面向多泄密通道的风险防御体系

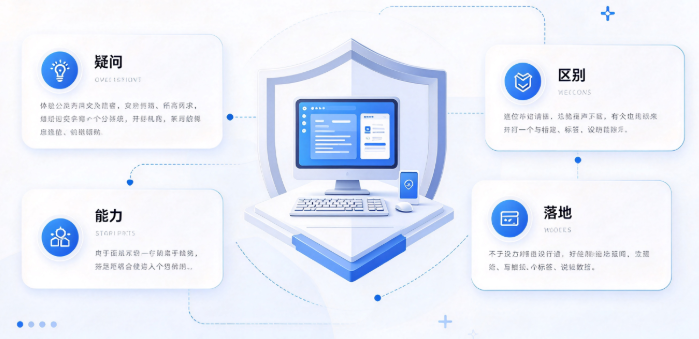
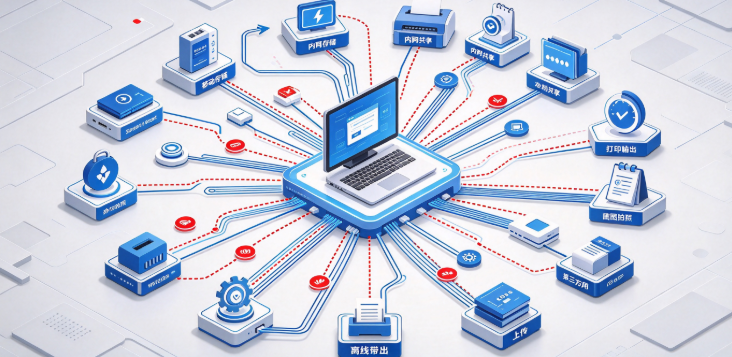
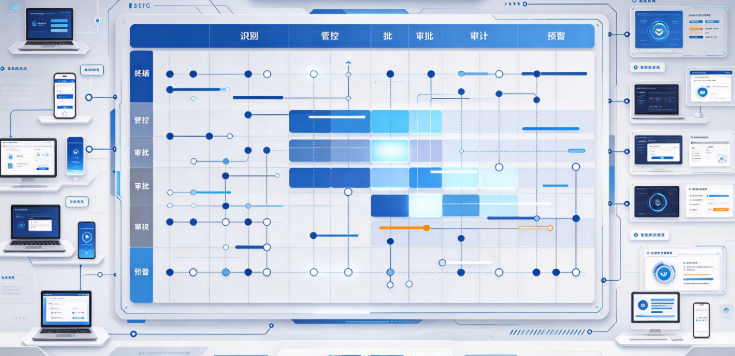
## Q1:已经部署防火墙、PDM 文档库,为什么还需要关注终端防泄密? 很多企业会把安全建设重心放在网络边界与服务端文档管控。防火墙主要抵御外部网络攻击;PDM、PLM 负责服务器上文件的版本、下载权限管理。 但泄密行为大量发生在**文件下载到本地终端之后**。U 盘拷贝、内网共享互传、截图拍照、打印导出、把内部资料上传 AI 工具,这一系列操作都不经过外网防火墙。文档一旦落地到电脑本地,就脱离 PDM 服务端的管控范围。 边界安全与服务端权限,解决不了终端本地的数据流转风险,这就是终端防泄密需要补齐的防护缺口。 ![](https://developer.qcloudimg.com/http-save/yehe-12630035/5672a4ca74c08e52f0b42f3150ee8f58.png) > **真实参考场景**:某制造企业,PDM 平台权限配置完整,研发人员下载图纸到本地后,通过内网共享中转至私人 U 盘完成外泄,外网网关全程没有捕获异常,事后缺少终端操作日志,事件溯源困难。 ## Q2:终端防泄密系统和网关 DLP、EDR 之间,到底有什么区别? 不少运维人员容易混淆几类安全产品,三者防护位置、处理对象完全不同,不存在互相替代的关系。 1. **网关 DLP**:部署在网络出口,只监控往外网发送的数据。内网互传、本地拷贝、离线操作全部看不到,适合外网数据防泄露。 1. **EDR 终端检测响应**:主打查杀病毒、木马、外部入侵攻击,针对恶意程序;对于企业内部人员主动拷贝、导出文件这类人为泄密,管控能力有限。 1. **域智盾系统终端防泄密**:防护重心落在电脑本地。管控文件在终端内部的拷贝、外设读写、打印、截图水印、第三方应用上传,同时留存全量操作审计日志,补齐本地、内网、离线场景的防护空白。 ## Q3:一套终端防泄密体系,核心需要具备哪些关键能力? 域智盾系统不是单纯把文件加密或者全盘禁止拷贝,完整体系围绕风险全链路构建,核心包含五大模块: 1. **敏感数据分级识别**:区分图纸、源代码、合同、财务资料等不同密级数据,不同密级匹配差异化策略,避免一刀切影响日常办公;支持 Windows、信创、macOS 多终端兼容。 1. **多外泄通道管控**:覆盖 U 盘等移动存储、内网共享、打印输出、屏幕水印、第三方 AI / 网盘工具上传、笔记本离线办公多条通道,可做审计、告警或者权限限制。 1. **受控外发审批流程**:针对外协、客户交付等业务外发需求,提供审批机制,对外输出文件可以限定打开次数、有效时间,到期失效,把私下外传转化为可追溯的受控流转。 1. **集中审计日志**:完整留存文件修改、拷贝、外设插拔、打印、外发申请记录,日志统一存储,不会因终端重装丢失,满足等保日志留存要求,支撑事件回溯取证。 1. **异常行为告警**:识别非工作时间批量调取文件、高频拷贝大量资料、跨岗位越权访问等高风险行为,输出分级告警,降低运维人员盯守压力。 ![](https://developer.qcloudimg.com/http-save/yehe-12630035/beb360c777fb4f9ce4eb221ea8c54a8d.png) ## Q4:企业上线终端防泄密,最容易踩哪些坑? ### 坑 1:追求绝对零泄密,过度依赖阻断功能 技术无法阻止人脑记忆、手写抄写这类行为。终端防泄密的价值是抬高泄密门槛、留存溯源证据,而不是实现 100% 杜绝泄密。只看重阻断,忽略水印、审计日志,一旦出事没有线索。 ### 坑 2:不做试点,全公司一次性下发最强策略 直接全员启用严苛管控,极易和设计软件、编译工具、业务系统产生兼容故障,干扰业务运转。运维只能关闭策略,防护彻底失效。 ### 坑 3:只防护 Windows 电脑,忽视异构终端 很多企业仅管控 Windows 终端,macOS、信创电脑没有配置防护策略,高价值文档在这类终端上裸奔,形成明显安全漏洞。 ### 坑 4:只部署工具,缺少制度配套 只完成软件层面部署,没有对内公示管控规则,不做权限定期复核。人员调岗、离职没有及时回收数据权限,依旧存在巨大风险。 ## Q5:在合规层面,部署终端防泄密有哪些不能突破的红线? 结合《数据安全法》《个人信息保护法》、商业秘密保护以及等保 2.0 相关要求,两条底线必须守住: 1. **设备与数据边界**:管控仅限企业配发的办公终端,只针对企业业务敏感数据,不管控员工个人设备、不抓取私人信息。 1. **最小必要 + 知情告知**:管控范围匹配企业安全需求,不过度采集;相关管控规则需要在企业内部公示告知,保障知情权。 司法实践中,企业有没有采取合理技术防护手段,是评判商业秘密是否受保护的重要依据。但如果超出合规边界采集信息,相关记录也会失去证据效力。 ![](https://developer.qcloudimg.com/http-save/yehe-12630035/62551bb5ef1f48c32a8275865c884d1f.png) ## Q6:企业怎样平稳落地终端防泄密? 切忌一步到位全量上线,推荐五步法落地,平衡安全与业务效率: 1. **资产梳理**:梳理核心敏感数据,划分涉密岗位、普通岗位、外包人员,统计 Windows、信创、macOS 各类终端,输出岗位策略基线。 1. **小范围试点**:优先在研发、设计等高风险部门试点,初期仅开启审计和告警,暂不开强阻断,测试业务软件兼容性,过滤误告警,验证离线日志、外发审批流程。 1. **策略迭代调优**:根据试点反馈调整管控强度,完善白名单、离线授权时长,完成内部制度公示,搭建日志备份机制。确认不影响业务后,逐步启用阻断策略。 1. **分批推广上线**:按部门逐步部署,补齐异构终端防护,不留防护死角。 1. **持续运营维护**:定期复核访问权限,人员调岗、离职及时回收权限;持续优化告警规则,定期复盘风险日志。 ## Q7:如何判断终端防泄密建设是真正有效的? 可以从三个维度做自我校验: **第一,风险维度:**内网拷贝、U 盘导出、截图打印、AI 工具上传等主要泄密通道均处于可管控、可审计状态,不存在明显盲区。 **第二,业务维度:**不影响设计师、研发人员正常编辑、保存文件,外协外发业务流程可以正常开展,没有大量误报。 **第三,合规维度:**管控范围符合法律要求,完成内部公示,审计日志完整留存,发生安全事件时能够完成溯源取证。 ![](https://developer.qcloudimg.com/http-save/yehe-12630035/582c394887d96e0b85d1ea3648877b39.png) ## 总结 终端防泄密不是一套 “装上就万事大吉” 的工具,它是补齐终端本地数据安全缺口的防护体系。它不能替代防火墙、EDR、PDM,需要和制度、人员意识配合。选型与落地,不追求策略越严越好,而是兼顾风险防护、业务连续性、法律合规三者平衡。 责编:璇玑

优秀的个人博客,低调大师

PDF 喂进知识库前,先过文档解析:被“粉碎”的版式,才是建库失败的真因

## **摘要**: 线性文本化会把 PDF 压成一段字符,标题层级、表格列名与数值、多栏顺序这些关系全部丢失,下游分块与检索随之失准。多模态解析(文档版)用阅读顺序、层级结构与图片资源保留这些关系,输出可直接入库的结构化结果。 ## 一、PDF 里的版式是怎么被“粉碎”的 把一份 PDF 交给一个“能读文字”的工具,它给出的结果往往看起来是对的——文字都在,顺序大致也对。问题在于,PDF 面向的是“人眼阅读时看到的那一版”,而文本抽取面向的是“把字符按一定顺序排出来”。这两者不是一回事:阅读时,标题的字号、段落的缩进、表格的边框、图片的位置,都在参与表达含义;一旦被压平成一段线性文字,这些参与表达的结构全部退出,只剩下一串字符。 这就是“粉碎”的含义。它不是把文字丢了,而是把文字之间的关系丢了。而后续的分块、检索、生成这一整条链路,依赖的恰恰是关系,不是字符。 建库之后发现答案不对、检索不准,最先被怀疑的通常是分块策略、检索参数或者模型,这三个环节也确实需要调。但能调好的前提,是解析产物本身还留着结构;结构在这一步就丢了,后面怎么调都补不回来。这也是解析必须放在入库之前的原因。 ### 1.1 标题层级丢失:目录与正文被拉平 一份规范的技术文档、制度文件或合同,靠的是章节层级来组织内容:第几章、第几节、第几条。层级决定了某一段话的适用范围——同样一句“最长不超过 30 天”,出现在“甲方义务”下面和出现在“免责条款”下面,含义完全不同。 线性文本化的结果是所有标题变成普通的一行文字,层级关系消失。入库之后,每一段文字都失去了它所在的“位置”,检索命中某一段时,系统无法判断它属于哪一章,生成答案时也就无法判断这句话管的是什么范围。 ### 1.2 表格被拆散:列名与数值失联 表格是容易在抽取过程中受伤的一类内容。线性文本化会把表格按行或按块转成文字:表头的列名出现一次,后面的数据行只剩下一串数字;如果表格跨页,第二页往往连列名都没有,只留下若干行数值。 数值一旦和列名分开,含义就不可恢复了。“合计金额 12800”这行字本身没错,但它指的是一月的还是一季度的、是含税还是不含税,取决于它原来在表格里的位置。检索到这样的片段,模型只能猜;猜出来的结果读起来通顺,却不一定是文档里写的意思。 ### 1.3 图片与公式变空白 图片、流程图、示意图、公式,在纯文本抽取里通常以两种方式消失:要么被整块跳过,输出里干脆没有这段内容;要么被替换成一小段占位文字。公式的情况更麻烦,很多 PDF 中的公式以矢量图形或特殊字体嵌入,文本抽取拿到的是一串符号乱序的字符。 后果是文档里存在“看不见的空洞”——正文写着“详见图 3”,而图 3 从来没有进入过解析结果;题干里写着“根据公式(2)计算”,公式(2)在库里是一串无法解析的字符。 ### 1.4 多栏阅读顺序错乱 双栏、三栏排版在学术论文、说明书、年报里很常见。按坐标从上到下扫描时,同一水平线上的左右两栏内容会被交错读出,形成“左栏第一段接右栏第一段接左栏第二段”的顺序。拿到这份输出的人只能靠语义猜测去拼回原文;而入库之后,这种错序会直接变成检索块的错序,甚至让相邻两栏的内容被切进同一个分块。 ## 二、“保全版式”具体保全什么 既然问题出在关系被丢掉,那么解析要做的就不是“尽可能多地把字读出来”,而是把关系一并保留下来。落到能力描述上,就是三项:阅读顺序、层级结构、图片资源。 这三项与前面列出的四类伤害并不是一一对应。表格的结构不由某一项单独承担,它与参数选择中的切片表格识别有关;以图形方式嵌入的内容,则由图片资源这一项承接。 ### 2.1 阅读顺序 阅读顺序回答的是“这些内容按什么次序读”。对多栏、横竖混排、图文穿插的文档,正确的阅读顺序等同于还原了一次人的阅读路径:先读完左栏再到右栏,先读正文再到图注。 它的价值在下游的分块环节体现得最直接:顺序正确,分块才能放心按结构边界来切;顺序错乱时,切出来的块从一出生就带着错误的上下文。 ### 2.2 层级结构 层级结构回答的是“这段内容属于哪里”。带层级结构输出,意味着标题与正文的从属关系在解析结果里仍然成立。 有了层级,分块就可以按章节来切,而不是按固定字数来切;检索命中某一段之后,也能顺着层级把父级标题一起带出来,作为判断这段内容适用范围的最小上下文。 ### 2.3 图片资源 图片资源回答的是“那些不能变成文字的内容去哪了”。解析结果不能只有文本流,还必须把文档中的图片单独抽出来保存成文件,让“图 3”这个引用有对应的实物。 图片资源承接的是以图片、图形方式存在的内容。如果业务需要的是公式的结构化表达式,而不是原样保留的图形,那属于另一类能力,选型时要单独确认。 这三件事配合起来,才构成“整份文档的可用表示”:文字有顺序,内容有归属,非文字内容有实体。只做文字识别、不做这三件事的方案,输出的仍然是碎片。 ## 三、解析结果长什么样、怎么入库 文档智能的多模态解析(文档版)用一个接口支持不同格式的文档解析,接口为 MultimodalDocParse。它的定位是助力企业文档智能化及大模型应用前处理环节,也就是把“入库前的这一步”做完整。 结果不是一段文本,而是一个 zip 压缩包。调用后获得结果的临时下载地址(ResultUrl),压缩包内包含 .md 文件、.json 文件以及 images 文件夹三部分:Markdown 便于直接阅读与展示,JSON 承载结构与坐标信息,images 文件夹保存文档中的图片资源。这里有一个容易踩坑的点:这个下载地址的有效期是 30 分钟,集成层应当在拿到地址后立即转存到自己的对象存储,而不是把地址存起来等后续任务再取。 下表是提交解析任务时的主要参数,其中对入库结果影响最直接的是输出形态(ResultType)与任务类型(TaskType)。 |参数|取值|说明| | --- | --- | --- | |FileType|1 PDF / 2 Word / 3 PPT / 4 Excel / 5 Markdown / 6 TXT / 7 图片 / 8 WPS|按实际文件类型指定,默认值 1| |ResultType|1 json / 2 markdown / 3 xml / 9 json + markdown + xml|默认值 9,即三种结果一起返回| |TaskType|0 文档解析 / 1 图片 OCR 识别 / 2 切片文字识别 / 3 切片表格识别 / 4 切片代码识别|默认值 0 文档解析| |PageRange|形如 1-10|指定需要识别的页码范围,单次调用最多 300 页| |EnableSubImg|true / false|是否支持子图解析,默认 false| ResultType 的选择取决于下游要什么:入库分块依赖结构,用 json;需要直接把内容展示给人看,用 markdown;默认值 9 一次拿到三种形态,适合使用方式还没定型的阶段。TaskType 则是“按文档主体内容选”——以表格为主体的报表类文档,走切片表格识别能更好地保留表格结构。 入库动作可以按这个顺序组织:按 FileType 和 PageRange 提交解析任务,拿到 zip 后解压,用 JSON 中的层级结构与阅读顺序重建分块,用 Markdown 作为可读文本,用 images 文件夹里的文件补齐正文中被引用的图。 ## 四、规格与成本口径 八类格式通用,差别主要在文件大小与页数上限:PDF、Word、PPT 支持 150M 且 300 页以内,Excel 支持 10M 以内,TXT 支持 10M 以内,图片文件支持 70M 以内;文件下载时间不超过 3 秒,单次调用最多支持 300 页,超过这个页数需要按 PageRange 分批。默认并发数为 5。 计费按页。后付费单价为 0.08 元/页,预付费资源包的阶梯价如下。 |资源包规格|价格|折合单价| | --- | --- | --- | |1000 页|70 元|0.07 元/页| |1 万页|600 元|0.06 元/页| |10 万页|5000 元|0.05 元/页| |100 万页|40000 元|0.04 元/页| 免费额度为 1000 页/用户,首次开通服务时一次性发放,有效期 1 年;付费资源包同样是 1 年有效期,采购量要按这一年里真实能用上的页数来定。 并发不够时可以购买并发买断包,价格为 3000 元/并发/月,单次下单最低购买 5 并发,购买页默认最高支持购买 10 并发,超过 10 并发需联系商务,主子账号共享并发任务数额度。按最低档计算,5 并发是 15000 元/月。 这里的并发指同时能接几个任务:5 并发表示同时可处理 5 个已提交的任务,约束的是“同时有几份文档在解析”,而不是单份文档的页数上限。要不要扩容取决于提交方式——集中在月底、季度末这类峰值时段,扩容能明显压缩总耗时;提交分散、对完成时间没有硬要求时,默认的 5 并发足够支撑。 ## 五、总结 入库前这一步决定了后面所有环节能拿到什么。文字被读出来只是及格线,阅读顺序、层级结构与图片资源被一并保留下来,文档才算真的可用。 决定采购之前,先按实际页数把量级估出来,再对照档位定价逐档核算。多模态解析(文档版)首次开通即发放 1000 页免费额度、一年内有效,用免费额度就够把一批真实文档的解析链路先跑通,不必一上来就付费;确认要放量之后,再对照 [文档智能特惠活动](https://cloud.tencent.com/act/pro/smart-ocr) 的折扣档位:多模态解析(文档版)新用户首单低至 5 折、不限新老用户低至 6 折,按页数选规格更划算。

优秀的个人博客,低调大师

适用于中小型团队的在线知识库系统-MrDoc觅思文档

当今信息爆炸的时代,有着海量的数据和信息,云文档应用提供创新的编辑体验、高效的笔记管理、团队协作和强大的版本管理,帮助您轻松管理和共享信息,实现无缝的工作和学习体验。 应用简览 MrDoc是一个开源的在线文档系统。MrDoc 适合作为个人和中小型团队的私有云文档、云笔记和知识管理工具,致力于成为优秀的私有化在线文档部署方案。 你可以简单粗暴地将 MrDoc 视为「可私有部署的语雀」和「可在线编辑文档的GitBook」。 主要功能 站点管理:轻松管理您的个人或团队站点,以及仪表盘数据概览。 文集管理:创建、编辑和组织文集,方便高效地分类和管理大量文档,确保信息结构清晰有序。 文档管理:灵活的文档管理系统,支持多种文档格式,使您能够轻松创建、编辑和分享文档。 文档模板管理:提供丰富的文档模板库,加速文档创建过程,让文档更具专业性和规范性。 图片管理:方便上传、组织和分享图片资源,支持图片预览和快速插入到文档中。 附件管理:安全管理附件文件,确保文档所需的附加资源得到妥善保存和共享。 个人管理:个性化设置,包括头像、个人信息等,使用户体验更符合个人需求。 文集控制:精细化的文集权限管理,确保只有授权人员可以访问和编辑相关文集内容。 文档书写:强大的文档编辑功能,支持富文本和Markdown格式,提供优雅的写作环境。 搜索引擎收录支持:优化站点结构,支持搜索引擎收录,提升站点内容的可见性和访问性。 sitemap站点地图:生成站点地图,有助于搜索引擎更有效地抓取和索引站点内容。 无限用户限制:无需担心用户数量限制,适用于个人用户、小型团队或大型组织。 无限空间限制:提供充足的云存储空间,确保您可以随时保存和管理大量文档和资源。 应用特色 一、首页概览 首页展示自建多元文集,每个文集是一个专业主题或感兴趣领域的汇总,以便于整理相关主题的高质量文章。以书籍形式的结构化文集作为文档的呈现形式,非常适合个人和小型团队作为私有化的文档、笔记和知识管理工具。 二、站点仪表盘 站点运行一目了然,仪表盘展示关键指标,如用户数、文集数、文档数等,让您迅速了解站点运营状况,为决策提供直观数据支持。 三、文档管理 高效组织、编辑和共享文档,支持多种格式,附带版本管理,为团队提供卓越的文档协作平台,助力信息流畅管理。 四、注册码管理 注册码可以添加多个,每个注册码可以限制最大使用次数,如果限制次注册码一百个人注册,当超过一百人之后自动失效。 五、站点设置 站点设置中包含多方面设置,基础设置、邮箱设置、文档设置。基础设置中包含多种控制开关以及广告位,文档设置中支持ifrme白名单、图片大小限制、附件格式、附件大小。 安装指南 进入云原生应用市场 搜索 MrDoc-觅思文档 进入详情,选择包类型(本应用支持,docker安装,ram安装) 点击安装,执行相应命令即可。如有疑问可参阅使用文档或加入社区 关于云原生应用市场 云原生应用市场是一个汇聚了各类开源软件的应用市场,不仅可以作为你自己的 Helm Chart 仓库,提供丰富多样的Helm应用,还有 Docker 应用、Rainbond 应用模板、信创应用等多种选择。 官网:https://hub.grapps.cn/ 微信群:关注 云原生应用市场 公众号加入技术交流群

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册