首页 文章 精选 留言 我的

精选列表

搜索[知识管理],共10000篇文章
优秀的个人博客,低调大师

超详细的MySQL数据库优化知识梳理

1 常见问题 阻塞 慢查询 2 可以从以下几个方面入手 服务器硬件优化 系统配置优化 数据库结构优化 SQL和索引 通常优化3和4 3 慢查询日志 show variables like 'slow_query_log'; # 开启慢查询日志 set global slow_query_log=on; # 查询慢查询日志文件存放的位置 show variables like 'slow_query_log_file'; # 设置慢查询日志文件存放的位置 set global slow_query_log_file= '/home/mysql/sql_log/mysql-slow.log' # 设置是否将没有使用索引的SQL记录到慢查询日志中 set global log_queries_not_using_indexes=on; # 设置是否将查询事件超过0秒的SQL记录到慢查询日志中,通产设置0.01秒 set global long_query_time=0; 4 实操 4.1 默认不开启慢查询日志 4.2 慢查询日志存储的位置 查询日志,这里我是Docker容器部署MySQL,映射在服务器上/data/mysql目录下 4.3 日志格式 第一行:执行SQL的主机信息 第二行:SQL的执行信息 第三行:SQL的执行事件 第四行:SQL的内容 5 慢查询日志分析工具 5.1 mysqldumpslow(官方工具) 5.1.1 参数解释 -s 是order的顺序 al 平均锁定时间 ar 平均返回记录时间 at 平均查询时间(默认) c 计数 l 锁定时间 r 返回记录 t 查询时间 -t 是top n的意思,即为返回前面多少条的数据 -g 后边可以写一个正则匹配模式,大小写不敏感的 5.1.2 基本使用 # 得到返回记录集最多的10个SQL。 mysqldumpslow -s r -t 10 /database/mysql/mysql06_slow.log # 得到访问次数最多的10个SQL mysqldumpslow -s c -t 10 /database/mysql/mysql06_slow.log # 得到按照时间排序的前10条里面含有左连接的查询语句。 mysqldumpslow -s t -t 10 -g “left join” /database/mysql/mysql06_slow.log # 另外建议在使用这些命令时结合 | 和more 使用 ,否则有可能出现刷屏的情况。 mysqldumpslow -s r -t 20 /mysqldata/mysql/mysql06-slow.log | more 5.2 pt-query-digest 5.2.1 快速安装 wget https://www.percona.com/downloads/percona-toolkit/2.2.16/RPM/percona-toolkit-2.2.16-1.noarch.rpm && yum localinstall -y percona-toolkit-2.2.16-1.noarch.rpm 5.2.2 参数解释 pt-query-digest [OPTIONS] [FILES] [DSN] --create-review-table 当使用--review参数把分析结果输出到表中时,如果没有表就自动创建。 --create-history-table 当使用--history参数把分析结果输出到表中时,如果没有表就自动创建。 --filter 对输入的慢查询按指定的字符串进行匹配过滤后再进行分析 --limit 限制输出结果百分比或数量,默认值是20,即将最慢的20条语句输出,如果是50%则按总响应时间占比从大到小排序,输出到总和达到50%位置截止。 --host mysql服务器地址 --user mysql用户名 --password mysql用户密码 --history 将分析结果保存到表中,分析结果比较详细,下次再使用--history时,如果存在相同的语句,且查询所在的时间区间和历史表中的不同,则会记录到数据表中,可以通过查询同一CHECKSUM来比较某类型查询的历史变化。 --review 将分析结果保存到表中,这个分析只是对查询条件进行参数化,一个类型的查询一条记录,比较简单。当下次使用--review时,如果存在相同的语句分析,就不会记录到数据表中。 --output 分析结果输出类型,值可以是report(标准分析报告)、slowlog(Mysql slow log)、json、json-anon,一般使用report,以便于阅读。 --since 从什么时间开始分析,值为字符串,可以是指定的某个”yyyy-mm-dd [hh:mm:ss]”格式的时间点,也可以是简单的一个时间值:s(秒)、h(小时)、m(分钟)、d(天),如12h就表示从12小时前开始统计。 --until 截止时间,配合—since可以分析一段时间内的慢查询。 5.2.3 基本使用 # 输出到文件 pt-query-digest slow-log > slow_log.report # 输出到数据库 --create-reviewtable 意思是慢查询日志输出到某一张表中 pt-query-digest slow.log -review h=127.0.0.1,D=test,p=root,P=3306,u=root.t=query_review --create-reviewtable --review-history t= hostname_slow 6 SQL优化 6.1 需要优化的SQL特征 查询次数多且每次查询占用时间长的SQL IO大的SQL(SQL中扫描行数越多,IO越大) 未命中索引的SQL 6.2 使用explain查询SQL的执行计划 6.2.1 解释说明 table 显示这一行数据时关于哪张表的 type 这是重要的列,显示连接使用了那种类型。从最好到最差的连接类型为const,eq_reg,ref,range,index,ALL。const常见于主键/唯一索引查找,eq_reg常见于主键的范围查找,ref常见于连接查询,range常见于索引的范围查找,index常见于索引的扫描,ALL常见于表扫描 possible_keys 显示可能应用在这张表中的索引。如果为空,没有可能的索引。 key 实际使用的索引。如果为NULL,则没有使用索引。 key_len 使用的索引长度。在不损失精确性的情况下,长度越短越好 ref 显示索引的那一列被使用了,如果可的话,是一个常数 rows MySQL认为必须检查的用来返回请求数据的行数 6.3 SQL优化 在经常查询的字段上适当加索引 避免子查询,可优化为连接查询,注意是否存在一对多关系,可能会出现数据重复 6.4 如何选择合理的列建立索引 在where从句,group by 从句,order by 从句,on 从句中出现的列 索引字段越小越好 离散度大的列放在联合索引的前面 例如: select * from payment where staff_id = 2 and customer_id = 584; 由于customer_id的离散度更大,所以应该使用index(customer_id,staff_id) 6.4.1 如何判断列的离散程度 select count(distinct customer_id),count(distinct staff_id) from payment 列的唯一值越高,离散程度越大,可选择性越高。 6.4.2 索引的维护和优化 重复及冗余索引,重复索引是指相同的列以相同的顺序建立的同类型的索引,如下面parmary key 和ID列上的索引就是重复索引 create table test(id int not null primart key),name vachar(10) not null,title varchar(50) not null,unique(id) ) engine=innodb 使用pt-duplicate-key-checker工具检查重复及冗余索引 pt-duplicate-key-checker -uroot -p'' -h 127.0.0.1 7 数据库及表结构优化 7.1 选择合适的数据类型 使用可以存下你的数据的最小的数据类型 使用简单数据类型,int要比varchar类型在MySQL处理上简单 尽可的使用not null 定义字段 尽量少用text类型,非用不可时最好考虑分表 例如 使用bigint来存储IP地址,利用INET_ATON(),INET__NTOA()两个函数进行转换 insert into sessions(ipaddress) values (INET_ATON('127.0.0.1')); select INET__NTOA('127.0.0.1') from sessions; 7.2 范式化和反范式化 7.2.1 范式化 第一范式,强调原子性,要求属性具有原子性,不可再分解 第二范式,强调主键,要求记录有唯一标识,即实体的唯一性,级不存在部分依赖 第三范式,强调外键,要求任何字段不能由其他字段派生出来,要求字段没有冗余,即不存在依赖传递 7.2.2 反范式化 为了查询效率的考虑,把原本符合第三范式的表适当的增加冗余,以达到优化查询效率的目的,反范式化是一种以控件来换时间的操作。 7.3 数据库结构的优化 7.3.1 表的垂直拆分 把原来一个有很多列的表拆分成多个表,这解决了表的宽度问题,通常垂直拆分可以按以下原则进行: 把不常用的字段单独存放在一个表中 把大字段独立存在在一个表中 把经常一起使用的字段放在一起 7.3.2 表的水平拆分 为了解决单表的数据量大的问题,水平拆分的表每一个表的结构都是完全一致的 8 系统配置优化 数据库是基于操作系统的,目前大多数MySQL都是安装在Linux上,所以对于操作系统的一些参数配置也会影响MySQL的性能,下面列出常用的系统配置 8.1 网络配置方面 修改/etc/sysctl.coonf文件 # 增加tcp支持的队列数 net.ip4.tcp_max_syn_backlog=65535 # 减少断开连接时,资源回收 net.ipv4.tcp_max_tw_buckets=8000 net.ipv4.tcp_tw_reuse=1 net.ipv4.tcp_tw_recycle=1 net.ipv4.tcp_fin_timeout=10 打开文件数的限制,可以使用ulimit -a查看目录的各位限制,可以修改/etc/security/limits.conf文件,增加以下内容以修改打开文件数量的限制 soft nofile 65335 hard nofile 65535 除此之外最好在MySQL服务器上关闭iptables,selinux 等防火墙软件 8.2 MySQL配置文件 8.2.1 配置文件路径 Linux:/etc/my.cnf 8.2.2 参数 innodb_buffer_pool_size:非常重要的参数,用于配置innodb的缓冲池如果数据库中只有innodb表,则推荐配置量为总内存的75% innodb_buffer_pool_instances:MySQL5.5中新增的参数,可以控制缓存池的个数,默认情况下只有一个缓存池 innodb_log_buffer_size:innodb log缓存的大小,由于日志最长每秒钟就会刷新所以一般不用太大 innodb_flush_log_at_trx_commit:关键参数,对innodb的IO效率影响最大,默认值为1,可以取0,1,2三个值,一般建议设置为2,但如果数据安全性要求比较高则使用默认值1 innodb_read_io_threads/innodb_write_io_threads:决定innodb读写IO的进程数,默认为4 innodb_file_per_table:关键参数,控制innodb没一个表使用独立的表空间,默认为OFF,也就是所有表都会建立在共享表空间中 innodb_stats_on_metadata:决定MySQL在什么情况下会刷新innodb表的统计信息 8.2.3 第三方配置工具 Percon Configuration Wizard 9 服务器硬件的优化 9.1 CPU 选择合适的CPU,单个频率更快的CPU MySQL一些工作只能使用到单核 MySQL对CPU的核数支持并不是越快越好,MySQL5.5使用的服务器不要超过32核 9.2 disk IO优化 常用RAID级别简介 RAID0:也成为条带,就是把多个磁盘连接成一个硬盘使用,这个级别IO最好 RAID1:也称为镜像,要求至少有两个磁盘,每组磁盘存储的数据相同 RAID5:也是把多个(最少3个)硬盘合并成一个逻辑盘使用,数据读写时会建立奇偶校验信息,并且奇偶校验信息和相对应的数据分别存储于不同的硬盘上。当RAID5的一个磁盘数据发生损坏后,就剩下的数据和相应的奇偶校验信息去恢复被损坏的数据。 RAID1+0:就是RAID1和RAID0的结合,同时具备两个级别的优缺点。一般建议数据库使用这个级别。 SNA和NAT是否适合数据库 常用于高可用的解决方案 顺序读写效率很高,但是随机读写不如人意 数据库随机读写效率很高

优秀的个人博客,低调大师

阿里云AIoT 经典基础知识 快问快答

业务数据流程 我的传感设备,IoT平台,业务服务器,App之间是什么关系? 上行数据链路: 设备以MQTT协议建立和 IoT 物联网平台的长连接,异步PUBLISH数据(Topic和Payload)到 IoT 平台 IoT 平台根据配置的规则引擎,处理数据后,流转到 数据库DB,消息队列MQ,函数计算FC 或者 通过AMQP协议流转到你的ECS服务器上 下行数据链路: ECS服务器程序调用HTTPS的Pub API,发送数据到 IoT 平台 IoT 平台通过MQTT协议,PUBLISH数据到设备端(指定Topic和Payload) FAQ 1.为什么设备无法上报数据? 您需要先定义具有发布权限的通信Topic 2.为什么设备无法接收数据? 您需要先定义具有订阅权限的通信Topic,并且设备主动subscribe此通信Topic定义Topic设备订阅Topic成功 3.设备一定要预先烧录三元组吗? 不需要,参考这个方案 https://developer.aliyun.com/article/770299 4.接入电信NB-IoT设备能对接到阿里云IoT吗? 可以,参考这个方案https://developer.aliyun.com/article/770009! 5.存量设备,不升级改造,能对接到阿里云IoT吗? 可以,参考这个方案https://developer.aliyun.com/article/770009 6.设备上线/离线日志 链路:设备→IoT平台(上线)、设备→IoT平台(离线) 7.物模型-属性上报处理过程的日志 消息链路:设备→IoT平台→物模型校验→物模型数据存储 8.自定义消息规则引擎流转 消息链路:设备→IoT平台→规则引擎→服务端订阅AMQP→业务服务器ECS→服务端订阅AMQP(ACK响应) 9.下行控制指令日志 消息链路:业务服务器ECS(Pub API)→IoT平台(Publish)→设备→IoT平台(PubAck响应) 10.私有协议脚本解析处理日志 消息链路:设备→IoT平台→自定义协议脚本解析→规则引擎→服务端订阅AMQP 【往期回顾】 1.自建MQTT集群迁移阿里云IoT平台2.IoT时代:WiFi配网技术剖析3.微信小程序和IoT智能家居实践4.IoT云端通用数据解析脚本实践

优秀的个人博客,低调大师

总结:一些关于 CPU 的基本知识

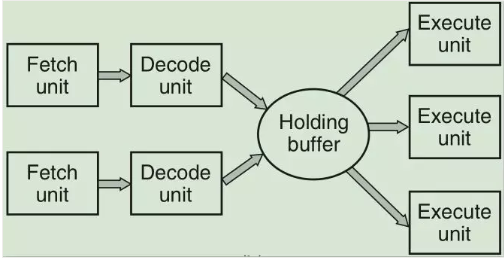
云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! CPU是计算机的大脑。1、程序的运行过程,实际上是程序涉及到的、未涉及到的一大堆的指令的执行过程。当程序要执行的部分被装载到内存后,CPU要从内存中取出指令,然后指令解码(以便知道类型和操作数,简单的理解为CPU要知道这是什么指令),然后执行该指令。再然后取下一个指令、解码、执行,以此类推直到程序退出。 2、这个取指、解码、执行三个过程构成一个CPU的基本周期。 3、每个CPU都有一套自己可以执行的专门的指令集(注意,这部分指令是CPU提供的,CPU-Z软件可查看)。正是因为不同CPU架构的指令集不同,使得x86处理器不能执行ARM程序,ARM程序也不能执行x86程序。(Intel和AMD都使用x86指令集,手机绝大多数使用ARM指令集)。注:指令集的软硬件层次之分:硬件指令集是硬件层次上由CPU自身提供的可执行的指令集合。软件指令集是指语言程序库所提供的指令,只要安装了该语言的程序库,指令就可以执行。 4、由于CPU访问内存以得到指令或数据的时间要比执行指令花费的时间长很多,因此在CPU内部提供了一些用来保存关键变量、临时数据等信息的通用寄存器。所以,CPU需要提供 一些特定的指令,使得可以从内存中读取数据存入寄存器以及可以将寄存器数据存入内存。 此外还需要提供加法、减、not/and/or等基本运算指令,而乘除法运算都是推算出来的(支持的基本运算指令参见ALU Functions),所以乘除法的速度要慢的多。这也是算法里在考虑时间复杂度时常常忽略加减法次数带来的影响,而考虑乘除法的次数的原因。 5、除了通用寄存器,还有一些特殊的寄存器。典型的如:PC:program counter,表示程序计数器,它保存了将要取出的下一条指令的内存地址,指令取出后,就会更新该寄存器指向下一条指令。堆栈指针:指向内存当前栈的顶端,包含了每个函数执行过程的栈帧,该栈帧中保存了该函数相关的输入参数、局部变量、以及一些没有保存在寄存器中的临时变量。PSW:program status word,表示程序状态字,这个寄存器内保存了一些控制位,比如CPU的优先级、CPU的工作模式(用户态还是内核态模式)等。 6、在CPU进行进程切换的时候,需要将寄存器中和当前进程有关的状态数据写入内存对应的位置(内核中该进程的栈空间)保存起来,当切换回该进程时,需要从内存中拷贝回寄存器中。即上下文切换时,需要保护现场和恢复现场。 7、为了改善性能,CPU已经不是单条取指-->解码-->执行的路线,而是分别为这3个过程分别提供独立的取值单元,解码单元以及执行单元。这样就形成了流水线模式。例如,流水线的最后一个单元——执行单元正在执行第n条指令,而前一个单元可以对第n+1条指令进行解码,再前一个单元即取指单元可以去读取第n+2条指令。这是三阶段的流水线,还可能会有更长的流水线模式。 8、更优化的CPU架构是superscalar架构(超标量架构)。这种架构将取指、解码、执行单元分开,有大量的执行单元,然后每个取指+解码的部分都以并行的方式运行。比如有2个取指+解码的并行工作线路,每个工作线路都将解码后的指令放入一个缓存缓冲区等待执行单元去取出执行。 9、除了嵌入式系统,多数CPU都有两种工作模式:内核态和用户态。这两种工作模式是由PSW寄存器上的一个二进制位来控制的。 10、内核态的CPU,可以执行指令集中的所有指令,并使用硬件的所有功能。 11、用户态的CPU,只允许执行指令集中的部分指令。一般而言,IO相关和把内存保护相关的所有执行在用户态下都是被禁止的,此外其它一些特权指令也是被禁止的,比如用户态下不能将PSW的模式设置控制位设置成内核态。 12、用户态CPU想要执行特权操作,需要发起系统调用来请求内核帮忙完成对应的操作。其实是在发起系统调用后,CPU会执行trap指令陷入(trap)到内核。当特权操作完成后,需要执行一个指令让CPU返回到用户态。 13、除了系统调用会陷入内核,更多的是硬件会引起trap行为陷入内核,使得CPU控制权可以回到操作系统,以便操作系统去决定如何处理硬件异常。关于CPU的基本组成 1、CPU是用来运算的(加法运算+、乘法运算*、逻辑运算and not or等),例如c=a+b。 2、运算操作涉及到数据输入(input)、处理、数据输出(output),a和b是输入数据,加法运算是处理,c是输出数据。 3、CPU需要使用一个叫做存储器(也就是各种寄存器)的东西保存输入和输出数据。以下是几种常见的寄存器(前文也介绍了一些)MAR: memory address register,保存将要被访问数据在内存中哪个地址处,保存的是地址值MDR: memory data register,保存从内存读取进来的数据或将要写入内存的数据,保存的是数据值AC: Accumulator,保存算术运算和逻辑运算的中间结果,保存的是数据值PC: Program Counter,保存下一个将要被执行指令的地址,保存的是地址值CIR: current instruction register,保存当前正在执行的指令 4、CPU还要将一些常用的基本运算工具(如加法器)放进CPU,这部分负责运算,称为算术逻辑单元(ALU, Arithmetic Logic Unit)。 5、CPU中还有一个控制器(CU, Control Unit),负责将存储器中的数据送到ALU中去做运算,并将运算后的结果存回到存储器中。控制器还包含了一些控制信号。 5、控制器之所以知道数据放哪里、做什么运算(比如是做加法还是逻辑运算?)都是由指令告诉控制器的,每个指令对应一个基本操作,比如加法运算对应一个指令。 6、例如,将两个MDR寄存器(保存了来自内存的两个数据)中的值拷贝到ALU中,然后根据指定的操作指令执行加法运算,将运算结果拷贝会一个MDR寄存器中,最后写入到内存。 7、这就是冯诺依曼结构图,也就是现在计算机的结构图。 关于CPU的多核和多线程 1、CPU的物理个数由主板上的插槽数量决定,每个CPU可以有多核心,每核心可能会有多线程。 2、多核CPU的每核(每核都是一个小芯片),在OS看来都是一个独立的CPU。 3、对于超线程CPU来说,每核CPU可以有多个线程(数量是两个,比如1核双线程,2核4线程,4核8线程),每个线程都是一个虚拟的逻辑CPU(比如windows下是以逻辑处理器的名称称呼的),而每个线程在OS看来也是独立的CPU。 这是欺骗操作系统的行为,在物理上仍然只有1核,只不过在超线程CPU的角度上看,它认为它的超线程会加速程序的运行。 4、要发挥超线程优势,需要操作系统对超线程有专门的优化。 5、多线程的CPU在能力上,比非多线程的CPU核心要更强,但每个线程不足以与独立的CPU核心能力相比较。 6、每核上的多线程CPU都共享该核的CPU资源。例如,假设每核CPU都只有一个"发动机"资源,那么线程1这个虚拟CPU使用了这个"发动机"后,线程2就没法使用,只能等待。所以,超线程技术的主要目的是为了增加流水线(参见前文对流水线的解释)上更多个独立的指令,这样线程1和线程2在流水线上就尽量不会争抢该核CPU资源。所以,超线程技术利用了superscalar(超标量)架构的优点。 7、多线程意味着每核可以有多个线程的状态。比如某核的线程1空闲,线程2运行。 8、多线程没有提供真正意义上的并行处理,每核CPU在某一时刻仍然只能运行一个进程,因为线程1和线程2是共享某核CPU资源的。可以简单的认为每核CPU在独立执行进程的能力上,有一个资源是唯一的,线程1获取了该资源,线程2就没法获取。但是,线程1和线程2在很多方面上是可以并行执行的。比如可以并行取指、并行解码、并行执行指令等。所以虽然单核在同一时间只能执行一个进程,但线程1和线程2可以互相帮助,加速进程的执行。并且,如果线程1在某一时刻获取了该核执行进程的能力,假设此刻该进程发出了IO请求,于是线程1掌握的执行进程的能力,就可以被线程2获取,即切换到线程2。这是在执行线程间的切换,是非常轻量级的。(WIKI: if resources for one process are not available, then another process can continue if its resources are available) 9、多线程可能会出现一种现象:假如2核4线程CPU,有两个进程要被调度,那么只有两个线程会处于运行状态,如果这两个线程是在同一核上,则另一核完全空转,处于浪费状态。更期望的结果是每核上都有一个CPU分别调度这两个进程。 关于CPU上的高速缓存 1、最高速的缓存是CPU的寄存器,它们和CPU的材料相同,最靠近CPU或最接近CPU,访问它们没有时延(<1ns)。但容量很小,小于1kb。 32bit:32*32比特=128字节64bit:64*64比特=512字节 2、寄存器之下,是CPU的高速缓存。分为L1缓存、L2缓存、L3缓存,每层速度按数量级递减、容量也越来越大。 3、每核心都有一个自己的L1缓存。L1缓存分两种:L1指令缓存(L1-icache)和L1数据缓存(L1-dcache)。L1指令缓存用来存放已解码指令,L1数据缓存用来放访问非常频繁的数据。 4、L2缓存用来存放近期使用过的内存数据。更严格地说,存放的是很可能将来会被CPU使用的数据。 5、多数多核CPU的各核都各自拥有一个L2缓存,但也有多核共享L2缓存的设计。无论如何,L1是各核私有的(但对某核内的多线程是共享的)。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-06-20本文作者:互联网架构师 本文来自:“互联网架构师 微信公众号 ”,了解相关信息可以关注“[互联网架构师](https://mp.weixin.qq.com/s/oUDJ7H7js2LpUMVzg5driA)

优秀的个人博客,低调大师

Android中高级面试题【理论知识】

1. ThreadLocal的理解 可以保证线程的安全。在多个线程共享相同的数据的时候,会为每个线程创建单独的副本,在单独的副本上进行数据的操作,不会对其它线程的数据产生影响,保证了线程安全。 2. HashMap HashSet HashTable的区别? 都是集合,底层都是Hash算法实现的。HashMap是Hashtable的替代品,这两个都是双列集合,而HashSet是单列集合。HashMap线程不安全、效率高、可以存储null键和null值;Hashtable线程安全,效率低,不可以存储null键和null值。 3. 如何让HashMap可以线程安全? HashMap 在并发执行 put 操作时会引起死循环,导致 CPU 利用率接近100%。因为多线程会导致 HashMap 的 Node 链表形成环形数据结构,一旦形成环形数据结构,Node 的 next 节点永远不为空,就会在获取 Node 时产生死循环。使用下面三种替换方式:HashtableConcurrentHashMapSynchronized Map 4. Android对HashMap做了优化后推出的新的容器类是什么? SparseArray它要比 HashMap 节省内存,某些情况下比HashMap性能更好,按照官方问答的解释,主要是因为SparseArray不需要对key和value进行auto-boxing(将原始类型封装为对象类型,比如把int类型封装成Integer类型),结构比HashMap简单(SparseArray内部主要使用两个一维数组来保存数据,一个用来存key,一个用来存value)不需要额外的额外的数据结构(主要是针对HashMap中的HashMapEntry而言的)。 5. Java多线程之间如何通信 等待唤醒机制 6. 线程池的实现机制 向线程池提交任务,会依次启动核心线程,如果提交的任务数超过了核心线程数,会将任务保存到阻塞队列中,如果阻塞队列也满了,且继续提交任务,则会创建新线程执行任务,直到任务数达到最大线程数。此时如果再提交任务的话会抛出异常或者直接丢弃任务。通过Executor.execute()无法得到返回值,通过ExecutorService.submit()可以得到返回值。 7. RxJava中map和flatmap操作符的区别及底层实现 Map返回的是结果集,flatmap返回的是包含结果集的Observable。Map只能一对一,flatmap可以一对多、多对多。RxJava是通过观察者模式实现的。 8. 对消息机制中Looper的理解 Looper在消息机制中扮演的角色是创造无限循环从Messagequeue中取得消息然后分发。 先领券再购买云产品》》 (不限新用户)云产品一折拼购直达地址》》aliyunp.com(阿里云拼团) (不限新老用户)阿里云双11优惠主会场直达地址》》aliyunh.com(阿里云优惠)! 9. 单例模式有哪些实现方式 饿汉模式(线程安全,调用效率高,但是不能延时加载)懒汉模式(线程安全,调用效率不高,但是能延时加载)双重检测锁模式(由于JVM底层模型原因,偶尔会出问题,不建议使用)静态内部类式(线程安全,调用效率高,可以延时加载)枚举类(线程安全,调用效率高,不能延时加载,可以天然的防止反射和反序列化调用) 10. 通过静态内部类实现单例模式有哪些优点 线程安全,调用效率高,可以延时加载 11. synchronized volatile关键字有什么区别?以及还有哪些同样功能的关键字 (1) volatile是变量修饰符,而synchronized则作用于一段代码或者方法。(2) volatile只是在线程内存和main memory(主内存)间同步某个变量的值;而synchronized通过锁定和解锁某个监视器同步所有变量的值。显然synchronized要比volatile消耗更多资源。const、final、lock 12. 界面卡顿的原因有哪些? UI线程(main)有耗时操作视图渲染时间过长,导致卡顿 13. 造成OOM/ANR 的原因? OOM: (1)不恰当地使用static关键字 (2)内部类对Activity的引用 (3)大量Bitmap的使用会导致程序包运行时的内存消耗变大 (4)游标Cursor对象用完应该及时关闭 (5)加载对象过大 (6)相应资源过多,来不及释放。ANR: (1)在5秒内没有响应输入的事件(IO操作耗时、数据库操作复杂耗时、主线程非主线程产生死锁等待、网络加载/图片操作耗时、硬件操作耗时) (2)BroadcastReceiver在10秒内没有执行完毕(Service binder数量达到上限、Service忙导致超时无响应) 14. Activity与Fragment生命周期有何联系 在创建的过程中,是Activity带领着Fragment,在销毁的过程中,是Fragment带领着Activity。这里写图片描述 15. Glide三级缓存 内存缓存,磁盘缓存、网络缓存(由于网络缓存严格来说不算是缓存的一种,故也称为二级缓存)。缓存的资源分为两种:原图(SOURCE)、处理图(RESULT)(默认)。内存缓存:默认开启的,可以通过调用skipMemoryCache(true)来设置跳过内存缓存,缓存最大空间:每个进程可用的最大内存*0.4。(低配手机0.33)磁盘缓存:分为四种:ALL(缓存原图)、NONE(什么都不缓存)、SOURCE(只缓存原图)、RESULT(之后处理图),通过diskCacheStrategy(DiskCacheStrategy.ALL)来设置,缓存大小250M。 16. MVC、MVP、MVVM的原理 (1) MVC,Model View Controller,是软件架构中最常见的一种框架,简单来说就是通过controller的控制去操作model层的数据,并且返回给view层展示。当用户发出事件的时候,view层会发送指令到controller层,接着controller去通知model层更新数据,model层更新完数据以后直接显示在view层上,这就是MVC的工作原理。这里写图片描述(2) MVP是MVC的演化。MVP的model层相对于MVC是一样的,而activity和fragment不再是controller层,而是纯粹的view层,所有关于用户事件的转发全部交由presenter层处理。presenter层充当了桥梁的作用,用于操作view层发出的事件传递到presenter层中,presenter层去操作model层,并且将数据返回给view层。这里写图片描述(3) MVVM和MVP的区别貌似不大,只不过是presenter层换成了viewmodel层,还有一点就是view层和viewmodel层是相互绑定的关系,这意味着当你更新viewmodel层的数据的时候,view层会相应的变动ui。这里写图片描述 17. 数据库的操作类型有哪些,如何导入外部数据库? (1) 增删改查(2) 将外部数据库放在项目的res/raw目录下。因为安卓系统下数据库要放在data/data/packagename/databases的目录下,然后要做的就是将外部数据库导入到该目录下,操作方法是通过FileInputStream读取外部数据库,再用FileOutputStrean把读取到的东西写入到该目录下。 18. 是否使用过 IntentService,作用是什么, AIDL 解决了什么问题? (1) IntentService继承自Service。由于Service运行在主线程,无法进行耗时操作。所以你需要在Service中开启一个子线程,并且在子线程中运行。为了简化这一操作,Android中提供了IntentService来进行这一处理。通过查看IntentService的源码可以看到,在onCreate中,我们开启了一个HandlerThread线程,之后获取HandlerThread线程中的Looper,并通过这个Looper创建了一个Handler。然后在onStart方法中通过这个Handler将intent与startId作为Message的参数进行发送到消息队列中,然后交由Handler中的handleMessage中进行处理。由于在onStart方法是在主线程内运行的,而Handler是通过工作者线程HandlerThread中的Looper创建的。所以也就是在主线程中发送消息,在工作者接收到消息后便可以进行一些耗时的操作。(2) 进程间通信 19. 是否使用过本地广播,和全局广播有什么差别? 本地广播的数据在本应用范围内传播,不用担心隐私数据泄露的问题。不用担心别的应用伪造广播,造成安全隐患。相比在系统内发送全局广播,它更高效。 20. Activity、 Window、 View 三者的差别, fragment 的特点? (1) Activity像一个工匠(控制单元),Window像窗户(承载模型),View像窗花(显示视图) LayoutInflater像剪刀,Xml配置像窗花图纸。(2) a. Fragment可以作为Activity界面的一部分组成出现; 可以在一个Activity中同时出现多个Fragment,并且一个Fragment也可以在多个Activity中使用; 在Activity运行过程中,可以添加、移除或者替换Fragment; Fragment可以响应自己的输入事件,并且有自己的生命周期,它们的生命周期会受宿主Activity的生命周期影响。 21. Handler、 Thread 和 HandlerThread 的差别 从Android中Thread(java.lang.Thread -> java.lang.Object)描述可以看出,Android的Thread没有对Java的Thread做任何封装,但是Android提供了一个继承自Thread的类HandlerThread(android.os.HandlerThread -> java.lang.Thread),这个类对Java的Thread做了很多便利Android系统的封装。android.os.Handler可以通过Looper对象实例化,并运行于另外的线程中,Android提供了让Handler运行于其它线程的线程实现,也是就HandlerThread。HandlerThread对象start后可以获得其Looper对象,并且使用这个Looper对象实例Handler。 22. 低版本 SDK 实现高版本 api 自己实现或使用注解@TargetApi annotation 23. launch mode 应用场景 (1) standard:标准的启动模式。 这里写图片描述(2) singleTop:单一顶部模式 如果Activity已经被开启,并且处于任务栈的栈顶,就不会创建新的Activity,而是复用这个已经开启的Activity。为了防止出现一些奇怪的用户体验,推荐使用单一顶部模式,整个任务栈可以有多个实例存在.应用场景:短信发送界面.这里写图片描述(3)singletask:单一任务栈 在整个任务栈里面只允许有一个当前Activity的实例存在如果要开启的Activity在任务栈中已经存在,直接复用这个已经存在的Activity,并且把这个Activity上面的所有的其他Activity给清空应用场景:如果一个Activity非常消耗内存和cpu资源,建议把这个Activity做成singletask的模式。浏览器的browserActivity这里写图片描述(4)singleinstance:单一实例. 整个手机操作系统只有一个实例存在,并且是运行在自己单独的任务栈里面.应用场景:通话界面的Activity这里写图片描述 24. touch 事件传递流程 事件处理包括三种情况,分别为:传递—-dispatchTouchEvent()函数、拦截——onInterceptTouchEvent()函数、消费—-onTouchEvent()函数和OnTouchListener。Android事件传递流程:(1) 事件都是从Activity.dispatchTouchEvent()开始传递(2) 事件由父View传递给子View,ViewGroup可以通过onInterceptTouchEvent()方法对事件拦截,停止其向子view传递(3) 如果事件从上往下传递过程中一直没有被停止,且最底层子View没有消费事件,事件会反向往上传递,这时父View(ViewGroup)可以进行消费,如果还是没有被消费的话,最后会到Activity的onTouchEvent()函数。(4) 如果View没有对ACTION_DOWN进行消费,之后的其他事件不会传递过来,也就是说ACTION_DOWN必须返回true,之后的事件才会传递进来(5) OnTouchListener优先于onTouchEvent()对事件进行消费 View不处理事件流程图View不处理事件流程图 View处理事件流程图View处理事件流程图 事件拦截事件拦截 25.Android性能优化 一、代码优化 1.使用AndroidLint分析结果进行相应优化2.不使用枚举及IOC框架,反射性能低3.常量加static4.静态方法5.减少不必要的对象、成员变量6.尽量使用线程池7.适当使用软引用和弱引用8.尽量使用静态内部类,避免潜在的内存泄露9.图片缓存,采用内存缓存LRUCache和硬盘缓存DiskLRUCache10.Bitmap优化,采用适当分辨率大小并及时回收 二、布局优化 避免OverDraw过渡绘制优化布局层级避免嵌套过多无用布局当我们在画布局的时候,如果能实现相同的功能,优先考虑相对布局,然后在考虑别的布局,不要用绝对布局。使用标签把复杂的界面需要抽取出来使用标签,因为它在优化UI结构时起到很重要的作用。目的是通过删减多余或者额外的层级,从而优化整个Android Layout的结构。核心功能就是减少冗余的层次从而达到优化UI的目的!ViewStub 是一个隐藏的,不占用内存空间的视图对象,它可以在运行时延迟加载布局资源文件。 三、ListView和GridView优化 1.采用ViewHolder复用convertView2.避免在getView中执行耗时操作3.列表在滑动状态时不加载图片4.开启硬件加速 26.Android内存泄漏 内存泄漏简单地说就是申请了一块内存空间,使用完毕后没有释放掉。它的一般表现方式是程序运行时间越长,占用内存越多,最终用尽全部内存,整个系统崩溃。由程序申请的一块内存,且没有任何一个指针指向它,那么这块内存就泄露了。可能的原因有:1.注册没取消造成内存泄露,如:广播2.静态变量持有Activity的引用3.单例模式持有Activity的引用4.查询数据库后没有关闭游标cursor5.构造Adapter时,没有使用 convertView 重用6.Bitmap对象不在使用时调用recycle()释放内存7.对象被生命周期长的对象引用,如activity被静态集合引用导致activity不能释放8.使用Handler造成的内存泄露 先领券再购买云产品》》 (不限新用户)云产品一折拼购直达地址》》aliyunp.com(阿里云拼团) (不限新老用户)阿里云双11优惠主会场直达地址》》aliyunh.com(阿里云优惠)!

优秀的个人博客,低调大师

(内含知识大图)

作者 |唐志龙(鲲龙) 阿里巴巴高级开发工程师 导读:本文总结了熟悉系统主要分三部分:业务学习、技术学习、实战。每部分会梳理一些在学习过程中需要解答的问题,这些问题随着经验的积累需要逐步补充完善。 前言 开发人员经常会面临下面一些场景: 新人入职,需要学习已有系统,作为 landing 的一部分,如何学习? 被拉过去参与一个陌生系统的迭代开发或者系统维护(bugfix),如何快速上手? 同事离职或转岗,需要把系统交接给你,怎么去接? 内心 os:这是一口锅吗? 这样的场景多了,就需要去梳理常见问题以及应对方法,方便后续遇到类似场景可以快速应对。本文总结熟悉系统主要分三部分:业务学习、技术学习、实战。每部分会梳理一些在学习过程中需要解答的问题,这些问题随着经验的积累需要逐步补充完善。 业务学习 业务学习就是从业务角度去学习系统,我们需要了解系统的

优秀的个人博客,低调大师

数据湖的这些知识点你了解吗

今天这篇文章主要介绍数据湖(data lake)的定义,其次介绍各大云厂商的解决方案以及目前的开源解决方案。 定义 看下维基百科的定义:数据湖是一个以原始格式(通常是对象块或文件)存储数据的系统或存储库。数据湖通常是所有企业数据的单一存储。用于报告、可视化、高级分析和机器学习等任务。数据湖可以包括来自关系数据库的结构化数据(行和列)、半结构化数据(CSV、日志、XML、JSON)、非结构化数据(电子邮件、文档、pdf)和二进制数据(图像、音频、视频)。定义中的重点内容我用红色字体标注出来,简单说明一下这几点。 原始格式:数据不做预处理,保存数据的原始状态 单一存储:存储库中会汇总多种数据源,是一个单一库 用于机器学习:除了 BI 、报表分析,数据湖更适用于机器学习 数据湖并不是新概念,最早 2015 年就被提出来了,可以看到数据湖经常被拿来跟目前的数据仓库作比较。下面是谷歌搜到的一篇比较早的数据湖和数据仓库对比的文章 至于为什么数据湖慢慢走近大家的视野,并且越来越多的跟仓库作比较。我认为主要是跟机器学习的广泛应用有很大关系。 数据湖和数据仓库的对比 大数据刚兴起的时候,数据主要用途是 BI 、报表、可视化。因此数据需要是结构化的,并且需要 ETL 对数据进行预处理。这个阶段数据仓库更适合完成这样的需求,所以企业大部分需要分析的数据都集中到数据仓库中。而机器学习的兴起对数据的需求更加灵活,如果从数据仓库中提数会有一些问题。比如:数据都是结构化的;数据是经过处理的可能并不是算法想要的结果;算法同学与数仓开发同学沟通成本较大等。我在工作中就遇到这种情况,做算法的同学需要经常理解我们的数仓模型,甚至要深入到做了什么业务处理,并且我们的处理可能并不是他们的想要的。基于上面遇到的各种问题,数据湖的概念应运而生。下面的表格对比一下数据湖和数据仓库的区别,主要来自 AWS 。 从以上表格的区别上我们可以看到数据湖的应用场景主要在于机器学习,并且在用的时候再建 Schema 更加灵活。虽然数据湖能够解决企业中机器学习应用方面的数据诉求,可以与数据仓库团队解耦。但并不意味着数据湖可以取代数据仓库,数据仓库在高效的报表和可视化分析中仍有优势。 云厂商的解决方案 近几年云计算的概念也是非常火,各大云厂商自然不会错失数据湖的解决方案。下面简单介绍阿里云、AWS 和 Azure 分别的数据产品。 阿里云:Data Lake Analytics,通过标准JDBC直接对阿里云OSS,TableStore,RDS,MongoDB等不同数据源中存储的数据进行查询和分析。DLA 无缝集成各类商业分析工具,提供便捷的数据可视化。阿里云OSS 可以存储各种结构化、半结构化、非结构化的数据,可以当做一个数据湖的存储库。DLA 使用前需要创建 Schema 、定义表,再进行后续分析。 AWS:Lake Formation,可以识别 S3 或关系数据库和 NoSQL 数据库中存储的现有数据,并将数据移动到 S3 数据湖中。使用 EMR for Apache Spark(测试版)、Redshift 或 Athena 进行分析。支持的数据源跟阿里云差不多。 Azure:Azure Data Lake Storage,基于 Azure Blob 存储构建的高度可缩放的安全 Data Lake 功能,通过 Azure Databricks 对数据湖中的数据进行处理、分析。但文档中并没有看到支持其他数据源的说明 开源解决方案 除了云厂商提供的方案外, 还有一个开源解决方案——kylo 。这个框架的关注度并不高,社区不是很活跃。大概看了下官网的介绍视频,基本上与云厂商的解决方案一致。支持多种数据源,分析时创建 Schema。另外,Databricks 团队(开源 Spark 框架)年初开源了 Delta lake 框架, Delta lake 是存储层,为数据湖带来了可靠性。Delta Lake 提供 ACID 事务、可伸缩的元数据处理,并统一流和批数据处理。Delta Lake运行在现有数据湖之上,与Apache Spark api完全兼容。架构图如下: 小结 今天这篇文章主要介绍了数据湖的概念,以及数据湖与数据仓库的区别,然后简单了解了目前数据湖在云厂商和开源软件中的解决方案。作为数仓建设和数据开发人员要密切关注这种新的概念,如果我们的工作中遇到这种问题我们也可以思考是否可以推动数据湖的建设。另外,作为中小企业上云的方案可能是一个比较好的选择,毕竟开源解决方案目前不是很成熟,社区还不是很强大。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册