首页 文章 精选 留言 我的

精选列表

搜索[notepad  ],共10025篇文章
优秀的个人博客,低调大师

Android -- Drag&&Drop

Android3.0提供了drag/drop框架,利用此框架可以实现使用拖放手势将一个view拖放到当前布局中的另外一个view中。 实现拖放的步骤 首先,我们先了解一下拖放过程,从官方文档可以知道,整个拖放过程共分为4个步骤,具体如下: 1、 Started:启动拖放,主要是调用被拖放View的startDrag方法。此方法原型为: public final boolean startDrag(ClipData data, View.DragShadowBuilder shadowBuilder, Object myLocalState, int flags) 启动后,系统生成拖放阴影并发送action为ACTION_DRAG_STARTED的拖放事件到当前布局中已经设置了拖放监听的View。 2、 Continuing:保持拖动状态。在此过程中系统可能会发送一个或多个拖动事件给设置了拖放监听器的View,比如ACTION_DRAG_ENTERED、ACTION_DRAG_LOCATION等。 3、 Dropped:用户在目标区域内释放拖动阴影,系统会向设置了拖放监听器的View发送action为ACTION_DROP的事件。 4、 Ended:用户释放了拖动阴影,系统会向设置了拖放监听器的View发送action为ACTION_DRAG_ENDED事件,完成拖放。 拖放过程中关键的接口和类 其次,我们要了解清楚拖放过程中的几个关键的接口和类,主要有OnDragListener、DragEvent、DragShadowBuilder、ClipData、ClipDescription等。 1、OnDragListener:接口,拖放事件监听器。当发生Drag时,回调此接口中的方法。接口中只含有一个方法onDrag,方法原型为: boolean onDrag(View v, DragEvent event) //参数v:设置了监听器的View //参数event:拖放事件的参数,封装了拖放相关的数据 //返回值:true-事件已处理;false事件未处理。 2、DragEvent:拖放事件对象,根据action的不同,包含不同的事件数据。 3、DragShadowBuilder:拖放阴影构造者对象,用于构造拖放阴影。 4、ClipData、ClipDescription:用于拖放的移动数据。 code <?xml version="1.0" encoding="utf-8"?> <RelativeLayout xmlns:android="http://schemas.android.com/apk/res/android" android:id="@+id/topContainer" android:layout_width="match_parent" android:layout_height="match_parent" android:orientation="vertical" > <ImageView android:id="@+id/img" android:layout_width="wrap_content" android:layout_height="wrap_content" android:contentDescription="@null" android:src="@drawable/ic_launcher" /> <LinearLayout android:id="@+id/container" android:layout_width="match_parent" android:layout_height="100dp" android:layout_alignParentBottom="true" android:orientation="vertical" android:background="#cccccc" > <TextView android:id="@+id/title" android:layout_width="fill_parent" android:layout_height="wrap_content" android:textColor="#ff0000" android:textSize="18sp" /> </LinearLayout> </RelativeLayout> 为ImageView绑定长点击事件 imageView.setOnLongClickListener(new OnLongClickListener() { @Override public boolean onLongClick(View v) { //创建移动数据 ClipData.Item item = new ClipData.Item((String) v.getTag()); ClipData data = new ClipData(IMAGEVIEW_TAG, new String[] { ClipDescription.MIMETYPE_TEXT_PLAIN }, item); //调用startDrag方法,第二个参数为创建拖放阴影 v.startDrag(data, new View.DragShadowBuilder(v), null, 0); return true; } }); 为目标View绑定拖拽监听: container.setOnDragListener(new OnDragListener() { @Override public boolean onDrag(View v, DragEvent event) { final int action = event.getAction(); switch (action) { case DragEvent.ACTION_DRAG_STARTED: //拖拽开始事件 if (event.getClipDescription().hasMimeType( ClipDescription.MIMETYPE_TEXT_PLAIN)) { return true; } return false; case DragEvent.ACTION_DRAG_ENTERED: //被拖放View进入目标View container.setBackgroundColor(Color.YELLOW); return true; case DragEvent.ACTION_DRAG_LOCATION: return true; case DragEvent.ACTION_DRAG_EXITED: //被拖放View离开目标View container.setBackgroundColor(Color.BLUE); title.setText(""); return true; case DragEvent.ACTION_DROP: //释放拖放阴影,并获取移动数据 ClipData.Item item = event.getClipData().getItemAt(0); String dragData = item.getText().toString(); title.setText(dragData+event.getY()+":"+event.getX()); return true; case DragEvent.ACTION_DRAG_ENDED: //拖放事件完成 return true; default: break; } return false; } }); imageView的位置 topContainer.setOnDragListener(new OnDragListener() { @Override public boolean onDrag(View v, DragEvent event) { final int action = event.getAction(); switch (action) { case DragEvent.ACTION_DRAG_STARTED: return true; case DragEvent.ACTION_DRAG_ENTERED: return true; case DragEvent.ACTION_DRAG_LOCATION: return true; case DragEvent.ACTION_DRAG_EXITED: return true; case DragEvent.ACTION_DROP: imageView.setX(event.getX()-imageView.getWidth()/2); imageView.setY(event.getY()-imageView.getHeight()/2); return true; case DragEvent.ACTION_DRAG_ENDED: return true; default: break; } return false; } }); 效果 我是天王盖地虎的分割线 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/4473992.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

【Windows10&amp;nbsp;IoT开发系列】PowerShell的相关配置

原文: 【Windows10IoT开发系列】PowerShell的相关配置 可使用 Windows PowerShell 远程配置和管理任何 Windows 10 IoT 核心版设备。PowerShell 是基于任务的命令行 Shell 和脚本语言,专为进行系统管理而设计。 1.​启动 PowerShell (PS) 会话 注:若要使用装有Windows10 IoT Core设备启动PS会话,首先需要在主机电脑与设备之间创建信任关系。 ​启动 Windows IoT 核心版设备后,与该设备相连的屏幕上将显示一个 IP 地址: (![Windows 10 IoT 核心版上的 CoreDefaultApp](/content/images/DefaultApp.png) 可在Windows10 IoT Core Watcher实用工具中找到相同信息。) Windows10 IoT Core启动界面 ​在本地电脑上启动管理员 PS 控制台。 (在 Windows“开始”菜单旁的“搜索 Web 和 Windows”文本框中键入“powershell”) 搜索Powershell 以管理员身份启动 PS,请右键单击“Windows PowerShell”项并选择“以管理员身份运行”: 管理员身份 Powershell控制台: Powershell 主界面 ​ 注:需要在桌面上启动 WinRM 服务以启用远程连接,在 Powershell 控制台中,输入: net start WinRM​ ​在 Powershell 控制台中,键入以下命令,从而使用相应的值替代: ​Set-Item WSMan:\localhost\Client\TrustedHosts -Value 输入 Y 以确认更改。 现在,使用 Windows IoT 核心版设备启动会话,在管理员身份 PS 控制台中,键入: ​Enter-PSSession -ComputerName -Credential \Administrator 在凭据对话框中,输入以下默认密码:p@ssw0rd 成功运行 更改账户密码:在 PowerShell 连接中发出以下命令 ​net user Administrator [new password] 完成操作后,需要使用具有新凭据的 Exit-PSSession 和 Enable-PSSession 来建立新的 PowerShell 会话。 Exit-PSSession Enter-PSSession -ComputerName -Credential \Administrator​ 2.Visual Studio 远程调试程序疑难解答 为了能够从 Visual Studio 2015 部署应用程序,需确保 Visual Studio 远程调试程序正在 Windows IoT 核心版设备上运行。远程调试器应在计算机启动时自动启动,若要检查启动情况,请使用 tlist 命令列出 powershell 中所有正在运行的进程,应有两个 msvsmon.exe 的实例正在设备上运行。 在长时间都处于非活动状态后,Visual Studio 远程调试器可能会出现超时。若Visual Studio 无法连接到 Windows IoT 核心版设备,请尝试重新启动设备。 3.​配置 Windows IoT 核心版设备 ​更改“计算机名”,请使用 setcomputername 实用工具: setcomputername ​重新启动设备使更改生效,使用 shutdown 命令: shutdown /r /t 0 ​重新启动后,由于计算机名称已更改,需要重新运行此命令,以便连接到设备: Set-Item WSMan:\localhost\Client\TrustedHosts -Value 4.已知问题与解决方法 ​问题:PowerShell 安全策略中的一个已知 Bug 会导致远程会话内的清单出现以下问题: ① Get-Help 返回异常匹配项。 ② 指定模块上的 Get-Command 将返回空命令列表。 ③ 从以下任意模块运行 cmdlet 将引发 CommandNotFoundException: Appx、NetAdapter、NetSecurity、NetTCPIP、PnpDevice。 ④ 上述任意模块上的 Import-Module 将引发 PSSecurityException 异常(包含 UnauthorizedAccess)。模块自动加载似乎也不起作用。 解决方法: 将远程 PowerShell 会话内的执行策略修改为“RemoteSigned”。 有关其他执行策略的更多详细信息,请参考https://technet.microsoft.com/zh-cn/library/ee176961.aspx 问题:有时,某些模块中的 cmdlet(如 NetAdapter)不可见。例如,Get-Module NetAdapter 将返回一个空列表。 解决方法: 将“-Force”参数与 Import-Module 结合使用。例如,Import-Module NetAdapter -Force。 问题: 将执行策略设置为“AllSigned”时会中断 PS 远程控制。创建远程会话的后续尝试均失败,并且 SecurityException 正在加载 Typesv3.ps1xml。 解决方法: 使用 winrs.exe 还原 Powershell 执行策略: ① 更改控制台代码页 Chcp 65001 ② 登录到远程 cmd.exe shell Winrs.exe -r: -u: -p: cmd.exe ③ 在远程 cmd.exe 内,修改相应的注册表项 reg add HKLM\Software\Microsoft\PowerShell\1\ShellIds\Microsoft.PowerShell /v ExecutionPolicy /d RemoteSigned /f ④ 退出远程 cmd.exe 会话 exit 本文​主要资源来自Windows 开发中心。

优秀的个人博客,低调大师

JavaEE课程概述 &amp;&amp; JavaEE基础班课程概述 &amp;&amp; JavaEE就业班课程概述

JavaEE课程概述 阶段 知识点概述 能解决的问题 市场价值 Java基础阶段 计算机基础知识编程基础面向对象异常图形化界面常用类介绍集合IO多线程网络编程数据存储综合案例 学生具备javase本地应用开发能力能够在本机开发一些应用软件例如:压缩软件、下载软件、聊天软件、模拟DOS系统、综合信息管理软件 ¥5000 JavaWeb+SSH框架阶段 HTMLCSSJavaScriptJQueryBootStarp响应式页面MySQLJDBC服务器端技术:WEB通信、Tomcat服务器,Servlet、request、response、Cookie、session、jsp、EL、JSTL过滤器、监听器AJAX技术传智商城文件上传与下载Linux服务器部署Nginx+Tomcat搭建集群完成负载均衡部署到阿里云Struts2框架学习Hibernate框架学习Spring框架学习Maven 学生具备简单网站的开发能力,并结合阿里云,具备了真实环境的项目部署能力,已经能够在企业担任javaee工程师开发岗位 ¥8000 综合项目实战阶段一 OracleWebServiceJQueryEasyUISpringData互联网金融(P2P)、物流、医疗等项目实战 综合项目一,完整的贯穿了之前学习的内容,并且引入权限、报表、接口、支付、缓存、消息队列等诸多主流就业元素,凭借此项目学员可以斩获万元薪资岗位 ¥10000 综合项目实战阶段二 MyBatis框架SpringMVC框架SSM框架整合LuceneSolrRedisZookeeperB2C大型购物网站项目实战 综合项目二,在综合项目一基础上对集群、高并发、优化,进行了针对增强,这些主流的高级就业元素,可以让学员更轻松面对互联网开发岗位 ¥12000 云计算之大数据阶段 Hadoop入门HDFS分布式文件系统MapReduce分布式计算模型ZooKeeper分布式协调框架HAdoop集群管理YARN资源调度系统Sqoop数据迁移工具Hbase分布式数据库Hive数据仓库Storm实时计算论坛日志分析项目 综合项目三,在互联网数据爆炸时代,大数据分析计算势必成为主流,Hadoop、Storm这些主流大数据分析计算框架肯定可以帮助学员在云计算大数据方向占尽先机 ¥15000 为知笔记链接:JavaEE基础班课程概述 为知笔记链接:JavaEE就业班课程概述我的GitHub地址: https://github.com/heizemingjun 我的博客园地址: http://www.cnblogs.com/chenmingjun 我的蚂蚁笔记博客地址: http://blog.leanote.com/chenmingjun Copyright ©2018 黑泽明军 【转载文章务必保留出处和署名,谢谢!】

优秀的个人博客,低调大师

WebSphere MQ&amp;&amp;Active MQ

WebSphere MQ 1、中间件处于应用软件与系统软件之间,是一种以自己的复杂换取企业应用简单化的可复用的基础软件,它使用系统软件所提供的基础服务(功能),衔接网络上应用系统的各个部分或不同的应用,能够达到资源共享、功能共享的目的。 2、三种通信技术: RPC(remote process call):同步; CPI-C:同步; MQI(message queue interface):异步通信方式,通信的方式与传送协议无关。 3、中间件产品: 消息中间件:IBM WebSphere MQ 交易中间件:IBM CICS,Bea tuxedo 对象中间件:IBM componentbroker,ionaorbix,borland,visibroker 应用服务器:IBM WebSphere,Bea weblogic 安全中间件:entrust 应用集成服务器:lss flowwan,IBM flowman,vitria businessagiliti 4、WebSphere MQ由消息传输系统和应用程序接口组成,资源是消息和队列; 消息传输系统:用于确保队列之间的消息提供,包括网络中不同系统上的远程队列之间的消息提供,并保证网络故障或关闭后的恢复; 应用程序接口:应用程序和消息系统之间通过WebSphere MQ API实现(API在所有WebSphere MQ平台上是一致的,API只有14个调用2个动作(发送put和接收get)) 消息:Request Message,Reply Message,Report Message,Datagram Message 一个消息包含两个因素:消息描述和数据消息 消息描述:用于定义,如消息传输目标 数据消息:如应用程序数据或数据库查询 队列:一个安全的存储消息的地方,消息的存储一般是顺序的,队列是消息分阶段的传送和接收,因为消息存放在队列中,所以应用程序可以相互独立的运行,以不同的速度,在不同的时间,不同的地点; 注:程序之间的通信通过传递消息而非直接调用程序;WebSphere MQ最基本而最重要的技术——可靠消息传输,它具有特殊的技术防止消息重复传送,确保消息一次且仅一次传送(once-and-only-once) 5、重要特点: 统一接口:目标应用程序位置的透明性(target application location transparency); 处理不依赖时间的限制:异步处理 给分布式处理提供强健的中间件:保证数据一致性,信息的传输(once-and-only-once),并可在系统故障时,及时恢复,业务不受影响 小节: WebSphere MQ是基于消息队列Message Queue或消息传送MessagePassing的中间件,主要功能是在应用程序之间传送消息,这些消息可以在不同的网络协议,不同的计算机系统和不同的应用软件之间传送,使用它可简单方便的开发出可靠高效的分布式应用系统; WebSphere的技术可实施在广泛的IBM和非IBM平台上,提供了一个面向业务的信息技术架构(基于WebSphere MQ的应用程序可以更接近的模拟商业问题,更容易设计、开发和维护),使得基于它的应用无结构限制,应用程序之间可以是一对一、一对多、多对多的关系,应用程序之间信息传递可以是单向或双向,灵活的结构,支持平衡工作负荷、并发处理、多路广播及其它应用程序之间的关系,总之是应用程序充分接近业务需求,并且当应用需求改变时,WebSphere MQ的结构可以很容易的跟着改变。 Active MQ: 1、Active MQ是开源的JMS的实现,部分特点:多种语言和协议编写;完全支持JMS和J2EE各版本;支持Ajax(异步应用);调整的信息持久化等。 2、消息生产者――》消息队列――》消费者 JMS(java message service):MOM(messageoriented middleware面向消息的中间件),应用程序在异步情况下可靠的传输和接收消息 Message producer:消息生产者 JMS provider:消息提供者(中转站) JMS consumer:消费者(接收者) JMS消息传递模式: 点对点模式:p2p,每个消息只能被一个接收者接收;每条消息要么被接收者从队列中取走,要么被JMS Provider在超时情况下删除;消息产生的时候接收者不一定存在,接收者可以在消息产生的任何时候取走消息; 发布/订阅模式:发送者为发布者,接收者为订阅者,一个消息可以有很多接收者,订阅者只能接收它订阅的主题中的消息,订阅者在消息发送的时候必须是活动的,并随时准备接收消息,否则会错过该消息。 JMS消息的组成:消息头(header);属性(property);消息体(body):bytemessage,mapmessage,streammessage,textmessage,objectmessage. 3、安装(必须先安装JDK(JavaDevelopment kit)才能装Active MQ): #mkdir/usr/java #tarzxvf /usr/src/ jdk-8u51-linux-x64.tar.gz -C/usr/java/ #cd/usr/java/ #ln-s jdk1.8.0_51 /usr/java/jdk #ls-l(查看链接是否正确) #vim/etc/profile.d/java.sh JAVA_HOME=/usr/java/jdk Export JAVA_HOME Export PATH=$PATH:$JAVA_HOME/bin:$JAVA_HOME/jre/bin #source/etc/profile.d/java.sh #java-version #javac-version(有正确结果输出则环境配置正确) #tarzxvf /usr/src/ apache-activemq-5.12.0-bin.tar.gz -C/usr/java/ #cd/usr/java/ #ln-s apache-activemq-5.12.0 /usr/java/activemq #ll(查看软链接是否正确) #vim/usr/java/activemq/conf/activemq.xml(主配置文件,通过此文件可优化配置,如撤销存储策略,broker的memoryUsage阀值,配置监听IP<transportConnectors>段等) #/usr/java/activemq/bin/activemq start|stop #netstat lntup |egrep“61616|8161” #ps-ef | grepactivemq #pkilljava http://localhost:8161/admin(浏览器登陆,可用图形化管理,首次登陆用户名密码均为admin) 本文转自 chaijowin 51CTO博客,原文链接:http://blog.51cto.com/jowin/1688986,如需转载请自行联系原作者

优秀的个人博客,低调大师

Choosing Between ElasticSearch, MongoDB &amp;amp; Hadoop

An interesting trend has been developing in the IT landscape over the past few years. Many new technologies develop and immediately latch onto the “Big Data” buzzword. And as older technologies add “Big Data” features in an attempt to keep up with the Joneses, we areseeing a blurring of the boundaries between various technologies. Say you have search engines such as ElasticSearch or Solr storing JSON documents, MongoDB storing JSON documents, or a pile of JSON documents stored in HDFS on a Hadoop cluster. Interestingly enough, you can fulfill many of the same use cases with any of these three configurations. ElasticSearch as a NoSQL database? Superficially, that doesn’t sound right, but nonethelessit is a valid scenario. Likewise, MongoDB with support for MapReduce over sharded collections can accomplish many of the same things as Hadoop. And, of course, with the many tools that you can layer on top of a Hadoop base (Hive, HBase, Pig, and the like) you can query data from your Hadoop cluster in a multitude of ways. Given that, can we now say that Hadoop, MongoDB and ElasticSearch are all exactly equivalent? Of course not. Each tool still has a niche for which it is most ideally suited, but each has enough flexibility to fulfill multiple roles. The question now becomes “What is the ideal use for each of these technologies”, and that my friends is what we will explore now. ElasticSearch has begun to spread beyond its roots as a “pure” search engine and now adds some features for analytics and visualization - but at its core,remains primarily a full-text search engine for locating documents by keyword. ElasticSearch builds on top of Lucene and supports extremely fast lookup and a rich query syntax. If you have millions (or more) of text documents and you need to locate documents by keywords located in that text, ElasticSearch fits the bill perfectly. Yes, if your documents are JSON you can treat ElasticSearch as a sort of lightweight “NoSQL database”. But ElasticSearch is not quite a “database engine” and provides less support for complex calculations and aggregation as part of a query - although the “statistics” facet does provide some ability to retrieve calculated statistical information scoped to the given query. Facets in ElasticSearch are intended mainly to support a “faceted navigation” facility. If you are looking to return a (usually small) collection of documents in response to a keyword query, and want the ability to support faceted navigation around those documents, then ElasticSearch is probably your best, first choice. If you need to perform more complex calculations, run server-side scripts against your data, and easily run MapReduce jobs on your data, then MongoDB or Hadoop enter the picture. 假设你的目的是通过指定keyword查询取得一个文档集合(一般是较小的),而且具有支持对文档基于切面的导航,elasticsearch会非常合适,可是假设你希望支持很多其它复杂的计算,在server端你的数据上执行脚本,非常easy的在你的数据上执行mapreduce成寻。那么MongoDB和Hadoop就在被考虑的范围里边了。 MongoDB is a “NoSQL” database which is designed from the ground up to be highly scalable, with automatic sharding support and a number of additional performance optimizations. MongoDB is a document oriented database which stores document in a “JSON like” format (technically BSON) with some extensions beyond plain JSON - for example, a native date type. MongoDB provides a text index type for supporting full-text search against fields which contain text, so we can see that there is overlap between what you can do with ElasticSearch and MongoDB, in terms of basic keyword search against a collection of documents. Where MongoDB goes beyond ElasticSearch is its support for features like server-side scripts in Javascript, aggregation pipelines, MapReduce support and capped collections. With MongoDB, you can use aggregation pipelines to process documents in a collection, streaming them through a sequence of pipeline operators where each operator transforms the document. Pipeline operators can generate entirely new documents or remove documents from the final output. This is a very powerful facility for filtering, processing and transforming data as it is retrieved. MongoDB also supports running map/reduce jobs over the data in a collection, using custom Javascript functions for the map and reduce phases of the operation. This allows for ultimate flexibility in performing any type of calculation or transformation to the selected data. 与ES相比,MongoDB超过es的地方是支持server端的javascript和聚合管道 以及MapReduce的支持和capped collections Another extremely powerful feature in MongoDB is known as “capped collections”. With the capped collections facility, a user can define a maximum size for a collection - after which the collection can simply be written to blindly, and it will roll-over data as necessary to maintain the specified size limit. This feature is extremely useful for capture logs and other streaming data for analysis. 另外一个很NB的特征是capped collections;通过capped collections。用户能够定义为一个collection定义最大的size,用来插入数据(仅仅能插入更新 不能删除)。依照LRU挤出数据存放新插入的数据,这个特点很适合获取log数据和流数据的存储和分析 科普一下capped collections 特点: 1.仅仅能插入,更新,不能删除doc,能够使用drop()删除整个collection 2.LRU列表。相信大家对这个应该非常了解了,oracle里面非常多地方就是用的这个规则,假设指定的集合大小满了。那么会依照LRU挤出数据存放新插入的数据,这里记得更新是不能超出collection的大小的,不能挤出空间存放更新的数据,这个也合情合理。 3.插入的记录都是依照插入的顺序排列,普通的collection在_id上是肯定有索引的,可是这里是没有的 4.能够高速的查询和插入。假设写比读的比例大。建议不要建立索引。否则写会耗费非常多额外的资源。 As you can see, while ElasticSearch and MongoDB have some overlap in possible use cases, they are not the same tool. But what about Hadoop? Isn’t Hadoop “just MapReduce” which is supported by MongoDB anyway? Is there really a use case for Hadoop where MongoDB isjust as suitable. In a word, yes. Hadoop is the grand-father of MapReduce based cluster computing frameworks. Hadoop provides probably the overall most flexible and powerful environment for processing large amounts of data, and definitely fits niches for which you would not use ElasticSearch or MongoDB. To understand why this is true, look at how Hadoop abstracts storage - via HDFS - from the associated computational facility. With data stored in HDFS, any arbitrary job can be run against that data, using either Java code written to the core MapReduce API, or arbitrary code written in native languages using Hadoop Streaming. And starting with Hadoop2 and YARN, even the core programming model is abstracted so that you aren’t limited to MapReduce. With YARN you can, for example, implement MPI on top of Hadoop and write jobs in that style. Additionally, the Hadoop ecosystem provides a staggering array of tools that build on top of HDFS and core MapReduce to query, analyze and process data. Hive provides a “SQL like” language that allows Business Analysts to query data using a syntax they are already familiar with. HBase provides a column oriented database on top of Hadoop. Pig and Sizzle provide two more alternative programming models for querying Hadoop Data. With data stored in HDFS using Hadoop, you inherit the ability to simply plugin Apache Mahout to use advanced machine learning algorithms on your data. While using RHadoopis straightforward to use the R statistical language to perform advanced statistical analyses on Hadoop data. So while Hadoop and MongoDB also have some overlapping use cases, and share some useful functionality (seamless horizontal scalability, for example) it remains the case that each tool serves a specific purpose in enterprise computing. If you simply want to locate documents by keyword and perform simple analytics, then ElasticSearch mayfit the bill. If you need to query documents that can be modeled as JSON and perform moderately more sophisticated analysis, then MongoDB becomes a compelling choice. And if you have a huge quantity of data that needs a wide variety of different types of complex processing and analysis, then Hadoop provides the broadest range of tools and the most flexibility. As always, it is important to choose the right tool(s) for the job at hand. And in the “Big Data” space the sheer number of technologies and the blurry lines can make this difficult. As we can see, there are specific scenarios which best suit each of these technologies and, more importantly,the differences do matter. Though, the best news of all isyou are notlimited to using only one of these tools. Depending on the details of your use case, it may actually make sense to build a combination platform. For example, ElasticSearch and Hadoop are known to work well together, with ElasticSearch providing rapid keyword search, and Hadoop jobs powering the more complicated analytics. In the end, it takes ample research and careful analysis to make the best choices for your computing environment. Before selecting any technology or platform, take the time to evaluate it carefully, understand what scenarios it was designed to optimize for, and what tradeoffs and sacrifices it makes. Start with a small pilot project to “kick the tires” before converting your entire enterprise to a new platform, and slowly grow into the new stack. Follow these steps and you can successfully navigate the maze of “Big Data” technologies and reap the associated benefits.\ 本文转自:http://www.osintegrators.com/opensoftwareintegrators%7CChoosing-Between-ElasticSearch-MongoDB-%2526-Hadoop 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/5208702.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android Step Counter &amp;amp; Detector Sensor

package zhangphil.sensor; import android.content.Context; import android.hardware.Sensor; import android.hardware.SensorEvent; import android.hardware.SensorEventListener; import android.hardware.SensorManager; import android.support.v7.app.AppCompatActivity; import android.os.Bundle; import android.util.Log; public class MainActivity extends AppCompatActivity { private String TAG = "ZHANG PHIL"; private SensorManager mSensorManager; @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); startSensor(); } /** * 启动传感器。 */ private void startSensor() { mSensorManager = (SensorManager) this.getSystemService(Context.SENSOR_SERVICE); Sensor mStepCounterSensor = mSensorManager.getDefaultSensor(Sensor.TYPE_STEP_COUNTER); Sensor mStepDetectorSensor = mSensorManager.getDefaultSensor(Sensor.TYPE_STEP_DETECTOR); if (mSensorManager == null || mStepCounterSensor == null || mStepDetectorSensor == null) { throw new UnsupportedOperationException("设备不支持"); } mSensorManager.registerListener(mSensorEventListener, mStepCounterSensor, SensorManager.SENSOR_DELAY_NORMAL); mSensorManager.registerListener(mSensorEventListener, mStepDetectorSensor, SensorManager.SENSOR_DELAY_NORMAL); } private SensorEventListener mSensorEventListener = new SensorEventListener() { private float step, stepDetector; @Override public void onSensorChanged(SensorEvent sensorEvent) { /** * 计步计数传感器传回的历史累积总步数 */ if (sensorEvent.sensor.getType() == Sensor.TYPE_STEP_COUNTER) { step = sensorEvent.values[0]; Log.d(TAG, "STEP_COUNTER:" + step); } /** * 计步检测传感器检测到的步行动作是否有效? */ if (sensorEvent.sensor.getType() == Sensor.TYPE_STEP_DETECTOR) { stepDetector = sensorEvent.values[0]; Log.d(TAG, "STEP_DETECTOR:" + stepDetector); if (stepDetector == 1.0) { Log.d(TAG, "一次有效的步行"); } } } @Override public void onAccuracyChanged(Sensor sensor, int i) { } }; @Override protected void onDestroy() { super.onDestroy(); mSensorManager.unregisterListener(mSensorEventListener); } }

优秀的个人博客,低调大师

Ubuntu SVN安装&amp;使用&amp;命令

SVN 安装 apt-get install subversion checkout svn checkout svn://192.168.1.110/app 按提示输入相应的用户名和密码。 往版本库中添加新的文件 svn add *.c //(添加当前目录下所有的 c文件) 将改动的文件提交到版本库 svn commit -m “my commit“ test.cpp 删除文件 svn delete svn://192.168.1.100/app/php/helloworld.php -m “delete file” help帮助 svn help chechout checkout (co): Check out a working copy from a repository. usage: checkout URL[@REV]... [PATH] SVN常用命令 checkout svn checkout path(path 是服务器上的目录) //例如:svn checkout svn://192.168.1.100/app/ 添加新的文件 svn add file //例如:svn add test.php(添加test.php) 将改动的文件提交到版本库 svn commit -m “LogMessage“ [-N] [--no-unlock] PATH (如果选择了保持锁,就使用–no- unlock开关) //例如:svn commit -m “add test file for my test“ test.php 加锁/解锁 svn lock -m “LockMessage“ [--force] PATH //例如:svn lock -m “lock test file“ test.php 更新到某个版本 svn update -r m path //例如: //svn update如果后面没有目录,默认将当前目录以及子目录下的所有文件都更新到最新版本。 //svn update -r 200 test.php(将版本库中的文件test.php还原到版本200) //svn update test.php(更新,于版本库同步。如果在提交的时候提示过期的话,是因为冲突,需要先update,修改文件,然后清除svn resolved,最后再提交commit) 查看文件或者目录状态 svn status path(目录下的文件和子目录的状态,正常状态不显示) //【?:不在svn的控制中;M:内容被修改;C:发生冲突;A:预定加入到版本库;K:被锁定】 svn status -v path(显示 文件和子目录状态) //第一列保持相同,第二列显示工作版本号,第三和第四列显示最后一次修改的版本号和修改人。 //注:svn status、svn diff和 svn revert这三条命令在没有网络的情况下也可以执行的,原因是svn在本地的.svn中保留了本地版本的原始拷贝。 删除文件 svn delete path -m “delete test fle“ //例如:svn delete svn://192.168.1.100/app/php/test.php -m “delete test file” //或者直接svn delete test.php 然后再svn ci -m ‘delete test file‘,推荐使用这种 查看日志 svn log path //例如:svn log test.php 显示这个文件的所有修改记录,及其版本号的变化 查看文件详细信息 svn info path //例如:svn info test.php 比较差异 svn diff path(将修改的文件与基础版本比较) //例如:svn diff test.php svn diff -r m:n path(对版本m和版本n比较差异) //例如:svn diff -r 200:201 test.php 将两个版本之间的差异合并到当前文件 svn merge -r m:n path //例如:svn merge -r 200:205 test.php(将版本200与205之间的差异合并到当前文件,但是一般都会产生冲突,需要处理一下) 恢复本地修改 svn revert: 恢复原始未改变的工作副本文件 (恢复大部份的本地修改)。revert: //注意: 本子命令不会存取网络,并且会解除冲突的状况。但是它不会恢复被删除的目录 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/4300332.html如需转载请自行联系原作者

优秀的个人博客,低调大师

Openstack API 类型 &amp;amp; REST 风格

目录 目录 Openstack 提供了三种操作方式 Web界面 CIL 指令行 RESTful API REST 风格 RESTFul风格的API设计 基于HTTP协议的RESTful API OpenStack中的RESTful API开发框架 Openstack 提供了三种操作方式 Web界面 也就是通过Dashboard(儀表板)来使用Openstack雲計算平台上的功能。通过Web界面使用 OpenStack Services 这种方式是通过 OpenStack Horizon Project 提供的。Horizon Project 是一个Django Web Application。Horizon Project 会通过API来和各个 OpenStack Services 进行交互,然后在 Web 界面上顯示這些 Services 的状态和交互結果。 CIL 指令行 通过以往的 keystone、nova、neutron 等指令,或者通过最新的 OpenStack 指令来操作各个 Services 的功能。社区目前希望使用統一的 OpenStack 指令來代替以往每个 Project 都有各自的 Commands 的方式,这些 Commands 是由命名为 client(EG. keystoneclient、novaclient) 的項目所實現的。這些 client 項目除了爲用户提供命令行操作界面方式之外還提供了 Python 的 SDK (其实是在SDK的基础上实现了命令行)。这些 client 项目提供的 SDK 本質是封装了這些 Openstack services 的 API 的调用。現在 Openstack 社區希望僅使用 openstackclient 作爲统一的命令行工具,然后使用各个 Services 的 client 项目所提供的 SDK 来完成相应的操作。 RESTful API 通过各个 OpenStack Project 提供的 API 来使用各 Services 的功能。API 这种方式是支撐上述兩種方式的基础,由各个 Services 自身來实现使用 API 操作 OpenStack 的方式。这些 API 具有统一的形式,均采用了基於 HTTP 协议的 Restful 风格来实现。Openstack API 服务进程在接收了客户端的HTTP Request之后,一个所谓的 路由 模块就会将URL转换成为相应的资源,并路由到合适的操作函数上去。以此来实现了从API到具体操作的映射。 REST 风格 REST(Representational State Transfer)表述性状态转换,是一种软件架构的设计风格,而不是一种标准,为软件设计提供了一组原则和约束条件,但这是原则和约束的条件也同样不具有标准性。所以也可以将REST理解为是一组没有严格标准的架构约束条件和设计原则。REST的软件设计倾向于简单轻量的方法设计和实现,以及**REST具有通过HTTP直接传输数据的特性。**REST风格的软件架构必须满足下面两点规范: URI 标识资源:首先从Restful的角度来看,互联网上的任何东西(文本/图片/视频/歌曲/Services)都是一个资源。每个资源都使用了一个特定的URI来唯一标示,访问这一个URI就是访问这一个资源,而且这个资源具有至少一种状态。 无状态原则: 再一个就是,Client 和 Server 之间互相传递的只是资源的表述,即:调用资源的URI并获取资源的不同表现形式。并且 Client 和 Server 之间的交互是由 HTTP 无状态协议来支撑的,所以资源的所有状态都只会保存在 Server 中。当 Client 应用 HTTP 协议中的 GET/POST/PUT/DELETE 操作资源时,会使得 Server 中的资源的状态发生转换,这就是所谓的“表述性状态转换”。 RESTFul风格的API设计 你的URI中应该都是名词,表示一个事物,而非动词。EG. /resources/142 是好的URI,它看起来像是一个事物 而 /resources/142/get 则不是好的URI,因为它看起来更像是一个动作,只有事物才符合资源的定义。 面向资源的体系结构 URI使用名词,不使用动词 资源地址即URI 无状态性 灵活使用单数和复数 传输资源的表现形式(Web Server 接收和返回的互联网媒体类型,JSON/XML) 对资源的操作与HTTP内置方法映射 基于HTTP协议的RESTful API 由于这种软件设计风格非常适合采用HTTP协议来实现,因此HTTP协议是目前实现RESTful API的主要方案。 OpenStack 就是基于 HTTP 协议和 JSON 来实现自己的 RESTful API(之前OpenStack还有采用XML来表示数据的,现在都已经转到JSON了)。当一个 Service 要对外提供 API 时,它就会启动一个 HTTP Web Server,用来对外提供 RESTful API。 OpenStack 的 API 都是有详细的文档记录的,可以查看所有的API文档。 OpenStack 的 API 服务都是使用 WSGI 的方式来部署的。部署WSGI,一般会使用 Web Server + Application Server + Application(框架) 的部署方式。OpenStack 官方推荐的是使用 Apache + mod_wsgi ,当然你也可以选 nginx + uWSGI 。还有些项目会提供使用 eventlet 的单进程部署方案(EG. Keystone项目的keystone-all命令)。 OpenStack中的RESTful API开发框架 OpenStack 早期的核心项目(EG. Keystone/Nova/Glance/Neutron)使用了由几个模块组合出来的一个框架: Paste + PasteDeploy + Routes + WebOb 。这些模块分别负责了应用的 WSGI 化、URL 路由和请求处理等功能。但是这种框架存在着较为复杂的弊端,所以现在 Openstack 社区的新项目已经开始使用新的 Web 框架 Pecan。 Pecan 是一个基于对象路由的框架,即灵活又简单。Pecan 主要实现了 URL 路由功能,支持 RESTful API 。Pecan 没有实现模板、session 管理、 ORM 等功能,但是这些功能可以通过其他的模块来实现。对于 OpenStack 来说,Pecan 是一个很好的选择,因为 OpenStack 项目中统一使用 sqlalchemy 来实现ORM,API的实现也不需要模板功能,安全控制则基于 Keystone 体系。使用 Pecan 来开发 REST 服务,代码量很少,代码结构也清晰。

优秀的个人博客,低调大师

hadoop(2): 安装&amp;amp;使用 sqoop

本文的原文连接是: http://blog.csdn.net/freewebsys/article/details/47722393 未经博主允许不得转载。 1,关于sqoop Sqoop是一个用来将Hadoop和关系型数据库中的数据相互转移的工具,可以将一个关系型数据库(例如 : MySQL ,Oracle ,Postgres等)中的数据导入到Hadoop的HDFS中,也可以将HDFS的数据导入到关系型数据库中。 官网:http://sqoop.apache.org/ 一个1.4.6 版本,一个是1.99版本(开发版还没有迁移完成,生产环境不推荐) 文档: http://sqoop.apache.org/docs/1.4.6/ 2,安装 参考之前的文章hadoop和hive用的是2.0,所以sqoop这里也用2.0,不过是alpha。直接解压缩。 配置环境变量 export JAVA_HOME=/usr/java/default export CLASS_PATH=$JAVA_HOME/lib export PATH=$JAVA_HOME/bin:$PATH export HADOOP_HOME=/data/hadoop export PATH=$HADOOP_HOME/bin:$PATH export HIVE_HOME=/data/apache-hive export PATH=$HIVE_HOME/bin:$PATH export SQOOP_HOME=/data/sqoop export PATH=$SQOOP_HOME/bin:$PATH sqoop启动的时候会检查hbase环境变量,不需要,直接注释 /data/sqoop/bin/configure-sqoop 的128 行到 147行。 128 ## Moved to be a runtime check in sqoop. 129 #if [ ! -d "${HBASE_HOME}" ]; then 130 # echo "Warning: $HBASE_HOME does not exist! HBase imports will fail." 131 # echo 'Please set $HBASE_HOME to the root of your HBase installation.' 132 #fi 133 134 ## Moved to be a runtime check in sqoop. 135 #if [ ! -d "${HCAT_HOME}" ]; then 136 # echo "Warning: $HCAT_HOME does not exist! HCatalog jobs will fail." 137 # echo 'Please set $HCAT_HOME to the root of your HCatalog installation.' 138 #fi 139 140 #if [ ! -d "${ACCUMULO_HOME}" ]; then 141 # echo "Warning: $ACCUMULO_HOME does not exist! Accumulo imports will fail." 142 # echo 'Please set $ACCUMULO_HOME to the root of your Accumulo installation.' 143 #fi 144 #if [ ! -d "${ZOOKEEPER_HOME}" ]; then 145 # echo "Warning: $ZOOKEEPER_HOME does not exist! Accumulo imports will fail." 146 # echo 'Please set $ZOOKEEPER_HOME to the root of your Zookeeper installation.' 147 #fi hadoop和hive参考之前写的博客: http://blog.csdn.net/freewebsys/article/details/47617975 sqoop命令主要就分为数据导入到hadoop,和数据从hadoop导出到 mysql。 首先创建mysql数据库blog,创建一个hadoop用户操作blog库,blog库里面创建一个msg表,插入6条记录 CREATE DATABASE blog DEFAULT CHARACTER SET utf8 COLLATE utf8_general_ci; GRANT ALL PRIVILEGES ON blog.* TO sqoop@"%" IDENTIFIED BY "sqoop"; FLUSH PRIVILEGES; ##创建msg和 msg_hive数据表: CREATE TABLE `msg_hive` ( `id` bigint(20) NOT NULL, `gid` bigint(20) DEFAULT NULL , `content` varchar(4000), `create_time` datetime DEFAULT NULL COMMENT '创建时间', PRIMARY KEY (`id`,`gid`) ) ENGINE=MyISAM DEFAULT CHARSET=utf8 PARTITION BY KEY(`gid`); CREATE TABLE `msg` ( `id` bigint(20) NOT NULL, `gid` bigint(20) DEFAULT NULL , `content` varchar(4000), `create_time` datetime DEFAULT NULL COMMENT '创建时间', PRIMARY KEY (`id`,`gid`) ) ENGINE=MyISAM DEFAULT CHARSET=utf8 PARTITION BY KEY(`gid`); #插入测试数据。 insert into `msg`(id,gid,content,create_time) values(1,1,'zhang san 11',now()); insert into `msg`(id,gid,content,create_time) values(1,2,'zhang san 22',now()); insert into `msg`(id,gid,content,create_time) values(1,3,'zhang san 33',now()); insert into `msg`(id,gid,content,create_time) values(2,1,'li si 11',now()); insert into `msg`(id,gid,content,create_time) values(2,2,'li si 22',now()); insert into `msg`(id,gid,content,create_time) values(2,3,'li si 33',now()); 3,sqoop使用,导入,导出 首先测试下数据库连接执行select。 sqoop eval --connect jdbc:mysql://127.0.0.1:3306/blog --username sqoop --password sqoop --query 'select now()' ##执行结果: ----------------------- | now() | ----------------------- | 2015-08-18 17:22:26.0 | ----------------------- 将mysql 数据导入到hive中,其实就是导入到hadoop上面,这里需要指定输出目录是hive的warehouse目录: sqoop import --direct --connect jdbc:mysql://127.0.0.1:3306/blog --username sqoop --password sqoop --table msg \ --fields-terminated-by "\001" --lines-terminated-by "\n" --delete-target-dir --null-string '\\N' --null-non-string '\\N' --target-dir /user/hive/warehouse/msg 参数一大堆,设置分隔符的,设置null的。最后指定hive的warehouse目录。 但是这样hive还不识别这个表,必须在hive中创建下。 sqoop create-hive-table --hive-table msg --connect jdbc:mysql://127.0.0.1:3306/blog --username sqoop --password sqoop --table msg 将hive 数据导入到 mysql中。 sqoop export --direct --connect jdbc:mysql://127.0.0.1:3306/blog --username sqoop --password sqoop --table msg_hive \ --fields-terminated-by "\001" --lines-terminated-by "\n" --export-dir /user/hive/warehouse/msg 同样的需要配置export-dir,配置mysql的数据表msg_hive 检查结果:(分别在hive和mysql中查看数据) hive> select * from msg; OK 1 1 zhang san 11 2015-08-17 12:11:32 1 2 zhang san 22 2015-08-17 12:11:33 1 3 zhang san 33 2015-08-17 12:11:33 2 1 li si 11 2015-08-17 12:11:33 2 2 li si 22 2015-08-17 12:11:33 2 3 li si 33 2015-08-17 12:11:33 Time taken: 0.105 seconds, Fetched: 6 row(s) mysql> select * from msg_hive; +----+-----+--------------+---------------------+ | id | gid | content | create_time | +----+-----+--------------+---------------------+ | 2 | 1 | li si 11 | 2015-08-17 12:11:33 | | 2 | 2 | li si 22 | 2015-08-17 12:11:33 | | 2 | 3 | li si 33 | 2015-08-17 12:11:33 | | 1 | 3 | zhang san 33 | 2015-08-17 12:11:33 | | 1 | 1 | zhang san 11 | 2015-08-17 12:11:32 | | 1 | 2 | zhang san 22 | 2015-08-17 12:11:33 | +----+-----+--------------+---------------------+ 6 rows in set (0.00 sec) 4,总结 本文的原文连接是: http://blog.csdn.net/freewebsys/article/details/47722393 未经博主允许不得转载。 sqoop提供了import和export功能,很方便的就可以迁移mysql和hive的数据。 业务数据需要迁移到hadoop上面进行计算,同时,将计算结果放到mysql数据库中进行统计显示。 数据可以方便的流动。 参考: http://segmentfault.com/a/1190000002532293 写的参数很详细。

优秀的个人博客,低调大师

分布式处理与大数据平台(RabbitMQ&amp;Celery&amp;Hadoop&amp;Spark&amp;Storm&amp;Elasticsearch)

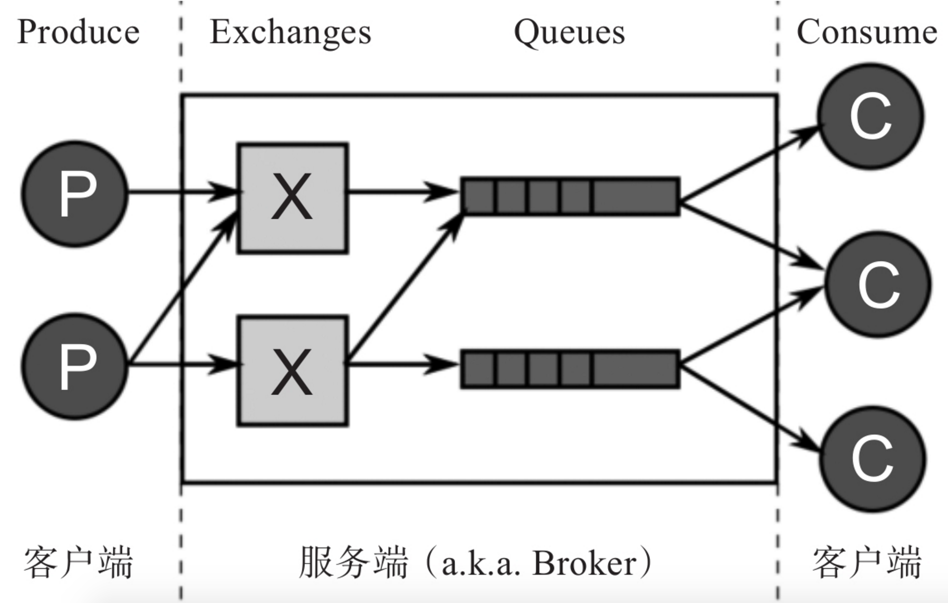
热门的消息队列中间件RabbitMQ,分布式任务处理平台Celery,大数据分布式处理的三大重量级武器:Hadoop、Spark、Storm,以及新一代的数据采集和分析引擎Elasticsearch。 RabbitMQ RabbitMQ是一个支持Advanced Message Queuing Protocol(AMQP)的开源消息队列实现,由Erlang编写,因以高性能、高可用以及可伸缩性出名。它支持多种客户端,如:Java、Python、PHP、.NET、Ruby、JavaScript等。它主要用于在分布式系统中存储和转发消息,方便组件之间的解耦,消息的发送者无需知道消息使用者的存在,反之亦然。 AMQP架构中有两个主要组件:Exchange和Queue,两者都在服务端,又称Broker,由RabbitMQ实现的。客户端通常有Producer和Consumer两种类型。 在使用RabbitMQ过程中需要注意的是,它将数据存储在Node中,默认情况为hostname。因此在使用docker run指令运行容器的时候,应该通过-h/--hostname参数指定每一个rabbitmq daemon运行的主机名。这样就可以轻松地管理和维护数据了: $ docker run -d --hostname my-rabbit --name some-rabbit rabbitmq:3 3f28f6290e05375363ee661151170d37fbc89ada004c3235f02997b711b4cb2b 用户使用rabbitmqctl工具进行远程管理,或跨容器管理的时候,会需要设置持久化的cookie。这里可以使用RABBITMQ_ERLANG_COOKIE参数进行设置: $ docker run -d --hostname my-rabbit --name some-rabbit -e RABBITMQ_ERLANG_COOKIE='secret cookie here'rabbitmq:3 使用cookie连接至一个独立的实例: $ docker run -it --rm --link some-rabbit:my-rabbit -e RABBITMQ_ERLANG_COOKIE='secret cookie here'rabbitmq:3 bash root@f2a2d3d27c75:/# rabbitmqctl -n rabbit@my-rabbit list_users Listing users ... guest [administrator] 同样,用户也可以使用RABBITMQ_NODENAME简化指令: $ docker run -it --rm --link some-rabbit:my-rabbit -e RABBITMQ_ERLANG_COOKIE='secret cookie here'-e RABBITMQ_NODENAME=rabbit@my-rabbit rabbitmq:3 bash root@f2a2d3d27c75:/# rabbitmqctl list_users Listing users ... guest [administrator] 默认情况下,rabbitmq会安装并启动一些管控插件,如rabbitmq:3-management。通常可以通过默认用户名密码以及标准管控端口15672访问这些插件: $ docker run -d --hostname my-rabbit --name some-rabbit rabbitmq:3-management 用户可以通过浏览器访问http://container-ip:15672,如果需要从宿主机外访问,则使用8080端口: $ docker run -d --hostname my-rabbit --name some-rabbit -p 8080:15672 rabbitmq:3-management 如果需要修改默认用户名与密码(guest:guest),则可以使用RABBITMQ_DEFAULT_USER和RABBITMQ_DEFAULT_PASS环境变量: $ docker run -d --hostname my-rabbit --name some-rabbit -e RABBITMQ_DEFAULT_USER=user -e RABBITMQ_DEFAULT_PASS=password rabbitmq:3-management 如果需要修改默认vhost,可以修改RABBITMQ_DEFAULT_VHOST环境变量: $ docker run -d --hostname my-rabbit --name some-rabbit -e RABBITMQ_DEFAULT_VHOST=my_vhost rabbitmq:3-management 然后连接至daemon: $ docker run --name some-app --link some-rabbit:rabbit -d application-that-uses-rabbitmq 用户也可以访问官方镜像仓库,并对Dockerfile进行更多定制。 Celery 除了通用的消息队列外,任务队列在分布式处理中也十分重要。任务队列的输入是工作的一个单元,称为任务,有多个工作者监听队列来获取任务并执行。 Celery是一个简单、灵活、高可用、高性能的开源(BSD许可)分布式任务处理系统,专注于实时处理的任务队列管理,同时也支持任务调度。Celery基于Python实现,跟包括Django、Pyramid、Pylons、Flask、Tornado等Web框架都无缝集成,有庞大的用户与贡献者社区。Celery可以单机运行,也可以在多台机器上运行,甚至可以跨越数据中心运行。 1.使用官方镜像 启动一个celery worker,即RabbitMQ Broker: $ docker run --link some-rabbit:rabbit --name some-celery -d celery:latest 检查集群状态: $ docker run --link some-rabbit:rabbit --rm celery celery status 启动一个celery worker,即Redis Broker: $ docker run --link some-redis:redis -e CELERY_BROKER_URL=redis://redis --namesome-celery -d celery 检查集群状态: $ docker run --link some-redis:redis -e CELERY_BROKER_URL=redis://redis --rmcelery celery status 2.使用Celery库 如果用户使用的框架已有Celery库,那么使用起来会更方便。 下面是Python中调用Celery的hello world程序: from celery import Celery app = Celery('hello', broker='amqp://guest@localhost//') @app.task def hello(): return 'hello world' Hadoop 作为当今大数据处理领域的经典分布式平台,Apache Hadoop主要基于Java语言实现,由三个核心子系统组成:HDFS、YARN、MapReduce,其中,HDFS是一套分布式文件系统;YARN是资源管理系统,MapReduce是运行在YARN上的应用,负责分布式处理管理。如果从操作系统的角度看,HDFS相当于Linux的ext3/ext4文件系统,而Yarn相当于Linux的进程调度和内存分配模块。 1.使用官方镜像 可以通过docker run指令运行镜像,同时打开bash命令行,如下所示: $ docker run -it sequenceiq/hadoop-docker:2.7.0 /etc/bootstrap.sh -bash bash-4.1# 此时可以查看各种配置信息和执行操作,例如查看namenode日志等信息: bash-4.1# cat /usr/local/hadoop/logs/hadoop-root-namenode-d4e1e9d8f24f.out ulimit -a for user root core file size (blocks, -c) 0 data seg size (kbytes, -d) unlimited scheduling priority (-e) 0 file size (blocks, -f) unlimited pending signals (-i) 7758 max locked memory (kbytes, -l) 64 max memory size (kbytes, -m) unlimited open files (-n) 1048576 pipe size (512 bytes, -p) 8 POSIX message queues (bytes, -q) 819200 real-time priority (-r) 0 stack size (kbytes, -s) 8192 cpu time (seconds, -t) unlimited max user processes (-u) unlimited virtual memory (kbytes, -v) unlimited file locks (-x) unlimited 2.安装验证 需要验证Hadoop环境是否安装成功。打开容器的bash命令行环境,进入Hadoop目录: bash-4.1# cd $HADOOP_PREFIX bash-4.1# pwd /usr/local/hadoop 然后通过运行Hadoop内置的实例程序来进行测试: bash-4.1# bin/hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-2.7.0.jargrep input output'dfs[a-z.]+' 16/08/31 10:00:11 INFO client.RMProxy: Connecting to ResourceManager at /0.0.0.0:8032 16/08/31 10:00:15 INFO input.FileInputFormat: Total input paths to process : 31 16/08/31 10:00:16 INFO mapreduce.JobSubmitter: number of splits:31 ... 最后可以使用hdfs指令检查输出结果: bash-4.1# bin/hdfs dfs -cat output/* Spark Apache Spark是一个围绕速度、易用性和复杂分析构建的大数据处理框架,基于Scala开发。最初在2009年由加州大学伯克利分校的AMPLab开发,并于2010年成为Apache的开源项目之一。与Hadoop和Storm等其他大数据和MapReduce技术相比,Spark支持更灵活的函数定义,可以将应用处理速度提升一到两个数量级,并且提供了众多方便的实用工具,包括SQL查询、流处理、机器学习和图处理等。 Spark体系架构包括如下三个主要组件:数据存储、API、管理框架,如图13-3所示。 1.使用官方镜像 用户可以使用sequenceiq/spark镜像,版本方面支持Hadoop 2.6.0,Apache Spark v1.6.0(CentOS)。同时此镜像还包含Dockerfile,用户可以基于它构建自定义的Apache Spark镜像。 用户使用docker pull指令直接获取镜像: $ docker pull sequenceiq/spark:1.6.0 也可以使用docker build指令构建spark镜像: $ docker build --rm -t sequenceiq/spark:1.6.0 . 另外,用户在运行容器时,需要映射YARN UI需要的端口: $ docker run -it -p 8088:8088 -p 8042:8042 -h sandbox sequenceiq/spark:1.6.0 bash 启动后,可以使用bash命令行来查看namenode日志等信息: bash-4.1# cat /usr/local/hadoop/logs/hadoop-root-namenode-sandbox.out 2.验证 基于YARN部署Spark系统时,用户有两种部署方式可选:YARN客户端模式和YARN集群模式。 下面分别论述两种部署方式。 1.YARN客户端模式 在YARN客户端模式中,SparkContext(或称为驱动程序,driver program)运行在客户端进程中,应用的master仅处理来自YARN的资源管理请求: #运行spark shell spark-shell \ --master yarn-client \ --driver-memory 1g \ --executor-memory 1g \ --executor-cores 1 #执行以下指令,若返回1000则符合预期 scala> sc.parallelize(1 to 1000).count() 2.YARN集群模式 在YARN集群模式中,Spark driver驱动程序运行于应用master的进程中,即由YARN从集群层面进行管理。 下面,用户以Pi值计算为例子,展现两种模式的区别: Pi计算(YARN集群模式): #执行以下指令,成功后,日志中会新增记录"Pi is roughly 3.1418" #集群模式下用户必须制定--files参数,以开启metrics spark-submit \ --class org.apache.spark.examples.SparkPi \ --files $SPARK_HOME/conf/metrics.properties \ --master yarn-cluster \ --driver-memory 1g \ --executor-memory 1g \ --executor-cores 1 \ $SPARK_HOME/lib/spark-examples-1.6.0-hadoop2.6.0.jar Pi计算(YARN客户端模式): #执行以下指令,成功后,命令行将显示"Pi is roughly 3.1418" spark-submit \ --class org.apache.spark.examples.SparkPi \ --master yarn-client \ --driver-memory 1g \ --executor-memory 1g \ --executor-cores 1 \ $SPARK_HOME/lib/spark-examples-1.6.0-hadoop2.6.0.jar 3.容器外访问Spark 如果需要从容器外访问Spark环境,则需要设置YARN_CONF_DIR环境变量。只能使用根用户访问Docker的HDFS环境。 yarn-remote-client文件夹内置远程访问的配置信息: export YARN_CONF_DIR="`pwd`/yarn-remote-client" 当用户从容器集群外部,使用非根用户访问Spark环境时,则需要配置HADOOP_USER_NAME环境变量: export HADOOP_USER_NAME=root Storm Apache Storm是一个实时流计算框架,由Twitter在2014年正式开源,遵循Eclipse Public License 1.0。Storm基于Clojure等语言实现。 Storm集群与Hadoop集群在工作方式上十分相似,唯一区别在于Hadoop上运行的是MapReduce任务,在Storm上运行的则是topology。MapReduce任务完成处理即会结束,而topology则永远在等待消息并处理(直到被停止)。 使用Compose搭建Storm集群 利用Docker Compose模板,用户可以在本地单机Docker环境快速地搭建一个Apache Storm集群,进行应用开发测试。 1.Storm示例架构,Storm架构图。 其中包含如下容器: ·Zookeeper:Apache Zookeeper三节点部署。 ·Nimbus:Storm Nimbus。 ·Ui:Storm UI ·Supervisor:Storm Supervisor(一个或多个)。 ·Topology:Topology部署工具,其中示例应用基于官方示例storm-starter代码构建。 2.本地开发测试 首先从Github下载需要的代码: $ gitclonehttps://github.com/denverdino/docker-storm.git $ cd docker-swarm/local 代码库中的docker-compose.yml文件描述了典型的Storm应用架构。 用户可以直接运行下列命令构建测试镜像: $ docker-compose build 现在可以用下面的命令来一键部署一个Storm应用: $ docker-compose up -d 当UI容器启动后,用户可以访问容器的8080端口来打开操作界面。 利用如下命令,可以伸缩supervisor的数量,比如伸缩到3个实例: $ docker-compose scale supervisor=3 用户也许会发现Web界面中并没有运行中的topology。这是因为Docker Compose目前只能保证容器的启动顺序,但是无法确保所依赖容器中的应用已经完全启动并可以被正常访问了。为了解决这个问题,需要运行下面的命令来再次启动topolgoy服务应用来提交更新的拓扑: $ docker-compose start topology 稍后刷新Storm UI,可以发现Storm应用已经部署成功了。 Elasticsearch Elasticsearch是一个基于Lucene的开源搜索服务器,主要基于Java实现。它提供了一个分布式的,多租户的全文搜索引擎,内含RESTful web接口。 Elasticsearch提供了实时的分布式数据存储和分析查询功能,很容易扩展到上百台服务器,支持处理PB级结构化或非结构化数据。配合Logstash、Kibana等组件,可以快速构建一套对日志消息的分析平台。 可以使用官方镜像,快速运行Elasticsearch容器: $ docker run -d elasticsearch 也可以在启动时传入一些额外的配置参数: $ docker run -d elasticsearch elasticsearch -Des.node.name="TestNode" 目前使用的镜像内含默认配置文件,包含了预先定义好的默认配置。 如果用户要使用自定义配置,可以使用数据卷,挂载自定义配置文件至/usr/share/elasticsearch/config: $ docker run -d -v "$PWD/config":/usr/share/elasticsearch/config elasticsearch 如果需要数据持久化,可以使用数据卷指令,挂载至/usr/share/elasticsearch/data: $ docker run -d -v "$PWD/esdata":/usr/share/elasticsearch/data elasticsearch 此镜像会暴露9200 9300两个默认的HTTP端口,可以通过此端口进行服务访问。9200端口是对外提供服务的API使用的端口。9300端口是内部通信端口,这些通信包括心跳,集群内部信息同步。 小结 分布式处理与大数据处理领域的典型热门工具,包括Rabbitmq、Celery、Hadoop、Spark、Storm和Elasticsearch等。这些开源项目的出现,极大降低了开发者进行分布式处理和数据分析的门槛。 实际上,摩尔定律的失效,必将导致越来越多的复杂任务必须采用分布式架构进行处理。在新的架构和平台下,如何实现高性能、高可用性,如何让应用容易开发、方便调试,都是十分复杂的问题。已有的开源平台项目提供了很好的实现参考,方便用户将更多的精力放到核心业务的维护上。通过基于容器的部署和使用,极大简化了对如此复杂系统的使用和维护。

优秀的个人博客,低调大师

java并发编程笔记3-同步容器&amp;并发容器&amp;闭锁&amp;栅栏&amp;信号量

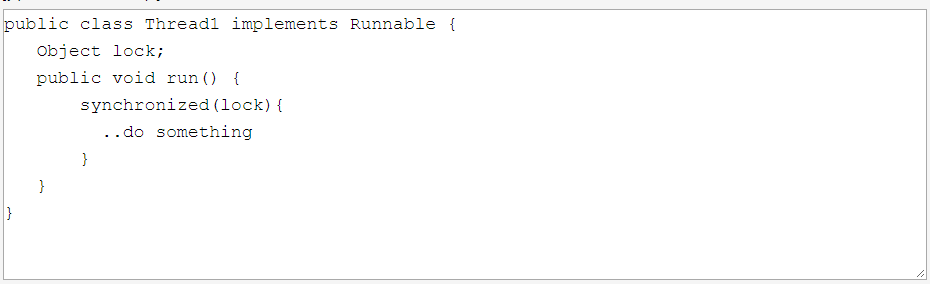
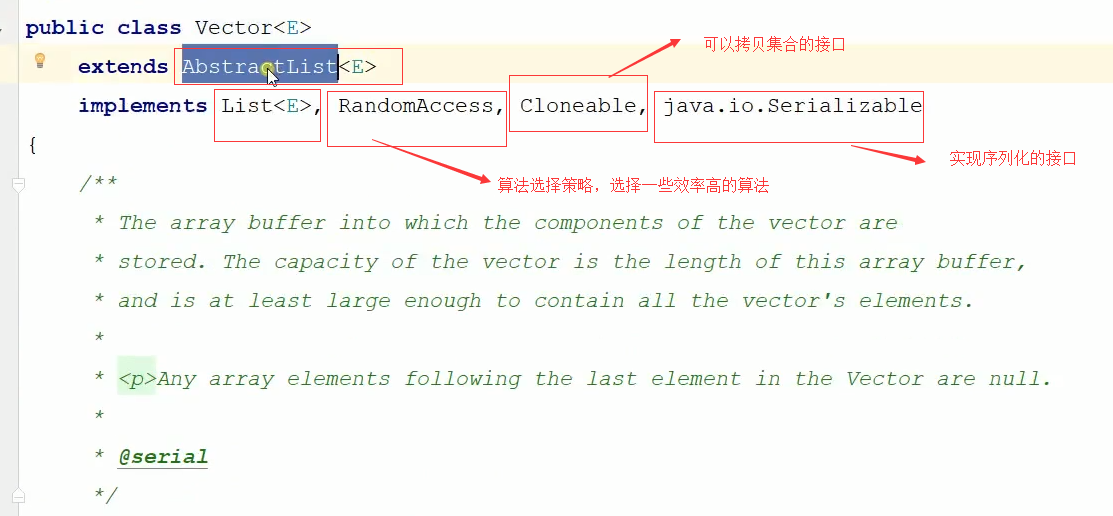
一.同步容器: 1.Vector容器实现了List接口,Vector实际上就是一个数组,和ArrayList类似,但是Vector中的方法都是synchronized方法,即进行了同步措施。保证了线程安全。源码如下图: 可以看到这些方法都加了synchronized。即加了同步操作。 2.Hashtable集合。HashTable实现了Map接口,它和HashMap很相似,但是HashTable进行了同步处理,而HashMap没有源码如下: 可以看到HashTable的实现方法也用到了synchronized同步。 3.Collections类中提供的静态工厂方法创建的类,在Collections类中提供了大量的方法,比如对集合或者容器进行排序、查找等操作。最重要的是,在它里面提供了几个静态工厂方法来创建同步容器类;源码如下图: 可以看到Collection类的静态工厂方法的内部实现也是使用了synchronized同步。 同步容器都是线程安全的。但是对于复合操作(迭代、缺少即加入、导航:根据一定的顺序寻找下一个元素),有时可能需要使用额外的客户端加锁进行保护。在一个同步容器中,复合操作是安全的。但是当其他线程能够并发修改容器的时候,它们就可能不会按照期望工作了。 例如: 几个单局语句是原子性的,但是一复合就不是在原子性的了。因为几条原子性的语句合起来就存在了时间差,这就出现线程安全的问题了,因为当一个线程进行删除容器中某个元素时,另外一个线程比这个线程已经先一步删除了该元素,这是导致抛出并发修改异常。 注意,并不是多线程才出现并发修改异常,单线程也会,比如,一个List,用iterator进行迭代,然后你没用iterator.remove()方法,而是直接用list.remove()方法就会发生并发修改异常。 这是就要手工 进行加synchronized了,如下: 有一些原因造成我们不愿意在迭代期间对容器加锁,当其它线程需要访问容器时,必须等待,直到迭代结束,如果容器很大,或者对每一个元素执行的任务耗时比较长,它们可能需要等待很长一段时间。另外,如果对元素的操作还要持有另一个锁,这是一个产生死锁风险的因素。在迭代期间,对容器加锁的一个替代方法是复制容器,因为复制是线程限制的,没有其他的线程能够在迭代期间对其进行修改,这样就消除了ConcurrentModificationException发生的可能性。但是如果容器非常大,复制起来这就非常消耗性能。 同步容器中的方法采用了synchronized进行了同步,这必然会影响到执行性能.同步容器将所有对容器状态的访问都串行化了,这样保证了线程的安全性,但代价就是严重降低了并发性,当多个线程竞争容器时,吞吐量严重降低。 二.并发容器 java5.0开始针对多线程并发访问设计,提供了并发性能较好的并发容器,引入了java.util.concurrent包。主要解决了两个问题: 1).根据具体场景进行设计,尽量避免synchronized,提供并发性。 2).定义了一些并发安全的复合操作,并且保证并发环境下的迭代操作不会出错。 1.ConcurrentHashMap并发容器,来替代同步的哈希Map实现。ConcurrentHashMap实现采用了散列机制,但是采用了分段锁(Lock Striping)机制提供了并发性能。其内部的结构可以让其在进行写操作的时候能够将锁的粒度保持地尽量地小,不用对整个ConcurrentHashMap加锁。 ConcurrentHashMap是由Segment数组结构和HashEntry数组结构组成,分段锁是对Segments中每一个Segment加锁,Segment是一种可重入锁ReentrantLock,在ConcurrentHshMap里扮演锁的角色,HashEntry则用于存储键值对数据。一个ConcurrentHashMap里包含一个Segment数组,Segment的结构和HashMap类似,是一种数组和链表结构,一个Segment里包含一个HashEntry数组,每一个HashEntry是一个链表结构的元素,每个Segment守护着HashEntry数组里的元素,当对HashEntry数组的数据进行修改时,必须首先获得它对应的Segment的锁。 并发环境下实现更的吞吐量,而在单线程环境下只损失非常小的性能。ConcurrentHashMap结构如下图: 没有则增加: V putIfAbsent(key,value):表示如果不存在(新的entry),那么会向map中添加该键值对,并返回null。 如果已经存在,那么不会覆盖已有的值,直接返回已经存在的值。 相等则移除: boolean remove(Object key, Object value) :当key对应到指定的value时,才移除该key-value对。 相等则替换: boolean replace(K key, V oldValue, V newValue) :当key对应到指定的value时,才替换key对应的value值。 拥有则替换: V replace(K key,V value):只有目前将键的条目映射到某一值时,才替换该键的条目。 1.1ConcurrentHashMap的使用注意项目 ConcurrentHashMap 虽然为并发安全的组件,但是使用不当还是会导致程序错误,通过使用简单的案例来复现这些问题并给出开发时候如何进行避免的策略。 这里借用直播的一个场景,直播业务中,每个直播间对应一个 topic,每个用户进入直播间时候会把自己设备 id 绑定到这个 topic 上,也就是一个 topic 对应一堆用户设备,可知可以使用 map 来维护这些信息,key 为 topic,value 为设备的 list。下面通过代码模拟多用户同时进入直播间时候 map 信息的维护,代码如下: public class ConcurrentHashMapTest { //(1)创建map,key为topic,value为设备列表 static ConcurrentHashMap<String, List<String>> map = new ConcurrentHashMap<String, List<String>>(); public static void main(String[] args) { //(2)进入直播间topic1 线程one Thread threadOne = new Thread(new Runnable() { public void run() { List<String> list1 = new ArrayList<String>(); list1.add("device1"); list1.add("device2"); map.put("topic1", list1); System.out.println(JSON.toJSONString(map)); } }); //(3)进入直播间topic1 线程two Thread threadTwo = new Thread(new Runnable() { public void run() { List<String> list1 = new ArrayList<String>(); list1.add("device11"); list1.add("device22"); map.put("topic1", list1); System.out.println(JSON.toJSONString(map)); } }); //(4)进入直播间topic2 线程three Thread threadThree = new Thread(new Runnable() { public void run() { List<String> list1 = new ArrayList<String>(); list1.add("device111"); list1.add("device222"); map.put("topic2", list1); System.out.println(JSON.toJSONString(map)); } }); //(5)启动线程 threadOne.start(); threadTwo.start(); threadThree.start(); } } 运行结果如下: 或者如下的运行结果: 可知 topic1 房间中的用户会丢失一部分,这是因为 put 方法如果发现 map 里面存在这个 key, 则使用 value 覆盖该 key 对应的老的 value 值,而 putIfAbsent 方法则如果已经存在该 key 则返回该 key 对应的 value 并不进行覆盖,如果不存在则会新增该 key,并且判断和写入是原子性操作。使用 putIfAbsent 替代 put 方法后代码如下: public class ConcurrentHashMapTest1 { //(1)创建map,key为topic,value为设备列表 static ConcurrentHashMap<String, List<String>> map = new ConcurrentHashMap<String, List<String>>(); public static void main(String[] args) { //(2)进入直播间topic1 线程one Thread threadOne = new Thread(new Runnable() { public void run() { List<String> list1 = new ArrayList<String>(); list1.add("device1"); list1.add("device2"); //(2.1) List<String> oldList = map.putIfAbsent("topic1", list1); if(null != oldList){ oldList.addAll(list1); } System.out.println(JSON.toJSONString(map)); } }); //(3)进入直播间topic1 线程two Thread threadTwo = new Thread(new Runnable() { public void run() { List<String> list1 = new ArrayList<String>(); list1.add("device11"); list1.add("device22"); List<String> oldList = map.putIfAbsent("topic1", list1); if(null != oldList){ oldList.addAll(list1); } System.out.println(JSON.toJSONString(map)); } }); //(4)进入直播间topic2 线程three Thread threadThree = new Thread(new Runnable() { public void run() { List<String> list1 = new ArrayList<String>(); list1.add("device111"); list1.add("device222"); List<String> oldList = map.putIfAbsent("topic2", list1); if(null != oldList){ oldList.addAll(list1); } System.out.println(JSON.toJSONString(map)); } }); //(5)启动线程 threadOne.start(); threadTwo.start(); threadThree.start(); } } 运行结果如下: 如上代码(2.1)使用 map.putIfAbsent 方法添加新设备列表,如果 topic1 在 map 中不存在则放入 topic1 和对应设备列表到 map,要注意的是这个判断不存在和放入是原子性操作,这时候放入后会返回 null。如果 topic1 已经在 map 里面存在,则调用 putIfAbsent 会返回 topic1 对应的设备里面,代码发现返回的设备列表不为 null 则把新的设备列表添加到返回的设备列表里面,从而问题得到解决。 总结:put(K key, V value) 方法如果 key 已经存在则使用 value 覆盖原来的值并返回原来的值,如果不存在则把 value 放入并返回 null。而 putIfAbsent(K key, V value) 方法如果 key 已经存在则直接返回原来对应的值并不使用 value 覆盖,如果 key 不存在则存入 value 并返回 null,另外要注意判断 key 不存在和存入是原子操作。 2.CopyOnWriteArrayList/set并发容器 CopyOnWrite容器即写时复制的容器。通俗的理解是当我们往一个容器添加元素的时候,不直接往当前容器添加,而是先将当前容器进行Copy,复制出一个新的容器,然后新的容器里添加元素,添加完元素之后,再将原容器的引用指向新的容器。 这样做的好处是我们可以对CopyOnWrite容器进行并发的读,而不需要加锁,因为当前容器不会添加任何元素。所以CopyOnWrite容器也是一种读写分离的思想,读和写不同的容器。大部分用于读操作,写操作少,因为如果的数据很大,你每次进行写操作 都要进行拷贝,重新复制一份数组,这开销很大的。 源码如下: CopyOnWrite容器有很多优点,但是同时也存在两个问题,即内存占用问题和数据一致性问题: 1.内存问题:因为CopyOnWrite的写时复制机制,所以在进行写操作的时候,内存里会同时驻扎两个对象的内存,旧的对象和新写入的对象(注意:在复制的时候只是复制容器里的引用,只是在写的时候会创建新对象添加到新容器里,而旧容器的对象还在使用,所以有两份对象内存)。 如果这些对象占用的内存比较大,比如说200M左右,那么再写入100M数据进去,内存就会占用300M,那么这个时候很有可能造成频繁的Yong GC和Full GC。 之前我们系统中使用了一个服务由于每晚使用CopyOnWrite机制更新大对象,造成了每晚15秒的Full GC,应用响应时间也随之变长。 2.数据一致性问题:CopyOnWrite容器只能保证数据的最终一致性,不能保证数据的实时一致性。 3.BlockingQueue阻塞队列并发容器:Java 5.0之后新增加了Queue(队列)和BlockingQueue(阻塞队列)。Queue的底层实现其实就是一个LinkedList。队列是典型的FIFO先进先出的实现。阻塞队列提供了很多现成的方法可以满足我们实现生产者—消费者模型。 生产者—消费者模型简单理解就是一个缓冲容器,协调生产者和消费者之间的关系。生产者生产数据扔到容器里,消费者直接从容器里消费数据,大家不需要关心彼此,只需要和容器打交道,这样就实现了生产者和消费者的解耦。 队列分为有界队列和无界队列,无界队列会因为数据的累计造成内存溢出,使用时要小心。阻塞队列有很多种实现,最常用的有ArrayBlockingQueue和LinkedBlockingQueue。 阻塞队列提供了阻塞的take和put方法,如果队列已满,那么put方法将等待队列有空间时在执行插入操作;如果队列为空,那么take方法将一直阻塞直到有元素可取。有界队列是一个强大的资源管理器,它能抑制产生过多的工作项,使程序更加健壮。 三.闭锁(CountDownLatch) 闭锁相当于一扇门,在闭锁到达结束状态之前,这扇门一直是关闭着的,没有任何线程可以通过,当到达结束状态时,这扇门才会打开并容许所有线程通过。它可以使一个或多个线程等待一组事件发生。 闭锁状态包括一个计数器,初始化为一个正式,正数表示需要等待的事件数量。countDown方法递减计数器,表示一个事件已经发生,而await方法等待计数器到达0,表示等待的事件已经发生。 CountDownLatch强调的是一个线程(或多个)需要等待另外的n个线程干完某件事情之后才能继续执行。 应用场景: 1、确保某个计算在其所有资源都被初始化之后才继续执行。二元闭锁(只有两个状态)可以用来表示“资源R已经被初始化”,而所有需要R操作都必须先在这个闭锁上等待。 2、确保某个服务在所有其他服务都已经启动之后才启动。这时就需要多个闭锁。让S在每个闭锁上等待,只有所有的闭锁都打开后才会继续运行。 3、等待直到某个操作的参与者(例如,多玩家游戏中的玩家)都就绪再继续执行。在这种情况下,当所有玩家都准备就绪时,闭锁将到达结束状态。 代码例子: public class Test2 { public static void main(String[] args) { //参数代表等待线程的数量 final CountDownLatch latch = new CountDownLatch(2); new Thread(){ @Override public void run() { try { System.out.println("子线程" + Thread.currentThread().getName() + "正在执行"); Thread.sleep(3000); System.out.println("子线程" + Thread.currentThread().getName() + "执行完毕"); //子线程完成 latch.countDown(); } catch (InterruptedException e) { e.printStackTrace(); } } }.start(); new Thread(){ public void run() { try { System.out.println("子线程" + Thread.currentThread().getName() + "正在执行"); Thread.sleep(3000); System.out.println("子线程" + Thread.currentThread().getName() + "执行完毕"); //子线程完成 latch.countDown(); } catch (InterruptedException e) { e.printStackTrace(); } } }.start(); try { System.out.println("等待2个子线程执行完毕。。。。"); //进行等待 latch.await(); System.out.println("2个子线程已经执行完毕"); System.out.println("继续执行主线程"); } catch (InterruptedException e) { e.printStackTrace(); } } } 运行结果如下: 可以看到主线程等待两个子线程执行完毕后,才能继续执行主线程。 四.栅栏 栅栏(Bariier)类似于闭锁,它能阻塞一组线程知道某个事件发生。栅栏与闭锁的关键区别在于,所有的线程必须同时到达栅栏位置,才能继续执行。闭锁用于等待等待时间,而栅栏用于等待线程。 CyclicBarrier 可以使一定数量的参与方反复的在栅栏位置汇聚,它在并行迭代算法中非常有用:将一个问题拆成一系列相互独立的子问题。当线程到达栅栏位置时,调用await() 方法,这个方法是阻塞方法, 直到所有线程到达了栅栏位置,那么栅栏被打开,此时所有线程被释放,而栅栏将被重置以便下次使用。 比方说数据写入的例子,多个子线程写数据库,必须都写完了,其他任务才能继续,如下图: public class Test3 { public static void main(String[] args) { int N = 4; CyclicBarrier barrier = new CyclicBarrier(N); for (int i = 0;i<N;i++){ new Writer(barrier).start(); } } static class Writer extends Thread{ private CyclicBarrier cyclicBarrier; public Writer(CyclicBarrier cyclicBarrier){ this.cyclicBarrier = cyclicBarrier; } @Override public void run() { System.out.println("线程"+Thread.currentThread().getName()+"正在写入数据。。。。。"); try { Thread.sleep(5000);//以睡眠来模拟写入数据操作 System.out.println("线程"+Thread.currentThread().getName()+"写入数据完毕,等待其他线程写入"); cyclicBarrier.await(); //await()的数量都达到了指定N时,才继续放行。 } catch (InterruptedException e) { e.printStackTrace(); } catch (BrokenBarrierException e) { e.printStackTrace(); } System.out.println("所有线程写入完毕,继续处理其他任务。。。。"); } } } 结果如下: 另一种形式的栅栏是Exchanger,它是一种两方(Two-Party)栅栏,各方在栅栏位置上交换数据。例如当一个线程想缓冲区写入数据,而另一个线程从缓冲区中读取数据。这些线程可以使用 Exchanger 来汇合,并将慢的缓冲区与空的缓冲区交换。当两个线程通过 Exchanger 交换对象时,这种交换就把这两个对象安全的发布给另一方。 Exchanger 可能被视为 SynchronousQueue 的双向形式。我们也可以用两个SynchronousQueue来实现 Exchanger的功能。 五。信号量 信号量用于对有限数量的资源的同时并发访问数进行控制。若有m个资源,但有n条线程(n>m),因此同一时刻只能允许m条线程访问资源,此时可以使用Semaphore控制访问该资源的线程数量。 闭锁控制访问的时间,而信号量则用来控制访问某个特定资源的操作数量,控制空间。而且闭锁只能够减少,一次性使用,而信号量则申请可释放,可增可减。 计数信号量还可以用来实现某种资源池,或者对容器施加边界。 Semaphone 管理这一组许可(permit),可通过构造函数指定。同时提供了阻塞方法acquire,用来获取许可。同时提供了release方法表示释放一个许可。 Semaphone 可以将任何一种容器变为有界阻塞容器,如用于实现资源池。例如数据库连接池。我们可以构造一个固定长度的连接池,使用阻塞方法 acquire和release获取释放连接,而不是获取不到便失败。 (当然,一开始设计时就使用BlockingQueue来保存连接池的资源是一种更简单的方法) 例子如下: public class Test3 { public static void main(String[] args) { int N = 8;//工人数 Semaphore semaphore = new Semaphore(5);//机器数 for (int i = 0;i<N;i++){ new Worker(i,semaphore).start(); } } static class Worker extends Thread{ private int num; private Semaphore semaphore; public Worker(int num,Semaphore semaphore){ this.num = num; this.semaphore = semaphore; } @Override public void run() { try { semaphore.acquire(); System.out.println("工人"+this.num+"占用一个机器在生产。。。"); Thread.sleep(2000); System.out.println("工人"+this.num+"释放机器"); semaphore.release(); } catch (InterruptedException e) { e.printStackTrace(); } } } } 运行结果如下: 可以看到信号量对有限数量的资源的同时并发访问数进行控制

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册
修改密码
忘记密码