首页 文章 精选 留言 我的

精选列表

搜索[动效],共9006篇文章
优秀的个人博客,低调大师

云API,让应用程序“动”起来!

随着云应用的增长,越来越多的企业尝试同时使用多个供应商。弥补服务中断的需求,使用不同服务的需求,以及基于费用选择服务的能力,都强调了对数据和应用程序可移植性的需求。应用程序编程接口是和云服务交互的关键,但是跨供应商的API区别巨大——这让移植非常困难。 本文研究了云的可移植性可能遇到的挑战,并且探讨API在其中所起的作用。 云上应用可移植性的最大问题是什么? 在所有情况下,API都是用来访问数据和服务的。没有具体的规则来定义云计算API应该如何工作或者它们应该提供什么功能。但是,当多个供应商提供相互竞争的或者类似的服务,并且使用完全不同的API去访问这些服务时,问题就出现了。 对于软件开发人员来说,这就是个噩梦。他们可能不得不重写软件以便使用某个特定服务的API,这通常导致出现软件的多个版本。在一些情况下,开发人员能够设计软件,让其检测特定的服务并且使用相应的API,但是这会让应用程序的整体大小急速膨胀,并且导致测试很复杂。不管使用上述哪种方式,为不同的云计算API创建应用程序的代价都很高,且需要花很多时间。 市场上哪些公有云计算API呢? 在公有云领域有三种常见类型的API:基础架构、服务和应用程序。 基础架构或基础架构即服务(IaaS)API意图控制低级别的资源,比如虚拟机(VM)镜像、可扩展组群和负载均衡。开发人员和IT团队使用基础架构API来预配,管理并移除公有云资源。比如,开发人员可以使用Amazon Web Services (AWS) Elastic Compute Cloud API在EC2实例里创建、移除以及使用镜像。 服务或者平台即服务API支持访问定义良好的服务或者功能,比如数据库、管理和汇报工具、消息系统、门户以及存储实例。服务API通常和基础架构即服务API协同使用,来构造出复杂的工作环境。比如,开发人员可能会使用基础架构API来预配VM,然后使用服务API将存储实例附加到VM上。 跨云API 还有跨云的API,比如Apache jclouds,允许云开发人员创建出软件,访问来自主要云供应商以及所需的其他云供应商的资源。但是,这还在开发中,因为没有清晰的规定云供应商应该提供哪些通用服务。 应用程序或者软件即服务API通常是最高层级API,提供完整的应用程序作为本地IT环境的替代品或者扩展。比如,企业可能选择使用客户关系管理软件作为托管服务而不是在本地安装。和该软件交互的工具会使用设计的API来安全地交换数据以及查询。如,想要集成Microsoft office 365功能进自己软件的企业就可以使用Microsoft Graph API。 现在有哪些可用的云计算API? 现在有大量供开发人员可用的云计算API,来创建面向用户的软件。比如,AWS提供API来操作自己的EC2和Simple Storage Service (S3,简单存储服务)服务,以及API门户服务,允许用户创建自定义API来编排一些AWS服务。其他主流公有云供应商,如Google和Microsoft Azure,也提供API将云服务链接到外部软件。 还有一些其他API可以使用来做云项目。如,私有云可能会使用类似Apache CloudStack 4.9.0.1这样的平台来支持IaaS类型的云,还能够原生支持Amazon EC2和S3 API。 API标准化 要帮助用户在任意云平台上部署应用程序——无需变更软件,越来越多的人开始对公有云供应商API的标准化感兴趣。不幸的是,我们离这样的标准化还相当遥远,特别是在主流公有云供应商之间的竞争日益白热化的情况下。 其他云计算API承诺提供更加通用、跨平台的能力。比如,Simple Cloud API是由供应商联盟推进的,它允许开发人员创建可以和多个云供应商交互的代码。 API创建有哪些通用准则? 不管你是开发自己的云计算API,还是评估待选供应商的API,以下一些通用考量可能会有所帮助。 考虑API的效率。API的实现必须简单高效。不要尝试重新创造轮子,比如SOAP、REST、JSON等这些底层技术——使用那些已经实现了的庞大的标准库。另外,不要尝试在一个API里完成所有事情。开发人员倾向于使用有限数量的语言,因此为了迎合每种主流语言都创建一个API版本,这里的主流语言包括C++、Java、 Python、PHP、Ruby、Perl、Haskell、C#、JavaScript、Node.js、OCaml 和 Delphi。 确保良好的API文档。粗糙的文档会成为采用某个供应商API的阻碍,也会阻止别人使用你的API。文档必须最新、精准并且包含一些使用示例或者教程。通过同行评审或者API用户的精准反馈来验证文档。 API必须灵活。开发人员可能会尝试以各种方式使用云计算API,因此这些API必须灵活,特别是如何处理输入和输出上。比如,灵活的API可能支持多种格式,比如JSON、YAML以及可扩展标记语言,并且不区分大小写。 注意API发布的稳定性。API变更的速度和一致性会影响到使用。开发人员使用那些不经常变化的API会更加轻松。发布周期必须计划良好,测试全面并且有完整的文档,同时让开发人员有足够的时间体验beta版本。 注意API安全性。可靠的身份验证和安全对于现代服务以及访问这些服务的云计算API来说至关重要。在大多数情况下,这包括通过API向服务传递SHA-1或者其他加密令牌。在其他情况下,通过OAuth2和SSL保证安全性。API所有者必须实现几种类型的安全。 本文作者:崔婧雯 来源:51CTO

优秀的个人博客,低调大师

AI 测试提效神器:推荐一款接口自动化测试提效skill!

![](https://developer.qcloudimg.com/http-save/yehe-6490225/1750c6d356792b204f649b4c015df3f1.png) > **导读**:前面我们已经分享过了,如何用 AI + Agent Skill 把接口测试脚本自动"造"了出来。但脚本生成只是起点——真正让接口自动化测试产生价值的,是让脚本**跑起来**。 今天就给大家推荐一款让能接口测试"听话地跑起来"的 Agent Skill: **api-test-executor** ## **写在开头** 先问大家一个问题:**你平时是怎么跑接口自动化测试的?** 大概率是这样的—— 1. 1. 打开终端,cd 到项目目录; 1. 2. 想跑某个模块的测试,但记不住 pytest 的 `-k` 参数怎么写; 1. 3. 翻一遍代码,找到对应的测试文件名; 1. 4. 拼好命令,执行; 1. 5. 跑完发现环境配置没切对,重来; 1. 6. 想只跑 P0 用例,发现脚本没有标签体系,只能按文件名筛选; 1. 7. 跑完之后,结果散落在终端里,整理成报告要花半天; 1. 8. 想让开发同事一起看,发现没有可分享的报告链接…… 如果以上场景你中了三条以上,那么今天这款 skill,你一定要了解——**api-test-executor**,一款专为接口自动化测试执行设计的 Agent Skill。 ## **一、它是什么?** **api-test-executor 是接口自动化测试的智能执行调度引擎**,你可以把它理解成测试执行闭环的"发动机"。 它的核心定位非常克制——**只做三件事**: 1. 1. **触发执行**:一键触发 pytest,自动加载环境配置、测试数据; 1. 2. **范围筛选**:支持标签索引 + 自然语言双模式,让用户"说人话"就能圈定执行范围; 1. 3. **结果收集**:结构化采集每条用例的状态、耗时、错误信息、请求/响应快照,输出标准化 JSON 和 Markdown 摘要。 听起来很简单?但简单背后,是反复打磨过的设计。 ## **二、5 大核心亮点** ### **① 自然语言调用:说人话就能跑** 这是它最打动人的一点。 **传统方式**,跑一组测试你得这么写: ``` pytest testcases/ -k "smoke and auth" -n 4 --reruns 2 --timeout=30 \ --alluredir=./allure-results --html=./report.html -v ``` **用 api-test-executor**,你只需要说一句: ``` 在 test 环境跑一下登录模块的冒烟测试 ``` 它会自动解析为: - • 环境:test - • 范围:冒烟测试(smoke) - • 模块:登录(auth) - • 并发:4 线程 - • 失败重试:2 次 解析完还会主动向你确认:"我将执行:test 环境,冒烟测试,登录模块,4 线程,确认吗?"——**确认后才真正执行,避免误操作**。 支持的语义包括但不限于: |你说的话|自动解析结果| | --- | --- | |"跑一下冒烟测试"|--scope smoke| |"执行所有用例"|--scope full| |"只跑登录相关的"|--module auth| |"跑一下订单和支付"|--module order,payment| |"只跑 P0 用例"|--priority P0| |"排除不稳定的用例"|--exclude-tag flaky| |"8 个线程跑"|--parallel 8| |"失败重试 3 次"|--retry 3| |"模拟执行看看"|--dry-run| 甚至支持组合语义: > "在 test 环境跑一下冒烟测试,只跑登录和订单模块的 P0 用例,排除 flaky 的" 也能精准解析为: `--env test --scope smoke --module auth,order --priority P0 --exclude-tag flaky` **这意味着:测试人员不用再记复杂的命令参数,也不用频繁翻文档**。说人话,就能跑测试。 ### **② 多维筛选:想跑什么就跑什么** 传统测试执行最常见的尴尬——**想跑一部分用例,但筛选不出来**。 api-test-executor 支持三种筛选模式: **模式 A:标签索引模式(推荐)** 配合 `api-test-tagger` 打好的标签,按维度筛选: - • 按模块:`--module auth,order` - • 按优先级:`--priority P0,P1` - • 按场景:`--tag scene:positive` - • 按策略:`--scope smoke` **模式 B:文件路径回退模式** 没有标签?也能用。按文件名匹配模块,按方法名关键字推断场景。 **模式 C:自然语言解析模式** 最直观,说话即可。 **好处是**:执行范围不再写死,可以按业务需要灵活组合。今天跑冒烟、明天跑回归、后天只跑支付模块——一条指令搞定。 ### **③ 结构化输出:结果不再散落** 执行完了,结果怎么收集?这是很多团队的痛点。 api-test-executor 会同时输出三种结果: **1. `execution_results.json`(给下游消费)** 结构化的执行结果,包含每条用例的状态、耗时、错误信息、请求/响应快照。这是后续诊断、报告生成、数据归档的基础数据。 **2. `execution_summary.md`(给人看)** 人能直接读的执行摘要,包含执行概览和失败用例列表。 **3. pytest 原生报告(兼容生态)** - • `allure-results/`:Allure 原始数据 - • `html-report/report.html`:HTML 测试报告 - • `junit.xml`:JUnit XML 格式 **也就是说,它既能让下游 Skill 接管(结构化 JSON),又能兼容你已有的报告工具链(Allure/HTML/JUnit)**。这一点对老项目迁移特别友好。 ### **④ 能力边界:只做该做的事** 这点其实是它最被低估的优势。 **明确不做的事**: - • 不做复杂的环境健康自检(仅做基础服务连通性检查) - • 不做分布式并发调度(仅支持本地 pytest-xdist 并发) - • 不做实时监控告警 - • 不做失败根因分析(交给下游 api-failure-diagnoser) 为什么不做? 因为**一个试图包揽所有的 Skill,最终什么都会做不好**。环境巡检、分布式调度、根因分析——每一项都是独立的复杂领域,强行塞进执行 Skill 里,只会让它臃肿、脆弱、难维护。 api-test-executor 把"触发 + 筛选 + 收集"这三件事做到极致,把更重的能力留给底层平台或独立的 Skill——**这种克制反而让它更稳定、更专注、更好用**。 ### **⑤ 生态衔接:可独立、可编排** api-test-executor 不是孤岛,它是一整套 Skill 体系的核心节点: - • **上游**:`api-test-tagger` 给脚本打标签,让它能精准筛选 - • **下游**:`api-failure-diagnoser` 接收执行结果,自动诊断失败、修复脚本 - • **下游**:`api-testdata-cleaner` 在执行后清理测试数据 - • **下游**:`api-report-generator` 基于执行结果生成可视化报告 - • **编排**:`api-pipeline-scheduler` 把这些 Skill 串成流水线,一键跑通全流程 也就是说,**它既能独立使用,又能作为整条流水线的核心节点**——这就是它作为"发动机"的真正价值。 ## **三、几个典型使用场景** **场景一:日常冒烟测试** 每天早上来公司,想快速验证服务是否正常: ``` 在 test 环境跑一下冒烟测试 ``` 几分钟出结果,喝杯咖啡的功夫就知道今天服务是不是健康的。 **场景二:版本前的 P0 回归** 发版前,要跑一遍所有核心用例: ``` 在 test 环境跑一下 shop-lab-api-test 项目 P0 级测试用例 ``` 它会自动扫描出 87 条 P0 用例,覆盖 49 个文件,按 4 线程并发执行,失败重试 2 次,全程无需人工配置。 **场景三:调试单个模块** 开发刚改了订单接口,想快速验证: ``` 在 test 环境跑一下订单模块的所有用例 ``` 不用翻代码找文件名,不用拼 `-k` 表达式,一句话搞定。 **场景四:模拟执行(dry-run)** 想看看某类用例有多少条、覆盖了哪些文件,又不想真跑: ``` 模拟执行一下,看看支付模块有哪些正向场景用例 ``` 它会列出用例清单,但不真正执行——**这个功能在评估测试覆盖范围时特别有用**。 **场景五:接入 CI/CD 流水线** 通过 Claude CLI 的非交互模式,可以无缝接入 Jenkins: ``` claude -p "调用 api-test-executor 技能,参数: project_path=${PROJECT_PATH}, env=test, scope=p0" \ --permission-mode bypassPermissions \ --output-format json \ --max-turns 30 ``` 让接口测试真正成为流水线的一环。 ## **五、适合谁用?** **强烈推荐**: - • **接口自动化测试工程师**:日常跑用例、做回归、出报告 - • **测试开发工程师**:搭建团队测试基础设施、接入 CI/CD - • **全栈测试工程师**:希望降低自动化使用门槛 - • **测试团队负责人**:希望提升团队测试执行效率 **特别适合**: - • 已有 pytest 测试脚本的团队(迁移成本低) - • 希望用 AI 但不知道从哪里下手的团队(这是最好的切入点) - • 测试用例数量多、模块复杂的团队(标签筛选价值最大) ## **六、如何获取和安装?** 在AI 进化社内,下载获取api-test-executor 技能包。 **安装到 WorkBuddy**: ``` cp -r skills/api-test-executor ~/.workbuddy/skills/ ``` **安装到 Claude Code**: ``` cp -r skills/api-test-executor ~/.claude/skills/ ``` 安装完成后,在你的 AI 工具里直接说: > "在 test 环境跑一下 xxx 项目的冒烟测试" 就可以开始用了。 > **小贴士**:建议先配合 `api-test-tagger` 给脚本打上标准化标签,这样筛选效果最佳。 ## **七、实战演示** 1、首先,利用`api-testscript-generator` 技能 为被测项目`shop-lab`一键生成好测试脚本,比如生成好的项目脚本目录为:`shop-lab-api-test` (之前有文章分享过,此处不再重复) 2、将测试脚本项目下的`config`配置目录中`test.yaml`配置文件更换成被测项目真实地址,如下图,按需修改: ![](https://developer.qcloudimg.com/http-save/yehe-6490225/d768c8172446dafa5be51cdf517b0707.png) 3、打开任意Agent,比如WorkBuddy,在技能列表中,选择 `api-test-executor` 技能,传入测试脚本项目目录和环境配置: ``` 在 test 环境跑一下shop-lab-api-test 项目登录模块的冒烟测试 ``` ![](https://developer.qcloudimg.com/http-save/yehe-6490225/60a0fa4b3c51cdb648558346de5cd0eb.png) 4、收到上述执行提示词后,技能会进行自动解析成测试框架能理解的执行意图,最终**将执行翻译为:test 环境,冒烟测试,登录模块(auth),4 线程并发,失败重试 2 次**,并询问用户是否确认。 ![](https://developer.qcloudimg.com/http-save/yehe-6490225/a8c84bd5ef4fcaf6a987d51f8cef00ff.png) 这里可能有人会问,老师:"在上面的执行意图中,我们并没有明确要求配置4个线程并发,失败重试2次的要求啊“,那为什么在意图解析时,会出现这种执行要求呢? 这是因为`api-test-executor`技能中CLI命令行参数内置了默认值,如下图所示: ![](https://developer.qcloudimg.com/http-save/yehe-6490225/b3833cf7dcd326ff0508042523802280.png) 选择确认执行。 ![](https://developer.qcloudimg.com/http-save/yehe-6490225/0810a867482200657f8f26928c8570bb.png) WorkBuddy 会加载 `api-test-executor` 技能,自动完成以下流程: 1)、**环境自检**:检查 localhost:8080 服务是否可用、数据库连接是否正常; ![](https://developer.qcloudimg.com/http-save/yehe-6490225/3d9634f40ea786ad5699461bad0ee778.png) 2)、**执行范围解析**:扫描 testcases/ 目录,识别对应要求待执行的测试用例集; 3)、**解发pytest执行:** 运行脚本组装并执行 pytest 命令。 4)、**结果收集**:生成 `execution_summary.md` 执行结果汇总文件。 > 如果需要在Claude Code中调用`api-test-executor`,可以直接下载该技能源码或在线安装,也可以选择将workbuddy中对应的技能迁移到claude code目录下。 ![](https://developer.qcloudimg.com/http-save/yehe-6490225/33b528810bfcae30de5d9f81dfb7a74a.png) 进入到Claude Code中,输入`/api-test-executor` ![](https://developer.qcloudimg.com/http-save/yehe-6490225/0b7640d981e270fe9e9d9e35f538af70.png) ``` /api-test-executor 在 test 环境跑一下shop-lab-api-test 项目登录模块的冒烟测试 shop-lab-api-test路径为:xxx ``` ![](https://developer.qcloudimg.com/http-save/yehe-6490225/6a2e26b6fadc6d32a3047a9184a2b55c.png) 执行结果: ![](https://developer.qcloudimg.com/http-save/yehe-6490225/37926f34f51f2f259199f3cfa3c72a71.png) 从上述执行结果可以看到,本次用例执行有成功也有失败,这才符合接口测试执行的常规表现。 我们重点来看这条失败用例`test_register_success`,这是一个非常典型的数据污染问题。 脚本里把用户名`newuser_001`写死在了代码中,上一轮运行时这个账号就已经完成注册,再次执行脚本,接口检测到账号重复,直接返回异常,造成用例运行失败。 ![](https://developer.qcloudimg.com/http-save/yehe-6490225/72c78c2ab915fb1d2f54482eb95883f7.png) 针对这类脚本数据污染的问题,不要慌,我们可以调用失败用例智能诊断技能:`api-failure-diagnoser`来自动修复一下,当然这个技能,篇符关系,我们就留在下一篇再讲吧。 ## **写在最后** 测试行业有句老话:**"自动化测试的难点不在写脚本,而在跑脚本、看结果、修失败。"** api-test-executor 解决的就是这三个难点中最关键的一环——**让脚本能"听话地跑起来"**。 它不会替代你的测试策略思考,不会替代你的业务理解,更不会替代你对质量的整体把控。它只是把你从**机械的执行调度、繁琐的命令参数、散落的结果文件**中解放出来,让你把精力聚焦在更有价值的事情上——**测试策略优化、风险深度挖掘、质量趋势分析**。 **而这,正是 AI 赋能测试的真正意义**——不是替代人,而是解放人。 如果你也厌倦了每次跑测试都要折腾半天,强烈推荐试试这款 skill。 ![图片](https://developer.qcloudimg.com/http-save/yehe-6490225/77717a6a2888b7f76d099afdc3c98065.gif) 我是 狂师,**热衷于分享 AI 与软件测试开发技术实战与干货**。

优秀的个人博客,低调大师

大厂是如何利用DolphinScheduler提效?

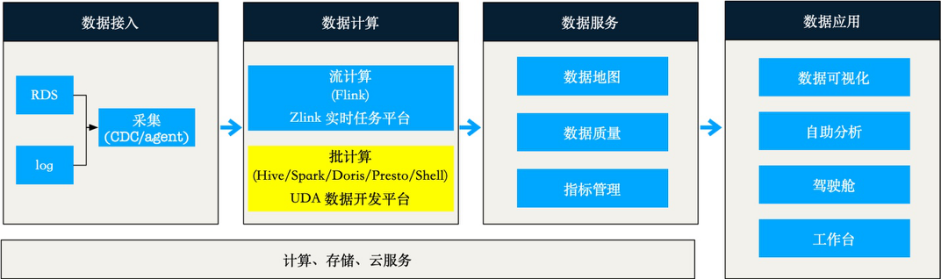
摘要 随着任务数量、任务类型需求不断增长,对我们的数据开发平台提出了更高的要求。本文主要分享我们将调度引擎升级到 Apache DolphinScheduler 的实践经验,以及对数据开发平台的一些思考。 背景 ===== 首先介绍下我们的大数据平台架构: 数据计算层承接了全公司的数据开发需求,负责运行各类指标计算任务。 其中批计算任务运行在 UDA 数据开发平台,支持任务全链路的开发场景:开发、调试、环境隔离、运维、监控。这些功能的支持、任务的稳定运行,强依赖底层的调度系统。 原有调度系统是 2015 年 (抑或更早) 自研的,随着任务类型新增、任务数量增多,暴露出诸多问题: 稳定性:频繁出现 mysql 连接不释放、锁超时等问题;数据库压力进一步导致调度性能瓶颈,任务无法及时调度。 可维护性:核心调度器通过 php 开发,代码古老又经历多次交接,外围模块实现时采用了 go java python 多种语言;再加上功能上也存在单点,维护成本很高。 扩展性:业务高速发展,不同任务类型需求越来越多,但是调度作为底层服务在支撑上一直力不从心。 可观测性:由于是定时nohup启动任务进程的方式,经常出现任务跑飞了的情况,系统暴露出来的可观测指标几乎为 0。 对调度系统的核心诉求,我觉得分为功能和系统两部分: 功能上,调度系统的核心能力是解决数仓构建的依赖调度问题,因此需要支持多种依赖形式;支持丰富的任务类型,同时可扩展自定义新的任务类型。以及上线管控、历史版本回滚、任务血缘等提高易用性的能力。 系统上,稳定性是第一位的,因此需要具备高可用的能力。同时支持租户隔离、线性扩展、可观测,以方便的对系统进行开发、维护和预警。 历史上我们调研过Airflow、DolphinScheduler 等多种选型,在过去大概一年的时间里,我们将大部分任务从自研调度系统迁移到了 DolphinScheduler 上。 当前调度系统概况如下: 任务类型上:HiveSQL、SparkSQL、DorisSQL、PrestoSQL、部分 shell 任务,均通过 DolphinScheduler 调度;遗留部分 shell 任务在原调度系统。 任务数量上:DolphinScheduler 天级别调度数万工作流实例,数十万任务实例,高峰时期同时运行 4K+ 工作流实例。迁移完成后,预计工作流实例实例数翻倍。 数据开发平台实践 =========== 2.1. 基于 DolphinScheduler 的改造 对 DolphinScheduler 的改造围绕稳定性和易用性展开,对于原有调度系统设计良好的功能,需要兼容以降低任务迁移成本。 我们基于 DolphinScheduler 做了如下升级: 由于 DolphinScheduler 的架构设计比较好,优化基本上可以围绕单点或者复用现有能力展开,而无需对架构进行大刀阔斧的改造。 我们的 SQL 任务都是多个 SQL 组成,但是原生的 SQL 任务只能提交单个。为了确保系统简洁,我没有引入各类 client(hive-client、spark-client 等),而是通过 SQL 解析、连接池管理方式重构等方式,通过 JDBC 协议支持了单任务多 SQL 的提交。 同时充分复用了 DolphinScheduler 对于数据源的设计,赋予数据源更多的属性,比如连接不同的 HiveServer2、Kyubbi、Presto Coordinator 等,对于计算运行在 Yarn 上的任务,单个数据源也只允许使用单个队列。对数据源增加权限控制,这样不同任务就只能使用有权限的集群资源。 我们将资源文件、DQL运行的结果数据,都统一上传到了腾讯云的 COS 对象存储,以确保做到 Worker 真正的无状态。(注:日志上传进行中) 此外包括对负载均衡进行优化、多业务线的租户调度隔离、数据库使用优化等。 2.2. 平滑的大规模迁移 尽管两个调度系统,在功能以及架构上存在巨大差异,但是需要做到平滑的迁移,主要三个原因: 原有调度系统服务多年,用户对于功能设计、系统专有字段名词等都已经养成习惯 2W+ 工作流的迁移预计耗时较久,涵盖公司众多重要数据流,问题影响程度高 用户覆盖了公司众多业务线 (平台、直播课、硬件、图书),问题影响面广 如此大规模的迁移我们做到了对用户几乎无感知,主要依赖新旧调度系统的打通和 DIFF。 接下来介绍下具体是怎么做的。 2.2.1. 新旧调度系统打通 任务迁移阶段,一部分任务运行在新的调度系统上,一部分运行在原有调度系统上,就需要解决两个问题: 用户能够查看所有任务实例的运行情况,包括一些内部已经习惯的调度名词 (run_index、result_ftp、log_ftp、csv_result_path 等),这部分信息在 DolphinScheduler 调度里显然没有 任务和任务之间有依赖关系,两个系统间调度任务时,也需要查询对方系统调度的任务实例状态,用于判断当前任务依赖是否就绪。 因此,我们在迁移阶段,架构是这样: 核心设计有两处。 首先任务实例状态统一到原调度系统数据库,对平台而言: 查询方式、字段、API 跟之前一致 任务更新时,如果该任务已经迁移到了新调度系统,则同时更新 DolphinScheduler 里的工作流定义 因此平台在使用上,对用户没有感知。 其次我们修改了 DolphinScheduler DependentTaskProcessor 的代码,支持查询 DolphinScheduler 及原有调度系统的任务实例状态。这样 DolphinScheduler 调度的任务,就可以自由依赖两个调度系统的任务实例了。 因此在调度能力上,也做到了对用户没有感知。 上述架构,未来在迁移完成后,就可以仅通过 UDA-API + DolphinScheduler 提供完整的调度能力了。 同时,我们在配置依赖的易用性上也做了优化,历史上支持了多种依赖方式:文件依赖、任务依赖、hql依赖、prestosql 依赖等。后两者都需要用户手动配置查询对应表,我们都优化为了表依赖。平台解析用户的 sql,针对读取的表,自动添加对应的依赖。既提高了易用性,也对用户屏蔽了底层具体表存储类型 (Hive/Presto/Iceberg/...) 的细节: 对任务依赖,也支持了全局搜索、偏移量、偏移单位以进一步提高易用性。 2.2.2. 新旧调度系统 DIFF 其次是新旧调度系统的 DIFF. 作为基础平台,服务的业务线众多,再加上 YARN 资源极其紧张,因此我们对调度系统的稳定性要求很高。为了确保迁移顺利,专门基于 DolphinScheduler DryRun 的能力做了一版定制: 所谓镜像任务,是指我们在迁移新调度之前,会先在 DolphinScheduler 镜像一份完全相同的任务,任务同样经过变量替换等操作,只是该任务标记了不真正执行。 这样我们就可以比较两个系统间的 DIFF,主要包括: 调度时间是否基本一致:用于验证依赖配置、定时设置等的兼容性 SQL 是否完全一致:验证变量替换、SQL 屏蔽、队列配置后,真正提交的 SQL 是否完全相同 经过上述空跑观察一段时间,确保无 diff 后,线上任务就真正迁移到新的调度引擎上了。 2.2.3. 系统的可观测性 在有限的时间里,我们做了上述准备,但是仍然不够充分。 系统需要具备良好的可观测性,DolphinScheduler 对外提供了 Prometheus 格式的基础指标。我们增加了一些高优指标,同时转化为 Falcon 格式对接到公司内部的监控系统。 通过监控大盘来查看调度系统的健康状况,并针对不同级别的指标和阈值,配置电话 / 钉钉报警: 可观测性提高后,分析问题的人力成本也得到控制,例如对于这种曲线: 容易观察到在非工作时间曲线值基本为 0,因此就能判断指标异常 (=1) 很可能是用户修改后触发的,相比之前出现问题只能靠猜和逐台机器登录分析日志的方式,通过 metrics 分析能够更早发现和预警问题。 在迁移启动后,对于 misfire、worker 线程池饱和度、连接池饱和度、io-util、overload 等指标,都重点关注和评估,以确保迁移顺利。 2.3. 迁移收益 目前迁移已经进行了一大半,我们针对新旧调度系统的数据库以及调度机资源使用做了对比: 数据库: QPS: 10000+ -> 500 负载:4.0 -> 1.0 资源使用降低 65% 我们在迁移过程中,通过 DolphinScheduler 以极低的开发成本支持了 SparkSQL、DorisSQL,以及高版本 PrestoSQL 这类业务新的调度需求。 功能上的其他对比: 未来规划 ======= 例行任务、调试能力全部迁移 DolphinScheduler,沉淀线上操作SOP 结合社区的容器化进度,实现模块 K8S 部署。当前 API 模块已经在生产环境使用,Worker、Master 进行中 全链路的一键数据回溯能力 离线、实时平台打通 本文由 白鲸开源科技 提供发布支持!

优秀的个人博客,低调大师

数据结构七:递归+动规+分治+回溯

Datawhale 系列数据结构 本文参考链接:01背包问题:https://blog.csdn.net/chanmufeng/article/details/82955730 Task7.1 递归 7.1.1爬楼梯 //爬楼梯: //假设你正在爬楼梯。需要 n 阶你才能到达楼顶 //每次你可以爬 1 或 2 个台阶。你有多少种不同的方法可以爬到楼顶呢? class Solution { public int climbStairs(int n) { int [] ways = new int[n+1]; ways[0] = 0; for (int i = 1;i<ways.length;i++){ if (i < 3 ){ ways[i] = i; }else { ways[i] = ways[i-1] + ways[i-2]; } } return ways[n]; } } //使用最小花费爬楼梯 //数组的每个索引做为一个阶梯,第 i个阶梯对应着一个非负数的体力花费值 cost[i](索引从0开始)。 //每当你爬上一个阶梯你都要花费对应的体力花费值,然后你可以选择继续爬一个阶梯或者爬两个阶梯。 //您需要找到达到楼层顶部的最低花费。在开始时,你可以选择从索引为 0 或 1 的元素作为初始阶梯。 class Solution { public int minCostClimbingStairs(int[] cost) { int length = cost.length; int[] newCost = new int[length+1]; newCost = Arrays.copyOf(cost,length+1); length = length+1; cost = newCost; int[] fn = new int[length]; fn[0] = 0; fn[1] = 0; fn[2] = Math.min(cost[0],cost[1]); for (int i = 3;i<length;i++){ fn[i] = Math.min(fn[i-1] + cost[i-1],fn[i-2]+cost[i-2]); } return fn[length-1]; } } 7.1.2 0-1背包问题(递归方法解决) 问题描述:给定 n 种物品重量$ w_1,w_2,w_3,...,w_n $,价值为$v_1,v_2,v_3,...,v_4$,一个容量为$C$的背包,问:应该如何选择装入背包的物品,使得装入背包中的物品的总价值最大?递归思想:首先我们用递归的方式来尝试解决这个问题我们用$F(n,C)$ 表示将前$n$个物品放进容量为$C$的背包里,得到最大的价值。我们用自顶向下的角度来看,假如我们已经进行到了最后一步(即求解将$n$个物品放到背包了获得最大价值),此时我们便有两种选择: 1.不放第$n$个物品,此时总价值为$F(n-1,C)$ 2.放置第$n$个物品,此时总价值为$v_n+F(n-1,C-w_n)$ 两种选择中总价值最大的方案就是我们的最终方案,递推式如下: $F(i,C)=max(F(i-1,C),v(i)+F(i-1,C-w(i)))$ //递归解法 public static int solveKS(int[] w,int[] v,int index,int capacity ){ if(index<0 || capacity <=0) return 0; int res = solveKS(w,v,index-1,capacity); if(w[index]<=capacity){ res=Math.max(res, v[index]+solveKS(w,v,index-1,capacity-w[index])); } return res; } public static int knapSack(int [] w,int [] v,int C){ int size=w.length; return solveKS(w,v,size-1,C); } Task 7.2 回溯 7.2.1八皇后问题 public static int [][] array=new int[8][8]; public static int map=0; public static void main(String[] args) { System.out.println("八皇后问题"); findQueen(0); System.out.println("八皇后问题共有:"+map+"种可能"); } public static void findQueen(int i){ if(i>7){ map++; print();// return; } for(int m=0;m<8;m++){ if(check(i,m)){ array[i][m]=1; findQueen(i+1); array[i][m]=0; } } } public static boolean check(int k, int j){ for(int i=0;i<8;i++){//检查行列冲突 if(array[i][j]==1){ return false; } } for(int i=k-1,m=j-1;i>=0&& m>=0;i--,m--){ if(array[i][m]==1){//检查左对角线冲突 return false; } } for(int i=k-1,m=j+1;i>=0&&m<=7;i--,m++){ if(array[i][m]==1){ return false; } } return true; } public static void print(){ System.out.print("方案"+map+":"+"\n"); for(int i=0;i<8;i++){ for(int m=0;m<8;m++){ if(array[i][m]==1){ //System.out.print("皇后"+(i+1)+"在第"+i+"行,第"+m+"列\t"); System.out.print("o "); } else{ System.out.print("+ "); } } System.out.println(); } System.out.println(); } 7.2.2求解0-1背包问题(回溯方法解决) 整体思路: 用回溯法需要构造子集树。对于每一个物品i,对于该物品只有选与不选2个决策,总共有n个物品,可以顺序依次考虑每个物品,这样就形成了一颗空间树:基本思想就是遍历这棵树,以枚举所有情况,最后进行判断,如果重量不超过背包容量,且价值最大的话,该方案就是最后的答案 算法设计: 利用回溯设计一个算法求出0-1背包问题的解,也就是求出一个解向量xi(即对n个物品放或不妨的一种的方案) 其中,(xi=0或1,xi=0表示物体i不放入背包,xi=1表示把物体i放入背包)。 在递归函数Backtrack中, 当i>n时,算法搜索到叶子节点,得到一个新的物品包装方案。此时算法适时更新当前的最有价值。 当i<n时,当前扩展结点位于排列树的第(i-1)层,此时算法选择下一个要安排的物品,以深度优先方式递归的对相应的子树进行搜索,对不满足上界约束的结点,则剪去相应的子树 //回溯 public class KnapSack02 { private static int n=3;//物品数量编号,从0开始 private static double c=5;//背包容量 private static double [] v={12,10,20,15};//各个物品的价值 private static double [] w={2,1,3,2};//各个物品的重量 private static double cw = 0.0;//当前背包重量 current weight private static double cp = 0.0;//当前背包中物品总价值 current value private static double bestp = 0.0;//当前最优价值best price private static double [] perp = new double [4];//单位物品价值(排序后) per price private static int [] order = new int [4];//物品编号 private static int [] put = new int [4];//设置是否装入,1装入,0不装 //按单位价值排序 public static void knapsack(){ int i,j; int temporder = 0; double temp= 0.0; for(i=1;i<=n;i++) perp[i]=v[i]/w[i]; for(i=1;i<=n-1;i++) { for(j=i+1;j<=n;j++) if(perp[i]<perp[j])//冒泡排序perp[],order[],sortv[],sortw[] { temp = perp[i]; //冒泡对perp[]排序 perp[i]=perp[i]; perp[j]=temp; temporder=order[i];//冒泡对order[]排序 order[i]=order[j]; order[j]=temporder; temp = v[i];//冒泡对v[]排序 v[i]=v[j]; v[j]=temp; temp=w[i];//冒泡对w[]排序 w[i]=w[j]; w[j]=temp; } } } public static void backtrack(int i){ //i表示到达的层数(第几步,从0开始),同事也只是当前选择玩了几个物品 bound( i); if(i>n){ bestp=cp; return; } //如若左子节点可行,则直接搜索左子树; //对于右子树,先计算上界函数,以判断是否将其减去 if(cw+w[i]<=c)//将物品i放入背包,搜索左子树 { cw+=w[i];//同步更新当前背包的重量 cp+=v[i];//同步更新当前背包的总价值 put[i]=1; backtrack(i+1);//深度搜索进入下一层 cw-=w[i];//回溯复原 cp-=v[i];//回溯复原 } if(bound(i+1)>bestp)//如若符合条件则搜索右子树 backtrack(i+1); } //计算上界函数,功能为剪枝 public static double bound(int i) { //判断当前背包的总价值cp+剩余容量可容纳的最大价值<=当前最优价值 double leftw= c-cw;//剩余背包容量 double b = cp;//记录当前背包的总价值cp,最后求上界 //以物品单位重量价值递减次序装入物品 while(i<=n && w[i]<=leftw) { leftw-=w[i]; b+=v[i]; i++; } //装满背包 if(i<=n) b+=v[i]/w[i]*leftw; return b;//返回计算出的上界 } public static void main(String[] args) { knapsack(); backtrack(1); System.out.println(bestp); } } Task7.3 分治 7.3.1 利用分治算法求一组数据的逆序对个数 public class ReverseOrder { private static int sum = 0; private static int []a ={5,4,2,6,3,1}; private static int []b =new int [6]; public static void worksort(int l,int r){ int mid,tmp,i,j; if(r>l+1){ mid=(l+r)/2; worksort(l,mid-1); worksort(mid,r); tmp=l; for(i=l,j=mid;i<=mid-1 && j<=r;){ if(a[i]>a[j]) { b[tmp++]=a[j++];//快速排序 sum+=mid-i;//统计逆序对个数 } else b[tmp++]=a[i++]; } if(j<=r) for(;j<=r;j++) b[tmp++]=a[j]; else for(;i<=mid-1;i++) b[tmp++]=a[i]; for(i=l;i<=r;i++) a[i]=b[i];//将排好序的b数组赋值给a数组 }else{ if(l+1==r)//递归的边界 if(a[l]>a[r]) { int temp = a[l]; a[l]=a[r]; a[r]=temp; sum++; } } } public static void main(String[] args) { worksort(0,5); System.out.println(sum); } } Task 7.4 动态规划 7.4.1 0-1背包问题 //动态规划 int size = w.length; if (size == 0) { return 0; } int[] dp = new int[C + 1]; //初始化第一行 //仅考虑容量为C的背包放第0个物品的情况 for (int i = 0; i <= C; i++) { dp[i] = w[0] <= i ? v[0] : 0; } for (int i = 1; i < size; i++) { for (int j = C; j >= w[i]; j--) { dp[j] = Math.max(dp[j], v[i] + dp[j - w[i]]); } } return dp[C]; } public static void main(String[] args) { int[] w = {2, 1, 3, 2}; int[] v = {12, 10, 20, 15}; System.out.println(knapSack(w, v, 5)); } 7.4.2 编程实现莱温斯坦最短编辑距离 public static int minEditDistance(String dest,String src){ int [][] f=new int[dest.length()+1][src.length()+1]; f[0][0]=0; for(int i=1;i<dest.length()+1;i++){ f[i][0]=i; } for(int i=1;i<src.length()+1;i++){ f[0][i]=i; } for(int i=1;i<dest.length()+1;i++){ for(int j=1;j<src.length()+1;j++){ int cost=0; if(dest.charAt(i - 1) != src.charAt(j - 1)){ cost=1; } int minCost; if(f[i-1][j]<f[i][j-1]){ minCost=f[i-1][j]+cost; }else{ minCost=f[i][j-1]+cost; } f[i][j]=minCost; } } return f[dest.length()][src.length()]; } public static void main(String[] args) { System.out.println(minEditDistance("sot", "stop")); } 7.4.3 编程实现查找两个字符串的最长子序列 //求解str1 和 str2 的最长公共子序列 public static int LCS(String str1, String str2){ int[][] c = new int[str1.length() + 1][str2.length() + 1]; for(int row = 0; row <= str1.length(); row++) c[row][0] = 0; for(int column = 0; column <= str2.length(); column++) c[0][column] = 0; for(int i = 1; i <= str1.length(); i++) for(int j = 1; j <= str2.length(); j++) { if(str1.charAt(i-1) == str2.charAt(j-1)) c[i][j] = c[i-1][j-1] + 1; else if(c[i][j-1] > c[i-1][j]) c[i][j] = c[i][j-1]; else c[i][j] = c[i-1][j]; } return c[str1.length()][str2.length()]; } //test public static void main(String[] args) { String str1 = "BDCABA"; String str2 = "ABCBDAB"; int result = LCS(str1, str2); System.out.println(result); } 7.4.4编程实现一个数据序列的最长递增子序列 class Solution { public int lengthOfLIS(int[] nums) { /** dp[i]: 所有长度为i+1的递增子序列中, 最小的那个序列尾数. 由定义知dp数组必然是一个递增数组, 可以用 maxL 来表示最长递增子序列的长度. 对数组进行迭代, 依次判断每个数num将其插入dp数组相应的位置: 1. num > dp[maxL], 表示num比所有已知递增序列的尾数都大, 将num添加入dp 数组尾部, 并将最长递增序列长度maxL加1 2. dp[i-1] < num <= dp[i], 只更新相应的dp[i] **/ int maxL = 0; int[] dp = new int[nums.length]; for(int num : nums) { // 二分法查找, 也可以调用库函数如binary_search int lo = 0, hi = maxL; while(lo < hi) { int mid = lo+(hi-lo)/2; if(dp[mid] < num) lo = mid+1; else hi = mid; } dp[lo] = num; if(lo == maxL) maxL++; } return maxL; } } Task 7.5 练习 7.5.1 实战递归 //Letter Combinations of a Phone Number(17) String[] button=new String[]{"","","abc","def","ghi","jkl","mno","pqrs","tuv","wxyz"}; List<String> list=new ArrayList<>(); public List<String> letterCombinations(String digits) { if (digits==null||digits.length()==0) return list; letterCombinations(digits,0,new String()); return list; } public void letterCombinations(String digits,int index,String temp) { if(index==digits.length()){ list.add(temp); return; } int position=digits.charAt(index)-'0'; String str=button[position]; for (int i=0;i<str.length();i++){ letterCombinations(digits,index+1,temp+str.charAt(i)); } } //permutations(46) List<List<Integer>> res = new ArrayList<>(); public List<List<Integer>> permute(int[] nums) { permutation(nums, 0, nums.length - 1); return res; } private void permutation(int[] nums, int p, int q) { if (p == q) { res.add(arrayToList(nums)); } for (int i = p; i <= q; i++) { swap(nums, i, p); permutation(nums, p + 1, q); swap(nums, i, p); // 这里要交换回来,免得出现重复的情况 } } private List<Integer> arrayToList(int[] nums) { List<Integer> res = new ArrayList<>(); for (int i = 0; i < nums.length; i++) { res.add(nums[i]); } return res; } private void swap(int[] nums, int i, int j) { int temp = nums[i]; nums[i] = nums[j]; nums[j] = temp; } 7.5.2 实战dp //完成0-1背包问题实现(自我实现)及Leetcode 参考7.4.1 //Palindrome Partitioning II(132) public int minCut(String s) { if(s == null || s.isEmpty()){ return 0; } int len = s.length(); boolean[][] dp = new boolean[s.length()][s.length()]; int[] cut = new int[s.length()]; for(int i = 0; i < len; i++){ //最大划分就是i次 cut[i]= i; for(int j = 0; j <= i; j++){ if(s.charAt(i) == s.charAt(j) &&(i-j <= 1 || dp[j+1][i-1])){ dp[j][i] = true; if(j == 0) { //0-i直接是回文 cut[i] = 0; } else { cut[i] = Math.min(cut[j-1]+1, cut[i]); } } } } return cut[len-1]; } 7.5.2 可选练习 //Regular Expression Matching(正则表达式匹配) class Solution { public boolean isMatch(String text, String pattern) { if (pattern.isEmpty()) return text.isEmpty(); boolean first_match = (!text.isEmpty() && (pattern.charAt(0) == text.charAt(0) || pattern.charAt(0) == '.')); if (pattern.length() >= 2 && pattern.charAt(1) == '*'){ return (isMatch(text, pattern.substring(2)) || (first_match && isMatch(text.substring(1), pattern))); } else { return first_match && isMatch(text.substring(1), pattern.substring(1)); } } } //Minimum Path Sum(最小路径和) public int minPathSum(int[][] grid) { int rows=grid.length; int cols=grid[0].length; int [] dp=new int[cols]; dp[0]=grid[0][0]; for(int col=1;col<cols;col++){ dp[col]=dp[col-1]+grid[0][col]; } for(int row = 1; row < rows; row++) { for(int col = 0; col < cols; col++) { if(col > 0){ dp[col] = Math.min(dp[col-1], dp[col]) + grid[row][col]; }else{ dp[col] += grid[row][col]; } } } return dp[cols - 1]; } //Coin Change (零钱兑换)[作为可选] //Best Time to Buy and Sell Stock(买卖股票的最佳时机)[作为可选] //Maximum Product Subarray(乘积最大子序列)[作为可选] //Triangle(三角形最小路径和)[作为可选]

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册