首页 文章 精选 留言 我的

精选列表

搜索[内核任意读写],共10009篇文章
优秀的个人博客,低调大师

Hadoop核心-HDFS读写流程

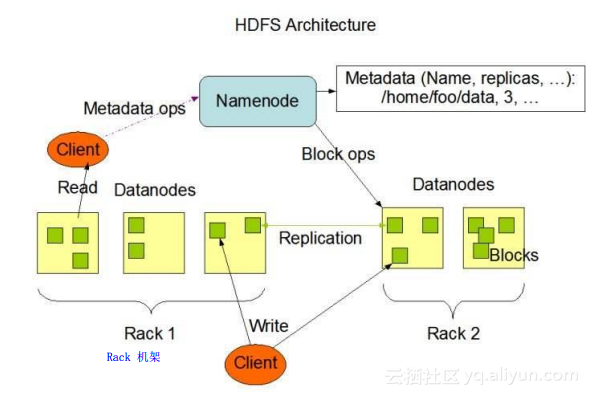
HDFS写数据步骤: 1. client发起文件上传请求,通过RPC与NameNode建立连接,NameNode检查目标文件是否已经存在,父目录是否存在,并检查用户是否有相应的权限,若检查通过, 会为该文件创建一个新的记录,否则的话文件创建失败,客户端得到异常信息, 2. client通过请求NameNode,第一个block应该传输到哪些DataNode服务器上; 3. NameNode根据配置文件中指定的备份(replica)数量及机架感知原理进行文件分配,返回可用的DataNode的地址 以三台DataNode为例:A B C 注: Hadoop在设计时考虑到数据的安全与高效,数据文件默认在HDFS上存放三份,存储策略为:第一个备份放在客户端相同的datanode上(若客户端在集群外运行, 就随机选取一个datanode来存放第一个replica),第二个replica放在与第一个replica不同机架的一个随机datanode上,第三个replica放在与第二个repli ca相同机架的随机datanode上,如果replica数大于三,则随后的replica在集群中随机存放,Hadoop会尽量避免过多的replica存放在同一个机架上.选取repl ica存放在同一个机架上.(Hadoop 1.x以后允许replica是可插拔的,意思是说可以定制自己需要的replica分配策略) 4. client请求3台的DataNode的一台A上传数据,(本质是一个RPC调用,建立pipeline),A收到请求会继续调用B,然后B调用C,将整个pipeline建立完成后,逐 级返回client; 5. client开始往A上传第一个block(先从磁盘读取数据放到一个本地内存缓存),以packet为单位(默认 64K),A收到一个packet就会传给B,B传递给C;A每传一 个packet会放入一个应答队列等待应答. 注: 如果某个datanode在写数据的时候宕掉了下面这些对用户透明的步骤会被执行: 1) 管道线关闭,所有确认队列上的数据会被挪到数据队列的首部重新发送,这样也就确保管道线中宕掉的datanode下流的datanode不会因为宕掉的datanode而丢 失数据包 2) 在还在正常运行datanode上的当前block上做一个标志,这样当宕掉的datanode重新启动以后namenode就会知道该datanode上哪个block是刚才宕机残留下 的局部损坏block,从而把他删除掉 3) 已经宕掉的datanode从管道线中被移除,未写完的block的其他数据继续呗写入到其他两个还在正常运行的datanode中,namenode知道这个block还处在und er-replicated状态(即备份数不足的状态)下,然后它会安排一个新的replica从而达到要求的备份数,后续的block写入方法同前面正常时候一样 4) 有可能管道线中的多个datanode宕掉(一般这种情况很少),但只要dfs.relication.min(默认值为1)个replica被创建,我么就认为该创建成功了,剩余的re lica会在以后异步创建以达到指定的replica数. 6. 数据被分割成一个个packet数据包在pipeline上一次传输,在pipeline反方向上,逐个发送ack(命令正确应答),最终由pipeline中第一个DataNode节点A 将pipeline ack发送给client 7. 当一个block传输完成后,client再次发送请求NameNode上传第二个block到服务器 HDFS读数据步骤: 1. Client向NameNode发起RPC请求,来确定请求文件block所在的位置; 2. NameNode会视情况返回文件的部分或者全部block列表,对于每个block,NameNode都会返回含有该block副本的DataNode地址 3. 这些返回的DN地址,会按照集群拓扑结构得出DataNode与客户端的距离,然后进行排序,排序两个规则:网络拓扑结构中距离Client的排在前;心跳机制中超时汇 报的DN状态为STALE,这样的排在后 4. Clietn选取排序靠前的DataNode来读取block,如果客户端本身就是DataNode,那么将从本地直接获取数据 5. 底层本质是建立Socket Stream(FSDataInputStream) ,重复调用父类DataInputStream的read方法,知道这个块上的数据读取完毕; 6. 当读完列表的block后,若文件读取还没有结束,客户端会继续想NameNode获取下一批的block列表 7. 读取完一个Block都会进行checksum验证,如果读取DataNode时出现错误,客户端会通知NameNode,然后再从下一个拥有该block副本的DataNode继续读取 注: 如果在读取过程中DFSInputStream检测到block错误,DFSInputStream也会检查从datanode读取来的数据的校验和,如果发现有数据损坏,它会把坏掉的bl ock报告给namenode同时重新读取其他datanode上的其他block备份 8. read方法是并行的读取block信息,不是一块一块的读取,NameNode只是返回Client请求包含块的DataNode地址,并不是返回请求块的数据; 9. 最终读取哎所有的block会合并成一个完整的最终文件

优秀的个人博客,低调大师

任意Android设备上运行测试

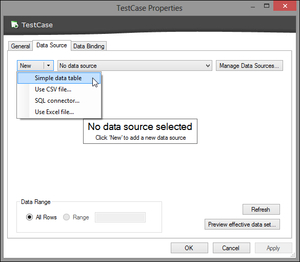
图:打开数据源“对话框... 图:添加一个简单数据表... 图:添加设备名称到简单数据表 这样做之后,切换到“数据绑定”选项卡,并绑定数据源中的模块变量。 图:数据源绑定变量 如果你想了解更多有关测试数据驱动的方法,参考第3课:数据驱动的测试。 现在,测试套件准备好在不同的设备上运行了。 成功运行测试后,测试报告看起来应该像下面这样。 图:两个设备上成功执行的测试 我们会向你证明,在设备上运行您的Andr??oid测试是多么容易。添加其他设备,调制并部署测试的App,如本章前面所述。 注意:在不同的设备上运行测试时,请一定要加一个'Close Application'的action,因为如果前一个设备上的 App不被关闭,那么接着执行时,这个设备上的App仍然会被自动化。 图:添加“Close Application”action,以确保录制的脚本在正确的设备上执行 这样做之后,对'Run Mobile App' 的'Device Display Name'列进行参数化,改成模块变量。 图:把设备名称作为变量 把设备名称参数化后,打开包含该模块用例的“数据源”对话框,添加一个简单数据表,在表中添加你想运行设备的名称。 并行执行测试 它也可以在多个设备上同时运行一个测试。 因为没有必要使用数据源,所以在测试用例属性对话框中禁用先前创建的数据源。 图:禁用数据源 添加一个全局参数,并把它绑定到变量'varMobileDevice'。 图:添加全局参数 图:把变量绑定到全局参数 全局参数和数据绑定的进一步详情请参考“ 第3课:数据驱动测试。 在对象库中,使用Ranorex Xpy 的path编辑器打开移动App的RanoreXPath,。 图:打开高级RanoreXPath编辑器 添加设备名称到RanoreXPath中,并选择变量'varMobileDevice'作为值。 图:把设备名称变量添加到RanoreXPath 执行这些步骤之后,你就可以编译测试套件,通过命令行,把移动设备名称作为命令行参数来执行测试用例,参考“ 第4课:Ranorex测试套件-无RanorexStudio运行测试 “: start MobileTest.exe /pa:globalMobileDevice="Galaxy Nexus" start MobileTest.exe /pa:globalMobileDevice="GT-P7500" 最新内容请见作者的GitHub页:http://qaseven.github.io/

优秀的个人博客,低调大师

Go 语言读写 Excel 基础库

Excelize 是 Go 语言编写的一个用来操作 Office Excel 文档类库,基于 ECMA-376 Office OpenXML 标准。可以使用它来读取、写入 XLSX 文件。相比较其他的开源类库,Excelize 支持写入原本带有图片(表)的文档,还支持向 Excel 中插入图片,并且在保存后不会丢失图表样式。 安装 go get github.com/xuri/excelize/v2 创建 XLSX package main import ( "fmt" "github.com/xuri/excelize/v2" ) func main() { f := excelize.NewFile() // Create a new sheet. index := f.NewSheet("Sheet2") // Set value of a cell. f.SetCellValue("Sheet2", "A2", "Hello world.") f.SetCellValue("Sheet1", "B2", 100) // Set active sheet of the workbook. f.SetActiveSheet(index) // Save xlsx file by the given path. err := f.SaveAs("./Book1.xlsx") if err != nil { fmt.Println(err) } } 读取已有文档 package main import ( "fmt" "github.com/xuri/excelize/v2" ) func main() { f, err := excelize.OpenFile("./Book1.xlsx") if err != nil { fmt.Println(err) return } // Get value from cell by given worksheet name and axis. cell, err := f.GetCellValue("Sheet1", "B2") if err != nil { fmt.Println(err) return } fmt.Println(cell) // Get all the rows in the Sheet1. rows, err := f.GetRows("Sheet1") for _, row := range rows { for _, colCell := range row { fmt.Print(colCell, "\t") } fmt.Println() } } 向 Excel 中插入图表 package main import ( "fmt" "github.com/xuri/excelize/v2" ) func main() { categories := map[string]string{"A2": "Small", "A3": "Normal", "A4": "Large", "B1": "Apple", "C1": "Orange", "D1": "Pear"} values := map[string]int{"B2": 2, "C2": 3, "D2": 3, "B3": 5, "C3": 2, "D3": 4, "B4": 6, "C4": 7, "D4": 8} f := excelize.NewFile() for k, v := range categories { f.SetCellValue("Sheet1", k, v) } for k, v := range values { f.SetCellValue("Sheet1", k, v) } err := f.AddChart("Sheet1", "E1", `{"type":"col3DClustered","series":[{"name":"Sheet1!$A$2","categories":"Sheet1!$B$1:$D$1","values":"Sheet1!$B$2:$D$2"},{"name":"Sheet1!$A$3","categories":"Sheet1!$B$1:$D$1","values":"Sheet1!$B$3:$D$3"},{"name":"Sheet1!$A$4","categories":"Sheet1!$B$1:$D$1","values":"Sheet1!$B$4:$D$4"}],"title":{"name":"Fruit 3D Clustered Column Chart"}}`) if err != nil { fmt.Println(err) return } // Save xlsx file by the given path. err = f.SaveAs("./Book1.xlsx") if err != nil { fmt.Println(err) } } 向 Excel 中插入图片 package main import ( "fmt" _ "image/gif" _ "image/jpeg" _ "image/png" "github.com/xuri/excelize/v2" ) func main() { f, err := excelize.OpenFile("./Book1.xlsx") if err != nil { fmt.Println(err) return } // Insert a picture. err = f.AddPicture("Sheet1", "A2", "./image1.png", "") if err != nil { fmt.Println(err) } // Insert a picture to worksheet with scaling. err = f.AddPicture("Sheet1", "D2", "./image2.jpg", `{"x_scale": 0.5, "y_scale": 0.5}`) if err != nil { fmt.Println(err) } // Insert a picture offset in the cell with printing support. err = f.AddPicture("Sheet1", "H2", "./image3.gif", `{"x_offset": 15, "y_offset": 10, "print_obj": true, "lock_aspect_ratio": false, "locked": false}`) if err != nil { fmt.Println(err) } // Save the xlsx file with the origin path. err = f.Save() if err != nil { fmt.Println(err) } } 还有其他一些功能,在这里就不一一列举了,详细使用文档以及获取后期的维护更新可以从项目的主页获取 github.com/xuri/excelize

优秀的个人博客,低调大师

jdbc 读写 blob 类型的数据

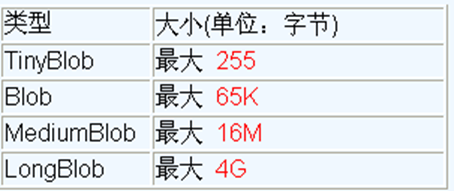
1 MySQL BLOB类型 MySQL中,BLOB是一个二进制大型对象,是一个可以存储大量数据的容器,它能容纳不同大小的数据。 插入BLOB类型的数据必须使用PreparedStatement,因为BLOB类型的数据无法使用字符串拼接写的。 MySQL的四种BLOB类型(除了在存储的最大信息量上不同外,他们是等同的) 实际使用中根据需要存入的数据大小定义不同的BLOB类型。 需要注意的是:如果存储的文件过大,数据库的性能会下降。 如果在指定了相关的Blob类型以后,还报错:xxx too large,那么在mysql的安装目录下,找my.ini文件加上如下的配置参数:max_allowed_packet=16M。同时注意:修改了my.ini文件之后,需要重新启动mysql服务。 2 向数据表中插入大数据类型 //获取连接 Connection conn = JDBCUtils.getConnection(); String sql = "insert into customers(name,email,birth,photo)values(?,?,?,?)"; PreparedStatement ps = conn.prepareStatement(sql); //java项目www.fhadmin.org // 填充占位符 ps.setString(1, "张强"); ps.setString(2, "123@126.com"); ps.setDate(3, new Date(new java.util.Date().getTime())); // 操作Blob类型的变量 FileInputStream fis = new FileInputStream("xhq.png"); ps.setBlob(4, fis); //执行 ps.execute(); fis.close(); JDBCUtils.closeResource(conn, ps); 3 修改数据表中的Blob类型字段 Connection conn = JDBCUtils.getConnection(); String sql = "update customers set photo = ? where id = ?"; PreparedStatement ps = conn.prepareStatement(sql); //java项目www.fhadmin.org // 填充占位符 // 操作Blob类型的变量 FileInputStream fis = new FileInputStream("coffee.png"); ps.setBlob(1, fis); ps.setInt(2, 25); ps.execute(); fis.close(); JDBCUtils.closeResource(conn, ps); 4 从数据表中读取大数据类型 //java项目www.fhadmin.org String sql = "SELECT id, name, email, birth, photo FROM customer WHERE id = ?"; conn = getConnection(); ps = conn.prepareStatement(sql); ps.setInt(1, 8); rs = ps.executeQuery(); if(rs.next()){ Integer id = rs.getInt(1); String name = rs.getString(2); String email = rs.getString(3); Date birth = rs.getDate(4); Customer cust = new Customer(id, name, email, birth); System.out.println(cust); //读取Blob类型的字段 Blob photo = rs.getBlob(5); InputStream is = photo.getBinaryStream(); OutputStream os = new FileOutputStream("c.jpg"); byte [] buffer = new byte[1024]; int len = 0; while((len = is.read(buffer)) != -1){ os.write(buffer, 0, len); } JDBCUtils.closeResource(conn, ps, rs); if(is != null){ is.close(); } if(os != null){ os.close(); } }

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册