鸿蒙内核源码分析(汇编汇总篇) | 鸿蒙所有的汇编代码都在这里 | 中文注解HarmonyOS源码 | v40.01
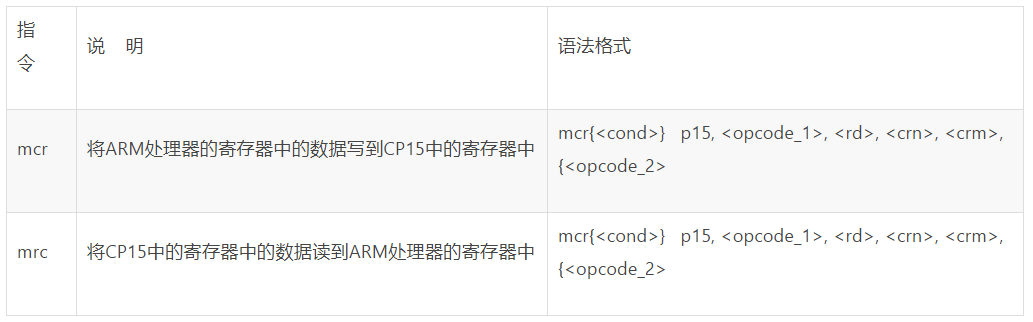
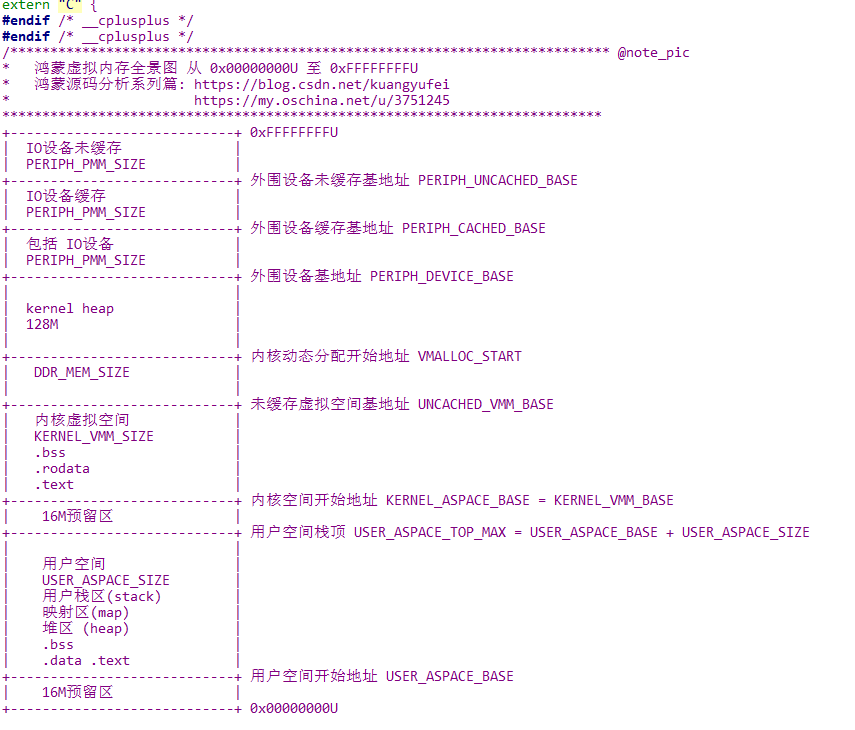
百万汉字注解 >> 精读内核源码,中文注解分析, 深挖地基工程,大脑永久记忆,四大码仓每日同步更新< gitee | github | csdn | coding > 百篇博客分析 >> 故事说内核,问答式导读,生活式比喻,表格化说明,图形化展示,多站点每日同步更新< oschina | csdn | weharmony > 汇编其实很可爱 绝大部分IT从业人员终生不用触碰到的汇编,它听着像上古时代遥远的呼唤,总觉得远却又能听到声,汇编再往下就真的是01110011了,汇编指令基本是一一对应了机器指令. 所谓内核是对硬件的驱动,对驱动之后资源的良序管理,这里说的资源是CPU(单核/多核),内存,磁盘,i/o设备.层层封装,步步遮蔽,到了应用层,不知有汉,无论魏晋才好.好是好,但有句话,其实哪有什么岁月静好,只是有人替你负重前行.难道你真的不想知道别人是怎么替你负重前行的? 越高级的语言是越接近人思维模式的,越低级的语言就是越贴近逻辑与非门的高低电平的起伏.汇编是贴着硬件飞行的,要研究内核就绕不过汇编,觉得神秘是来源于不了解,恐惧是来自于没接近. 其实当你深入分析内核源码之后就会发现,汇编其实很可爱,很容易,比c/c++/java容易太多了,真的是很傻很单纯. 鸿蒙内核源码分析系列篇至少已经有五篇涉及到了汇编,请自行翻看,但还是远远不够,要写十五篇,彻底摸透,现在才刚刚开始,本篇先整理鸿蒙内核所有汇编文件和大概说明文件的作用,后续一块一块来剥,不把这些汇编剥个精光不罢休. 汇编目录 鸿蒙所有汇编文件如下: 直接点击可以查看注解源码,有些站点会把链接去除,没办法,可直接去各大站点搜"鸿蒙内核源码分析",找到源码注解. \arch\arm\arm\src startup 启动相关 reset_vector_mp.S 多核CPU下启动代码,大文件 reset_vector_up.S 单核CPU下启动代码,大文件 armv7a cache.S 缓存相关的两个函数 los_dispatch.S 异常分发处理,大文件. los_hw_exc.S 硬件异常相关,大文件. los_hw_runstop.S OsSRSaveRegister 和 OsSRRestoreRegister 汇编实现 jmp.S 两个简单的跳转函数 hw_user_get.S 拷贝用户空间数据到内核空间 hw_user_put.S 拷贝内核空间数据到用户空间 hw_user_get.S 将用户空间数据src 拷贝到内核空间 dst // errno_t _arm_get_user(void *dst, const void *src, size_t dstTypeLen, size_t srcTypeLen) FUNCTION(_arm_get_user) stmdb sp!, {r0, r1, r2, r3, lr} @四个参数入栈,保存LR cmp r2, #0 @r2 和 0比较 beq .Lget_user_return @相等 跳到Lget_user_return 直接返回 cmp r2, r3 @r2 和 r3比较 bne .Lget_user_err @不等,说明函数要返回错误 cmp r2, #1 @r2 和 1比较 bhi .Lget_user_half @if(dstTypeLen>1) 跳转到Lget_user_half .Lget_user_byte: @按字节拷贝数据 0: ldrbt r3, [r1], #0 @r3=*r1 1: strb r3, [r0], #0 @*r0=r3 b .Lget_user_return .Lget_user_half: cmp r2, #2 @r2 和 2比较 bhi .Lget_user_word @if(dstTypeLen>2) Lget_user_word 2: ldrht r3, [r1], #0 @完成最后一个字节的拷贝 3: strh r3, [r0], #0 @完成最后一个字节的拷贝 b .Lget_user_return .Lget_user_word: cmp r2, #4 @r2 和 4比较 bhi .Lget_user_err @if(dstTypeLen>4) 跳转到Lget_user_err 4: ldrt r3, [r1], #0 5: str r3, [r0], #0 .Lget_user_return: @返回锚点 ldmia sp!, {r0, r1, r2, r3, lr} @保存的内容出栈,恢复各寄存器值 mov r0, 0 @r0保存返回值为0 bx lr @跳回调用函数继续执行,_arm_get_user到此结束! .Lget_user_err: ldmia sp!, {r0, r1, r2, r3, lr} @保存的内容出栈,恢复各寄存器值 mov r0, #-14 @r0保存返回值为-14 bx lr @跳回调用函数继续执行,_arm_get_user到此结束! .pushsection __exc_table, "a" .long 0b, .Lget_user_err .long 1b, .Lget_user_err .long 2b, .Lget_user_err .long 3b, .Lget_user_err .long 4b, .Lget_user_err .long 5b, .Lget_user_err .popsection hw_user_put.S 将内核空间数据src 拷贝到用户空间 dst // errno_t _arm_put_user(void *dst, const void *src, size_t dstTypeLen, size_t srcTypeLen) FUNCTION(_arm_put_user) stmdb sp!, {r0, r1, r2, r3, lr} cmp r2, #0 beq .Lget_user_return cmp r2, r3 bne .Lget_user_err cmp r2, #1 bhi .Lget_user_half .Lget_user_byte: 0: ldrb r3, [r1], #0 1: strbt r3, [r0], #0 b .Lget_user_return .Lget_user_half: cmp r2, #2 bhi .Lget_user_word 2: ldrh r3, [r1], #0 3: strht r3, [r0], #0 b .Lget_user_return .Lget_user_word: cmp r2, #4 bhi .Lget_user_err 4: ldr r3, [r1], #0 5: strt r3, [r0], #0 .Lget_user_return: ldmia sp!, {r0, r1, r2, r3, lr} mov r0, 0 bx lr .Lget_user_err: ldmia sp!, {r0, r1, r2, r3, lr} mov r0, #-14 bx lr .pushsection __exc_table, "a" .long 0b, .Lget_user_err .long 1b, .Lget_user_err .long 2b, .Lget_user_err .long 3b, .Lget_user_err .long 4b, .Lget_user_err .long 5b, .Lget_user_err .popsection 解读 如果仔细对比一下发现这两个函数的汇编代码是一模一样的,没有区别.这就跟让左右各一个美女陪你和左右各一个丑姑娘陪你的道理是一样,都是1+1=2,算式加法的逻辑是一样的,不会变.但给你的感觉能一样嘛,美丑的含义是上层赋予的,到了这里美丑不重要,都变成了 r0,r1,r2,r3了, 跟咱东哥一样脸盲分不清啦 用户空间和内核空间的数据为什么需要拷贝? 这是个经典问题,看了网上的一些回答,没毛病: 内核不能信任任何用户空间的指针。必须对用户空间的指针指向的数据进行验证。如果只做验证不做拷贝的话,那么在随后的运行中要随时受到其它进/线程可能修改用户空间数据的威胁。所以必须做拷贝。 在内存系列篇中已经反复的说过,每个用户进程都有自己独立的用户空间,但这个用户空间是通过MMU映射出来的,是表面上繁花似锦,背后都共用着真正的物理内存,所以在高频率的任务切换过程中,原有的用户空间地址内容很容易被覆盖掉.举个例子说明下: 用户A客户有个美女放在万聪酒店21号房说要献给内核大佬,如果内核不直接把美女接回家,而仅仅是做个记录,写着美女在万聪酒店21号房,内核立马跑去过还好不会错,但如果被其他事给耽搁了呢? 耽搁的这回功夫,调度算法把万聪酒店21号房给了B客户使用,当然B客户用之前酒店管理人员会把美女置换个地方(以至于A客户再回到酒店时,原来的东西该怎样还咋样). 等21号房空出来了,B肯定不知道原来的房间是A在用,而且里面还有个美女,更不可能晓得美女献给内核大佬了.因为B的业务需要,很可能往21号房整了个东施进来. 此时如果内核大佬事忙完了,想起A客户献美女的事了,是时候了.因为只记录了地址,直接去万聪酒店21号房抓人,那抓出来可是东施呀.这可不把事给搞砸啦. 所以需要拷贝,直接把美女接回家找个地方关起来先. reset_vector_mp.S 和 reset_vector_up.S 鸿蒙开机代码根据 CPU多核还是单核分成了两个独立文件处理. mp就是多处理器(multiprocessing)的意思: 多CPU核的操作系统3种处理模式(SMP+AMP+BMP) 鸿蒙实现的是 SMP 的方式 非对称多处理(Asymmetric multiprocessing,AMP)每个CPU内核 运行一个独立的操作系统或同一操作系统的独立实例(instantiation)。 对称多处理(Symmetric multiprocessing,SMP)一个操作系统的实例 可以同时管理所有CPU内核,且应用并不绑定某一个内核。 混合多处理(Bound multiprocessing,BMP)一个操作系统的实例可以 同时管理所有CPU内核,但每个应用被锁定于某个指定的核心。 up(unit processing )的意思,单个CPU,虽然没mp的复杂,但文件也很大 500行汇编,一小节讲不完,需要单独的一篇专讲 reset_vector 这里只列出up情况下的开机代码 reset_vector: @鸿蒙单核cpu 开机代码 /* do some early cpu setup: i/d cache disable, mmu disabled */ mrc p15, 0, r0, c1, c0, 0 bic r0, #(1<<12) bic r0, #(1<<2 | 1<<0) mcr p15, 0, r0, c1, c0, 0 /* r11: delta of physical address and virtual address */ adr r11, pa_va_offset ldr r0, [r11] sub r11, r11, r0 /* if we need to relocate to proper location or not */ adr r4, __exception_handlers /* r4: base of load address */ ldr r5, =SYS_MEM_BASE /* r5: base of physical address */ subs r12, r4, r5 /* r12: delta of load address and physical address */ beq reloc_img_to_bottom_done /* if we load image at the bottom of physical address */ /* we need to relocate image at the bottom of physical address */ ldr r7, =__exception_handlers /* r7: base of linked address (or vm address) */ ldr r6, =__bss_start /* r6: end of linked address (or vm address) */ sub r6, r7 /* r6: delta of linked address (or vm address) */ add r6, r4 /* r6: end of load address */ los_dispatch.S 和 los_hw_exc.S 异常模式处理入口和统一分发现实,之前也有提到过,很复杂,1000多行,后续单独细说实现过程. jmp.S 两个简单的函数longjmp setjmp 的实现,加注解部分请前往 鸿蒙内核源码注解分析 查看 FUNCTION(longjmp) ldmfd r0,{r4-r12} add r0,#(4 * 9) ldr r13,[r0] add r0,#4 ldr r14,[r0] cmp r1,#0 moveq r1,#1 mov r0,r1 mov pc,lr FUNCTION(setjmp) stmea r0,{r4-r12} add r0,#(4 * 9) str r13,[r0] add r0,#4 str r14,[r0] mov r0,#0 mov pc,lr los_hw_runstop.S .global OsSRSaveRegister .global OsSRRestoreRegister 两个函数的汇编现实,有点复杂,后续单独说明. cache.S 这是缓存部分的两个函数实现,此处没有加注解,试着看明白这两个函数的实现.加注解部分请前往 鸿蒙内核源码注解分析 查看 .macro DCACHE_LINE_SIZE, reg, tmp mrc p15, 0, \tmp, c0, c0, 1 lsr \tmp, \tmp, #16 and \tmp, \tmp, #0xf mov \reg, #4 mov \reg, \reg, lsl \tmp .endm FUNCTION(arm_inv_cache_range) push {r2, r3} DCACHE_LINE_SIZE r2, r3 sub r3, r2, #1 tst r0, r3 bic r0, r0, r3 mcrne p15, 0, r0, c7, c14, 1 tst r1, r3 bic r1, r1, r3 mcrne p15, 0, r1, c7, c14, 1 1: mcr p15, 0, r0, c7, c6, 1 add r0, r0, r2 cmp r0, r1 blo 1b dsb pop {r2, r3} mov pc, lr FUNCTION(arm_clean_cache_range) push {r2, r3} DCACHE_LINE_SIZE r2, r3 sub r3, r2, #1 bic r0, r0, r3 1: mcr p15, 0, r0, c7, c10, 1 add r0, r0, r2 cmp r0, r1 blo 1b dsb pop {r2, r3} mov pc, lr 参与贡献 访问注解仓库地址 Fork 本仓库 >> 新建 Feat_xxx 分支 >> 提交代码注解 >> 新建 Pull Request 新建 Issue 喜欢请大方 点赞+关注+收藏 吧 各大站点搜 "鸿蒙内核源码分析" ,快速找到组织. 欢迎转载,请注明出处,公众号转载申请方式: 关注后直接回复您的公众号名称即可. 百万汉字注解 >> 精读内核源码,中文注解分析, 深挖地基工程,大脑永久记忆,四大码仓每日同步更新< gitee | github | csdn | coding > 百篇博客分析 >> 故事说内核,问答式导读,生活式比喻,表格化说明,图形化展示,多站点每日同步更新< oschina | csdn | weharmony >