首页 文章 精选 留言 我的

精选列表

搜索[boot],共8300篇文章
优秀的个人博客,低调大师

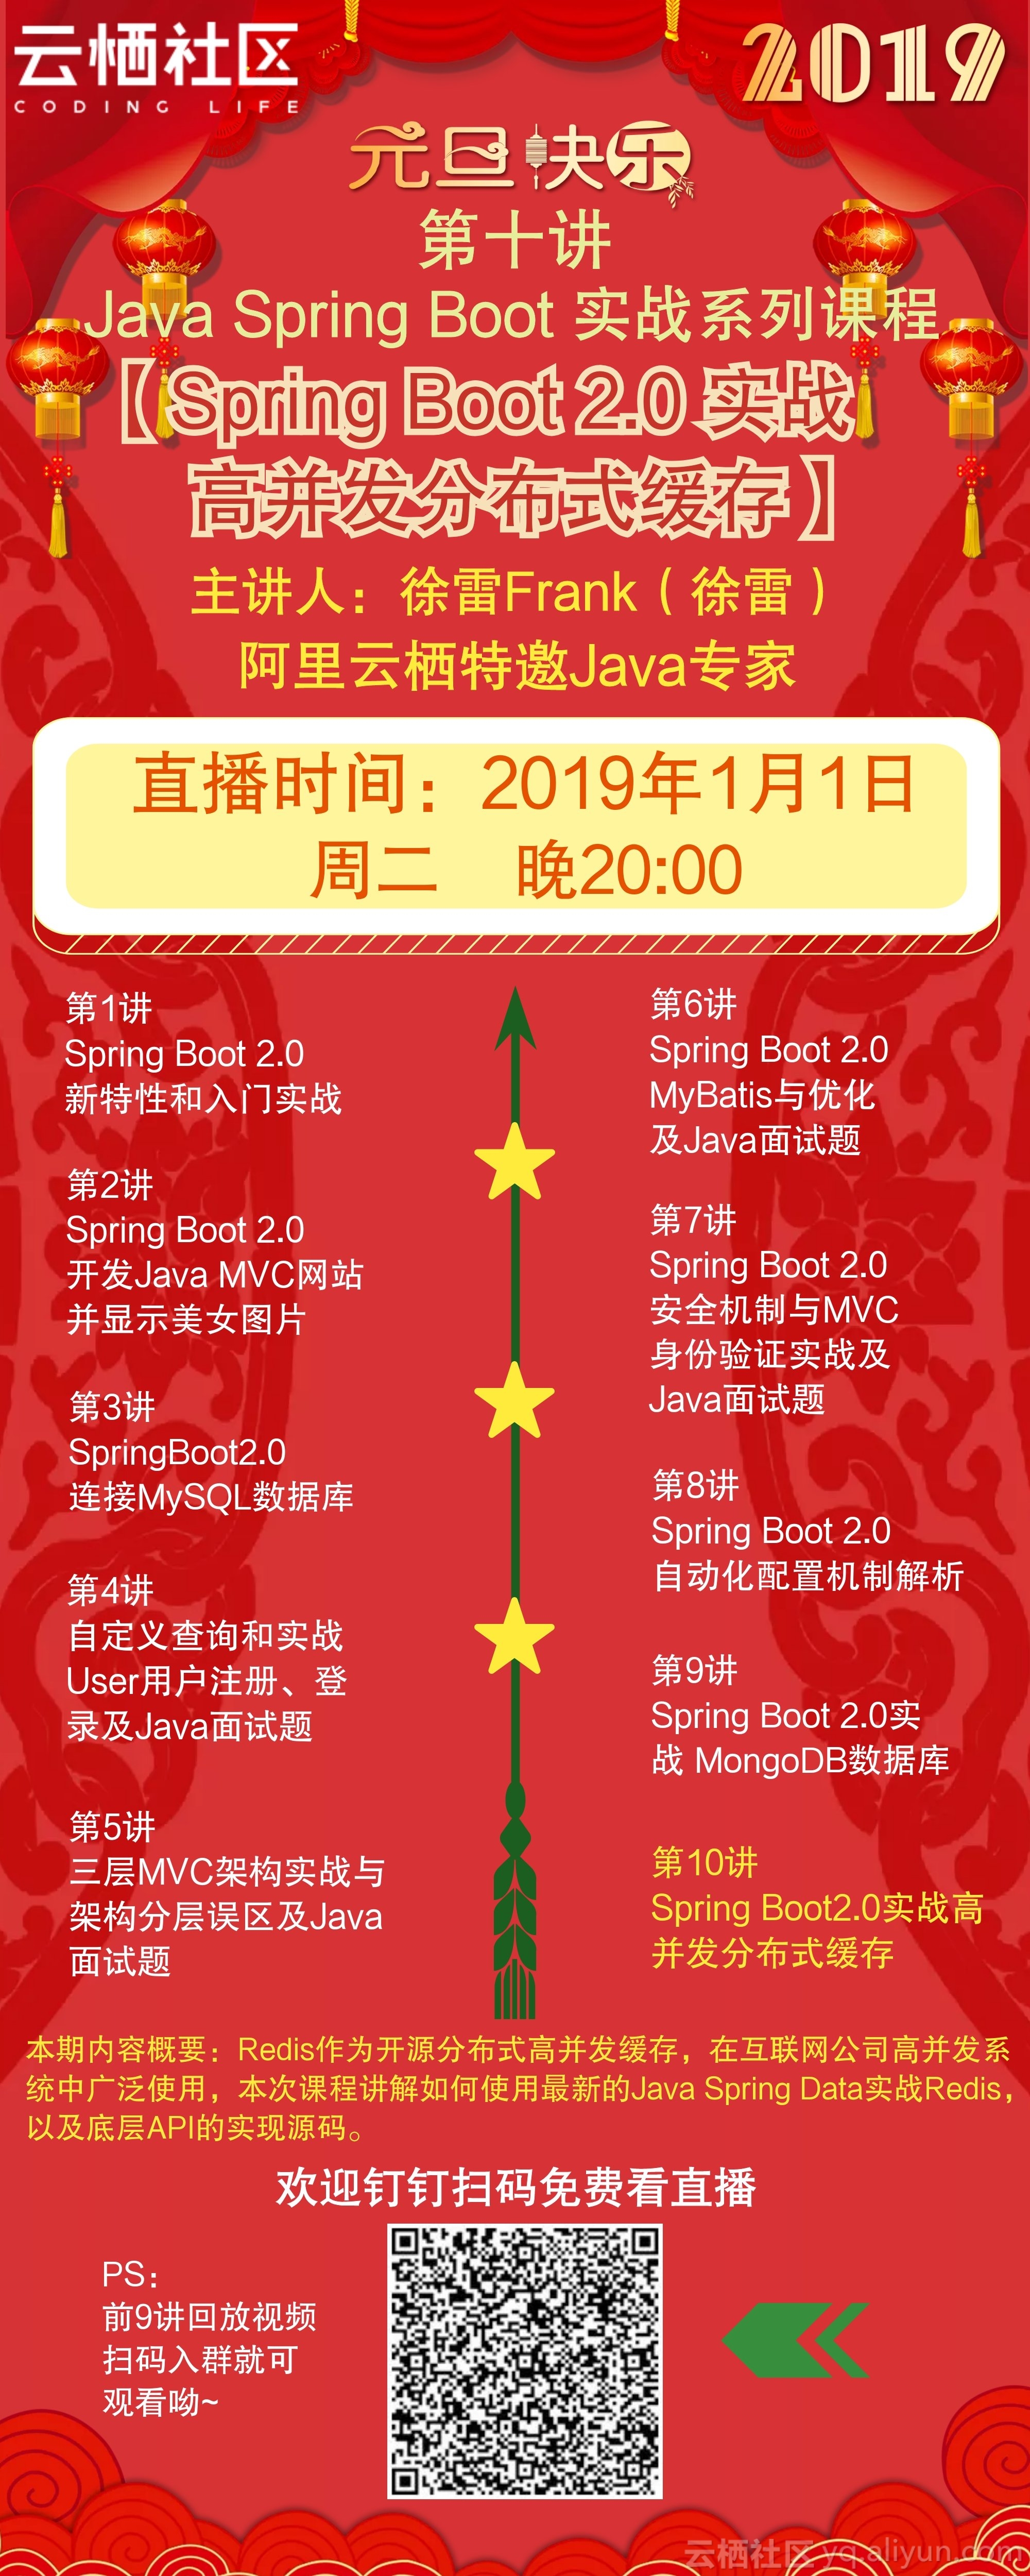
【直播预告】:Java Spring Boot实战系列课程(第十讲):Spring Boot 2.0实战高并发分布式缓存

内容概要:Redis作为开源分布式高并发缓存,在互联网公司高并发系统中广泛使 用,本次课程讲解如何使用最新的Java Spring Data实战Redis,以及底层API的实现源码。主讲人:徐雷(阿里云栖特邀Java专家)直播时间:2019年1月1日 周二 今晚20:00直播地点:【阿里Java技术进阶】钉钉群详情请看下方图片: 想看免费直播的提前扫码入群,前九讲均在群中有回放视频

优秀的个人博客,低调大师

《Spring Boot + JPA 实战》第5招 Repository边界

## 01、痛点 我是老李。前几天,团队里一个新人问我:为什么我们的 Repository 全都继承了 JpaRepository,明明很多方法业务代码根本不该用,但每次 Code Review 都没人提。我让他看一个真实场景:订单服务里,业务代码为了清理测试数据,直接调用 orderRepository.deleteAll(),结果在生产预发环境差点把整张订单表清空。幸亏有备份,不然就是事故。 这不是孤例。很多项目里,CustomerRepository、OrderRepository、ProductRepository,一律 extends JpaRepository,于是 save、saveAll、delete、deleteAll、deleteInBatch、flush 全部暴露给 Service。开发人员写起来确实爽,想要什么方法直接调,代码量少。但时间一长,数据访问边界就被冲垮了:领域聚合原本只允许“新增客户、按邮箱查客户、修改客户信息”,结果现在任何人拿到 CustomerRepository 都能直接物理删除客户,绕过业务上的注销流程。 更要命的是,这种“方便”是温水煮青蛙。今天手滑调用 deleteAll,明天可能就在循环里批量 flush,后天发现有人在事务里直接 deleteInBatch 绕过了一级缓存和审计。表面上看是少写几行代码,实际上是把数据库的万能遥控器塞给了每一个 Service,领域规则形同虚设。 为什么现在要讲这个?因为微服务和 DDD 落地之后,越来越多的团队开始重视聚合和仓储边界,但很多老项目还在无脑继承 JpaRepository。这个问题不解决,后续的架构治理、代码评审、甚至数据安全都是空谈。 ## 02、是什么 要理解 Repository 的价值,先得分清一组接口:Repository、CrudRepository、PagingAndSortingRepository、JpaRepository。 Repository 是 Spring Data 里的标记接口,本身不定义任何方法,只用来标识“这是一个仓储”。它最重要的作用不是提供能力,而是告诉 Spring Data:请为这个接口生成代理,并根据方法名解析查询。 CrudRepository 在 Repository 基础上增加了一组通用的增删改查方法:save、saveAll、findById、existsById、findAll、findAllById、count、delete、deleteById、deleteAll、deleteAllById 等。注意,这里的 delete 是物理删除,直接操作数据库。 PagingAndSortingRepository 继承 CrudRepository,额外提供 findAll(Sort)、findAll(Pageable) 两个分页排序查询方法。它的价值在于标准化分页参数传递,但依然没有脱离“通用数据访问”的范畴。 JpaRepository 继承 PagingAndSortingRepository,又增加了一批 JPA 特有的方法:flush、saveAndFlush、saveAllAndFlush、deleteInBatch、deleteAllInBatch、getReferenceById 等。这些方法越来越贴近 JPA 底层实现,性能优化空间大,但危险系数也更高。比如 deleteInBatch 会一次性生成批量删除 SQL,绕过一级缓存和实体生命周期回调,审计、乐观锁、级联策略都可能失效。 很多开发者没有意识到:你继承 JpaRepository,等于把上述所有方法一次性全部暴露给调用方。哪怕业务上只允许“按主键查询客户”和“保存客户”,但只要接口类型是 JpaRepository,Service 层就可以随时调 deleteAll。这不是能力不足,而是能力过剩。 那 Spring Data 是怎么做到“你声明一个接口,它就能给你实现”的?核心是 Repository Proxy 和 SimpleJpaRepository。 SimpleJpaRepository 是 JpaRepository 接口的默认实现类。它内部持有一个 EntityManager,所有通用方法都是基于 JPA 的 EntityManager 实现的,比如 save 内部调用 persist 或 merge,delete 内部调用 remove,findAll 拼接 JPQL 查询。Spring Data JPA 启动时会扫描所有继承 Repository 的接口,为每个接口生成一个 JDK 动态代理(Repository Proxy)。代理在运行时会根据方法签名路由:如果是 SimpleJpaRepository 里已有的方法,就委托给 SimpleJpaRepository;如果是自定义方法,比如 findByEmail,就根据方法名解析出查询策略,生成对应的 JPA 查询。这就是为什么你只需要写接口,不用写实现类。 关键点来了:代理的生成依据是接口类型和方法签名。你继承 JpaRepository,代理就会把 SimpleJpaRepository 的全部方法接到你的接口上。你只继承 Repository 并声明少数方法,代理就只暴露这些方法。换句话说,接口继承层级直接决定了数据访问契约的宽度。 ## 03、为什么 为什么我们总是不自觉地继承 JpaRepository? 第一,省事。继承 JpaRepository 之后,常用方法开箱即用,不用声明、不用实现。对于一个刚接触 Spring Data 的开发者来说,这几乎是最短路径。 第二,示例诱导。网上大量教程、博客、甚至官方快速入门,开篇就是 interface UserRepository extends JpaRepository。看得多了,大家默认这就是标准写法。 第三,缺乏边界意识。很多团队没有聚合、限界上下文的概念,Repository 被简单理解成“封装数据库操作的工具类”。既然是工具类,方法越多越好,谁也不会嫌功能多。 但问题恰恰出在这里。 Repository 的真正价值,不是让所有 Service 都获得数据库万能遥控器,而是表达一个聚合允许执行的数据访问契约。这句话需要展开。 在领域驱动设计里,聚合是一组强一致性的对象集合,每个聚合有一个根实体。外部对聚合内部对象的访问,必须通过聚合根进行。而 Repository 就是聚合根的持久化入口:它负责把聚合从数据库里取出来,或者把聚合存回去。Repository 的方法集合,应该只包含这个聚合在业务上允许的数据访问操作。 比如 Customer 聚合,业务上只允许创建客户、按邮箱查询客户、修改客户资料、注销客户(软删除)。那么 CustomerRepository 应该只有 save、findById、findByEmail、existsByEmail 这几个方法,绝对不应该出现 deleteAll、deleteInBatch 这种物理清除手段。因为物理删除会绕过注销流程,破坏审计和合规要求。 再比如 Order 聚合,订单创建后不能随意删除,只能取消或关闭。所以 OrderRepository 里不应该有 delete 方法。如果继承了 JpaRepository,Service 层就可能直接调 deleteById 把订单干掉,订单历史、支付记录、库存回滚等关联逻辑全部被绕过。 这就是“无脑继承 JpaRepository 会扩大数据访问边界”的原因:你不是在写一个订单仓储,而是在发一个数据库万能遥控器。每个人都有权限按下“删除全部”的按钮,只是暂时没人按错而已。 为什么现在必须讲?因为系统越复杂,这种边界模糊的代价越高。微服务拆分后,每个服务的数据访问面变窄,但如果没有在代码层面收窄,拆分只是物理隔离,逻辑上依然是一团乱麻。现在正是架构演进的关键窗口,收窄 Repository 边界,成本最低。 ## 04、架构 从架构层面看,收窄 Repository 边界,本质上是把“领域层的数据访问契约”与“基础设施层的实现能力”解耦。 推荐的做法是:仓储接口定义在领域层,只声明聚合需要的方法;实现放在基础设施层,可以利用 Spring Data JPA 的代理机制自动生成。领域层不依赖任何 JPA 接口,只依赖一个最基础的 Repository 标记接口(或者自定义的轻量基础接口)。 具体来说,可以定义一个 BaseRepository extends Repository,然后每个聚合的仓储接口继承这个 BaseRepository,并按需声明方法。 为什么不建议直接继承 JpaRepository?因为 JpaRepository 属于 Spring Data JPA 的实现细节,它把 flush、batch delete 等基础设施能力带进了领域接口。领域层一旦依赖 JpaRepository,就等于依赖了 JPA 的底层 API,不仅扩大了数据访问边界,还增加了领域层与具体 ORM 框架的耦合。 更好的做法是:基础设施层仍然可以使用 SimpleJpaRepository 作为内部实现,但这些实现只存在于运行时,不暴露到接口上。比如你定义一个 CustomerRepository extends Repository { Optional findById(Long id); Customer save(Customer customer); boolean existsByEmail(String email); },Spring Data 在启动时会为这个接口生成代理。代理内部仍然会使用 SimpleJpaRepository 或类似机制完成 save 和 findById,但调用方只能看到这三个方法。 这样架构上的收益是: - 领域层保持纯净,不依赖 JPA; - 数据访问契约清晰,每个聚合能做什么一目了然; - 危险操作被隔离,物理删除、批量更新等只能通过专门的应用服务或内部组件执行; - 测试更容易,因为仓储接口只有几个方法,Mock 成本大幅降低。 有人可能会问:如果某些聚合确实需要批量更新或删除怎么办?答案不是把 deleteInBatch 暴露在仓储接口上,而是单独定义专用的数据操作组件(比如 CustomOrderRepository 的内部接口),或者使用专门的批量处理服务。不要让普通业务代码直接拿到批量删除能力。 ## 05、实战 下面用三个聚合——Customer、Order、Product——演示如何建立窄接口 Repository。 先给一个共同的标记接口,避免每个仓储都直接继承 Spring Data 的 Repository: ```java import org.springframework.data.repository.NoRepositoryBean; import org.springframework.data.repository.Repository; @NoRepositoryBean public interface BaseRepository extends Repository { } ``` 这里使用 @NoRepositoryBean 防止 Spring Data 为这个基础接口生成代理。 Customer 聚合:业务上只允许按 ID 查询、按邮箱查询、保存客户、判断邮箱是否已存在。不提供删除和批量操作。 ```java public interface CustomerRepository extends BaseRepository { Optional findById(Long id); Optional findByEmail(Email email); Customer save(Customer customer); boolean existsByEmail(Email email); } ``` 有了这个接口,Service 层只能做四件事:按 ID 查、按邮箱查、保存、判断邮箱存在。物理删除客户的按钮直接消失,注销流程只能走专门的 cancel 方法。 Order 聚合:订单不允许物理删除,只能保存、按 ID 查、按状态查、统计某状态数量。不提供 delete 相关方法。 ```java public interface OrderRepository extends BaseRepository { Optional findById(Long id); Order save(Order order); List findByStatus(OrderStatus status); long countByStatus(OrderStatus status); } ``` 注意,这里没有 deleteById、deleteAll,也没有 saveAll、flush。如果有人在 Service 里写 orderRepository.deleteById(id),编译时就会报错,因为接口里根本没有这个方法。 Product 聚合:商品可以保存、按 ID 查、按分类分页查询,并需要更新库存。但库存更新必须走明确的领域方法,不能暴露通用 save 让外部随意改库存字段。 ```java public interface ProductRepository extends BaseRepository { Optional findById(Long id); Product save(Product product); Page findByCategory(Category category, Pageable pageable); @Modifying @Query("update Product p set p.stock = p.stock - :quantity where p.id = :id and p.stock >= :quantity") int decreaseStock(@Param("id") Long id, @Param("quantity") int quantity); } ``` decreaseStock 方法用 JPQL 实现扣减库存,并且加了条件 p.stock >= :quantity 防止超卖。这个方法名是业务动作,不是泛化的 update,调用方一看就知道它在做什么。返回 int 表示影响行数,调用方可以判断是否成功。 注意,decreaseStock 使用了 @Modifying,这类方法需要事务支持。但接口本身只暴露了一个明确的扣库存动作,没有暴露任意批量更新能力。 对比一下:如果这三个接口都直接继承 JpaRepository,那么 CustomerRepository 会多出 deleteAll、deleteAllInBatch;OrderRepository 会多出 deleteById、deleteInBatch;ProductRepository 会多出 flush、saveAllAndFlush。任何一个 Service 都能调用这些危险方法。现在经过收窄,业务代码只能做接口里声明的事情,边界一目了然。 有人担心:这样是不是要写很多方法声明?其实不会。一个聚合真正需要的数据访问操作通常不超过 5~8 个,声明成本极低。而且 Spring Data 会根据方法名自动生成查询,不需要实现类。牺牲一点“万能感”,换来的是领域边界的清晰和安全。 ## 06、洞见 DAO 样板代码可以减少,但领域边界不能因此消失。 Spring Data JPA 帮我们省掉了大量 DAO 实现样板,这是好事。但省样板不等于省设计。很多团队把“少写代码”误当成“少做设计”,用 JpaRepository 的万能接口替代了每个聚合应该独立声明的数据访问契约。 更深层的问题是:Repository 不是数据库操作工具,而是领域模型的一部分。它代表聚合根的持久化边界。当你定义一个 OrderRepository 时,你其实是在告诉团队:订单聚合只允许这些数据操作,其他一律不允许。如果接口上挂着 deleteAll,你就是在告诉所有人:订单可以随意物理删除。这与你口头强调“订单不能删除”是矛盾的。 领域边界为什么不能因为 DAO 样板减少而消失?因为代码是执行时的真实约束。口头约定、文档、代码评审都会失效,只有接口签名不会说谎。你在接口上不声明 delete,编译器就是最忠诚的守门人。你在接口上声明了 deleteAll,任何未来的维护者都会认为这是被允许的,并且很可能在某些“特殊场景”里使用它。 收窄 Repository 的另一个好处是:它迫使你思考每个聚合真正需要什么。这个过程本身就是在梳理领域模型。Customer 需要 existsByEmail 吗?如果不需要,就不该有。Order 需要 findAll 吗?如果业务上从不列出所有订单,就不该有。Product 需要批量更新吗?如果只有一个明确的扣库存动作,就不要暴露 saveAll。每一个方法的增加,都应该是业务驱动的,而不是因为 JpaRepository 自带。 这就是“DAO 样板代码可以减少,但领域边界不能因此消失”的真正含义:工具可以帮我们少写重复代码,但不能替我们做设计决策。Repository 的接口设计,就是聚合边界的设计。 ## 07、行动 现在就可以动手检查你的项目。步骤如下: 第一,列出所有 Repository 接口,逐个确认它们继承了什么。凡是直接继承 JpaRepository 的,标记出来。 第二,对每个聚合,列出业务上真正需要的数据访问操作。注意是“业务需要”,不是“可能用得上”。比如 Customer 聚合,业务上需要 findById、findByEmail、save、existsByEmail;如果暂时没有注销物理删除需求,就不需要 delete。 第三,将接口改为继承 BaseRepository(或直接继承 Repository),只保留业务需要的方法。把原来的 JpaRepository 继承去掉。这一步会直接导致所有调用危险方法的代码编译失败,这正是一份现成的整改清单。 第四,优先处理核心聚合,比如订单、支付、账户。这些聚合的误操作风险最高,先收窄它们。 第五,对确实需要批量更新或物理删除的场景,不要重新把 deleteInBatch 加回仓储接口,而是定义专门的应用服务或内部组件,并限制调用范围。例如,只有订单归档任务可以调用批量删除,普通业务服务不能。 第六,把“Repository 接口不得直接继承 JpaRepository”写入团队编码规范,并在 Code Review 中重点检查。可以配合静态检查工具,禁止出现 extends JpaRepository 的声明。 第七,逐步迁移,不要一次性全部改完。可以先从新聚合、新服务开始,老代码慢慢过渡。每次迁移后,运行测试确保行为一致。 最后,定期回顾。每季度检查一次 Repository 接口方法,看有没有新增的越界方法。边界是动态的,需要持续维护。 ## 08、小结 Repository 的价值不是让你少写 DAO,而是让你明确每个聚合的数据访问契约。Repository、CrudRepository、PagingAndSortingRepository、JpaRepository 的能力层层叠加,越往下越危险。无脑继承 JpaRepository,等于把数据库万能遥控器发给所有 Service,数据访问边界被无限扩大。 通过为 Customer、Order、Product 分别建立窄接口 Repository,可以看到:收窄之后,代码不仅没有变复杂,反而更清晰、更安全。delete、batch update 等危险操作被隔离在业务接口之外,领域规则通过编译期约束得到保证。 记住一句话:DAO 样板代码可以减少,但领域边界不能因此消失。工具越强大,我们越需要清醒地定义边界。 ## 09、链接与概念说明 概念说明: - Repository:Spring Data 的标记接口,用于标识仓储,本身不定义数据操作方法。 - CrudRepository:提供标准 CRUD 方法,包括 save、delete、deleteAll 等。 - PagingAndSortingRepository:继承 CrudRepository,增加分页和排序方法。 - JpaRepository:继承 PagingAndSortingRepository,增加 flush、batch delete 等 JPA 特有方法。 - SimpleJpaRepository:JpaRepository 接口的默认实现,基于 EntityManager 完成通用操作。 - Repository Proxy:Spring Data 为仓储接口生成的 JDK 动态代理,根据接口声明路由方法调用。 - 聚合与仓储:领域驱动设计中,仓储是聚合根的持久化入口,方法集合应表达聚合允许的数据访问契约。 推荐进一步阅读:Spring Data JPA 官方文档“Defining Repository Interfaces”部分,以及 Eric Evans《领域驱动设计》中关于 Repository 的章节。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册