AgentOS + Harness + MCP 都火了:测试工程师真正该补的,是这套 Agent 质量工程能力
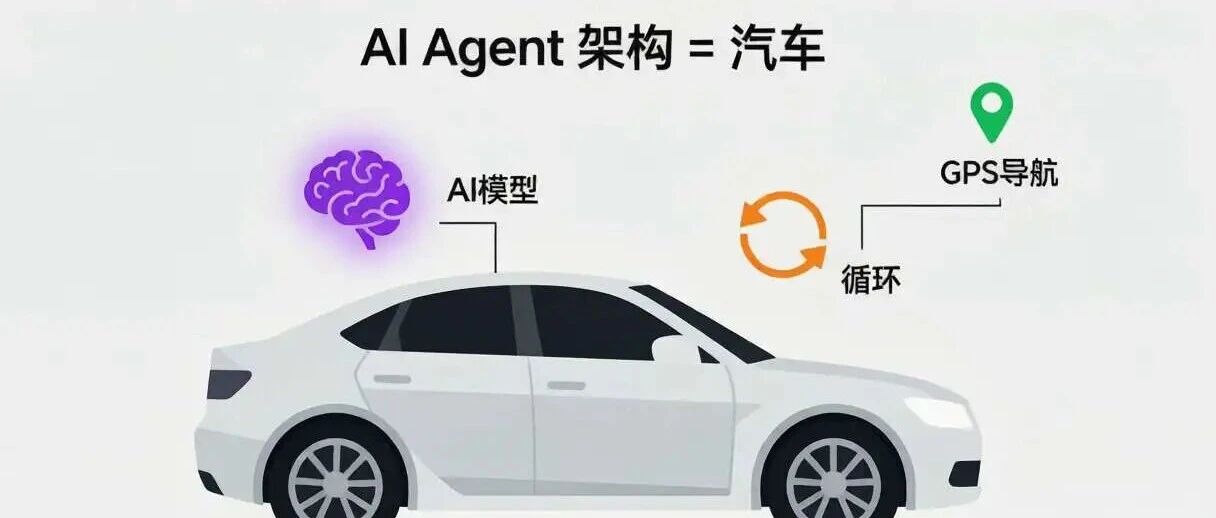
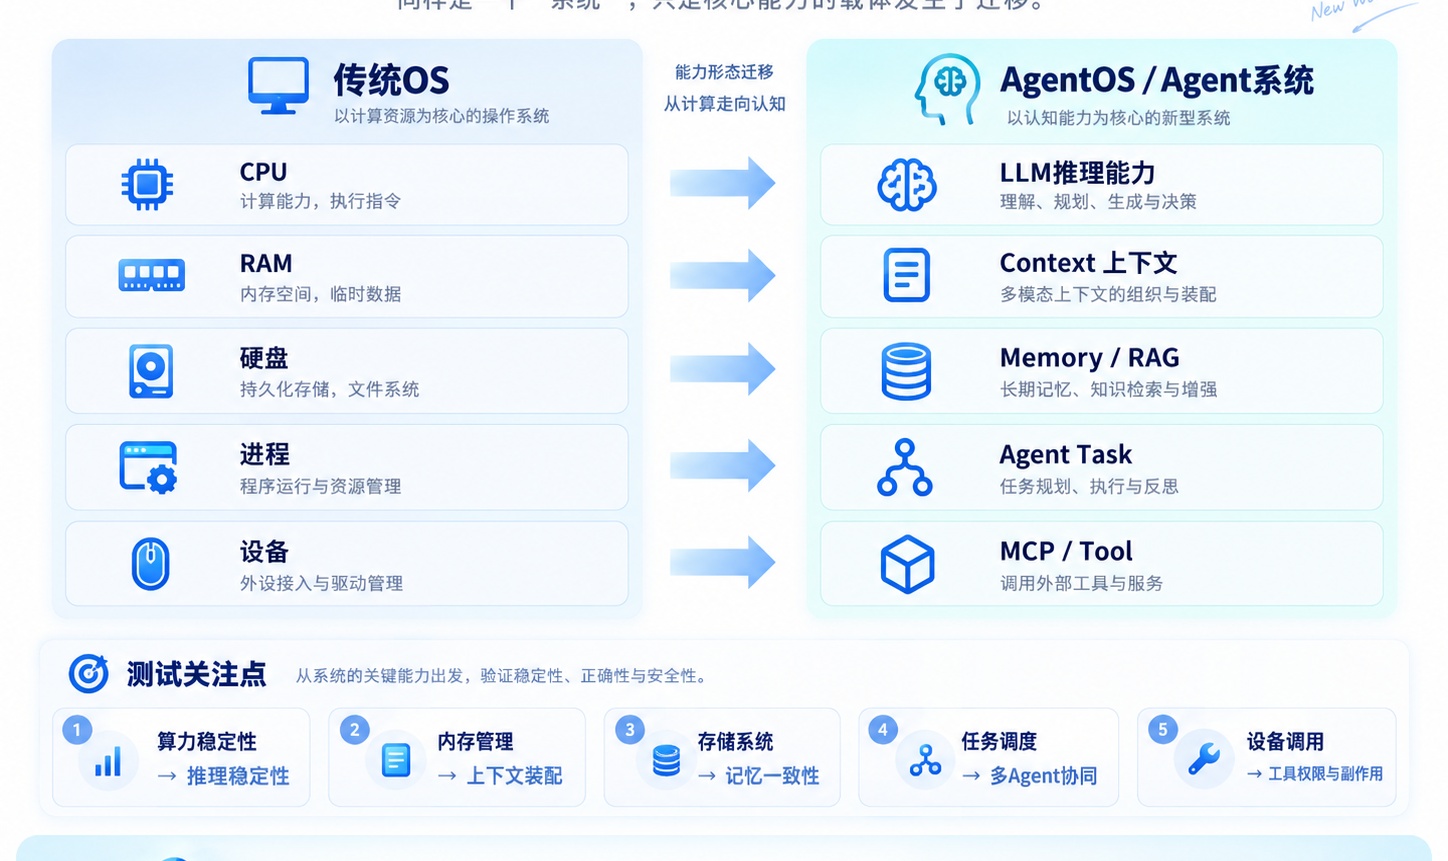
最近如果你关注 AI Agent,会发现行业里的讨论重点正在悄悄变化。 前两年大家最爱聊的是模型本身:哪个模型更聪明,Prompt 怎么写,怎么接 RAG,怎么让模型调几个工具。到了现在,讨论越来越多地开始围绕另一组词展开:Agent Runtime、Memory、Tool、Guardrails、Observability,以及最近频繁出现的 AgentOS。 为什么大家突然开始讲“OS”了? 原因其实并不复杂。 因为越来越多团队发现,让一个 Agent 在 Demo 里跑起来,和让它在真实生产环境里稳定工作,完全不是同一件事。 Demo 里,让 Agent 读个文件、查个数据库、调个接口,甚至生成一段代码,都不算特别难。但真正接进生产环境以后,问题会迅速变得复杂:Agent 调错工具怎么办?上下文太长,关键约束被裁掉怎么办?一次任务连续调用几十次模型,Token 成本失控怎么办?涉及删数据、发版、转账之类的操作,要不要人工审批?任务跑到一半挂了,是从头再来,还是从中间恢复?昨天能跑通的流程,今天为什么突然失败? 这些问题有一个共同点: 它们已经不再只是“模型够不够聪明”的问题,而是“这个系统能不能被稳定管理”的问题。 这正是 AgentOS 这类架构思路开始出现的原因。 而站在测试工程师的角度看,这件事其实更值得关注。因为当 Agent 从 Demo 走向生产,测试对象也会跟着发生变化。 --- # 一、AgentOS到底解决什么问题? 可以先把 AgentOS 理解得简单一点。 它并不是 Windows、Linux 那种传统意义上的操作系统,而更像一套负责管理 AI Agent 运行过程的基础设施。 传统操作系统主要管理 CPU、内存、存储、进程和设备;而到了 Agent 系统里,需要被管理的对象逐渐变成了模型推理能力、上下文窗口、长期记忆、工具调用、任务调度、多 Agent 协作、权限以及 Token 成本。 也就是说,系统复杂度并没有消失,只是管理对象发生了变化。 以前主要管理的是“计算资源”,现在越来越多地是在管理“认知资源”。 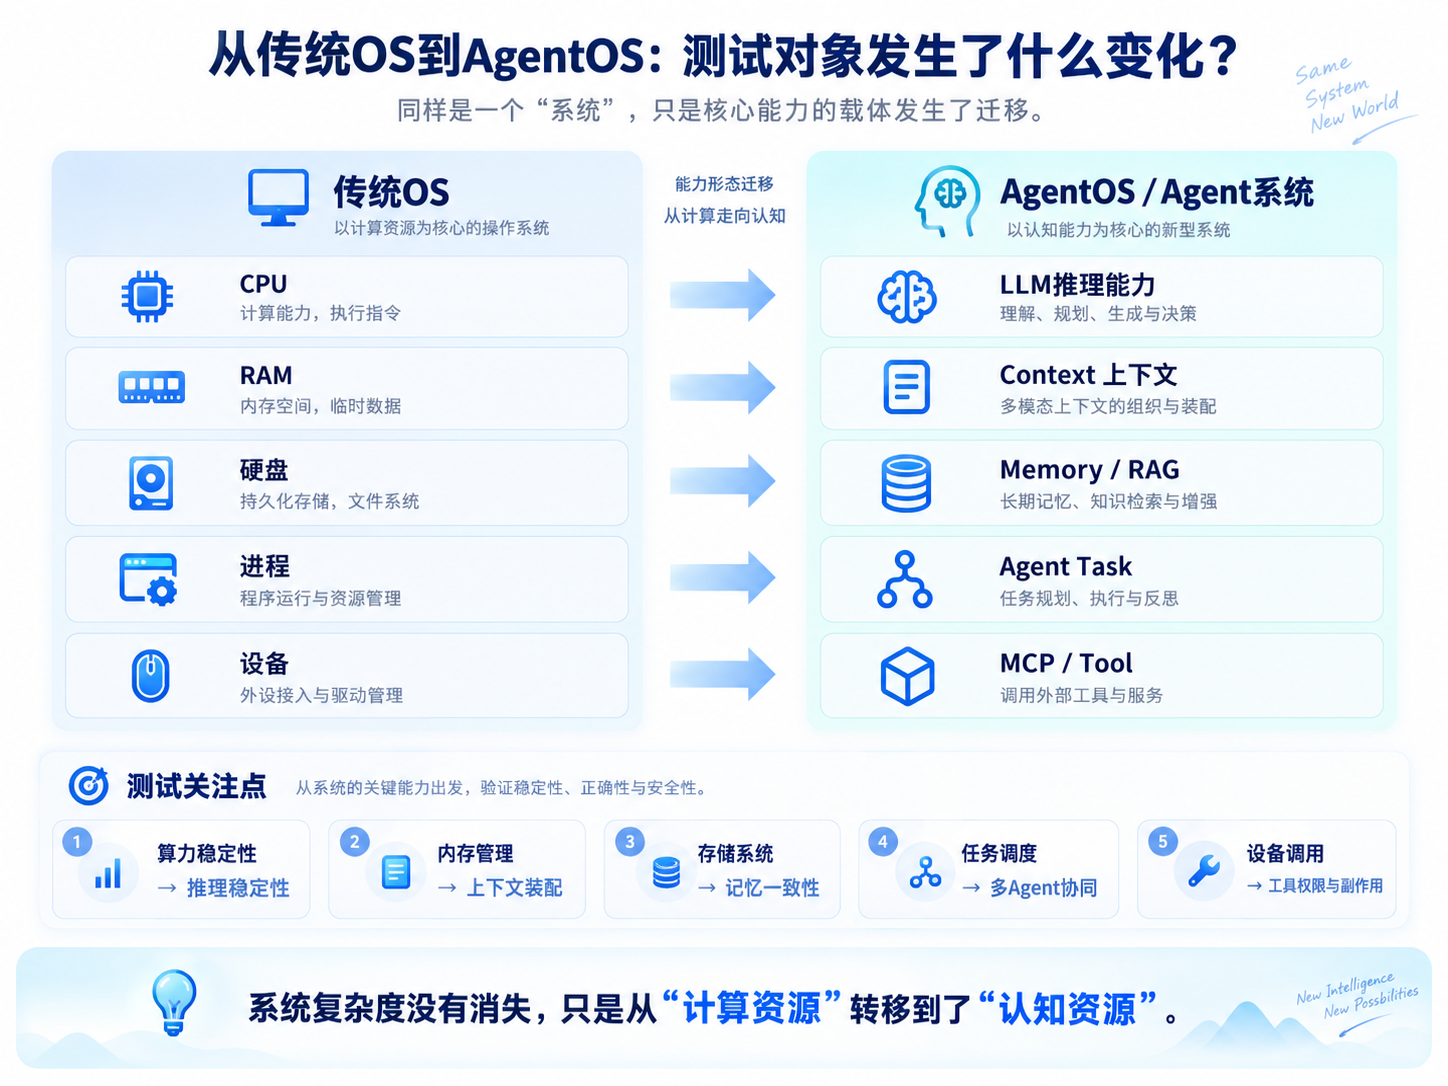 从这个角度理解,AgentOS关注的核心已经不只是“模型能不能回答问题”,而是一个 Agent 能不能长期、安全、稳定、可控地执行任务。 这两件事,看起来只差一步,实际上隔着一整套工程体系。 --- # 二、以后测Agent,已经不能只看“答案对不对” 现在不少团队做大模型测试,方法还比较简单:给模型一个问题,看输出结果对不对。 这种方式放在聊天机器人阶段还能勉强成立,但到了 Agent,就明显不够用了。 假设公司做了一个运维 Agent,用户说:“帮我看看线上订单服务为什么突然变慢了。” 这个 Agent 可能会读取监控、查询日志、执行 SQL、调用 Kubernetes 接口、检查数据库连接,再根据这些结果生成诊断结论。 如果只是聊天机器人,答错一次,最多是一次错误回答。但 Agent 不一样,因为它可能真的会执行动作,甚至修改数据、执行命令、操作生产环境。 所以 Agent 测试关注的不应该只剩“最终答案对不对”,而是整条决策和执行链路是否合理。 可以把传统软件测试和 Agent 测试做一个简单对比: | 传统软件测试更关注 | Agent测试还要额外关注 | | ---------- | ------------------------------- | | 输入能否得到正确输出 | 决策路径是否合理 | | 接口是否返回正确结果 | Agent是否选对工具 | | 参数是否合法 | 模型生成的工具参数是否安全 | | 权限是否越界 | Agent是否执行了越权操作 | | Bug是否可复现 | Trajectory是否能够回放 | | 版本升级后做回归 | Model / Prompt / Skill变化后持续Eval | 这张表背后真正想表达的是: **传统测试没有消失,只是测试对象扩大了。** Agent系统把“软件逻辑”之外,又增加了模型、上下文、记忆、工具和自主决策这些新的变量。 --- # 三、第一个新的测试对象:Context 很多 AI 系统出现错误以后,大家第一反应是“模型又胡说了”。 但真实情况往往没这么简单。 有时候模型本身并没有出太大问题,真正的问题是它压根没有拿到正确的信息。 一个长期运行的 Agent,上下文里可能同时存在系统 Prompt、用户任务、历史对话、长期记忆、RAG 检索结果、工具说明、工具执行结果,甚至其他 Agent 发送过来的消息。 信息越来越多以后,就会遇到一个现实限制:上下文窗口不是无限的。 系统必须决定哪些内容要保留,哪些内容要压缩,哪些信息可以被裁掉,哪些内容需要重新检索。 这也是 AgentOS 体系里“上下文装配”非常关键的原因。每一轮推理之前,系统都需要把历史、记忆、工具和策略重新组合成本轮真正需要的有限上下文,同时还要兼顾 Token 预算、工具暴露范围和提示词注入等风险。 这对测试来说,其实意味着一个新的测试方向: **Context 本身也要被测试。** 例如: * 连续执行很多轮任务以后,关键约束是否还存在? * RAG 召回了一段恶意 Prompt,Agent 会不会被污染? * 上下文接近 Token 上限时,系统优先裁掉了什么? * 长期记忆里存在错误信息,新任务会不会继续复用? * 多个 Agent 并发时,Memory 是否可能发生串扰? 这些问题过去很少被单独拿出来讨论,但到了 Agent 时代,它们会越来越像传统系统里的“内存管理问题”。 只不过这一次,管理的不是 RAM,而是 Context。 --- # 四、第二个新的测试对象:Tool Calling 如果说 Context 决定了 Agent“看到了什么”,那么 Tool Calling 决定的就是它“真正做了什么”。 这也是 Agent 系统里风险非常高的一环。 现在很多 Agent 教程都会演示一件事:给模型注册几个工具,让模型自己判断什么时候调用。 Demo做到这里,通常已经很有成就感了。 但真正上线以后,你还得继续往下问: Agent为什么选这个工具? 参数是谁生成的? 参数有没有校验? 执行失败以后会不会自动重试? 如果重试,操作是不是幂等的? 这个工具能不能回滚? 是不是所有 Agent 都有资格调用? 如果模型调的是查询接口,风险还比较低。但如果它调用的是删除、发版、转账这类动作,情况就完全不同了。 所以成熟 Agent 系统不会把所有 Tool 当成一个级别处理。只读操作、可回滚操作、高风险操作,需要进入完全不同的权限和审批机制。原始材料里也强调了类似的工具分级与审批机制,高风险动作需要进入人工门禁。 对于测试工程师来说,这部分其实一点都不陌生。 因为它和我们过去做的权限测试、接口测试、安全测试、异常测试非常像。 区别在于,以前我们测试的是: “用户有没有权限调用 API。” 以后还得测试: “Agent 有没有资格调用 API,以及它为什么会调用这个 API。” 这一步,测试从“验证结果”,开始进入“验证决策”。 --- # 五、第三个新的测试对象:Trajectory Agent出错以后,还有一个很麻烦的问题: **不知道它到底是从哪一步开始错的。** 传统系统出问题,我们通常会查日志、接口、SQL、调用链,基本还能顺着线索往回找。 但一个 Agent 任务可能经历: 用户输入 → Context装配 → RAG检索 → 模型推理 → Tool A → Tool结果回灌 → 再次推理 → Tool B → Memory更新 → 子Agent执行 → 最终输出。 链路一旦拉长,任何一个环节发生变化,都可能影响最终结果。 所以 Agent 系统越来越强调 Trace、Event、Checkpoint、Replay、Evaluation,本质上就是为了回答两个问题: **刚才到底发生了什么?** **能不能重新还原一遍?** 长任务还需要借助状态持久化、检查点和日志,在任务失败后继续恢复,并帮助定位错误从哪个阶段开始出现。 这也意味着,以后测试一个 Agent,不能只保存 Input 和 Output。 真正有价值的是完整 Trajectory,也就是整个执行轨迹。 这里我建议文章里不再用很多短句,可以直接用一张小流程图或者普通流程表达: **用户请求 → Context → Prompt → Model Response → Tool Call → Tool Result → Memory Update → Next Reasoning → Final Answer** 只要这条链路能够被完整记录,很多 AI Bug 才真正具备“可定位”和“可复现”的可能。 从这个角度看,未来的 AI 测试开发,会越来越像“分布式系统测试 + AI Evaluation”的结合体。 --- # 六、第四个新的测试对象:Agent会不会“越改越差” Agent系统还有一个很特别的问题。 现在越来越多团队开始做自动评测、失败案例收集、Prompt 优化、Skill 调整、Workflow 调整,甚至让 Agent 自动提出改进建议。 听起来像是系统会越来越聪明。 但测试工程师应该马上想到一个问题: **怎么证明它是真的变好了,而不是只在一部分 Case 上变好了?** 比如原来100个Case通过82个,改完Prompt以后变成91个,看起来提升明显。 但与此同时,另外一批边界Case可能从76%的通过率掉到了52%。 这其实就是 AI 时代非常典型的 Regression。 所以 Agent 的持续优化,必须建立持续回归和评测机制。 一个比较典型的闭环可以理解成: Production Trace → 失败案例收集 → Failure Classification → 加入 Eval Dataset → 修改 Prompt / Skill / Workflow → Regression Evaluation → 对比旧版本 → 发布或回滚 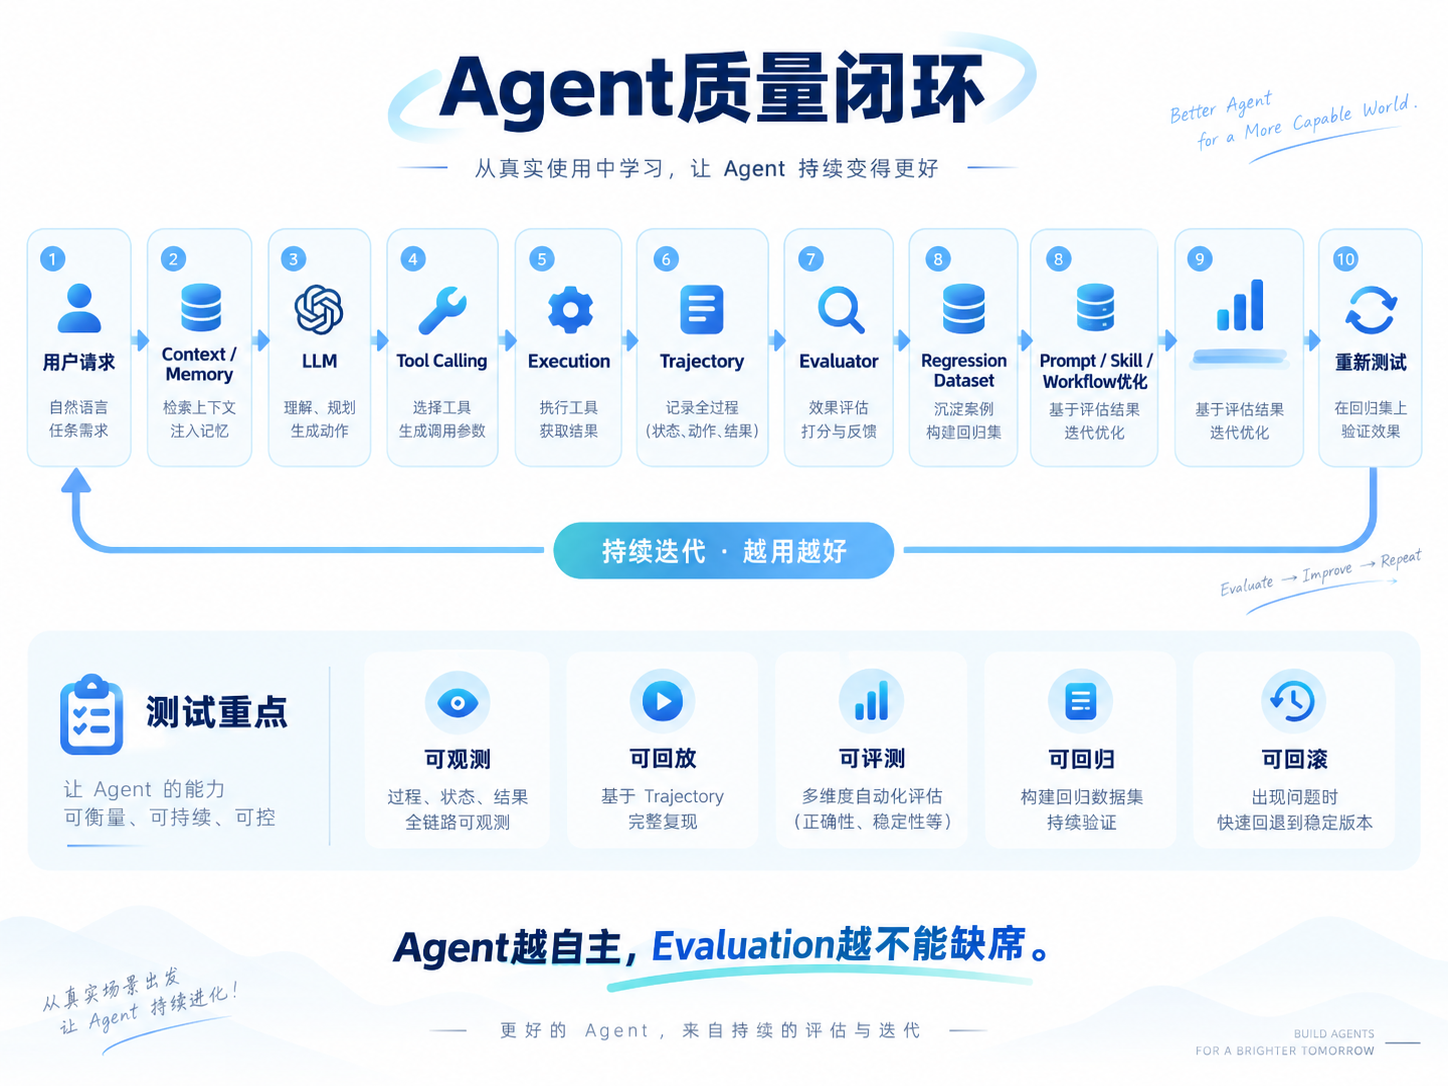 这张图表达的其实就是一件事: Agent不是“测一次就结束”,而是要形成持续评估、持续回归、持续迭代的机制。 原始材料里也把这类自主改进描述为一个受控闭环:运行、记录轨迹、评分和失败归因、生成改进方案、重新验证,不达标就回滚。 你会发现,这套思想其实并没有脱离传统软件工程。 测试、回归、版本对比、发布、回滚,这些东西依然存在。 只是对象换成了 Agent。 --- # 七、AgentOS成熟以后,测试岗位反而会更工程化 AI出现以后,一直有人讨论: “AI都能写代码了,以后还需要测试吗?” 如果把测试理解成点按钮、跑用例、检查结果,这类工作确实会越来越容易被自动化。 但如果未来的系统越来越多是: LLM + Agent + MCP + RAG + Memory + Tool Calling + Multi-Agent 那么系统本身反而变得更复杂了。 以前一个接口,链路可能就是输入、业务逻辑、输出。 现在一个 Agent 请求可能经历: 输入、Context装配、RAG、LLM、Tool、环境执行、Memory、其他Agent、再次推理,最后才生成结果。 链路更长,状态更多,不确定性也更高。 所以测试的重点并不是消失,而是从“确定性软件验证”,慢慢扩展到了“AI系统质量工程”。 这也是为什么我觉得,测试工程师真正需要关注的,不是“会不会让ChatGPT帮我写几个测试用例”,而是能不能建立一套围绕 AI 系统的质量能力。 --- # 八、现在做AI测试开发,真正该补哪些能力? 这里不建议再做“第一层、第二层、第三层”那种连续短段落。 直接看表会更清楚: | 能力方向 | 测试工程师重点关注 | | -------------------- | ----------------------------------- | | Python / API | 自动化、测试工具、数据构造 | | LLM API | Prompt、Token、Structured Output、模型异常 | | RAG | 召回质量、Groundedness、知识污染 | | Agent / Tool Calling | 工具选择、参数、权限、副作用 | | Evaluation | Dataset、Evaluator、Regression、版本对比 | | Observability | Trace、Latency、Token、执行轨迹 | 这张表并不是想表达“以后测试工程师又多了6门课要学”。 真正的变化是: 测试对象已经从传统业务系统,逐渐延伸到了模型、上下文、知识、工具和自主决策链路。 以后一个测试工程师如果只会接口自动化,可能会越来越吃力。 但如果他本身已经具备 Python、API、分布式系统、自动化这些基础,再往 LLM、RAG、Agent、Evaluation 这些方向补,其实反而是有天然优势的。 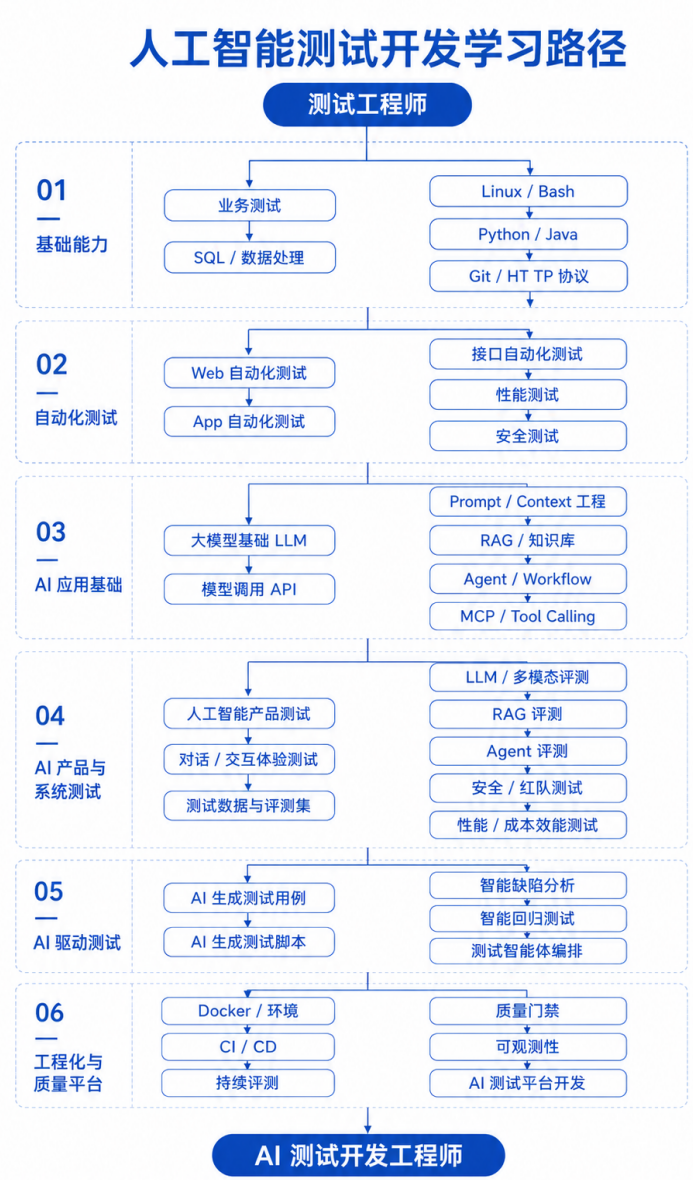 # 九、最后说一个很多测试工程师还没完全意识到的变化 过去软件测试里有一句很经典的话: 测试不能证明系统没有Bug,只能证明Bug存在。 到了 Agent 时代,这句话可能还要再往前走一步。 因为模型版本会更新,Context会变化,RAG 每次召回的内容不一定完全一致,Memory 会不断累积,工具返回值也会变化,Prompt、Skill、Workflow同样会持续迭代。 这意味着,一个今天出现的问题,明天即使输入完全相同的请求,也未必能够沿着完全一样的路径再次出现。 所以真正进入生产环境以后,企业需要解决的,已经不只是“模型够不够聪明”,而是整个 Agent 系统能不能被测试、被观察、被回放、被评估;改完以后能不能做回归,出现问题以后能不能回滚,高风险行为能不能被治理。 这些能力,才是真正把 Agent 从 Demo 和生产环境区分开的东西。 AgentOS 为什么越来越多人开始讨论? 某种意义上,也说明 Agent 行业正在从: “能不能跑起来” 进入: “敢不敢放到生产环境长期跑” 这个阶段。 而一个行业一旦开始认真讨论可靠性、安全、评测、回归、可观测性和失败恢复,测试和质量工程就不再是外围角色。 它会越来越靠近系统核心。 如果你现在正在做功能测试、自动化测试,或者已经开始接触 AI 测试开发,我反而不建议只追某一个框架。 LangChain会变,模型会变,MCP生态会变,甚至 AgentOS 这个词以后是不是还继续流行,也不一定。 但有几件事大概率不会变: 怎么验证 Agent 做对了。 怎么知道 Agent 为什么做错。 怎么保证改完以后没有变得更差。 这些问题,才是测试工程师真正值得长期积累的能力。 ---