首页 文章 精选 留言 我的

精选列表

搜索[智能问数],共10000篇文章
优秀的个人博客,低调大师

四问复合索引,让你的数据查询速度飞起

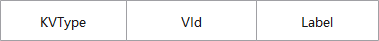
本文分享自华为云社区《华为云GES持久化图数据库复合索引介绍》,作者:村头树下。 本文章主要介绍索引的作用,以及如何实现这种功能,希望可以帮助理解索引的作用以及如何使用索引 1. 什么是复合索引 复合索引是用户手动建立的用于加速查询的一类额外数据。详细参数可以参考规格文档 https://support.huaweicloud.com/api-ges/ges_03_0454.html 2. 复合索引能做什么 复合索引有两类。一是label索引,用于加速label的扫描。二是属性索引,用于加速属性过滤。 这里列举了一些常用接口(语句)与索引的关系 api接口 索引加速方式 summary 扫描label索引,统计各label点边数目 match (n:user) return count(*) 扫描点label索引,统计label为user的点数目 match ()-[r:label]-() return count® 扫描边label索引,统计指定label点数目 match (n:user) return n limit 1 通过点label索引快速寻找label为user的点 match (n:user) where n.age > 10 return n limit 1 仅有label索引时扫描label索引,寻找user的点,然后进行属性过滤。当存在age属性索引时直接使用属性索引定位到目标点 match (n:user) where n.age in [1, 10] return n limit 1 同上 3. 无索引时如何查询 首先了解无索引的情况下,查询的逻辑,才可以理解索引在此基础上做了什么使得查询能够加速。查询逻辑主要与两个方面有关:数据结构,以及数据访问方式,以及查询场景。 a) 原始点结构 持久化版本所有数据都是以KV(键值对)的方式存储在分布式KV数据库中,在没有建立索引的时候,数据库中仅有原始点边KV。以点数据结构为例: Key: Value: key的开始部分为kVType,这是所有数据都会存在的固定前缀,用以区分不同类型的数据。然后是Vid是全局唯一点id。Labelid是标识label的内置编码。Value则是属性的数据。 b) 数据访问方式 所有的图数据的查询最终都是依托于KV数据库的访问。常用的访问KV数据的方式有两种: 精确查询接口,指定完整的key查询value 前缀查询接口,仅指定key的前缀部分,查询所有key的前缀匹配的KV数据对。前缀查相对来说会更加频繁的使用。一个场景可能会需要多次前缀查,而前缀查的次数越多,结果越多,相应的此场景响应速度就越慢。前缀查结果大小直接与前缀的长度有关,前缀越长或者越精确,那么前缀查的结果越少。需要的计算量也越少。相应速度就会越快。 c) 查询场景: 常见查询场景的对应的kv层接口调用: 场景 KV接口及调用次数 查询速度 对应Cypher语句 指定id过滤 前缀查 * 1 快,由于KVType和Vid已知,可以拼出前缀,同时一个id一般不会有太多label,前缀查的结果不会特别多。 match(n) where id(n)=‘0’ return n 指定label过滤 前缀查 n + 过滤 m 慢, 由于不知道Vid,所以只能先拼出只有KVType的前缀,然后前缀查出所有点,再逐个过滤Label,点数据较多时,会有多次前缀查,分批获取再过滤。 match(n:Label) return n 指定label+属性过滤 前缀查 n + 过滤 m 慢, 查询前缀为KvType,遍历全图点,先进行Label过滤,再进行属性过滤 match (n:Label) where n.prop=‘xx’ return n 指定属性过滤 前缀查 n + 过滤 m 非常慢, 查询前缀为KvType,遍历全图点,全部进行属性过滤 match (n) where n.prop=‘xx’ return n 可见,除了指定id的查询,其他所有查询均非常慢。这些查询都需要进行全图点扫描加过滤的方式来获取结果。这与查询出来的结果数目无关。对于较大的图来说,这样的查询代价是十分巨大的。 4. 复合索引如何加速 查询慢的场景无外乎两种场景,label查询或者属性查询。在没有索引的情况下,这两种查询都是建立在全局点扫描的基础上,进行过滤。当有效数据占比越低(例如全局点1w,目标点仅有1个),这种扫描方式就越显得不划算。 对于这两种场景,我们可以建立对应的索引。索引本身也是KV数据。所以其key的布局就决定了其功能。 1.对于label过滤场景,索引的key的格式为: 对于每一个点,都会有一条对应的Label索引KV。 当需要过滤特定Label时,可以拼出KVType+Label的前缀,利用kv数据底座的前缀查接口,就能直接将所有符合条件的点过滤出来。 2. 对于属性过滤的场景,索引的key格式为: 属性索引只针对个别过滤较为频繁的属性而建立。所以也只会对包含此属性的点才会生成属性索引kv。相比于Label索引这里只是多了一个property字段。此字段填的是Vid对应点的属性的值。需要注意的是,property字段并不包含全部的点属性,仅仅是待过滤属性的值。 当进行属性查询时,由于知道目标值(例如where n.prop=1,目标值就是1)。直接拼出KVTypr+Label+Property,调用前缀查询接口。即可查出所有符合条件的点。 当利用索引查出匹配的索引KV之后,就可以很方便的拿到对应的VId。然后根据此Vid,就能快速查询到这个点的属性,或者邻居等信息。 5. 索引建立的若干建议 索引并不是没有代价的,虽然它能加速查询,但是会降低写操作的性能,以及耗费更多的磁盘空间。所以建立索引之前需要考虑是不是必要的。这可以从数据区分度,数据大小,以及访问频率三个方面来评估。 数据区分度:对于属性索引建议在过滤性好的属性上建立。值分布较为分散,比较适合建立。例如身份证号,手机号。但是对于性别这种属性,就不建议为此建立。对于label索引,如果图里面只有一个label,那么建label索引其实也是没有什么必要的,但是大部分情况,label索引都是必要的。 数据大小:这主要是针对属性索引来说的,在已经有Label索引的前提下,如果某个label下的点边数目很少,即使扫描所有label代价也不高,这时候没有必要再为其建立属性索引。 访问频率:这一点很好理解,只对频繁在where子句中出现的属性建立索引。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

方法调用:一看就懂,一问就懵?

方法调用是不是很熟悉?那你真的了解它吗?今天就让我们来盘一下它。 首先大家要明确一个概念,此处的方法调用并不是方法中的代码被执行,而是要确定被调用方法的版本,即最终会调用哪一个方法。 上篇文章中我们了解到,class字节码文件中的方法的调用都只是符号引用,而不是直接引用(方法在实际运行时内存布局中的入口地址),要实现两者的转化,就不得不提到解析和分派了。 解析 我们之前说过在类加载的解析阶段,会将一部分的符号引用转化为直接引用,该解析成立的前提是:方法在程序真正运行之前就已经有一个可确定的调用版本,并且这个方法的调用版本在运行期是不可改变的。我们把这类方法的调用称为解析(Resolution)。 看到这个前提条件,有没有小伙伴联想到对象的多态性? 没错,就是这样,在java中能满足不被重写的方法有静态方法、私有方法(不能被外部访问)、实例构造器和被final修饰的方法,因此它们都适合在类加载阶段进行解析,另外通过this或者super调用的父类方法也是在类加载阶段进行解析的。 指令集 调用不同类型的方法,字节码指令集里设置了不同的指令,在jvm里面提供了5条方法调用字节码指令: invokestatic:调用静态方法,解析阶段确定唯一方法版本 invokespecial:实例构造器init方法、私有及父类方法,解析阶段确定唯一方法版本 invokevirtual:调用所有虚方法 invokeinterface:调用接口方法,在运行时再确定一个实现该接口的对象 invokedynamic:先在运行时动态解析出调用点限定符所引用的方法,然后再执行该方法,在此之前的4条调用指令,分派逻辑是固化在Java虚拟机内部的,而invokedynamic指令的分派逻辑是由用户所设定的引导方法决定的。 invokedynamic指令是Java7中增加的,是为实现动态类型的语言做的一种改进,但是在java7中并没有直接提供生成该指令的方法,需要借助ASM底层字节码工具来产生指令,直到java8的lambda表达式的出现,该指令才有了直接的生成方式。 小知识点:静态类型语言与动态类型语言 它们的区别就在于对类型的检查是在编译期还是在运行期,满足前者就是静态类型语言,反之是动态类型语言。即静态类型语言是判断变量自身的类型信息,动态类型语言是判断变量值的类型信息,变量没有类型信息,变量值才有类型信息,这是动态语言的一个重要特征。 例java类中定义的基本数据类型,在声明时就已经确定了他的具体类型了;而JS中用var来定义类型,值是什么类型就会在调用时使用什么类型。 虚方法与非虚方法 字节码指令集为invokestatic、invokespecial或者是用final修饰的invokevirtual的方法的话,都可以在解析阶段中确定唯一的调用版本,符合这个条件的就是我们上边提到的五类方法。它们在类加载的时候就会把符号引用解析为该方法的直接引用,这些方法可以称为非虚方法。与之相反,不是非虚方法的方法是虚方法。 分派 如果我们在编译期间没有将方法的符号引用转化为直接引用,而是在运行期间根据方法的实际类型绑定相关的方法,我们把这种方法的调用称为分派。其中分派又分为静态分派和动态分派。 静态分派 不知道你对重载了解多少?为了解释静态分派,我们先来个重载的小测试: public class StaticDispatch { static abstract class Human { } static class Man extends Human { } static class Woman extends Human { } public void sayHello(Human guy) { System.out.println("hello,guy!"); } public void sayHello(Man guy) { System.out.println("hello,gentleman!"); } public void sayHello(Woman guy) { System.out.println("hello,lady!"); } public static void main(String[] args) { Human man = new Man(); Human woman = new Woman(); StaticDispatch sr = new StaticDispatch(); sr.sayHello(man); sr.sayHello(woman); } } 请考虑一下输出结果,沉默两分钟。答案是 hello,guy! hello,guy! 你答对了嘛?首先我们来了解两个概念:静态类型和实际类型。拿Human man = new Man();来说Human称为变量的静态类型,而Man我们称为变量的实际类型,区别如下: 静态类型的变化仅仅在使用时才发生,变量本身的静态类型是不会被改变,并且最终静态类型在编译期是可知的。 实际类型的变化是在运行期才知道,编译器在编译程序时并不知道一个对象的具体类型是什么。 此处之所以执行的是Human类型的方法,是因为编译器在重载时,会通过参数的静态类型来作为判定执行方法的依据,而不是使用实际类型。 所有依赖静态类型来定位方法执行版本的分派动作称为静态分派。静态分派的典型应用就是方法重载。静态分派发生在编译阶段,因此确定静态分派的动作实际上不是由虚拟机来执行的,而是由编译器来完成。 动态分派 了解了重载之后再来了解下重写?案例走起: public class DynamicDispatch { static abstract class Human{ protected abstract void sayHello(); } static class Man extends Human{ @Override protected void sayHello() { System.out.println("man say hello!"); } } static class Woman extends Human{ @Override protected void sayHello() { System.out.println("woman say hello!"); } } public static void main(String[] args) { Human man = new Man(); Human woman = new Woman(); man.sayHello(); woman.sayHello(); man = new Woman(); man.sayHello(); } } 请考虑一下输出结果,继续沉默两分钟。答案是: man say hello! woman say hello! woman say hello! 这次相信大家的结果都对了吧?我们先来补充一个知识点: 父类引用指向子类时,如果执行的父类方法在子类中未被重写,则调用自身的方法;如果被子类重写了,则调用子类的方法。如果要使用子类特有的属性和方法,需要向下转型。 根据这个结论我们反向推理一下:man和women是静态类型相同的变量,它们在调用相同的方法sayHello()时返回了不同的结果,并且在变量man的两次调用中执行了不同的方法。导致这个现象的原因很明显,是这两个变量的实际类型不同,Java虚拟机是如何根据实际类型来分派方法执行版本的呢?我们看下字节码文件: man.sayHello(); woman.sayHello(); 我们关注的是以上两行代码,他们对应的分别是17和21行的字节码指令。单从字节码指令角度来看,它俩的指令invokevirtual和常量$Human.sayHello:()V是完全一样的,但是执行的结果确是不同的,所以我们得研究下invokevirtual指令了,操作流程如下: 找到操作数栈顶的第一个元素所指向的对象的实际类型,记作C。 如果在类型C中找到与常量中的描述符和简单名称都相符的方法,则进行访问权限校验,如果通过则返回这个方法的直接引用,查找过程结束;如果不通过,则返回java.lang.IllegalAccessError异常(假如不在一同一个jar包下就会报非法访问异常)。 否则,按照继承关系从下往上依次对C的各个父类进行第2步的搜索和验证过程。 如果始终没有找到合适的方法,则抛出java.lang.AbstractMethodError异常。 由于invokevirtual指令执行的第一步就是在运行期确定接收者的实际类型,所以两次调用中的invokevirtual指令并不是把常量池中方法的符号引用解析到直接引用上就结束了,还会根据接收者的实际类型来选择方法版本(案例中的实际类型为Man和Woman),这个过程就是Java语言中方法重写的本质。 我们把这种在运行期根据实际类型确定方法执行版本的分派过程称为动态分派。 单分派与多分派 方法的接收者与方法的参数统称为方法的宗量,这个定义最早应该来源于《Java与模式》一书。根据分派基于多少种宗量,可以将分派划分为单分派和多分派两种。单分派是根据一个宗量对目标方法进行选择,多分派则是根据多于一个宗量对目标方法进行选择。 举例说明 public class Dispatch{ static class QQ{} static class_360{} public static class Father{ public void hardChoice(QQ arg){ System.out.println("father choose qq"); } public void hardChoice(_360 arg){ System.out.println("father choose 360"); } } public static class Son extends Father{ public void hardChoice(QQ arg){ System.out.println("son choose qq"); } public void hardChoice(_360 arg){ System.out.println("son choose 360"); } } public static void main(String[]args){ Father father=new Father(); Father son=new Son(); father.hardChoice(new_360()); son.hardChoice(new QQ()); } } 请考虑一下输出结果,继续沉默两分钟。答案是: father choose 360 son choose qq 我们来看看编译阶段编译器的选择过程,也就是静态分派的过程。这时选择目标方法的依据有两点:一是静态类型是Father还是Son,二是方法参数是QQ还是360。这次选择结果的最终产物是产生了两条invokevirtual指令,两条指令的参数分别为常量池中指向Father.hardChoice(360)及Father.hardChoice(QQ)方法的符号引用。因为是根据两个宗量进行选择,所以Java语言的静态分派属于多分派类型。 再看看运行阶段虚拟机的选择,也就是动态分派的过程。在执行“son.hardChoice(new QQ())”这句代码时,更准确地说,是在执行这句代码所对应的invokevirtual指令时,由于编译期已经决定目标方法的签名必须为hardChoice(QQ),虚拟机此时不会关心传递过来的参数“QQ”到底是“腾讯QQ”还是“奇瑞QQ”,因为这时参数的静态类型、实际类型都对方法的选择不会构成任何影响,唯一可以影响虚拟机选择的因素只有此方法的接受者的实际类型是Father还是Son。因为只有一个宗量作为选择依据,所以Java语言的动态分派属于单分派类型。 虚方法表 在面向对象的编程中,会很频繁的使用到动态分派,如果在每次动态分派的过程中都要重新在类的方法元数据中搜索合适的目标的话就很可能影响到执行效率。因此,为了提高性能,jvm采用在类的方法区建立一个虚方法表(Vritual Method Table,也称为vtable,与此对应的,在invokeinterface执行时也会用到接口方法表——Inteface Method Table,简称itable)来实现,使用虚方法表索引来代替元数据查找以提高性能。 每一个类中都有一个虚方法表,表中存放着各种方法的实际入口: 如果某个方法在子类中没有被重写,那子类的虚方法表里面的地址入口和父类相同方法的地址入口是一致的,都指向父类的实现入口。 如果子类中重写了这个方法,子类方法表中的地址将会替换为指向子类实现版本的入口地址。 Son重写了来自Father的全部方法,因此Son的方法表没有指向Father类型数据的箭头。但是Son和Father都没有重写来自Object的方法,所以它们的方法表中所有从Object继承来的方法都指向了Object的数据类型。 为了程序实现上的方便,具有相同签名的方法,在父类、子类的虚方法表中都应当具有一样的索引序号,这样当类型变换时,仅需要变更查找的方法表,就可以从不同的虚方法表中按索引转换出所需的入口地址。方法表一般在类加载的连接阶段进行初始化,准备了类的变量初始值后,虚拟机会把该类的方法表也初始化完毕。 绑定机制 解析调用一定是个静态的过程,在编译期间就完全确定,在类装载的解析阶段就会把涉及的符号引用全部转变为可确定的直接引用,不会延迟到运行期再去完成。分派(Dispatch)调用则可能是静态的也可能是动态的。因此我们把 解析 和 静态分派 这俩在编译期间就确定了被调用的方法,且在运行期间不变的调用称之为静态链接,而在运行期才确定下来调用方法的称之为动态链接。 我们把在静态链接过程中的转换成为早期绑定,将动态链接过程中的转换称之为晚期绑定。 看到这,方法的调用你搞懂了吗?如果你还有什么困惑的话,可以关注微信公众号“阿Q说代码”,也可以加阿Q好友qingqing-4132,阿Q期待你的到来!

优秀的个人博客,低调大师

DevOps敏捷60问,一定有你想了解的问题

摘要:问题覆盖了规划设计、开发集成、测试、部署发布、运维监控等DevOps落地实践中的关键疑点与难点。 “DevOps的价值是又快又好地交付软件” ——《凤凰项目》的作者Gene Kim和《持续交付》的作者JezHumble 当前数字化转型的形势下,软件行业面临着巨大的市场机遇,而软件系统复杂度不断增加,跨地域高效协作、多环境部署等问题也逐渐突出,DevOps能帮助企业提升软件研发效率,通过自动化“软件交付”和“架构变更”的流程,来使得构建、测试、发布软件能够更加快捷、频繁和可靠。 基于此,邀请到姚冬、卜汉东两位专家老师,为我们解答涵盖规划设计、开发集成、测试、部署发布、运维监控等DevOps落地实践中的关键疑点与难点的60个问题,希望通过这些问题与解析,帮助更多DevOps实践者解决DevOps落地过程中的疑惑与痛点。 (点击可下载大纲模式的pdf文档方便浏览) 【一、华为端到端DevOps概览】 Q1:华为端到端的DevOps工具链是如何承载敏捷和DevOps相关理念和方法的? A:敏捷和DevOps的理念其实是相通的,DevOps可以视作敏捷的延伸,敏捷思想打破了需求与开发之间的壁垒,DevOps则通过将开发与运维间的壁垒打破,打通软件交付全流程。 华为云DevOps工具链DevCloud包含了从需求管理到代码托管、构建部署、测试等一系列步骤,覆盖软件开发全生命周期。理念往往需要结合实践,我们可以通过DevCloud进行需求管理、每日站会等等许多敏捷实践,通过提交代码可以触发执行流水线,让开发人员专注开发。 Q2:华为云DevCloud与传统基于开源组件拼接的工具链,有什么差异优势? A:传统的由开源组件拼接而成的工具链,大部分都是使用Jira来进行需求管理、用Git来做代码托管、用Jenkins做DevOps开发,因为其组件大部分都是开源的,所以一般费用较低或者免费,其缺点是使用者需要掌握很多工具,而且这些工具并不是在同一个平台上。华为云DevCloud是一站式的软件开发平台,可以做到所有工具都在一个平台上,端到端打通覆盖整个软件开发全生命周期。 用Jenkins的人都知道,在使用之前首先需要搭建一套Jenkins的环境,还需要定制化地做一些脚本、配置等,华为云DevCloud相当于是一个已经封装好了的DevOps开发工具,可以极大减少这些操作。 在华为云DevCloud里,将编译构建、部署任务等做成了原子化的操作,如果我们想要做Tomcat部署,可以直接使用这些模板,只需要对里面的步骤进行细微的调整即可。而且它还使用了可视化视图,操作起来一目了然,学习成本也比较低。华为云DevCloud还支持代码检查、自定义shell、Python、脚本、自定义report展示。 Q3:DevOps /敏捷和SDLC 有何不同? A:DevOps/敏捷和SDLC的角度不一样。SDLC是指系统生命周期,它提出的几种典型生命周期模型包括瀑布模型、快速原型模型、迭代模型。敏捷打破了需求和开发之间的沟通壁垒,DevOps则打通了整个软件交付的全流程。 Q4:DevOps人员在与项目的结合中是否会承担更多开发、测试、运维的工作? A:DevOps不会让人去承担更多开发、测试、运维的工作。DevOps里有一个理念:让开发的人专注于开发、测试的人专注于测试、运维的人专注于运维,所有的工具层面的东西全部交给工具,只要把一切可自动化的东西自动化,所有的人忙自己手头的工作就好了。 Q5:DevOps的反模式有哪些? A:参考《9种DevOps团队结构适用类型与7种反型》 Q6:DevOps适合哪些行业的业务模式?对于非软件行业是否需要调整模式? A:DevOps也好,敏捷也好,其初衷和理念适用于所有行业,但是每个行业在执行和实际落地效果上会有一些折扣,比如持续交付的生产环境、自动化部署、质量管控、自动化流转等过程的实现等。 简单而言,互联网的一些应用,或者说SaaS应用,相对来说更适合DevOps的研发模式。原因是:其业务对软件更新、发布的要求较高;没有太大的历史包袱;相对更容易对标目标受众群体,包括生产环境等。 传统类的业务比较重,比如银行的核心系统,实践起来相对较难,也不是说不能用敏捷或DevOps。比如持续集成、每天多次构建、多次提交代码、自动化测试、可视化等,都可以实行。 对于非软件行业,如硬件、嵌入式、机械类,实践起来也比较难,比如测试自动化等,需要做一些工具或平台的适配,引进插件或工具后,流程也能够跑起来,只是会慢一些。 综上,我认为敏捷和DevOps本身是一条没有终点的路,所有行业都可以到这条路上来,只是走得难易与远近的问题。 Q7:在企业落地DevOps有没有什么套路? A:企业实际情况各不相同,落地DevOps没有统一的套路,但会有一些建议的方式。DevOps偏工程侧,通常建议先把版本管理建立起来,比如Git代码仓、代码分支管理等;接下来需要把流水线构建起来,在上面逐渐进行自动化测试、分层测试等。 Q8:最能有效促进Scrum团队本身的持续改进的是什么实践? A:每个团队遇到的问题都是不一样的,如果一定要找一个通用的答案,首先要保证团队每日站会、评审会议等如质如期进行,以此来保持持续改进。 【二、持续规划与设计】 Q9:基于DevOps实现持续有效规划应该先从哪个层面去入手呢? A:首先需要理解DevOps和敏捷的含义,我们一般说的规划与设计更偏向于敏捷项目管理中涵盖的需求和计划。 狭义的DevOps主要是CI/CD,即持续集成和持续部署,是偏工程侧的。广义的DevOps,即本训练营中讲的DevOps是“端到端的DevOps”,从持续集成/持续部署,向前延伸到业务侧,向后延伸到运维/运营侧,因此也涵盖了前段的需求和设计层面。 回到问题,基于DevOps实现持续有效规划,应该从需求和计划切入,包括整个的市场分析、目标客户群体的用户画像,用户的痛点是什么,针对这些痛点提供什么样的功能,然后到产品应该怎么设计,接下来才真正落到研发这个主体上。 从方法论角度来看,需求和设计层面的方法论包括设计思维、精益创业等。做好需求分析后,就要进行需求拆分,排列优先级,这样就进到敏捷项目计划里,方法论包括看板、Scrum等,大规模团队敏捷框架有SAFe等。 Q10:Scrum,看板和 XP 是敏捷开发的具体方式,老师能否具体讲解一下区别? A:参考文章《DevOps VS 敏捷:傻傻分不清楚》。 Scrum和看板更侧重在团队级敏捷项目管理层面,XP更偏向于工程实践层面。 Scrum和看板两者比较:“标准的”Scrum包括3355的框架;看板源自丰田的精益生产,其背后是精益的思想,通过可视化、限制在制品的数量,快速暴露问题和瓶颈点,集中对最严重的瓶颈点进行修复,然后去寻找下一个瓶颈点。 DevOps的很多理念同样借鉴了精益的思想,个人认为,看板可以应用到很多领域。另外,Scrum和看板在实施或应用时并没有冲突,可以结合起来使用。 Q11:企业组织架构中什么角色或者部分适合推行DevOps落地? A:企业组织架构中一般都没有专门的组织来推行和落地DevOps。DevOps包括两个部分“Dev”和“Ops”,就是指开发部门和运维部门。 几种常见的情况: 如果是由开发部门来发起DevOps落地,就是由开发往运维去推进。我们平时看到比较多的是测试团队或传统的质量管理部门来发起,从开发到测试再往前一步到运维生产环境上去,因为这些部门本身就承担着代码托管、编译构建、自动化测试等职能。 而有的公司会把内部的基础设施、IT支撑、测试等放在数据中心,往前去推把自己变成类似我们讲的DevOps工程师,然后通过自动化工具帮助开发团队进行自动化部署等,这就是从运维侧往前推进DevOps落地。 还有一种情况,就是近年来比较火的云原生,架构师更多考虑采用微服务架构,通过基础设施即代码等方式自动化部署到Docker环境中去,因此引入自动化流水线、Infrastructure as Code(基础设施即代码)、接口测试等实践,这些都属于DevOps的范畴。 还有一些其他的角色,比如敏捷教练、内部的技术教练等,他们本身就是在做研发管理的落地实践,很自然地转化去做DevOps推进。 综上,DevOps的推进和落地不一定非要有一个DevOps工程师或独立的DevOps团队,初期引入DevOps的时候需要有一个团队或角色去承担起这个职责,进行概念和实践的导入和探索,这时更容易把DevOps工程师、DevOps团队建立起来。而后期应该把这些工程师或能力分散到各个团队中去,让DevOps在企业内有更广泛的传播和实践。 Q12:请问在Scrum中,如果没有项目经理,是由TeamLeader还是ScrumMaster协调资源? A:应该由TeamLeader来协调资源,ScrumMaster不是管理角色,而更多的是一个辅助的牧羊犬的角色,在Scrum实施过程中守护团队Scrum流程不受干扰。 Q13:对于非产品形态的项目,Product Owner来自哪个部门更合适?(业务部门/研发部门) A:Product Owner代表客户,一般是哪个部门更接近业务,更了解业务和系统,就由这个部门的人来担任。非产品形态项目的Product Owner,要求既了解业务又懂技术,一般可以由业务分析师、PMO等角色担任。 Q14:实际开发中,客户往往无人承担PO的角色,而是领导来承担,如何破解这个问题? A:这种情况可称为“BDD”,Boss-Driven Development,老板驱动开发。好处是至少有一个人能拍板;坏处是拍板的人,你可能很难去辩驳或谈判,所以最好还是能够把客户侧的人拉进来。当然,如果老板确实对业务非常了解,也非常专业,并且是一个可沟通的人,也是可以的。PO的核心要求是需要有一个人代表客户或业务侧,针对需求或范围做决定,且当团队有问题的时候,可以随时找到这个人。 Q15:影响地图主要应用于哪个环节? A:从HE2E DevOps实施框架图可以看到,在端到端的DevOps实践中,影响地图通常用于需求规划或业务规划阶段,与传统的Scrum流程相比,更偏业务侧。影响地图通过四层结构:why、who、how、what来拆解业务和需求,也可以用于运营或项目冷启动环节。 Q16:请问如果一个大的Story拆分成多个小的Story,甚至再次拆分成孙子辈的Story,如何更好地表示这些关联关系? A:Story拆分有两种方式:一种是从epic(史诗故事)到feature到story的拆分,epic以月为单位,feature以周为单位,story以天为单位;另一种是平级拆分,所有拆分的故事全部叫story,只不过它们之间存在父子关系。不管是三层还是四层,我们只关注父子关系,从一个父story拆分出子story,如果粒度不够小,则以子story为父story继续拆分出它的子story。如果系统需要有层级追溯,可以用树状或脑图等结构来展现。 Q17:学完课程感觉用户故事和项目管理里的工作包很像,二者有个共同的问题,拆解到什么粒度是好的用户故事? A:故事也好,需求也好,只是一个名字,用户故事之所以叫用户故事,有两点表征:1)它是站在用户的角度去看;2)它讲了一个故事、一个场景。好的用户故事遵循INVEST原则,即一个合适的用户故事应该是独立的(Independent)、有价值的(Valuable)、可讨论的(Negotiable)、小的(Small)、可估算的(Estimable)和可测试验证的(Testable)。 Q18:如果采用敏捷开发,最终的用户需求如何呈现给用户?如果是需要存档的用户需求说明书、设计说明书或操作手册之类的文档,适合从DevCloud导出后再修改么?另外如果出现变更,如何确保文档与代码一致? A:如果是需求文档,可以以用户故事的形式存放,华为云DevCloud或者其他工具都提供多元的存储格式,如文本、图片、附件等,华为云DevCloud有一个帮助网站,每一个新上线的功能都会在这里进行同步和更新。 也可以把词条或需求存放到wiki里,并跟前端的需求条目之间建立链接。wiki本身是可以有层级关系的,可以把需求从wiki里导出来形成文档形式,如果做得好,还会有版本计划,比如版本里包括10条需求,可以统一导出一篇需求规格说明文档。 需求和代码之间的同步,可以通过流程等方式去控制,比如发版的检查点,这可能需要以人工方式去做,但也可以通过一些工具来辅助。比如提交代码的时候需要提交注释,可以把这个注释关联到一个工作项上,一个需求可能会修改多个文件里的多段代码,这其实就是一个完整的变更集的概念,这个变更是为了同一个目的,是有相关性的,如果要从代码里去剥离的话,应该会把这一次变更集统一进行剥离。在未来查看代码时,可以进行代码版本比较,看两个版本之间进行了哪些增加/修改、这些变更是为什么目的、其意图是什么。 Q19:对于变化的需求或者新增的需求,是应该放到当前迭代里,还是规划到后面的迭代里,持续规划是指规划过程贯穿整个生命周期么? A:变化或新增的需求都会统一放到一个大的池子里,我们称之为product backlog(产品待办事项列表),这是一个一维的表格,所有需求按照优先级排列。我们要通过判断新进需求的优先级,看它应该放在什么位置。敏捷强调需求是动态变化的,我们会定期对需求列表进行梳理,看是否需要进行优先级排序的调整, 因此变化或新增的需求不会放到当前的迭代里,因为当前迭代是一个固定的时间窗口,且范围相对固定,团队对此进行了承诺。我们会将其放入大的需求池,是在下个迭代还是之后的迭代实现,取决于该需求的优先级。 Q20:对于初学者刚刚接触一个项目,但是项目的需求不明确、结构不成熟,怎么从敏捷入手? A:这里包括两种情况:初学者、项目在初级阶段。如果是初学者,应该通过获取现有资产快速熟悉和上手;如果项目处于初级阶段,需求也不太明确,可以通过敏捷的快速交付、精益的MVP等实践,快速获取反馈,对后续工作进行指导和建议。 Q21:作为整个项目的入口,需求的质量如何把控和评测? A:明确定义需求可以转开发的标准,即DoR。那什么是DoR呢?敏捷开发发展了几个年头之后,人们发现进入迭代开发应当满足一定条件,否则过于模糊的需求会导致迭代的失败,在迭代内花费过多的时间去做需求澄清,因此给进入迭代设立门槛,就是Definition of Ready,简略称之为“DoR”, 最初的Ready是指准备好可以进入迭代开发。 Q22:持续规划与设计有什么度量数据或指标用于衡量团队绩效或用于持续改进?如何衡量持续规划与设计的成熟度? A:度量工具推荐Scum的燃尽图、看板的累积流图。研发效能的核心度量数据指标包括团队速率、Lead time,即需求的平均交付时长。 Q23:敏捷下的组织过程资产(配置、文档等)这些有好的存储方案么? A:理论上文档、资产等都存储在资产库里,常用的知识库或资产平台有Conflunce、IBM的Rational Asset Manager等。资产和知识是不同的概念,现在做资产管理的相对少一些,知识库可以用wiki等平台,便于统一维护更新和协同。 Q24:DevOps 持续规划与设计在DevOps生命周期中是处于开始的时刻,为什么还说代码集成是整个DevOps生命周期的核心呢? A:“代码集成”包括两部分:代码和集成。 整个软件生命周期包括三个版本:需求版本,即发版计划;代码版本;上线发布的二进制包的版本。其中代码版本处于承前启后的中间位置,且是唯一真正有价值的。需求和文档是没有价值的,只有由代码编译成二进制包并部署上线才是有价值的。在代码层面多花一些精力是非常有必要的,所有的研发其实都是在一个代码仓库里进行协同开发,包括代码版本管理、分支管理等模式,因此将代码视为DevOps生命周期的核心也是必然的。 软件研发最痛苦的地方往往是在集成层面,一开始大家各写各的代码,一旦要将这些不同的代码进行集成的时候,问题就出现了。持续集成的概念来源于XP,“如果代码集成是一件非常痛苦的事情,那我们就每天多次地进行。”一切杀不死你的都会让你更强大,持续地进行集成,你会想办法去减少集成的痛苦。就像跑步一样,假如以前的集成是一块大石头,每天多次集成就相当于将这块石头变成一颗颗的小石子,大石头打在身上会非常疼,小石子就好多了。这也是我们为什么要把集成往前提,并且持续去进行的原因,所以在DevOps生命周期中持续集成也非常重要。 【三、持续开发与集成】 Q25:如何加强开发人员对于版本质量的信心? A:加强对版本质量的信心,不只是针对开发人员,对所有人都应该如此。整个DevOps的过程其实就是在保障整体的版本质量,包括静态代码检测、接口API测试等。 另一方面,版本对需求的映射关系或完成程度,应该从业务场景往下去切,看整个需求的匹配程度。 第三点应该是我们通常说的非功能性需求(Non-functional requirements),比如负载、性能、安全、并发支持等,这些要根据我们服务承诺的质量来做相关措施。 Q26:敏捷开发相比传统开发有什么优点? A:我认为最大的优点或特点是敏捷开发更真实,或者说它更愿意承认研发的本质或现状。 传统的研发认为质量受三个因素制约:范围、资源、时间,且默认范围和资源投入是相对确定的,时间是变化的。然而,在真实场景或变化的市场下,时间和资源是固定的,没办法讨价还价,因为市场、业务、客户都不会等你,在这样的前提下,软件的需求或范围实际上是可以商量或讨论的,我们要以可变的范围去赢得市场、时间窗口。 敏捷开发要求我们不断交付高优先级的需求,并获取反馈,不断调整。这是敏捷开发的最大的核心,承认市场是变化莫测的,需求范围是可变的。 Q27:一个产品,既有主线版本,又有很多的行业定制分支(50+),适合什么样的分支策略? A:这种场景在传统的产品里比较常见,个人认为应该考虑的是产品策略而不是分支策略。如果分支非常多,会导致产品碎片化严重。 我们在持续集成、持续交付的时候,推崇主干开发或短的分支,不希望这些分支长期存在,否则在产品进行合并时会非常痛苦,工作量也会随着分支的多少和分支存在的时间呈几何倍数增长,所以不建议用长期存在的分支。 那可以用什么样的方式来解决呢?首先要看整个版本上是否一定要出现这么多定制化的分支,这些分支有没有可能通过配置文件、功能开放等方式处理或实现。举个例子,我们做项目管理的软件,每个客户要求的字段、功能流转的流程都不太一样,如果都通过代码实现,有多少客户就会出现多少个分支,可能都不止50个。 我们是怎么做的呢?针对字段,我可以配置一个界面,里面包括常见属性的字段,这个字段可以是文本类型或下拉框等形式;功能流转的话,新进来一个需求,它的下一个状态是什么、应该触发什么动作、应该是什么样的角色来触发这个动作等这些都是可以进行配置的,这些配置信息存在数据库里,变成用户的配置数据,这样我的主代码主程序是保持不变的,只需要提供一套模型根据数据去驱动适配或实现。这是我们更推崇的方式,可以用来消灭那些分支。 Q28:日常项目开发,在代码分支管理上经常疑惑用什么分支管理策略,比如是选择基于生产分支工作流,还是基于环境等等,在实际实践中,我们应该重点考虑哪些因素?既可以兼顾管理效率,又可以确保代码质量。 A:个人建议采用分支开发主干发布或分支开发分支发布的分支管理策略。基于环境进行分支构建的话,以前我们会有开发库测试库等仓库管理的概念,但现在全部是持续集成、自动化部署,就没必要再基于环境去拉取分支了。 如何保证代码质量,我们在CI/CD流水线、自动化部署和构建的同时需要考虑每一个环境上跑哪些测试,这些测试大部分通过自动化的方式实现,也有少量的是手工进行。 Q29:像华为云这样团队成员能力超强、应用场景以线上服务为主,一般会采用什么样的分支管理模式? A:华为云团队也是采用特性分支的管理模式,同时会做多级流水线触发不同环境的流水线来做相关构建,除了开发环境的流水线以外,还有测试、类生产环境等流水线。 Q30: 要做到主干上的提交始终处于可发布状态,不受隐含的代码冲突、提交的feature只部分完成等因素影响,对开发团队和基础设施有哪些要求? A:首先主干上提交的流程或质量要严格控制,真正达到DoD(Definition of Done)的标准,这里可能需要一些机制人为地进行管控,比如Committer机制等。提交的时候,除了非功能性的要求,比如跑相关的回归测试、代码检视以外,还有很重要的功能性要求,比如对需求的实现程度的检查。另外“基础设施即代码”,还要看持续集成、持续部署、自动化测试能不能快速有效地跑起来,并保持高度一致。 Q31:持续集成的成功因素是什么? A:持续集成主要包括代码仓库、自动构建、自动部署、自动测试四个方面。要求每人每天都要向主干提交代码,触发自动构建和自动部署,在类生产环境进行自动化测试,同时需要团队每个成员确保清楚正在发生的状况,以此来保证持续集成的成功。 Q32:华为云上的CI/CD与K8s上搭的CI/CD有什么区别? A:华为云DevCloud打通了端到端的软件交付全流程,集成了常用的DevOps开发工具,不仅可以完成CI/CD,还可以直接在上面进行项目管理和开发;而K8s只是软件开发中一个单独的工具,没有项目需求管理等功能,需要配合其他工具一起使用才能实现完整的软件开发与交付。 Q33:开发和修复bug的工时如何进行安排呢?之前迭代出来的bug是按照单独工时安排,还是统一安排在开发中? A:主要看发版的标准和要求是什么,通常来说可以带病发版,但如果是非常严重的缺陷,就不能上线,必须先修复这些bug。一般bug会跟需求放在同一个池子里,根据它的优先级和影响程度来进行排序,决定是先修复bug还是先做需求。如果修改bug是为了扫清技术债务,建议在一个迭代里固定一定比例的时间来进行。 Q34:感觉SaltStack和Ansible中哪个是最好的配置管理(CM)工具?为什么? A:两者定位不一样。个人认为Ansible并不是一个标准的配置管理工具,它更多是通过自动化部署的手段去touch环境这一侧,SaltStack相对来说功能性更强一些。 Q35:在代码互评审和评审流程中如何高效的提升代码质量? A:人机结合,将重复性的,比如检查代码风格、命名规则等工作交给工具;人工集中看代码实践的逻辑、对需求的匹配等。将人从重复性的工作中解放出来,节约时间和人力。 华为实行代码审查Committer机制,开发人员提交代码后,会自动拉起自动化代码检查。提交一个Pull Request,工具匹配相关的review进行评审和打分,如果是重要实现还可能会有一个评审会议,然后进入最终Committer决定是否将提交的代码合并到主干上去。 【四、持续测试与反馈】 Q36:“通过持续测试实现快速与高质量“是敏捷测试原则之一,而测试金字塔顶端的一些测试往往依赖许多外部因素,较为脆弱,容易因被测软件之外的因素而失败;且由于这类测试同时测试了软件中的多个模块,定位问题就会更难一些。对于 Flaky tests 怎样处理比较好?删除还是进行标记使其不中断后续的测试且不影响质量门禁? A:Flaky Tests,就是指在被测对象和测试条件都不变的情况下,有时候失败、有时候成功的测试。因此,Flaky Tests实际上就是不稳定的测试,或者随机失败(随机成功)的测试。 测试金字塔之所以是正的三角形,核心理念是越往上,即金字塔顶端的测试,其跨度越大,影响面越大,一旦出现问题,爆炸的半径也会更大,在这个层面做测试投入产出较小,工作量大且很难执行,比如测试故障定位等,而且自动化用例的复用程度或稳定性也较差,维护成本也比较高。当然该做的工作一定要做,但相对而言,建议这个层面的测试数量要适当减少。 相反,越往底层,比如单元测试,爆炸半径相对就小一些,复用度和投入产出比也更高,而且在这个层面发现的bug应该是最多的。建议金字塔底层的测试措施应该相对多做。 中间比如接口测试或跨组件的集成等,如果微服务拆分相对颗粒度小一些,各方面相对就比较好,且接口测试相应的工具也比较多,投入产出比也会越来越大。接口测试也可以多做一些,这样中间层变大,金字塔也会变成橄榄球形。 Q37:构建本地持续测试和云上持续测试的对比难易程度和成本,如何选取? A:本地持续测试和云上持续测试的差异在于:本地需要自行对工具和版本进行维护,云上的环境相对快捷。从成本方面考虑,云上是按需的,性能测试、压力测试等适合在云上进行,因为自己去搭建一套10万/100万并发的环境成本非常高;越往前端的测试频度非常高,适合在本地进行构建。另外还需要综合考虑开发人员的使用习惯、公司对于数据的安全要求等进行选取。 Q38:从传统的瀑布型测试到敏捷测试再到DevOps,三者之间具体有什么区别? A:瀑布型测试是在开发完成交付以后才进行完整的测试,测试主体是测试人员;敏捷测试往前走一步,做大量的持续集成等实践(如果敏捷实践不只是在管理层面的话);DevOps是全流程测试,除了测试左移外,还有测试右移,频繁地持续部署到准生产或生产环境上去跑相关测试,甚至还有现网测试,包括混沌工程、Chaos monkey等,其概念更广。DevOps信奉Resilience(韧性),测试这件事很痛苦,我们要频繁地去做。和反脆弱的概念比较一致,“一切杀不死你的让你更坚强”。 Q39 在测试自动化环节中应该如何简化测试流程又能快速发现业务风险? A:测试流程未必会简化,所谓的简化应该是指人员参与的流程减少,把大量能够让机器完成的工作交给机器、回归测试等实现自动化,将人从枯燥的重复性的测试活动中解放出来,去做一些新型测试的探索。 Q40:SRE和DevOps有什么区别和联系? A:DevOps通常由两种角色去发起,Dev和Ops,即开发和运维。 SRE是Google首先提出的一个概念,Site Reliability Engineer(网站可靠性工程师),从Google运维体系出来的一个角色。 SRE工程师会通过自动化工具帮助开发人员,以运维的角度去参与研发并提供一些支持,包括开发一些自动化部署及运维相关的工具,通过这些工具和流程使能开发人员。 两者比较而言,DevOps概念和范围相对更大一些,SRE则聚焦在开发与运维层面。 Q41:在Scrum中只有 Dev team,没有专门的测试团队。“做测试者胜于做检查者”也要求测试人员不仅能发现问题更要准确定位问题。持续测试向价值流持续交付的两端延伸,要求测试人员不仅要懂业务、懂开发还要懂运维,对测试人员的要求很高。在这种背景下,测试人员该如何进行职业发展规划? A:确实测试人员的焦虑相对更多,因为不管流程也好、角色分工也好,他都处于开发和运维之间的位置,像三明治一样,比较难受。 换个角度来看,测试是承上启下的活动,DevOps或敏捷在开始的时候都会相对顺利一些,短期成效很快,但等真正进入到测试层面,就像进入深水区,推进变得困难,原因可能就是自动化测试没做好。这样看来测试人员或测试活动其实大有可为,我们强调测试应该是一类活动,分配在整个研发生命周期过程中,而不是中间的某个阶段,因此对测试人员的要求当然也会更高。 以往测试人员给人的印象是在研发提交后才参与进来,或者大量通过手工界面的点击去做回归等工作。现在和未来,这类测试人员存在的价值会很低,未来可能会要求测试人员懂业务,从业务的角度设计测试用例;还要懂开发,需要写测试脚本;还要懂运维。其实这些要求对所有的工程师都同样存在,包括开发工程师,要会做架构、做设计、做开发、还可能要自己做测试、部署运维等;运维工程师也是如此,如果转型SRE工程师的话,也要往前段去走。从这点来看,大家都在同一水平线上,所有人都要求往T型人才发展。 综上,测试工程师应该是一个全程的质量保障人员,要从专业测试的视角对研发流程、需求、交付等进行质量控制,还需要引入相关实践、开发工具或做工具集成,去赋能开发和运维。真正好的测试对整个团队的帮助和提升应该是最大的。 Q42:与传统项目比较,在敏捷项目中,测试工作在整个流程中所占的比重是否更少了,频次更高了,这是否意味着人效更高了?在DevOps流程下,产品人员、开发人员、主导测试人员的比例是否有一个新的经验参考? A:与传统项目相比,敏捷项目中,测试工作比重更大、频次更高、人效也会更高,但这个更高不是通过人去堆,而是通过自动化工具或时间来完成。在DevOps流程下,专职的测试人员数量会下降,现在大量的开发测试是由开发人员来做,在华为内部称为开发者测试,强调开发人员自己去做测试,以前开发测试比例差不多是3:1, 甚至1:1,现在可能是5:1或10:1的比例。产品人员跟以往应该没有太大差异,现在强调产品思维、运营思维,业务运营人员的人数会增加。 Q43:小团队(5人,分工:2前端,3后端,没有专业测试人员)需要单独配备测试人员吗,一边开发一边测试,还是每个人对自己代码负责最后一块集中测试。这两种哪种好一些? A:个人认为5人团队没有必要配置专职测试,可以先由开发承担测试,当团队认为需要有一个专业的测试去知道或支持时,再去引入专业测试人员。那端到端的测试谁来做?建议是采用轮岗机制,类似on call,让团队成员轮流去做,这样可以让所有人对完整的测试都有了解和重视。 Q44:未来是否会研测一体化? A:我认为研侧一体化会是一个趋势,开发者测试或开发测试的比例会越来越大,且不断往前端延伸, 社会分工本就是合久必分分久必合,大分工衍生了一些新的概念,专业的人做专业的事,驱使我们更聚焦于自己的业务本质,比如IaaS(基础设施即服务),运维/环境管理、系统管理等会有专业的人去做,可以看看你是否就是这样一个专职的人才;测试也是如此,比如TaaS(Test as a service),也是一个非常专业的领域,要求懂开发、懂业务、懂运维。再有就是看公司的核心业务是什么,很多公司都不是专门做测试、运维或工具的,我们应该专注聚焦于公司主营业务。 【五、持续安全与审计】 Q45:如果组织中缺少专业的安全与审计人员,应该如何去补足这方面的能力? A:有些团队会把这个能力转移给相关的SaaS服务平台或第三方厂商。但平台只能提供问题的展现,实际的安全审计处理还需要专人进行。团队规模小时,可以通过业务上的分割和一些工具手段,尽量减轻相应人员的压力。 Q46:小团队安全管控得太严格了,对开发测试都会造成很多不便,也会影响问题排除追踪,如何合理度量安全管控? A:项目进入正规化流程后会有很多环境:开发环境、测试环境、类生产环境、生产环境等,可以采用多环境不同程度安全管控的策略,比如在进行开发环境测试时安全管控力度可以松一些,类生产环境测试时安全管控严格一些。 【六、持续部署与发布】 Q47:持续部署是不是可以做到热部署,不暂停业务直接通过流水线进行部署、提供用户体验? A:持续部署,每一次变化都是直接部署到生产环境里,但持续交付是有一定选择性的,我们可以选择性地把一些需要的东西部署到生产环境中。如果希望可以做到热更新、热部署,不暂停业务,可以通过持续部署的方式,直接使用流水线来实现。 Q48:K8s和Docker在应用上有什么区别? A:Docker是一种容器技术,在实践中可以直接使用Docker进行镜像构建等操作;K8s是进行集群管理的技术手段,华为云DevCloud的帮助中心有一个凤凰商城的实践案例,和HCIP考试中的实验一样,只是多了CI/CD的环节,在这个环节中就使用了K8s。 Q49:K8S 和 云原生是什么关系? A:云原生是包括微服务、DevOps、容器化、持续交付等理念和方法,K8s只是一个集群管理的工具。 Q50:如果生产环境有等保要求,还有什么办法实现持续部署吗? A:如果生产环境有等保要求的话,不太适合直接做持续部署,这时使用持续交付的方式更好一些,我们可以先决定应该把哪些特性搬到生产环境上去。 Q51:新版程序修改了数据结构,如何进行应用设计或部署方案,以应对可能出现重大问题所需要的版本回退? A:当我们做一些比较大的修改时,一般会先部署到类生产环境上,检视没问题后才会通过灰度的方式同步到生产环境中。 Q52:我们已经在做持续集成了,但持续交付和持续部署应该怎么落地? A:如果已经在做持续集成,且做得比较成熟了的话,再往前落地持续交付和持续部署会相对容易。我们经常说:持续交付只是持续集成往前的一小步,最后一公里或最后一米会比较痛苦。其实更多的痛点不在于技术层面,而是在于流程、制度层面,可能很难打穿部门墙、穿透企业管控类的要求,这些都未必是技术能解决的问题。 【七、持续运维与监控】 Q53:通过自动化的方式实现持续集成和持续交付,中间会不会出现干扰而发生错误? A:一般来说,通过自动化的方式实现持续集成和持续交付后,不是很容易发生错误。错误的出现可能是由于配置问题导致的,在配置相应流水线时没有配置好,比如参数出现问题,版本变得不一致等。除此之外还可能会有一个意外导致的问题,比如网络故障等。 Q54:如果生产环境要求网络隔离,还有什么办法实现持续部署吗? A:如果生产环境要求网络隔离的话,我们的流水线一般会搭建在公司内部,也就是从提交代码到构建部署都会在公司内部实现。这个过程中使用云上自动化产品会少一些,因为目前大部分云上构建的工具都必须访问公网才可以做到流水线的效果。 因此这种环境下,建议在本地搭建自动化构建流水线,或者购买可供私有化部署的工具。也可以在公网进行代码托管和构建,只在部署的时候通过手工部署的方式将软件包放到网络隔离的机器上去。 Q55:Docker与虚拟机有何不同? A:从上图可以用比较清楚的看到Docker和虚拟机的异同。左边的VM是虚拟机使用,container是容器使用,也就是我们说的Docker。两边都有server端和Host OS(虚拟机上的系统)。我们知道每个APP上都有Bin/libs,在Docker容器技术环境下,相同的APP可以共用同一个Bin/libs。大大节省了所占的资源空间。 【八、DevOps实践与转型路径】 Q56:到目前为止,已经学习了很多DevOps的功能,但是有一个困惑,对于使用DevOps是零代码,那么对于专业的开发人员来说,会不会慢慢降低他们的代码开发积极性? A:DevOps提供的零代码是指在整个DevOps工具链中希望是零代码的,通过将一切可自动化的工具自动化,将开发人员从各种维护工作中解放出来,使他们专注于开发。 Q57:在DevOps实践中,环境差异的问题需要在哪个环节就开始着手来注意减少或者避免? A:配置即代码,在开发环节配置差异化的时候把环境差异等都配置进去。 Q58:在DevOps转型过程中,对组织和团队最有挑战的有哪些? A:我认为DevOps转型最难的有两方面:一是如何争取公司高层同意推动DevOps转型;二是如果请了教练/顾问协助DevOps转型,顾问/教练走后,如何继续保持和落地DevOps实践。 Q59:小团队如果想要使用DevOps需要全员学习吗,感觉每个人都学习时间成本挺高的,是否可以专人负责特定阶段? A:团队如果想要进行DevOps转型,需要专门有一个人把这些流程和工具研究明白,或者聘请一位外部DevOps顾问,再由整个专职人员或DevOps顾问在整个团队进行培训和推动。 Q60:四个闭环过程中遇到困难或者难点是否可以列举?有什么避免的方案? A:先回忆一下四个闭环过程: 第一阶段闭环:需求开发测试融合,将产品、研发、测试等角色融合,组建跨职能团队,提升产品交付价值与质量; 第二阶段闭环:开发测试融合,组建研发部门内部的跨职能团队,提升自动化水平,降低修复成本; 第三阶段闭环:研发运营一体化,实施产品自运营、自运维,打破了市场、研发、运维部门之间的壁垒,更多角色融入交付链路,提升业务响应力,建立价值反馈流; 第四阶段闭环:目标是逐步实现所有业务线都以跨职能团队为最小组织单元,实现业务敏捷性,持续提升企业的市场竞争力。 难点包括: 打通需求难。产品侧和研发侧沟通难。在传统瀑布模式下产品和研发的沟通存在很多问题,比如需求沟通不明确等,引入敏捷的计划会议,在计划会议上做需求澄清,可以解决这一难题。 开发测试融合难。在很多公司这是两个团队,还有些公司没有测试的角色,要进行人员和过程的融合比较困难。 研发运营结合难。研发运营一体化,运营部分的内容怎么跟开发结合也是一个难点。 组织结构管理难。整个流程打通了,人员的管理和组织结构的变动方面也可能会存在问题。 以上难点需要根据公司具体情况来实践和探索最佳解决方案。 本文分享自华为云社区《【FAQ】DevOps敏捷8大领域60+常见问题解答》,原文作者:Cynthia成。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

面试必问系列:悲观锁和乐观锁的那些事儿

程序安全 线程安全是程序开发中非常需要我们注意的一环,当程序存在并发的可能时,如果我们不做特殊的处理,很容易就出现数据不一致的情况。 通常情况下,我们可以用加锁的方式来保证线程安全,通过对共享资源 (也就是要读取的数据) 的加上"隔离的锁",使得多个线程执行的时候也不会互相影响,而悲观锁和乐观锁正是并发控制中较为常用的技术手段。 乐观锁和悲观锁 什么是悲观锁?什么是乐观锁?其实从字面上就可以区分出两者的区别,通俗点说, 悲观锁 悲观锁就好像一个有迫害妄想症的患者,总是假设最坏的情况,每次拿数据的时候都以为别人会修改,所以每次拿数据的时候都会上锁,直到整个数据处理过程结束,其他的线程如果要拿数据就必须等当前的锁被释放后才能操作。 使用案例 悲观锁的使用场景并不少见,数据库很多地方就用到了这种锁机制,比如行锁,表锁,读锁,写锁等,都是在做操作之前先上锁,悲观锁的实现往往依靠数据库本身的锁功能实现。Java程序中的Synchronized和ReentrantLock等实现的锁也均为悲观锁。 在数据库中,悲观锁的调用一般是在所要查询的语句后面加上 for update, select * from db_stock where goods_id = 1 for update 当有一个事务调用这条 sql 语句时,会对goods_id = 1 这条记录加锁,其他的事务如果也对这条记录做 for update 的查询的话,那就必须等到该事务执行完后才能查出结果,这种加锁方式能对读和写做出排他的作用,保证了数据只能被当前事务修改。 当然,如果其他事务只是简单的查询而没有用 for update的话,那么查询还是不会受影响的,只是说更新时一样要等待当前事务结束才行。 值得注意的是,MySQL默认使用autocommit模式,也就是说,当你执行一个更新操作后,MySQL会立刻将结果进行提交,就是说,如果我们不仅要读,还要更新数据的话,需要手动控制事务的提交,比如像下面这样: set autocommit=0; //开始事务 begin; //查询出商品id为1的库存表数据 select * from db_stock where goods_id = 1 for update; //减库存 update db_stock set stock_num = stock_num - 1 where goods_id = 1 ; //提交事务 commit; 虽然悲观锁能有效保证数据执行的顺序性和一致性,但在高并发场景下并不适用,试想,如果一个事务用悲观锁对数据加锁之后,其他事务将不能对加锁的数据进行除了查询以外的所有操作,如果该事务执行时间很长,那么其他事务将一直等待,这无疑会降低系统的吞吐量。 这种情况下,我们可以有更好的选择,那就是乐观锁。 乐观锁 乐观锁的思想和悲观锁相反,总是假设最好的情况,认为别人都是友好的,所以每次获取数据的时候不会上锁,但更新数据那一刻会判断数据是否被更新过了,如果数据的值跟自己预期一样的话,那么就可以正常更新数据。 场景 这种思想应用到实际场景的话,可以用版本号机制和CAS算法实现。 CAS CAS是一种无锁的思想,它假设线程对资源的访问是没有冲突的,同时所有的线程执行都不需要等待,可以持续执行。如果遇到冲突的话,就使用一种叫做CAS (比较交换) 的技术来鉴别线程冲突,如果检测到冲突发生,就重试当前操作到没有冲突为止。 原理 CAS的全称是Compare-and-Swap,也就是比较并交换,它包含了三个参数:V,A,B,V表示要读写的内存位置,A表示旧的预期值,B表示新值 具体的机制是,当执行CAS指令的时候,只有当V的值等于预期值A时,才会把V的值改为B,如果V和A不同,有可能是其他的线程修改了,这个时候,执行CAS的线程就会不断的循环重试,直到能成功更新为止。 正是基于这样的原理,CAS即时没有使用锁,也能发现其他线程对当前线程的干扰,从而进行及时的处理。 缺点 CAS算是比较高效的并发控制手段,不会阻塞其他线程。但是,这样的更新方式是存在问题的,看流程就知道了,如果C的结果一直跟预期的结果不一样的话,线程A就会一直不断的循环重试,重试次数太多的话对CPU也是一笔不小的开销。 而且,CAS的操作范围也比较局限,只能保证一个共享变量的原子操作,如果需要一段代码块的原子性的话,就只能通过Synchronized等工具来实现了。 除此之外,CAS机制最大的缺陷就是"ABA"问题。 ABA问题 前面说过,CAS判断变量操作成功的条件是V的值和A是一致的,这个逻辑有个小小的缺陷,就是如果V的值一开始为A,在准备修改为新值前的期间曾经被改成了B,后来又被改回为A,经过两次的线程修改对象的值还是旧值,那么CAS操作就会误任务该变量从来没被修改过,这就是CAS中的“ABA”问题。 看完流程图相信也不用我说太多了吧,线程多发的情况下,这样的问题是非常有可能发生的,那么如何避免ABA问题呢? 加标志位,例如搞个自增的字段,没操作一次就加一,或者是一个时间戳,每次更新比较时间戳的值,这也是数据库版本号更新的思想(下面会说到) 在Java中,自JDK1.5以后就提供了这么一个并发工具类AtomicStampedReference,该工具内部维护了一个内部类,在原有基础上维护了一个对象,及一个int类型的值(可以理解为版本号),在每次进行对比修改时,都会先判断要修改的值,和内存中的值是否相同,以及版本号是否相同,如果全部相等,则以原子方式将该引用和该标志的值设置为给定的更新值。 private static class Pair<T> { final T reference; final int stamp; private Pair(T reference, int stamp) { this.reference = reference; this.stamp = stamp; } static <T> Pair<T> of(T reference, int stamp) { return new Pair<T>(reference, stamp); } } 适用场景 CAS一般适用于读多写少的场景,因为这种情况线程的冲突不会太多,也只有线程冲突不严重的情况下,CAS的线程循环次数才能有效的降低,性能也能更高。 版本号机制 版本号机制是数据库更新操作里非常实用的技巧,其实原理很简单,就是获取数据的时候会拿一个能对应版本的字段,然后更新的时候判断这个字段是否跟之前拿的值是否一致,一致的话证明数据没有被别人更新过,这时就可以正常实现更新操作。 还是上面的那张表为例,我们加上一个版本号字段version,然后每次更新数据的时候就把版本号加1, select goods_id,stock_num,version from db_stock where goods_id = 1 update db_stock set stock_num = stock_num - 1,version = version + 1 where goods_id = 1 and version = #{version} 这样的话,如果有两个事务同时对goods_id = 1这条数据做更新操作的话,一定会有一个事务先执行完成,然后version字段就加1,另一个事务更新的时候发现version已经不是之前获取到的那个值了,就会重新执行查询操作,从而保证了数据的一致性。 这种锁的方式也不会影响吞吐量,毕竟大家都可以同时读和写,但高并发场景下,sql更新报错的可能性会大大增加,这样对业务处理似乎也不友好。 这种情况下,我们可以把锁的粒度缩小,比如说减库存的时候,我们可以这么处理: update db_stock set stock_num = stock_num - 1 where goods_id = 1 and stock_num > 0 这样一来,sql更新冲突的概率会大大降低,而且也不用去单独维护类似version的字段了。 最后 关于悲观锁和乐观锁的例子介绍就到这儿了,当然,本文也只是略微讲解,更多的知识点还要靠大家研究,而且,除了这两种锁,并发控制中还有很多其他的控制手段,像什么Synchronized、ReentrantLock、公平锁,非公平锁之类的都是很常见的并发知识,不管是为了日常开发还是应付面试,掌握这些知识点还是很有必要的,而且,并发编程的知识思想是共通的,知道一块知识点后很容易就能延伸去学习其他的知识点。 拿我自己来说,最近也在认真研究Java并发编程的一些知识点,也因为要写乐观锁的缘故,顺道复习了一下CAS和它的使用案例,从而也了解到了ReentrantLock底层其实就是通过CAS机制来实现锁的,而且还了解了独占锁,共享锁,可重入锁等使用场景,由点到面,也让我知识体系储备更加的丰富,近期也有打算撸几篇关于ReentrantLock知识的文章出来,欢迎大家多来踩踩!

优秀的个人博客,低调大师

面试必问--synchronized实现原理及锁升级过程你懂吗

synchronized实现原理及锁升级过程 前言: synchronized是Java内置的机制,是JVM层面的,而Lock则是接口,是JDK层面的 尽管最初synchronized的性能效率比较差,但是随着版本的升级,synchronized已经变得原来越强大了,本文带大家了解的是synchronized实现原理及锁升级过程,希望可以帮助到大家。 1.用法 synchronized可用来给对象和方法或者代码块加锁,当它锁定一个方法或者一个代码块的时候,同一时刻最多只有一个线程执行这段代码。 synchronized有三种应用方式: 作用于实例方法,当前实例加锁,进入同步代码前要获得当前实例的锁; 作用于静态方法,当前类加锁,进去同步代码前要获得当前类对象的锁; 作用于代码块,对括号里配置的对象加锁。 2.实现原理 2.1 Java对象头 synchronized用的锁存在Java对象头里,Java对象头里的Mark Word默认存储对象的HashCode、分代年龄和锁标记位。在运行期间,Mark Word里存储的数据会随着锁标志位的变化而变化。32位JVM的Mark Word可能变化存储为以下5种数据: 锁一共有四种状态,级别从低到高依次是:无锁状态、偏向锁状态、轻量级锁状态和重量级锁状态,这几个状态随着竞争情况逐渐升级。为了提高获得锁和释放锁的效率,锁可以升级但不能降级,意味着偏向锁升级为轻量级锁后不能降级为偏向锁。 1.偏向锁 当一个线程访问同步块并获取锁时,会在对象头和栈帧的锁记录里存储偏向的线程ID,以后该线程在进入和退出同步块时不需要进行CAS操作来加锁和解锁,只需测试Mark Word里线程ID是否为当前线程。如果测试成功,表示线程已经获得了锁。如果测试失败,则需要判断偏向锁的标识。如果标识被设置为0(表示当前是无锁状态),则使用CAS竞争锁;如果标识设置成1(表示当前是偏向锁状态),则尝试使用CAS将对象头的偏向锁指向当前线程,触发偏向锁的撤销。偏向锁只有在竞争出现才会释放锁。当其他线程尝试竞争偏向锁时,程序到达全局安全点后(没有正在执行的代码),它会查看Java对象头中记录的线程是否存活,如果没有存活,那么锁对象被重置为无锁状态,其它线程可以竞争将其设置为偏向锁;如果存活,那么立刻查找该线程的栈帧信息,如果还是需要继续持有这个锁对象,那么暂停当前线程,撤销偏向锁,升级为轻量级锁,如果线程1不再使用该锁对象,那么将锁对象状态设为无锁状态,重新偏向新的线程。 2.轻量级锁 线程在执行同步块之前,JVM会先在当前线程的栈帧中创建用于存储锁记录的空间,并将对象头的MarkWord复制到锁记录中,即Displaced Mark Word。然后线程会尝试使用CAS将对象头中的Mark Word替换为指向锁记录的指针。如果成功,当前线程获得锁。如果失败,表示其他线程在竞争锁,当前线程使用自旋来获取锁。当自旋次数达到一定次数时,锁就会升级为重量级锁。 轻量级锁解锁时,会使用CAS操作将Displaced Mark Word替换回到对象头,如果成功,表示没有竞争发生。如果失败,表示当前锁存在竞争,锁已经被升级为重量级锁,则会释放锁并唤醒等待的线程。 流程大致如下: 结束: 今天就分享到这里,有不对需要改进的地方还望大佬们指出 喜欢这篇文章的话记得给作者点个关注点个喜欢

优秀的个人博客,低调大师

【干货满满】K8S常见问答50问(持续更新)

1、logtail有开源计划吗https://yq.aliyun.com/ask/4932882、logtail和log-pilot有啥不同?https://yq.aliyun.com/ask/4932933、数以万计的agent如何部署和升级https://yq.aliyun.com/ask/4932894、如果单个agent需要采集的数据过多,是否有优先级控制?比如高优保障采集某一部分日志https://yq.aliyun.com/ask/4932905、如果某台机器资源紧张,agent是否会进行自我资源限制?比如现在采集流量或者现在自身消耗的cpu?https://yq.aliyun.com/ask/4932916、对采集agent进行资源限制有什么好的方法 现在用的是workloadmanagerhttps://yq.al

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册