首页 文章 精选 留言 我的

精选列表

搜索[c 17],共10000篇文章
优秀的个人博客,低调大师

java B2B2C 多级分销多租户电子商城系统-单点登录(SSO)简介

单点登录SSO(Single Sign-On)是身份管理中的一部分。 SSO的一种较为通俗的定义是:SSO是指访问同一服务器不同应用中的受保护资源的同一用户,只需要登录一次,即 通过一个应用中的安全验证后,再访问其他应用中的受保护资源时,不再需要重新登录验证。 目前的企业应用环境中,往往有很多的应用系统,如办公自动化(OA)系统,财务管理系统,档案管理系统,信息查询系统等等。这些应用系统服务于企业的信息 化建设,为企业带来了很好的效益。但是,用户在使用这些应用系统时,并不方便。用户每次使用系统,都必须输入用户名称和用户密码,进行身份验证;而且应用 系统不同,用户账号就不同,用户必须同时牢记多套用户名称和用户密码。特别是对于应用系统数目较多,用户数目也很多的企业,这个问题尤为突出。问题的原因 并不是系统开发出现失误,而是缺少整体规划,缺乏统一的用户登录平台,使用SSO技术可以解决以上这些问题。 一、使用SSO的好处主要有 (1)方便用户 用户使用应用系统时,能够一次登录,多次使用。用户不再需要每次输入用户名称和用户密码,也不需要牢记多套用户名称和用户密码。单点登录平台能够改善用户使用应用系统的体验。 (2)方便管理员 系统管理员只需要维护一套统一的用户账号,方便、简单。相比之下,系统管理员以前需要管理很多套的用户账号。每一个应用系统就有一套用户账号,不仅给管理上带来不方便,而且,也容易出现管理漏洞。 (3)简化应用系统开发 开发新的应用系统时,可以直接使用单点登录平台的用户认证服务,简化开发流程。单点登录平台通过提供统一的认证平台,实现单点登录。因此,应用系统并不需要开发用户认证程序。 二、实现SSO的技术主要有 (1)基于cookies实现,需要注意如下几点:如果是基于两个域名之间传递sessionid的方法可能在windows中成立,在 unix&linux中可能会出现问题;可以基于数据库实现;在安全性方面可能会作更多的考虑。另外,关于跨域问题,虽然cookies本身不跨 域,但可以利用它实现跨域的SSO。 (2)Broker-based(基于经纪人),例如Kerberos等; 这种技术的特点就是,有一个集中的认证和用户帐号管理的服务器。经纪人给被用于进一步请求的电子的身份存取。中央数据库的使用减少了管理的代价,并为认证 提供一个公共和独立的"第三方"。例如Kerberos、Sesame、IBM KryptoKnight(凭证库思想)等。 (3)Agent-based(基于代理) 在这种解决方案中,有一个自动地为不同的应用程序认证用户身份的代理程序。这个代理程序需要设计有不同的功能。比如, 它可以使用口令表或加密密钥来自动地将认证的负担从用户移开。代理被放在服务器上面,在服务器的认证系统和客户端认证方法之间充当一个"翻译"。例如 SSH等。 (4)Token-based,例如SecurID、WebID、现在被广泛使用的口令认证,比如FTP,邮件服务器的登录认证,这是一种简单易用的方式,实现一个口令在多种应用当中使用。 (5)基于网关 Agent and Broker-based,这里不作介绍。 (6)基于安全断言标记语言(SAML)实现,SAML(Security Assertion Markup Language,安全断言标记语言)的出现大大简化了SSO,并被OASIS批准为SSO的执行标准。开源组织OpenSAML 实现了 SAML 规范,可参考http//www.opensaml.org。 三、SUN SSO技术 SUN SSO技术是Sun Java System Access Manager产品中的一个组成部分。 Sun 的新身份管理产品包括Sun Java System Identity Manager、Sun Java System Directory Server Enterprise Edition 和 Sun Java System Access Manager,以上三者为Sun Java Identity Management Suite (身份识别管理套件)的组成部分,它们与Sun Java Application Platform Suite、Sun Java Availability Suite、Sun Java Communications Suite、Sun Java Web Infrastructure Suite组成Java ES。具有革新意义的这一系列产品提供端到端身份管理,同时可与 60 多种第三方资源和技术实现互操作,集成产品可以从SUN公司网站下载,一般以Agent软件方式提供,是业内集成程序最高、最为开放的身份管理解决方案之 一。 在Sun 的新身份管理产品中,Sun Java System Access Manager是基中的一个重要组成部分,Java Access Manager基于J2EE架构,采用标准的API,可扩展性强,具有高可靠性和高可用性,应用是部署在Servlets容器中的,支持分布式,容易部署 且有较低的TCO。通过使用集中验证点、其于角色的访问控制以及 SSO,Sun Java System Access Manager 为所有基于 Web 的应用程序提供了一个可伸缩的安全模型。它简化了信息交换和交易,同时能保护隐私及重要身份信息的安全。 四、CAS 介绍 CAS(Central Authentication Service),是耶鲁大学开发的单点登录系统(SSO,single sign-on),应用广泛,具有独立于平台的,易于理解,支持代理功能。CAS系统在各个大学如耶鲁大学、加州大学、剑桥大学、香港科技大学等得到应 用。 Spring Framework的Acegi安全系统支持CAS,并提供了易于使用的方案。Acegi安全系统,是一个用于Spring Framework的安全框架,能够和目前流行的Web容器无缝集成。它使用了Spring的方式提供了安全和认证安全服务,包括使用Bean Context,拦截器和面向接口的编程方式。因此,Acegi安全系统能够轻松地适用于复杂的安全需求。Acegi安全系统在国内外得到了广泛的应用, 有着良好的社区环境。 CAS 的设计目标 (1)为多个Web应用提供单点登录基础设施,同时可以为非Web应用但拥有Web前端的功能服务提供单点登录的功能; (2)简化应用认证用户身份的流程; (3)将用户身份认证集中于单一的Web应用,让用户简化他们的密码管理,从而提高安全性;而且当应用需要修改身份验证的业务逻辑时,不需要到处修改代码。 CAS 的实现原理 CAS(Central Authentication Server)被设计成一个独立的Web应用。实现原理非常简单。 CAS创建一个位数很长的随机数(ticket)。CAS把这个ticket和成功登录的用户以及用户要访问的service联系起来。例如,如果用户 peon重定向自service S,CAS创建ticket T,这个ticket T允许peon访问service S。这个ticket是个一次性的凭证;它仅仅用于peon和仅仅用于service S,并且只能使用一次,使用之后马上会过期,即ticket通过验证,CAS立即删除该ticket,使它以后不能再使用。这样可以保证其安全性。 关于ST,在取一个ST时,即使用delete Ticket(ticketId)同时将一次性的ST删除;而对于TGT或PT,则通过reset Timer(ticketId)以更新TGT或PT的时间。在CAS服务端返回的ST中只能得出用户名。 另外,CAS3.0版本也已经发布了,现在最新的版本是3.03,希望CAS3.0在向下兼容的同时,更能向我们提供一些新东西。

优秀的个人博客,低调大师

java B2B2C 源码 多级分销Springcloud多租户电子商城系统-KAFKA介绍

Kafka是一个分布式的、可分区的、可复制的消息系统。 它提供了普通消息系统的功能,但具有自己独特的设计。这个独特的设计是什么样的呢? 首先让我们看几个基本的消息系统术语: Kafka将消息以topic为单位进行归纳。 将向Kafka topic发布消息的程序成为producers. 将预订topics并消费消息的程序成为consumer. Kafka以集群的方式运行,可以由一个或多个服务组成,每个服务叫做一个broker. producers通过网络将消息发送到Kafka集群,集群向消费者提供消息,如下图所示: 客户端和服务端通过TCP协议通信。Kafka提供了Java客户端,并且对多种语言都提供了支持。 Topics 和Logs 先来看一下Kafka提供的一个抽象概念:topic. 一个topic是对一组消息的归纳。对每个topic,Kafka 对它的日志进行了分区,如下图所示: 每个分区都由一系列有序的、不可变的消息组成,这些消息被连续的追加到分区中。分区中的每个消息都有一个连续的序列号叫做offset,用来在分区中唯一的标识这个消息。 在一个可配置的时间段内,Kafka集群保留所有发布的消息,不管这些消息有没有被消费。比如,如果消息的保存策略被设置为2天,那么在一个消 息被发布的两天时间内,它都是可以被消费的。之后它将被丢弃以释放空间。Kafka的性能是和数据量无关的常量级的,所以保留太多的数据并不是问题。 实际上每个consumer唯一需要维护的数据是消息在日志中的位置,也就是offset.这个offset有consumer来维护:一般情 况下随着consumer不断的读取消息,这offset的值不断增加,但其实consumer可以以任意的顺序读取消息,比如它可以将offset设置 成为一个旧的值来重读之前的消息。 以上特点的结合,使Kafka consumers非常的轻量级:它们可以在不对集群和其他consumer造成影响的情况下读取消息。你可以使用命令行来"tail"消息而不会对其他正在消费消息的consumer造成影响。 将日志分区可以达到以下目的:首先这使得每个日志的数量不会太大,可以在单个服务上保存。另外每个分区可以单独发布和消费,为并发操作topic提供了一种可能。 分布式 每个分区在Kafka集群的若干服务中都有副本,这样这些持有副本的服务可以共同处理数据和请求,副本数量是可以配置的。副本使Kafka具备了容错能力。 每个分区都由一个服务器作为“leader”,零或若干服务器作为“followers”,leader负责处理消息的读和 写,followers则去复制leader.如果leader down了,followers中的一台则会自动成为leader。集群中的每个服务都会同时扮演两个角色:作为它所持有的一部分分区的leader,同 时作为其他分区的followers,这样集群就会据有较好的负载均衡。 Producers Producer将消息发布到它指定的topic中,并负责决定发布到哪个分区。通常简单的由负载均衡机制随机选择分区,但也可以通过特定的分区函数选择分区。使用的更多的是第二种。 consumer 发布消息通常有两种模式:队列模式和发布-订阅模式。队列模式中,consumers可以同时从服务端读取消息,每个消息只被其中一个consumer读到;发布-订阅模式中消息被广播到所有的consumer中。 Consumers可以加入一个consumer 组,共同竞争一个topic,topic中的消息将被分发到组中的一个成员中。同一组中的consumer可以在不同的程序中,也可以在不同的机器上。如果所有的consumer都在一个组中,这就成为了传统的队列模式,在各consumer中实现负载均衡。 如果所有的consumer都不在不同的组中,这就成为了发布-订阅模式,所有的消息都被分发到所有的consumer中。 更常见的是,每个topic都有若干数量的consumer组,每个组都是一个逻辑上的“订阅者”,为了容错和更好的稳定性,每个组由若干consumer组成。这其实就是一个发布-订阅模式,只不过订阅者是个组而不是单个consumer。 由两个机器组成的集群拥有4个分区 (P0-P3) 2个consumer组. A组有两个consumerB组有4个 相比传统的消息系统,Kafka可以很好的保证有序性。 传统的队列在服务器上保存有序的消息,如果多个consumers同时从这个服务器消费消息,服务器就会以消息存储的顺序向consumer分 发消息。虽然服务器按顺序发布消息,但是消息是被异步的分发到各consumer上,所以当消息到达时可能已经失去了原来的顺序,这意味着并发消费将导致 顺序错乱。为了避免故障,这样的消息系统通常使用“专用consumer”的概念,其实就是只允许一个消费者消费消息,当然这就意味着失去了并发性。 在这方面Kafka做的更好,通过分区的概念,Kafka可以在多个consumer组并发的情况下提供较好的有序性和负载均衡。将每个分区分 只分发给一个consumer组,这样一个分区就只被这个组的一个consumer消费,就可以顺序的消费这个分区的消息。因为有多个分区,依然可以在多 个consumer组之间进行负载均衡。注意consumer组的数量不能多于分区的数量,也就是有多少分区就允许多少并发消费。 Kafka只能保证一个分区之内消息的有序性,在不同的分区之间是不可以的,这已经可以满足大部分应用的需求。如果需要topic中所有消息的有序性,那就只能让这个topic只有一个分区,当然也就只有一个consumer组消费它。

优秀的个人博客,低调大师

java B2B2C springmvc mybatis多租户电子商城系统--Zuul的高可用

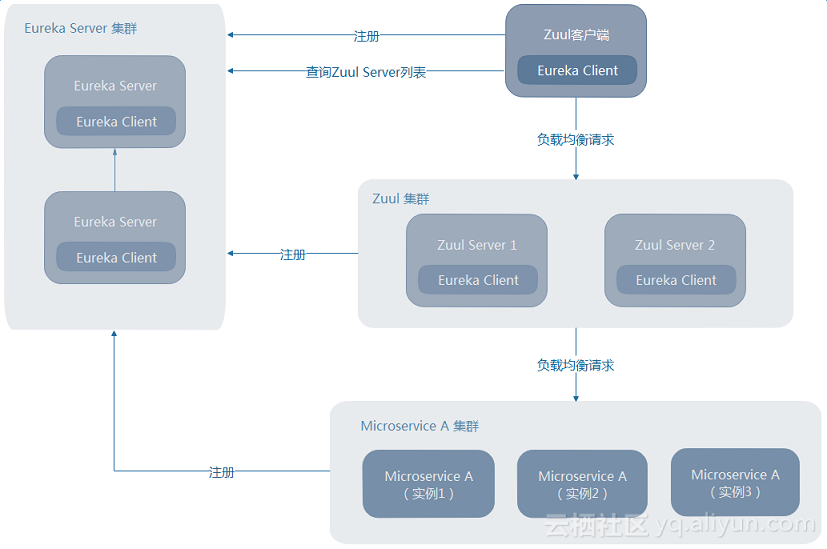
Zuul的高可用非常关键,因为外部请求到后端服务的流量都会经过Zuul。故而在生产环境下一般都需要部署高可用的Zuul以避免单点故障。愿意了解源码的朋友直接求求交流分享技术:二一四七七七五六三三一Zuul客户端也注册到EurekaServer上这种情况下,Zuul的高可用非常简单,只须将多个Zuul节点注册到EurekaServer上,就可实现Zuul的高可用。此时Zuul的高可用与其他微服务的高可用没什么区别。如下图,当Zuul客户端也注册到EurekaServer上时,只须部署多个Zuul节点即可实现其高可用。Zuul客户端会自动从EurekaServer中查询ZuulServer的列表,并使用Ribbon负责均衡地请求Zuul集群。 二Zuul客户端未注册到EurekaServer上现实中,这种场景更多,例如,Zuul客户端是一个手机APP——不可能让所有的手机终端都注册到EurekaServer上。这种情况下,可借助一个额外的负载均衡器来实现Zuul的高可用,例如Nginx、HAProxy、F5等。如下图,Zuul客户端请求发送到负载均衡器,负载均衡器将请求转发到其代理的其中一个Zuul节点。这样,就可以实现Zuul的高可用。 整体代码结构如下:资料和源码来源

优秀的个人博客,低调大师

java B2B2C源码电子商务平台 -----客户端负载均衡策略

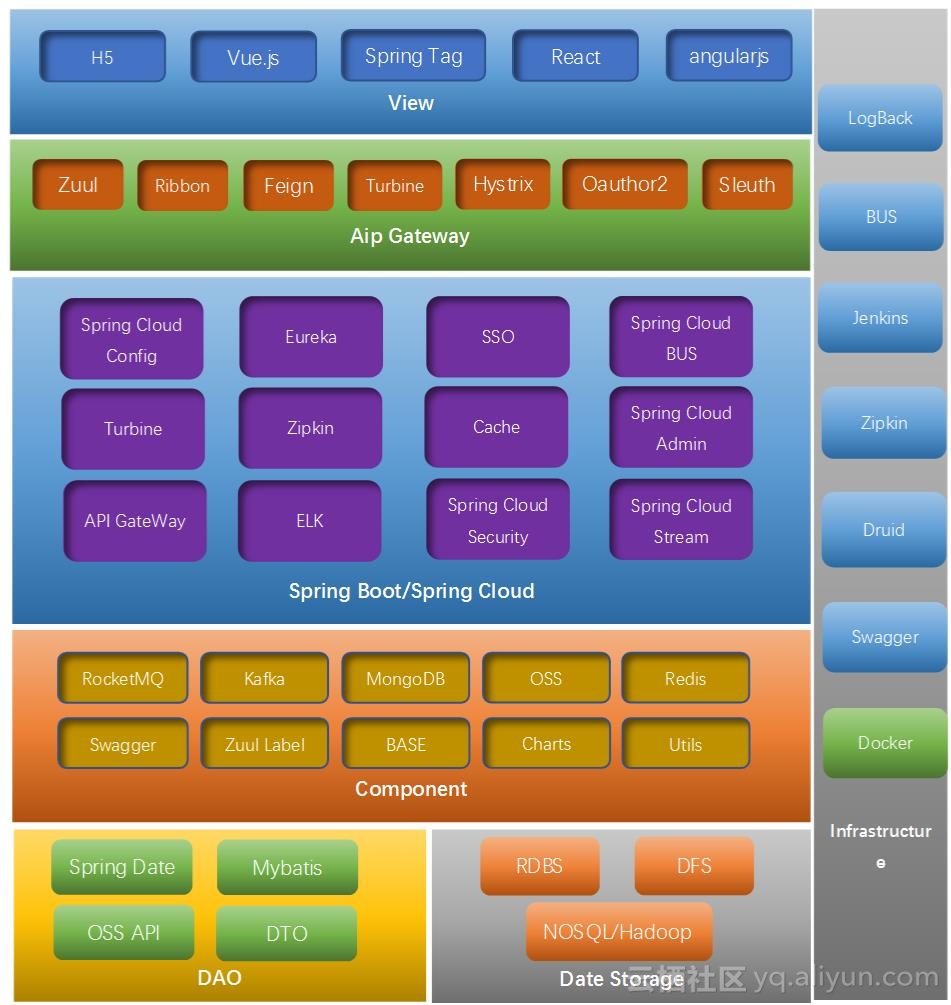
一、负载均衡介绍负载均衡(Load Balance):建立在现有网络结构之上,它提供了一种廉价有效透明的方法扩展网络设备和服务器的带宽、增加吞吐量、加强网络数据处理能力、提高网络的灵活性和可用性。其意思就是分摊到多个操作单元上进行执行,例如Web服务器、FTP服务器、企业关键应用服务器和其它关键任务服务器等,从而共同完成工作任务。愿意了解源码的朋友直接求求交流分享技术:二一四七七七五六三三 1、服务端负载均衡:客户端请求到负载均衡服务器,负载均衡服务器根据自身的算法将该请求转给某台真正提供业务的服务器,该服务器将响应数据给负载均衡服务器,负载均衡服务器最后将数据返回给客服端。(nginx) 2、客服端负载均衡:基于客户端的负载均衡,简单的说就是在客户端程序里面,自己设定一个调度算法,在向服务器发起请求的时候,先执行调度算法计算出向哪台服务器发起请求,然后再发起请求给服务器。 二、负载均衡策略介绍(1) AbstractLoadBalancerRuleAbstractLoadBalancerRule是一个抽象类,里边主要定义了一个ILoadBalancer,定义它的目的主要是辅助负责均衡策略选取合适的服务端实例。 (2) RandomRule该负载均衡策略就是随机选择一个服务实例,看源码我们知道,在RandomRule的无参构造方法中初始化了一个Random对象,然后在它重写的choose方法又调用了choose(ILoadBalancer lb, Object key)这个重载的choose方法,在这个重载的choose方法中,每次利用random对象生成一个不大于服务实例总数的随机数,并将该数作为下标所以获取一个服务实例。 (3) RoundRobinRuleRoundRobinRule这种负载均衡策略叫做线性负载均衡策略,也就是我们在上文所说的BaseLoadBalancer负载均衡器中默认采用的负载均衡策略。这个类的choose(ILoadBalancer lb, Object key)函数整体逻辑是这样的:开启一个计数器count,在while循环中遍历服务清单,获取清单之前先通过incrementAndGetModulo方法获取一个下标,这个下标是一个不断自增长的数先加1然后和服务清单总数取模之后获取到的(所以这个下标从来不会越界),拿着下标再去服务清单列表中取服务,每次循环计数器都会加1,如果连续10次都没有取到服务,则会报一个警告No available alive servers after 10 tries from load balancer: XXXX。 (4) RetryRule 看名字就知道这种负载均衡策略带有重试功能。首先RetryRule中又定义了一个subRule,它的实现类是RoundRobinRule,然后在RetryRule的choose(ILoadBalancer lb, Object key)方法中,每次还是采用RoundRobinRule中的choose规则来选择一个服务实例,如果选到的实例正常就返回,如果选择的服务实例为null或者已经失效,则在失效时间deadline之前不断的进行重试(重试时获取服务的策略还是RoundRobinRule中定义的策略),如果超过了deadline还是没取到则会返回一个null。 (5) WeightedResponseTimeRuleWeightedResponseTimeRule是RoundRobinRule的一个子类,在WeightedResponseTimeRule中对RoundRobinRule的功能进行了扩展,WeightedResponseTimeRule中会根据每一个实例的运行情况来给计算出该实例的一个权重,然后在挑选实例的时候则根据权重进行挑选,这样能够实现更优的实例调用。WeightedResponseTimeRule中有一个名叫DynamicServerWeightTask的定时任务,默认情况下每隔30秒会计算一次各个服务实例的权重,权重的计算规则也很简单,如果一个服务的平均响应时间越短则权重越大,那么该服务实例被选中执行任务的概率也就越大。 (6) ClientConfigEnabledRoundRobinRuleClientConfigEnabledRoundRobinRule选择策略的实现很简单,内部定义了RoundRobinRule,choose方法还是采用了RoundRobinRule的choose方法,所以它的选择策略和RoundRobinRule的选择策略一致,不赘述。 (7) BestAvailableRuleBestAvailableRule继承自ClientConfigEnabledRoundRobinRule,它在ClientConfigEnabledRoundRobinRule的基础上主要增加了根据loadBalancerStats中保存的服务实例的状态信息来过滤掉失效的服务实例的功能,然后顺便找出并发请求最小的服务实例来使用。然而loadBalancerStats有可能为null,如果loadBalancerStats为null,则BestAvailableRule将采用它的父类即ClientConfigEnabledRoundRobinRule的服务选取策略(线性轮询)。 (8) PredicateBasedRulePredicateBasedRule是ClientConfigEnabledRoundRobinRule的一个子类,它先通过内部定义的一个过滤器过滤出一部分服务实例清单,然后再采用线性轮询的方式从过滤出来的结果中选取一个服务实例。 (9) ZoneAvoidanceRuleZoneAvoidanceRule是PredicateBasedRule的一个实现类,只不过这里多一个过滤条件,ZoneAvoidanceRule中的过滤条件是以ZoneAvoidancePredicate为主过滤条件和以AvailabilityPredicate为次过滤条件组成的一个叫做CompositePredicate的组合过滤条件,过滤成功之后,继续采用线性轮询的方式从过滤结果中选择一个出来。使用ZoneAvoidancePredicate和AvailabilityPredicate来判断是否选择某个server,前一个判断判定一个zone的运行性能是否可用,剔除不可用的zone(的所有server),AvailabilityPredicate用于过滤掉连接数过多的Server。 技术架构图如下: 资料和源码来源

优秀的个人博客,低调大师

java B2B2C电子商务平台分析之十------服务网关zuul

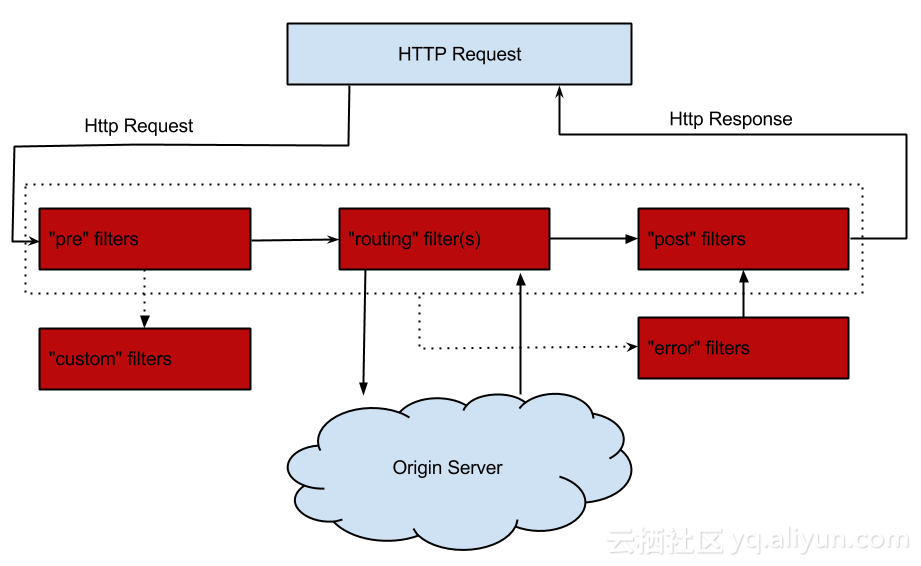
Zuul是什么微服务场景下,每一个微服务对外暴露了一组细粒度的服务。客户端的请求可能会涉及到一串的服务调用,如果将这些微服务都暴露给客户端,那么会增加客户端代码的复杂度。愿意了解源码的朋友直接求求交流分享技术:二一四七七七五六三三 参考GOF设计模式中的Facade模式,将细粒度的服务组合起来提供一个粗粒度的服务,所有请求都导入一个统一的入口,那么整个服务只需要暴露一个api,对外屏蔽了服务端的实现细节,也减少了客户端与服务器的网络调用次数。这就是api gateway。 有了api gateway之后,一些与业务关系并不大的通用处理逻辑可以从api gateway中剥离出来,api gateway仅仅负责服务的编排与结果的组装。 Spring Cloud Netflix的Zuul组件可以做反向代理的功能,通过路由寻址将请求转发到后端的粗粒度服务上,并做一些通用的逻辑处理。 2.Zuul 能做什么Zuul可以通过加载动态过滤机制,从而实现以下各项功能: 验证与安全保障: 识别面向各类资源的验证要求并拒绝那些与要求不符的请求。审查与监控: 在边缘位置追踪有意义数据及统计结果,从而为我们带来准确的生产状态结论。动态路由: 以动态方式根据需要将请求路由至不同后端集群处。压力测试: 逐渐增加指向集群的负载流量,从而计算性能水平。负载分配: 为每一种负载类型分配对应容量,并弃用超出限定值的请求。静态响应处理: 在边缘位置直接建立部分响应,从而避免其流入内部集群。多区域弹性: 跨越AWS区域进行请求路由,旨在实现ELB使用多样化并保证边缘位置与使用者尽可能接近。3.Zuul的核心Filter是Zuul的核心,用来实现对外服务的控制。Filter的生命周期有4个,分别是“PRE”、“ROUTING”、“POST”、“ERROR”,整个生命周期可以用下图来表示。 Zuul大部分功能都是通过过滤器来实现的,这些过滤器类型对应于请求的典型生命周期。 PRE:这种过滤器在请求被路由之前调用。我们可利用这种过滤器实现身份验证、在集群中选择请求的微服务、记录调试信息等。ROUTING:这种过滤器将请求路由到微服务。这种过滤器用于构建发送给微服务的请求,并使用Apache HttpClient或Netfilx Ribbon请求微服务。POST:这种过滤器在路由到微服务以后执行。这种过滤器可用来为响应添加标准的HTTP Header、收集统计信息和指标、将响应从微服务发送给客户端等。ERROR:在其他阶段发生错误时执行该过滤器。 除了默认的过滤器类型,Zuul还允许我们创建自定义的过滤器类型。例如,我们可以定制一种STATIC类型的过滤器,直接在Zuul中生成响应,而不将请求转发到后端的微服务。Zuul中默认实现的Filter4.怎么使用ZuulSpring Cloud Zuul路由是微服务架构的不可或缺的一部分,提供动态路由,监控,弹性,安全等的边缘服务。Zuul是Netflix出品的一个基于JVM路由和服务端的负载均衡器。 下面我们通过代码来了解Zuul是如何工作的 1.简单使用 1、添加依赖 <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-zuul</artifactId> </dependency> 引入spring-cloud-starter-zuul包 2、配置文件 spring.application.name=gateway-service-zuul server.port=8888 #这里的配置表示,访问/it/** 直接重定向到http://www.ityouknow.com/** zuul.routes.baidu.path=/it/** zuul.routes.baidu.url=http://www.ityouknow.com/ 3、启动类 @SpringBootApplication @EnableZuulProxy public class GatewayServiceZuulApplication { public static void main(String[] args) { SpringApplication.run(GatewayServiceZuulApplication.class, args); } } 启动类添加@EnableZuulProxy,支持网关路由。 史上最简单的zuul案例就配置完了。 整体代码结构如下: 资料和源码来源

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册
修改密码
忘记密码