首页 文章 精选 留言 我的

精选列表

搜索[开发者预览],共10000篇文章
优秀的个人博客,低调大师

app支付集成开发者指南

鉴于很多对接app支付的童鞋经常出现app支付系统繁忙,ali40247,订单信息异常在等等的错误,其实那些错误都是大同小异的,无非就是没权限,密钥不对,参数传值错误,请求信息拼接有问题等等,所以这边写app支付开发指南分享帖,希望能够帮到大家!!! 一、文档地址 app支付官方文档地址:[url]https://docs.open.alipay.com/204[/url] 二、开发前准备工作 1、签约:[url]https://openclub.alipay.com/read.php?tid=276&fid=72[/url] 2、创建应用:[url]https://openclub.alipay.com/read.php?tid=1606&fid=72[/url] 3、生成密钥:[url]https://openclub.

优秀的个人博客,低调大师

条码支付集成开发者指南

本帖仅供参考,非官方demo 一、官方文档 文档地址:点击【查看】 sdk下载:点击【查看】 官方demo下载地址:点击【查看】 二、开发前准备工作 1、签约:[url]https://openclub.alipay.com/read.php?tid=276&fid=72[/url] 2、创建应用:[url]https://openclub.alipay.com/read.php?tid=1606&fid=72[/url] 3、生成密钥:[url]https://openclub.alipay.com/read.php?tid=1833&fid=69[/url] 4、下载服务端sdk:[url]https://docs.open.alipay.com/54/106370/[/url] 如何签约以及签约无法成功等相关签约问题:[

优秀的个人博客,低调大师

向Java开发者介绍Scala

Scala结合了面向对象编程与函数编程思想,使用一种能够完全兼容Java、可以运行在Java虚拟机上的、简洁的语法。对于函数编程风格的支持,尤其是对于Lambda表达式的支持,能够有助于减少必须要编写的逻辑无关固定代码,也许让它可以更简单的关注要面对的任务本身,而相对的Java中对Lamdba表达式的支持要到预定于2012年发布的JavaSE8才会实现。本文就是对于Scala介绍。 相关厂商内容 Flash Builder 4.5高级版试用版免费高速下载 QClub(北京站)——《云计算与虚拟化在企业架构中的实施》(10月12日 晚7点) 作为第一步,先安装好最新的Scala发布包Typesafe stack,打开命令行窗口,键入“scala”:这会启动REPL(读入-运算 输出 循环)交互式编码环境。然后你就可以写下你的第一行Scala代码: scala> val columbus : Int = 1492columbus: Int = 1492 我们刚刚声明了一个类型为Int的变量,初始值为1492,就像我们在Java里用语句Int columbus = 1492;所做的一样。除了把类型放在变量之后这样一种反向的声明方式之外,Scala在这里所表现出的不同是使用“val”来显性地把变量声明为不可变。如果我们想要修改这个变量: scala> columbus = 1500 <console>:8: error: reassignment to val columbus = 1500 ^ 请注意错误消息精确地指出了错误位于行的哪个位置。再尝试声明这个变量,但这一次用“var”,让其可变更。这样编译器拥有足够的智能来推断出1492是一个整数,你也就不需要指定类型了: scala> var columbus = 1492 columbus: Int = 1492 scala> columbus = 1500 columbus: Int = 1500 接下来,我们来定义一个类: scala> case class Employee( name:String="guest", age:Int=30, company:String = "DevCode" ) defined class Employee 我们定义了一个类,名为Employee,有三个不可变更的字段:name、age和company,各自有自己的缺省值。关键字“case”相当于Java里的switch语句,只不过要更为灵活。它说明该类具有模式匹配的额外机制,以及其他一些特性,包括用来创建实例的工厂方法(不需要使用“new”关键字来构造),同样的也不需要创建缺省的getter方法。与Java中不同的是,变量缺省下的访问控制是public(而不是protected),而Scala为公开变量创建一个getter方法,并命名为变量名。如果你愿意,你也可以把字段定义成可变且/或私有(private)的,只需要在参数之前使用“var”(例如:case class Person(private var name:String))。 我们再来用不同方式创建一些实例,看看其他的特性,像是命名参数和缺省参数(从Scala2.8开始引入): scala> val guest = Employee() guest: Employee = Employee(guest,30,DevCode) scala> val guestAge = guest.age // (age变量的缺省getter方法) guestAge: Int = 300 scala> val anna = Employee("Anna") anna: Employee = Employee(Anna,30,DevCode) scala> val thomas = Employee("Thomas",41) thomas: Employee = Employee(Thomas,41,DevCode) scala> val luke = Employee("Luke", company="LucasArt") luke: Employee = Employee(Luke,30,LucasArt) scala> val yoda = luke.copy("Yoda", age=800) yoda: Employee = Employee(Yoda,800,LucasArt) 不过,下面的写法 scala> val darth = Employee("Darth", "DevCode") <console>:9: error: type mismatch; found : java.lang.String("DevCode") required: Int Error occurred in an application involving default arguments. val darth = Employee("Darth", "DevCode") ^ 是行不通的(可不是因为Darth不是DevCode的雇员!),这是由于构造函数在这个位置需要age作为参数,因为函数参数没有显性地进行命名。 现在我们再来看集合,这才是真正让人兴奋的地方。 有了泛型(Java5以上),Java可以遍历一个——比方说整数型列表,用下面这样的代码: List<Integer> numbers = new arrayList<Integer>(); numbers.add(1); numbers.add(2); numbers.add(3); for(Integer n:numbers) { System.out.println("Number "+n); } 运行的结果是 Number 1 Number 2 Number 3 Scala对于可变集合和不可变集合进行了系统性地区别处理,不过鼓励使用不可变集合,也因此在缺省情况下创建不可变集合。这些集合是通过模拟的方式实现添加、更新和删除操作,在这些操作中,不是修改集合,而是返回新的集合。 与前面的Java代码等价的Scala代码可能像下面这样: scala> val numbers = List(1,2,3) numbers: List[Int] = List(1, 2, 3) scala> for (n <- numbers) println("Number "+n) Number 1 Number 2 Number 3 这里的“for”循环语法结构非常接近于Java的命令式编程风格。在Scala(以及Java虚拟机上其他很多语言如:Groovy、JRuby或JPython)里还有另外一种方式来实现上面的逻辑。这种方式使用一种更加偏向函数编程的风格,引入了Lambda表达式(有时也称为闭包——closure)。简单地说,Lambda表达式就是你可以拿来当作参数传递的函数。这些函数使用参数作为输入(在我们的例子中就是“n”整型变量),返回语句作为函数体的最终语句。他们的形式如下 functionName { input => body } scala> numbers.foreach { n:Int => // 按回车键继续下一行 | println("Number "+n) | } Number 1 Number 2 Number 3 上面的例子中,函数体只有一条语句(println……),返回的是单位(Unit,也就是“空结果”),也就是大致相当于Java中的void,不过有一点不同的是——void是不返回任何结果的。 除了只打印出我们的数值列表以外,应该说我们更想做的是处理和变换这些元素,这时我们需要调用方法来生成结果列表,以便后面接着使用。让我们尝试一些例子: scala> val reversedList = numbers.reverse reversedList: List[Int] = List(3, 2, 1) scala> val numbersLessThan3 = numbers.filter { n => n < 3 } numbersLessThan3: List[Int] = List(1, 2) scala> val oddNumbers = numbers.filterNot { n => n % 2 == 0 } oddNumbers: List[Int] = List(1, 3) scala> val higherNumbers = numbers.map { n => n + 10 } higherNumbers: List[Int] = List(11, 12, 13) 最后的这一个变换“map”非常有用,它对列表的每一个元素应用闭包,结果是一个同样大小的、包含了每个变换后元素的列表。 我们在这里还想介绍最后的一个方法,就是“foldLeft”方法,它把状态从一个元素传播到另一个元素。比如说,要算出一个列表里所有元素的和,你需要累加它们,并在切换元素的时候保存中间的计数: scala> val sumOfNumbers = numbers.foldLeft(0) { (total,element) => | total + element | } sumOfNumbers: Int = 6 作为第一个变量传递给foldLeft的值0是初始值(也就是说在把函数用到第一个列表元素的时候total=0)。(total,element)代表了一个Tuple2,在Scala里这是一个二元组(就像要表示三维空间坐标,经常要用到Tuple3(x,y,z)等等)。注意在合计时,Scala的编程接口实际上提供了一个“sum”方法,这样上一条语句就可以写成: scala> val sumOfNumbers = numbers.sum sumOfNumbers: Int = 6 还有许多其他的类似的集合变换方法,你可以参照scaladoc API。你也可以把这些方法组合起来(例如:numbers.reverse.filter……),让代码更加简洁,不过这样会影响可读性。 最后,{ n => n + 10 }还可以简单地写成(_ + 10),也就是说如果输入参数只是用于你调用的方法,则不需要声明它;在我们的例子里,“n”被称为匿名变量,因为你可以把它用任何形式来代替,比如说“x”或者“number”,而下划线则表示一处需要用你的列表的每个元素来填补的空白。(与“_”的功能类似,Groovy保留了关键字“it”,而Python则使用的是“self”)。 scala> val higherNumbers = numbers.map(_+10) higherNumbers: List[Int] = List(11, 12, 13) 在介绍了对整数的基本处理后,我们可以迈入下一个阶段,看看复杂对象集合的变换,例如使用我们上面所定义的Employee类: scala> val allEmployees = List(luke,anna,guest,yoda,thomas) allEmployees: List[Employee] = List(Employee(Luke,30,LucasArt), Employee(Anna,30,DevCode), Employee(guest,30,DevCode), Employee(Yoda,800,LucasArt), Employee(Thomas,41,DevCode)) 从这个五个元素的列表里,我们可以应用一个条件来过滤出应用匿名方法后返回值为True的雇员,这样就得到了——比方说属于DevCode的雇员: scala> val devcodeEmployees = allEmployees.filter { _.company == "DevCode" } devcodeEmployees: List[Employee] = List(Employee(Anna,30,DevCode), Employee(guest,30,DevCode), Employee(Thomas,41,DevCode)) scala> val oldEmployees = allEmployees.filter(_.age > 100).map(_.name) oldEmployees: List[String] = List(Yoda) 假设我们手头的allEmployees集合是我们使用SQL查询获得的结果集,查询语句可能类似于“SELECT * FROM employees WHERE company = ‘DevCode’ ”。现在我们可以把List[Employee]变换到以company名称作为键、属于该公司的所有员工的列表作为值的Map类型,这样就可以把雇员按company来排序: scala> val sortedEmployees = allEmployees.groupBy(_.company) sortedEmployees: scala.collection.immutable.Map[String,List[Employee]] = Map(DevCode - > List(Employee(Anna,30,DevCode), Employee(guest,30,DevCode), Employee(Thomas,41,DevCode)), LucasArt -> List(Employee(Luke,30,LucasArt), Employee(Yoda,800,LucasArt))) 每一个列表已经作为一个值存入了(键——值)哈希表,为了示范如何进一步处理这些列表,可以设想我们需要计算每个公司的雇员平均年龄。 这具体意味着我们必须要计算每个列表的每个雇员的的“age”字段的和,然后除以该列表中雇员的数量。让我们先计算一下DevCode: scala> devcodeEmployees res4: List[Employee] = List(Employee(Anna,30,DevCode), Employee(guest,30,DevCode), Employee(Thomas,41,DevCode)) scala> val devcodeAges = devcodeEmployees.map(_.age) devcodeAges: List[Int] = List(30, 30, 41) scala> val devcodeAverageAge = devcodeAges.sum / devcodeAges.size devcodeAverageAge: Int = 33 回到我们的Map (key:String ->value:List[Employee]),下面是个更加一般性的例子。我们现在可以归并并计算每个公司的平均年龄,要做的只是写几行代码: scala> val averageAgeByCompany = sortedEmployees.map{ case(key,value)=> | value(0).copy(name="average",age=(value.map(_.age).sum)/value.size)} averageAgeByCompany: scala.collection.immutable.Iterable[Employee] = List(Employee(average,33,DevCode), Employee(average,415,LucasArt)) 这里的“case(key,value)”说明了Scala提供的模式匹配机制是多么强大。请参考Scala的文档来获取更多的信息。 到这里我们的任务就完成了。我们实现的是一个简单的Map-Reduce算法。由于每个公司雇员的归并是完全独立于其他公司,这个算法非常直观地实现了并行计算。 在后面的附录里给出了此算法的等价的实现,分为Java版本和Scala版本。 参考 The typesafe stack. 附录 Map Reduce: Java public class Employee { final String name; final Integer age; final String company; public Employee(String name, Integer age, String company) { this.name = name == null ? "guest" : name; this.age = age == null ? 30 : age; this.company = company == null ? "DevCode" : company; } public String getName() { return name; } public int getAge() { return age; } public String getCompany() { return company; } @Override public String toString() { return "Employee [name=" + name + ", age=" + age + ", company=" + company + "]"; } } class Builder { String name, company; Integer age; Builder(String name) { this.name = name; } Employee build() { return new Employee(name, age, company); } Builder age(Integer age) { this.age = age; return this; } Builder company(String company) { this.company = company; return this; } } import java.util.ArrayList; import java.util.Collection; import java.util.List; import com.google.common.base.Function; import com.google.common.collect.ImmutableListMultimap; import com.google.common.collect.ImmutableSet; import com.google.common.collect.Multimaps; public class MapReduce { public static final void main(String[] args) { Employee guest = new Builder("Guest").build(); Employee anna = new Builder("Anna").build(); Employee thomas = new Builder("Thomas").age(41).build(); Employee luke = new Builder("Luke").company("LucasArt").build(); Employee yoda = new Builder("Yoda").age(800).company("LucasArt").build(); Collection<Employee> employees = new ArrayList<Employee>(); employees.add(guest); employees.add(anna); employees.add(thomas); employees.add(luke); employees.add(yoda); ImmutableListMultimap<String, Employee> personsGroupByCompany = Multimaps.index(employees, new Function<Employee,String>() { public String apply(Employee person) { return person.getCompany(); } }); ImmutableSet<String> companyNamesFromMap = personsGroupByCompany.keySet(); List<Employee> averageAgeByCompany = new ArrayList<Employee>(); for(String company: companyNamesFromMap) { List<Employee> employeesForThisCompany = personsGroupByCompany.get(company); int sum = 0; for(Employee employee: employeesForThisCompany) { sum+= employee.getAge(); } averageAgeByCompany.add(new Employee("average",sum/employeesForThisCompany.size(),company)); } System.out.println("Result: "+averageAgeByCompany); } } MapReduce.scala: case class Employee(name: String = "guest", age: Int = 30, company: String = "DevCode") object MapReduce { def main(args: Array[String]): Unit = { val guest = Employee() val anna = Employee("Anna") val thomas = Employee("Thomas", 41) val luke = Employee("Luke", company = "LucasArt") val yoda = luke.copy("Yoda", age = 800) val allEmployees = List(luke, anna, guest, yoda, thomas) val sortedEmployees = allEmployees.groupBy(_.company) val averageAgeByCompany = sortedEmployees.map { case (key, value) => value(0).copy(name = "average", age = (value.map(_.age).sum) / value.size) } println("Result: "+averageAgeByCompany) } } 关于作者 Thomas Alexandre是DevCode的高级咨询顾问,专注于Java和Scala软件开发。他热爱技术,热衷于分享知识,永远在寻求方法、采用新的开源软件和标准来实现更加有效的编程。在十四年的Java开发经验之外,过去几年他集中精力在新的编程语言和Web框架上,例如Groovy/Grails和Scala/Lift。Thomas从法国里尔大学获得了计算机科学博士学位,在卡耐基梅隆大学度过了两年的博士后研究生涯,研究方向是安全和电子商务。 查看英文原文:An Introduction to Scala for Java Developers ============================================================================== 本文转自被遗忘的博客园博客,原文链接:http://www.cnblogs.com/rollenholt/articles/2192384.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android开发者指南(6) —— AIDL

正文 使用AIDL设计远程接口(Designing a Remote Interface Using AIDL) 由于每个应用程序都运行在自己的进程空间,并且可以从应用程序UI运行另一个服务进程,而且经常会在不同的进程间传递对象。在Android平台,一个进程通常不能访问另一个进程的内存空间,所以要想对话,需要将对象分解成操作系统可以理解的基本单元,并且有序的通过进程边界。 通过代码来实现这个数据传输过程是冗长乏味的,Android提供了AIDL工具来处理这项工作。 AIDL (Android Interface Definition Language)是一种IDL语言,用于生成可以在Android设备上两个进程之间进行进程间通信(IPC)的代码。如果在一个进程中(例如Activity)要调用另一个进程中(例如Service)对象的操作,就可以使用AIDL生成可序列化的参数。 AIDL IPC机制是面向接口的,像COM或Corba一样,但是更加轻量级。它是使用代理类在客户端和实现端传递数据。 使用AIDL实现IPC(Implementing IPC Using AIDL) 使用AIDL实现IPC服务的步骤是: 1.创建.aidl文件-该文件(YourInterface.aidl)定义了客户端可用的方法和数据的接口。 2.在makefile文件中加入.aidl文件-(Eclipse中的ADT插件提供管理功能)Android包括名为AIDL的编译器,位于tools/文件夹。 3.实现接口-AIDL编译器从AIDL接口文件中利用Java语言创建接口,该接口有一个继承的命名为Stub的内部抽象类(并且实现了一些IPC调用的附加方法),要做的就是创建一个继承于YourInterface.Stub的类并且实现在.aidl文件中声明的方法。 4.向客户端公开接口-如果是编写服务,应该继承Service并且重载Service.onBind(Intent)以返回实现了接口的对象实例 创建.aidl文件(Create an .aidl File) AIDL使用简单的语法来声明接口,描述其方法以及方法的参数和返回值。这些参数和返回值可以是任何类型,甚至是其他AIDL生成的接口。重要的是必须导入所有非内置类型,哪怕是这些类型是在与接口相同的包中。下面是AIDL能支持的数据类型: *Java编程语言的主要类型(int, boolean等)—不需要import语句。 *以下的类(不需要import语句): String List-列表中的所有元素必须是在此列出的类型,包括其他AIDL生成的接口和可打包类型。List可以像一般的类(例如List<String>)那样使用,另一边接收的具体类一般是一个ArrayList,这些方法会使用List接口。 Map- Map中的所有元素必须是在此列出的类型,包括其他AIDL生成的接口和可打包类型。一般的maps(例如Map<String,Integer>)不被支持,另一边接收的具体类一般是一个HashMap,这些方法会使用Map接口。 CharSequence-该类是被TextView和其他控件对象使用的字符序列。 *通常引引用方式传递的其他AIDL生成的接口,必须要import语句声明 *实现了Parcelable protocol以及按值传递的自定义类,必须要import语句声明。 以下是基本的AIDL语法: 实现接口(Implementing the Interface) AIDL生成了与.aidl文件同名的接口,如果使用Eclipse插件,AIDL会做为编译过程的一部分自动运行(不需要先运行AIDL再编译项目),如果没有插件,就要先运行AIDL。 生成的接口包含一个名为Stub的抽象的内部类,该类声明了所有.aidl中描述的方法,Stub还定义了少量的辅助方法,尤其是asInterface(),通过它或以获得IBinder(当applicationContext.bindService()成功调用时传递到客户端的onServiceConnected())并且返回用于调用IPC方法的接口实例,更多细节参见Calling an IPC Method。 要实现自己的接口,就从YourInterface.Stub类继承,然后实现相关的方法(可以创建.aidl文件然后实现stub方法而不用在中间编译,Android编译过程会在.java文件之前处理.aidl文件)。 这个例子实现了对 IRemoteService 接口的调用,这里使用了匿名对象并且只有一个 getPid() 接口。 这里是实现接口的几条说明: *不会有返回给调用方的异常 *默认IPC调用是同步的。如果已知IPC服务端会花费很多毫秒才能完成,那就不要在Activity或View线程中调用,否则会引起应用程序挂起(Android可能会显示“应用程序未响应”对话框),可以试着在独立的线程中调用。 *AIDL接口中只支持方法,不能声明静态成员。 向客户端暴露接口(Exposing Your Interface to Clients) 在完成了接口的实现后需要向客户端暴露接口了,也就是发布服务,实现的方法是继承Service,然后实现以Service.onBind(Intent)返回一个实现了接口的类对象。下面的代码片断表示了暴露IRemoteService接口给客户端的方式。 public class RemoteService extends Service{ ... @Override public IBinderonBind(Intentintent){ // Selecttheinterfacetoreturn.Ifyourserviceonlyimplements // asingleinterface,youcanjustreturnitherewithoutchecking // theIntent. if (IRemoteService. class .getName().equals(intent.getAction())){ return mBinder; } if (ISecondary. class .getName().equals(intent.getAction())){ return mSecondaryBinder; } return null ; } /** *TheIRemoteInterfaceisdefinedthroughIDL */ private final IRemoteService.StubmBinder = new IRemoteService.Stub(){ public void registerCallback(IRemoteServiceCallbackcb){ if (cb != null )mCallbacks.register(cb); } public void unregisterCallback(IRemoteServiceCallbackcb){ if (cb != null )mCallbacks.unregister(cb); } }; /** *Asecondaryinterfacetotheservice. */ private final ISecondary.StubmSecondaryBinder = new ISecondary.Stub(){ public int getPid(){ return Process.myPid(); } public void basicTypes( int anInt, long aLong, boolean aBoolean, float aFloat, double aDouble,StringaString){ } }; } 使用可打包接口传递参数Pass by value Parameters using Parcelables 如果有类想要能过AIDL在进程之间传递,这一想法是可以实现的,必须确保这个类在IPC的两端的有效性,通常的情形是与一个启动的服务通信。 这里列出了使类能够支持Parcelable的4个步骤:【译者注:原文为5,但列表为4项,疑为作者笔误】 1.使该类实现Parcelabel接口。 2.实现public void writeToParcel(Parcel out)方法,以便可以将对象的当前状态写入包装对象中。 3.增加名为CREATOR的构造器到类中,并实现Parcelable.Creator接口。 4.最后,但同样重要的是,创建AIDL文件声明这个可打包的类(见下文),如果使用的是自定义的编译过程,那么不要编译此AIDL文件,它像C语言的头文件一样不需要编译。 AIDL会使用这些方法的成员序列化和反序列化对象。 这个例子演示了如何让Rect类实现Parcelable接口。 import android.os.Parcel; import android.os.Parcelable; public final class Rect implements Parcelable{ public int left; public int top; public int right; public int bottom; public static final Parcelable.Creator < Rect > CREATOR = new Parcelable.Creator < Rect > (){ public RectcreateFromParcel(Parcelin){ return new Rect(in); } public Rect[]newArray( int size){ return new Rect[size]; } }; public Rect(){ } private Rect(Parcelin){ readFromParcel(in); } public void writeToParcel(Parcelout){ out.writeInt(left); out.writeInt(top); out.writeInt(right); out.writeInt(bottom); } public void readFromParcel(Parcelin){ left = in.readInt(); top = in.readInt(); right = in.readInt(); bottom = in.readInt(); } } 这个是Rect.aidl文件。 序列化Rect类的工作相当简单,对可打包的其他类型的数据可以参见Parcel类。 警告 :不要忘了对从其他进程接收到的数据进行安全检查。在上面的例子中, rect 要从数据包中读取 4 个数值,需要确认无论调用方想要做什么,这些数值都是在可接受的范围之内。想要了解更多的关于保持应用程序安全的内容,可参见 Security and Permissions 。 调用IPC方法(Calling an IPC Method) 这里给出了调用远端接口的步骤: 1.声明.aidl文件中定义的接口类型的变量。 2.实现ServiceConnection 3.调用Context.bindService(),传递ServiceConnection的实现 4.在ServiceConnection.onServiceConnected()方法中会接收到IBinder对象,调用YourInterfaceName.Stub.asInterface((IBinder)service)将返回值转换为YourInterface类型 5.调用接口中定义的方法。应该总是捕获连接被打断时抛出的DeadObjectException异常,这是远端方法唯一的异常。 6.调用Context.unbindService()断开连接 这里是几个调用IPC服务的提示: *对象是在进程间进行引用计数 *可以发送匿名对象作为方法参数 以下是演示调用 AIDL 创建的服务,可以在 ApiDemos 项目中获取远程服务的示例。 public static class Binding extends Activity{ /** Theprimaryinterfacewewillbecallingontheservice. */ IRemoteServicemService = null ; /** Anotherinterfaceweuseontheservice. */ ISecondarymSecondaryService = null ; ButtonmKillButton; TextViewmCallbackText; private boolean mIsBound; /** *Standardinitializationofthisactivity.SetuptheUI,thenwait *fortheusertopokeitbeforedoinganything. */ @Override protected void onCreate(BundlesavedInstanceState){ super .onCreate(savedInstanceState); setContentView(R.layout.remote_service_binding); // Watchforbuttonclicks. Buttonbutton = (Button)findViewById(R.id.bind); button.setOnClickListener(mBindListener); button = (Button)findViewById(R.id.unbind); button.setOnClickListener(mUnbindListener); mKillButton = (Button)findViewById(R.id.kill); mKillButton.setOnClickListener(mKillListener); mKillButton.setEnabled( false ); mCallbackText = (TextView)findViewById(R.id.callback); mCallbackText.setText( " Notattached. " ); } /** *Classforinteractingwiththemaininterfaceoftheservice. */ private ServiceConnectionmConnection = new ServiceConnection(){ public void onServiceConnected(ComponentNameclassName,IBinderservice){ // Thisiscalledwhentheconnectionwiththeservicehasbeen // established,givingustheserviceobjectwecanuseto // interactwiththeservice.Wearecommunicatingwithour // servicethroughanIDLinterface,sogetaclient-side // representationofthatfromtherawserviceobject. mService = IRemoteService.Stub.asInterface(service); mKillButton.setEnabled( true ); mCallbackText.setText( " Attached. " ); // Wewanttomonitortheserviceforaslongasweare // connectedtoit. try { mService.registerCallback(mCallback); } catch (RemoteExceptione){ // Inthiscasetheservicehascrashedbeforewecouldeven // doanythingwithit;wecancountonsoonbeing // disconnected(andthenreconnectedifitcanberestarted) // sothereisnoneedtodoanythinghere. } // Aspartofthesample,telltheuserwhathappened. Toast.makeText(Binding. this ,R.string.remote_service_connected, Toast.LENGTH_SHORT).show(); } public void onServiceDisconnected(ComponentNameclassName){ // Thisiscalledwhentheconnectionwiththeservicehasbeen // unexpectedlydisconnected--thatis,itsprocesscrashed. mService = null ; mKillButton.setEnabled( false ); mCallbackText.setText( " Disconnected. " ); // Aspartofthesample,telltheuserwhathappened. Toast.makeText(Binding. this ,R.string.remote_service_disconnected, Toast.LENGTH_SHORT).show(); } }; /** *Classforinteractingwiththesecondaryinterfaceoftheservice. */ private ServiceConnectionmSecondaryConnection = new ServiceConnection(){ public void onServiceConnected(ComponentNameclassName,IBinderservice){ // Connectingtoasecondaryinterfaceisthesameasany // otherinterface. mSecondaryService = ISecondary.Stub.asInterface(service); mKillButton.setEnabled( true ); } public void onServiceDisconnected(ComponentNameclassName){ mSecondaryService = null ; mKillButton.setEnabled( false ); } }; private OnClickListenermBindListener = new OnClickListener(){ public void onClick(Viewv){ // Establishacoupleconnectionswiththeservice,binding // byinterfacenames.Thisallowsotherapplicationstobe // installedthatreplacetheremoteservicebyimplementing // thesameinterface. bindService( new Intent(IRemoteService. class .getName()), mConnection,Context.BIND_AUTO_CREATE); bindService( new Intent(ISecondary. class .getName()), mSecondaryConnection,Context.BIND_AUTO_CREATE); mIsBound = true ; mCallbackText.setText( " Binding. " ); } }; private OnClickListenermUnbindListener = new OnClickListener(){ public void onClick(Viewv){ if (mIsBound){ // Ifwehavereceivedtheservice,andhenceregisteredwith // it,thennowisthetimetounregister. if (mService != null ){ try { mService.unregisterCallback(mCallback); } catch (RemoteExceptione){ // Thereisnothingspecialweneedtodoiftheservice // hascrashed. } } // Detachourexistingconnection. unbindService(mConnection); unbindService(mSecondaryConnection); mKillButton.setEnabled( false ); mIsBound = false ; mCallbackText.setText( " Unbinding. " ); } } }; private OnClickListenermKillListener = new OnClickListener(){ public void onClick(Viewv){ // Tokilltheprocesshostingourservice,weneedtoknowits // PID.Convenientlyourservicehasacallthatwillreturn // tousthatinformation. if (mSecondaryService != null ){ try { int pid = mSecondaryService.getPid(); // Notethat,thoughthisAPIallowsustorequestto // killanyprocessbasedonitsPID,thekernelwill // stillimposestandardrestrictionsonwhichPIDsyou // areactuallyabletokill.Typicallythismeansonly // theprocessrunningyourapplicationandanyadditional // processescreatedbythatappasshownhere;packages // sharingacommonUIDwillalsobeabletokilleach // other'sprocesses. Process.killProcess(pid); mCallbackText.setText( " Killedserviceprocess. " ); } catch (RemoteExceptionex){ // Recovergracefullyfromtheprocesshostingthe // serverdying. // Justforpurposesofthesample,putupanotification. Toast.makeText(Binding. this , R.string.remote_call_failed, Toast.LENGTH_SHORT).show(); } } } }; // ---------------------------------------------------------------------- // Codeshowinghowtodealwithcallbacks. // ---------------------------------------------------------------------- /** *Thisimplementationisusedtoreceivecallbacksfromtheremote *service. */ private IRemoteServiceCallbackmCallback = new IRemoteServiceCallback.Stub(){ /** *Thisiscalledbytheremoteserviceregularlytotellusabout *newvalues.NotethatIPCcallsaredispatchedthroughathread *poolrunningineachprocess,sothecodeexecutingherewill *NOTberunninginourmainthreadlikemostotherthings--so, *toupdatetheUI,weneedtouseaHandlertohopoverthere. */ public void valueChanged( int value){ mHandler.sendMessage(mHandler.obtainMessage(BUMP_MSG,value, 0 )); } }; private static final int BUMP_MSG = 1 ; private HandlermHandler = new Handler(){ @Override public void handleMessage(Messagemsg){ switch (msg.what){ case BUMP_MSG: mCallbackText.setText( " Receivedfromservice: " + msg.arg1); break ; default : super .handleMessage(msg); } } }; } 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582282,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android开发者指南(9) —— ProGuard

混淆器(ProGuard) 在本文中(In this document) Enabling ProGuard Configuring ProGuard Decoding Obfuscated Stack Traces Debugging considerations for published applications 参见 ProGuard Manual » ProGuard ReTrace Manual » 混淆器通过删除从未用过的代码和使用晦涩名字重命名类、字段和方法,对代码进行压缩,优化和混淆。结果是一个比较小的.apk文件,该文件比较难进行逆向工程。因此,当你的应用程序对安全敏感(要求高),例如当你授权应用程序的时候,混淆器是一种重要的保护手段。 混淆器被集成在android构建系统中,所以你不必手动调用它。同时混淆器仅在发布模式下进行构建应用程序的时候才会运行起来,所以在调试模式下构建程序时,你不必处理混淆代码。让混淆器运行起来是可选择的,但是推荐选上。 这个文档描述了怎样启用并配置混淆器,以及使用跟踪(retrace)工具对混淆的堆栈跟踪信息(stack traces)进行解码。 启用混淆器Enabling ProGuard 当你新建了一个Android工程之后,一个proguard.cfg文件会在工程的根目录下自动创建。这个文件定义了混淆器是怎样优化和混淆你的代码的,所以懂得怎样根据你的需要来定制是非常重要的。缺省的配置文件仅覆盖到了通常情况,所以根据你的需求,很可能需要编辑它。接下来的内容是关于通过定制混淆器配置文件来对混淆器配置。 为了让启用混淆器作为Ant或者Eclipse构建过程中一部分,可以在<project_root>/default.properties文件中,设置proguard.config属性。路径可以是绝对路径或者工程根目录的相对路径。 如果你让proguard.cfg文件在缺省位置(工程的根目录),你可以像这样指定位置: proguard.config=proguard.cfg 同样,你可以把该文件放到任意的位置,并指定它的绝对路径。 proguard.config=/path/to/proguard.cfg 当你在发布模式下,或者通过运行ant release,或者通过使用Eclipse中的Export Wizard构建你的应用程序的时候,构建系统都会自动地去检查proguard.config属性是否被设置了。如果被设置了,混淆器在把所有东西打包成.apk文件之前,自动地对应用程序字节码进行混淆处理。而在调试模式中构建则不会调用混淆器,因为那样调试会更加繁重。 运行混淆器之后输出的文件有: dump.txt 描述.apk包中所有class文件的内部结构。 mapping.txt 列出了源代码与混淆后的类,方法和属性名字之间的映射。这个文件对于在构建之后得到的bug报告是有用的,因为它把混淆的堆栈跟踪信息反翻译为源代码中的类,方法和成员名字。更多信息,查看解码混淆过的堆栈跟踪信息。 seeds.txt 列出那些未混淆的类和成员。 usage.txt 列出从.apk中剥离的代码。 这些文件放在以下目录中: l<project_root>/bin/proguard当你使用Ant时 l<project_root>/proguard当你使用Eclipse时 注意:每次在发布模式下构建时,这些文件都会被最新的文件覆盖。所以每次发布程序时候,为了反混淆来自构建时产生的bug报告,请保存这些文件的一个拷贝。对于为什么要保存这些文件的重要性的更多信息,请查看程序发布调试注意事项。 混淆器配置(Configuring ProGuard) 某些情况下,proguard.cfg文件的缺省配置可以满足需求了。但是,对于混淆器来说,大多数情况做出正确的分析是困难的,并且它或许会删除在它看来是无用的,但对于程序来说却确实需要的代码。一些例子如下: l一个仅引用于AndroidManifest.xml文件的类。 l一个通过JNI调用的方法。 l动态引用的属性和方法。 缺省的proguard.cfg文件试图覆盖普通的情况,但是你可能碰到类似ClassNotFoundException的异常,这个异常出现在当你的程序去访问一个被混淆器移除了的类的时候。 你可以在proguard.cfg文件中添加-keep这一行来修复这些错误。例如: -keeppublicclass<MyClass> -Keep设置有很多可选项和注意地方,所以为了获得更多关于配置信息,强烈推荐你阅读混淆器用户手册。特别有用的有Keep选项综述和举例部分。在混淆器手册问题解决方案部分,介绍了代码在混淆过程中你可能碰到的其他常见问题。 解码混淆过的堆栈跟踪信息(Decoding Obfuscated Stack Traces) 当混淆代码并输出了一个堆栈调试信息时,这些方法名字是混淆过的,虽然可以进行调试,但是调试变得困难。幸运的是,每当混淆器运行时候,它都会输出到文件<project_root>/bin/proguard/mapping.txt中,该文件包含了从原始类,方法和属性名字到混淆后名字的映射。 Windows系统中retrace.bat脚本命令或者Linux和Mac OS X系统中retrace.sh脚本命令能把混淆后的堆栈调试信息转换为可以理解的文件。它被放在<sdk_root>/tools/proguard/目录下。运行retrace工具的命令语法是: retrace.bat|retrace.sh[-verbose]mapping.txt[<stacktrace_file>] 例如: retrace.bat-verbose mapping.txt obfuscated_trace.txt 如果你没有为<stracktrace_file>指定值,那么retrace工具从标准输入读取。 已发布应用程序的调试注意事项(Debugging considerations for published applications) 保存好每一个已发布给用户的程序的mapping.txt文件。通过保存发布构建版本的mapping.txt文件拷贝,确保当用户碰到bug,并把混淆后的堆栈调试跟踪信息提交给你时,你可以进行调试从而修复问题。程序的mapping.txt文件在每次发布构建时都会被覆盖,所以你一定要注意保存正确的版本。 例如,假设你已经发布了一个应用程序并在继续在新的版本中开发添加新的功能。接着你马上启动混淆器并创建一个新的发布版本。该操作把mapping.txt文件覆盖了。一个用户提交了来自当前发布版本的bug报告,该报告包含了堆栈调试信息。你再也不能对用户的堆栈信息进行调试了,因为这个对应用户本机上版本的mapping.txt文件不存在了。其他覆盖mapping.txt文件的情况还有很多,所以对于每一个可能需要调试的版本,你都要确保有一份拷贝。 如何保存mapping.txt文件由你决定。例如,你可以根据版本和构建号来重命名它们,或者连同你的源代码进行版本控制。 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582279,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android开发者指南(14) —— Introduction

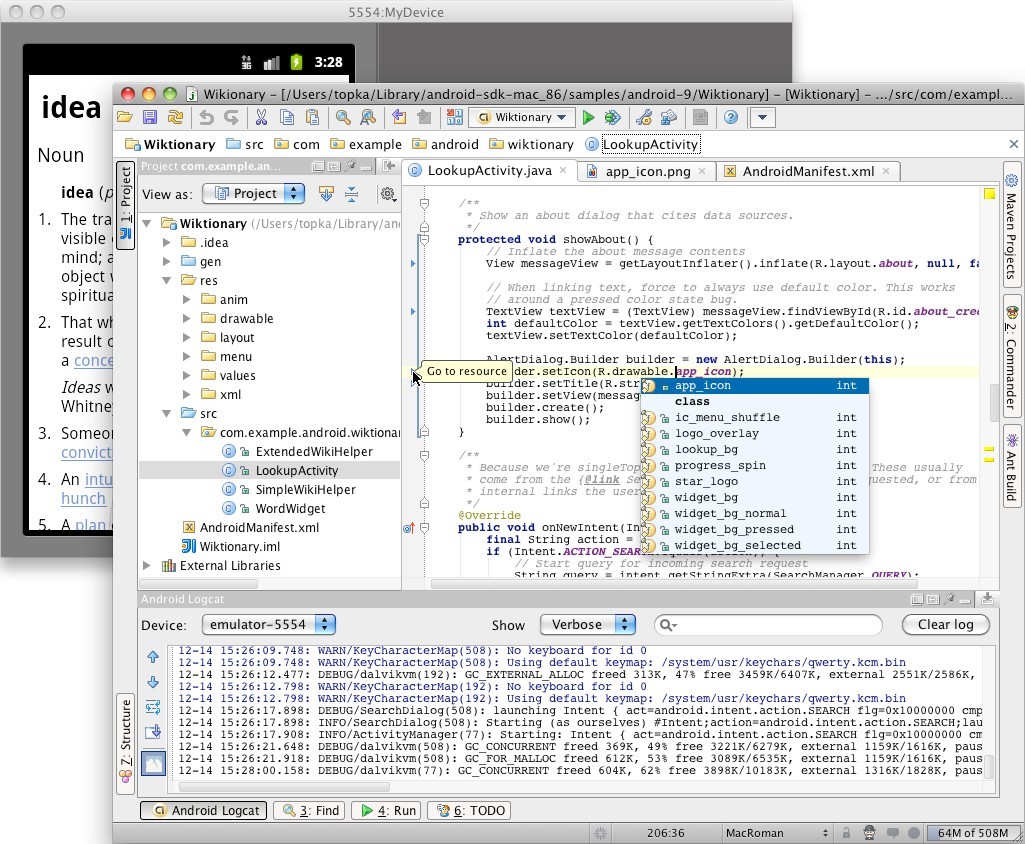
简介 使用SDK提供的工具来开发Android设备的应用程序非常方便。要使用这些工具,不仅可以通过被称为ADT(Android Development Tools)的Eclipse插件,还可以通过命令行。我们推荐使用Eclipse进行开发,因为它可以使我们在开发应用程序的过程中,能够直接调用所需的各种工具。 当然,你也可以选择使用其它的IDE进行开发。或者,仅使用一个简单的文本编辑器,并通过命令行来调用工具或执行脚本。对开发而言,这是一些数量不多的流线式步骤。尽管有时不得不手工地调用命令行工具,但所有的这些功能在Eclipse中全都具备。 备注:在开始开发Android应用程序之前,请确信已通读了安装中罗列的所有步骤。 不管是否使用Eclipse,开发应用程序的基本步骤是一样的: 1.安装Android虚拟设备或硬件设备。 需要创建Android虚拟设备或连接硬件设备,用来安装应用程序。 更多信息请查阅管理虚拟设备和使用硬件设备。 2.创建Android工程。 Android工程容纳了应用程序的全部源代码和资源文件。最后,它会被构建到一个.apk的包中,用于安装到Android设备。 3.构建和运行应用程序。 如果使用Eclipse进行开发,那么每次保存所做的改动时都会执行构建。要把应用程序安装到设备中,只需要点击Run。如果使用的是其它IDE,可以用Ant来构建工程,并用adb来把它安装到设备中。 (译者注:Eclipse中的构建是否在保存操作后自动执行,取决于菜单项Project>Build Automatically的状态) 4.用SDK的调试和日志工具来调试应用程序。 应用程序调试包括使用JDWP兼容调试器,以及Android SDK提供的调试和日志工具。在Eclipse中,已经包含的一个兼容调试器。 (译者注:JDWP是Java调试线协议,其详细介绍可参阅这里) 5.用测试和测量框架来测试应用程序。 Android SDK提供了一个测试和测量框架,用来帮助在仿真器或设备中安装和运行测试。 必要的命令行工具 当使用Eclipse之外的其它IDE或编辑器进行开发时,需要熟悉下列的所有工具,它们都必须通过命令行来执行。 android 创建和更改Android工程,创建、移动和删除AVD。 Android Emulator 在一个Android仿真平台上运行你的Android应用程序。 Android Debug Bridge 与仿真器或已连接设备之间的接口(安装应用程序、执行设备shell、发送命令等)。 除了上面的SDK工具之外,还需要下面的开源三方工具: Ant 用于把Android工程编译构建为可安装的.apk文件。 Keytool Keytool是JDK的一部分,用于生成密钥库和私钥,进而对.apk文件进行签名。 Jarsigner(或类似的签名工具) 用Keytool生成的私钥对.apk文件进行签名。Jarsigner也是JDK的一部分。 如果使用Eclipse和ADT,那么adb和android都会由Eclipse和ADT的类似功能来进行调用。不过,你还是需要熟悉adb,因为它的有些功能是无法从Eclipse访问的,比如adbshell命令。你可能还需要调用Keytool和Jarsigner来对应用程序进行签名,但最好还是对Eclipse进行设置,让它来自动地做这件事。 有关Android SDK提供的工具的更多信息,请查阅文档的工具部分。 第三方开发工具 下面所述的工具不是由Android SDK团队开发的。Android开发指南中没有提供这些工具相关的文档,请通过给出的链接来找到它们。 在IntelliJ IDEA中开发 IntelliJ IDEA是来自JetBrains的强大的Java IDE,它的免费社区版和最终版都提供了完整的Android开发支持。 IDE确保与最新Android SDK的兼容,同时还提供智能的代码编辑器、在代码和资源间的快速导航、图形化调试器、使用Android测试框架的单元测试支持、以及在模拟器或USB连接的设备中运行应用程序的能力。 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/596986,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android开发者指南(2) —— aapt

正文 使用aapt aapt是标准的Android辅助打包工具,位于SDK的tools/文件夹下。该工具允许查看、创建或更新Zip兼容格式(zip,jar,apk)的文档,并且能将资源编译到二进制格式的包中。 通常不需要直接使用aapt工具,IDE插件和编译脚本能利用它打包apk文件来合成应用程序。 详细的用法可以打开命令行终端,到tools文件夹下运行如下命令: Linux或Mac OS X: ./aapt Windows: aapt.exe 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582290,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android开发者指南(5) —— monkeyrunner

正文 monkeyrunner工具提供了一个API,使用此API写出的程序可以在Android代码之外控制Android设备和模拟器。通过monkeyrunner,您可以写出一个Python程序去安装一个Android应用程序或测试包,运行它,向它发送模拟击键,截取它的用户界面图片,并将截图存储于工作站上。monkeyrunner工具的主要设计目的是用于测试功能/框架水平上的应用程序和设备,或用于运行单元测试套件,但您当然也可以将其用于其它目的。 monkeyrunner工具与(UI/Application Exerciser Monkey)用户界面/应用程序测试工具,也称为monkey工具并无关联。monkey工具直接运行在设备或模拟器的adbshell中,生成用户或系统的伪随机事件流。而monkeyrunner工具则是在工作站上通过API定义的特定命令和事件控制设备或模拟器。 monkeyrunner工具为Android测试提供了以下特性: *多设备控制:monkeyrunnerAPI可以跨多个设备或模拟器实施测试套件。您可以在同一时间接上所有的设备或一次启动全部模拟器(或统统一起),依据程序依次连接到每一个,然后运行一个或多个测试。您也可以用程序启动一个配置好的模拟器,运行一个或多个测试,然后关闭模拟器。 *功能测试:monkeyrunner可以为一个应用自动贯彻一次功能测试。您提供按键或触摸事件的输入数值,然后观察输出结果的截屏。 *回归测试:monkeyrunner可以运行某个应用,并将其结果截屏与既定已知正确的结果截屏相比较,以此测试应用的稳定性。 *可扩展的自动化:由于monkeyrunner是一个API工具包,您可以基于Python模块和程序开发一整套系统,以此来控制Android设备。除了使用monkeyrunnerAPI之外,您还可以使用标准的Pythonos和subprocess模块来调用如Android Debug Bridge这样的Android工具。 您还可以向monkeyrunner API中添加您自己的类。我们将在使用插件扩展monkeyrunner一节中对此进行详细讨论。 monkeyrunner工具使用Jython(使用Java编程语言的一种Python实现)。Jython允许monkeyrunnerAPI与Android框架轻松的进行交互。使用Jython,您可以使用Python语法来获取API中的常量、类以及方法。 一个简单的monkeyrunner程序实例(A Simple monkeyrunner Program) 以下为一个简单的monkeyrunner程序,它将会连接到一个设备,创建一个MonkeyDevice对象。使用MonkeyDevice对象,程序将安装一个Android应用包,运行其中一个活动,并向其发送按键事件。程序接下来会将结果截图,创建一个MonkeyImage对象,并使用这个对象截图将保存至.png文件。 The monkeyrunner API monkeyrunnerAPI于com.android.monkeyrunner包中包含三个模块: *MonkeyRunner:一个为monkeyrunner程序提供工具方法的类。这个类提供了用于连接monkeyrunner至设备或模拟器的方法。它还提供了用于创建一个monkeyrunner程序的用户界面以及显示内置帮助的方法。 *MonkeyDevice:表示一个设备或模拟器。这个类提供了安装和卸载程序包、启动一个活动以及发送键盘或触摸事件到应用程序的方法。您也可以用这个类来运行测试包。 *MonkeyImage:表示一个截图对象。这个类提供了截图、将位图转换成各种格式、比较两个MonkeyImage对象以及写图像到文件的方法。 在python程序中,您将以Python模块的形式使用这些类。monkeyrunner工具不会自动导入这些模块。您必须使用类似如下的from语句: 其中,为您想要导入的类名。您可以在一个from语句中导入超过一个模块,其间以逗号分隔。 Running monkeyrunner 您可以直接使用一个代码文件运行monkeyrunner,抑或在交互式对话中输入monkeyrunner语句。不论使用哪种方式,您都需要调用SDK目录的tools子目录下的monkeyrunner命令。如果您提供一个文件名作为运行参数,则monkeyrunner将视文件内容为Python程序,并加以运行;否则,它将提供一个交互对话环境。 monkeyrunner命令的语法为: 表1阐释了命令的标志和参数。 参数 说明 -plugin <plugin_jar> (可选)指定一个内含monkeyrunner插件的.jar文件。欲了解更多关于monkeyrunner插件的内容,请参照(Extending monkeyrunner with plugins)使用插件扩展monkeyrunner。要指定多个文件,包括多次论证。如欲指定超过一个文件,可以多次使用此参数。 <program_filename> 如果您指定此参数,monkeyrunner将视文件内容为Python程序并予以执行。如果此参数未予指定,则开启一个交互式会话。 <program_options> (可选)<程序文件名>所指定的程序所需的参数 monkeyrunner内建帮助(monkeyrunner Built-in Help) 您可以用以下命令来生成monkeyrunner的API参考: 参数说明: *可以为text或html,分别代表纯文本和HTML输出。 *指定了输出文件的全路经名称。 使用插件扩展monkeyrunner(Extending monkeyrunner with Plugins) 您可以用Java语言创建新的类,并打包成一个或多个.jar文件,以此来扩展monkeyrunnerAPI。您可以使用您自己写的类或者继承现有的类来扩展monkeyrunnerAPI。您还可以使用此功能来初始化monkeyrunner环境。 为了使monkeyrunner加载一个插件,您应当如使用如表1中所述的-plugin参数来调用monkeyrunner命令。 在您编写的插件中,您可以导入或继承位于com.android.monkeyrunner包中的几个主要的monkeyrunner类:MonkeyDevice,MonkeyImage和MonkeyRunner(参见monkeyrunnerAPI)。 请注意,插件无法让你访问Android的SDK。您不能导入com.android.app等包。这是因为monkeyrunner是在框架API层次之下与设备或模拟器进行交互的。 插件启动类(The plugin startup class) 用于插件的.jar文件可以指定一个类,使其在脚本执行之前就实例化。如欲指定这个类,您需要在.jar文件的manifest中添加键MonkeyRunnerStartupRunner。其值为启动时运行的类的名称。以下代码段显示了如何在一个ant构建脚本达到这样的目的: 如欲访问 monkeyrunner 的运行时环境,启动类可以实现 com.google.common.base.Predicate<PythonInterpreter> 。例如,用这个类在默认的命名空间中设置一些变量: 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582283,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册