首页 文章 精选 留言 我的

精选列表

搜索[Excel导入],共10000篇文章
优秀的个人博客,低调大师

如何将mysql数据导入Hadoop之Sqoop安装

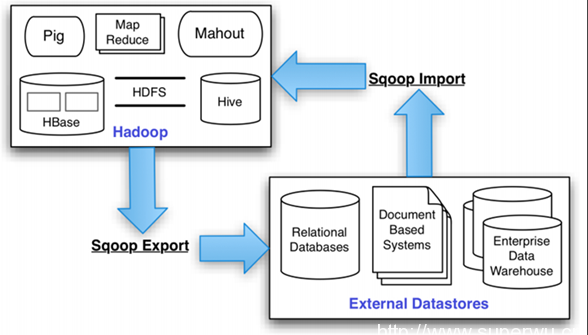
Sqoop是一款开源的工具,主要用于在Hadoop(Hive)与传统的数据库(mysql、postgresql...)间进行数据的传递,可以将一个关系型数据库(例如 : MySQL ,Oracle ,Postgres等)中的数据导进到Hadoop的HDFS中,也可以将HDFS的数据导进到关系型数据库中。Sqoop项目开始于2009年,最早是作为Hadoop的一个第三方模块存在,后来为了让使用者能够快速部署,也为了让开发人员能够更快速的迭代开发,Sqoop独立成为一个Apache项目。 总之Sqoop是一个转换工具,用于在关系型数据库与HDFS之间进行数据转换。 注意:sqoop1与sqoop2完全不兼容,1.4.6及之前的版本是sqoop1,之后的是sqoop2 Sqoop1和Sqoop2的对比 sqoop2比sqoop1的改进 引入sqoop server,集中化管理connector等 多种访问方式:CLI,Web UI,REST API 引入基于角色 的安全机制 sqoop1与sqoop2的优缺点 sqoop1的架构,仅仅使用一个sqoop客户端,sqoop2的架构,引入了sqoop server集中化管理connector,以及rest api,web,UI,并引入权限安全机制。 sqoop1优点架构部署简单 sqoop1的缺点命令行方式容易出错,格式紧耦合,无法支持所有数据类型,安全机制不够完善,例如密码暴漏, 安装需要root权限,connector必须符合JDBC模型 sqoop2的优点多种交互方式,命令行,web UI,rest API,conncetor集中化管理,所有的链接安装在sqoop server上,完善权限管理机制,connector规范化,仅仅负责数据的读写。 sqoop2的缺点,架构稍复杂,配置部署更繁琐。 sqoop1架构图 sqoop2架构图 由于sqoop2还不是很完善,官方建议生产环境不建议使用,在此就sqoop1.4.6来作介绍 安装环境: Cenos7系统 sqoop版本:1.4.6 Hadoop:2.7.3 MySQL:5.7.15 JDK :1.8 下载并解压sqoop1.4.6 安装在一台节点上就可以了 点击 sqoop下载地址,下载Sqoop安装文件sqoop-1.4.6.bin__hadoop-2.0.4-alpha.tar.gz。将文件上传到服务器的/usr/local文件夹中。 下面执行以下命令 1.cd~#进入当前用户的用户目录2.cd/usr/local3.sudotar-zxvfsqoop-1.4.6.bin__hadoop-2.0.4-alpha.tar.gz-C/usr/local#解压安装文件5.sudomvsqoop-1.4.6.bin__hadoop-2.0.4-alphasqoop146#修改文件名6.sudochown-Rhadoop:hadoopsqoop146#修改文件夹属主,如果你当前登录用户名不是hadoop,请修改成你自己的用户名(hadoop为用Hadoop创建的用户组和用户名,sqoop将与Hadoop组合使用) 修改配置文件sqoop-env.sh 1.cdsqoop146/conf/ 2.catsqoop-env-template.sh>>sqoop-env.sh#将sqoop-env-template.sh复制一份并命名为sqoop-env.sh3.visqoop-env.sh#编辑sqoop-env.sh 修改sqoop-env.sh的如下信息,若有其它的可以都加上 exportHADOOP_COMMON_HOME=/usr/local/hadoop273 exportHADOOP_MAPRED_HOME=/usr/local/hadoop273 export HBASE_HOME=/usr/local/hbase export HIVE_HOME=/usr/local/hive export ZOOCFGDIR= #如果读者配置了ZooKeeper,也需要在此配置ZooKeeper的路径 配置环境变量 打开当前用户的环境变量配置文件: vi~/.bash_profile 在配置文件第一行键入如下信息: exportSQOOP_HOME=/usr/local/sqoop146 exportPATH=$PATH:$SBT_HOME/bin:$SQOOP_HOME/bin exportCLASSPATH=$CLASSPATH:$SQOOP_HOME/lib 保存该文件,退出vim编辑器。 然后,执行下面命令让配置文件立即生效: source~/.bash_profile 将mysql驱动包拷贝到$SQOOP_HOME/lib 下面要把MySQL驱动程序和hadoop-connector jar包拷贝到$SQOOP_HOME/lib目录下,不存在先下载驱动包。 cp./mysql-connector-java-5.1.40/mysql-connector-java-5.1.40-bin.jar/usr/local/sqoop146/lib cp$HADOOP_HOME/share/hadoop/common/hadoop-common-2.7.3.jar$SQOOP_HOME/lib 修改$SQOOP_HOME/bin/configure-sqoop 注释掉HCatalog,Accumulo检查(除非你准备使用HCatalog,Accumulo等HADOOP上的组件) ##Movedtobearuntimecheckinsqoop.#if[!-d"${HCAT_HOME}"];then#echo"Warning:$HCAT_HOMEdoesnotexist!HCatalogjobswillfail."#echo'Pleaseset$HCAT_HOMEtotherootofyourHCataloginstallation.'#fi #if[!-d"${ACCUMULO_HOME}"];then#echo"Warning:$ACCUMULO_HOMEdoesnotexist!Accumuloimportswillfail."#echo'Pleaseset$ACCUMULO_HOMEtotherootofyourAccumuloinstallation.'#fi #AddHCatalogtodependencylist#if[-e"${HCAT_HOME}/bin/hcat"];then#TMP_SQOOP_CLASSPATH=${SQOOP_CLASSPATH}:`${HCAT_HOME}/bin/hcat-classpath`#if[-z"${HIVE_CONF_DIR}"];then#TMP_SQOOP_CLASSPATH=${TMP_SQOOP_CLASSPATH}:${HIVE_CONF_DIR}#fi#SQOOP_CLASSPATH=${TMP_SQOOP_CLASSPATH}#fi #AddAccumulotodependencylist#if[-e"$ACCUMULO_HOME/bin/accumulo"];then#forjnin`$ACCUMULO_HOME/bin/accumuloclasspath|grepfile:.*accumulo.*jar|cut-d':'-f2`;do#SQOOP_CLASSPATH=$SQOOP_CLASSPATH:$jn#done#forjnin`$ACCUMULO_HOME/bin/accumuloclasspath|grepfile:.*zookeeper.*jar|cut-d':'-f2`;do#SQOOP_CLASSPATH=$SQOOP_CLASSPATH:$jn#done#fi 测试与MySQL的连接 首先请确保mysql服务已经启动了,如果没有启动,请执行下面命令启动: servicemysqlstart 然后就可以测试sqoop与MySQL之间的连接是否成功: sqooplist-databases--connectjdbc:mysql://127.0.0.1:3306/--usernameroot-passwordroot root为数据库的用户名和密码,mysql的数据库列表显示在屏幕上表示连接成功。 本文转自xmgdc51CTO博客,原文链接:http://blog.51cto.com/12953214/1941199 ,如需转载请自行联系原作者

优秀的个人博客,低调大师

【视频云端】iOS库冲突的问题---动态库导入

1.什么是库 首先来看什么是库,库(Library)说白了就是一段编译好的二进制代码,加上头文件就可以供别人使用。 什么时候我们会用到库呢?一种情况是某些代码需要给别人使用,但是我们不希望别人看到源码,就需要以库的形式进行封装,只暴露出头文件。另外一种情况是,对于某些不会进行大的改动的代码,我们想减少编译的时间,就可以把它打包成库,因为库是已经编译好的二进制了,编译的时候只需要 Link 一下,不会浪费编译时间。 上面提到库在使用的时候需要 Link,Link 的方式有两种,静态和动态,于是便产生了静态库和动态库。 2.静态库和动态库的存在形式和区别。 2.1 静态库和动态库的存在形式 静态库:.a 和 .framework动态库:.dylib 和 .framework 2.2 静态库和动态库的区别 静态库:静态库即静态链接库(Windows 下

优秀的个人博客,低调大师

Spark Streaming 数据产生与导入相关的内存分析

前言 我这篇文章会分几个点来描述Spark Streaming 的Receiver在内存方面的表现。 一个大致的数据接受流程 一些存储结构的介绍 哪些点可能导致内存问题,以及相关的配置参数 另外,有位大牛写了 Spark Streaming 源码解析系列,我觉得写的不错,这里也推荐下。 我在部门尽力推荐使用Spark Streaming做数据处理,目前已经应用在日志处理,机器学习等领域。这期间也遇到不少问题,尤其是Kafka在接受到的数据量非常大的情况下,会有一些内存相关的问题。 另外特别说明下,我们仅仅讨论的是High Level的Kafka Stream,也就是输入流通过如下方式创建: KafkaUtils.createStream 并且不开启WAL的情况下。 数据接受流程 启动Spark Streaming(后续缩写为SS)后,SS 会选择一台Executor 启动ReceiverSupervisor,并且标记为Active状态。接着按如下步骤处理: ReceiverSupervisor会启动对应的Receiver(这里是KafkaReceiver) KafkaReceiver 会根据配置启动新的线程接受数据,在该线程中调用 ReceiverSupervisor.store 方法填充数据,注意,这里是一条一条填充的。 ReceiverSupervisor 会调用 BlockGenerator.addData 进行数据填充。 到目前为止,整个过程不会有太多内存消耗,正常的一个线性调用。所有复杂的数据结构都隐含在 BlockGenerator 中。 BlockGenerator 存储结构 BlockGenerator 会复杂些,这里有几个点, 维护了一个缓存 currentBuffer ,就是一个无限长度的ArrayBuffer。currentBuffer 并不会被复用,而是每次都会新建,然后把老的对象直接封装成Block,BlockGenerator会负责保证currentBuffer 只有一个。currentBuffer 填充的速度是可以被限制的,以秒为单位,配置参数为 spark.streaming.receiver.maxRate。这个是Spark内存控制的第一道防线,填充currentBuffer 是阻塞的,消费Kafka的线程直接做填充。 维护了一个 blocksForPushing 队列, size 默认为10个(1.5.1版本),可通过 spark.streaming.blockQueueSize 进行配置。该队列主要用来实现生产-消费模式。每个元素其实是一个currentBuffer形成的block。 blockIntervalTimer 是一个定时器。其实是一个生产者,负责将currentBuffer 的数据放到 blocksForPushing 中。通过参数 spark.streaming.blockInterval 设置,默认为200ms。放的方式很简单,直接把currentBuffer做为Block的数据源。这就是为什么currentBuffer不会被复用。 blockPushingThread 也是一个定时器,负责将Block从blocksForPushing取出来,然后交给BlockManagerBasedBlockHandler.storeBlock 方法。10毫秒会取一次,不可配置。到这一步,才真的将数据放到了Spark的BlockManager中。 步骤描述完了,我们看看有哪些值得注意的地方。 currentBuffer 首先自然要说下currentBuffer,如果200ms期间你从Kafka接受的数据足够大,则足以把内存承包了。而且currentBuffer使用的并不是spark的storage内存,而是有限的用于运算存储的内存。 默认应该是 heap*0.4。除了把内存搞爆掉了,还有一个是GC。导致receiver所在的Executor 极容易挂掉,处理速度也巨慢。 如果你在SparkUI发现Receiver挂掉了,考虑有没有可能是这个问题。 blocksForPushing blocksForPushing 这个是作为currentBuffer 和BlockManager之间的中转站。默认存储的数据最大可以达到 10*currentBuffer 大小。一般不打可能,除非你的 spark.streaming.blockInterval 设置的比10ms 还小,官方推荐最小也要设置成 50ms,你就不要搞对抗了。所以这块不用太担心。 blockPushingThread blockPushingThread 负责从 blocksForPushing 获取数据,并且写入 BlockManager 。这里很蛋疼的事情是,blockPushingThread只写他自己所在的Executor的 blockManager,也就是每个batch周期的数据都会被 一个Executor给扛住了。 这是导致内存被撑爆的最大风险。 也就是说,每个batch周期接受到的数据最好不要超过接受Executor的内存(Storage)的一半。否则有你受的。我发现在数据量很大的情况下,最容易挂掉的就是Receiver所在的Executor了。 建议Spark-Streaming团队最好是能将数据写入到多个BlockManager上。 StorageLevel 的配置问题 另外还有几个值得注意的问题: 如果你配置成Memory_Disk ,如果Receiver所在的Executor一旦挂掉,你也歇菜了,整个Spark Streaming作业会失败。失败的原因是一部分block找不到了。 如果你配置成Memory_Disk_2,数据会被replication到不同的节点。一般而言不会出现作业失败或者丢数据。但解决不了Receiver也容易挂的问题,当然还是主要还是内存引起的。 最好是采用默认设置 MEMORY_AND_DISK_SER_2 比较靠谱些。 这里面还有一个风险点就是,如果某个batch processing延迟了,那么对应的BlockManager的数据不会被释放,然后下一个batch的数据还在进,也会加重内存问题。 动态控制消费速率以及相关论文 另外,spark的消费速度可以设置上限以外,亦可以根据processing time 来动态调整。通过 spark.streaming.backpressure.enabled 设置为true 可以打开。算法的论文可参考: Socc 2014: Adaptive Stream Processing using Dynamic Batch Sizing ,还是有用的,我现在也都开启着。 Spark里除了这个 Dynamic,还有一个就是Dynamic Allocation,也就是Executor数量会根据资源使用情况,自动伸缩。我其实蛮喜欢Spark这个特色的。具体的可以查找下相关设计文档。 后话 接下来一篇文章会讲一些解决方案。

优秀的个人博客,低调大师

Spark-zeppelin大数据可视化导入Mysql

Zeppelin是基于spark的数据可视化方案。支持scala语言,任何在spark上运行的job都可以在此平台上运行,此外支持对表数据的可视化。对数据源的可视化可以通过interpreter进行扩展,比如github中就有支持MySQL的interpreter。 下面着重介绍zeppelin notebook中代码书写: scala:使用此interpreter的好处是,可以将各个数据源的数据在同一张视图中进行展示。比如以下是对mysql,hive数据的混合展示: Load mysql表,并注册为spark sqlContext同样的表名: import java.util.Properties val properties = new Properties() val url = "..." properties.put("user", "...") properties.put("password", "...") properties.put("driver", "com.mysql.jdbc.Driver") val tables = "...,..." tables.split(",").foreach{mysql_table =>sqlContext.read.jdbc(url, mysql_table, properties).registerTempTable(mysql_table) } Hive数据可以直接进行load: sql(s""" SELECT ... FROM table where ...""").registerTempTable("hive_table") 对mysql,hive表进行混合查询,支持下拉框: sql(""select ... from """ + z.select("数据源", Seq(("""mysql_table1""","mysql table1数据"), ("""mysql_table2""","mysql table2数据"), ("""hive_table""","hive数据"))) + """ where ...""").registerTempTable("result") 效果: scala中可以使用以下方式对dataframe数据进行展示: val result = sql("select * from result").rdd.map { r => r.mkString("\t") }.collect().mkString("\n") println("%table dt\tvalue\n" + result)

优秀的个人博客,低调大师

Excel COPILOT( ) 函数的10大应用场景2

场景描述:客户送修设备时一般会附带故障具体描述,服务人员需要按照既定故障分类标准,识别、匹配相关描述以判定故障类型,再将设备分派给对应工程师检修。但客户故障描述语言形式多样,依靠人工将其精准归入标准化故障分类体系,不仅难度大、耗费时间。引入智能自动化处理方案,能够有效提升故障归类的准确率与整体服务处理效率。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册