首页 文章 精选 留言 我的

精选列表

搜索[文档识别],共10000篇文章
优秀的个人博客,低调大师

Apache Storm 官方文档 —— Trident Spouts

与一般的 Storm API 一样,spout 也是 Trident 拓扑的数据来源。不过,为了实现更复杂的功能服务,Trident Spout 在普通的 Storm Spout 之上另外提供了一些 API 接口。 数据源、数据流以及基于数据流更新 state(比如数据库)的操作,他们之间的耦合关系是不可避免的。Trident State一文中有这方面的详细解释,理解他们之间的这种联系对于理解 spout 的运作方式非常重要。 Trident 拓扑中的大部分 spout 都是非事务型 spout。在 Trident 拓扑中可以使用普通的IRichSpout接口来创建数据流: TridentTopology topology = new TridentTopology(); topology.newStream("myspoutid", new MyRichSpout()); Trident 拓扑中的所有 spout 都必须有一个唯一的标识,而且这个标识必须在整个 Storm 集群中都是唯一的。Trident 需要使用这个标识来存储 spout 从 ZooKeeper 中消费的元数据(metadata),包括 txid 以及其他相关的 spout 元数据。 你可以使用以下配置项来设置用于存储 spout 元数据的 ZooKeeper 地址(一般情况下不需要设置以下选项,因为 Storm 默认会直接使用集群的 ZooKeeper 服务器来存储数据 —— 译者注): transactional.zookeeper.servers:ZooKeeper 的服务器列表 transactional.zookeeper.port:ZooKeeper 集群的端口 transactional.zookeeper.root:元数据在 ZooKeeper 中存储的根目录。元数据会直接存储在该设置目录下。 管道 默认情况下,Trident 每次处理只一个 batch,知道该 batch 处理成功或者失败之后才会开始处理其他的 batch。你可以通过将 batch 管道化来提高吞吐率,降低每个 batch 的处理延时。同时处理的 batch 的最大数量可以通过topology.max.spout.pending来进行配置。 不过,即使在同时处理多个 batch 的情况下,Trident 也会按照 batch 的顺序来更新 state。例如,假如你正在处理一个将全局计数结果整合并更新到数据库中的任务,那么在你向数据库中更新 batch1 的计数结果时,你同时可以继续处理 batch2、batch3 甚至 batch10 的计数工作。不过,Trident 只会在 batch1 的 state 更新结束之后才会处理后续 batch 的 state 更新操作。这是实现恰好一次处理的语义的必要基础,我们已经在Trident State一文中讨论了这一点。 Trident spout 类型 下面列出了一些可用的 spout API 接口: ITridentSpout:这是最常用的 API,支持事务型和模糊事务型的语义实现。不过一般会根据需要使用它的某个已有的实现,而不是直接实现该接口。 IBatchSpout:非事务型 spout,每次会输出一个 batch 的 tuple。 IPartitionedTridentSpout:可以从分布式数据源(比如一个集群或者 Kafka 服务器)读取数据的事务型 spout。 OpaquePartitionedTridentSpout:可以从分布式数据源读取数据的模糊事务型 spout。 当然,正如这篇教程的开头提到的,除了这些 API 之外,你还可以使用普通的IRichSpout。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 容错性

本文通过问答的形式解释了 Storm 的容错性原理。 工作进程(worker)死亡时会发生什么? 工作进程死亡的时候,supervisor 会重新启动这个进程。如果在启动过程中仍然一直失败,并且无法向 Nimbus 发送心跳,Nimbus 就会将这个 worker 重新分配到其他机器上去。 节点故障时会发生什么? 一个节点(集群中的工作节点,非 Nimbus 所在服务器)故障时,该节点上所有的任务(tasks)都会超时,然后 Nimbus 在检测到超时后会将所有的这些任务重新分配到其他机器上去。 Nimbus 或者 Supervisor 的后台进程挂掉时会发生什么 Nimbus 和 Supervisor 的后台进程本身是设计为快速失败(无论何时发生了异常情况之后都会启动自毁操作)和无状态(所有的状态由 ZooKeeper 负责管理)的。正如配置 Storm 集群这篇文章中所述,Nimbus 和 Supervisor 的后台进程实际上是在后台监控工具的监控之下运行的。所以,如果 Nimbus 或者 Supervisor 进程挂掉,他们就会静默地自动重启。 值得一提的是,Nimbus 和 Supervisor 的故障不会影响任何工作进程。这一点与 Hadoop 形成了鲜明对比,在 Hadoop 中 JobTracker 的故障会导致所有正在运行的 job 运行失败(Hadoop 2.x 中引入的 Yarn 架构已经提升了 Hadoop 系统的稳定性,目前的架构并不会如这里所说的那么不堪——译者注)。 Nimbus 是系统的单故障点1吗? 如果你的 Nimbus 节点出现故障无法访问,集群中的 worker 仍然会继续保持运行。另外,此时 Supervisor 也仍然会正常工作,在 worker 挂掉时自动重启挂掉的进程。但是,由于缺少 Nimbus 的协调,worker 就不会在必要的时候重新分配到不同的机器中(看上去好像你丢失了一个 worker)。 所以这个问题的答案是,Nimbus 确实稍微有一点像 SPOF(单故障点,Single Point of Failure)。不过在实际应用中,Nimbus 的故障从来就不是什么问题。未来的开发计划中还会考虑让 Nimbus 具备更好的可用性。 Storm 是如何保障消息的完全处理的? 对于节点故障或者消息丢失的情况,Storm 提供了一套完善的机制保障所有的消息都能够得到正确处理。消息的可靠性保障一文中解释了这方面更多的技术细节。 1单故障点是指在一个系统中的某个在失效或停止运转后会导致整个系统不能工作的部件,具体概念可以参考维基百科。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 本地模式

本地模式是一种在本地进程中模拟 Storm 集群的工作模式,对于开发和测试拓扑很有帮助。在本地模式下运行拓扑与在集群模式下运行拓扑的方式很相似。 创建一个进程内的“集群”只需要使用LocalCluster类即可,例如: import backtype.storm.LocalCluster; LocalCluster cluster = new LocalCluster(); 随后,你就可以使用LocalCluster中的submitTopology方法来提交拓扑了。与StormSubmitter中相应的方法相似,submitTopology接收一个拓扑名称、拓扑配置以及拓扑对象作为输入参数。你也可以以拓扑名称为参数,使用killTopology方法来 kill 掉对应的拓扑。 使用以下语句关闭本地模式集群运行: cluster.shutdown(); 本地模式的常用配置 你可以在这里找到完整的配置项列表。以下是几个比较有用的配置项说明: Config.TOPOLOGY_MAX_TASK_PARALLELISM:该配置项设置了单个组件(bolt/spout)的线程数上限。生产环境下的拓扑往往含有很高的并行度(数百个线程),导致在本地模式下测试拓扑时会有较大的负载。这个配置项可以让你很容易地控制并行度。 Config.TOPOLOGY_DEBUG:此配置项设置为 true 时 Storm 会打印出 spout 或者 bolt 每一次发送消息的日志记录。这个功能对于调试拓扑很有用。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 基础概念

Storm 系统中包含以下几个基本概念: 拓扑(Topologies) 流(Streams) 数据源(Spouts) 数据流处理组件(Bolts) 数据流分组(Stream groupings) 可靠性(Reliability) 任务(Tasks) 工作进程(Workers) 译者注:由于 Storm 的几个基础概念无论是直译还是意译均不够清晰,而且还会让习惯了 Storm 编程模型的读者感到困惑,因此后文在提及这些概念时大多还会以英文原文出现,希望大家能够谅解。 拓扑(Topologies) Storm 的拓扑是对实时计算应用逻辑的封装,它的作用与 MapReduce 的任务(Job)很相似,区别在于 MapReduce 的一个 Job 在得到结果之后总会结束,而拓扑会一直在集群中运行,直到你手动去终止它。拓扑还可以理解成由一系列通过数据流(Stream Grouping)相互关联的 Spout 和 Bolt 组成的的拓扑结构。Spout 和 Bolt 称为拓扑的组件(Component)。我们会在后文中给出这些概念的解释。 相关资料 TopologyBuilder:在 Java 中使用此类构造拓扑 在生产环境中运行拓扑 本地模式:通过本文学习如何在本地模式中开发、测试拓扑 数据流(Streams) 数据流(Streams)是 Storm 中最核心的抽象概念。一个数据流指的是在分布式环境中并行创建、处理的一组元组(tuple)的无界序列。数据流可以由一种能够表述数据流中元组的域(fields)的模式来定义。在默认情况下,元组(tuple)包含有整型(Integer)数字、长整型(Long)数字、短整型(Short)数字、字节(Byte)、双精度浮点数(Double)、单精度浮点数(Float)、布尔值以及字节数组等基本类型对象。当然,你也可以通过定义可序列化的对象来实现自定义的元组类型。 在声明数据流的时候需要给数据流定义一个有效的 id。不过,由于在实际应用中使用最多的还是单一数据流的 Spout 与 Bolt,这种场景下不需要使用 id 来区分数据流,因此可以直接使用OutputFieldsDeclarer来定义“无 id”的数据流。实际上,系统默认会给这种数据流定义一个名为“default”的 id。 相关资料 元组(Tuple):数据流由多个元组构成 OutputFieldsDeclarer:用于声明数据流和数据流对应的模式 序列化(Serialization):关于 Storm 元组的动态类型以及声明自定义序列化模型的相关内容 ISerialization:自定义的序列化模型必须实现该接口 CONFIG.TOPOLOGY_SERIALIZATIONS:自定义的序列化模型可以通过这个配置项实现注册 数据源(Spouts) 数据源(Spout)是拓扑中数据流的来源。一般 Spout 会从一个外部的数据源读取元组然后将他们发送到拓扑中。根据需求的不同,Spout 既可以定义为可靠的数据源,也可以定义为不可靠的数据源。一个可靠的 Spout 能够在它发送的元组处理失败时重新发送该元组,以确保所有的元组都能得到正确的处理;相对应的,不可靠的 Spout 就不会在元组发送之后对元组进行任何其他的处理。 一个 Spout 可以发送多个数据流。为了实现这个功能,可以先通过OutputFieldsDeclarer的declareStream方法来声明定义不同的数据流,然后在发送数据时在SpoutOutputCollector的emit方法中将数据流 id 作为参数来实现数据发送的功能。 Spout 中的关键方法是nextTuple。顾名思义,nextTuple要么会向拓扑中发送一个新的元组,要么会在没有可发送的元组时直接返回。需要特别注意的是,由于 Storm 是在同一个线程中调用所有的 Spout 方法,nextTuple不能被 Spout 的任何其他功能方法所阻塞,否则会直接导致数据流的中断(关于这一点,阿里的 JStorm 修改了 Spout 的模型,使用不同的线程来处理消息的发送,这种做法有利有弊,好处在于可以更加灵活地实现 Spout,坏处在于系统的调度模型更加复杂,如何取舍还是要看具体的需求场景吧——译者注)。 Spout 中另外两个关键方法是ack和fail,他们分别用于在 Storm 检测到一个发送过的元组已经被成功处理或处理失败后的进一步处理。注意,ack和fail方法仅仅对上述“可靠的” Spout 有效。 相关资料 IRichSpout:这是实现 Spout 的接口 消息的可靠性处理 数据流处理组件(Bolts) 拓扑中所有的数据处理均是由 Bolt 完成的。通过数据过滤(filtering)、函数处理(functions)、聚合(aggregations)、联结(joins)、数据库交互等功能,Bolt 几乎能够完成任何一种数据处理需求。 一个 Bolt 可以实现简单的数据流转换,而更复杂的数据流变换通常需要使用多个 Bolt 并通过多个步骤完成。例如,将一个微博数据流转换成一个趋势图像的数据流至少包含两个步骤:其中一个 Bolt 用于对每个图片的微博转发进行滚动计数,另一个或多个 Bolt 将数据流输出为“转发最多的图片”结果(相对于使用2个Bolt,如果使用3个 Bolt 你可以让这种转换具有更好的可扩展性)。 与 Spout 相同,Bolt 也可以输出多个数据流。为了实现这个功能,可以先通过OutputFieldsDeclarer的declareStream方法来声明定义不同的数据流,然后在发送数据时在OutputCollector的emit方法中将数据流 id 作为参数来实现数据发送的功能。 在定义 Bolt 的输入数据流时,你需要从其他的 Storm 组件中订阅指定的数据流。如果你需要从其他所有的组件中订阅数据流,你就必须要在定义 Bolt 时分别注册每一个组件。对于声明为默认 id(即上文中提到的“default”——译者注)的数据流,InputDeclarer支持订阅此类数据流的语法糖。也就是说,如果需要订阅来自组件“1”的数据流,declarer.shuffleGrouping("1")与declarer.shuffleGrouping("1", DEFAULT_STREAM_ID)两种声明方式是等价的。 Bolt 的关键方法是execute方法。execute方法负责接收一个元组作为输入,并且使用OutputCollector对象发送新的元组。如果有消息可靠性保障的需求,Bolt 必须为它所处理的每个元组调用OutputCollector的ack方法,以便 Storm 能够了解元组是否处理完成(并且最终决定是否可以响应最初的 Spout 输出元组树)。一般情况下,对于每个输入元组,在处理之后可以根据需要选择不发送还是发送多个新元组,然后再响应(ack)输入元组。IBasicBolt接口能够实现元组的自动应答。 在 Bolt 中启动新线程来进行异步处理是一种非常好的方式,因为OutputCollector是线程安全的对象,可以在任意时刻被调用(此处译者保留意见,由于 Storm 的并发设计和集群的弹性扩展机制,在 Bolt 中新建的线程可能存在一定的不可控风险——译者注)。 请注意OutputCollector不是线程安全的对象,所有的 emit、ack 和 fail 操作都需要在同一个线程中进行处理。更多信息请参考问题与解决一文。 相关资料 IRichBolt:用于定义 Bolt 的基本接口 IBasicBolt: 用于定义带有过滤或者其他简单的函数操作功能的 Bolt 的简便接口 OutputCollector:Bolt 使用此类来发送数据流 消息的可靠性处理 数据流分组(Stream groupings) 为拓扑中的每个 Bolt 的确定输入数据流是定义一个拓扑的重要环节。数据流分组定义了在 Bolt 的不同任务(tasks)中划分数据流的方式。 在 Storm 中有八种内置的数据流分组方式(原文有误,现在已经已经有八种分组模型——译者注),而且你还可以通过CustomStreamGrouping接口实现自定义的数据流分组模型。这八种分组分时分别为: 随机分组(Shuffle grouping):这种方式下元组会被尽可能随机地分配到 Bolt 的不同任务(tasks)中,使得每个任务所处理元组数量能够能够保持基本一致,以确保集群的负载均衡。 域分组(Fields grouping):这种方式下数据流根据定义的“域”来进行分组。例如,如果某个数据流是基于一个名为“user-id”的域进行分组的,那么所有包含相同的“user-id”的元组都会被分配到同一个任务中,这样就可以确保消息处理的一致性。 部分关键字分组(Partial Key grouping):这种方式与域分组很相似,根据定义的域来对数据流进行分组,不同的是,这种方式会考虑下游 Bolt 数据处理的均衡性问题,在输入数据源关键字不平衡时会有更好的性能1。感兴趣的读者可以参考这篇论文,其中详细解释了这种分组方式的工作原理以及它的优点。 完全分组(All grouping):这种方式下数据流会被同时发送到 Bolt 的所有任务中(也就是说同一个元组会被复制多份然后被所有的任务处理),使用这种分组方式要特别小心。 全局分组(Global grouping):这种方式下所有的数据流都会被发送到 Bolt 的同一个任务中,也就是 id 最小的那个任务。 非分组(None grouping):使用这种方式说明你不关心数据流如何分组。目前这种方式的结果与随机分组完全等效,不过未来 Storm 社区可能会考虑通过非分组方式来让 Bolt 和它所订阅的 Spout 或 Bolt 在同一个线程中执行。 直接分组(Direct grouping):这是一种特殊的分组方式。使用这种方式意味着元组的发送者可以指定下游的哪个任务可以接收这个元组。只有在数据流被声明为直接数据流时才能够使用直接分组方式。使用直接数据流发送元组需要使用OutputCollector的其中一个emitDirect方法。Bolt 可以通过TopologyContext来获取它的下游消费者的任务 id,也可以通过跟踪OutputCollector的emit方法(该方法会返回它所发送元组的目标任务的 id)的数据来获取任务 id。 本地或随机分组(Local or shuffle grouping):如果在源组件的 worker 进程里目标 Bolt 有一个或更多的任务线程,元组会被随机分配到那些同进程的任务中。换句话说,这与随机分组的方式具有相似的效果。 相关资料 TopologyBuilder:使用此类构造拓扑 InputDeclarer:在TopologyBuilder中调用setBolt方法时会返回这个对象的实例,通过该对象就可以定义 Bolt 的输入数据流以及数据流的分组方式 CoordinatedBolt:这个 Bolt 主要用于分布式 RPC 拓扑,其中大量使用了直接数据流与直接分组模型 可靠性(Reliability) Storm 可以通过拓扑来确保每个发送的元组都能得到正确处理。通过跟踪由 Spout 发出的每个元组构成的元组树可以确定元组是否已经完成处理。每个拓扑都有一个“消息延时”参数,如果 Storm 在延时时间内没有检测到元组是否处理完成,就会将该元组标记为处理失败,并会在稍后重新发送该元组。 为了充分利用 Storm 的可靠性机制,你必须在元组树创建新结点的时候以及元组处理完成的时候通知 Storm。这个过程可以在 Bolt 发送元组时通过OutputCollector实现:在emit方法中实现元组的锚定(Anchoring),同时使用ack方法表明你已经完成了元组的处理。 关于可靠性保障的更多内容可以参考这篇文章:消息的可靠性处理。 任务(Tasks) 在 Storm 集群中每个 Spout 和 Bolt 都由若干个任务(tasks)来执行。每个任务都与一个执行线程相对应。数据流分组可以决定如何由一组任务向另一组任务发送元组。你可以在TopologyBuilder的setSpout方法和setBolt方法中设置 Spout/Bolt 的并行度。 工作进程(Workers) 拓扑是在一个或多个工作进程(worker processes)中运行的。每个工作进程都是一个实际的 JVM 进程,并且执行拓扑的一个子集。例如,如果拓扑的并行度定义为300,工作进程数定义为50,那么每个工作进程就会执行6个任务(进程内部的线程)。Storm 会在所有的 worker 中分散任务,以便实现集群的负载均衡。 相关资料 Config.TOPOLOGY_WORKERS:这个配置项用于设置拓扑的工作进程数 1Partial Key grouping 方式目前仅支持开发版,尚未加入 Storm 的正式发行版,不过可以通过CustomStreamGrouping间接实现该分组功能,具体的实现可以参考PartialKeyGrouping源代码。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark编程指南

Spark编程指南 概述 总体上来说,每个Spark应用都包含一个驱动器(driver)程序,驱动器运行用户的main函数,并在集群上执行各种并行操作。 Spark最重要的一个抽象概念就是弹性分布式数据集(resilient distributed dataset – RDD),RDD是一个可分区的元素集合,其包含的元素可以分布在集群各个节点上,并且可以执行一些分布式并行操作。RDD通常是通过,HDFS(或者其他Hadoop支持的文件系统)上的文件,或者驱动器中的Scala集合对象,来创建或转换得到;其次,用户也可以请求Spark将RDD持久化到内存里,以便在不同的并行操作里复用之;最后,RDD具备容错性,可以从节点失败中自动恢复数据。 Spark第二个重要抽象概念是共享变量,共享变量是一种可以在并行操作之间共享使用的变量。默认情况下,当Spark把一系列任务调度到不同节点上运行时,Spark会同时把每个变量的副本和任务代码一起发送给各个节点。但有时候,我们需要在任务之间,或者任务和驱动器之间共享一些变量。Spark提供了两种类型的共享变量:广播变量和累加器,广播变量可以用来在各个节点上缓存数据,而累加器则是用来执行跨节点的“累加”操作,例如:计数和求和。 本文将会使用Spark所支持的所有语言来展示Spark的特性。如果你能启动Spark的交互式shell动手实验一下,效果会更好(对scala请使用bin/spark-shell,而对于python,请使用bin/pyspark)。 链接Spark Scala Java Python Spark 1.6.0 使用了Scala 2.10。用Scala写应用的话,你需要使用一个兼容的Scala版本(如:2.10.X) 同时,如果你需要在maven中依赖Spark,可以用如下maven工件标识: groupId = org.apache.spark artifactId = spark-core_2.10 version = 1.6.0 另外,如果你需要访问特定版本的HDFS,那么你可能需要增加相应版本的hadoop-client依赖项,其maven工件标识如下: groupId = org.apache.hadoop artifactId = hadoop-client version = <your-hdfs-version> 最后,你需要如下,在你的代码里导入一些Spark class: import org.apache.spark.SparkContext import org.apache.spark.SparkConf (在Spark 1.3.0之前,你需要显示的import org.apache.spark.SparkContext._来启用这些重要的隐式转换) 初始化Spark Scala Java Python Spark应用程序需要做的第一件事就是创建一个SparkContext对象,SparkContext对象决定了Spark如何访问集群。而要新建一个SparkContext对象,你还得需要构造一个SparkConf对象,SparkConf对象包含了你的应用程序的配置信息。 每个JVM进程中,只能有一个活跃(active)的SparkContext对象。如果你非要再新建一个,那首先必须将之前那个活跃的SparkContext 对象stop()掉。 val conf = new SparkConf().setAppName(appName).setMaster(master) new SparkContext(conf) appName参数值是你的应用展示在集群UI上的应用名称。master参数值是Spark, Mesos or YARN cluster URL或者特殊的“local”(本地模式)。实际上,一般不应该将master参数值硬编码到代码中,而是应该用spark-submit脚本的参数来设置。然而,如果是本地测试或单元测试中,你可以直接在代码里给master参数写死一个”local”值。 使用shell Scala Python 在Spark shell中,默认已经为你新建了一个SparkContext对象,变量名为sc。所以spark-shell里不能自建SparkContext对象。你可以通过–master参数设置要连接到哪个集群,而且可以给–jars参数传一个逗号分隔的jar包列表,以便将这些jar包加到classpath中。你还可以通过–packages设置逗号分隔的maven工件列表,以便增加额外的依赖项。同样,还可以通过–repositories参数增加maven repository地址。下面是一个示例,在本地4个CPU core上运行的实例: $./bin/spark-shell –masterlocal[4] 或者,将code.jar添加到classpath下: $ ./bin/spark-shell --master local[4] --jars code.jar 通过maven标识添加依赖: $ ./bin/spark-shell --master local[4] --packages "org.example:example:0.1" spark-shell –help可以查看完整的选项列表。实际上,spark-shell是在后台调用spark-submit来实现其功能的(spark-submitscript.) 弹性分布式数据集(RDD) Spark的核心概念是弹性分布式数据集(RDD),RDD是一个可容错、可并行操作的分布式元素集合。总体上有两种方法可以创建RDD对象:由驱动程序中的集合对象通过并行化操作创建,或者从外部存储系统中数据集加载(如:共享文件系统、HDFS、HBase或者其他Hadoop支持的数据源)。 并行化集合 Scala Java Python 并行化集合是以一个已有的集合对象(例如:Scala Seq)为参数,调用 SparkContext.parallelize() 方法创建得到的RDD。集合对象中所有的元素都将被复制到一个可并行操作的分布式数据集中。例如,以下代码将一个1到5组成的数组并行化成一个RDD: val data = Array(1, 2, 3, 4, 5) val distData = sc.parallelize(data) 一旦创建成功,该分布式数据集(上例中的distData)就可以执行一些并行操作。如,distData.reduce((a, b) => a + b),这段代码会将集合中所有元素加和。后面我们还会继续讨论分布式数据集上的各种操作。 并行化集合的一个重要参数是分区(partition),即这个分布式数据集可以分割为多少片。Spark中每个任务(task)都是基于分区的,每个分区一个对应的任务(task)。典型场景下,一般每个CPU对应2~4个分区。并且一般而言,Spark会基于集群的情况,自动设置这个分区数。当然,你还是可以手动控制这个分区数,只需给parallelize方法再传一个参数即可(如:sc.parallelize(data, 10) )。注意:Spark代码里有些地方仍然使用分片(slice)这个术语,这只不过是分区的一个别名,主要为了保持向后兼容。 外部数据集 Scala Java Python Spark 可以通过Hadoop所支持的任何数据源来创建分布式数据集,包括:本地文件系统、HDFS、Cassandra、HBase、Amazon S3等。Spark 支持的文件格式包括:文本文件(text files)、SequenceFiles,以及其他Hadoop 支持的输入格式(InputFormat)。 文本文件创建RDD可以用 SparkContext.textFile 方法。这个方法输入参数是一个文件的URI(本地路径,或者 hdfs://,s3n:// 等),其输出RDD是一个文本行集合。以下是一个简单示例: scala> val distFile = sc.textFile("data.txt") distFile: RDD[String] = MappedRDD@1d4cee08 创建后,distFile 就可以执行数据集的一些操作。比如,我们可以把所有文本行的长度加和:distFile.map(s => s.length).reduce((a, b) => a + b) 以下是一些Spark读取文件的要点: 如果是本地文件系统,那么这个文件必须在所有的worker节点上能够以相同的路径访问到。所以要么把文件复制到所有worker节点上同一路径下,要么挂载一个共享文件系统。 所有Spark基于文件输入的方法(包括textFile)都支持输入参数为:目录,压缩文件,以及通配符。例如:textFile(“/my/directory”), textFile(“/my/directory/*.txt”), 以及 textFile(“/my/directory/*.gz”) textFile方法同时还支持一个可选参数,用以控制数据的分区个数。默认地,Spark会为文件的每一个block创建一个分区(HDFS上默认block大小为64MB),你可以通过调整这个参数来控制数据的分区数。注意,分区数不能少于block个数。 除了文本文件之外,Spark的Scala API还支持其他几种数据格式: SparkContext.wholeTextFiles 可以读取一个包含很多小文本文件的目录,并且以 (filename, content) 键值对的形式返回结果。这与textFile 不同,textFile只返回文件的内容,每行作为一个元素。 对于SequenceFiles,可以调用 SparkContext.sequenceFile[K, V],其中 K 和 V 分别是文件中key和value的类型。这些类型都应该是Writable接口的子类, 如:IntWritableandText等。另外,Spark 允许你为一些常用Writable指定原生类型,例如:sequenceFile[Int, String] 将自动读取 IntWritable 和 Text。 对于其他的Hadoop InputFormat,你可以用 SparkContext.hadoopRDD 方法,并传入任意的JobConf 对象和 InputFormat,以及key class、value class。这和设置Hadoop job的输入源是同样的方法。你还可以使用 SparkContext.newAPIHadoopRDD,该方法接收一个基于新版Hadoop MapReduce API (org.apache.hadoop.mapreduce)的InputFormat作为参数。 RDD.saveAsObjectFile 和 SparkContext.objectFile 支持将RDD中元素以Java对象序列化的格式保存成文件。虽然这种序列化方式不如Avro效率高,却为保存RDD提供了一种简便方式。 RDD算子 RDD支持两种类型的算子(operation):transformation算子 和 action算子;transformation算子可以将已有RDD转换得到一个新的RDD,而action算子则是基于数据集计算,并将结果返回给驱动器(driver)。例如,map是一个transformation算子,它将数据集中每个元素传给一个指定的函数,并将该函数返回结果构建为一个新的RDD;而 reduce是一个action算子,它可以将RDD中所有元素传给指定的聚合函数,并将最终的聚合结果返回给驱动器(还有一个reduceByKey算子,其返回的聚合结果是一个数据集)。 Spark中所有transformation算子都是懒惰的,也就是说,这些算子并不立即计算结果,而是记录下对基础数据集(如:一个数据文件)的转换操作。只有等到某个action算子需要计算一个结果返回给驱动器的时候,transformation算子所记录的操作才会被计算。这种设计使Spark可以运行得更加高效 – 例如,map算子创建了一个数据集,同时该数据集下一步会调用reduce算子,那么Spark将只会返回reduce的最终聚合结果(单独的一个数据)给驱动器,而不是将map所产生的数据集整个返回给驱动器。 默认情况下,每次调用action算子的时候,每个由transformation转换得到的RDD都会被重新计算。然而,你也可以通过调用persist(或者cache)操作来持久化一个RDD,这意味着Spark将会把RDD的元素都保存在集群中,因此下一次访问这些元素的速度将大大提高。同时,Spark还支持将RDD元素持久化到内存或者磁盘上,甚至可以支持跨节点多副本。 基础 Scala Java Python 以下简要说明一下RDD的基本操作,参考如下代码: val lines = sc.textFile("data.txt") val lineLengths = lines.map(s => s.length) val totalLength = lineLengths.reduce((a, b) => a + b) 其中,第一行是从外部文件加载数据,并创建一个基础RDD。这时候,数据集并没有加载进内存除非有其他操作施加于lines,这时候的lines RDD其实可以说只是一个指向 data.txt 文件的指针。第二行,用lines通过map转换得到一个lineLengths RDD,同样,lineLengths也是懒惰计算的。最后,我们使用 reduce算子计算长度之和,reduce是一个action算子。此时,Spark将会把计算分割为一些小的任务,分别在不同的机器上运行,每台机器上都运行相关的一部分map任务,并在本地进行reduce,并将这些reduce结果都返回给驱动器。 如果我们后续需要重复用到 lineLengths RDD,我们可以增加一行: lineLengths.persist() 这一行加在调用 reduce 之前,则 lineLengths RDD 首次计算后,Spark会将其数据保存到内存中。 将函数传给Spark Scala Java Python Spark的API 很多都依赖于在驱动程序中向集群传递操作函数。以下是两种建议的实现方式: 匿名函数(Anonymous function syntax),这种方式代码量比较少。 全局单件中的静态方法。例如,你可以按如下方式定义一个 object MyFunctions 并传递其静态成员函数 MyFunctions.func1: object MyFunctions { def func1(s: String): String = { ... } } myRdd.map(MyFunctions.func1) 注意,技术上来说,你也可以传递一个类对象实例上的方法(不是单件对象),不过这回导致传递函数的同时,需要把相应的对象也发送到集群中各节点上。例如,我们定义一个MyClass如下: class MyClass { def func1(s: String): String = { ... } def doStuff(rdd: RDD[String]): RDD[String] = { rdd.map(func1) } } 如果我们 new MyClass 创建一个实例,并调用其 doStuff 方法,同时doStuff中的 map算子引用了该MyClass实例上的 func1 方法,那么接下来,这个MyClass对象将被发送到集群中所有节点上。rdd.map(x => this.func1(x)) 也会有类似的效果。 类似地,如果应用外部对象的成员变量,也会导致对整个对象实例的引用: class MyClass { val field = "Hello" def doStuff(rdd: RDD[String]): RDD[String] = { rdd.map(x => field + x) } } 上面的代码对field的引用等价于 rdd.map(x => this.field + x),这将导致应用整个this对象。为了避免类似问题,最简单的方式就是,将field固执到一个本地临时变量中,而不是从外部直接访问之,如下: def doStuff(rdd: RDD[String]): RDD[String] = { val field_ = this.field rdd.map(x => field_ + x) } 理解闭包 Spark里一个比较难的事情就是,理解在整个集群上跨节点执行的变量和方法的作用域以及生命周期。Spark里一个频繁出现的问题就是RDD算子在变量作用域之外修改了其值。下面的例子,我们将会以foreach() 算子为例,来递增一个计数器counter,不过类似的问题在其他算子上也会出现。 示例 考虑如下例子,我们将会计算RDD中原生元素的总和,如果不是在同一个JVM中执行,其表现将有很大不同。例如,这段代码如果使用Spark本地模式(–master=local[n])运行,和在集群上运行(例如,用spark-submit提交到YARN上)结果完全不同。 Scala Java Python var counter = 0 var rdd = sc.parallelize(data) // Wrong: Don't do this!! rdd.foreach(x => counter += x) println("Counter value: " + counter) 本地模式 v.s. 集群模式 上面这段代码其行为是不确定的。在本地模式下运行,所有代码都在运行于单个JVM中,所以RDD的元素都能够被累加并保存到counter变量中,这是因为本地模式下,counter变量和驱动器节点在同一个内存空间中。 然而,在集群模式下,情况会更复杂,以上代码的运行结果就不是所预期的结果了。为了执行这个作业,Spark会将RDD算子的计算过程分割成多个独立的任务(task)- 每个任务分发给不同的执行器(executor)去执行。而执行之前,Spark需要计算闭包。闭包是由执行器执行RDD算子(本例中的foreach())时所需要的变量和方法组成的。闭包将会被序列化,并发送给每个执行器。由于本地模式下,只有一个执行器,所有任务都共享同样的闭包。而在其他模式下,情况则有所不同,每个执行器都运行于不同的worker节点,并且都拥有独立的闭包副本。 在上面的例子中,闭包中的变量会跟随不同的闭包副本,发送到不同的执行器上,所以等到foreach真正在执行器上运行时,其引用的counter已经不再是驱动器上所定义的那个counter副本了,驱动器内存中仍然会有一个counter变量副本,但是这个副本对执行器是不可见的!执行器只能看到其所收到的序列化闭包中包含的counter副本。因此,最终驱动器上得到的counter将会是0。 为了确保类似这样的场景下,代码能有确定的行为,这里应该使用累加器(Accumulator)。累加器是Spark中专门用于集群跨节点分布式执行计算中,安全地更新同一变量的机制。本指南中专门有一节详细说明累加器。 通常来说,闭包(由循环或本地方法组成),不应该改写全局状态。Spark中改写闭包之外对象的行为是未定义的。这种代码,有可能在本地模式下能正常工作,但这只是偶然情况,同样的代码在分布式模式下其行为很可能不是你想要的。所以,如果需要全局聚合,请记得使用累加器(Accumulator)。 打印RDD中的元素 另一种常见习惯是,试图用 rdd.foreach(println) 或者 rdd.map(println) 来打印RDD中所有的元素。如果是在单机上,这种写法能够如预期一样,打印出RDD所有元素。然后,在集群模式下,这些输出将会被打印到执行器的标准输出(stdout)上,因此驱动器的标准输出(stdout)上神马也看不到!如果真要在驱动器上把所有RDD元素都打印出来,你可以先调用collect算子,把RDD元素先拉倒驱动器上来,代码可能是这样:rdd.collect().foreach(println)。不过如果RDD很大的话,有可能导致驱动器内存溢出,因为collect会把整个RDD都弄到驱动器所在单机上来;如果你只是需要打印一部分元素,那么take是不更安全的选择:rdd.take(100).foreach(println) 使用键值对 Scala Java Python 大部分Spark算子都能在包含任意类型对象的RDD上工作,但也有一部分特殊的算子要求RDD包含的元素必须是键值对(key-value pair)。这种算子常见于做分布式混洗(shuffle)操作,如:以key分组或聚合。 在Scala中,这种操作在包含Tuple2(内建与scala语言,可以这样创建:(a, b) )类型对象的RDD上自动可用。键值对操作是在PairRDDFunctions类上可用,这个类型也会自动包装到包含tuples的RDD上。 例如,以下代码将使用reduceByKey算子来计算文件中每行文本出现的次数: val lines = sc.textFile("data.txt") val pairs = lines.map(s => (s, 1)) val counts = pairs.reduceByKey((a, b) => a + b) 同样,我们还可以用 counts.sortByKey() 来对这些键值对按字母排序,最后再用 counts.collect() 将数据以对象数据组的形式拉到驱动器内存中。 注意:如果使用自定义类型对象做键值对中的key的话,你需要确保自定义类型实现了 equals() 方法(通常需要同时也实现hashCode()方法)。完整的细节可以参考:Object.hashCode() documentation 转换算子 – transformation 以下是Spark支持的一些常用transformation算子。详细请参考RDD API doc (Scala,Java,Python,R) 以及 键值对 RDD 函数 (Scala,Java) 。 transformation算子 作用 map(func) 返回一个新的分布式数据集,其中每个元素都是由源RDD中一个元素经func转换得到的。 filter(func) 返回一个新的数据集,其中包含的元素来自源RDD中元素经func过滤后(func返回true时才选中)的结果 flatMap(func) 类似于map,但每个输入元素可以映射到0到n个输出元素(所以要求func必须返回一个Seq而不是单个元素) mapPartitions(func) 类似于map,但基于每个RDD分区(或者数据block)独立运行,所以如果RDD包含元素类型为T,则 func 必须是 Iterator<T> => Iterator<U> 的映射函数。 mapPartitionsWithIndex(func) 类似于 mapPartitions,只是func 多了一个整型的分区索引值,因此如果RDD包含元素类型为T,则func 必须是 Iterator<T> => Iterator<U> 的映射函数。 sample(withReplacement,fraction,seed) 采样部分(比例取决于fraction)数据,同时可以指定是否使用回置采样(withReplacement),以及随机数种子(seed) union(otherDataset) 返回源数据集和参数数据集(otherDataset)的并集 intersection(otherDataset) 返回源数据集和参数数据集(otherDataset)的交集 distinct([numTasks])) 返回对源数据集做元素去重后的新数据集 groupByKey([numTasks]) 只对包含键值对的RDD有效,如源RDD包含 (K, V) 对,则该算子返回一个新的数据集包含 (K, Iterable<V>) 对。 注意:如果你需要按key分组聚合的话(如sum或average),推荐使用 reduceByKey或者 aggregateByKey 以获得更好的性能。 注意:默认情况下,输出计算的并行度取决于源RDD的分区个数。当然,你也可以通过设置可选参数 numTasks 来指定并行任务的个数。 reduceByKey(func, [numTasks]) 如果源RDD包含元素类型(K, V) 对,则该算子也返回包含(K, V) 对的RDD,只不过每个key对应的value是经过func聚合后的结果,而func本身是一个 (V, V) => V 的映射函数。 另外,和 groupByKey 类似,可以通过可选参数numTasks指定reduce任务的个数。 aggregateByKey(zeroValue)(seqOp,combOp, [numTasks]) 如果源RDD包含 (K, V) 对,则返回新RDD包含 (K, U) 对,其中每个key对应的value都是由combOp函数 和 一个“0”值zeroValue聚合得到。允许聚合后value类型和输入value类型不同,避免了不必要的开销。和 groupByKey 类似,可以通过可选参数numTasks指定reduce任务的个数。 sortByKey([ascending], [numTasks]) 如果源RDD包含元素类型(K, V) 对,其中K可排序,则返回新的RDD包含 (K, V) 对,并按照 K 排序(升序还是降序取决于ascending参数) join(otherDataset, [numTasks]) 如果源RDD包含元素类型(K, V) 且参数RDD(otherDataset)包含元素类型(K, W),则返回的新RDD中将包含内关联后key对应的 (K, (V, W)) 对。外关联(Outer joins)操作请参考 leftOuterJoin、rightOuterJoin 以及 fullOuterJoin 算子。 cogroup(otherDataset, [numTasks]) 如果源RDD包含元素类型(K, V) 且参数RDD(otherDataset)包含元素类型(K, W),则返回的新RDD中包含 (K, (Iterable<V>, Iterable<W>))。该算子还有个别名:groupWith cartesian(otherDataset) 如果源RDD包含元素类型 T 且参数RDD(otherDataset)包含元素类型 U,则返回的新RDD包含前二者的笛卡尔积,其元素类型为 (T, U) 对。 pipe(command,[envVars]) 以shell命令行管道处理RDD的每个分区,如:Perl 或者 bash 脚本。 RDD中每个元素都将依次写入进程的标准输入(stdin),然后按行输出到标准输出(stdout),每一行输出字符串即成为一个新的RDD元素。 coalesce(numPartitions) 将RDD的分区数减少到numPartitions。当以后大数据集被过滤成小数据集后,减少分区数,可以提升效率。 repartition(numPartitions) 将RDD数据重新混洗(reshuffle)并随机分布到新的分区中,使数据分布更均衡,新的分区个数取决于numPartitions。该算子总是需要通过网络混洗所有数据。 repartitionAndSortWithinPartitions(partitioner) 根据partitioner(spark自带有HashPartitioner和RangePartitioner等)重新分区RDD,并且在每个结果分区中按key做排序。这是一个组合算子,功能上等价于先 repartition 再在每个分区内排序,但这个算子内部做了优化(将排序过程下推到混洗同时进行),因此性能更好。 动作算子 – action 以下是Spark支持的一些常用action算子。详细请参考RDD API doc (Scala,Java,Python,R) 以及 键值对 RDD 函数 (Scala,Java) 。 Action算子 作用 reduce(func) 将RDD中元素按func进行聚合(func是一个 (T,T) => T 的映射函数,其中T为源RDD元素类型,并且func需要满足交换律 和 结合律以便支持并行计算) collect() 将数据集中所有元素以数组形式返回驱动器(driver)程序。通常用于,在RDD进行了filter或其他过滤操作后,将一个足够小的数据子集返回到驱动器内存中。 count() 返回数据集中元素个数 first() 返回数据集中首个元素(类似于 take(1) ) take(n) 返回数据集中前n个元素 takeSample(withReplacement,num, [seed]) 返回数据集的随机采样子集,最多包含num个元素,withReplacement表示是否使用回置采样,最后一个参数为可选参数seed,随机数生成器的种子。 takeOrdered(n,[ordering]) 按元素排序(可以通过 ordering 自定义排序规则)后,返回前n个元素 saveAsTextFile(path) 将数据集中元素保存到指定目录下的文本文件中(或者多个文本文件),支持本地文件系统、HDFS 或者其他任何Hadoop支持的文件系统。 保存过程中,Spark会调用每个元素的toString方法,并将结果保存成文件中的一行。 saveAsSequenceFile(path) (Java and Scala) 将数据集中元素保存到指定目录下的Hadoop Sequence文件中,支持本地文件系统、HDFS 或者其他任何Hadoop支持的文件系统。适用于实现了Writable接口的键值对RDD。在Scala中,同样也适用于能够被隐式转换为Writable的类型(Spark实现了所有基本类型的隐式转换,如:Int,Double,String 等) saveAsObjectFile(path) (Java and Scala) 将RDD元素以Java序列化的格式保存成文件,保存结果文件可以使用 SparkContext.objectFile 来读取。 countByKey() 只适用于包含键值对(K, V)的RDD,并返回一个哈希表,包含 (K, Int) 对,表示每个key的个数。 foreach(func) 在RDD的每个元素上运行 func 函数。通常被用于累加操作,如:更新一个累加器(Accumulator) 或者 和外部存储系统互操作。 注意:用 foreach 操作出累加器之外的变量可能导致未定义的行为。更详细请参考前面的“理解闭包”(Understanding closures)这一小节。 混洗操作 有一些Spark算子会触发众所周知的混洗(Shuffle)事件。Spark中的混洗机制是用于将数据重新分布,其结果是所有数据将在各个分区间重新分组。一般情况下,混洗需要跨执行器(executor)或跨机器复制数据,这也是混洗操作一般都比较复杂而且开销大的原因。 背景 为了理解混洗阶段都发生了哪些事,我首先以reduceByKey算子为例来看一下。reduceByKey算子会生成一个新的RDD,将源RDD中一个key对应的多个value组合进一个tuple - 然后将这些values输入给reduce函数,得到的result再和key关联放入新的RDD中。这个算子的难点在于对于某一个key来说,并非其对应的所有values都在同一个分区(partition)中,甚至有可能都不在同一台机器上,但是这些values又必须放到一起计算reduce结果。 在Spark中,通常是由于为了进行某种计算操作,而将数据分布到所需要的各个分区当中。而在计算阶段,单个任务(task)只会操作单个分区中的数据 – 因此,为了组织好每个reduceByKey中reduce任务执行时所需的数据,Spark需要执行一个多对多操作。即,Spark需要读取RDD的所有分区,并找到所有key对应的所有values,然后跨分区传输这些values,并将每个key对应的所有values放到同一分区,以便后续计算各个key对应values的reduce结果 – 这个过程就叫做混洗(Shuffle)。 虽然混洗好后,各个分区中的元素和分区自身的顺序都是确定的,但是分区中元素的顺序并非确定的。如果需要混洗后分区内的元素有序,可以参考使用以下混洗操作: mapPartitions 使用 .sorted 对每个分区排序 repartitionAndSortWithinPartitions重分区的同时,对分区进行排序,比自行组合repartition和sort更高效 sortBy 创建一个全局有序的RDD 会导致混洗的算子有:重分区(repartition)类算子,如:repartition和coalesce;ByKey类算子(除了计数类的,如 countByKey) 如:groupByKey和reduceByKey;以及Join类算子,如:cogroup和join. 性能影响 混洗(Shuffle)之所以开销大,是因为混洗操作需要引入磁盘I/O,数据序列化以及网络I/O等操作。为了组织好混洗数据,Spark需要生成对应的任务集 – 一系列map任务用于组织数据,再用一系列reduce任务来聚合数据。注意这里的map、reduce是来自MapReduce的术语,和Spark的map、reduce算子并没有直接关系。 在Spark内部,单个map任务的输出会尽量保存在内存中,直至放不下为止。然后,这些输出会基于目标分区重新排序,并写到一个文件里。在reduce端,reduce任务只读取与之相关的并已经排序好的blocks。 某些混洗算子会导致非常明显的内存开销增长,因为这些算子需要在数据传输前后,在内存中维护组织数据记录的各种数据结构。特别地,reduceByKey和aggregateByKey都会在map端创建这些数据结构,而ByKey系列算子都会在reduce端创建这些数据结构。如果数据在内存中存不下,Spark会把数据吐到磁盘上,当然这回导致额外的磁盘I/O以及垃圾回收的开销。 混洗还会再磁盘上生成很多临时文件。以Spark-1.3来说,这些临时文件会一直保留到其对应的RDD被垃圾回收才删除。之所以这样做,是因为如果血统信息需要重新计算的时候,这些混洗文件可以不必重新生成。如果程序持续引用这些RDD或者垃圾回收启动频率较低,那么这些垃圾回收可能需要等较长的一段时间。这就意味着,长时间运行的Spark作业可能会消耗大量的磁盘。Spark的临时存储目录,是由spark.local.dir 配置参数指定的。 混洗行为可以由一系列配置参数来调优。参考Spark配置指南(Spark Configuration Guide)中“混洗行为”这一小节。 RDD持久化 Spark的一项关键能力就是它可以持久化(或者缓存)数据集在内存中,从而跨操作复用这些数据集。如果你持久化了一个RDD,那么每个节点上都会存储该RDD的一些分区,这些分区是由对应的节点计算出来并保持在内存中,后续可以在其他施加在该RDD上的action算子中复用(或者从这些数据集派生新的RDD)。这使得后续动作的速度提高很多(通常高于10倍)。因此,缓存对于迭代算法和快速交互式分析是一个很关键的工具。 你可以用persist() 或者 cache() 来标记一下需要持久化的RDD。等到该RDD首次被施加action算子的时候,其对应的数据分区就会被保留在内存里。同时,Spark的缓存具备一定的容错性 – 如果RDD的任何一个分区丢失了,Spark将自动根据其原来的血统信息重新计算这个分区。 另外,每个持久化的RDD可以使用不同的存储级别,比如,你可以把RDD保存在磁盘上,或者以java序列化对象保存到内存里(为了省空间),或者跨节点多副本,或者使用Tachyon存到虚拟机以外的内存里。这些存储级别都可以由persist()的参数StorageLevel对象来控制。cache() 方法本身就是一个使用默认存储级别做持久化的快捷方式,默认存储级别是 StorageLevel.MEMORY_ONLY(以java序列化方式存到内存里)。完整的存储级别列表如下: 存储级别 含义 MEMORY_ONLY 以未序列化的Java对象形式将RDD存储在JVM内存中。如果RDD不能全部装进内存,那么将一部分分区缓存,而另一部分分区将每次用到时重新计算。这个是Spark的RDD的默认存储级别。 MEMORY_AND_DISK 以未序列化的Java对象形式存储RDD在JVM中。如果RDD不能全部装进内存,则将不能装进内存的分区放到磁盘上,然后每次用到的时候从磁盘上读取。 MEMORY_ONLY_SER 以序列化形式存储RDD(每个分区一个字节数组)。通常这种方式比未序列化存储方式要更省空间,尤其是如果你选用了一个比较好的序列化协议(fast serializer),但是这种方式也相应的会消耗更多的CPU来读取数据。 MEMORY_AND_DISK_SER 和MEMORY_ONLY_SER类似,只是当内存装不下的时候,会将分区的数据吐到磁盘上,而不是每次用到都重新计算。 DISK_ONLY RDD数据只存储于磁盘上。 MEMORY_ONLY_2, MEMORY_AND_DISK_2, etc. 和上面没有”_2″的级别相对应,只不过每个分区数据会在两个节点上保存两份副本。 OFF_HEAP (实验性的) 将RDD以序列化格式保存到Tachyon。与MEMORY_ONLY_SER相比,OFF_HEAP减少了垃圾回收开销,并且使执行器(executor)进程更小且可以共用同一个内存池,这一特性在需要大量消耗内存和多Spark应用并发的场景下比较吸引人。而且,因为RDD存储于Tachyon中,所以一个执行器挂了并不会导致数据缓存的丢失。这种模式下Tachyon 的内存是可丢弃的。因此,Tachyon并不会重建一个它逐出内存的block。如果你打算用Tachyon做为堆外存储,Spark和Tachyon具有开箱即用的兼容性。请参考这里,有建议使用的Spark和Tachyon的匹配版本对:page。 注意:在Python中存储的对象总是会使用Pickle做序列化,所以这时是否选择一个序列化级别已经无关紧要了。 Spark会自动持久化一些混洗操作(如:reduceByKey)的中间数据,即便用户根本没有调用persist。这么做是为了避免一旦有一个节点在混洗过程中失败,就要重算整个输入数据。当然,我们还是建议对需要重复使用的RDD调用其persist算子。 如何选择存储级别? Spark的存储级别主要可于在内存使用和CPU占用之间做一些权衡。建议根据以下步骤来选择一个合适的存储级别: 如果RDD能使用默认存储级别(MEMORY_ONLY),那就尽量使用默认级别。这是CPU效率最高的方式,所有RDD算子都能以最快的速度运行。 如果步骤1的答案是否(不适用默认级别),那么可以尝试MEMORY_ONLY_SER级别,并选择一个高效的序列化协议(selecting a fast serialization library),这回大大节省数据对象的存储空间,同时速度也还不错。 尽量不要把数据吐到磁盘上,除非:1.你的数据集重新计算的代价很大;2.你的数据集是从一个很大的数据源中过滤得到的结果。否则的话,重算一个分区的速度很可能和从磁盘上读取差不多。 如果需要支持容错,可以考虑使用带副本的存储级别(例如:用Spark来服务web请求)。所有的存储级别都能够以重算丢失数据的方式来提供容错性,但是带副本的存储级别可以让你的应用持续的运行,而不必等待重算丢失的分区。 在一些需要大量内存或者并行多个应用的场景下,实验性的OFF_HEAP会有以下几个优势: 这个级别下,可以允许多个执行器共享同一个Tachyon中内存池。 可以有效地减少垃圾回收的开销。 即使单个执行器挂了,缓存数据也不会丢失。 删除数据 Spark能够自动监控各个节点上缓存使用率,并且以LRU(最近经常使用)的方式将老数据逐出内存。如果你更喜欢手动控制的话,可以用RDD.unpersist() 方法来删除无用的缓存。 共享变量 一般而言,当我们给Spark算子(如 map 或 reduce)传递一个函数时,这些函数将会在远程的集群节点上运行,并且这些函数所引用的变量都是各个节点上的独立副本。这些变量都会以副本的形式复制到各个机器节点上,如果更新这些变量副本的话,这些更新并不会传回到驱动器(driver)程序。通常来说,支持跨任务的可读写共享变量是比较低效的。不过,Spark还是提供了两种比较通用的共享变量:广播变量和累加器。 广播变量 广播变量提供了一种只读的共享变量,它是把在每个机器节点上保存一个缓存,而不是每个任务保存一份副本。通常可以用来在每个节点上保存一个较大的输入数据集,这要比常规的变量副本更高效(一般的变量是每个任务一个副本,一个节点上可能有多个任务)。Spark还会尝试使用高效的广播算法来分发广播变量,以减少通信开销。 Spark的操作有时会有多个阶段(stage),不同阶段之间的分割线就是混洗操作。Spark会自动广播各个阶段用到的公共数据。这些方式广播的数据都是序列化过的,并且在运行各个任务前需要反序列化。这也意味着,显示地创建广播变量,只有在跨多个阶段(stage)的任务需要同样的数据 或者 缓存数据的序列化和反序列化格式很重要的情况下才是必须的。 广播变量可以通过一个变量v来创建,只需调用 SparkContext.broadcast(v)即可。这个广播变量是对变量v的一个包装,要访问其值,可以调用广播变量的 value 方法。代码示例如下: Scala Java Python scala> val broadcastVar = sc.broadcast(Array(1, 2, 3)) broadcastVar: org.apache.spark.broadcast.Broadcast[Array[Int]] = Broadcast(0) scala> broadcastVar.value res0: Array[Int] = Array(1, 2, 3) 广播变量创建之后,集群中任何函数都不应该再使用原始变量v,这样才能保证v不会被多次复制到同一个节点上。另外,对象v在广播后不应该再被更新,这样才能保证所有节点上拿到同样的值(例如,更新后,广播变量又被同步到另一新节点,新节点有可能得到的值和其他节点不一样)。 累加器 累加器是一种只支持满足结合律的“累加”操作的变量,因此它可以很高效地支持并行计算。利用累加器可以实现计数(类似MapReduce中的计数器)或者求和。Spark原生支持了数字类型的累加器,开发者也可以自定义新的累加器。如果创建累加器的时候给了一个名字,那么这个名字会展示在Spark UI上,这对于了解程序运行处于哪个阶段非常有帮助(注意:Python尚不支持该功能)。 创捷累加器时需要赋一个初始值v,调用 SparkContext.accumulator(v) 可以创建一个累加器。后续集群中运行的任务可以使用 add 方法 或者 += 操作符 (仅Scala和Python支持)来进行累加操作。不过,任务本身并不能读取累加器的值,只有驱动器程序可以用 value 方法访问累加器的值。 以下代码展示了如何使用累加器对一个元素数组求和: Scala Java Python scala> val accum = sc.accumulator(0, "My Accumulator") accum: spark.Accumulator[Int] = 0 scala> sc.parallelize(Array(1, 2, 3, 4)).foreach(x => accum += x) ... 10/09/29 18:41:08 INFO SparkContext: Tasks finished in 0.317106 s scala> accum.value res2: Int = 10 以上代码使用了Spark内建支持的Int型累加器,开发者也可以通过子类化AccumulatorParam来自定义累加器。累加器接口(AccumulatorParam)主要有两个方法:1. zero:这个方法为累加器提供一个“零值”,2.addInPlace 将收到的两个参数值进行累加。例如,假设我们需要为Vector提供一个累加机制,那么可能的实现方式如下: object VectorAccumulatorParam extends AccumulatorParam[Vector] { def zero(initialValue: Vector): Vector = { Vector.zeros(initialValue.size) } def addInPlace(v1: Vector, v2: Vector): Vector = { v1 += v2 } } // Then, create an Accumulator of this type: val vecAccum = sc.accumulator(new Vector(...))(VectorAccumulatorParam) 如果使用Scala,Spark还支持几种更通用的接口:1.Accumulable,这个接口可以支持所累加的数据类型与结果类型不同(如:构建一个收集元素的list);2.SparkContext.accumulableCollection 方法可以支持常用的Scala集合类型。 对于在action算子中更新的累加器,Spark保证每个任务对累加器的更新只会被应用一次,例如,某些任务如果重启过,则不会再次更新累加器。而如果在transformation算子中更新累加器,那么用户需要注意,一旦某个任务因为失败被重新执行,那么其对累加器的更新可能会实施多次。 累加器并不会改变Spark懒惰求值的运算模型。如果在RDD算子中更新累加器,那么其值只会在RDD做action算子计算的时候被更新一次。因此,在transformation算子(如:map)中更新累加器,其值并不能保证一定被更新。以下代码片段说明了这一特性: Scala Java Python val accum = sc.accumulator(0) data.map { x => accum += x; f(x) } // 这里,accum任然是0,因为没有action算子,所以map也不会进行实际的计算 部署到集群 应用提交指南(application submission guide)中描述了如何向集群提交应用。换句话说,就是你需要把你的应用打包成 JAR文件(Java/Scala)或者一系列 .py 或 .zip 文件(Python),然后再用 bin/spark-submit 脚本将其提交给Spark所支持的集群管理器。 从Java/Scala中启动Spark作业 org.apache.spark.launcher包提供了简明的Java API,可以将Spark作业作为子进程启动。 单元测试 Spark对所有常见的单元测试框架提供友好的支持。你只需要在测试中创建一个SparkContext对象,然后吧master URL设为local,运行测试操作,最后调用 SparkContext.stop() 来停止测试。注意,一定要在 finally 代码块或者单元测试框架的 tearDown方法里调用SparkContext.stop(),因为Spark不支持同一程序中有多个SparkContext对象同时运行。 从1.0之前版本迁移过来 Scala Java Python Spark 1.0 冻结了Spark Core 1.x 系列的核心API,只要是没有标记为 “experimental” 或者 “developer API”的API,在未来的版本中会一直支持。对于Scala用户来说,唯一的变化就是分组相关的算子,如:groupByKey, cogroup, join,这些算子的返回类型由 (Key, Seq[Value]) 变为 (Key, Iterable[Value])。 更详细迁移向导请参考这里:Spark Streaming,MLlib以及GraphX. 下一步 你可以去Spark的官网上看看示例程序(example Spark programs)。另外,Spark代码目录下也自带了不少例子,见 examples 目录(Scala,Java,Python,R)。你可以把示例中的类名传给 bin/run-example 脚本来运行这些例子;例如: ./bin/run-example SparkPi 如果需要运行Python示例,则需要使用 spark-submit 脚本: ./bin/spark-submit examples/src/main/python/pi.py 对R语言,同样也需要使用 spark-submit: ./bin/spark-submit examples/src/main/r/dataframe.R 配置(configuration)和调优(tuning)指南提供了不少最佳实践的信息,可以帮助你优化程序,特别是这些信息可以帮助你确保数据以一种高效的格式保存在内存里。集群模式概览(cluster mode overview)这篇文章描述了分布式操作中相关的组件,以及Spark所支持的各种集群管理器。 最后,完整的API文件见:Scala,Java,Python以及R. 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark配置(一)

Spark配置 Spark有以下三种方式修改配置: Spark properties(Spark属性)可以控制绝大多数应用程序参数,而且既可以通过SparkConf对象来设置,也可以通过Java系统属性来设置。 Environment variables(环境变量)可以指定一些各个机器相关的设置,如IP地址,其设置方法是写在每台机器上的conf/spark-env.sh中。 Logging(日志)可以通过log4j.properties配置日志。 Spark属性 Spark属性可以控制大多数的应用程序设置,并且每个应用的设定都是分开的。这些属性可以用SparkConf对象直接设定。SparkConf为一些常用的属性定制了专用方法(如,master URL和application name),其他属性都可以用键值对做参数,调用set()方法来设置。例如,我们可以初始化一个包含2个本地线程的Spark应用,代码如下: 注意,local[2]代表2个本地线程 – 这是最小的并发方式,可以帮助我们发现一些只有在分布式上下文才能复现的bug。 val conf = new SparkConf() .setMaster("local[2]") .setAppName("CountingSheep") val sc = new SparkContext(conf) 注意,本地模式下,我们可以使用n个线程(n >= 1)。而且在像Spark Streaming这样的场景下,我们可能需要多个线程来防止类似线程饿死这样的问题。 配置时间段的属性应该写明时间单位,如下格式都是可接受的: 25ms (milliseconds) 5s (seconds) 10m or 10min (minutes) 3h (hours) 5d (days) 1y (years) 配置大小的属性也应该写明单位,如下格式都是可接受的: 1b (bytes) 1k or 1kb (kibibytes = 1024 bytes) 1m or 1mb (mebibytes = 1024 kibibytes) 1g or 1gb (gibibytes = 1024 mebibytes) 1t or 1tb (tebibytes = 1024 gibibytes) 1p or 1pb (pebibytes = 1024 tebibytes) 动态加载Spark属性 在某些场景下,你可能需要避免将属性值写死在 SparkConf 中。例如,你可能希望在同一个应用上使用不同的master或不同的内存总量。Spark允许你简单地创建一个空的SparkConf对象: val sc = new SparkContext(new SparkConf()) 然后在运行时设置这些属性: ./bin/spark-submit --name "My app" --master local[4] --conf spark.eventLog.enabled=false --conf "spark.executor.extraJavaOptions=-XX:+PrintGCDetails -XX:+PrintGCTimeStamps" myApp.jar Spark shell和spark-submit工具支持两种动态加载配置的方法。第一种,通过命令行选项,如:上面提到的–master(设置master URL)。spark-submit可以在启动Spark应用时,通过–conf标志接受任何属性配置,同时有一些特殊配置参数同样可用(如,–master)。运行./bin/spark-submit –help可以展示这些选项的完整列表。 同时,bin/spark-submit 也支持从conf/spark-defaults.conf 中读取配置选项,在该文件中每行是一个键值对,并用空格分隔,如下: spark.master spark://5.6.7.8:7077 spark.executor.memory 4g spark.eventLog.enabled true spark.serializer org.apache.spark.serializer.KryoSerializer 这些通过参数或者属性配置文件传递的属性,最终都会在SparkConf 中合并。其优先级是:首先是SparkConf代码中写的属性值,其次是spark-submit或spark-shell的标志参数,最后是spark-defaults.conf文件中的属性。 有一些配置项被重命名过,这种情形下,老的名字仍然是可以接受的,只是优先级比新名字优先级低。 查看Spark属性 每个SparkContext都有其对应的Spark UI,所以Spark应用程序都能通过Spark UI查看其属性。默认你可以在这里看到:http://<driver>:4040,页面上的”Environment“ tab页可以查看Spark属性。如果你真的想确认一下属性设置是否正确的话,这个功能就非常有用了。注意,只有显式地通过SparkConf对象、在命令行参数、或者spark-defaults.conf设置的参数才会出现在页面上。其他属性,你可以认为都是默认值。 可用的属性 绝大多数属性都有合理的默认值。这里是部分常用的选项: 应用属性 属性名称 默认值 含义 spark.app.name (none) Spark应用的名字。会在SparkUI和日志中出现。 spark.driver.cores 1 在cluster模式下,用几个core运行驱动器(driver)进程。 spark.driver.maxResultSize 1g Spark action算子返回的结果最大多大。至少要1M,可以设为0表示无限制。如果结果超过这一大小,Spark作业(job)会直接中断退出。但是,设得过高有可能导致驱动器OOM(out-of-memory)(取决于spark.driver.memory设置,以及驱动器JVM的内存限制)。设一个合理的值,以避免驱动器OOM。 spark.driver.memory 1g 驱动器进程可以用的内存总量(如:1g,2g)。 注意,在客户端模式下,这个配置不能在SparkConf中直接设置(因为驱动器JVM都启动完了呀!)。驱动器客户端模式下,必须要在命令行里用 –driver-memory 或者在默认属性配置文件里设置。 spark.executor.memory 1g 单个执行器(executor)使用的内存总量(如,2g,8g) spark.extraListeners (none) 逗号分隔的SparkListener子类的类名列表;初始化SparkContext时,这些类的实例会被创建出来,并且注册到Spark的监听总线上。如果这些类有一个接受SparkConf作为唯一参数的构造函数,那么这个构造函数会被优先调用;否则,就调用无参数的默认构造函数。如果没有构造函数,SparkContext创建的时候会抛异常。 spark.local.dir /tmp Spark的”草稿“目录,包括map输出的临时文件,或者RDD存在磁盘上的数据。这个目录最好在本地文件系统中,这样读写速度快。这个配置可以接受一个逗号分隔的列表,通常用这种方式将文件IO分散不同的磁盘上去。 注意:Spark-1.0及以后版本中,这个属性会被集群管理器所提供的环境变量覆盖:SPARK_LOCAL_DIRS(独立部署或Mesos)或者 LOCAL_DIRS(YARN)。 spark.logConf false SparkContext启动时是否把生效的 SparkConf 属性以INFO日志打印到日志里 spark.master (none) 集群管理器URL。参考allowed master URL’s. 除了这些以外,以下还有很多可用的参数配置,在某些特定情形下,可能会用到: 运行时环境 属性名 默认值 含义 spark.driver.extraClassPath (none) 额外的classpath,将插入到到驱动器的classpath开头。 注意:驱动器如果运行客户端模式下,这个配置不能通过SparkConf 在程序里配置,因为这时候程序已经启动呀!而是应该用命令行参数(–driver-class-path)或者在 conf/spark-defaults.conf 配置。 spark.driver.extraJavaOptions (none) 驱动器额外的JVM选项。如:GC设置或其他日志参数。 注意:驱动器如果运行客户端模式下,这个配置不能通过SparkConf在程序里配置,因为这时候程序已经启动呀!而是应该用命令行参数(–driver-java-options)或者conf/spark-defaults.conf 配置。 spark.driver.extraLibraryPath (none) 启动驱动器JVM时候指定的依赖库路径。 注意:驱动器如果运行客户端模式下,这个配置不能通过SparkConf在程序里配置,因为这时候程序已经启动呀!而是应该用命令行参数(–driver-library-path)或者conf/spark-defaults.conf 配置。 spark.driver.userClassPathFirst false (试验性的:即未来不一定会支持该配置) 驱动器是否首选使用用户指定的jars,而不是spark自身的。这个特性可以用来处理用户依赖和spark本身依赖项之间的冲突。目前还是试验性的,并且只能用在集群模式下。 spark.executor.extraClassPath (none) 添加到执行器(executor)classpath开头的classpath。主要为了向后兼容老的spark版本,不推荐使用。 spark.executor.extraJavaOptions (none) 传给执行器的额外JVM参数。如:GC设置或其他日志设置等。注意,不能用这个来设置Spark属性或者堆内存大小。Spark属性应该用SparkConf对象,或者spark-defaults.conf文件(会在spark-submit脚本中使用)来配置。执行器堆内存大小应该用 spark.executor.memory配置。 spark.executor.extraLibraryPath (none) 启动执行器JVM时使用的额外依赖库路径。 spark.executor.logs.rolling.maxRetainedFiles (none) Sets the number of latest rolling log files that are going to be retained by the system. Older log files will be deleted. Disabled by default.设置日志文件最大保留个数。老日志文件将被干掉。默认禁用的。 spark.executor.logs.rolling.maxSize (none) 设置执行器日志文件大小上限。默认禁用的。 需要自动删日志请参考 spark.executor.logs.rolling.maxRetainedFiles. spark.executor.logs.rolling.strategy (none) 执行器日志滚动策略。默认禁用。 可接受的值有”time”(基于时间滚动) 或者 “size”(基于文件大小滚动)。 time:将使用 spark.executor.logs.rolling.time.interval设置滚动时间间隔 size:将使用 spark.executor.logs.rolling.size.maxBytes设置文件大小上限 spark.executor.logs.rolling.time.interval daily 设置执行器日志滚动时间间隔。日志滚动默认是禁用的。 可用的值有 “daily”, “hourly”, “minutely”,也可设为数字(则单位为秒)。 关于日志自动清理,请参考 spark.executor.logs.rolling.maxRetainedFiles spark.executor.userClassPathFirst false (试验性的)与 spark.driver.userClassPathFirst类似,只不过这个参数将应用于执行器 spark.executorEnv.[EnvironmentVariableName] (none) 向执行器进程增加名为EnvironmentVariableName的环境变量。用户可以指定多个来设置不同的环境变量。 spark.python.profile false 对Python worker启用性能分析,性能分析结果会在sc.show_profile()中,或者在驱动器退出前展示。也可以用sc.dump_profiles(path)输出到磁盘上。如果部分分析结果被手动展示过,那么驱动器退出前就不再自动展示了。默认会使用pyspark.profiler.BasicProfiler,也可以自己传一个profiler 类参数给SparkContext构造函数。 spark.python.profile.dump (none) 这个目录是用来在驱动器退出前,dump性能分析结果。性能分析结果会按RDD分别dump。同时可以使用ptats.Stats()来装载。如果制定了这个,那么分析结果就不再自动展示。 spark.python.worker.memory 512m 聚合时每个python worker使用的内存总量,和JVM的内存字符串格式相同(如,512m,2g)。如果聚合时使用的内存超过这个量,就将数据溢出到磁盘上。 spark.python.worker.reuse true 是否复用Python worker。如果是,则每个任务会启动固定数量的Python worker,并且不需要fork() python进程。如果需要广播的数据量很大,设为true能大大减少广播数据量,因为需要广播的进程数减少了。 混洗行为 属性名 默认值 含义 spark.reducer.maxSizeInFlight 48m map任务输出同时reduce任务获取的最大内存占用量。每个输出需要创建buffer来接收,对于每个reduce任务来说,有一个固定的内存开销上限,所以最好别设太大,除非你内存非常大。 spark.shuffle.compress true 是否压缩map任务的输出文件。通常来说,压缩是个好主意。使用的压缩算法取决于 spark.io.compression.codec spark.shuffle.file.buffer 32k 每个混洗输出流的内存buffer大小。这个buffer能减少混洗文件的创建和磁盘寻址。 spark.shuffle.io.maxRetries 3 (仅对netty)如果IO相关异常发生,重试次数(如果设为非0的话)。重试能是大量数据的混洗操作更加稳定,因为重试可以有效应对长GC暂停或者网络闪断。 spark.shuffle.io.numConnectionsPerPeer 1 (仅netty)主机之间的连接是复用的,这样可以减少大集群中重复建立连接的次数。然而,有些集群是机器少,磁盘多,这种集群可以考虑增加这个参数值,以便充分利用所有磁盘并发性能。 spark.shuffle.io.preferDirectBufs true (仅netty)堆外缓存可以有效减少垃圾回收和缓存复制。对于堆外内存紧张的用户来说,可以考虑禁用这个选项,以迫使netty所有内存都分配在堆上。 spark.shuffle.io.retryWait 5s (仅netty)混洗重试获取数据的间隔时间。默认最大重试延迟是15秒,设置这个参数后,将变成maxRetries* retryWait。 spark.shuffle.manager sort 混洗数据的实现方式。可用的有”sort”和”hash“。基于排序(sort)的混洗内存利用率更高,并且从1.2开始已经是默认值了。 spark.shuffle.service.enabled false 启用外部混洗服务。启用外部混洗服务后,执行器生成的混洗中间文件就由该服务保留,这样执行器就可以安全的退出了。如果 spark.dynamicAllocation.enabled启用了,那么这个参数也必须启用,这样动态分配才能有外部混洗服务可用。 更多请参考:dynamic allocation configuration and setup documentation spark.shuffle.service.port 7337 外部混洗服务对应端口 spark.shuffle.sort.bypassMergeThreshold 200 (高级)在基于排序(sort)的混洗管理器中,如果没有map端聚合的话,就会最多存在这么多个reduce分区。 spark.shuffle.spill.compress true 是否在混洗阶段压缩溢出到磁盘的数据。压缩算法取决于spark.io.compression.codec Spark UI 属性名 默认值 含义 spark.eventLog.compress false 是否压缩事件日志(当然spark.eventLog.enabled必须开启) spark.eventLog.dir file:///tmp/spark-events Spark events日志的基础目录(当然spark.eventLog.enabled必须开启)。在这个目录中,spark会给每个应用创建一个单独的子目录,然后把应用的events log打到子目录里。用户可以设置一个统一的位置(比如一个HDFS目录),这样history server就可以从这里读取历史文件。 spark.eventLog.enabled false 是否启用Spark事件日志。如果Spark应用结束后,仍需要在SparkUI上查看其状态,必须启用这个。 spark.ui.killEnabled true 允许从SparkUI上杀掉stage以及对应的作业(job) spark.ui.port 4040 SparkUI端口,展示应用程序运行状态。 spark.ui.retainedJobs 1000 SparkUI和status API最多保留多少个spark作业的数据(当然是在垃圾回收之前) spark.ui.retainedStages 1000 SparkUI和status API最多保留多少个spark步骤(stage)的数据(当然是在垃圾回收之前) spark.worker.ui.retainedExecutors 1000 SparkUI和status API最多保留多少个已结束的执行器(executor)的数据(当然是在垃圾回收之前) spark.worker.ui.retainedDrivers 1000 SparkUI和status API最多保留多少个已结束的驱动器(driver)的数据(当然是在垃圾回收之前) spark.sql.ui.retainedExecutions 1000 SparkUI和status API最多保留多少个已结束的执行计划(execution)的数据(当然是在垃圾回收之前) spark.streaming.ui.retainedBatches 1000 SparkUI和status API最多保留多少个已结束的批量(batch)的数据(当然是在垃圾回收之前) 压缩和序列化 属性名 默认值 含义 spark.broadcast.compress true 是否在广播变量前使用压缩。通常是个好主意。 spark.closure.serializer org.apache.spark.serializer. JavaSerializer 闭包所使用的序列化类。目前只支持Java序列化。 spark.io.compression.codec snappy 内部数据使用的压缩算法,如:RDD分区、广播变量、混洗输出。Spark提供了3中算法:lz4,lzf,snappy。你也可以使用全名来指定压缩算法:org.apache.spark.io.LZ4CompressionCodec,org.apache.spark.io.LZFCompressionCodec,org.apache.spark.io.SnappyCompressionCodec. spark.io.compression.lz4.blockSize 32k LZ4算法使用的块大小。当然你需要先使用LZ4压缩。减少块大小可以减少混洗时LZ4算法占用的内存量。 spark.io.compression.snappy.blockSize 32k Snappy算法使用的块大小(先得使用Snappy算法)。减少块大小可以减少混洗时Snappy算法占用的内存量。 spark.kryo.classesToRegister (none) 如果你使用Kryo序列化,最好指定这个以提高性能(tuning guide)。 本参数接受一个逗号分隔的类名列表,这些类都会注册为Kryo可序列化类型。 spark.kryo.referenceTracking true (false when using Spark SQL Thrift Server) 是否跟踪同一对象在Kryo序列化的引用。如果你的对象图中有循环护着包含统一对象的多份拷贝,那么最好启用这个。如果没有这种情况,那就禁用以提高性能。 spark.kryo.registrationRequired false Kryo序列化时,是否必须事先注册。如果设为true,那么Kryo遇到没有注册过的类型,就会抛异常。如果设为false(默认)Kryo会序列化未注册类型的对象,但会有比较明显的性能影响,所以启用这个选项,可以强制必须在序列化前,注册可序列化类型。 spark.kryo.registrator (none) 如果你使用Kryo序列化,用这个class来注册你的自定义类型。如果你需要自定义注册方式,这个参数很有用。否则,使用 spark.kryo.classesRegister更简单。要设置这个参数,需要用KryoRegistrator的子类。详见:tuning guide。 spark.kryoserializer.buffer.max 64m 最大允许的Kryo序列化buffer。必须必你所需要序列化的对象要大。如果你在Kryo中看到”buffer limit exceeded”这个异常,你就得增加这个值了。 spark.kryoserializer.buffer 64k Kryo序列化的初始buffer大小。注意,每台worker上对应每个core会有一个buffer。buffer最大增长到 spark.kryoserializer.buffer.max spark.rdd.compress false 是否压缩序列化后RDD的分区(如:StorageLevel.MEMORY_ONLY_SER)。能节省大量空间,但多消耗一些CPU。 spark.serializer org.apache.spark.serializer. JavaSerializer (org.apache.spark.serializer. KryoSerializer when using Spark SQL Thrift Server) 用于序列化对象的类,序列化后的数据将通过网络传输,或从缓存中反序列化回来。默认的Java序列化使用java的Serializable接口,但速度较慢,所以我们建议使用usingorg.apache.spark.serializer.KryoSerializerand configuring Kryo serialization如果速度需要保证的话。当然你可以自定义一个序列化器,通过继承org.apache.spark.Serializer. spark.serializer.objectStreamReset 100 如果使用org.apache.spark.serializer.JavaSerializer做序列化器,序列化器缓存这些对象,以避免输出多余数据,然而,这个会打断垃圾回收。通过调用reset来flush序列化器,从而使老对象被回收。要禁用这一周期性reset,需要把这个参数设为-1,。默认情况下,序列化器会每过100个对象,被reset一次。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark独立模式

Spark独立模式 Spark除了可以在Mesos和YARN集群上运行之外,还支持一种简单的独立部署模式。独立部署模式下,你既可以手工启动(手动运行master和workers),也可以利用我们提供的启动脚本(launch scripts)。同时,独立部署模式下,你可以在单机上运行这些程序,以方便测试。 Spark集群独立安装 要独立安装Spark,你只需要将编译好的Spark包复制到集群中每一个节点上即可。你可以下载一个编译好的Spark版本,也可以在这里自己编译一个版本(build it yourself)。 手动启动集群 执行以下命令,启动独立部署的master server: ./sbin/start-master.sh 一旦启动完成,master会打印出master URL(spark://HOST:PORT),后续worker需要用这个URL来连接master,写代码的时候SparkContext中的master参数也需要设置成这个master URL。你还可以在master的web UI(默认为http://localhost:8080)上查看master URL。 类似地,你可以通过以下命令,启动一个或多个worker节点,并将其连接到master: ./sbin/start-slave.sh <master-spark-URL> 启动一个worker以后,刷新一下master的web UI(默认为http://localhost:8080),你应该可以在这里看到一个新的节点。 最后,以下配置选项将会被传给master和worker: 参数 含义 -h HOST,--host HOST 监听的主机名 -i HOST,--ip HOST 监听的主机名(已经废弃,请使用-h 或者 –host) -p PORT,--port PORT 服务监听的端口(master节点默认7077,worker节点随机) --webui-port PORT web UI端口(master节点默认8080,worker节点默认8081) -c CORES,--cores CORES 单节点上,Spark应用能够使用的CPU core数上限(默认,等于CPU core的个数);仅worker节点有效 -m MEM,--memory MEM 单节点上,Spark应用能够使用的内存上限,格式为1000M 或者 2G(默认为,机器上所有内存减去1G);仅worker节点有效 -d DIR,--work-dir DIR 工作目录,同时job的日志也输出到该目录(默认:${SPAKR_HOME}/work);仅worker节点有效 --properties-file FILE 自定义Spark属性文件的加载路径(默认:conf/spark-defaults.conf) 集群启动脚本 要使用启动脚本,来启动一个Spark独立部署集群,首先你需要在Spark目录下创建一个文件conf/slaves,并且在文件中写入你需要作为worker节点启动的每一台机器主机名(或IP),每行一台机器。如果conf/slaves文件不存在,启动脚本会默认会用单机方式启动,这种方式对测试很有帮助。注意,master节点访问各个worker时使用ssh。默认情况下,你需要配置ssh免密码登陆(使用秘钥文件)。如果你没有设置免密码登陆,那么你也可以通过环境变量SPARK_SSH_FOREGROUND来一个一个地设置每个worker的密码。 设置好conf/slaves文件以后,你就可以用一下shell脚本来启动或停止集群了,类似于Hadoop的部署,这些脚本都在${SPARK_HOME}/sbin目录下: sbin/start-master.sh– 在本机启动一个master实例 sbin/start-slaves.sh– 在conf/slaves文件所指定的每一台机器上都启动一个slave实例 sbin/start-slave.sh– 在本机启动一个slave实例 sbin/start-all.sh– 启动一个master和多个slave实例,详细见上面的描述。 sbin/stop-master.sh– 停止 start-master.sh所启动的master实例 sbin/stop-slaves.sh– 停止所有在conf/slaves中指定的slave实例 sbin/stop-all.sh– 停止master节点和所有slave节点,详细见上面的描述 注意,这些脚本都需要在你启动Spark master的机器上运行,而不是你的本地机器。 Spark独立部署集群的其他可选的环境变量见conf/spark-env.sh。你可以通过复制conf/spark-env.sh.template来创建这个文件,同时你还需要将配置好的文件复制到所有的worker节点上。以下是可用的设置: 环境变量 含义 SPARK_MASTER_IP master实例绑定的IP地址,例如,绑定到一个公网IP SPARK_MASTER_PORT mater实例绑定的端口(默认7077) SPARK_MASTER_WEBUI_PORT master web UI的端口(默认8080) SPARK_MASTER_OPTS master专用配置属性,格式如”-Dx=y” (默认空),可能的选项请参考下面的列表。 SPARK_LOCAL_DIRS Spark的本地工作目录,包括:映射输出的临时文件和RDD保存到磁盘上的临时数据。这个目录需要快速访问,最好设成本地磁盘上的目录。也可以通过使用逗号分隔列表,将其设成多个磁盘上的不同路径。 SPARK_WORKER_CORES 本机上Spark应用可以使用的CPU core上限(默认所有CPU core) SPARK_WORKER_MEMORY 本机上Spark应用可以使用的内存上限,如:1000m,2g(默认为本机所有内存减去1GB);注意每个应用单独使用的内存大小要用 spark.executor.memory 属性配置的。 SPARK_WORKER_PORT Spark worker绑定的端口(默认随机) SPARK_WORKER_WEBUI_PORT worker web UI端口(默认8081) SPARK_WORKER_INSTANCES 每个slave机器上启动的worker实例个数(默认:1)。如果你的slave机器非常强劲,可以把这个值设为大于1;相应的,你需要设置SPARK_WORKER_CORES参数来显式地限制每个worker实例使用的CPU个数,否则每个worker实例都会使用所有的CPU。 SPARK_WORKER_DIR Spark worker的工作目录,包括worker的日志以及临时存储空间(默认:${SPARK_HOME}/work) SPARK_WORKER_OPTS worker的专用配置属性,格式为:”-Dx=y”,可能的选项请参考下面的列表。 SPARK_DAEMON_MEMORY Spark master和worker后台进程所使用的内存(默认:1g) SPARK_DAEMON_JAVA_OPTS Spark master和workers后台进程所使用的JVM选项,格式为:”-Dx=y”(默认空) SPARK_PUBLIC_DNS Spark master和workers使用的公共DNS(默认空) 注意:启动脚本目前不支持Windows。如需在Windows上运行,请手工启动master和workers。 SPARK_MASTER_OPTS支持以下属性: 属性名 默认值 含义 spark.deploy.retainedApplications 200 web UI上最多展示几个已结束应用。更早的应用的数将被删除。 spark.deploy.retainedDrivers 200 web UI上最多展示几个已结束的驱动器。更早的驱动器进程数据将被删除。 spark.deploy.spreadOut true 独立部署集群的master是否应该尽可能将应用分布到更多的节点上;设为true,对数据本地性支持较好;设为false,计算会收缩到少数几台机器上,这对计算密集型任务比较有利。 spark.deploy.defaultCores (无限制) Spark独立模式下应用程序默认使用的CPU个数(没有设置spark.cores.max的情况下)。如果不设置,则为所有可用CPU个数(除非设置了spark.cores.max)。如果集群是共享的,最好将此值设小一些,以避免用户占满整个集群。 spark.worker.timeout 60 如果master没有收到worker的心跳,那么将在这么多秒之后,master将丢弃该worker。 SPARK_WORKER_OPTS支持以下属性: 属性名 默认值 含义 spark.worker.cleanup.enabled false 是否定期清理 worker 和应用的工作目录。注意,该设置仅在独立模式下有效,YARN有自己的清理方式;同时,只会清理已经结束的应用对应的目录。 spark.worker.cleanup.interval 1800 (30 minutes) worker清理本地应用工作目录的时间间隔(秒) spark.worker.cleanup.appDataTtl 7 * 24 * 3600 (7 days) 清理多久以前的应用的工作目录。这个选项值将取决于你的磁盘总量。spark应用会将日志和jar包都放在其对应的工作目录下。随着时间流逝,应用的工作目录很快会占满磁盘,尤其是在你的应用提交比较频繁的情况下。 连接到集群 要在Spark集群上运行一个应用,只需把spark://IP:PORT这个master URL传给SparkContext(参考SparkContextconstructor) 如需要运行交互式的spark shell,运行如下命令: ./bin/spark-shell --master spark://IP:PORT 你也可以通过设置选线 –total-executor-cores <numCores> 来控制spark-shell在集群上使用的CPU总数。 启动Spark应用 spark-submit脚本(spark-submitscript)是提交spark应用最简洁的方式。对于独立安装的集群来说,spark目前支持两种运行模式。客户端(client)模式下,驱动器进程(driver)将在提交应用的机器上启动。而在集群(cluster)模式下,驱动器(driver)将会在集群中的某一台worker上启动,同时提交应用的客户端在提交动作完成之后立即退出,而不会等到Spark应用运行结束。 如果你的应用时通过spark-submit提交启动的,那么应用对应的jar包会自动发布到所有的worker节点上。任何额外的依赖项jar包,都必须在–jars参数中指明,并以逗号分隔(如:–jars jar1,jar2)。 另外,独立安装的集群还支持异常退出(返回值非0)时自动重启。要启用这个特性,你需要在spark-submit时指定–supervise参数。其后,如果你需要杀掉一个重复失败的应用,你可能需要运行如下指令: ./bin/spark-class org.apache.spark.deploy.Client kill <master url> <driver ID> 你可以在master web UI(http://<master url>:8080)上查看驱动器ID。 资源调度 独立安装集群目前只支持简单的先进先出(FIFO)调度器。这个调度器可以支持多用户,你可以控制每个应用所使用的最大资源。默认情况下,Spark应用会申请集群中所有的CPU,这不太合理,除非你的进群同一时刻只运行一个应用。你可以通过SparkConf中的spark.cores.max,来设置一个CPU帽子以限制其使用的CPU总数。例如: val conf = new SparkConf() .setMaster(...) .setAppName(...) .set("spark.cores.max", "10") val sc = new SparkContext(conf) 另外,你也可以通过conf/spark-env.sh中的spark.deploy.defaultCores设置应用默认使用的CPU个数(特别针对没有设置spark.cores.max的应用)。 export SPARK_MASTER_OPTS="-Dspark.deploy.defaultCores=<value>" 在一些共享的集群上,用户很可能忘记单独设置一个最大CPU限制,那么这个参数将很有用。 监控和日志 Spark独立安装模式提供了一个基于web的集群监控用户界面。master和每个worker都有其对应的web UI,展示集群和Spark作业的统计数据。默认情况下,你可以在master机器的8080端口上访问到这个web UI。这个端口可以通过配置文件或者命令行来设置。 另外,每个作业的详细日志,将被输出到每个slave节点上的工作目录下(默认为:${SPARK_HOME}/work)。每个Spark作业下都至少有两个日志文件,stdout和stderr,这里将包含所有的输出到控制台的信息。 和Hadoop同时运行 你可以让Spark和已有的Hadoop在同一集群上同时运行,只需要将Spark作为独立的服务启动即可。这样Spark可以通过hdfs:// URL来访问Hadoop上的数据(通常情况下是,hdfs://<namenode>:9000/path,你可以在Hadoop Namenode的web UI上找到正确的链接)。当然,你也可以为Spark部署一个独立的集群,这时候Spark仍然可以通过网络访问HDFS上的数据;这会比访问本地磁盘慢一些,但如果Spark和Hadoop集群都在同一个本地局域网内的话,问题不大(例如,你可以在Hadoop集群的每个机架上新增一些部署Spark的机器)。 网络安全端口配置 Spark会大量使用网络资源,而有些环境会设置严密的防火墙设置,以严格限制网络访问。完整的端口列表,请参考这里:security page. 高可用性 默认情况下,独立调度的集群能够容忍worker节点的失败(在Spark本身来说,它能够将失败的工作移到其他worker节点上)。然而,调度器需要master做出调度决策,而这(默认行为)会造成单点失败:如果master挂了,任何应用都不能提交和调度。为了绕过这个单点问题,我们有两种高可用方案,具体如下: 基于Zookeeper的热备master 概要 利用Zookeeper来提供领导节点选举以及一些状态数据的存储,你可以在集群中启动多个master并连接到同一个Zookeeper。其中一个将被选举为“领导”,而另一个将处于备用(standby)状态。如果“领导”挂了,则另一个master会立即被选举,并从Zookeeper恢复已挂“领导”的状态,并继续调度。整个恢复流程(从“领导”挂开始计时)可能需要1到2分钟的时间。注意,整个延时只会影响新增应用 – 已经运行的应用不会受到影响。 更多关于Zookeeper信息请参考这里:here 配置 要启用这种恢复模式,你可以在spark-env中设置SPARK_DAEMON_JAVA_OPTS,可用的属性如下: 系统属性 含义 spark.deploy.recoveryMode 设为ZOOKEEPER以启用热备master恢复模式(默认空) spark.deploy.zookeeper.url Zookeeper集群URL(如:192.168.1.100:2181,192.168.1.101:2181) spark.deploy.zookeeper.dir 用于存储可恢复状态的Zookeeper目录(默认 /spark) 可能的问题:如果你有多个master,但没有正确设置好master使用Zookeeper的配置,那么这些master彼此都不可见,并且每个master都认为自己是“领导”。这件会导致整个集群处于不稳定状态(多个master都会独立地进行调度) 详细 如果你已经有一个Zookeeper集群,那么启动高可用特性是很简单的。只需要在不同节点上启动多个master,并且配置相同的Zookeeper(包括Zookeeper URL和目录)即可。masters可以随时添加和删除。 在调度新提交的Spark应用或者新增worker节点时,需要知道当前”领导“的IP地址。你只需要将以前单个的master地址替换成多个master地址即可。例如,你可以在SparkContext中设置master URL为spark://host1:port1.host2:port2。这会导致SparkContext在两个master中都进行登记 – 那么这时候,如果host1挂了,这个应用的配置同样可以在新”领导“(host2)中找到。 ”在master注册“和普通操作有一个显著的区别。在Spark应用或worker启动时,它们需要找当前的”领导“master,并在该master上注册。一旦注册成功,它们的状态将被存储到Zookeeper上。如果”老领导“挂了,”新领导“将会联系所有之前注册过的Spark应用和worker并通知它们领导权的变更,所以Spark应用和worker在启动时甚至没有必要知道”新领导“的存在。 由于这一特性,新的master可以在任何时间添加进来,你唯一需要关注的就是,新的应用或worker能够访问到这个master。总之,只要应用和worker注册成功,其他的你都不用管了。 基于本地文件系统的单点恢复 概要 利用Zookeeper当然是生成环境下高可用的最佳选择,但有时候你仍然希望在master挂了的时候能够重启之,FILESYSTEM模式能帮你实现这一需求。当应用和worker注册到master的时候,他们的状态都将被写入文件系统目录中,一旦master挂了,你只需要重启master,这些状态都能够恢复。 配置 要使用这种恢复模式,你需要在spark-env中设置SPARK_DAEMON_JAVA_OPTS,可用的属性如下: 系统属性 含义 spark.deploy.recoveryMode 设为FILESYSTEM以启用单点恢复模式(默认空) spark.deploy.recoveryDirectory 用于存储可恢复状态数据的目录,master进程必须有访问权限 Details(详细) 这个解决方案可以用于和一些监控、管理系统进行串联(如:monit),或者与手动重启相结合。 至少,基于文件系统工单恢复总比不能恢复强;同时,这种恢复模式也会是开发或者实验场景下的不错的选择。在某些情况下,通过stop-master.sh杀死master可能不会清理其状态恢复目录下的数据,那么这时候你启动或重启master,将会进入恢复模式。这可能导致master的启动时间长达一分钟(master可能要等待之前注册的worker和客户端超时)。 你也可以使用NFS目录来作为数据恢复目录(虽然这不是官方声明支持的)。如果老的master挂了,你可以在另一个节点上启动master,这个master只要能访问同一个NFS目录,它就能够正确地恢复状态数据,包括之前注册的worker和应用(等价于Zookeeper模式)。后续的应用必须使用新的master来进行注册。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》监控和工具

监控和工具 监控Spark应用有很多种方式:web UI,metrics 以及外部工具。 Web界面 每个SparkContext都会启动一个web UI,其默认端口为4040,并且这个web UI能展示很多有用的Spark应用相关信息。包括: 一个stage和task的调度列表 一个关于RDD大小以及内存占用的概览 运行环境相关信息 运行中的执行器相关信息 你只需打开浏览器,输入 http://<driver-node>:4040 即可访问该web界面。如果有多个SparkContext在同时运行中,那么它们会从4040开始,按顺序依次绑定端口(4041,4042,等)。 注意,默认情况下,这些信息只有在Spark应用运行期内才可用。如果需要在Spark应用退出后仍然能在web UI上查看这些信息,则需要在应用启动前,将 spark.eventLog.enabled 设为 true。这项配置将会把Spark事件日志都记录到持久化存储中。 事后查看 Spark独立部署时,其对应的集群管理器也有其对应的web UI。如果Spark应用将其运行期事件日志保留下来了,那么独立部署集群管理器对应的web UI将会根据这些日志自动展示已经结束的Spark应用。 如果Spark是运行于Mesos或者YARN上的话,那么你需要开启Spark的history server,开启event log。开启history server需要如下指令: ./sbin/start-history-server.sh 如果使用file-system provider class(参考下面的 spark.history.provider),那么日志目录将会基于 spark.history.fs.logDirectory 配置项,并且在表达Spark应用的事件日志路径时,应该带上子目录。history server对应的web界面默认在这里 http://<server-url>:18080。同时,history server有一些可用的配置如下: 环境变量 含义 SPARK_DAEMON_MEMORY history server分配多少内存(默认: 1g) SPARK_DAEMON_JAVA_OPTS history server的 JVM参数(默认:none) SPARK_PUBLIC_DNS history server的外部访问地址,如果不配置,那么history server有可能会绑定server的内部地址,这可能会导致外部不能访问(默认:none) SPARK_HISTORY_OPTS history server配置项(默认:none):spark.history.* 属性名称 默认值 含义 spark.history.provider org.apache.spark.deploy .history.FsHistoryProvider Spark应用历史后台实现的类名。目前可用的只有spark自带的一个实现,支持在本地文件系统中查询应用日志。 spark.history.fs.logDirectory file:/tmp/spark-events history server加载应用日志的目录 spark.history.fs.update.interval 10s history server更新信息的时间间隔。每次更新将会检查磁盘上的日志是否有更新。 spark.history.retainedApplications 50 UI上保留的spark应用历史个数。超出的将按时间排序,删除最老的。 spark.history.ui.port 18080 history server绑定的端口 spark.history.kerberos.enabled false history server是否启用kerberos验证登陆。如果history server需要访问一个需要安全保证的hadoop集群,则需要开启这个功能。该配置设为true以后,需要同时配置 spark.history.kerberos.principal 和 spark.history.kerberos.keytab spark.history.kerberos.principal (none) 登陆history server的kerberos 主体名称 spark.history.kerberos.keytab (none) history server对应的kerberos keytab文件路径 spark.history.ui.acls.enable false 指定是否启用ACL以控制用户访问验证。如果启用,那么不管某个应用是否设置了 spark.ui.acls.enabled,访问控制都将检查用户是否有权限。Spark应用的owner始终有查看的权限,而其他用户则需要通过 spark.ui.view.acls 配置其访问权限。如果禁用,则不会检查访问权限。 spark.history.fs.cleaner.enabled false 指定history server是否周期性清理磁盘上的event log spark.history.fs.cleaner.interval 1d history server清理磁盘文件的时间间隔。只会清理比 spark.history.fs.cleaner.maxAge 时间长的磁盘文件。 spark.history.fs.cleaner.maxAge 7d 如果启用了history server周期性清理,比这个时间长的Spark作业历史文件将会被清理掉 注意,所有web界面上的 table 都可以点击其表头来排序,这样可以帮助用户做一些简单分析,如:发现跑的最慢的任务、数据倾斜等。 注意history server 只展示已经结束的Spark作业。一种通知Spark作业结束的方法是,显式地关闭SparkContext(通过调用 sc.stop(),或者在 使用 SparkContext() 处理其 setup 和 tear down 事件(适用于python),然后作业历史就会出现在web UI上了。 REST API 度量信息除了可以在UI上查看之外,还可以以JSON格式访问。这能使开发人员很容易构建新的Spark可视化和监控工具。JSON格式的度量信息对运行中的Spark应用和history server中的历史作业均有效。其访问端点挂载在 /api/v1 路径下。例如,对于history server,一般你可以通过 http://<server-url>:18080/api/v1 来访问,而对于运行中的应用,可以通过 http://localhost:4040/api/v1 来访问。 端点 含义 /applications 所有应用的列表 /applications/[app-id]/jobs 给定应用的全部作业列表 /applications/[app-id]/jobs/[job-id] 给定作业的细节 /applications/[app-id]/stages 给定应用的stage列表 /applications/[app-id]/stages/[stage-id] 给定stage的所有attempt列表 /applications/[app-id]/stages/[stage-id]/[stage-attempt-id] 给定attempt的详细信息 /applications/[app-id]/stages/[stage-id]/[stage-attempt-id]/taskSummary 指定attempt对应的所有task的概要度量信息 /applications/[app-id]/stages/[stage-id]/[stage-attempt-id]/taskList 指定的attempt的所有task的列表 /applications/[app-id]/executors 给定应用的所有执行器 /applications/[app-id]/storage/rdd 给定应用的已保存的RDD列表 /applications/[app-id]/storage/rdd/[rdd-id] 给定的RDD的存储详细信息 /applications/[app-id]/logs 将给定应用的所有attempt对应的event log以zip格式打包下载 /applications/[app-id]/[attempt-id]/logs 将给定attempt的所有attempt对应的event log以zip格式打包下载 如果在YARN上运行,每个应用都由多个attempts,所以 [app-id] 实际上是 [app-id]/[attempt-id]。 这些API端点都有版本号,所以基于这些API开发程序就比较容易。Spark将保证: 端点一旦添加进来,就不会删除 某个端点支持的字段永不删除 未来可能会增加新的端点 已有端点可能会增加新的字段 未来可能会增加新的API版本,但会使用不同的端点(如:api/v2 )。但新版本不保证向后兼容。 API版本可能会整个丢弃掉,但在丢弃前,一定会和新版本API共存至少一个小版本。 注意,在UI上检查运行中的应用时,虽然每次只能查看一个应用, 但applicatoins/[app-id] 这部分路径仍然是必须的。例如,你需要查看运行中应用的作业列表时,你需要输入 http://localhost:4040/api/v1/applications/[app-id]/jobs。虽然麻烦点,但这能保证两种模式下访问路径的一致性。 度量 Spark的度量子系统是可配置的,其功能是基于Coda Hale Metrics Library开发的。这套度量子系统允许用户以多种形式的汇报槽(sink)汇报Spark度量信息,包括:HTTP、JMX和CSV文件等。其对应的配置文件路径为:${SPARK_HOME}/conf/metrics.properties。当然,你可以通过spark.metrics.conf 这个Spark属性来自定义配置文件路径(详见configuration property)。Spark的各个组件都有其对应的度量实例,且这些度量实例之间是解耦的。这些度量实例中,你都可以配置一系列不同的汇报槽来汇报度量信息。以下是目前支持的度量实例: master: 对应Spark独立部署时的master进程。 applications: master进程中的一个组件,专门汇报各个Spark应用的度量信息。 worker: 对应Spark独立部署时的worker进程。 executor: 对应Spark执行器。 driver: 对应Spark驱动器进程(即创建SparkContext对象的进程)。 每个度量实例可以汇报给0~n个槽。以下是目前 org.apache.spark.metrics.sink 包中包含的几种汇报槽(sink): ConsoleSink:将度量信息打印到控制台。 CSVSink: 以特定的间隔,将度量信息输出到CSV文件。 JmxSink: 将度量信息注册到JMX控制台。 MetricsServlet: 在已有的Spark UI中增加一个servlet,对外提供JSON格式的度量数据。 GraphiteSink: 将度量数据发到Graphite节点。 Slf4jSink: 将度量数据发送给slf4j 打成日志。 Spark同样也支持Ganglia,但因为license限制的原因没有包含在默认的发布包中: GangliaSink: 将度量信息发送给一个Ganglia节点或者多播组。 如果需要支持GangliaSink的话,你需要自定义Spark构建包。注意,如果你包含了GangliaSink代码包的话,就必须同时将LGPL-licensed 协议包含进你的Spark包中。对于sbt用户,只需要在编译打包前设置好环境变量:SPARK_GANGLIA_LGPL即可。对于maven用户,启用 -Pspark-ganglia-lgpl 即可。另外,除了修改集群的Spark之外,用户程序还需要链接 spark-ganglia-lgpl 工件。 度量系统配置文件语法可以参考这个配置文件示例:${SPARK_HOME}/conf/metrics.properties.template 高级工具 以下是几个可以用以分析Spark性能的外部工具: 集群整体监控工具,如:Ganglia,可以提供集群整体的使用率和资源瓶颈视图。比如,Ganglia的仪表盘可以迅速揭示出整个集群的工作负载是否达到磁盘、网络或CPU限制。 操作系统分析工具,如:dstat,iostat, 以及iotop,可以提供单个节点上细粒度的分析剖面。 JVM工具可以帮助你分析JVM虚拟机,如:jstack可以提供调用栈信息,jmap可以转储堆内存数据,jstat可以汇报时序统计信息,jconsole可以直观的探索各种JVM属性,这对于熟悉JVM内部机制非常有用。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark官方文档》提交Spark应用

提交Spark应用 spark-submit脚本在Spark的bin目录下,可以利用此脚本向集群提交Spark应用。该脚本为所有Spark所支持的集群管理器(cluster managers)提供了统一的接口,因此,你基本上可以用同样的配置和脚本,向不同类型的集群管理器提交你的应用。 打包应用程序依赖 如果你的代码依赖于其他工程,那么你需要把依赖项也打包进来,并发布给Spark集群。这需要创建一个程序集jar包(或者uber jar),包含你自己的代码,同时也包含其依赖项。sbtandMaven都有assembly插件。创建程序集jar包时,注意,要把Spark和Hadoop的jar包都可设为provided;这些jar包在Spark集群上已经存在,不需要再打包进来。完成jar包后,你就可以使用bin/spark-submit来提交你的jar包了。 对于Python,你可以使用spark-submit的–py-files参数,将你的程序以.py、.zip 或.egg文件格式提交给集群。如果你需要依赖很多Python文件,我们推荐你使用.zip或者.egg来打包。 利用spark-submit启动应用 一旦打包好一个应用程序,你就可以用bin/spark-submit来提交之。这个脚本会自动设置Spark及其依赖的classpath,同时可以支持多种不同类型的集群管理器、以及不同的部署模式: ./bin/spark-submit \ --class <main-class> --master <master-url> \ --deploy-mode <deploy-mode> \ --conf <key>=<value> \ ... # 其他选项 <application-jar> \ [application-arguments] 一些常用的选项如下: --class: 应用入口类(例如:org.apache.spark.examples.SparkPi)) --master: 集群的master URL(如:spark://23.195.26.187:7077) --deploy-mode:驱动器进程是在集群上工作节点运行(cluster),还是在集群之外客户端运行(client)(默认:client) --conf: 可以设置任意的Spark配置属性,键值对(key=value)格式。如果值中包含空白字符,可以用双引号括起来(”key=value“)。 application-jar: 应用程序jar包路径,该jar包必须包括你自己的代码及其所有的依赖项。如果是URL,那么该路径URL必须是对整个集群可见且一致的,如:hdfs://path 或者file://path(要求对所有节点都一致) application-arguments: 传给入口类main函数的启动参数,如果有的话。 一种常见的部署策略是,在一台网关机器上提交你的应用,这样距离工作节点的物理距离比较近。这种情况下,client模式会比较适合。client模式下,驱动器直接运行在spark-submit的进程中,同时驱动器对于集群来说就像是一个客户端。应用程序的输入输出也被绑定到控制台上。因此,这种模式特别适用于交互式执行(REPL),spark-shell就是这种模式。 当然,你也可以从距离工作节点很远的机器(如:你的笔记本)上提交应用,这种情况下,通常适用cluster模式,以减少网络驱动器和执行器之间的网络通信延迟。注意:对于Mesos集群管理器,Spark还不支持cluster模式。目前,只有YARN上Python应用支持cluster模式。 对于Python应用,只要把<application-jar>换成一个.py文件,再把.zip、.egg或者.py文件传给–py-files参数即可。 有一些参数是专门用于设置集群管理器的(cluster manager)。例如,在独立部署(Spark standalone cluster)时,并且使用cluster模式,你可以用–supervise参数来确保驱动器在异常退出情况下(退出并返回非0值)自动重启。spark-submit –help可查看完整的选项列表。这里有几个常见的示例: # 本地运行,占用8个core ./bin/spark-submit \ --class org.apache.spark.examples.SparkPi \ --master local[8] \ /path/to/examples.jar \ 100 # 独立部署,client模式 ./bin/spark-submit \ --class org.apache.spark.examples.SparkPi \ --master spark://207.184.161.138:7077 \ --executor-memory 20G \ --total-executor-cores 100 \ /path/to/examples.jar \ 1000 # 独立部署,cluster模式,异常退出时自动重启 ./bin/spark-submit \ --class org.apache.spark.examples.SparkPi \ --master spark://207.184.161.138:7077 \ --deploy-mode cluster --supervise --executor-memory 20G \ --total-executor-cores 100 \ /path/to/examples.jar \ 1000 # YARN上运行,cluster模式 export HADOOP_CONF_DIR=XXX ./bin/spark-submit \ --class org.apache.spark.examples.SparkPi \ --master yarn \ --deploy-mode cluster \ # 要client模式就把这个设为client --executor-memory 20G \ --num-executors 50 \ /path/to/examples.jar \ 1000 # 独立部署,运行python ./bin/spark-submit \ --master spark://207.184.161.138:7077 \ examples/src/main/python/pi.py \ 1000 # Mesos集群上运行,cluster模式,异常时自动重启 ./bin/spark-submit \ --class org.apache.spark.examples.SparkPi \ --master mesos://207.184.161.138:7077 \ --deploy-mode cluster --supervise --executor-memory 20G \ --total-executor-cores 100 \ http://path/to/examples.jar \ 1000 Master URLs 传给Spark的master URL可以是以下几种格式: Master URL 含义 local 本地运行Spark,只用1个worker线程(没有并行计算) local[K] 本地运行Spark,使用K个worker线程(理论上,最好将这个值设为你机器上CPU core的个数) local[*] 本地运行Spark,使用worker线程数同你机器上逻辑CPU core个数 spark://HOST:PORT 连接到指定的Spark独立部署的集群管理器(Spark standalone cluster)。端口是可以配置的,默认7077。 mesos://HOST:PORT 连接到指定的Mesos集群。端口号可以配置,默认5050。如果Mesos集群依赖于ZooKeeper,可以使用 mesos://zk://… 来提交,注意 –deploy-mode需要设置为cluster,同时,HOST:PORT应指向MesosClusterDispatcher. yarn 连接到指定的YARN集群,使用–deploy-mode来指定 client模式 或是 cluster 模式。YARN集群位置需要通过 $HADOOP_CONF_DIR 或者 $YARN_CONF_DIR 变量来查找。 yarn-client YARN client模式的简写,等价于 –master yarn –deploy-mode client yarn-cluster YARN cluster模式的简写,等价于 –master yarn –deploy-mode cluster 从文件加载配置 spark-submit脚本可以从一个属性文件加载默认的Spark属性配置值(Spark configuration values),并将这些属性传给你的应用程序。默认Spark会从 conf/spark-defaults.conf读取这些属性配置。更详细信息,请参考loading default configurations. 用这种方式加载默认Spark属性配置,可以在调用spark-submit脚本时省略一些参数标志。例如:如果属性文件中设置了spark.master属性,那么你就以忽略spark-submit的–master参数。通常,在代码里用SparkConf中设置的参数具有最高的优先级,其次是spark-submit中传的参数,再次才是spark-defaults.conf文件中的配置值。 如果你总是搞不清楚最终生效的配置值是从哪里来的,你可以通过spark-submit的–verbose选项来打印细粒度的调试信息。 高级依赖管理 通过spark-submit提交应用时,application jar和–jars选项中的jar包都会被自动传到集群上。Spark支持以下URL协议,并采用不同的分发策略: file:– 文件绝对路径,并且file:/URI是通过驱动器的HTTP文件服务器来下载的,每个执行器都从驱动器的HTTP server拉取这些文件。 hdfs:,http:,https:,ftp:– 设置这些参数后,Spark将会从指定的URI位置下载所需的文件和jar包。 local:– local:/ 打头的URI用于指定在每个工作节点上都能访问到的本地或共享文件。这意味着,不会占用网络IO,特别是对一些大文件或jar包,最好使用这种方式,当然,你需要把文件推送到每个工作节点上,或者通过NFS和GlusterFS共享文件。 注意,每个SparkContext对应的jar包和文件都需要拷贝到所对应执行器的工作目录下。一段时间之后,这些文件可能会占用相当多的磁盘。在YARN上,这些清理工作是自动完成的;而在Spark独立部署时,这种自动清理需要配置 spark.worker.cleanup.appDataTtl 属性。 用户还可以用–packages参数,通过给定一个逗号分隔的maven坐标,来指定其他依赖项。这个命令会自动处理依赖树。额外的maven库(或者SBT resolver)可以通过–repositories参数来指定。Spark命令(pyspark,spark-shell,spark-submit)都支持这些参数。 对于Python,也可以使用等价的–py-files选项来分发.egg、.zip以及.py文件到执行器上。 更多信息 部署完了你的应用程序后,cluster mode overview描述了分布式执行中所涉及的各个组件,以及如何监控和调试应用程序。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark快速入门

快速入门 本教程是对Spark的一个快速简介。首先,我们通过Spark的交互式shell介绍一下API(主要是Python或Scala),然后展示一下如何用Java、Scala、Python写一个Spark应用。更完整参考看这里:programming guide 首先,请到Spark website下载一个Spark发布版本,以便后续方便学习。我们暂时还不会用到HDFS,所以你可以使用任何版本的Hadoop。 使用Spark shell交互式分析 基础 利用Spark shell 很容易学习Spark API,同时也Spark shell也是强大的交互式数据分析工具。Spark shell既支持Scala(Scala版本的shell在Java虚拟机中运行,所以在这个shell中可以引用现有的Java库),也支持Python。在Spark目录下运行下面的命令可以启动一个Spark shell: Scala Python ./bin/spark-shell Spark最主要的抽象概念是个分布式集合,也叫作弹性分布式数据集(Resilient Distributed Dataset –RDD)。RDD可以由Hadoop InputFormats读取HDFS文件创建得来,或者从其他RDD转换得到。下面我们就先利用Spark源代码目录下的README文件来新建一个RDD: scala> val textFile = sc.textFile("README.md") textFile: spark.RDD[String] = spark.MappedRDD@2ee9b6e3 RDD有两种算子,action算子(actions)返回结果,transformation算子(transformations)返回一个新RDD。我们先来看一下action算子: scala> textFile.count() // Number of items in this RDD res0: Long = 126 scala> textFile.first() // First item in this RDD res1: String = # Apache Spark 再来看下如何使用transformation算子。我们利用filter这个transformation算子返回一个只包含原始文件子集的新RDD。 scala> val linesWithSpark = textFile.filter(line => line.contains("Spark")) linesWithSpark: spark.RDD[String] = spark.FilteredRDD@7dd4af09 把这两个例子串起来,我们可以这样写: scala> textFile.filter(line => line.contains("Spark")).count() // How many lines contain "Spark"? res3: Long = 15 更多RDD算子 RDD action 和 transformation 算子可以做更加复杂的计算。下面的代码中,我们将找出文件中包含单词数最多的行有多少个单词: Scala Python scala> textFile.map(line => line.split(" ").size).reduce((a, b) => if (a > b) a else b) res4: Long = 15 首先,用一个map算子将每一行映射为一个整数,返回一个新RDD。然后,用reduce算子找出这个RDD中最大的单词数。map和reduce算组的参数都是scala 函数体(闭包),且函数体内可以使用任意的语言特性,或引用scala/java库。例如,我们可以调用其他函数。为了好理解,下面我们用Math.max作为例子: scala> import java.lang.Math import java.lang.Math scala> textFile.map(line => line.split(" ").size).reduce((a, b) => Math.max(a, b)) res5: Int = 15 Hadoop上的MapReduce是大家耳熟能详的一种通用数据流模式。而Spark能够轻松地实现MapReduce流程: scala> val wordCounts = textFile.flatMap(line => line.split(" ")).map(word => (word, 1)).reduceByKey((a, b) => a + b) wordCounts: spark.RDD[(String, Int)] = spark.ShuffledAggregatedRDD@71f027b8 这个例子里,我使用了flatMap,map, andreduceByKey这几个transformation算子,把每个单词及其在文件中出现的次数转成一个包含(String,int)键值对的RDD,计算出每个单词在文件中出现的次数 scala> wordCounts.collect() res6: Array[(String, Int)] = Array((means,1), (under,2), (this,3), (Because,1), (Python,2), (agree,1), (cluster.,1), ...) 缓存 Spark同样支持把数据集拉到集群范围的内存缓存中。这对于需要重复访问的数据非常有用,比如:查询一些小而”热“(频繁访问)的数据集 或者 运行一些迭代算法(如 PageRank)。作为一个简单的示例,我们把 linesWithSpark 这个数据集缓存一下: Scala Python scala> linesWithSpark.cache() res7: spark.RDD[String] = spark.FilteredRDD@17e51082 scala> linesWithSpark.count() res8: Long = 19 scala> linesWithSpark.count() res9: Long = 19 用Spark来缓存一个100行左右的文件,看起来确实有点傻。但有趣的是,同样的代码可以用于缓存非常大的数据集,即使这些数据集可能分布在数十或数百个节点,也是一样。你可以用 bin/spark-shell 连到一个集群上来验证一下,更详细的请参考:programming guide. 独立的应用程序 假设我们想写一个独立的Spark应用程序。我们将快速的过一下一个简单的应用程序,分别用Scala(sbt编译),Java(maven编译)和Python。 Scala Java Python 首先用Scala新建一个简单的Spark应用 – 简单到连名字都叫SimpleApp.scala /* SimpleApp.scala */ import org.apache.spark.SparkContext import org.apache.spark.SparkContext._ import org.apache.spark.SparkConf object SimpleApp { def main(args: Array[String]) { val logFile = "YOUR_SPARK_HOME/README.md" // Should be some file on your system val conf = new SparkConf().setAppName("Simple Application") val sc = new SparkContext(conf) val logData = sc.textFile(logFile, 2).cache() val numAs = logData.filter(line => line.contains("a")).count() val numBs = logData.filter(line => line.contains("b")).count() println("Lines with a: %s, Lines with b: %s".format(numAs, numBs)) } } 注意,应用程序需要定义一个main方法,而不是继承scala.App。scala.App的子类可能不能正常工作。 这个程序,统计了Spark README文件中分别包含‘a’和’b’的行数。注意,你需要把YOUR_SPARK_HOME换成你的Spark安装目录。与之前用spark-shell不同,这个程序有一个单独的SparkContext对象,我们初始化了这个SparkContext对象并将其作为程序的一部分。 我们把一个SparkConf对象传给SparkContext的构造函数,SparkConf对象包含了我们这个应用程序的基本信息和配置。 我们的程序需要依赖Spark API,所以我们需要包含一个sbt配置文件,simple.sbt,在这个文件里,我们可以配置Spark依赖项。这个文件同时也添加了Spark本身的依赖库: name := "Simple Project" version := "1.0" scalaVersion := "2.10.5" libraryDependencies += "org.apache.spark" %% "spark-core" % "1.6.0" 为了让sbt能正常工作,我们需要一个典型的目录结构来放SimpleApp.scala和simple.sbt程序。一旦建立好目录,我们就可以创建一个jar包,然后用spark-submit脚本运行我们的代码。 # Your directory layout should look like this $ find . . ./simple.sbt ./src ./src/main ./src/main/scala ./src/main/scala/SimpleApp.scala # Package a jar containing your application $ sbt package ... [info] Packaging {..}/{..}/target/scala-2.10/simple-project_2.10-1.0.jar # Use spark-submit to run your application $ YOUR_SPARK_HOME/bin/spark-submit \ --class "SimpleApp" \ --master local[4] \ target/scala-2.10/simple-project_2.10-1.0.jar ... Lines with a: 46, Lines with b: 23 下一步 恭喜你!你的首个Spark应用已经跑起来了! 进一步的API参考,请看这里:Spark programming guide,或者在其他页面上点击“Programming Guides”菜单 如果想了解集群上运行应用程序,请前往:deployment overview 最后,Spark examples子目录下包含了多个示例,你可以这样来运行这些例子: # For Scala and Java, use run-example: ./bin/run-example SparkPi # For Python examples, use spark-submit directly: ./bin/spark-submit examples/src/main/python/pi.py # For R examples, use spark-submit directly: ./bin/spark-submit examples/src/main/r/dataframe.R 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark作业调度

Spark作业调度 概览 Spark有好几种计算资源调度的方式。首先,回忆一下集群模式概览(cluster mode overview)中每个Spark应用(包含一个SparkContext实例)中运行了一些其独占的执行器(executor)进程。集群管理器提供了Spark应用之间的资源调度(scheduling across applications)。其次,在各个Spark应用内部,各个线程可能并发地通过action算子提交多个Spark作业(job)。如果你的应用服务于网络请求,那这种情况是很常见的。在Spark应用内部(对应同一个SparkContext)各个作业之间,Spark默认FIFO调度,同时也可以支持公平调度(fair scheduler)。 Spark应用之间的资源调度 如果在集群上运行,每个Spark应用都会获得一批独占的执行器JVM,来运行其任务并存储数据。如果有多个用户共享集群,那么会有很多资源分配相关的选项,如何设置还取决于具体的集群管理器。 对Spark所支持的各个集群管理器而言,最简单的资源分配,就是对资源静态划分。这种方式就意味着,每个Spark应用都是设定一个最大可用资源总量,并且该应用在整个生命周期内都会占住这些资源。这种方式在Spark独立部署(standalone)和YARN调度,以及Mesos粗粒度模式(coarse-grained Mesos mode)下都可用。 Standalone mode:默认情况下,Spark应用在独立部署的集群中都会以FIFO(first-in-first-out)模式顺序提交运行,并且每个Spark应用都会占用集群中所有可用节点。不过你可以通过设置spark.cores.max或者spark.deploy.defaultCores 来限制单个应用所占用的节点个数。最后,除了可以控制对CPU的使用数量之外,还可以通过 spark.executor.memory 来控制各个应用的内存占用量。 Mesos:在Mesos中要使用静态划分的话,需要将 spark.mesos.coarse 设为true,同样,你也需要设置 spark.cores.max 来控制各个应用的CPU总数,以及 spark.executor.memory 来控制各个应用的内存占用。 YARN:在YARN中需要使用 –num-executors 选项来控制Spark应用在集群中分配的执行器的个数,对于单个执行器(executor)所占用的资源,可以使用 –executor-memory 和 –executor-cores 来控制。 Mesos上另一种可用的方式是动态共享CPU。在这种模式下,每个Spark应用的内存占用仍然是固定且独占的(仍由spark.executor.memory决定),但是如果该Spark应用没有在某个机器上执行任务的话,那么其他应用可以占用该机器上的CPU。这种模式对集群中有大量不是很活跃应用的场景非常有效,例如:集群中有很多不同用户的Spark shell session。但这种模式不适用于低延迟的场景,因为当Spark应用需要使用CPU的时候,可能需要等待一段时间才能取得CPU的使用权。要使用这种模式,只需要在 mesos:// URL 上设置 spark.mesos.coarse 属性为flase即可。 注意,目前还没有任何一种资源分配模式能支持跨Spark应用的内存共享。如果你需要跨Spark应用共享内存,我们建议你用单独用一个server来计算和保留同一个RDD查询的结果,这样就能在多个请求(request)之间共享同一个RDD的数据。在未来的发布版本中,一些内存存储系统(如:Tachyon)或许能够提供这种跨Spark应用共享RDD的能力。 动态资源分配 Spark还提供了一种基于负载来动态调节Spark应用资源占用的机制。这意味着,你的应用会在资源空闲的时候将其释放给集群,而后续用到的时候再重新申请。这一特性在多个应用共享Spark集群资源的情况下特别有用。 注意,这个特性默认是禁用的,但是在所有的粗粒度集群管理器上都是可用的,如:独立部署模式(standalone mode),YARN模式(YARN mode)以及Mesos粗粒度模式(Mesos coarse-grained mode)。 配置和部署 要使用这一特性有两个前提条件。首先,你的应用必须设置 spark.dynamicAllocation.enabled 为 true。其次,你必须在每个节点上启动一个外部混洗服务(external shuffle service),并在你的应用中将 spark.shuffle.service.enabled 设为true。外部混洗服务的目的就是为了在删除执行器的时候,能够保留其输出的混洗文件(本文后续有更详细的描述)。启用外部混洗的方式在各个集群管理器上各不相同: 在Spark独立部署的集群中,你只需要在worker启动前设置 spark.shuffle.server.enabled 为true即可。 在Mesos粗粒度模式下,你需要在各个节点上运行 ${SPARK_HOME}/sbin/start-mesos-shuffle-service.sh 并设置 spark.shuffle.service.enabled 为true 即可。例如,你可以用Marathon来启用这一功能。 在YARN模式下,混洗服务需要按以下步骤在各个NodeManager上启动: 首先按照YARN profile构建Spark。如果你已经有打好包的Spark,可以忽略这一步。 找到 spark-<version>-yarn-shuffle.jar。如果你是自定义编译,其位置应该在 ${SPARK_HOME}/network/yarn/target/scala-<version>,否则应该可以在 lib 目录下找到这个jar包。 将该jar包添加到NodeManager的classpath路径中。 配置各个节点上的yarn-site.xml,将 spark_shuffle 添加到 yarn.nodemanager.aux-services 中,然后将 yarn.nodemanager.aux-services.spark_shuffle.class 设为 org.apache.spark.network.yarn.YarnShuffleService,并将 spark.shuffle.service.enabled 设为 true。 最后重启各节点上的NodeManager。 所有相关的配置都是可选的,并且都在 spark.dynamicAllocation.* 和 spark.shuffle.service.* 命名空间下。更详细请参考:configurations page。 资源分配策略 总体上来说,Spark应该在执行器空闲时将其关闭,而在后续要用时再次申请。因为没有一个固定的方法,可以预测一个执行器在后续是否马上回被分配去执行任务,或者一个新分配的执行器实际上是空闲的,所以我们需要一些试探性的方法,来决定是否申请或移除一个执行器。 请求策略 一个启用了动态分配的Spark应用会在有等待任务需要调度的时候,申请额外的执行器。这种情况下,必定意味着已有的执行器已经不足以同时执行所有未完成的任务。 Spark会分轮次来申请执行器。实际的资源申请,会在任务挂起 spark.dynamicAllocation.schedulerBacklogTimeout 秒后首次触发,其后如果等待队列中仍有挂起的任务,则每过 spark.dynamicAlloction.sustainedSchedulerBacklogTimeout 秒触发一次资源申请。另外,每一轮所申请的执行器个数以指数形式增长。例如,一个Spark应用可能在首轮申请1个执行器,后续的轮次申请个数可能是2个、4个、8个… … 。 采用指数级增长策略的原因有两个:第一,对于任何一个Spark应用如果只是需要多申请少数几个执行器的话,那么必须非常谨慎地启动资源申请,这和TCP慢启动有些类似;第二,如果一旦Spark应用确实需要申请很多个执行器的话,那么可以确保其所需的计算资源及时地增长。 移除策略 移除执行器的策略就简单多了。Spark应用会在某个执行器空闲超过 spark.dynamicAllocation.executorIdleTimeout 秒后将其删除。在绝大多数情况下,执行器的移除条件和申请条件都是互斥的,也就是说,执行器在有待执行任务挂起时,不应该空闲。 优雅地关闭执行器 非动态分配模式下,执行器可能的退出原因有执行失败或者相关Spark应用已经退出。不管是那种原因,执行器的所有状态都已经不再需要,可以丢弃掉。但在动态分配的情形下,执行器有可能在Spark应用运行期间被移除。这时候,如果Spark应用尝试去访问该执行器存储的状态,就必须重算这一部分数据。因此,Spark需要一种机制,能够优雅地关闭执行器,同时还保留其状态数据。 这种需求对于混洗操作尤其重要。混洗过程中,Spark执行器首先将map输出写到本地磁盘,同时执行器本身又是一个文件服务器,这样其他执行器就能够通过该执行器获得对应的map结果数据。一旦有某些任务执行时间过长,动态分配有可能在混洗结束前移除任务异常的执行器,而这些被移除的执行器对应的数据将会被重新计算,但这些重算其实是不必要的。 要解决这一问题,就需要用到一个外部混洗服务(external shuffle service),该服务在Spark 1.2引入。该服务在每个节点上都会启动一个不依赖于任何Spark应用或执行器的独立进程。一旦该服务启用,Spark执行器不再从各个执行器上获取shuffle文件,转而从这个service获取。这意味着,任何执行器输出的混洗状态数据都可能存留时间比对应的执行器进程还长。 除了混洗文件之外,执行器也会在磁盘或者内存中缓存数。一旦执行器被移除,其缓存数据将无法访问。这个问题目前还没有解决。或许在未来的版本中,可能会采用外部混洗服务类似的方法,将缓存数据保存在堆外存储中以解决这一问题。 Spark应用内部的资源调度 在指定的Spark应用内部(对应同一SparkContext实例),多个线程可能并发地提交Spark作业(job)。在本节中,作业(job)是指,由Spark action算子(如:collect)触发的一系列计算任务的集合。Spark调度器是完全线程安全的,并且能够支持Spark应用同时处理多个请求(比如:来自不同用户的查询)。 默认,Spark应用内部使用FIFO调度策略。每个作业被划分为多个阶段(stage)(例如:map阶段和reduce阶段),第一个作业在其启动后会优先获取所有的可用资源,然后是第二个作业再申请,再第三个……。如果前面的作业没有把集群资源占满,则后续的作业可以立即启动运行,否则,后提交的作业会有明显的延迟等待。 不过从Spark 0.8开始,Spark也能支持各个作业间的公平(Fair)调度。公平调度时,Spark以轮询的方式给每个作业分配资源,因此所有的作业获得的资源大体上是平均分配。这意味着,即使有大作业在运行,小的作业再提交也能立即获得计算资源而不是等待前面的作业结束,大大减少了延迟时间。这种模式特别适合于多用户配置。 要启用公平调度器,只需设置一下 SparkContext中spark.scheduler.mode 属性为 FAIR即可: val conf = new SparkConf().setMaster(...).setAppName(...) conf.set("spark.scheduler.mode", "FAIR") val sc = new SparkContext(conf) 公平调度资源池 公平调度器还可以支持将作业分组放入资源池(pool),然后给每个资源池配置不同的选项(如:权重)。这样你就可以给一些比较重要的作业创建一个“高优先级”资源池,或者你也可以把每个用户的作业分到一组,这样一来就是各个用户平均分享集群资源,而不是各个作业平分集群资源。Spark公平调度的实现方式基本都是模仿Hadoop Fair Scheduler来实现的。 默认情况下,新提交的作业都会进入到默认资源池中,不过作业对应于哪个资源池,可以在提交作业的线程中用SparkContext.setLocalProperty 设定 spark.scheduler.pool 属性。示例代码如下: // Assuming sc is your SparkContext variable sc.setLocalProperty("spark.scheduler.pool", "pool1") 一旦设好了局部属性,所有该线程所提交的作业(即:在该线程中调用action算子,如:RDD.save/count/collect 等)都会使用这个资源池。这个设置是以线程为单位保存的,你很容易实现用同一线程来提交同一用户的所有作业到同一个资源池中。同样,如果需要清除资源池设置,只需在对应线程中调用如下代码: sc.setLocalProperty("spark.scheduler.pool", null) 资源池默认行为 默认地,各个资源池之间平分整个集群的资源(包括default资源池),但在资源池内部,默认情况下,作业是FIFO顺序执行的。举例来说,如果你为每个用户创建了一个资源池,那么久意味着各个用户之间共享整个集群的资源,但每个用户自己提交的作业是按顺序执行的,而不会出现后提交的作业抢占前面作业的资源。 配置资源池属性 资源池的属性需要通过配置文件来指定。每个资源池都支持以下3个属性: schedulingMode:可以是FIFO或FAIR,控制资源池内部的作业是如何调度的。 weight:控制资源池相对其他资源池,可以分配到资源的比例。默认所有资源池的weight都是1。如果你将某个资源池的weight设为2,那么该资源池中的资源将是其他池子的2倍。如果将weight设得很高,如1000,可以实现资源池之间的调度优先级 – 也就是说,weight=1000的资源池总能立即启动其对应的作业。 minShare:除了整体weight之外,每个资源池还能指定一个最小资源分配值(CPU个数),管理员可能会需要这个设置。公平调度器总是会尝试优先满足所有活跃(active)资源池的最小资源分配值,然后再根据各个池子的weight来分配剩下的资源。因此,minShare属性能够确保每个资源池都能至少获得一定量的集群资源。minShare的默认值是0。 资源池属性是一个XML文件,可以基于 conf/fairscheduler.xml.template 修改,然后在SparkConf的 spark.scheduler.allocation.file 属性指定文件路径: conf.set("spark.scheduler.allocation.file", "/path/to/file") 资源池XML配置文件格式如下,其中每个池子对应一个<pool>元素,每个资源池可以有其独立的配置: <?xml version="1.0"?> <allocations> <pool name="production"> <schedulingMode>FAIR</schedulingMode> <weight>1</weight> <minShare>2</minShare> </pool> <pool name="test"> <schedulingMode>FIFO</schedulingMode> <weight>2</weight> <minShare>3</minShare> </pool> </allocations> 完整的例子可以参考 conf/fairscheduler.xml.template。注意,没有在配置文件中配置的资源池都会使用默认配置(schedulingMode:FIFO,weight:1,minShare:0)。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark官方文档》集群模式概览

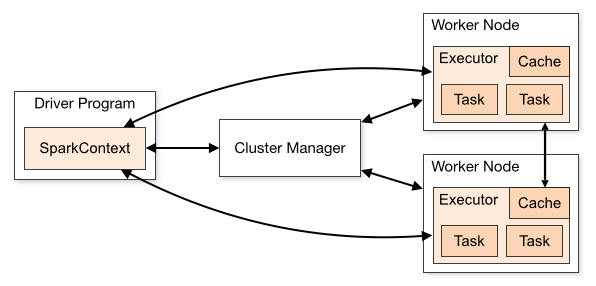
集群模式概览 本文简要描述了Spark在集群中各个组件如何运行。想了解如何在集群中启动Spark应用,请参考application submission guide。 组件 Spark应用在集群上运行时,包括了多个独立的进程,这些进程之间通过你的主程序(也叫作驱动器,即:driver)中的SparkContext对象来进行协调。 特别要指出的是,SparkContext能与多种集群管理器通信(包括:Spark独立部署时自带的集群管理器,Mesos或者YARN)。一旦连接上集群管理器,Spark会为该应用在各个集群节点上申请执行器(executor),用于执行计算任务和存储数据。接下来,Spark将应用程序代码(JAR包或者Python文件)发送给所申请到的执行器。最后SparkContext将分割出的任务(task)发送给各个执行器去运行。 这个架构中有几个值得注意的地方: 每个Spark应用程序都有其对应的多个执行器进程,执行器进程在整个应用程序生命周期内,都保持运行状态,并以多线程方式运行所收到的任务。这样的好处是,可以隔离各个Spark应用,从调度角度来看,每个驱动器可以独立调度本应用程序内部的任务,从执行器角度来看,不同的Spark应用对应的任务将会在不同的JVM中运行。然而这种架构同样也有其劣势,多个Spark应用程序之间无法共享数据,除非把数据写到外部存储中。 Spark对底层的集群管理器一无所知。只要Spark能申请到执行器进程,并且能与之通信即可。这种实现方式可以使Spark相对比较容易在一个支持多种应用的集群管理器上运行(如:Mesos或YARN) 驱动器(driver)程序在整个生命周期内必须监听并接受其对应的各个执行器的连接请求(参考:spark.driver.port and spark.fileserver.port in the network config section)。因此,驱动器程序必须能够被所有worker节点访问到。 因为集群上的任务是由驱动器来调度的,所以驱动器应该和worker节点距离近一些,最好在同一个本地局域网中。如果你需要远程对集群发起请求,最好还是在驱动器节点上启动RPC服务,来响应这些远程请求,同时把驱动器本身放在集群worker节点比较近的机器上。 集群管理器类型 Spark支持以下3中集群管理器: Standalone– Spark自带的一个简单的集群管理器,这使得启动一个Spark集群变得非常简单。 Apache Mesos– 一种可以运行Hadoop MapReduce或者服务型应用的通用集群管理器。 Hadoop YARN– Hadoop 2的集群管理器。 另外,使用Spark的EC2 launch scripts可以轻松地在Amazon EC2上启动一个独立集群。 提交Spark应用 利用spark-submit脚本,可以向Spark所支持的任意一种集群提交应用。详见:application submission guide 监控 每一个驱动器(driver)都有其对应的web UI,默认会绑定4040端口(多个并存会按顺序绑定4041、4042…),这个web UI会展示该Spark应用正在运行的任务(task)、执行器(executor)以及所使用的存储信息。只需在浏览器种打开http://<driver-node>:4040即可访问。monitoring guide详细描述了其他监控选项。 作业调度 Spark可以在应用程序之间(集群管理器这一层面)和之内(如:同一个SparkContext对象运行了多个计算作业)控制资源分配。job scheduling overview描述了更详细的信息。 概念和术语 下表简要说明了集群模式下的一些概念和术语: 术语 含义 Application(应用) Spark上运行的应用。包含了驱动器(driver)进程(一个)和集群上的执行器(executor)进程(多个) Application jar(应用jar包) 包含Spark应用程序的jar包。有时候,用户会想要把应用程序代码及其依赖打到一起,形成一个“uber jar”(包含自身以及所有依赖库的jar包),注意这时候不要把Spark或Hadoop的库打进来,这些库会在运行时加载 Driver program(驱动器) 运行main函数并创建SparkContext的进程。 Cluster manager(集群管理器) 用于在集群上申请资源的 外部服务(如:独立部署的集群管理器、Mesos或者YARN) Deploy mode(部署模式) 用于区分驱动器进程在哪里运行。在”cluster”模式下,驱动器将运行在集群上某个节点;在”client“模式下,驱动器在集群之外的客户端运行。 Worker node(工作节点) 集群上运行应用程序代码的任意一个节点。 Executor(执行器) 在集群工作节点上,为某个应用启动的工作进程;专门用于运行计算任务,并在内存或磁盘上保存数据。每个应用都独享其对应的多个执行器。 Task(任务) 下发给执行器的工作单元。 Job(作业) 一个并行计算作业,由一组任务(Task)组成,并由Spark的行动(action)算子(如:save、collect)触发启动;你会在驱动器日志中看到这个术语。 Stage(步骤) 每个作业(Job)可以划分为更小的任务(Task)集合,这就是步骤(Stage),这些步骤彼此依赖形成一个有向无环图(类似于MapReduce中的map和reduce);你会在驱动器日志中看到这个术语。 转载自并发编程网 - ifeve.com

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册