首页 文章 精选 留言 我的

精选列表

搜索[批量导入手机通讯录],共10000篇文章
优秀的个人博客,低调大师

docker学习系列17 镜像和容器的导入导出

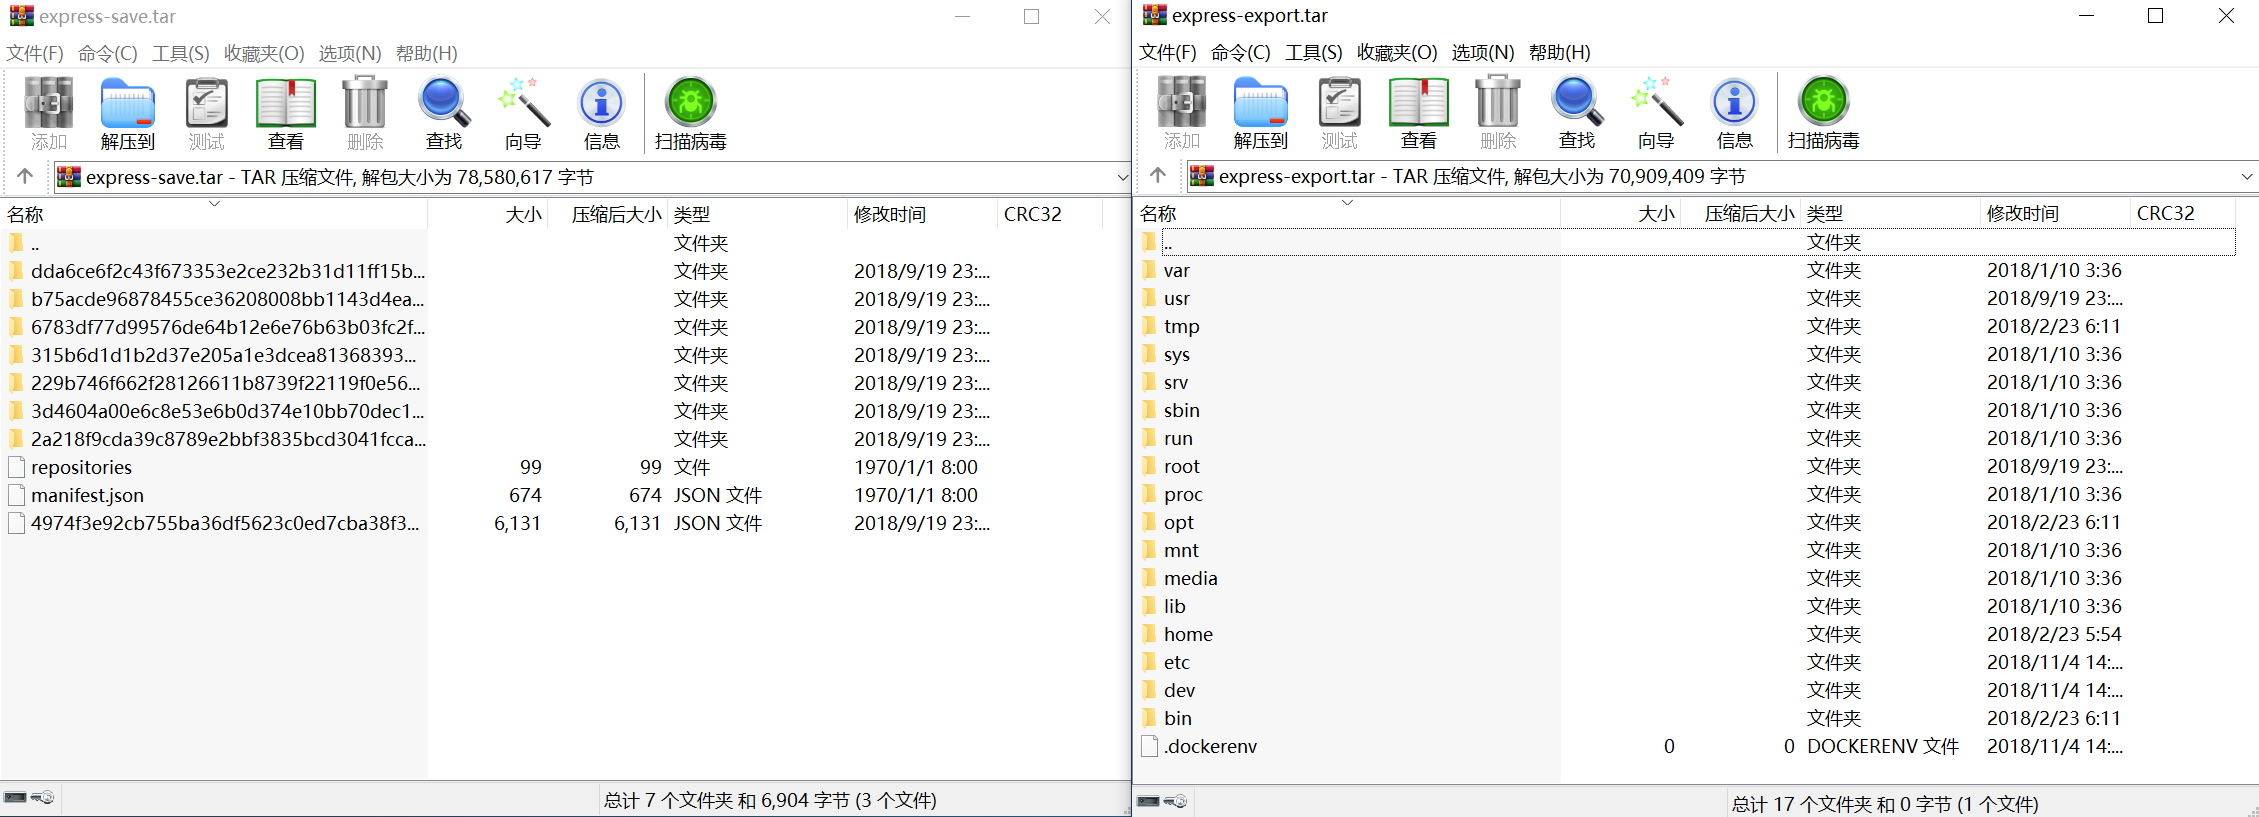
先说总结: docker save保存的是镜像(image),docker export保存的是容器(container); docker load用来载入镜像包,docker import用来载入容器,但两者都会恢复为镜像; docker load不能对载入的镜像重命名,而docker import可以为镜像指定新名称。 比如我本机上有一个 finleyma/express的镜像,容器ID为4a655b443069 使用如下命令分别导出镜像和容器docker save -o express-save.tar finleyma/expressdocker export -o express-export.tar 4a655b443069 发现如下特点: 镜像压缩包比容器要大。 目录结构不太一样 image.png export.tar 是很典型的Linux目录结构,还找到当初build时被ADD进的源码文件 image.png save.tar 其实就是分层的文件系统。Docker镜像就是由这样一层曾的文件叠加起来。 打开压缩包内的 repositories, 内容为 {"finleyma/express":{"latest":"dda6ce6f2c43f673353e2ce232b31d11ff15b444e338a0ef8f34b6ef74093d6c"}} 既这个镜像的名称,tag是latest,id为dda6ce6f2c43f673353e2ce232b31d11ff15b444e338a0ef8f34b6ef74093d6c 而且tar内有相同ID的目录。 image.png json文件的内容如下:里面记录着这一层容器文件的元信息,通过parent,还能知道依赖的上一层的文件系统是什么。 { "id": "dda6ce6f2c43f673353e2ce232b31d11ff15b444e338a0ef8f34b6ef74093d6c", "parent": "b75acde96878455ce36208008bb1143d4ea17723257c991f8bfb33ad9e27251d", "created": "2018-09-19T15:41:54.6130547Z", "container": "3cd78865317bce73179abc7d21fcbe860a96d14fc980c01566fa2c9412b17d7d", "container_config": { "Hostname": "3cd78865317b", "Domainname": "", "User": "", "AttachStdin": false, "AttachStdout": false, "AttachStderr": false, "ExposedPorts": { "8081/tcp": {} }, "Tty": false, "OpenStdin": false, "StdinOnce": false, "Env": ["PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin", "NODE_VERSION=8.9.4", "YARN_VERSION=1.3.2"], "Cmd": ["/bin/sh", "-c", "#(nop) ", "CMD [\"npm\" \"start\"]"], "ArgsEscaped": true, "Image": "sha256:91f850e6adbd56df68088dffe63c56e6f48fc24f763ff9d22c739742be71212a", "Volumes": null, "WorkingDir": "/usr/src/app", "Entrypoint": null, "OnBuild": [], "Labels": {} }, "docker_version": "18.06.1-ce", "config": { "Hostname": "", "Domainname": "", "User": "", "AttachStdin": false, "AttachStdout": false, "AttachStderr": false, "ExposedPorts": { "8081/tcp": {} }, "Tty": false, "OpenStdin": false, "StdinOnce": false, "Env": ["PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin", "NODE_VERSION=8.9.4", "YARN_VERSION=1.3.2"], "Cmd": ["npm", "start"], "ArgsEscaped": true, "Image": "sha256:91f850e6adbd56df68088dffe63c56e6f48fc24f763ff9d22c739742be71212a", "Volumes": null, "WorkingDir": "/usr/src/app", "Entrypoint": null, "OnBuild": [], "Labels": null }, "architecture": "amd64", "os": "linux" } 打开lay.tar, 对于的原来就是当初dockerfile中的ADD . /app/ image.png 那 node_modules 跑哪了,你很快就能猜测到,肯定在上一层文件中。事实确实是这样的。ADD . /app/ 之前对于的命令是 RUN npm install image.png 所以写dockerfile时,一行命令对于一层文件系统,要充分利用这样机制,层的数量尽可能少,只安装必要的依赖包。 参考:https://blog.csdn.net/liukuan73/article/details/78089138https://yeasy.gitbooks.io/docker_practice/content/appendix/best_practices.htmlhttps://docs.docker.com/develop/develop-images/dockerfile_best-practices/
优秀的个人博客,低调大师

如何将mysql数据导入Hadoop之Sqoop安装

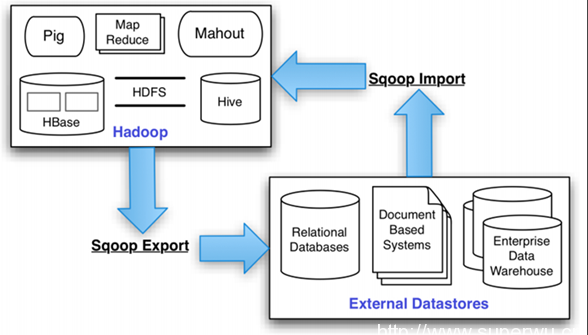
Sqoop是一款开源的工具,主要用于在Hadoop(Hive)与传统的数据库(mysql、postgresql...)间进行数据的传递,可以将一个关系型数据库(例如 : MySQL ,Oracle ,Postgres等)中的数据导进到Hadoop的HDFS中,也可以将HDFS的数据导进到关系型数据库中。Sqoop项目开始于2009年,最早是作为Hadoop的一个第三方模块存在,后来为了让使用者能够快速部署,也为了让开发人员能够更快速的迭代开发,Sqoop独立成为一个Apache项目。 总之Sqoop是一个转换工具,用于在关系型数据库与HDFS之间进行数据转换。 注意:sqoop1与sqoop2完全不兼容,1.4.6及之前的版本是sqoop1,之后的是sqoop2 Sqoop1和Sqoop2的对比 sqoop2比sqoop1的改进 引入sqoop server,集中化管理connector等 多种访问方式:CLI,Web UI,REST API 引入基于角色 的安全机制 sqoop1与sqoop2的优缺点 sqoop1的架构,仅仅使用一个sqoop客户端,sqoop2的架构,引入了sqoop server集中化管理connector,以及rest api,web,UI,并引入权限安全机制。 sqoop1优点架构部署简单 sqoop1的缺点命令行方式容易出错,格式紧耦合,无法支持所有数据类型,安全机制不够完善,例如密码暴漏, 安装需要root权限,connector必须符合JDBC模型 sqoop2的优点多种交互方式,命令行,web UI,rest API,conncetor集中化管理,所有的链接安装在sqoop server上,完善权限管理机制,connector规范化,仅仅负责数据的读写。 sqoop2的缺点,架构稍复杂,配置部署更繁琐。 sqoop1架构图 sqoop2架构图 由于sqoop2还不是很完善,官方建议生产环境不建议使用,在此就sqoop1.4.6来作介绍 安装环境: Cenos7系统 sqoop版本:1.4.6 Hadoop:2.7.3 MySQL:5.7.15 JDK :1.8 下载并解压sqoop1.4.6 安装在一台节点上就可以了 点击 sqoop下载地址,下载Sqoop安装文件sqoop-1.4.6.bin__hadoop-2.0.4-alpha.tar.gz。将文件上传到服务器的/usr/local文件夹中。 下面执行以下命令 1.cd~#进入当前用户的用户目录2.cd/usr/local3.sudotar-zxvfsqoop-1.4.6.bin__hadoop-2.0.4-alpha.tar.gz-C/usr/local#解压安装文件5.sudomvsqoop-1.4.6.bin__hadoop-2.0.4-alphasqoop146#修改文件名6.sudochown-Rhadoop:hadoopsqoop146#修改文件夹属主,如果你当前登录用户名不是hadoop,请修改成你自己的用户名(hadoop为用Hadoop创建的用户组和用户名,sqoop将与Hadoop组合使用) 修改配置文件sqoop-env.sh 1.cdsqoop146/conf/ 2.catsqoop-env-template.sh>>sqoop-env.sh#将sqoop-env-template.sh复制一份并命名为sqoop-env.sh3.visqoop-env.sh#编辑sqoop-env.sh 修改sqoop-env.sh的如下信息,若有其它的可以都加上 exportHADOOP_COMMON_HOME=/usr/local/hadoop273 exportHADOOP_MAPRED_HOME=/usr/local/hadoop273 export HBASE_HOME=/usr/local/hbase export HIVE_HOME=/usr/local/hive export ZOOCFGDIR= #如果读者配置了ZooKeeper,也需要在此配置ZooKeeper的路径 配置环境变量 打开当前用户的环境变量配置文件: vi~/.bash_profile 在配置文件第一行键入如下信息: exportSQOOP_HOME=/usr/local/sqoop146 exportPATH=$PATH:$SBT_HOME/bin:$SQOOP_HOME/bin exportCLASSPATH=$CLASSPATH:$SQOOP_HOME/lib 保存该文件,退出vim编辑器。 然后,执行下面命令让配置文件立即生效: source~/.bash_profile 将mysql驱动包拷贝到$SQOOP_HOME/lib 下面要把MySQL驱动程序和hadoop-connector jar包拷贝到$SQOOP_HOME/lib目录下,不存在先下载驱动包。 cp./mysql-connector-java-5.1.40/mysql-connector-java-5.1.40-bin.jar/usr/local/sqoop146/lib cp$HADOOP_HOME/share/hadoop/common/hadoop-common-2.7.3.jar$SQOOP_HOME/lib 修改$SQOOP_HOME/bin/configure-sqoop 注释掉HCatalog,Accumulo检查(除非你准备使用HCatalog,Accumulo等HADOOP上的组件) ##Movedtobearuntimecheckinsqoop.#if[!-d"${HCAT_HOME}"];then#echo"Warning:$HCAT_HOMEdoesnotexist!HCatalogjobswillfail."#echo'Pleaseset$HCAT_HOMEtotherootofyourHCataloginstallation.'#fi #if[!-d"${ACCUMULO_HOME}"];then#echo"Warning:$ACCUMULO_HOMEdoesnotexist!Accumuloimportswillfail."#echo'Pleaseset$ACCUMULO_HOMEtotherootofyourAccumuloinstallation.'#fi #AddHCatalogtodependencylist#if[-e"${HCAT_HOME}/bin/hcat"];then#TMP_SQOOP_CLASSPATH=${SQOOP_CLASSPATH}:`${HCAT_HOME}/bin/hcat-classpath`#if[-z"${HIVE_CONF_DIR}"];then#TMP_SQOOP_CLASSPATH=${TMP_SQOOP_CLASSPATH}:${HIVE_CONF_DIR}#fi#SQOOP_CLASSPATH=${TMP_SQOOP_CLASSPATH}#fi #AddAccumulotodependencylist#if[-e"$ACCUMULO_HOME/bin/accumulo"];then#forjnin`$ACCUMULO_HOME/bin/accumuloclasspath|grepfile:.*accumulo.*jar|cut-d':'-f2`;do#SQOOP_CLASSPATH=$SQOOP_CLASSPATH:$jn#done#forjnin`$ACCUMULO_HOME/bin/accumuloclasspath|grepfile:.*zookeeper.*jar|cut-d':'-f2`;do#SQOOP_CLASSPATH=$SQOOP_CLASSPATH:$jn#done#fi 测试与MySQL的连接 首先请确保mysql服务已经启动了,如果没有启动,请执行下面命令启动: servicemysqlstart 然后就可以测试sqoop与MySQL之间的连接是否成功: sqooplist-databases--connectjdbc:mysql://127.0.0.1:3306/--usernameroot-passwordroot root为数据库的用户名和密码,mysql的数据库列表显示在屏幕上表示连接成功。 本文转自xmgdc51CTO博客,原文链接:http://blog.51cto.com/12953214/1941199 ,如需转载请自行联系原作者

优秀的个人博客,低调大师

【视频云端】iOS库冲突的问题---动态库导入

1.什么是库 首先来看什么是库,库(Library)说白了就是一段编译好的二进制代码,加上头文件就可以供别人使用。 什么时候我们会用到库呢?一种情况是某些代码需要给别人使用,但是我们不希望别人看到源码,就需要以库的形式进行封装,只暴露出头文件。另外一种情况是,对于某些不会进行大的改动的代码,我们想减少编译的时间,就可以把它打包成库,因为库是已经编译好的二进制了,编译的时候只需要 Link 一下,不会浪费编译时间。 上面提到库在使用的时候需要 Link,Link 的方式有两种,静态和动态,于是便产生了静态库和动态库。 2.静态库和动态库的存在形式和区别。 2.1 静态库和动态库的存在形式 静态库:.a 和 .framework动态库:.dylib 和 .framework 2.2 静态库和动态库的区别 静态库:静态库即静态链接库(Windows 下

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册